
Last chance! 50% off DataCamp Premium
Sale ends in
Nei due precedenti tutorial su Kaggle hai imparato come preparare i dati per costruire il tuo primo modello di machine learning, usando analisi esplorativa dei dati e modelli di base. Poi sei riuscito a costruire il tuo primo modello, un classificatore ad albero di decisione. Hai inviato tutti questi modelli a Kaggle e ne hai interpretato l’accuratezza.
In questo terzo tutorial, imparerai di più sul feature engineering, un processo in cui usi la conoscenza del dominio dei tuoi dati per creare feature aggiuntive e rilevanti che aumentano il potere predittivo dell’algoritmo di apprendimento e migliorano ulteriormente le prestazioni dei tuoi modelli!
Più nello specifico,
Prima di cominciare, eseguirai tutti gli import, proprio come nel tutorial precedente, userai un po’ di magia IPython per assicurarti che le figure vengano generate inline nel Jupyter Notebook e imposterai lo stile di visualizzazione. Poi importerai i dati e ti assicurerai di salvare la variabile target dei dati di training in un posto sicuro. Successivamente unirai i set di dati di train e di test (eccetto la colonna 'Survived' di df_train) e memorizzerai il risultato in data.
Ricorda che lo fai per assicurarti che qualsiasi preprocessing applicato ai dati si rifletta sia sul train che sul test set!
Infine, userai il metodo .info() per dare un’occhiata ai tuoi dati:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBFai feature engineering per estrarre più informazioni dai dati, così da alzare l’asticella quando costruisci i modelli.
Vediamo di cosa si tratta con un esempio. Esamina la colonna 'Name' con il metodo .tail(), che ti mostra le ultime cinque righe dei dati:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
All’improvviso compaiono titoli diversi! In altre parole, questa colonna contiene stringhe o testo con titoli come "Mr", "Master" e "Dona".
Questi titoli ovviamente forniscono informazioni su status sociale, professione, ecc., che alla fine potrebbero dirti qualcosa in più sulla sopravvivenza.
A prima vista, separare nomi e titoli può sembrare difficile, ma niente panico! Ricorda che puoi usare facilmente le espressioni regolari per estrarre il titolo e salvarlo in una nuova colonna 'Title':
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
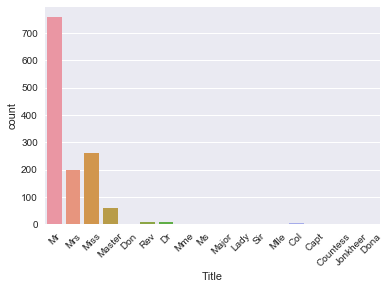
Nota che questa nuova colonna 'Title' è di fatto una nuova feature per il tuo dataset!
Consiglio: per saperne di più sulle espressioni regolari, leggi il mio resoconto del nostro ultimo evento FB Live code along oppure dai un’occhiata al tutorial sulle espressioni regolari in Python di DataCamp.
Nel grafico sopra vedi diversi titoli e molti compaiono raramente. Ha quindi senso raggrupparli in meno categorie.
Per esempio, probabilmente vorrai sostituire 'Mlle' e 'Ms' con 'Miss' e 'Mme' con 'Mrs', dato che sono titoli francesi e idealmente vuoi che tutti i dati siano in un’unica lingua. Poi prendi un insieme di titoli che non puoi categorizzare subito e li metti in un gruppo chiamato 'Special'.
Consiglio: sperimenta per vedere come cambia il rendimento dell’algoritmo al variare di queste scelte!
Successivamente, visualizza un barplot del risultato con il metodo .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
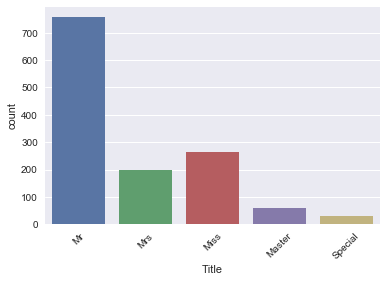
Ecco come appare la tua feature appena creata 'Title'!
Ora assicurati di avere la colonna 'Title' e ricontrolla i dati con il metodo .tail():
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Quando hai caricato e ispezionato i dati, hai visto che nella colonna 'Cabin' ci sono diversi NaN o valori mancanti.
È ragionevole presumere che quei NaN non avessero una cabina, il che potrebbe dirti qualcosa sulla 'Survival'. Creiamo quindi una nuova colonna 'Has_Cabin' che codifichi questa informazione e indichi se i passeggeri avevano una cabina oppure no.
Nota che nel blocco di codice qui sotto usi il metodo .isnull(), che restituisce True se il passeggero non ha una cabina e False altrimenti. Tuttavia, dato che vuoi salvare il risultato in una colonna 'Has_Cabin', vuoi invertire il risultato: vuoi True se il passeggero ha una cabina. Ecco perché usi la tilde ~.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Ora vuoi eliminare un po’ di colonne che non contengono più informazioni utili (o con cui non è chiaro come procedere). In questo caso stai guardando a colonne come ['Cabin', 'Name', 'PassengerId', 'Ticket'], perché
'Has_Cabin';'Name';'PassengerId' e 'Ticket' perché probabilmente non ti diranno nulla in più sulla sopravvivenza dei passeggeri del Titanic.Consiglio potrebbe esserci più informazione nella colonna 'Cabin', ma per questo tutorial supponiamo di no!
Per eliminare queste colonne dal tuo DataFrame data, usa l’argomento inplace del metodo .drop() impostandolo a True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Complimenti! Hai creato con successo nuove feature come 'Title' e 'Has_Cabin' e hai eliminato dal DataFrame le feature che non aggiungono informazioni utili al tuo modello!
Ora vuoi gestire i valori mancanti, effettuare il binning dei dati numerici e trasformare tutte le feature in variabili numeriche usando di nuovo .get_dummies(). Infine costruirai il modello finale per questo tutorial. Scopri come fare tutto ciò nelle prossime sezioni!
Con tutte le modifiche apportate al tuo DataFrame data originale, è una buona idea verificare se sono rimasti valori mancanti con .info():
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Il risultato indica che hai valori mancanti in 'Age', 'Fare' ed 'Embarked'.
Ricorda che puoi individuarlo facilmente guardando prima al numero totale di righe (1309) e poi al numero di valori non nulli nelle colonne elencate da .info(). In questo caso, vedi che 'Age' ha 1046 valori non nulli, quindi hai 263 mancanti. Allo stesso modo, 'Fare' ha un solo valore mancante e 'Embarked' ne ha due.
Come nel tutorial precedente, imputi questi valori mancanti con .fillna():
Nota che, ancora una volta, usi la mediana per riempire le colonne 'Age' e 'Fare' perché è perfetta per gestire gli outlier. Altri modi per imputare i mancanti sono la media, che ottieni sommando tutti i punti dati e dividendo per il loro numero, o la moda, che è il valore più frequente.
Riempi i due valori mancanti nella colonna 'Embarked' con 'S', che sta per Southampton, perché è il valore più comune tra quelli presenti in questa colonna.
Consiglio: puoi verificarlo con un po’ di analisi esplorativa!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Ora vuoi fare il binning dei dati numerici, perché hai un intervallo di età e di tariffe. Tuttavia, potrebbero esserci fluttuazioni in quei numeri che non riflettono pattern nei dati, ma solo rumore. Per questo metterai in uno stesso “cestino” le persone che rientrano in un certo intervallo di età o tariffa. Puoi farlo con la funzione di pandas qcut() per discretizzare i dati numerici:
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Nota che passi i dati come Series, data.Age e data.Fare, poi specifichi il numero di quantili, q=4. Infine imposti labels a False per codificare i bin come numeri.
Ora che hai discretizzato queste informazioni, puoi tranquillamente eliminare le colonne 'Age' e 'Fare'. Non dimenticare di controllare le prime cinque righe dei dati!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
La prossima cosa che puoi fare è creare una nuova colonna con il numero di membri della famiglia a bordo del Titanic. In questo tutorial non ci entreremo e vedremo come si comporta il modello senza. Se vuoi verificare come andrebbe il modello con questa colonna aggiuntiva, esegui la seguente riga di codice:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Per ora, andremo avanti ed elimineremo le colonne 'SibSp' e 'Parch' dal DataFrame:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Ora che hai creato altre feature, come 'Title' e 'Has_Cabin', gestito i valori mancanti e fatto il binning dei dati numerici, è il momento di trasformare tutte le variabili in numeriche. Lo fai perché in genere i modelli di machine learning accettano input numerici.
Come hai fatto in precedenza, userai .get_dummies() per farlo:
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Fatto tutto questo, è il momento di costruire il tuo modello finale!
Come prima, dividerai data nuovamente in train e test set. Poi li trasformerai in array:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Ora costruirai un albero di decisione sul tuo dataset appena ingegnerizzato. Per scegliere l’iperparametro max_depth, userai una variante del train/test split chiamata "cross validation".
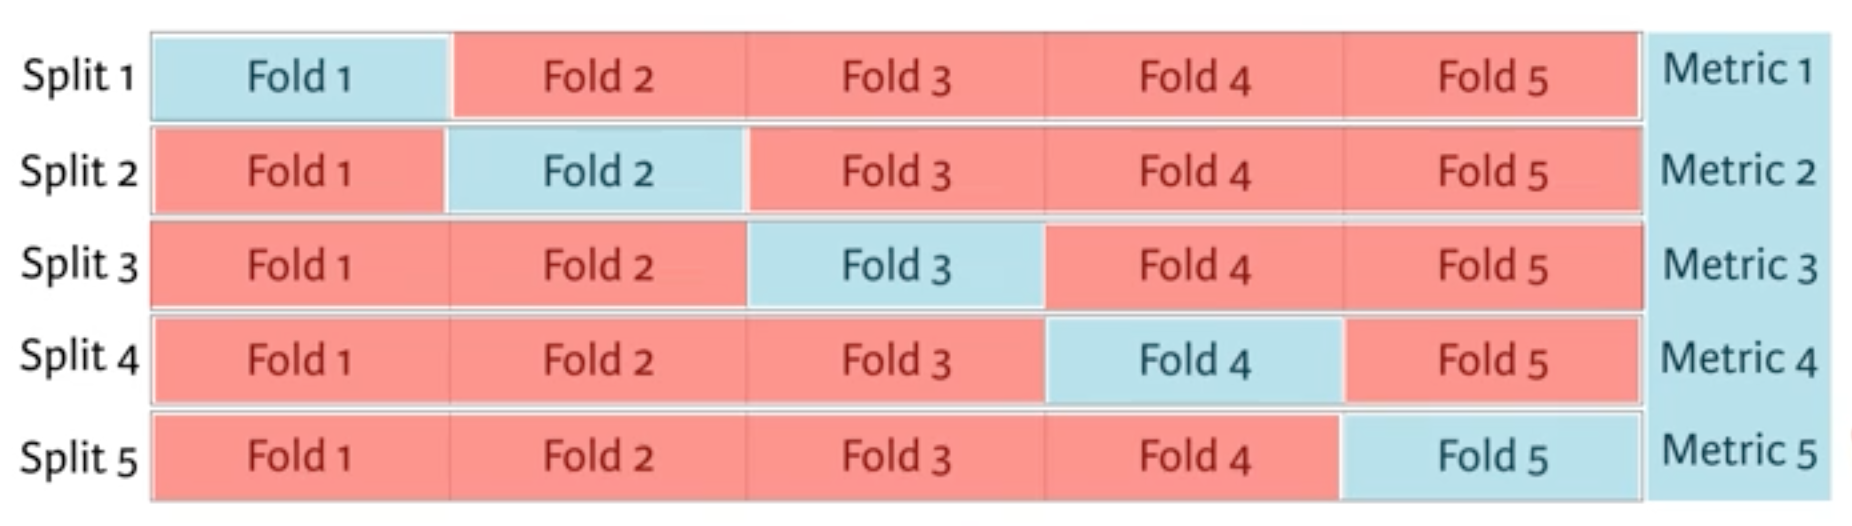
Inizi dividendo il dataset in 5 gruppi o fold. Poi metti da parte il primo fold come test set, addestri il modello sui restanti quattro fold, predici sul test set e calcoli la metrica di interesse. Successivamente metti da parte il secondo fold come test set, addestri sui rimanenti dati, predici sul test set e calcoli la metrica di interesse. E così via per il terzo, quarto e quinto.
Ottieni così cinque valori di accuratezza, dai quali puoi calcolare statistiche di interesse, come mediana e/o media e intervalli di confidenza al 95%.
Ripeti per ciascun valore di ogni iperparametro che stai ottimizzando e scegli il set di iperparametri con le migliori prestazioni. Questo si chiama grid search.
Basta teoria, andiamo al sodo!
Di seguito userai cross validation e grid search per scegliere il miglior max_depth per il tuo dataset ingegnerizzato:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Ora puoi fare previsioni sul tuo test set, creare una nuova colonna 'Survived' e salvarci le tue previsioni. Non dimenticare di salvare le colonne 'PassengerId' e 'Survived' di df_test in un file .csv e inviarlo a Kaggle!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
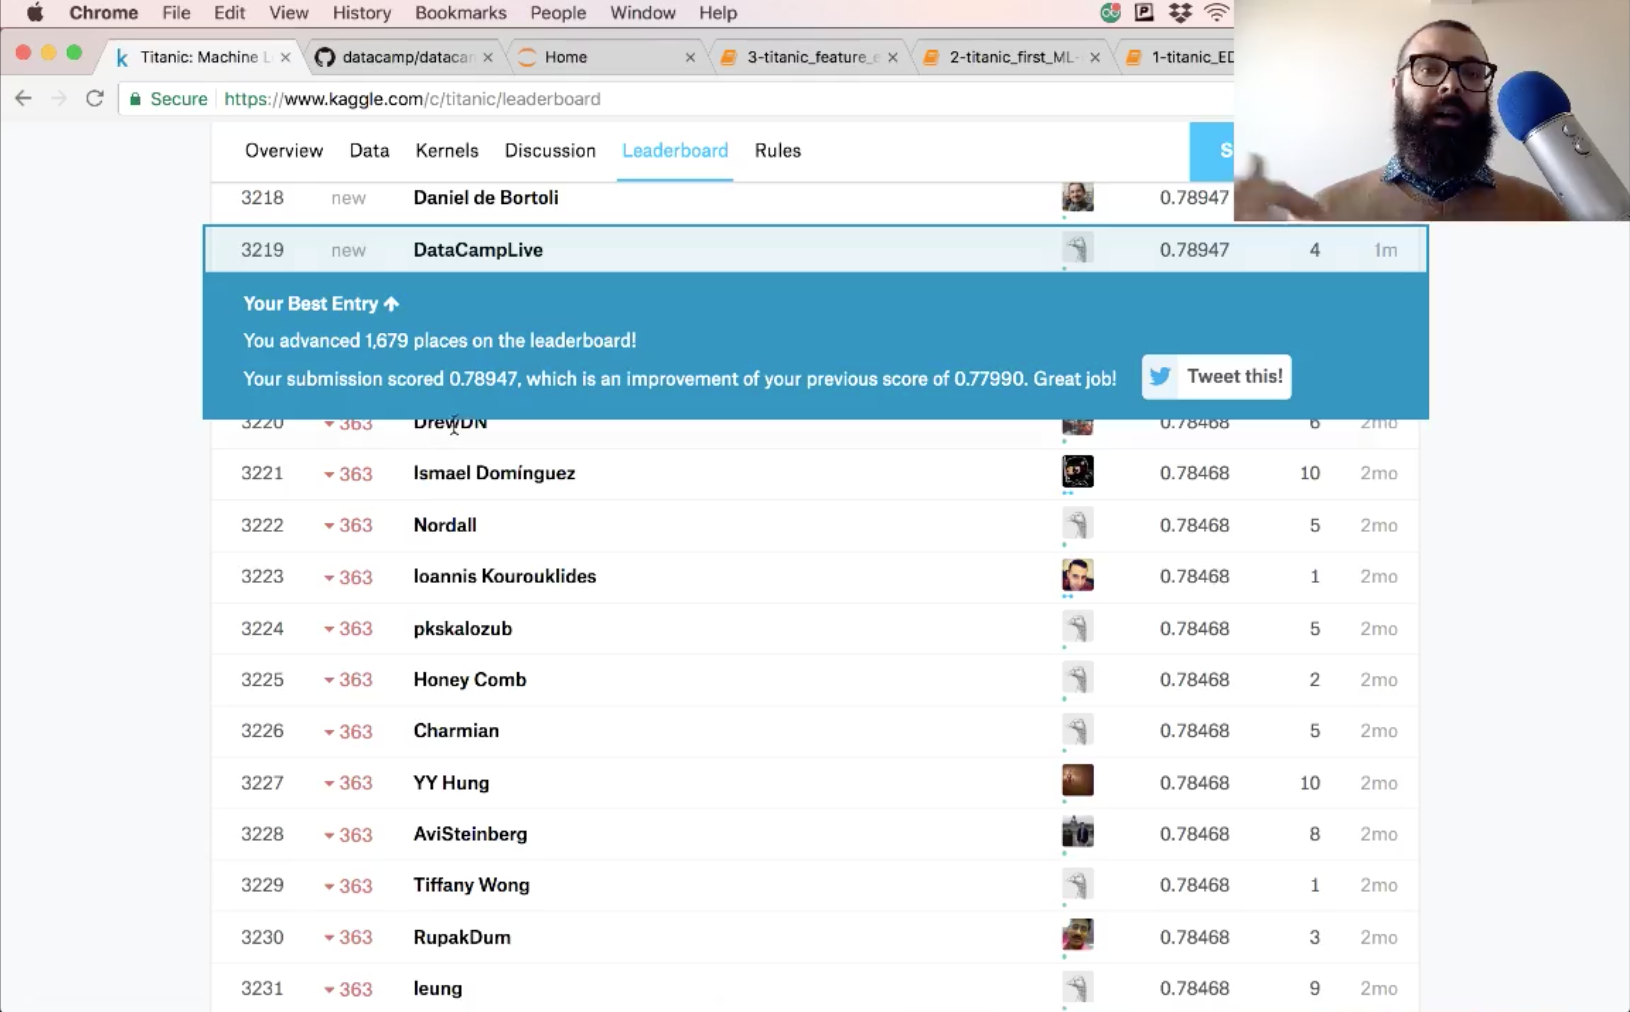
L’accuratezza della tua submission è 78,9.
Prova a fare altro feature engineering e sperimenta nuovi modelli per migliorare questo punteggio. Questo notebook, insieme ai due precedenti, è pubblicato su GitHub e sarebbe fantastico vedere i tuoi miglioramenti su questi modelli.
C’è molto altro preprocessing che vale la pena imparare, come lo scaling dei dati. Troverai anche le pipeline di scikit-learn molto utili. Dai un’occhiata al nostro corso Supervised Learning con scikit-learn e alla documentazione di scikit-learn per tutto questo e altro ancora.
Corsi di Machine Learning
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



