
Kursus
Fine-Tuning dengan Llama 3
2 jam
4.1K
MedGemma adalah koleksi varian Gemma 3 yang dirancang untuk unggul dalam pemahaman teks dan gambar medis. Koleksi ini saat ini mencakup dua varian yang kuat: versi multimodal 4B dan versi 27B hanya-teks.
Model MedGemma 4B menggabungkan SigLIP sebagai pengode gambar, yang dilatih awal pada beragam dataset medis terdeidentifikasi seperti rontgen dada, gambar dermatologi, gambar oftalmologi, dan slide histopatologi, dengan model bahasa besar (LLM) yang dilatih pada beragam data medis.
Dalam tutorial ini, kita akan mempelajari cara fine-tune model MedGemma 4B pada dataset MRI otak untuk tugas klasifikasi gambar. Tujuannya adalah menyesuaikan model MedGemma 4B yang lebih kecil agar efektif mengklasifikasikan pemindaian MRI otak dan memprediksi kanker otak dengan akurasi dan efisiensi yang lebih baik.
RunPod adalah platform yang sangat baik untuk menjalankan beban kerja berbasis GPU, menawarkan lingkungan prakonfigurasi dengan dukungan JupyterLab. Ini memungkinkan Anda meluncurkan pod dan langsung mulai ngoding menggunakan editor pilihan Anda. Berikut cara menyiapkan lingkungan Anda:
Masuk ke RunPod dan buat pod dengan GPU A100 dan image PyTorch terbaru. Lalu, klik tombol "Deploy On-Demand" untuk meluncurkan pod.
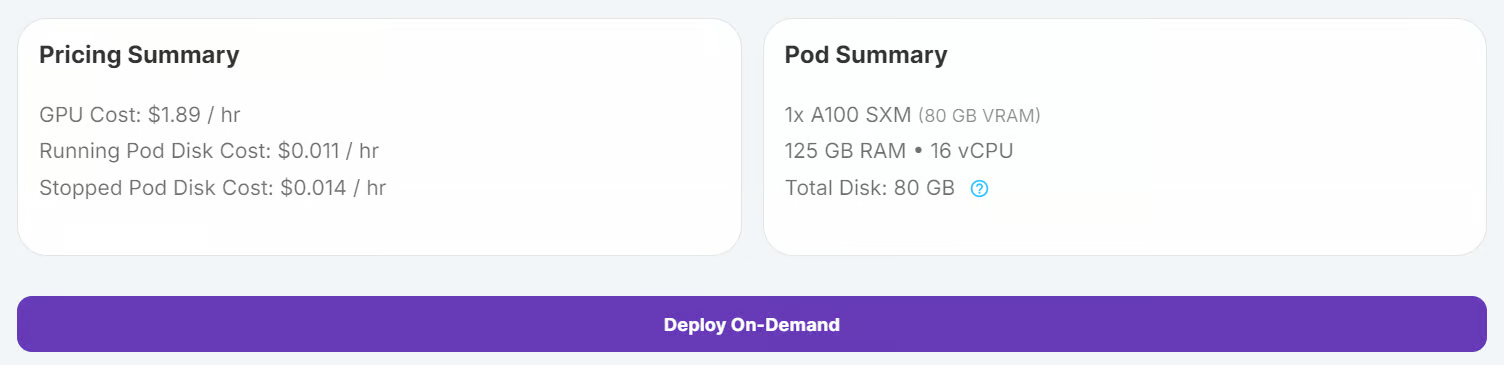
Edit pod dan tambahkan variabel lingkungan berikut untuk integrasi Hugging Face dan Kaggle:
Tingkatkan kapasitas penyimpanan menjadi 100GB untuk menampung dataset dan checkpoint model
Setelah pod berjalan, luncurkan instance JupyterLab dengan mengklik tombol "Connect". Buat notebook Python baru dan instal paket Python yang diperlukan dengan menjalankan perintah berikut:
! pip install --upgrade --quiet transformers bitsandbytes datasets evaluate peft trl scikit-learn kaggleKita akan menggunakan dataset MRI Brain Cancer dari Kaggle.
Unduh dan ekstrak dataset menggunakan Kaggle CLI:
!kaggle datasets download -d orvile/brain-cancer-mri-dataset --unzipDataset URL: https://www.kaggle.com/datasets/orvile/brain-cancer-mri-dataset
License(s): CC-BY-SA-4.0
Downloading brain-cancer-mri-dataset.zip to /workspace
90%|████████████████████████████████████▉ | 130M/144M [00:00<00:00, 231MB/s]
100%|█████████████████████████████████████████| 144M/144M [00:01<00:00, 108MB/s]Muat dataset sebagai dataset Hugging Face, bagi menjadi set pelatihan dan validasi, dan tampilkan strukturnya:
from datasets import load_dataset

data_dir = "./Brain_Cancer raw MRI data/Brain_Cancer"

# Define proportions for train and validation splits
train_size = 0.8
validation_size = 0.2


data = load_dataset("imagefolder", data_dir=data_dir, split="train")

# Split the dataset into train and validation sets
data = data.train_test_split(
    train_size=train_size,
    test_size=validation_size,
    shuffle=True,
    seed=42,
)

# Rename the 'test' split to 'validation'
data["validation"] = data.pop("test")

# Display dataset details
print(data)
Keluaran:
DatasetDict({
    train: Dataset({
        features: ['image', 'label'],
        num_rows: 4844
    })
    validation: Dataset({
        features: ['image', 'label'],
        num_rows: 1212
    })
})
Periksa gambar pertama dan label yang sesuai dari set pelatihan:
data["train"][0]["image"]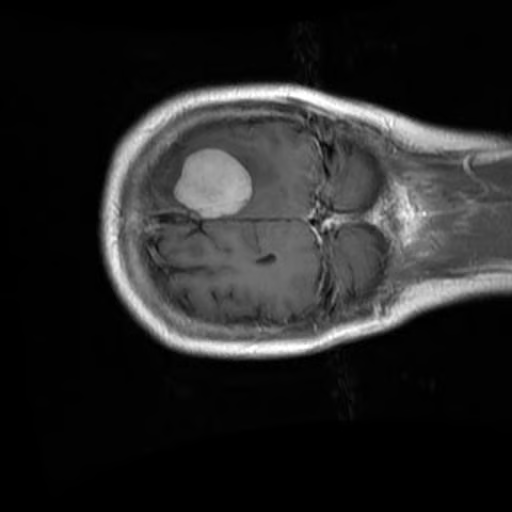
print(data["train"][0]["label"])1Sebelum memproses dataset, penting untuk terlebih dahulu memeriksa nama label guna memastikan penanganan tugas klasifikasi yang tepat.
BRAIN_CANCER_CLASSES = data["train"].features["label"].names
print("Detected classes:", BRAIN_CANCER_CLASSES)
Kelas yang terdeteksi adalah: ['brain_glioma', 'brain_menin', 'brain_tumor'].
Detected classes: ['brain_glioma', 'brain_menin', 'brain_tumor']Untuk meningkatkan proses klasifikasi, kita akan memodifikasi label kelas ini dengan menambahkan prefiks (A, B, C) agar lebih rapi dan selaras dengan format prompt khusus.
BRAIN_CANCER_CLASSES = ['A: brain glioma', 'B: brain menin', 'C: brain tumor']Selanjutnya, kita membuat prompt khusus yang akan digunakan untuk memandu model selama fine-tuning. Prompt ini mencakup label kelas yang telah diperbarui.
options = "\n".join(BRAIN_CANCER_CLASSES)
PROMPT = f"What is the most likely type of brain cancer shown in the MRI image?\n{options}"
Untuk menyiapkan dataset bagi fine-tuning, kita akan membuat kolom baru bernama "messages". Kolom ini akan berisi data terstruktur yang merepresentasikan kueri pengguna (prompt) dan respons asisten (label yang benar).
def format_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
        {
            "role": "assistant",
            "content": [
                {
                    "type": "text",
                    "text": BRAIN_CANCER_CLASSES[example["label"]],
                },
            ],
        },
    ]
    return example

# Apply the formatting to the dataset
formatted_data = data.map(format_data)
Untuk memverifikasi pemformatan, kita dapat memeriksa kolom message dari sampel pertama:
formatted_data["train"][0]["messages"]Titik data terformat yang dihasilkan terlihat seperti ini:
[{'content': [{'text': None, 'type': 'image'},
   {'text': 'What is the most likely type of brain cancer shown in the MRI image?\nA: brain glioma\nB: brain menin\nC: brain tumor',
    'type': 'text'}],
  'role': 'user'},
 {'content': [{'text': 'B: brain menin', 'type': 'text'}],
'role': 'assistant'}]Pada bagian ini, kita akan melakukan fine-tuning model MedGemma 4B Instruct pada dataset MRI Otak. Ini mencakup mengunduh model dan prosesor, menyiapkan adapter LoRA, mengonfigurasi trainer, dan memulai proses pelatihan.
Karena MedGemma adalah model berpagar akses, Anda perlu masuk ke Hugging Face CLI menggunakan kunci API Anda. Ini juga memungkinkan Anda menyimpan model yang sudah di-fine-tune ke Hugging Face Hub. Lihat kursus kami, Working with Hugging Face: Your Guide to the Hub, jika Anda membutuhkan penyegar ingatan.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)
Kita menggunakan pustaka Transformers untuk memuat model MedGemma 4B Instruct dan prosesornya. Model dikonfigurasi menggunakan presisi bfloat16 untuk komputasi yang efisien di GPU.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "google/medgemma-4b-it"

# Check if GPU supports bfloat16
if torch.cuda.get_device_capability()[0] < 8:
    raise ValueError("GPU does not support bfloat16, please use a GPU that supports bfloat16.")

model_kwargs = dict(
    attn_implementation="eager",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

# Use right padding to avoid issues during training
processor.tokenizer.padding_side = "right"Untuk melakukan fine-tuning model MedGemma 4B Instruct secara efisien, kita akan menggunakan Low-Rank Adaptation (LoRA), metode fine-tuning yang efisien parameter.
LoRA memungkinkan kita menyesuaikan model besar dengan hanya melatih sejumlah kecil parameter tambahan, secara signifikan mengurangi biaya komputasi sambil mempertahankan kinerja.
from peft import LoraConfig

peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.05,
    r=16,
    bias="none",
    target_modules="all-linear",
    task_type="CAUSAL_LM",
    modules_to_save=[
        "lm_head",
        "embed_tokens",
    ],
)
Untuk menangani masukan gambar dan teks selama pelatihan, kita mendefinisikan fungsi kolasi khusus. Fungsi ini memproses contoh dataset ke format yang sesuai untuk model, termasuk tokenisasi teks dan penyiapan data gambar.
def collate_fn(examples: list[dict[str, any]]):
    texts = []
    images = []
    for example in examples:
        images.append([example["image"]])
        texts.append(
            processor.apply_chat_template(
                example["messages"], add_generation_prompt=False, tokenize=False
            ).strip()
        )

    # Tokenize the texts and process the images
    batch = processor(text=texts, images=images, return_tensors="pt", padding=True)

    # The labels are the input_ids, with the padding and image tokens masked in
    # the loss computation
    labels = batch["input_ids"].clone()

    # Mask image tokens
    image_token_id = [
        processor.tokenizer.convert_tokens_to_ids(
            processor.tokenizer.special_tokens_map["boi_token"]
        )
    ]
    # Mask tokens that are not used in the loss computation
    labels[labels == processor.tokenizer.pad_token_id] = -100
    labels[labels == image_token_id] = -100
    labels[labels == 262144] = -100

    batch["labels"] = labels
    return batch
Kita menggunakan kelas SFTConfig dari pustaka trl untuk mendefinisikan argumen pelatihan. Argumen ini mengontrol proses fine-tuning, termasuk ukuran batch, laju pembelajaran, dan langkah akumulasi gradien.
from trl import SFTConfig

args = SFTConfig(
    output_dir="medgemma-brain-cancer",
    num_train_epochs=1,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=8,
    gradient_checkpointing=True,
    optim="adamw_torch_fused",
    logging_steps=0.1,
    save_strategy="epoch",
    eval_strategy="steps",
    eval_steps=0.1,
    learning_rate=2e-4,
    bf16=True,
    max_grad_norm=0.3,
    warmup_ratio=0.03,
    lr_scheduler_type="linear",
    push_to_hub=True,
    report_to="none",
    gradient_checkpointing_kwargs={"use_reentrant": False},
    dataset_kwargs={"skip_prepare_dataset": True},
    remove_unused_columns = False,
    label_names=["labels"],
)
SFTTrainer menyederhanakan proses fine-tuning dengan menggabungkan model, dataset, pengolah data, argumen pelatihan, dan konfigurasi LoRA ke dalam satu alur kerja. Ini membuat prosesnya lebih ringkas dan ramah pengguna.
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=formatted_data["train"],
    eval_dataset=formatted_data["validation"].shuffle().select(range(50)),
    peft_config=peft_config,
    processing_class=processor,
    data_collator=collate_fn,
)Setelah model, dataset, dan konfigurasi pelatihan siap, kita dapat memulai proses fine-tuning. SFTTrainer mempermudah langkah ini, memungkinkan kita melatih model dengan satu perintah saja:
trainer.train()Proses pelatihan memakan waktu sekitar 1 jam 8 menit hingga selesai. Selama waktu ini, loss pelatihan dan validasi menurun secara stabil di setiap langkah, menandakan bahwa model belajar dengan baik.
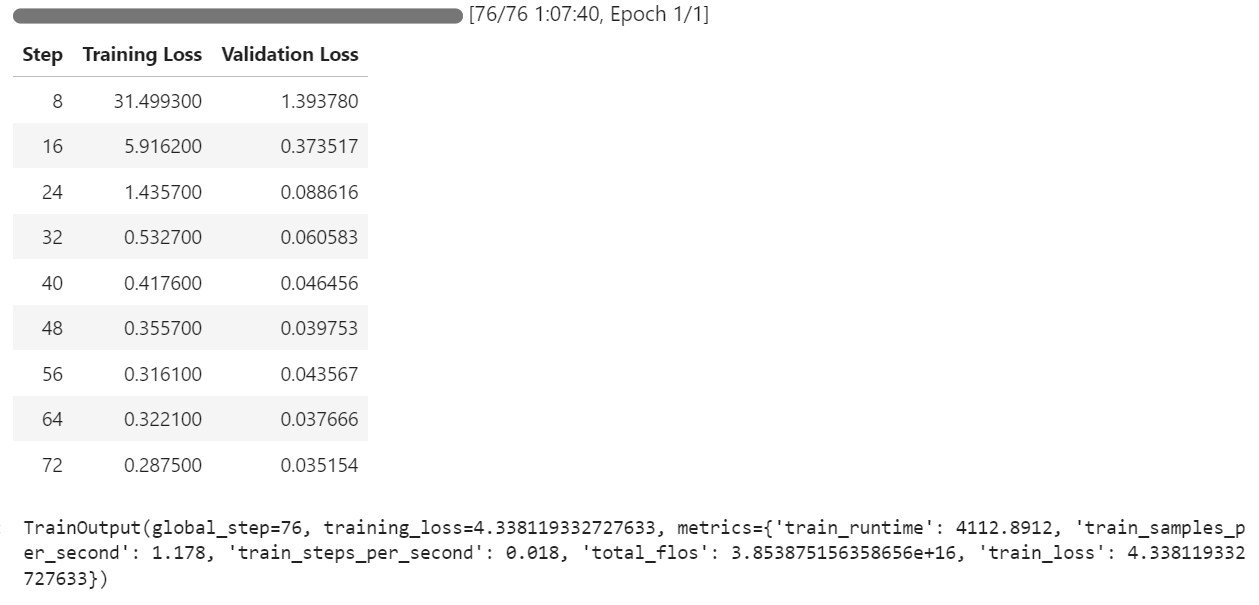
Setelah pelatihan selesai, model yang sudah di-fine-tune dapat disimpan secara lokal dan didorong ke Hugging Face Hub menggunakan metode save_model().
trainer.save_model()Model kini tersedia di kingabzpro/medgemma-brain-cancer · Hugging Face
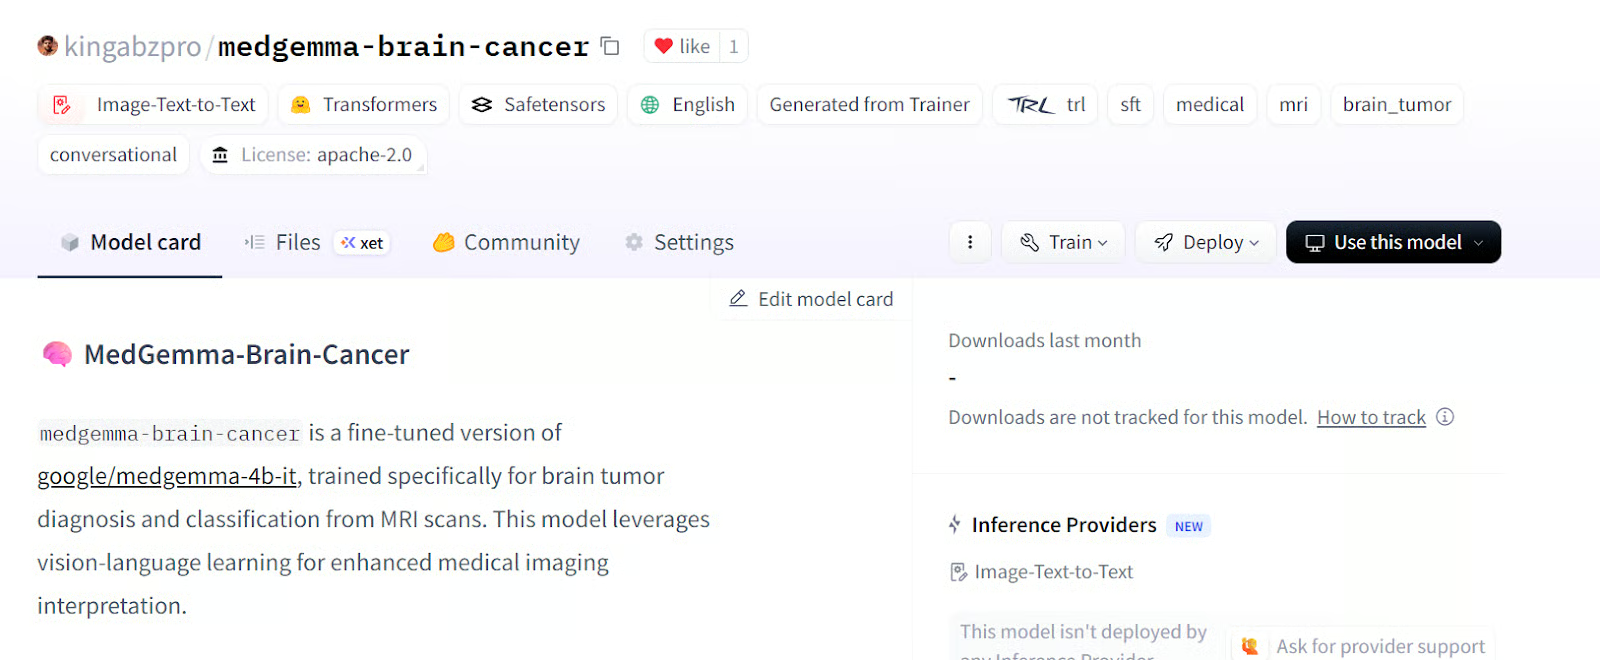
Sumber kingabzpro/medgemma-brain-cancer
Untuk mengevaluasi kinerja model MedGemma 4B, kita akan menguji model dasar dan model yang sudah di-fine-tune pada dataset validasi. Proses ini mencakup pembersihan memori, menyiapkan data uji, menghasilkan respons, dan menghitung metrik utama seperti akurasi dan skor F1.
Sebelum memulai evaluasi, kita menghapus setelan pelatihan untuk membebaskan memori GPU dan memastikan lingkungan yang bersih untuk pengujian
del model
del trainer
torch.cuda.empty_cache()Kita memformat dataset validasi agar sesuai dengan struktur masukan yang diperlukan model. Ini melibatkan pembuatan kolom "messages" yang berisi prompt pengguna untuk setiap contoh.
def format_test_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
    ]
    return example

test_data = data["validation"]
test_data = test_data.map(format_test_data)
Untuk mengevaluasi kinerja model, kita menggunakan pustaka evaluate, yang menyediakan metrik bawaan untuk tugas seperti klasifikasi. Setelah mengimpor pustaka dan memuat metrik yang diperlukan, kita mengekstrak label ground-truth dari dataset uji. Sebuah fungsi pembantu, compute_metrics, kemudian didefinisikan untuk menghitung akurasi dan skor F1 dengan membandingkan prediksi terhadap label tersebut.
import evaluate

accuracy_metric = evaluate.load("accuracy")
f1_metric = evaluate.load("f1")

# Ground-truth labels
REFERENCES = test_data["label"]


def compute_metrics(predictions: list[int]) -> dict[str, float]:
    metrics = {}
    metrics.update(
        accuracy_metric.compute(
            predictions=predictions,
            references=REFERENCES,
        )
    )
    metrics.update(
        f1_metric.compute(
            predictions=predictions,
            references=REFERENCES,
            average="weighted",
        )
    )
    return metrics
Untuk memastikan konsistensi dalam penanganan label, kita mengubah tipe kolom "label" dari dataset menjadi tipe ClassLabel. Ini memungkinkan pemetaan yang efisien antara indeks label dan nama yang sesuai. Selain itu, kita mendefinisikan pemetaan label alternatif untuk menangani variasi pemformatan label selama pascapemrosesan.
from datasets import ClassLabel

test_data = test_data.cast_column(
    "label",
    ClassLabel(names=BRAIN_CANCER_CLASSES)
)

LABEL_FEATURE = test_data.features["label"]

ALT_LABELS = dict([
    (label, f"({label.replace(': ', ') ')}") for label in BRAIN_CANCER_CLASSES
])
Untuk memetakan prediksi model ke label kelas yang benar, kita mendefinisikan fungsi postprocess. Fungsi ini memastikan prediksi dicocokkan ke label yang sesuai, memperhitungkan format label kanonik maupun alternatif.
def postprocess(prediction, do_full_match: bool = False) -> int:
    if isinstance(prediction, str):
        response_text = prediction
    else:
        response_text = prediction[0]["generated_text"]

    if do_full_match:
        return LABEL_FEATURE.str2int(response_text)

    for label in BRAIN_CANCER_CLASSES:
        # accept canonical or alternative wording
        if label in response_text or ALT_LABELS[label] in response_text:
            return LABEL_FEATURE.str2int(label)

return -1Untuk mengevaluasi kinerja model dasar, kita memuat model dan prosesor pralatih, mengonfigurasi pengaturan generasi, serta menyiapkan prompt dan gambar untuk pengujian.
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_kwargs = dict(
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(
    model_id, **model_kwargs
)

from transformers import GenerationConfig
gen_cfg = GenerationConfig.from_pretrained(model_id)
gen_cfg.update(
    do_sample          = False,
    top_k              = None,
    top_p              = None,
    cache_implementation = "dynamic"
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

def chat_to_prompt(chat_turns):
    return processor.apply_chat_template(
        chat_turns,
        add_generation_prompt=True,   # tells the model "your turn"
        tokenize=False                # we want raw text, not ids
    )

prompts = [chat_to_prompt(c) for c in test_data["messages"]]
images  = test_data["image"]                         # already a list of PIL images
assert len(prompts) == len(images), "1 prompt must match 1 image!"
Kita telah membuat fungsi batch_predict yang memproses dataset uji secara batch. Fungsi ini menghasilkan prediksi untuk setiap pasangan prompt-gambar dan menerapkan pascapemrosesan untuk memetakan keluaran ke label yang benar.
import torch
from typing import List, Any, Callable


def batch_predict(
    prompts,
    images,
    model,
    processor,
    postprocess,
    *,
    batch_size=64,
    device="cuda",
    dtype=torch.bfloat16,
    **gen_kwargs
):
    preds = []
    for i in range(0, len(prompts), batch_size):
        texts = prompts[i : i + batch_size]
        imgs = [[img] for img in images[i : i + batch_size]]
        enc = processor(text=texts, images=imgs, padding=True, return_tensors="pt").to(
            device, dtype=dtype
        )
        lens = enc["attention_mask"].sum(dim=1)
        with torch.inference_mode():
            out = model.generate(
                **enc,
                disable_compile=True,
                **gen_kwargs
            )
        for seq, ln in zip(out, lens):
            ans = processor.decode(seq[ln:], skip_special_tokens=True)
            preds.append(postprocess(ans))
    return preds
Kita akan menggunakan fungsi batch_predict untuk menghasilkan prediksi model dasar pada dataset uji. Prediksi kemudian dievaluasi menggunakan fungsi compute_metrics.
bf_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)


bf_metrics = compute_metrics(bf_preds)
print(f"Baseline metrics: {bf_metrics}")
Hasilnya tidak mengesankan. Kita mendapatkan akurasi 33%, yang cukup buruk.
Baseline metrics: {'accuracy': 0.33745874587458746, 'f1': 0.1737287617650654}Untuk lebih memahami perilaku model, kita dapat menghasilkan prediksi untuk satu contoh dari dataset. Ini melibatkan pembuatan fungsi pembantu untuk memproses masukan dan mengembalikan respons model.
Fungsi predict_one mengambil prompt dan gambar sebagai masukan, memprosesnya menggunakan prosesor model, dan menghasilkan respons. Fungsi ini memastikan keluaran model didekode menjadi teks yang dapat dibaca manusia.
import torch
from typing import Union, Dict, Any, List
from transformers import AutoModelForImageTextToText, AutoProcessor


def predict_one(
    prompt,
    image,
    model,
    processor,
    *,
    device="cuda",
    dtype=torch.bfloat16,
    disable_compile=True,
    **gen_kwargs
) -> str:
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(
        device, dtype=dtype
    )
    plen = inputs["input_ids"].shape[-1]
    with torch.inference_mode():
        ids = model.generate(
            **inputs,
            disable_compile=disable_compile,
            **gen_kwargs
        )
    return processor.decode(ids[0, plen:], skip_special_tokens=True)
Kita akan menggunakan predict_one untuk menghasilkan respons untuk sampel ke-11 dari dataset. Ini melibatkan menyiapkan prompt dan menjalankan fungsi prediksi.
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40
)

print("Model answer:", answer)
Hasilnya, kita menerima kalimat panjang yang menjelaskan mengapa brain glioma dipilih. Responsnya sepenuhnya salah, bahkan klasifikasinya keliru.
Model answer: Based on the MRI image, the most likely type of brain cancer is **A: brain glioma**.

Here's why:

* **Gliomas** are a common type of brain tumorUntuk mengevaluasi model yang sudah di-fine-tune, kita mengulangi proses evaluasi dengan memuat model dari direktori keluaran, menghasilkan prediksi, dan menghitung metrik.
Kita memuat model dan prosesor yang sudah di-fine-tune dari direktori keluaran, menjalankan fungsi batch_predict, dan menghitung metriknya.
model = AutoModelForImageTextToText.from_pretrained(
    args.output_dir, **model_kwargs
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

af_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)
af_metrics = compute_metrics(af_preds)
print(f"Fine-tuned metrics: {af_metrics}")
Hasil ini menunjukkan peningkatan signifikan dibanding model dasar, menyoroti efektivitas fine-tuning. Akurasi melonjak dari 33% menjadi 89% hanya dengan 1 epoch.
Fine-tuned metrics: {'accuracy': 0.8927392739273927, 'f1': 0.892641793935792}Untuk menganalisis lebih lanjut kinerja model yang sudah di-fine-tune, kita menghasilkan prediksi untuk satu contoh dari dataset uji.
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40              # any generate-kwargs you need
)

print("Model answer:", answer)
Model menghasilkan hasil dengan jelas dan tepat, dengan klasifikasi yang akurat dan terstruktur baik.
Model answer: C: brain tumorJika Anda mengalami kendala saat menjalankan kode di atas, silakan merujuk ke notebook pendamping: Fine_tuning_MedGemma.ipynb
MedGemma mewakili langkah maju yang signifikan dalam pemanfaatan AI untuk ilmu kedokteran. Dengan memberdayakan dokter untuk membuat pertimbangan yang lebih cepat dan akurat, model ini memungkinkan diagnosis yang lebih cepat dan rencana perawatan yang lebih efektif bagi pasien.
Fine-tuning model visi-bahasa seperti MedGemma 4B Instruct memungkinkan adaptabilitas di berbagai tugas medis, dari klasifikasi gambar hingga integrasi kemampuan penalaran.
Dalam tutorial ini, kita telah mempelajari cara melakukan fine-tuning model visi-bahasa pada dataset MRI Otak untuk klasifikasi kanker otak. Hasilnya luar biasa, dengan akurasi model meningkat dari 33% menjadi 89%, sebuah lompatan besar yang menyoroti potensi fine-tuning dalam aplikasi AI medis.
Jika Anda tertarik untuk mempelajari lebih lanjut, saya merekomendasikan sumber berikut:
Kursus Teratas di DataCamp
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



