
कोर्स
Llama 3 के साथ फाइन-ट्यूनिंग
2 घंटा
4.1K
MedGemma चिकित्सा पाठ और छवि समझ में उत्कृष्टता के लिए डिज़ाइन किए गए Gemma 3 वेरिएंट्स का एक संग्रह है। इस संग्रह में वर्तमान में दो शक्तिशाली वेरिएंट शामिल हैं: एक 4B मल्टीमॉडल संस्करण और एक 27B केवल-पाठ संस्करण।
MedGemma 4B मॉडल SigLIP इमेज एन्कोडर—जो छाती के एक्स-रे, त्वचा रोग, नेत्र-विज्ञान छवियाँ और हिस्टोपैथोलॉजी स्लाइड जैसी विविध, डी-आइडेंटिफाइड मेडिकल डेटासेट्स पर प्री-ट्रेंड है—को एक बड़े भाषा मॉडल (LLM) के साथ जोड़ता है, जिसे व्यापक चिकित्सा डेटा पर प्रशिक्षित किया गया है।
इस ट्यूटोरियल में, हम सीखेंगे कि ब्रेन MRI डेटासेट पर इमेज क्लासिफिकेशन कार्य के लिए MedGemma 4B मॉडल को कैसे फाइन-ट्यून किया जाए। उद्देश्य छोटे MedGemma 4B मॉडल को इस तरह अनुकूलित करना है कि वह ब्रेन MRI स्कैन को प्रभावी रूप से वर्गीकृत कर सके और ब्रेन कैंसर की भविष्यवाणी अधिक सटीकता और दक्षता के साथ कर सके।
RunPod GPU-आधारित वर्कलोड चलाने के लिए एक उत्कृष्ट प्लेटफ़ॉर्म है, जो JupyterLab सपोर्ट के साथ प्री-कॉन्फ़िगर्ड वातावरण प्रदान करता है। इससे आप एक पॉड लॉन्च कर सकते हैं और अपने पसंदीदा एडिटर से तुरंत कोडिंग शुरू कर सकते हैं। यहाँ बताया गया है कि अपना वातावरण कैसे सेट करें:
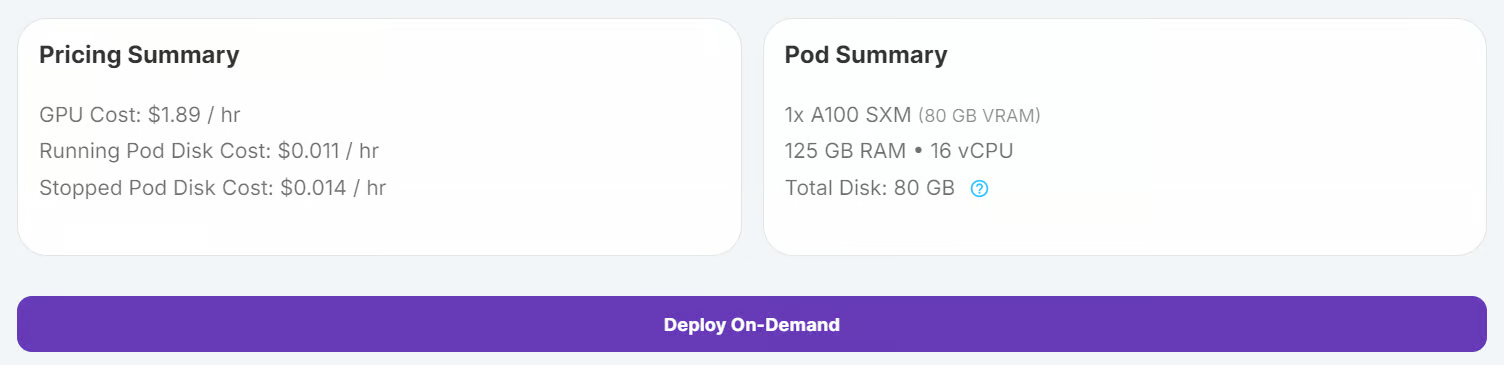
RunPod में लॉग इन करें और A100 GPU तथा नवीनतम PyTorch इमेज के साथ एक पॉड बनाएँ। फिर पॉड लॉन्च करने के लिए "Deploy On-Demand" बटन पर क्लिक करें।
पॉड को संपादित करें और Hugging Face तथा Kaggle इंटीग्रेशन के लिए निम्नलिखित environment variables जोड़ें:
डेटासेट्स और मॉडल चेकपॉइंट्स के लिए स्टोरेज क्षमता को 100GB तक बढ़ाएँ
पॉड चलने के बाद, "Connect" बटन पर क्लिक करके JupyterLab इंस्टेंस लॉन्च करें। एक नया Python नोटबुक बनाएँ और निम्न कमांड चलाकर आवश्यक Python पैकेज इंस्टॉल करें:
! pip install --upgrade --quiet transformers bitsandbytes datasets evaluate peft trl scikit-learn kaggleहम Kaggle से Brain Cancer MRI डेटासेट का उपयोग करेंगे।
Kaggle CLI का उपयोग करके डेटासेट डाउनलोड और अनज़िप करें:
!kaggle datasets download -d orvile/brain-cancer-mri-dataset --unzipDataset URL: https://www.kaggle.com/datasets/orvile/brain-cancer-mri-dataset
License(s): CC-BY-SA-4.0
Downloading brain-cancer-mri-dataset.zip to /workspace
90%|████████████████████████████████████▉ | 130M/144M [00:00<00:00, 231MB/s]
100%|█████████████████████████████████████████| 144M/144M [00:01<00:00, 108MB/s]डेटासेट को Hugging Face डेटासेट के रूप में लोड करें, उसे प्रशिक्षण और वैलिडेशन सेट में विभाजित करें, और उसकी संरचना दिखाएँ:
from datasets import load_dataset

data_dir = "./Brain_Cancer raw MRI data/Brain_Cancer"

# Define proportions for train and validation splits
train_size = 0.8
validation_size = 0.2


data = load_dataset("imagefolder", data_dir=data_dir, split="train")

# Split the dataset into train and validation sets
data = data.train_test_split(
    train_size=train_size,
    test_size=validation_size,
    shuffle=True,
    seed=42,
)

# Rename the 'test' split to 'validation'
data["validation"] = data.pop("test")

# Display dataset details
print(data)
आउटपुट:
DatasetDict({
    train: Dataset({
        features: ['image', 'label'],
        num_rows: 4844
    })
    validation: Dataset({
        features: ['image', 'label'],
        num_rows: 1212
    })
})
प्रशिक्षण सेट से पहली छवि और उसका लेबल जाँचें:
data["train"][0]["image"]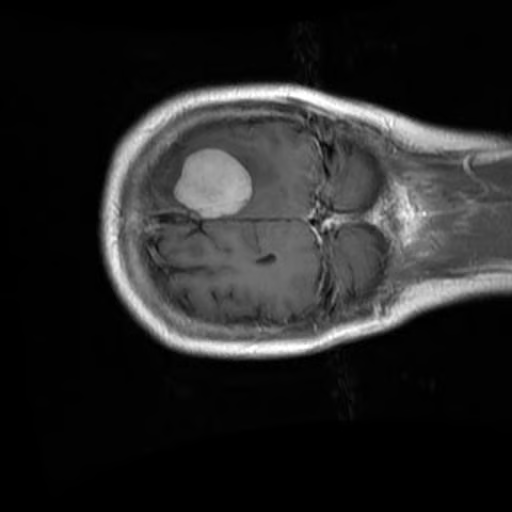
print(data["train"][0]["label"])1डेटासेट प्रोसेस करने से पहले, वर्गीकरण कार्य के उचित प्रबंधन के लिए लेबल के नामों की जाँच करना महत्वपूर्ण है।
BRAIN_CANCER_CLASSES = data["train"].features["label"].names
print("Detected classes:", BRAIN_CANCER_CLASSES)
पता लगाए गए क्लास हैं: ['brain_glioma', 'brain_menin', 'brain_tumor'].
Detected classes: ['brain_glioma', 'brain_menin', 'brain_tumor']वर्गीकरण प्रक्रिया को बेहतर बनाने के लिए, हम इन क्लास लेबल्स में प्रीफिक्स (A, B, C) जोड़कर संशोधित करेंगे, ताकि बेहतर संगठन हो और कस्टम प्रॉम्प्ट फ़ॉर्मेट के साथ संरेखण हो सके।
BRAIN_CANCER_CLASSES = ['A: brain glioma', 'B: brain menin', 'C: brain tumor']अगले चरण में, हम एक कस्टम प्रॉम्प्ट बनाएँगे जिसका उपयोग फाइन-ट्यूनिंग के दौरान मॉडल को निर्देशित करने के लिए किया जाएगा। प्रॉम्प्ट में अपडेटेड क्लास लेबल शामिल होंगे।
options = "\n".join(BRAIN_CANCER_CLASSES)
PROMPT = f"What is the most likely type of brain cancer shown in the MRI image?\n{options}"
फाइन-ट्यूनिंग के लिए डेटासेट तैयार करने हेतु, हम "messages" नाम का एक नया कॉलम बनाएँगे। इस कॉलम में यूज़र क्वेरी (प्रॉम्प्ट) और असिस्टेंट के उत्तर (सही लेबल) का संरचित डेटा होगा।
def format_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
        {
            "role": "assistant",
            "content": [
                {
                    "type": "text",
                    "text": BRAIN_CANCER_CLASSES[example["label"]],
                },
            ],
        },
    ]
    return example

# Apply the formatting to the dataset
formatted_data = data.map(format_data)
फ़ॉर्मैटिंग सत्यापित करने के लिए, हम पहले सैंपल के message कॉलम का निरीक्षण कर सकते हैं:
formatted_data["train"][0]["messages"]परिणामी फ़ॉर्मैटेड डेटा बिंदु इस प्रकार दिखता है:
[{'content': [{'text': None, 'type': 'image'},
   {'text': 'What is the most likely type of brain cancer shown in the MRI image?\nA: brain glioma\nB: brain menin\nC: brain tumor',
    'type': 'text'}],
  'role': 'user'},
 {'content': [{'text': 'B: brain menin', 'type': 'text'}],
'role': 'assistant'}]इस खंड में, हम MedGemma 4B Instruct मॉडल को ब्रेन MRI डेटासेट पर फाइन-ट्यून करेंगे। इसमें मॉडल और प्रोसेसर डाउनलोड करना, LoRA एडेप्टर सेट करना, ट्रेनर कॉन्फ़िगर करना, और ट्रेनिंग प्रक्रिया शुरू करना शामिल है।
क्योंकि MedGemma एक gated मॉडल है, आपको अपनी API कुंजी का उपयोग करके Hugging Face CLI में लॉग इन करना होगा। इससे आप अपने फाइन-ट्यून किए गए मॉडल को Hugging Face Hub पर सेव भी कर पाएँगे। यदि आपको पुनर्स्मरण चाहिए, तो हमारा कोर्स Working with Hugging Face: Your Guide to the Hub देखें।
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)
हम Transformers लाइब्रेरी का उपयोग करके MedGemma 4B Instruct मॉडल और उसके प्रोसेसर को लोड करेंगे। मॉडल को GPU पर कुशल गणना के लिए bfloat16 प्रिसीजन उपयोग करने हेतु कॉन्फ़िगर किया गया है।
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "google/medgemma-4b-it"

# Check if GPU supports bfloat16
if torch.cuda.get_device_capability()[0] < 8:
    raise ValueError("GPU does not support bfloat16, please use a GPU that supports bfloat16.")

model_kwargs = dict(
    attn_implementation="eager",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

# Use right padding to avoid issues during training
processor.tokenizer.padding_side = "right"MedGemma 4B Instruct मॉडल को कुशलतापूर्वक फाइन-ट्यून करने के लिए, हम Low-Rank Adaptation (LoRA) का उपयोग करेंगे, जो एक पैरामीटर-कुशल फाइन-ट्यूनिंग विधि है।
LoRA हमें केवल थोड़े अतिरिक्त पैरामीटर्स प्रशिक्षित करके बड़े मॉडलों को अनुकूलित करने देता है, जिससे गणनात्मक लागत में उल्लेखनीय कमी आती है और प्रदर्शन बना रहता है।
from peft import LoraConfig

peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.05,
    r=16,
    bias="none",
    target_modules="all-linear",
    task_type="CAUSAL_LM",
    modules_to_save=[
        "lm_head",
        "embed_tokens",
    ],
)
ट्रेनिंग के दौरान छवि और पाठ दोनों इनपुट सँभालने के लिए, हम एक कस्टम कोलेशन फ़ंक्शन परिभाषित करते हैं। यह फ़ंक्शन डेटासेट उदहारणों को ऐसे फ़ॉर्मैट में प्रोसेस करता है जो मॉडल के लिए उपयुक्त हो, जिसमें पाठ का टोकनाइज़ेशन और इमेज डेटा की तैयारी शामिल है।
def collate_fn(examples: list[dict[str, any]]):
    texts = []
    images = []
    for example in examples:
        images.append([example["image"]])
        texts.append(
            processor.apply_chat_template(
                example["messages"], add_generation_prompt=False, tokenize=False
            ).strip()
        )

    # Tokenize the texts and process the images
    batch = processor(text=texts, images=images, return_tensors="pt", padding=True)

    # The labels are the input_ids, with the padding and image tokens masked in
    # the loss computation
    labels = batch["input_ids"].clone()

    # Mask image tokens
    image_token_id = [
        processor.tokenizer.convert_tokens_to_ids(
            processor.tokenizer.special_tokens_map["boi_token"]
        )
    ]
    # Mask tokens that are not used in the loss computation
    labels[labels == processor.tokenizer.pad_token_id] = -100
    labels[labels == image_token_id] = -100
    labels[labels == 262144] = -100

    batch["labels"] = labels
    return batch
हम trl लाइब्रेरी की SFTConfig क्लास का उपयोग ट्रेनिंग आर्ग्युमेंट्स परिभाषित करने के लिए करते हैं। ये आर्ग्युमेंट्स फाइन-ट्यूनिंग प्रक्रिया को नियंत्रित करते हैं, जैसे बैच साइज, लर्निंग रेट, और ग्रेडिएंट एक्यूम्यूलेशन स्टेप्स।
from trl import SFTConfig

args = SFTConfig(
    output_dir="medgemma-brain-cancer",
    num_train_epochs=1,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=8,
    gradient_checkpointing=True,
    optim="adamw_torch_fused",
    logging_steps=0.1,
    save_strategy="epoch",
    eval_strategy="steps",
    eval_steps=0.1,
    learning_rate=2e-4,
    bf16=True,
    max_grad_norm=0.3,
    warmup_ratio=0.03,
    lr_scheduler_type="linear",
    push_to_hub=True,
    report_to="none",
    gradient_checkpointing_kwargs={"use_reentrant": False},
    dataset_kwargs={"skip_prepare_dataset": True},
    remove_unused_columns = False,
    label_names=["labels"],
)
SFTTrainer मॉडल, डेटासेट, डेटा कोलेटर, ट्रेनिंग आर्ग्युमेंट्स और LoRA कॉन्फ़िगरेशन को एक ही वर्कफ़्लो में जोड़कर फाइन-ट्यूनिंग प्रक्रिया को सरल बनाता है। इससे प्रक्रिया सुगम और उपयोगकर्ता-अनुकूल हो जाती है।
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=formatted_data["train"],
    eval_dataset=formatted_data["validation"].shuffle().select(range(50)),
    peft_config=peft_config,
    processing_class=processor,
    data_collator=collate_fn,
)जब मॉडल, डेटासेट और ट्रेनिंग कॉन्फ़िगुरेशंस तैयार हो जाएँ, तो हम फाइन-ट्यूनिंग प्रक्रिया शुरू कर सकते हैं। SFTTrainer इस चरण को सरल बनाता है, जिससे केवल एक कमांड से मॉडल ट्रेन हो जाता है:
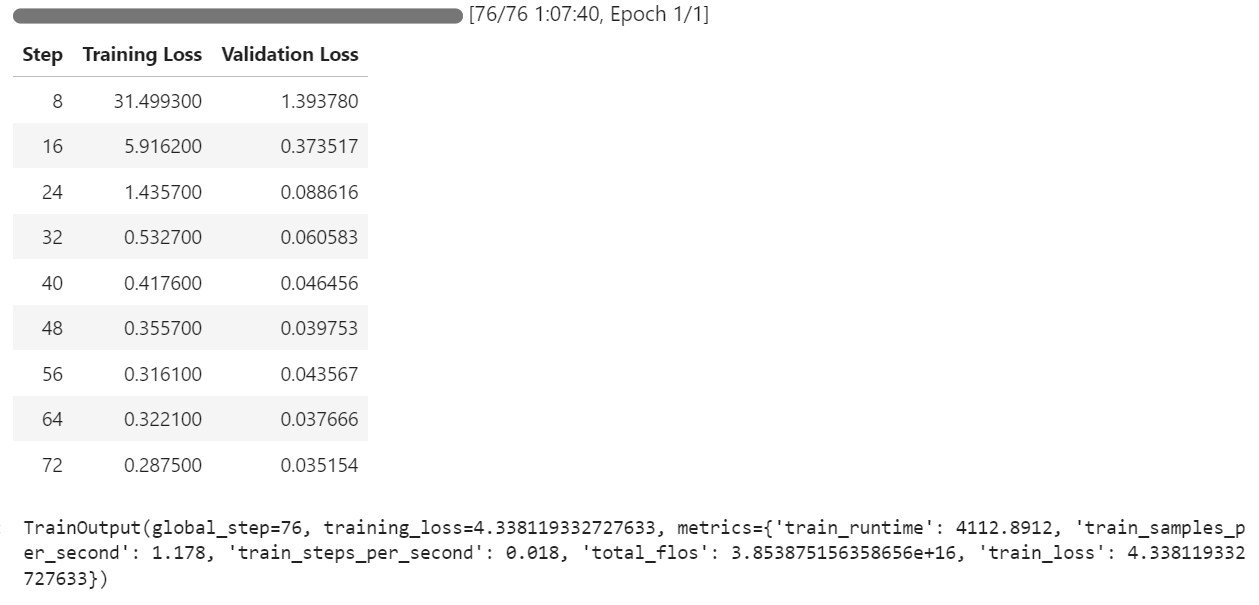
trainer.train()ट्रेनिंग प्रक्रिया को पूरा होने में लगभग 1 घंटा 8 मिनट लगे। इस दौरान, ट्रेनिंग लॉस और वैलिडेशन लॉस प्रत्येक स्टेप के साथ लगातार घटते गए, जो दर्शाता है कि मॉडल प्रभावी ढंग से सीख रहा था।
ट्रेनिंग पूरी होने के बाद, फाइन-ट्यून किया गया मॉडल लोकल रूप से सेव किया जा सकता है और save_model() मेथड का उपयोग कर Hugging Face Hub पर पुश किया जा सकता है।
trainer.save_model()मॉडल अब यहाँ उपलब्ध है kingabzpro/medgemma-brain-cancer · Hugging Face
स्रोत kingabzpro/medgemma-brain-cancer
MedGemma 4B मॉडल के प्रदर्शन का मूल्यांकन करने के लिए, हम वैलिडेशन डेटासेट पर बेस मॉडल और फाइन-ट्यून मॉडल दोनों का परीक्षण करेंगे। इस प्रक्रिया में मेमोरी साफ करना, टेस्ट डेटा तैयार करना, रिस्पॉन्स जनरेट करना, और accuracy तथा F1 स्कोर जैसे प्रमुख मेट्रिक्स की गणना शामिल है।
मूल्यांकन शुरू करने से पहले, हम ट्रेनिंग सेटअप हटाते हैं ताकि GPU मेमोरी खाली हो और टेस्टिंग के लिए स्वच्छ वातावरण सुनिश्चित हो
del model
del trainer
torch.cuda.empty_cache()हम वैलिडेशन डेटासेट को मॉडल द्वारा अपेक्षित इनपुट संरचना के अनुरूप फ़ॉर्मैट करते हैं। इसमें प्रत्येक उदाहरण के लिए यूज़र प्रॉम्प्ट वाला "messages" कॉलम बनाना शामिल है।
def format_test_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
    ]
    return example

test_data = data["validation"]
test_data = test_data.map(format_test_data)
मॉडल के प्रदर्शन का मूल्यांकन करने के लिए हम evaluate लाइब्रेरी का उपयोग करते हैं, जो वर्गीकरण जैसे कार्यों के लिए पूर्व-निर्मित मेट्रिक्स प्रदान करती है। लाइब्रेरी इम्पोर्ट करके और आवश्यक मेट्रिक्स लोड करने के बाद, हम टेस्ट डेटासेट से ग्राउंड-ट्रुथ लेबल निकालते हैं। एक हेल्पर फ़ंक्शन compute_metrics परिभाषित किया जाता है, जो भविष्यवाणियों की तुलना इन लेबल्स से करके accuracy और F1 स्कोर की गणना करता है।
import evaluate

accuracy_metric = evaluate.load("accuracy")
f1_metric = evaluate.load("f1")

# Ground-truth labels
REFERENCES = test_data["label"]


def compute_metrics(predictions: list[int]) -> dict[str, float]:
    metrics = {}
    metrics.update(
        accuracy_metric.compute(
            predictions=predictions,
            references=REFERENCES,
        )
    )
    metrics.update(
        f1_metric.compute(
            predictions=predictions,
            references=REFERENCES,
            average="weighted",
        )
    )
    return metrics
लेबल हैंडलिंग में एकरूपता सुनिश्चित करने के लिए, हम डेटासेट के "label" कॉलम को ClassLabel प्रकार में कास्ट करते हैं। इससे लेबल इंडेक्स और उनके नामों के बीच कुशल मैपिंग संभव होती है। साथ ही, पोस्ट-प्रोसेसिंग के दौरान लेबल फ़ॉर्मैटिंग में विविधताओं को सँभालने हेतु वैकल्पिक लेबल मैपिंग्स परिभाषित करते हैं।
from datasets import ClassLabel

test_data = test_data.cast_column(
    "label",
    ClassLabel(names=BRAIN_CANCER_CLASSES)
)

LABEL_FEATURE = test_data.features["label"]

ALT_LABELS = dict([
    (label, f"({label.replace(': ', ') ')}") for label in BRAIN_CANCER_CLASSES
])
मॉडल की भविष्यवाणियों को सही क्लास लेबल्स से मैप करने के लिए, हम postprocess फ़ंक्शन परिभाषित करते हैं। यह फ़ंक्शन सुनिश्चित करता है कि भविष्यवाणियाँ उपयुक्त लेबल से मेल खाएँ, और कैनॉनिकल तथा वैकल्पिक दोनों फ़ॉर्मैट्स को ध्यान में रखा जाए।
def postprocess(prediction, do_full_match: bool = False) -> int:
    if isinstance(prediction, str):
        response_text = prediction
    else:
        response_text = prediction[0]["generated_text"]

    if do_full_match:
        return LABEL_FEATURE.str2int(response_text)

    for label in BRAIN_CANCER_CLASSES:
        # accept canonical or alternative wording
        if label in response_text or ALT_LABELS[label] in response_text:
            return LABEL_FEATURE.str2int(label)

return -1बेस मॉडल के प्रदर्शन का मूल्यांकन करने के लिए, हम प्री-ट्रेंड मॉडल और प्रोसेसर लोड करते हैं, जेनरेशन सेटिंग्स कॉन्फ़िगर करते हैं, और टेस्टिंग के लिए प्रॉम्प्ट्स तथा इमेजेज तैयार करते हैं।
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_kwargs = dict(
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(
    model_id, **model_kwargs
)

from transformers import GenerationConfig
gen_cfg = GenerationConfig.from_pretrained(model_id)
gen_cfg.update(
    do_sample          = False,
    top_k              = None,
    top_p              = None,
    cache_implementation = "dynamic"
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

def chat_to_prompt(chat_turns):
    return processor.apply_chat_template(
        chat_turns,
        add_generation_prompt=True,   # tells the model "your turn"
        tokenize=False                # we want raw text, not ids
    )

prompts = [chat_to_prompt(c) for c in test_data["messages"]]
images  = test_data["image"]                         # already a list of PIL images
assert len(prompts) == len(images), "1 prompt must match 1 image!"
हमने एक batch_predict फ़ंक्शन बनाया है जो टेस्ट डेटासेट को बैच में प्रोसेस करता है। यह फ़ंक्शन प्रत्येक प्रॉम्प्ट-इमेज जोड़ी के लिए भविष्यवाणी जनरेट करता है और आउटपुट को सही लेबल्स से मैप करने के लिए पोस्ट-प्रोसेसिंग लागू करता है।
import torch
from typing import List, Any, Callable


def batch_predict(
    prompts,
    images,
    model,
    processor,
    postprocess,
    *,
    batch_size=64,
    device="cuda",
    dtype=torch.bfloat16,
    **gen_kwargs
):
    preds = []
    for i in range(0, len(prompts), batch_size):
        texts = prompts[i : i + batch_size]
        imgs = [[img] for img in images[i : i + batch_size]]
        enc = processor(text=texts, images=imgs, padding=True, return_tensors="pt").to(
            device, dtype=dtype
        )
        lens = enc["attention_mask"].sum(dim=1)
        with torch.inference_mode():
            out = model.generate(
                **enc,
                disable_compile=True,
                **gen_kwargs
            )
        for seq, ln in zip(out, lens):
            ans = processor.decode(seq[ln:], skip_special_tokens=True)
            preds.append(postprocess(ans))
    return preds
हम टेस्ट डेटासेट पर बेस मॉडल के लिए भविष्यवाणियाँ जनरेट करने हेतु batch_predict फ़ंक्शन का उपयोग करेंगे। इसके बाद, भविष्यवाणियों का मूल्यांकन compute_metrics फ़ंक्शन से किया जाएगा।
bf_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)


bf_metrics = compute_metrics(bf_preds)
print(f"Baseline metrics: {bf_metrics}")
परिणाम प्रभावशाली नहीं है। हमें 33% accuracy मिली, जो काफी कमजोर है।
Baseline metrics: {'accuracy': 0.33745874587458746, 'f1': 0.1737287617650654}मॉडल के व्यवहार को बेहतर समझने के लिए, हम डेटासेट से एकल उदाहरण के लिए भविष्यवाणी जनरेट कर सकते हैं। इसके लिए इनपुट प्रोसेस करने और मॉडल का उत्तर लौटाने हेतु एक हेल्पर फ़ंक्शन बनाते हैं।
predict_one फ़ंक्शन प्रॉम्प्ट और इमेज को इनपुट के रूप में लेकर मॉडल के प्रोसेसर से प्रोसेस करता है और एक रिस्पॉन्स जनरेट करता है। यह फ़ंक्शन सुनिश्चित करता है कि मॉडल का आउटपुट मानव-पठनीय टेक्स्ट में डिकोड हो।
import torch
from typing import Union, Dict, Any, List
from transformers import AutoModelForImageTextToText, AutoProcessor


def predict_one(
    prompt,
    image,
    model,
    processor,
    *,
    device="cuda",
    dtype=torch.bfloat16,
    disable_compile=True,
    **gen_kwargs
) -> str:
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(
        device, dtype=dtype
    )
    plen = inputs["input_ids"].shape[-1]
    with torch.inference_mode():
        ids = model.generate(
            **inputs,
            disable_compile=disable_compile,
            **gen_kwargs
        )
    return processor.decode(ids[0, plen:], skip_special_tokens=True)
हम डेटासेट के 11वें सैंपल के लिए predict_one का उपयोग करके उत्तर जनरेट करेंगे। इसमें प्रॉम्प्ट तैयार करना और प्रेडिक्शन फ़ंक्शन चलाना शामिल है।
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40
)

print("Model answer:", answer)
परिणामस्वरूप, हमें एक लंबा वाक्य मिला जिसमें बताया गया कि ब्रेन ग्लियोमा क्यों चुना गया। उत्तर पूरी तरह गलत है, वर्गीकरण भी गलत है।
Model answer: Based on the MRI image, the most likely type of brain cancer is **A: brain glioma**.

Here's why:

* **Gliomas** are a common type of brain tumorफाइन-ट्यून किए गए मॉडल का मूल्यांकन करने के लिए, हम आउटपुट डायरेक्टरी से मॉडल लोड करके, भविष्यवाणियाँ जनरेट करके और मेट्रिक्स की गणना करके प्रक्रिया को दोहराते हैं।
हम आउटपुट डायरेक्टरी से फाइन-ट्यून मॉडल और प्रोसेसर लोड करते हैं, batch_predict फ़ंक्शन चलाते हैं, और मेट्रिक्स की गणना करते हैं।
model = AutoModelForImageTextToText.from_pretrained(
    args.output_dir, **model_kwargs
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

af_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)
af_metrics = compute_metrics(af_preds)
print(f"Fine-tuned metrics: {af_metrics}")
ये परिणाम बेस मॉडल की तुलना में महत्वपूर्ण सुधार दर्शाते हैं, जो फाइन-ट्यूनिंग की प्रभावशीलता को रेखांकित करते हैं। केवल 1 epoch में accuracy 33% से बढ़कर 89% हो गई।
Fine-tuned metrics: {'accuracy': 0.8927392739273927, 'f1': 0.892641793935792}फाइन-ट्यून मॉडल के प्रदर्शन का और विश्लेषण करने के लिए, हम टेस्ट डेटासेट से एकल उदाहरण के लिए भविष्यवाणी जनरेट करते हैं।
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40              # any generate-kwargs you need
)

print("Model answer:", answer)
मॉडल ने परिणाम स्पष्ट और सटीक तरीके से दिया, जिसमें वर्गीकरण सही और सुव्यवस्थित था।
Model answer: C: brain tumorयदि आपको उपरोक्त कोड चलाने में समस्या आ रही है, तो कृपया सहायक नोटबुक देखें: Fine_tuning_MedGemma.ipynb
MedGemma चिकित्सा विज्ञान में AI के उपयोग में एक महत्वपूर्ण कदम का प्रतिनिधित्व करता है। डॉक्टरों और चिकित्सकों को तेज़ और अधिक सटीक निर्णय लेने में सक्षम बनाकर, यह तेज़ निदान और रोगियों के लिए अधिक प्रभावी उपचार योजनाएँ सुनिश्चित करता है।
MedGemma 4B Instruct जैसे विज़न-लैंग्वेज मॉडलों का फाइन-ट्यूनिंग, इमेज क्लासिफिकेशन से लेकर तर्क-क्षमताओं के एकीकरण तक, विविध चिकित्सा कार्यों में अनुकूलता प्रदान करता है।
इस ट्यूटोरियल में, हमने ब्रेन कैंसर वर्गीकरण के लिए ब्रेन MRI डेटासेट पर विज़न-लैंग्वेज मॉडल को फाइन-ट्यून करना सीखा। परिणाम उल्लेखनीय रहे—मॉडल की accuracy 33% से बढ़कर 89% हो गई—जो चिकित्सा AI अनुप्रयोगों में फाइन-ट्यूनिंग की क्षमता को दर्शाता है।
यदि आप और सीखने में रुचि रखते हैं, तो मैं निम्न संसाधन देखने की अनुशंसा करता/करती हूँ:
शीर्ष DataCamp कोर्स
कोर्स