
Last chance! 50% off DataCamp Premium
Sale ends in
MedGemma è una raccolta di varianti di Gemma 3 progettata per eccellere nella comprensione di testi e immagini in ambito medico. La raccolta include attualmente due potenti varianti: una versione multimodale 4B e una versione solo testo 27B.
Il modello MedGemma 4B combina l'encoder di immagini SigLIP, pre-addestrato su dataset medici eterogenei e de-identificati come radiografie del torace, immagini di dermatologia, immagini di oftalmologia e vetrini di istopatologia, con un large language model (LLM) addestrato su una vasta gamma di dati medici.
In questo tutorial impareremo a fare fine-tuning del modello MedGemma 4B su un dataset di risonanze magnetiche (MRI) cerebrali per un compito di classificazione di immagini. L'obiettivo è adattare il modello più piccolo, MedGemma 4B, per classificare efficacemente le scansioni MRI del cervello e prevedere il cancro al cervello con maggiore accuratezza ed efficienza.
RunPod è un'ottima piattaforma per eseguire carichi di lavoro su GPU, che offre ambienti preconfigurati con supporto a JupyterLab. Questo ti permette di avviare un pod e iniziare subito a scrivere codice con l'editor che preferisci. Ecco come configurare il tuo ambiente:
Accedi a RunPod e crea un pod con una GPU A100 e l'immagine PyTorch più recente. Quindi, fai clic sul pulsante "Deploy On-Demand" per avviare il pod.
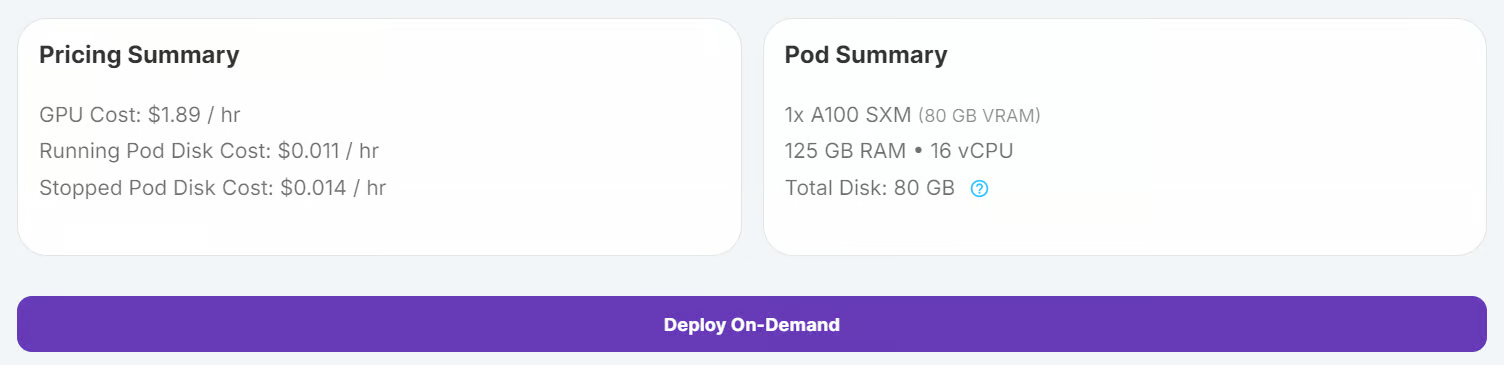
Modifica il pod e aggiungi le seguenti variabili d'ambiente per l'integrazione con Hugging Face e Kaggle:
Aumenta la capacità di archiviazione a 100 GB per accogliere dataset e checkpoint del modello
Una volta che il pod è in esecuzione, avvia l'istanza JupyterLab facendo clic sul pulsante "Connect". Crea un nuovo notebook Python e installa i pacchetti necessari eseguendo il seguente comando:
! pip install --upgrade --quiet transformers bitsandbytes datasets evaluate peft trl scikit-learn kaggleUseremo il dataset MRI Brain Cancer da Kaggle.
Scarica e decomprimi il dataset usando la CLI di Kaggle:
!kaggle datasets download -d orvile/brain-cancer-mri-dataset --unzipDataset URL: https://www.kaggle.com/datasets/orvile/brain-cancer-mri-dataset
License(s): CC-BY-SA-4.0
Downloading brain-cancer-mri-dataset.zip to /workspace
90%|████████████████████████████████████▉ | 130M/144M [00:00<00:00, 231MB/s]
100%|█████████████████████████████████████████| 144M/144M [00:01<00:00, 108MB/s]Carica il dataset come dataset di Hugging Face, dividilo in training e validation set e visualizzane la struttura:
from datasets import load_dataset

data_dir = "./Brain_Cancer raw MRI data/Brain_Cancer"

# Define proportions for train and validation splits
train_size = 0.8
validation_size = 0.2


data = load_dataset("imagefolder", data_dir=data_dir, split="train")

# Split the dataset into train and validation sets
data = data.train_test_split(
    train_size=train_size,
    test_size=validation_size,
    shuffle=True,
    seed=42,
)

# Rename the 'test' split to 'validation'
data["validation"] = data.pop("test")

# Display dataset details
print(data)
Output:
DatasetDict({
    train: Dataset({
        features: ['image', 'label'],
        num_rows: 4844
    })
    validation: Dataset({
        features: ['image', 'label'],
        num_rows: 1212
    })
})
Controlla la prima immagine e la relativa etichetta dal training set:
data["train"][0]["image"]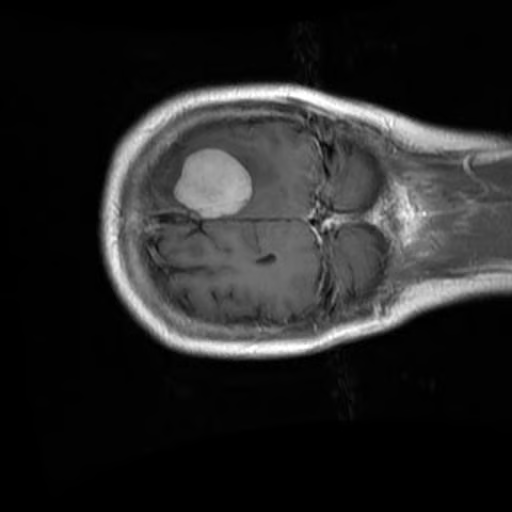
print(data["train"][0]["label"])1Prima di elaborare il dataset, è importante verificare i nomi delle etichette per gestire correttamente il task di classificazione.
BRAIN_CANCER_CLASSES = data["train"].features["label"].names
print("Detected classes:", BRAIN_CANCER_CLASSES)
Le classi rilevate sono: ['brain_glioma', 'brain_menin', 'brain_tumor'].
Detected classes: ['brain_glioma', 'brain_menin', 'brain_tumor']Per migliorare il processo di classificazione, modificheremo queste etichette aggiungendo un prefisso (A, B, C) per una migliore organizzazione e per allinearci a un prompt personalizzato.
BRAIN_CANCER_CLASSES = ['A: brain glioma', 'B: brain menin', 'C: brain tumor']Successivamente, creiamo un prompt personalizzato che verrà utilizzato per guidare il modello durante il fine-tuning. Il prompt include le etichette aggiornate.
options = "\n".join(BRAIN_CANCER_CLASSES)
PROMPT = f"What is the most likely type of brain cancer shown in the MRI image?\n{options}"
Per preparare il dataset al fine-tuning, creeremo una nuova colonna chiamata "messages". Questa colonna conterrà dati strutturati che rappresentano una richiesta dell'utente (il prompt) e la risposta dell'assistente (l'etichetta corretta).
def format_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
        {
            "role": "assistant",
            "content": [
                {
                    "type": "text",
                    "text": BRAIN_CANCER_CLASSES[example["label"]],
                },
            ],
        },
    ]
    return example

# Apply the formatting to the dataset
formatted_data = data.map(format_data)
Per verificare la formattazione, possiamo ispezionare la colonna dei messaggi dal primo campione:
formatted_data["train"][0]["messages"]Il dato formattato risultante appare così:
[{'content': [{'text': None, 'type': 'image'},
   {'text': 'What is the most likely type of brain cancer shown in the MRI image?\nA: brain glioma\nB: brain menin\nC: brain tumor',
    'type': 'text'}],
  'role': 'user'},
 {'content': [{'text': 'B: brain menin', 'type': 'text'}],
'role': 'assistant'}]In questa sezione effettueremo il fine-tuning del modello MedGemma 4B Instruct sul dataset MRI cerebrale. Ciò comporta il download del modello e del processor, la configurazione dell'adapter LoRA, la configurazione del trainer e l'avvio dell'addestramento.
Poiché MedGemma è un modello con accesso controllato, devi accedere alla CLI di Hugging Face usando la tua API key. Questo ti consente anche di salvare il modello fine-tunato su Hugging Face Hub. Dai un'occhiata al nostro corso Working with Hugging Face: Your Guide to the Hub, se ti serve un ripasso.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)
Usiamo la libreria Transformers per caricare il modello MedGemma 4B Instruct e il suo processor. Il modello è configurato per usare la precisione bfloat16 per un'elaborazione efficiente su GPU.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "google/medgemma-4b-it"

# Check if GPU supports bfloat16
if torch.cuda.get_device_capability()[0] < 8:
    raise ValueError("GPU does not support bfloat16, please use a GPU that supports bfloat16.")

model_kwargs = dict(
    attn_implementation="eager",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

# Use right padding to avoid issues during training
processor.tokenizer.padding_side = "right"Per effettuare in modo efficiente il fine-tuning del modello MedGemma 4B Instruct, useremo la Low-Rank Adaptation (LoRA), un metodo di fine-tuning efficiente in termini di parametri.
LoRA ci permette di adattare modelli di grandi dimensioni allenando solo un numero ridotto di parametri aggiuntivi, riducendo significativamente i costi computazionali mantenendo le prestazioni.
from peft import LoraConfig

peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.05,
    r=16,
    bias="none",
    target_modules="all-linear",
    task_type="CAUSAL_LM",
    modules_to_save=[
        "lm_head",
        "embed_tokens",
    ],
)
Per gestire sia input immagine sia testo durante l'addestramento, definiamo una funzione di collazione personalizzata. Questa funzione elabora gli esempi del dataset in un formato adatto al modello, includendo la tokenizzazione del testo e la preparazione dei dati immagine.
def collate_fn(examples: list[dict[str, any]]):
    texts = []
    images = []
    for example in examples:
        images.append([example["image"]])
        texts.append(
            processor.apply_chat_template(
                example["messages"], add_generation_prompt=False, tokenize=False
            ).strip()
        )

    # Tokenize the texts and process the images
    batch = processor(text=texts, images=images, return_tensors="pt", padding=True)

    # The labels are the input_ids, with the padding and image tokens masked in
    # the loss computation
    labels = batch["input_ids"].clone()

    # Mask image tokens
    image_token_id = [
        processor.tokenizer.convert_tokens_to_ids(
            processor.tokenizer.special_tokens_map["boi_token"]
        )
    ]
    # Mask tokens that are not used in the loss computation
    labels[labels == processor.tokenizer.pad_token_id] = -100
    labels[labels == image_token_id] = -100
    labels[labels == 262144] = -100

    batch["labels"] = labels
    return batch
Usiamo la classe SFTConfig della libreria trl per definire gli argomenti di training. Questi argomenti controllano il processo di fine-tuning, inclusi batch size, learning rate e i passaggi di accumulo del gradiente.
from trl import SFTConfig

args = SFTConfig(
    output_dir="medgemma-brain-cancer",
    num_train_epochs=1,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=8,
    gradient_checkpointing=True,
    optim="adamw_torch_fused",
    logging_steps=0.1,
    save_strategy="epoch",
    eval_strategy="steps",
    eval_steps=0.1,
    learning_rate=2e-4,
    bf16=True,
    max_grad_norm=0.3,
    warmup_ratio=0.03,
    lr_scheduler_type="linear",
    push_to_hub=True,
    report_to="none",
    gradient_checkpointing_kwargs={"use_reentrant": False},
    dataset_kwargs={"skip_prepare_dataset": True},
    remove_unused_columns = False,
    label_names=["labels"],
)L'SFTTrainer semplifica il processo di fine-tuning combinando modello, dataset, data collator, argomenti di training e configurazione LoRA in un unico flusso di lavoro. Questo rende il processo lineare e facile da usare.
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=formatted_data["train"],
    eval_dataset=formatted_data["validation"].shuffle().select(range(50)),
    peft_config=peft_config,
    processing_class=processor,
    data_collator=collate_fn,
)Una volta configurati modello, dataset e impostazioni di training, possiamo iniziare il processo di fine-tuning. L'SFTTrainer semplifica questo passaggio, permettendoci di addestrare il modello con un solo comando:
trainer.train()Il processo di training ha richiesto circa 1 ora e 8 minuti. Durante questo periodo, la training loss e la validation loss sono diminuite costantemente a ogni step, indicando che il modello stava apprendendo efficacemente.
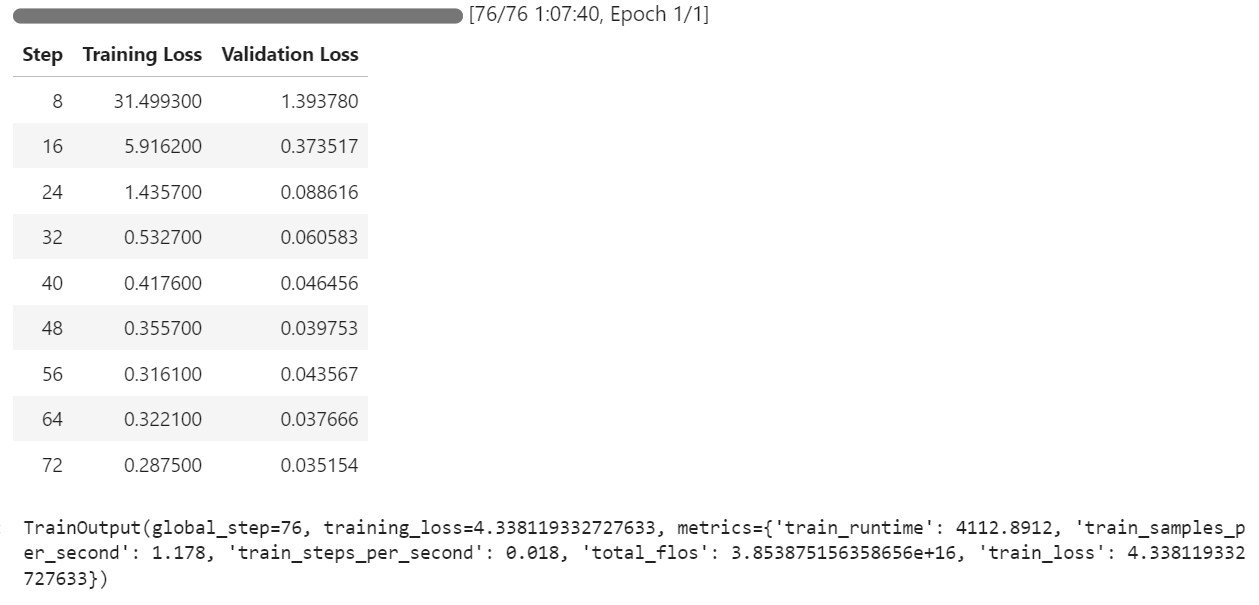
Al termine del training, il modello fine-tunato può essere salvato in locale e caricato su Hugging Face Hub usando il metodo save_model().
trainer.save_model()Il modello è ora disponibile su kingabzpro/medgemma-brain-cancer · Hugging Face
Fonte kingabzpro/medgemma-brain-cancer
Per valutare le prestazioni del modello MedGemma 4B, testeremo sia il modello base sia il modello fine-tunato sul dataset di validazione. Questo processo prevede la liberazione della memoria, la preparazione dei dati di test, la generazione delle risposte e il calcolo di metriche chiave come accuracy e F1 score.
Prima di iniziare la valutazione, rimuoviamo la configurazione di training per liberare memoria GPU e garantire un ambiente pulito per i test
del model
del trainer
torch.cuda.empty_cache()Formattiamo il dataset di validazione in modo che corrisponda alla struttura di input richiesta dal modello. Questo comporta la creazione di una colonna "messages" che contiene il prompt dell'utente per ogni esempio.
def format_test_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
    ]
    return example

test_data = data["validation"]
test_data = test_data.map(format_test_data)
Per valutare le prestazioni del modello, usiamo la libreria evaluate, che fornisce metriche predefinite per task come la classificazione. Dopo aver importato la libreria e caricato le metriche necessarie, estraiamo le etichette ground truth dal dataset di test. Una funzione di supporto, compute_metrics, viene quindi definita per calcolare accuracy e F1 score confrontando le previsioni con queste etichette.
import evaluate

accuracy_metric = evaluate.load("accuracy")
f1_metric = evaluate.load("f1")

# Ground-truth labels
REFERENCES = test_data["label"]


def compute_metrics(predictions: list[int]) -> dict[str, float]:
    metrics = {}
    metrics.update(
        accuracy_metric.compute(
            predictions=predictions,
            references=REFERENCES,
        )
    )
    metrics.update(
        f1_metric.compute(
            predictions=predictions,
            references=REFERENCES,
            average="weighted",
        )
    )
    return metrics
Per garantire coerenza nella gestione delle etichette, convertiamo la colonna "label" del dataset nel tipo ClassLabel. Questo consente un mapping efficiente tra indici delle etichette e relativi nomi. Inoltre, definiamo mapping alternativi delle etichette per gestire variazioni di formattazione durante il post-processing.
from datasets import ClassLabel

test_data = test_data.cast_column(
    "label",
    ClassLabel(names=BRAIN_CANCER_CLASSES)
)

LABEL_FEATURE = test_data.features["label"]

ALT_LABELS = dict([
    (label, f"({label.replace(': ', ') ')}") for label in BRAIN_CANCER_CLASSES
])
Per mappare le previsioni del modello alle etichette corrette, definiamo una funzione postprocess. Questa funzione assicura che le previsioni vengano associate all'etichetta appropriata, tenendo conto sia dei formati canonici sia di quelli alternativi.
def postprocess(prediction, do_full_match: bool = False) -> int:
    if isinstance(prediction, str):
        response_text = prediction
    else:
        response_text = prediction[0]["generated_text"]

    if do_full_match:
        return LABEL_FEATURE.str2int(response_text)

    for label in BRAIN_CANCER_CLASSES:
        # accept canonical or alternative wording
        if label in response_text or ALT_LABELS[label] in response_text:
            return LABEL_FEATURE.str2int(label)

return -1Per valutare le prestazioni del modello base, carichiamo il modello e il processor pre-addestrati, configuriamo le impostazioni di generazione e prepariamo prompt e immagini per il test.
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_kwargs = dict(
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(
    model_id, **model_kwargs
)

from transformers import GenerationConfig
gen_cfg = GenerationConfig.from_pretrained(model_id)
gen_cfg.update(
    do_sample          = False,
    top_k              = None,
    top_p              = None,
    cache_implementation = "dynamic"
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

def chat_to_prompt(chat_turns):
    return processor.apply_chat_template(
        chat_turns,
        add_generation_prompt=True,   # tells the model "your turn"
        tokenize=False                # we want raw text, not ids
    )

prompts = [chat_to_prompt(c) for c in test_data["messages"]]
images  = test_data["image"]                         # already a list of PIL images
assert len(prompts) == len(images), "1 prompt must match 1 image!"
Abbiamo creato una funzione batch_predict che elabora il dataset di test in batch. Questa funzione genera previsioni per ciascuna coppia prompt-immagine e applica il post-processing per mappare gli output alle etichette corrette.
import torch
from typing import List, Any, Callable


def batch_predict(
    prompts,
    images,
    model,
    processor,
    postprocess,
    *,
    batch_size=64,
    device="cuda",
    dtype=torch.bfloat16,
    **gen_kwargs
):
    preds = []
    for i in range(0, len(prompts), batch_size):
        texts = prompts[i : i + batch_size]
        imgs = [[img] for img in images[i : i + batch_size]]
        enc = processor(text=texts, images=imgs, padding=True, return_tensors="pt").to(
            device, dtype=dtype
        )
        lens = enc["attention_mask"].sum(dim=1)
        with torch.inference_mode():
            out = model.generate(
                **enc,
                disable_compile=True,
                **gen_kwargs
            )
        for seq, ln in zip(out, lens):
            ans = processor.decode(seq[ln:], skip_special_tokens=True)
            preds.append(postprocess(ans))
    return preds
Useremo la funzione batch_predict per generare previsioni con il modello base sul dataset di test. Le previsioni vengono poi valutate usando la funzione compute_metrics.
bf_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)


bf_metrics = compute_metrics(bf_preds)
print(f"Baseline metrics: {bf_metrics}")
Il risultato non è entusiasmante. Abbiamo ottenuto un'accuratezza del 33%, decisamente bassa.
Baseline metrics: {'accuracy': 0.33745874587458746, 'f1': 0.1737287617650654}Per comprendere meglio il comportamento del modello, possiamo generare previsioni per un singolo esempio del dataset. Questo comporta la creazione di una funzione di supporto per elaborare l'input e restituire la risposta del modello.
La funzione predict_one prende in input un prompt e un'immagine, li elabora con il processor del modello e genera una risposta. La funzione garantisce che l'output del modello venga decodificato in testo leggibile.
import torch
from typing import Union, Dict, Any, List
from transformers import AutoModelForImageTextToText, AutoProcessor


def predict_one(
    prompt,
    image,
    model,
    processor,
    *,
    device="cuda",
    dtype=torch.bfloat16,
    disable_compile=True,
    **gen_kwargs
) -> str:
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(
        device, dtype=dtype
    )
    plen = inputs["input_ids"].shape[-1]
    with torch.inference_mode():
        ids = model.generate(
            **inputs,
            disable_compile=disable_compile,
            **gen_kwargs
        )
    return processor.decode(ids[0, plen:], skip_special_tokens=True)
Useremo predict_one per generare una risposta per l'undicesimo campione del dataset. Questo comporta la preparazione del prompt e l'esecuzione della funzione di previsione.
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40
)

print("Model answer:", answer)
Di conseguenza, abbiamo ricevuto una frase lunga che spiega perché è stato scelto il glioma cerebrale. La risposta è completamente sbagliata, anche la classificazione è errata.
Model answer: Based on the MRI image, the most likely type of brain cancer is **A: brain glioma**.

Here's why:

* **Gliomas** are a common type of brain tumorPer valutare il modello fine-tunato, ripetiamo il processo di valutazione caricando il modello dalla cartella di output, generando le previsioni e calcolando le metriche.
Carichiamo il modello e il processor fine-tunati dalla cartella di output, eseguiamo la funzione batch_predict e calcoliamo le metriche.
model = AutoModelForImageTextToText.from_pretrained(
    args.output_dir, **model_kwargs
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

af_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)
af_metrics = compute_metrics(af_preds)
print(f"Fine-tuned metrics: {af_metrics}")
Questi risultati mostrano un miglioramento significativo rispetto al modello base, evidenziando l'efficacia del fine-tuning. L'accuratezza è passata dal 33% all'89% con una sola epoca.
Fine-tuned metrics: {'accuracy': 0.8927392739273927, 'f1': 0.892641793935792}Per analizzare ulteriormente le prestazioni del modello fine-tunato, generiamo una previsione per un singolo esempio dal dataset di test.
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40              # any generate-kwargs you need
)

print("Model answer:", answer)
Il modello ha prodotto il risultato in modo chiaro e preciso, con una classificazione corretta e ben strutturata.
Model answer: C: brain tumorSe riscontri problemi nell'eseguire il codice sopra, fai riferimento al notebook di accompagnamento: Fine_tuning_MedGemma.ipynb
MedGemma rappresenta un passo avanti significativo nell'uso dell'IA per le scienze mediche. Consentendo a medici e specialisti di prendere decisioni più rapide e accurate, permette diagnosi più tempestive e piani di trattamento più efficaci per i pazienti.
Il fine-tuning di modelli vision-language come MedGemma 4B Instruct permette adattabilità in diversi compiti medici, dalla classificazione di immagini all'integrazione di capacità di ragionamento.
In questo tutorial abbiamo visto come effettuare il fine-tuning di un modello vision-language su un dataset di MRI cerebrali per la classificazione del cancro al cervello. I risultati sono stati notevoli: l'accuratezza del modello è passata dal 33% all'89%, un balzo sostanziale che evidenzia il potenziale del fine-tuning nelle applicazioni di IA in ambito medico.
Se vuoi approfondire, ti consiglio di dare un'occhiata a queste risorse:
I migliori corsi DataCamp
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




