
Cursus
Fijn-afstemmen met Llama 3
2 uur
4.1K
MedGemma is een collectie van Gemma 3-varianten die uitblinken in het begrijpen van medische tekst en afbeeldingen. De collectie bevat momenteel twee krachtige varianten: een 4B multimodale versie en een 27B tekst-only versie.
Het MedGemma 4B-model combineert de SigLIP image encoder, voorgetraind op diverse, geanonimiseerde medische datasets zoals borstkasröntgens, dermatologische, oftalmologische en histopathologie-afbeeldingen, met een groot taalmodel (LLM) getraind op een uitgebreid scala aan medische data.
In deze tutorial leren we hoe je het fijn afstemt op een hersen-MRI-dataset voor een beeldclassificatietaak. Het doel is om het kleinere MedGemma 4B-model te laten uitgroeien tot een effectieve classifier voor hersen-MRI’s en hersenkanker nauwkeuriger en efficiënter te voorspellen.
RunPod is een uitstekend platform voor GPU-workloads, met vooraf geconfigureerde omgevingen en JupyterLab-ondersteuning. Zo kun je een pod starten en meteen beginnen met coderen in je favoriete editor. Zo stel je je omgeving in:
Log in op RunPod en maak een pod met een A100-GPU en de nieuwste PyTorch-image. Klik vervolgens op de knop "Deploy On-Demand" om de pod te starten.
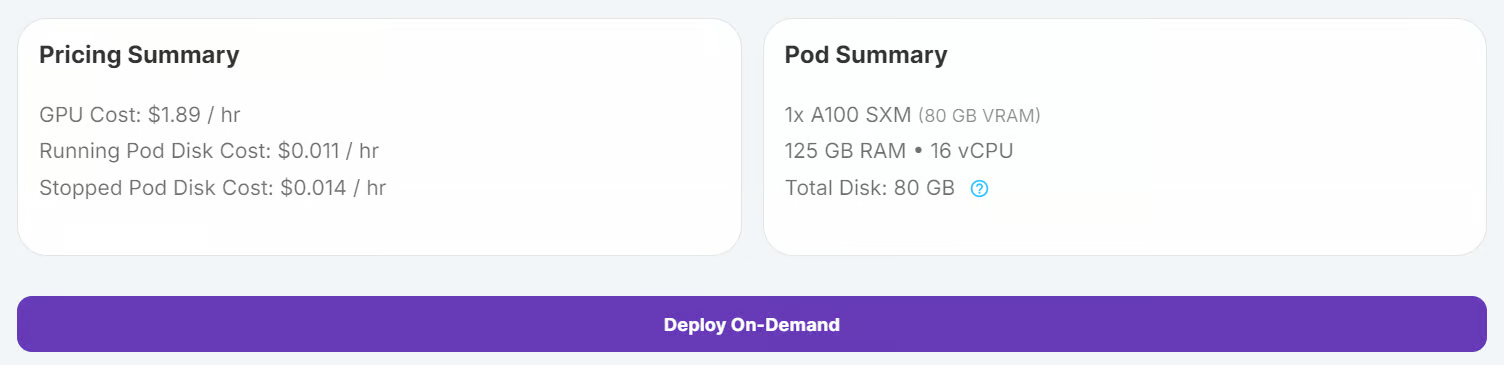
Bewerk de pod en voeg de volgende omgevingsvariabelen toe voor integratie met Hugging Face en Kaggle:
Vergroot de opslagcapaciteit naar 100GB om datasets en modelcheckpoints te kunnen opslaan
Zodra de pod draait, start je de JupyterLab-instantie via de knop "Connect". Maak een nieuw Python-notebook en installeer de vereiste Python-pakketten met het volgende commando:
! pip install --upgrade --quiet transformers bitsandbytes datasets evaluate peft trl scikit-learn kaggleWe gebruiken de Brain Cancer MRI-dataset van Kaggle.
Download en unzip de dataset met de Kaggle CLI:
!kaggle datasets download -d orvile/brain-cancer-mri-dataset --unzipDataset URL: https://www.kaggle.com/datasets/orvile/brain-cancer-mri-dataset
License(s): CC-BY-SA-4.0
Downloading brain-cancer-mri-dataset.zip to /workspace
90%|████████████████████████████████████▉ | 130M/144M [00:00<00:00, 231MB/s]
100%|█████████████████████████████████████████| 144M/144M [00:01<00:00, 108MB/s]Laad de dataset als een Hugging Face-dataset, splits deze in trainings- en validatiesets en toon de structuur:
from datasets import load_dataset

data_dir = "./Brain_Cancer raw MRI data/Brain_Cancer"

# Define proportions for train and validation splits
train_size = 0.8
validation_size = 0.2


data = load_dataset("imagefolder", data_dir=data_dir, split="train")

# Split the dataset into train and validation sets
data = data.train_test_split(
    train_size=train_size,
    test_size=validation_size,
    shuffle=True,
    seed=42,
)

# Rename the 'test' split to 'validation'
data["validation"] = data.pop("test")

# Display dataset details
print(data)
Uitvoer:
DatasetDict({
    train: Dataset({
        features: ['image', 'label'],
        num_rows: 4844
    })
    validation: Dataset({
        features: ['image', 'label'],
        num_rows: 1212
    })
})
Bekijk de eerste afbeelding en het bijbehorende label uit de trainingsset:
data["train"][0]["image"]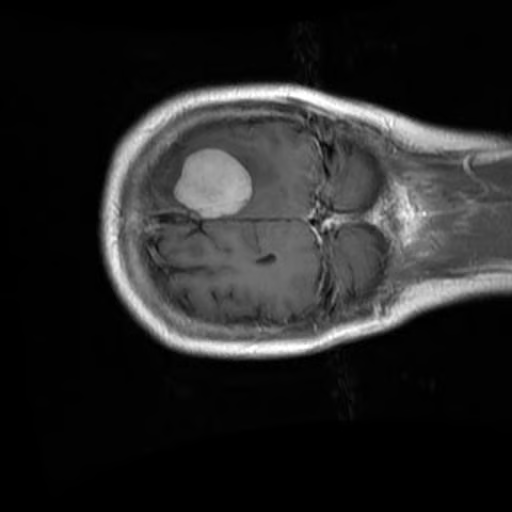
print(data["train"][0]["label"])1Voordat we de dataset verwerken, is het belangrijk om eerst de namen van de labels te controleren om de classificatietaak correct af te handelen.
BRAIN_CANCER_CLASSES = data["train"].features["label"].names
print("Detected classes:", BRAIN_CANCER_CLASSES)
De gedetecteerde klassen zijn: ['brain_glioma', 'brain_menin', 'brain_tumor'].
Detected classes: ['brain_glioma', 'brain_menin', 'brain_tumor']Om het classificatieproces te verbeteren, passen we deze klasselabels aan door een prefix (A, B, C) toe te voegen voor betere ordening en om aan te sluiten bij een aangepast promptformaat.
BRAIN_CANCER_CLASSES = ['A: brain glioma', 'B: brain menin', 'C: brain tumor']Vervolgens maken we een aangepaste prompt die het model tijdens het fijn-afstemmen zal sturen. De prompt bevat de bijgewerkte klasselabels.
options = "\n".join(BRAIN_CANCER_CLASSES)
PROMPT = f"What is the most likely type of brain cancer shown in the MRI image?\n{options}"
Om de dataset voor te bereiden op fijn-afstemmen, maken we een nieuwe kolom "messages". Deze kolom bevat gestructureerde data die een gebruikersvraag (de prompt) en assistentantwoord (het juiste label) voorstellen.
def format_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
        {
            "role": "assistant",
            "content": [
                {
                    "type": "text",
                    "text": BRAIN_CANCER_CLASSES[example["label"]],
                },
            ],
        },
    ]
    return example

# Apply the formatting to the dataset
formatted_data = data.map(format_data)
Om de formattering te controleren, kunnen we de message-kolom van het eerste voorbeeld inspecteren:
formatted_data["train"][0]["messages"]Het resulterende geformatteerde datapunt ziet er zo uit:
[{'content': [{'text': None, 'type': 'image'},
   {'text': 'What is the most likely type of brain cancer shown in the MRI image?\nA: brain glioma\nB: brain menin\nC: brain tumor',
    'type': 'text'}],
  'role': 'user'},
 {'content': [{'text': 'B: brain menin', 'type': 'text'}],
'role': 'assistant'}]In dit deel stemmen we het MedGemma 4B Instruct-model fijn af op de Brain MRI-dataset. Dit houdt in: het model en de processor downloaden, de LoRA-adapter instellen, de trainer configureren en het trainingsproces starten.
Omdat MedGemma een gated model is, moet je inloggen op de Hugging Face CLI met je API-sleutel. Dit stelt je ook in staat om je fijn-afgestemde model op de Hugging Face Hub op te slaan. Bekijk onze course Working with Hugging Face: Your Guide to the Hub als je een opfrisser nodig hebt.
from huggingface_hub import login
import os

hf_token = os.environ.get("HF_TOKEN")
login(hf_token)
We gebruiken de Transformers-bibliotheek om het MedGemma 4B Instruct-model en de bijbehorende processor te laden. Het model is geconfigureerd om bfloat16-precisie te gebruiken voor efficiënte berekening op GPU’s.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "google/medgemma-4b-it"

# Check if GPU supports bfloat16
if torch.cuda.get_device_capability()[0] < 8:
    raise ValueError("GPU does not support bfloat16, please use a GPU that supports bfloat16.")

model_kwargs = dict(
    attn_implementation="eager",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

# Use right padding to avoid issues during training
processor.tokenizer.padding_side = "right"Om het MedGemma 4B Instruct-model efficiënt fijn te stemmen, gebruiken we Low-Rank Adaptation (LoRA), een parameter-efficiënte methode voor fijn-afstemmen.
Met LoRA kunnen we grote modellen aanpassen door slechts een klein aantal extra parameters te trainen, wat de rekenkosten aanzienlijk verlaagt terwijl de prestaties behouden blijven.
from peft import LoraConfig

peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.05,
    r=16,
    bias="none",
    target_modules="all-linear",
    task_type="CAUSAL_LM",
    modules_to_save=[
        "lm_head",
        "embed_tokens",
    ],
)
Om tijdens training zowel beeld- als tekstinvoer te verwerken, definiëren we een aangepaste collate-functie. Deze functie verwerkt datasetvoorbeelden naar een formaat dat geschikt is voor het model, inclusief het tokenizen van tekst en het voorbereiden van beelddata.
def collate_fn(examples: list[dict[str, any]]):
    texts = []
    images = []
    for example in examples:
        images.append([example["image"]])
        texts.append(
            processor.apply_chat_template(
                example["messages"], add_generation_prompt=False, tokenize=False
            ).strip()
        )

    # Tokenize the texts and process the images
    batch = processor(text=texts, images=images, return_tensors="pt", padding=True)

    # The labels are the input_ids, with the padding and image tokens masked in
    # the loss computation
    labels = batch["input_ids"].clone()

    # Mask image tokens
    image_token_id = [
        processor.tokenizer.convert_tokens_to_ids(
            processor.tokenizer.special_tokens_map["boi_token"]
        )
    ]
    # Mask tokens that are not used in the loss computation
    labels[labels == processor.tokenizer.pad_token_id] = -100
    labels[labels == image_token_id] = -100
    labels[labels == 262144] = -100

    batch["labels"] = labels
    return batch
We gebruiken de SFTConfig-klasse uit de trl-bibliotheek om de trainingsargumenten te definiëren. Deze argumenten sturen het fijn-afstemproces aan, inclusief batchgrootte, learning rate en gradient accumulation-stappen.
from trl import SFTConfig

args = SFTConfig(
    output_dir="medgemma-brain-cancer",
    num_train_epochs=1,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    gradient_accumulation_steps=8,
    gradient_checkpointing=True,
    optim="adamw_torch_fused",
    logging_steps=0.1,
    save_strategy="epoch",
    eval_strategy="steps",
    eval_steps=0.1,
    learning_rate=2e-4,
    bf16=True,
    max_grad_norm=0.3,
    warmup_ratio=0.03,
    lr_scheduler_type="linear",
    push_to_hub=True,
    report_to="none",
    gradient_checkpointing_kwargs={"use_reentrant": False},
    dataset_kwargs={"skip_prepare_dataset": True},
    remove_unused_columns = False,
    label_names=["labels"],
)
De SFTTrainer vereenvoudigt het fijn-afstemmen door model, dataset, datacollator, trainingsargumenten en LoRA-configuratie te combineren in één workflow. Dit maakt het proces gestroomlijnd en gebruiksvriendelijk.
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=formatted_data["train"],
    eval_dataset=formatted_data["validation"].shuffle().select(range(50)),
    peft_config=peft_config,
    processing_class=processor,
    data_collator=collate_fn,
)Als het model, de dataset en de trainingsconfiguraties klaarstaan, kunnen we beginnen met fijn-afstemmen. De SFTTrainer maakt deze stap eenvoudig: met één opdracht start je de training:
trainer.train()Het trainingsproces duurde ongeveer 1 uur en 8 minuten. In die tijd daalden de training loss en validatie loss gestaag bij elke stap, wat aangeeft dat het model effectief leerde.
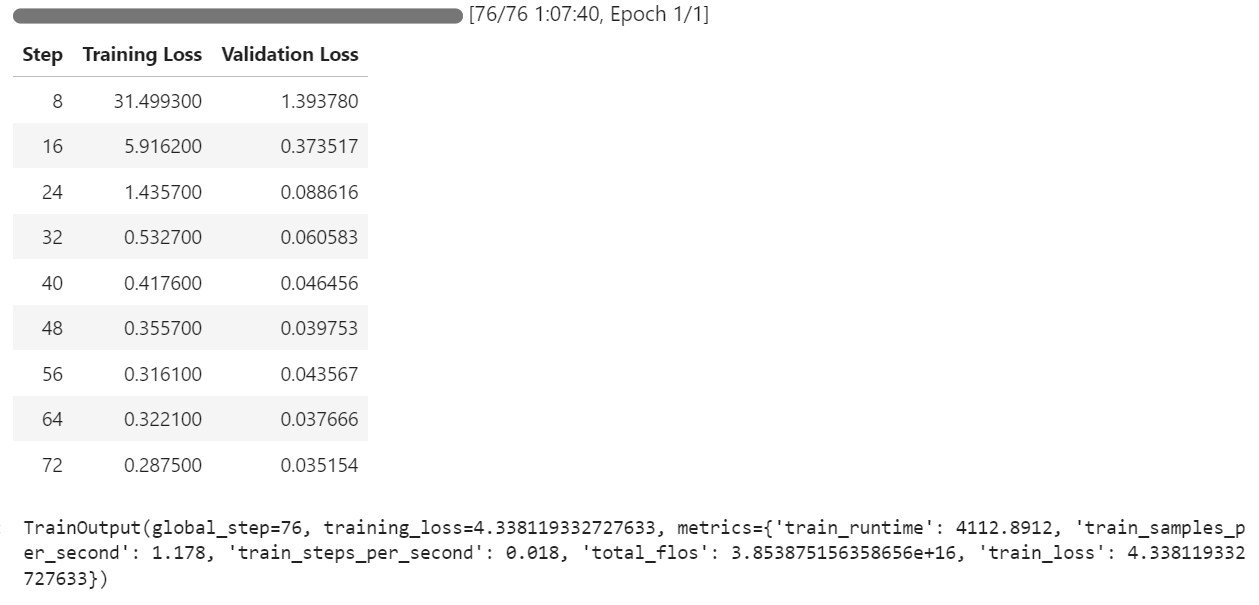
Na afloop van de training kan het fijn-afgestemde model lokaal worden opgeslagen en naar de Hugging Face Hub worden gepusht met de methode save_model().
trainer.save_model()Het model is nu beschikbaar op kingabzpro/medgemma-brain-cancer · Hugging Face
Bron kingabzpro/medgemma-brain-cancer
Om de prestaties van het MedGemma 4B-model te evalueren, testen we zowel het basismodel als het fijn-afgestemde model op de validatieset. Dit omvat het vrijmaken van geheugen, het voorbereiden van de testdata, het genereren van de respons en het berekenen van kernmetrics zoals accuracy en F1-score.
Voordat we beginnen met evalueren, verwijderen we de trainingsopzet om GPU-geheugen vrij te maken en een schone testomgeving te garanderen
del model
del trainer
torch.cuda.empty_cache()We formatteren de validatieset zodat deze aansluit op de door het model vereiste inputstructuur. Dit houdt in dat we een kolom "messages" maken met de gebruikersprompt voor elk voorbeeld.
def format_test_data(example: dict[str, any]) -> dict[str, any]:
    example["messages"] = [
        {
            "role": "user",
            "content": [
                {
                    "type": "image",
                },
                {
                    "type": "text",
                    "text": PROMPT,
                },
            ],
        },
    ]
    return example

test_data = data["validation"]
test_data = test_data.map(format_test_data)
Voor de evaluatie gebruiken we de evaluate-bibliotheek, die kant-en-klare metrics biedt voor taken zoals classificatie. Na het importeren en laden van de benodigde metrics halen we de grondwaarheidslabels uit de testset. Vervolgens definiëren we een hulpfunctie, compute_metrics, die accuracy en F1-score berekent door de voorspellingen met deze labels te vergelijken.
import evaluate

accuracy_metric = evaluate.load("accuracy")
f1_metric = evaluate.load("f1")

# Ground-truth labels
REFERENCES = test_data["label"]


def compute_metrics(predictions: list[int]) -> dict[str, float]:
    metrics = {}
    metrics.update(
        accuracy_metric.compute(
            predictions=predictions,
            references=REFERENCES,
        )
    )
    metrics.update(
        f1_metric.compute(
            predictions=predictions,
            references=REFERENCES,
            average="weighted",
        )
    )
    return metrics
Om consistente labelverwerking te garanderen, casten we de kolom "label" van de dataset naar een ClassLabel-type. Dit maakt efficiënte mapping mogelijk tussen labelindexen en bijbehorende namen. Daarnaast definiëren we alternatieve labelmappings om variaties in labelformattering tijdens postprocessing af te handelen.
from datasets import ClassLabel

test_data = test_data.cast_column(
    "label",
    ClassLabel(names=BRAIN_CANCER_CLASSES)
)

LABEL_FEATURE = test_data.features["label"]

ALT_LABELS = dict([
    (label, f"({label.replace(': ', ') ')}") for label in BRAIN_CANCER_CLASSES
])
Om de voorspellingen van het model aan de juiste klasselabels te koppelen, definiëren we een functie postprocess. Deze functie zorgt ervoor dat voorspellingen worden gematcht aan het juiste label, rekening houdend met zowel canonieke als alternatieve labelformats.
def postprocess(prediction, do_full_match: bool = False) -> int:
    if isinstance(prediction, str):
        response_text = prediction
    else:
        response_text = prediction[0]["generated_text"]

    if do_full_match:
        return LABEL_FEATURE.str2int(response_text)

    for label in BRAIN_CANCER_CLASSES:
        # accept canonical or alternative wording
        if label in response_text or ALT_LABELS[label] in response_text:
            return LABEL_FEATURE.str2int(label)

return -1Om de prestaties van het basismodel te evalueren, laden we het voorgetrainde model en de processor, configureren we de generatiesettings en bereiden we de prompts en beelden voor op de test.
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_kwargs = dict(
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(
    model_id, **model_kwargs
)

from transformers import GenerationConfig
gen_cfg = GenerationConfig.from_pretrained(model_id)
gen_cfg.update(
    do_sample          = False,
    top_k              = None,
    top_p              = None,
    cache_implementation = "dynamic"
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

def chat_to_prompt(chat_turns):
    return processor.apply_chat_template(
        chat_turns,
        add_generation_prompt=True,   # tells the model "your turn"
        tokenize=False                # we want raw text, not ids
    )

prompts = [chat_to_prompt(c) for c in test_data["messages"]]
images  = test_data["image"]                         # already a list of PIL images
assert len(prompts) == len(images), "1 prompt must match 1 image!"
We hebben een functie batch_predict gemaakt die de testset batchgewijs verwerkt. Deze functie genereert voorspellingen voor elk prompt-beeldpaar en past postprocessing toe om de outputs aan de juiste labels te koppelen.
import torch
from typing import List, Any, Callable


def batch_predict(
    prompts,
    images,
    model,
    processor,
    postprocess,
    *,
    batch_size=64,
    device="cuda",
    dtype=torch.bfloat16,
    **gen_kwargs
):
    preds = []
    for i in range(0, len(prompts), batch_size):
        texts = prompts[i : i + batch_size]
        imgs = [[img] for img in images[i : i + batch_size]]
        enc = processor(text=texts, images=imgs, padding=True, return_tensors="pt").to(
            device, dtype=dtype
        )
        lens = enc["attention_mask"].sum(dim=1)
        with torch.inference_mode():
            out = model.generate(
                **enc,
                disable_compile=True,
                **gen_kwargs
            )
        for seq, ln in zip(out, lens):
            ans = processor.decode(seq[ln:], skip_special_tokens=True)
            preds.append(postprocess(ans))
    return preds
We gebruiken de functie batch_predict om voorspellingen te genereren voor het basismodel op de testset. De voorspellingen worden vervolgens geëvalueerd met de functie compute_metrics.
bf_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)


bf_metrics = compute_metrics(bf_preds)
print(f"Baseline metrics: {bf_metrics}")
Het resultaat is niet indrukwekkend. We behaalden 33% accuracy, wat vrij slecht is.
Baseline metrics: {'accuracy': 0.33745874587458746, 'f1': 0.1737287617650654}Om het gedrag van het model beter te begrijpen, kunnen we voorspellingen genereren voor één enkel voorbeeld uit de dataset. Dit houdt in dat we een hulpfunctie maken om de input te verwerken en het modelantwoord terug te geven.
De functie predict_one neemt een prompt en een afbeelding als invoer, verwerkt deze met de processor van het model en genereert een respons. De functie zorgt ervoor dat de output van het model wordt gedecodeerd naar leesbare tekst.
import torch
from typing import Union, Dict, Any, List
from transformers import AutoModelForImageTextToText, AutoProcessor


def predict_one(
    prompt,
    image,
    model,
    processor,
    *,
    device="cuda",
    dtype=torch.bfloat16,
    disable_compile=True,
    **gen_kwargs
) -> str:
    inputs = processor(text=prompt, images=image, return_tensors="pt").to(
        device, dtype=dtype
    )
    plen = inputs["input_ids"].shape[-1]
    with torch.inference_mode():
        ids = model.generate(
            **inputs,
            disable_compile=disable_compile,
            **gen_kwargs
        )
    return processor.decode(ids[0, plen:], skip_special_tokens=True)
We gebruiken predict_one om een respons te genereren voor het 11e voorbeeld uit de dataset. Dit houdt in dat we de prompt voorbereiden en de predictiefunctie uitvoeren.
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40
)

print("Model answer:", answer)
Het resultaat was een lange zin die uitlegt waarom voor brain glioma is gekozen. De respons is volledig onjuist; zelfs de classificatie klopt niet.
Model answer: Based on the MRI image, the most likely type of brain cancer is **A: brain glioma**.

Here's why:

* **Gliomas** are a common type of brain tumorOm het fijn-afgestemde model te evalueren, herhalen we het evaluatieproces door het model uit de outputdirectory te laden, voorspellingen te genereren en metrics te berekenen.
We laden het fijn-afgestemde model en de processor uit de outputdirectory, draaien de functie batch_predict en berekenen de metrics.
model = AutoModelForImageTextToText.from_pretrained(
    args.output_dir, **model_kwargs
)
model.generation_config = gen_cfg

processor  = AutoProcessor.from_pretrained(args.output_dir)
tok = processor.tokenizer

model.config.pad_token_id            = tok.pad_token_id
model.generation_config.pad_token_id = tok.pad_token_id

af_preds = batch_predict(
    model         = model,
    processor     = processor,
    prompts       = prompts,
    images        = images,
    batch_size    = 64,
    max_new_tokens= 40,          # forwarded to generate
    postprocess= postprocess, # your label-mapping function
)
af_metrics = compute_metrics(af_preds)
print(f"Fine-tuned metrics: {af_metrics}")
Deze resultaten tonen een duidelijke verbetering ten opzichte van het basismodel, wat de effectiviteit van fijn-afstemmen onderstreept. De accuracy sprong van 33% naar 89% met slechts 1 epoch.
Fine-tuned metrics: {'accuracy': 0.8927392739273927, 'f1': 0.892641793935792}Om de prestaties van het fijn-afgestemde model verder te analyseren, genereren we een voorspelling voor één voorbeeld uit de testset.
idx     = 10
chat    = test_data["messages"][idx]
prompt  = processor.apply_chat_template(
            chat,
            add_generation_prompt=True,
            tokenize=False
          )

# run the one-sample helper
answer = predict_one(
    prompt   = prompt,
    image    = test_data["image"][idx],
    model    = model,
    processor= processor,
    max_new_tokens = 40              # any generate-kwargs you need
)

print("Model answer:", answer)
Het model gaf een duidelijke en precieze uitkomst, waarbij de classificatie zowel correct als netjes geformatteerd was.
Model answer: C: brain tumorLoop je vast met het bovenstaande, raadpleeg dan het bijbehorende notebook: Fine_tuning_MedGemma.ipynb
MedGemma betekent een belangrijke stap voorwaarts voor AI in de medische wetenschap. Door artsen in staat te stellen sneller en nauwkeuriger te oordelen, maakt het snellere diagnoses en effectievere behandelplannen voor patiënten mogelijk.
Fijn-afstemmen van vision-language-modellen zoals MedGemma 4B Instruct zorgt voor flexibiliteit over uiteenlopende medische taken, van beeldclassificatie tot het integreren van redeneervermogen.
In deze tutorial hebben we geleerd hoe je een vision-language-model fijn afstemt op een Brain MRI-dataset voor classificatie van hersenkanker. De resultaten waren opvallend: de accuracy steeg van 33% naar 89%, een flinke sprong die het potentieel van fijn-afstemmen in medische AI-toepassingen onderstreept.
Wil je meer leren? Bekijk dan deze resources:
Topcursussen bij DataCamp
Cursus
blog
Adel Nehme
15 min

