
{count, plural, one {Kursus} other {Kursus}}
Deep Learning untuk Gambar dengan PyTorch
{hours} jam
13.8K
FLUX.2 adalah model text-to-image modern yang dibangun untuk generasi berkualitas tinggi dan dapat dikendalikan. Dalam tutorial ini, saya akan menunjukkan cara menggunakan varian FLUX.2-dev untuk membangun Capsule Wardrobe Visualizer di mana kita mengunggah 2–10 gambar pakaian (kemeja, celana, jaket, sepatu, dll.), model mengambil sampel kombinasi dari potongan tersebut, dan aplikasi mengembalikan grid outfit yang memadupadankan dalam berbagai cara.
Hasilnya adalah alat interaktif yang memungkinkan Anda mengeksplorasi kombinasi outfit secara visual, didukung model difusi yang dioptimalkan untuk memori GPU.
Jika Anda ingin mempelajari lebih lanjut prinsip di balik tutorial ini, saya sarankan melihat kursus Deep Learning for Images with PyTorch.
FLUX.2 adalah keluarga model text-to-image yang dioptimalkan untuk berbagai titik pada spektrum kualitas, kecepatan, dan fleksibilitas, bukan satu checkpoint monolitik. Model ini memperkenalkan beberapa kemampuan penting:
Dalam praktiknya, Anda biasanya melihat tiga varian inti:
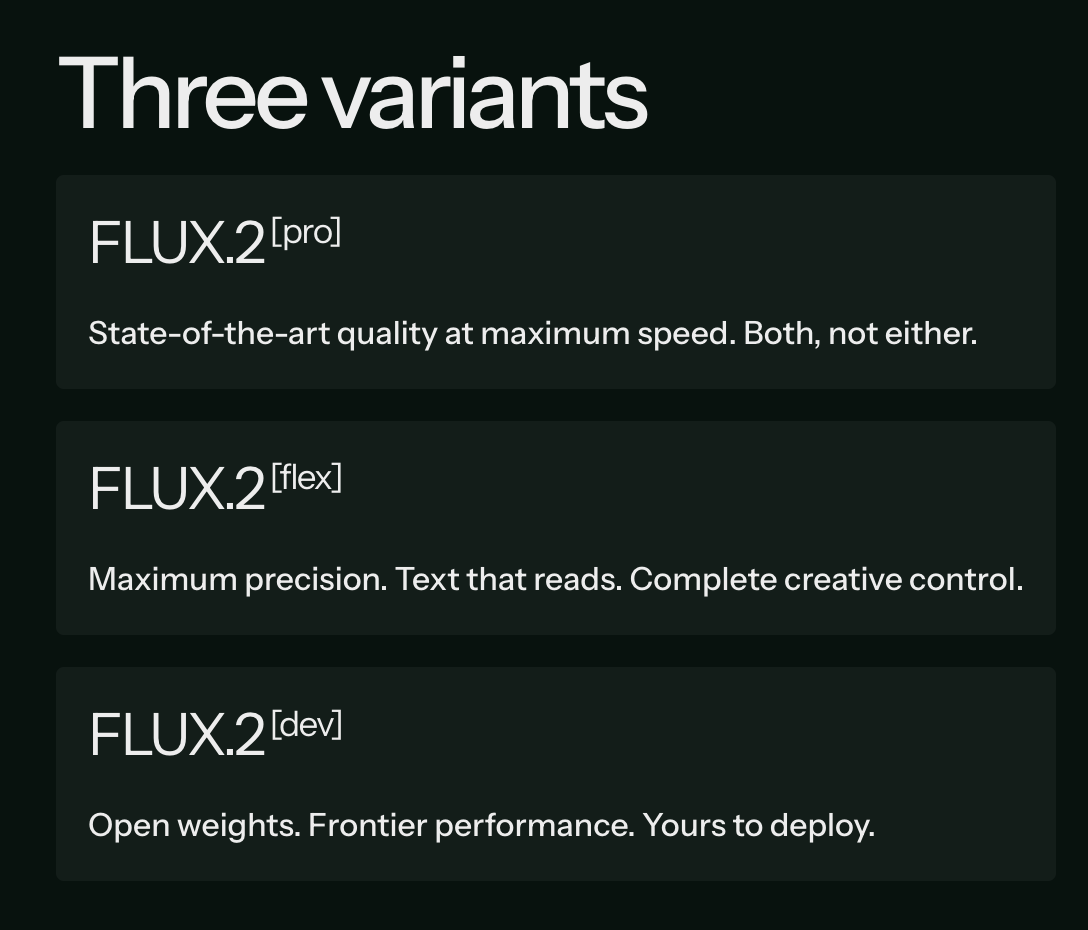
Dibanding Pro dan Flex, varian Dev dirancang khusus untuk mereka yang ingin bereksperimen dan inilah yang kita butuhkan untuk grid capsule wardrobe interaktif kita.
Lini FLUX.2 asli sudah kuat, tetapi FLUX.2-Dev ditambah kuantisasi 4-bit membuat demo ini jauh lebih mudah dijalankan, diiterasi, dan diperluas. Alasannya:
Singkatnya, FLUX.2-Dev (4-bit) memberi kita perpaduan terbaik memori, kecepatan, dan kualitas untuk alat capsule wardrobe interaktif.
Di bagian ini, kita akan mengimplementasikan capsule wardrobe visualizer dengan model FLUX 2 yang dibungkus dalam aplikasi Gradio. Secara garis besar, aplikasi melakukan tiga hal:
Pada video di bawah, Anda dapat melihat versi singkat alur kerja. Video dipercepat untuk tujuan demonstrasi (proses generasi sebenarnya dapat memakan waktu beberapa menit):
Pertama, instal pustaka diffusers terbaru dari GitHub dan dependensi lainnya.
!pip install -q "git+https://github.com/huggingface/diffusers.git@main" \
               "transformers>=4.44.0" accelerate safetensors bitsandbytes gradio pillow
Lalu masuk ke Hugging Face agar Anda bisa mengambil bobot FLUX.2-dev 4-bit:
from huggingface_hub import login
login()
Masukkan HF Token saat diminta dan masuk ke HF untuk mengambil model. Kemudian, lakukan pemeriksaan cepat untuk melihat apakah CUDA tersedia dan GPU apa yang kita gunakan:
import torch, diffusers, bitsandbytes as bnb
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smi
Jika Anda melihat GPU Anda pada keluaran nvidia-smi dan CUDA available: True, Anda siap melanjutkan.
Sekarang kita memuat komponen FLUX.2-dev 4-bit dari repo diffusers/FLUX.2-dev-bnb-4bit.
from diffusers import Flux2Pipeline, Flux2Transformer2DModel
from transformers import Mistral3ForConditionalGeneration
import torch
bnb_repo = "diffusers/FLUX.2-dev-bnb-4bit"
torch_dtype = torch.bfloat16
device = "cuda"
print("Loading 4-bit transformer...")
transformer = Flux2Transformer2DModel.from_pretrained(
    bnb_repo,
    subfolder="transformer",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Loading 4-bit text encoder...")
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
    bnb_repo,
    subfolder="text_encoder",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Building Flux2 pipeline...")
pipe = Flux2Pipeline.from_pretrained(
    bnb_repo,
    transformer=transformer,
    text_encoder=text_encoder,
    torch_dtype=torch_dtype,
).to(device)
pipe.set_progress_bar_config(disable=False)
print("Loaded. Example param device:", next(pipe.transformer.parameters()).device)
Setelah dependensi terpasang, kita dapat memuat FLUX.2 menggunakan pustaka diffusers dan memasangkannya dengan enkoder teks Mistral 3 dari transformers. Berikut tampilan kodenya:
Flux2Transformer2DModel: Ini adalah transformer mirip U-Net inti yang bertanggung jawab atas proses denoising dan dimuat dalam bentuk terkuantisasi 4-bit.Mistral3ForConditionalGeneration: Model ini digunakan sebagai enkoder teks, mengubah prompt teks Anda menjadi sinyal conditioning untuk proses difusi.Flux2Pipeline: Pipeline ini menggabungkan transformer, enkoder teks, dan komponen pendukung ke dalam satu antarmuka yang dapat dipanggil untuk generasi gambar.Menggunakan device_map="auto" dan torch_dtype=torch.bfloat16 membuatnya fleksibel di berbagai setelan GPU sekaligus hemat memori.
Aplikasi memungkinkan pengguna mengunggah banyak gambar lemari pakaian. Kita memerlukan beberapa utilitas untuk melakukannya:
import gradio as gr
import random, json
from typing import List, Union
from PIL import Image
MAX_REFS = 10
def files_to_pil(files: List[Union[str, dict]]) -> List[Image.Image]:
    images = []
    for f in files:
        path = f.get("name") if isinstance(f, dict) else f
        if not path:
            continue
        img = Image.open(path).convert("RGB")
        images.append(img)
    return images
def preprocess_refs(refs: List[Image.Image], max_size: int = 512) -> List[Image.Image]:
    processed = []
    for img in refs:
        img = img.convert("RGB")
        img.thumbnail((max_size, max_size), Image.LANCZOS)
        processed.append(img)
    return processed
Kode di atas mendefinisikan dua fungsi pembantu utama.
files_to_pil() mengambil objek file yang dikembalikan oleh Gradio, mengekstrak path-nya, dan membuka setiap file sebagai PIL.Image RGB.preprocess_refs() mengubah ukuran gambar ini hingga maksimum 512 × 512 sambil mempertahankan rasio aspeknya, yang penting untuk kecepatan dan penggunaan memori.Selain itu, kita membatasi jumlah gambar referensi dengan MAX_REFS = 10 agar set conditioning tidak kelebihan beban.
Alih-alih mengirim satu prompt teks datar, saya membangun prompt terstruktur mirip JSON yang mendeskripsikan:
def build_outfit_prompt(outfit_indices: List[int], labels: List[str]) -> str:
    item_phrases = [
        f"{labels[idx]} from reference image {idx+1}" for idx in outfit_indices
    ]
    outfit_items_str = ", ".join(item_phrases)
    mistral_prompt = """A professional full-body studio photograph of a high-end fashion editorial shoot, set against a flawless seamless neutral gray backdrop (#f5f5f5) in a controlled studio environment. The scene is bathed in soft, diffused three-point lighting (key, fill, and subtle rim) that eliminates harsh shadows, ensuring even illumination across the subject while preserving dimensionality and texture.
At the center of the frame stands a full-body adult model, exuding quiet confidence in a relaxed yet poised stance—one foot slightly forward, weight balanced, body angled subtly to the right. The model’s expression is natural, with a neutral gaze directed just off-camera, evoking a modern, minimalist lookbook aesthetic.
The outfit—meticulously styled and tailored—is the focal point, captured with ultra-realistic 8K resolution and razor-sharp detail. Fabrics display tactile depth: the weave of knits, the drape of silks, the sheen of leathers, and the crispness of cotton are all rendered with commercial-grade precision. The shallow depth of field (50mm prime lens, f/2.8) keeps the subject in crystalline focus while softly blurring the backdrop, emphasizing the outfit’s textures and proportions.
The composition adheres to classic fashion photography rules: vertical framing, ample headroom, and a slightly dynamic angle (eye-level) that flatters the model’s posture. The color palette is controlled and sophisticated, dominated by the outfit’s hues against the neutral gray, with subtle tonal contrasts to highlight layers and accessories.
Every element—from the studio-quality lighting to the catalog-ready styling—conveys luxury, clarity, and commercial appeal, designed to showcase the outfit as a covetable, high-end ensemble."""
    prompt_dict = {
        "scene": mistral_prompt,
        "subjects": [
            {
                "description": (
                    "The model is styled in an outfit composed of: "
                    + outfit_items_str
                    + ". Each garment should closely match the color, fabric, and key design details of its reference image."
                )
            }
        ]
    }
    return json.dumps(prompt_dict)
Fungsi build_outfit_prompt() melakukan tiga hal penting:
outfit_indices dan labels untuk membuat frasa seperti "potongan lemari 1 dari gambar referensi 1", yang kemudian digabung menjadi satu string yang mendeskripsikan pakaian terpilih untuk outfit tertentu ini.prompt_dict dengan field scene dan subjects, lalu serialisasi kamus tersebut ke JSON agar dapat dikirim sebagai satu string prompt ke pipeline.Secara konseptual, kita memperlakukan setiap gambar lemari yang diunggah sebagai “potongan lemari i” dan meminta model untuk “menyusun outfit menggunakan potongan lemari 1, potongan lemari 3, dan potongan lemari 4,” sambil mempertahankan warna, kain, dan detail desain kunci tiap potongan.
Catatan: Karena kita menggunakan model Mistral sebagai enkoder teks dalam pipeline ini, saya juga menggunakan Mistral untuk membantu menyusun prompt deskripsi studio yang panjang (mistral_prompt) melalui meta prompting. Ini menjaga gaya tetap selaras dengan apa yang “diharapkan” oleh enkoder dan memudahkan penyesuaian redaksi langsung di kode.
Inti demo adalah capsule_fn, yang:
def make_grid(images: List[Image.Image], rows: int, cols: int) -> Image.Image:
    w, h = images[0].size
    grid = Image.new("RGB", (cols * w, rows * h), (255, 255, 255))
    for idx, img in enumerate(images):
        r, c = divmod(idx, cols)
        grid.paste(img, (c * w, r * h))
    return grid
def capsule_fn(files, rows, cols, height, width, steps, guidance, seed):
    if not files or len(files) < 2:
        return None
    images = files_to_pil(files)
    images = images[:MAX_REFS]
    refs = preprocess_refs(images, max_size=512)
    labels = [f"wardrobe piece {i+1}" for i in range(len(refs))]
    random.seed(int(seed))
    tiles = []
    num_tiles = rows * cols
    for i in range(num_tiles):
        k = min(len(refs), random.randint(2, 3))
        outfit_idxs = random.sample(range(len(refs)), k=k)
        prompt = build_outfit_prompt(outfit_idxs, labels)
        generator = torch.Generator(device=device).manual_seed(int(seed) + i)
        out = pipe(
            prompt=prompt,
            image=refs,
            height=height,
            width=width,
            num_inference_steps=steps,
            guidance_scale=guidance,
            generator=generator,
        )
        tiles.append(out.images[0])
    grid = make_grid(tiles, rows, cols)
    return grid
Dua fungsi di atas membentuk mesin inti demo capsule wardrobe.
make_grid() membuat kanvas kosong yang cukup besar untuk tata letak baris × kolom, lalu menempelkan setiap gambar outfit yang dihasilkan ke posisi yang benar, menghasilkan satu gambar grid.capsule_fn() menyiapkan gambar lemari pengguna sebagai referensi, secara acak memilih 2–3 potongan per tile, membangun prompt outfit terstruktur, dan memanggil pipeline FLUX.2 dengan resolusi, langkah, guidance, dan seed yang dipilih. Fungsi ini mengumpulkan semua tile yang dihasilkan dan mengoperkannya ke make_grid(), sehingga pengguna melihat grid akhir outfit mix-and-match.Langkah ini menghubungkan mesin capsule wardrobe ke aplikasi Gradio. Pengguna mengunggah gambar lemari pakaian, memilih pengaturan grid dan generasi, lalu mendapatkan kembali grid outfit komposit.
inputs = [
    gr.File(file_types=["image"], file_count="multiple", label="Wardrobe pieces (2–10 images)"),
    gr.Slider(1, 4, value=2, step=1, label="Grid rows"),
    gr.Slider(1, 4, value=2, step=1, label="Grid cols"),
    gr.Slider(384, 896, value=512, step=64, label="Image height"),
    gr.Slider(256, 640, value=384, step=64, label="Image width"),
    gr.Slider(10, 30, value=16, step=2, label="Diffusion steps"),
    gr.Slider(1.0, 7.0, value=2.5, step=0.5, label="Guidance scale"),
    gr.Number(value=42, precision=0, label="Seed")
]
iface = gr.Interface(
    fn=capsule_fn,
    inputs=inputs,
    outputs=gr.Image(type="pil", label="Capsule wardrobe grid"),
    title="Capsule Wardrobe Visualizer – FLUX.2-dev (4-bit)",
    description="Upload 2–10 product images; mix & match outfits using FLUX.2-dev with multi-image reference.",
)
iface.launch(share=True, debug = True)
Begini cara kita membangun aplikasi Gradio:
gr.Interface menghubungkan input ini ke fungsi capsule_fn dan mendeklarasikan satu output gr.Image. Panggilan launch(share=True, debug=True) memulai server Gradio, menampilkan tautan publik yang bisa dibagikan untuk demo, dan mengaktifkan logging debug di konsol untuk membantu mendiagnosis masalah.Setelah antarmuka aktif:
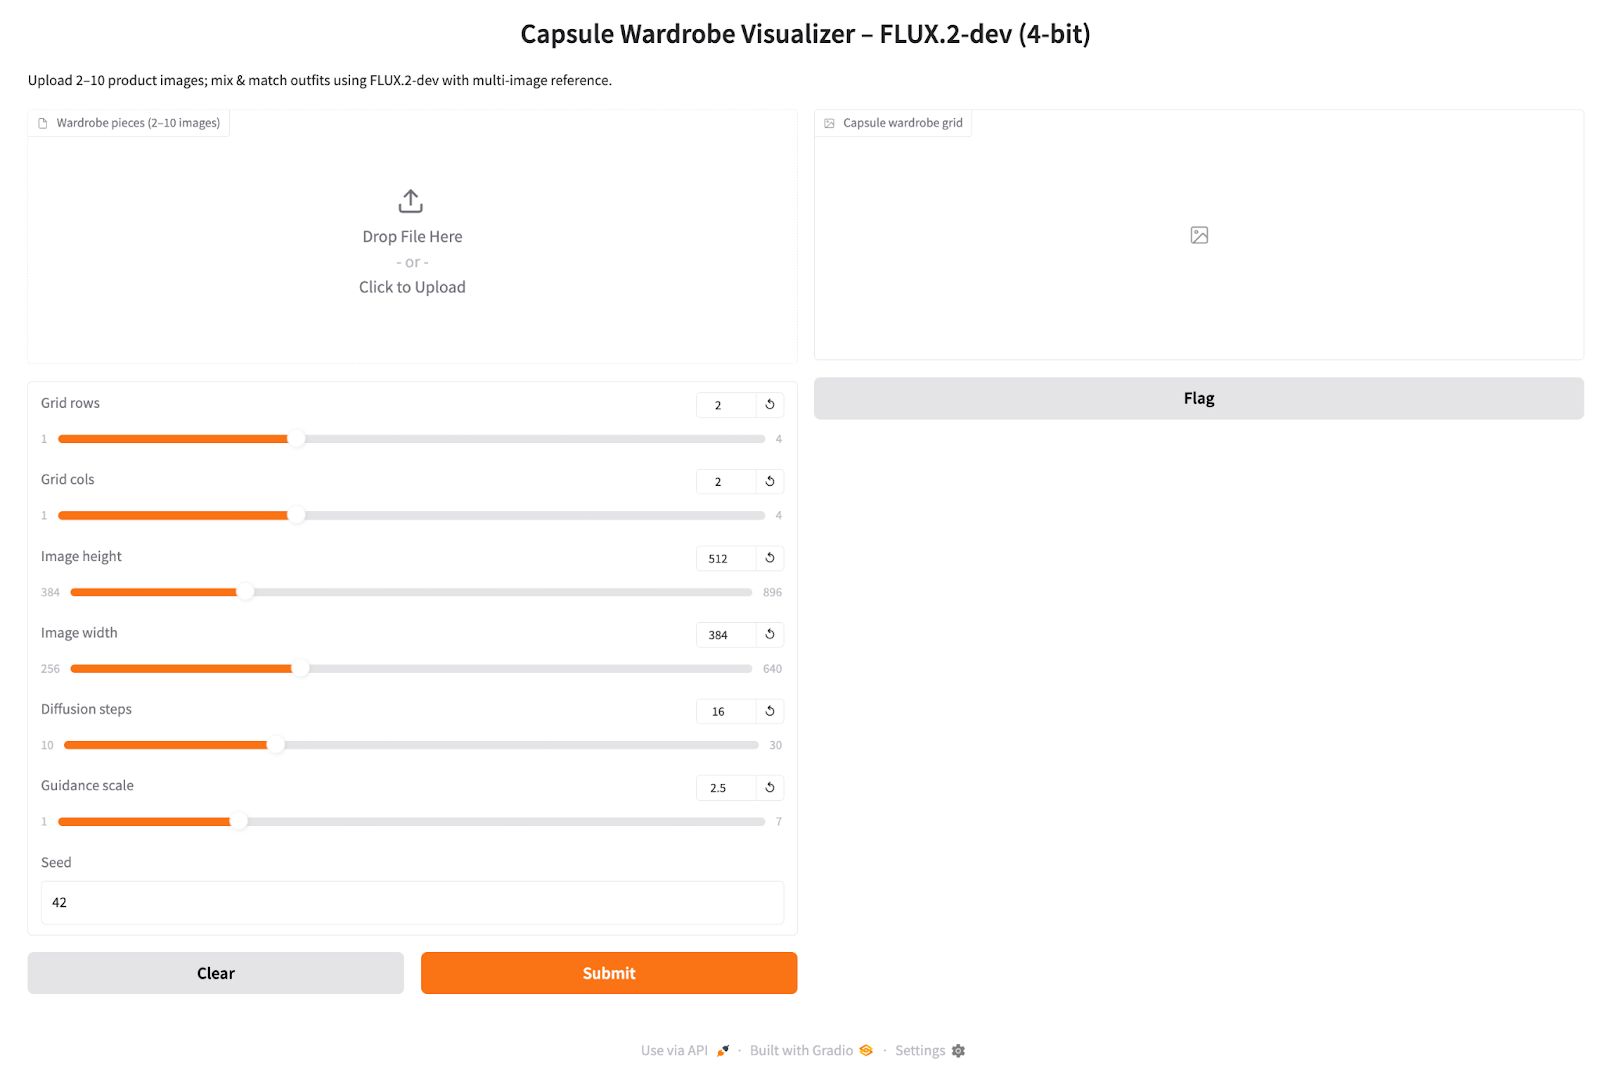
Untuk memahami bagaimana perilaku FLUX.2-dev dalam praktik, saya menjalankan beberapa eksperimen kecil dengan aplikasi final. Saya memvariasikan langkah difusi dan guidance scale, serta mencoba beberapa gambar dari pakaian yang sama dan satu gambar per pakaian unik untuk melihat seberapa banyak variasi yang dihasilkan model.
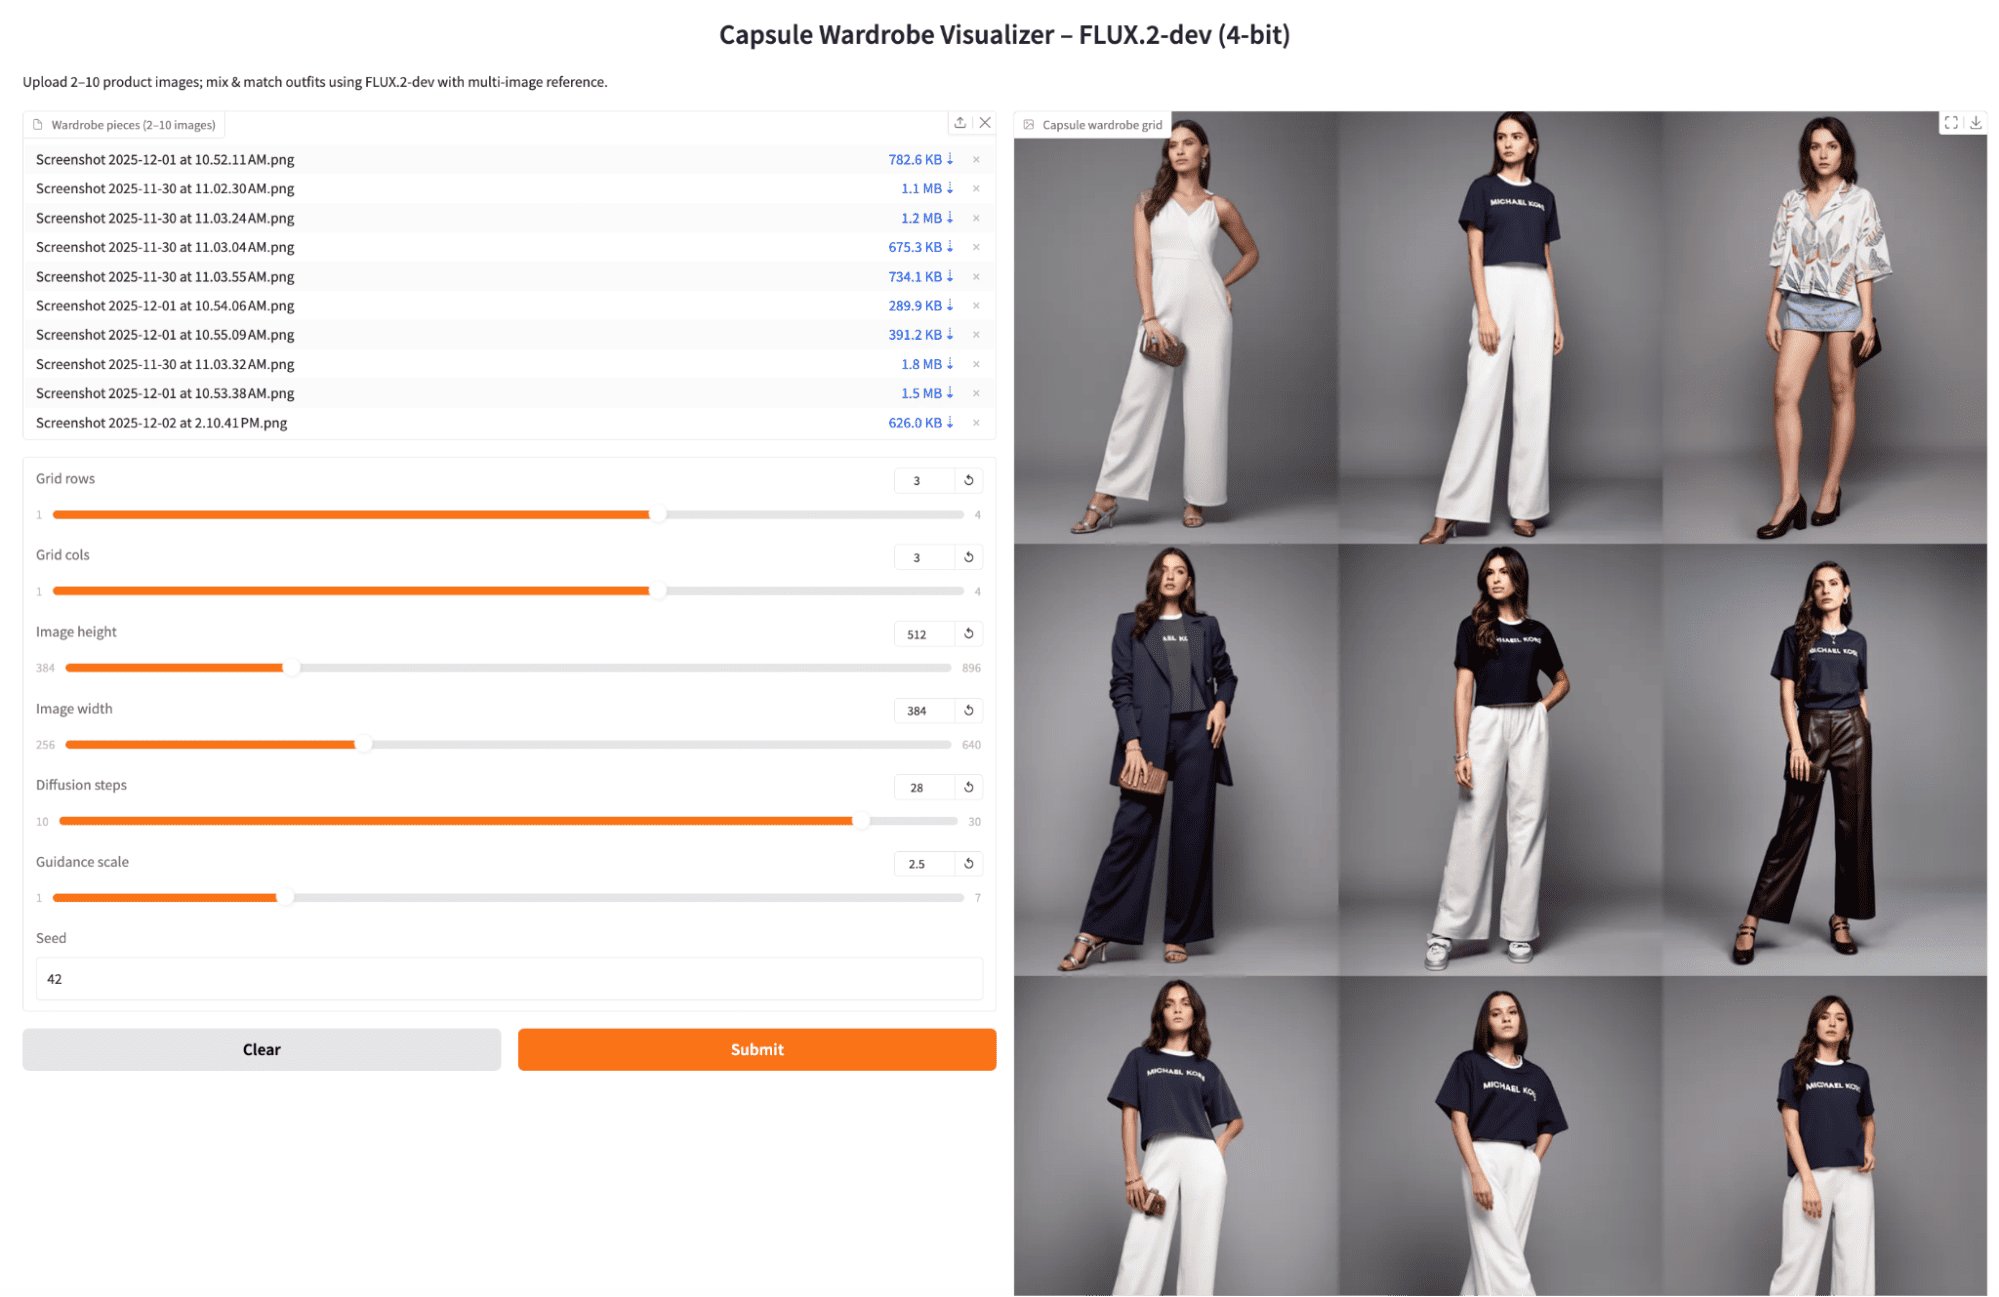
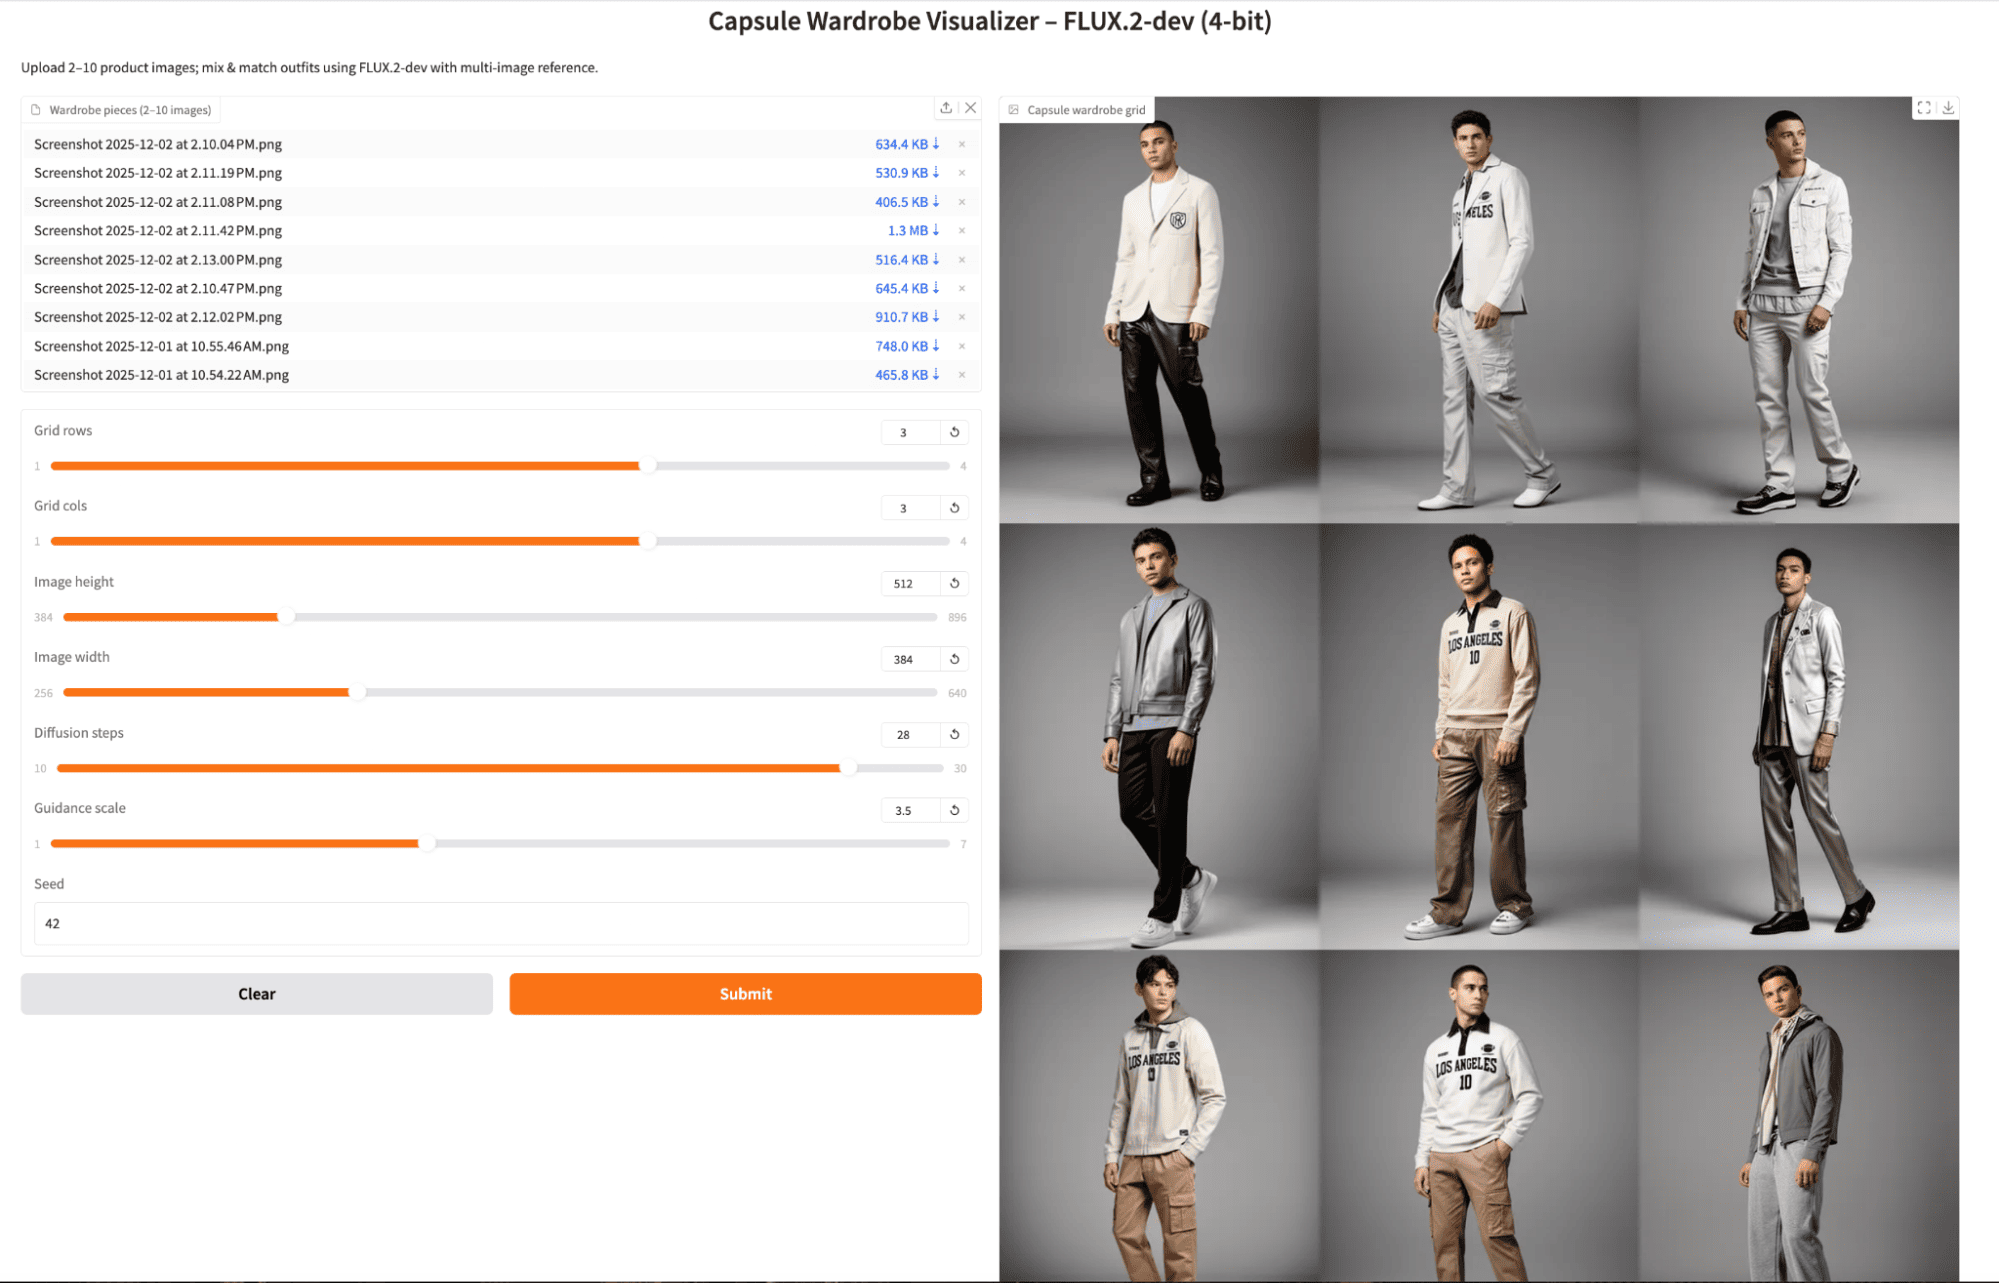
Saya pertama kali mengunggah beberapa gambar dari outfit yang sama yang diambil dari sudut berbeda, mempertahankan langkah difusi default dan guidance sedang. Model menghasilkan pencahayaan studio yang konsisten dan detail kain yang baik, dengan outfit yang terasa seperti variasi dari satu set kapsul.
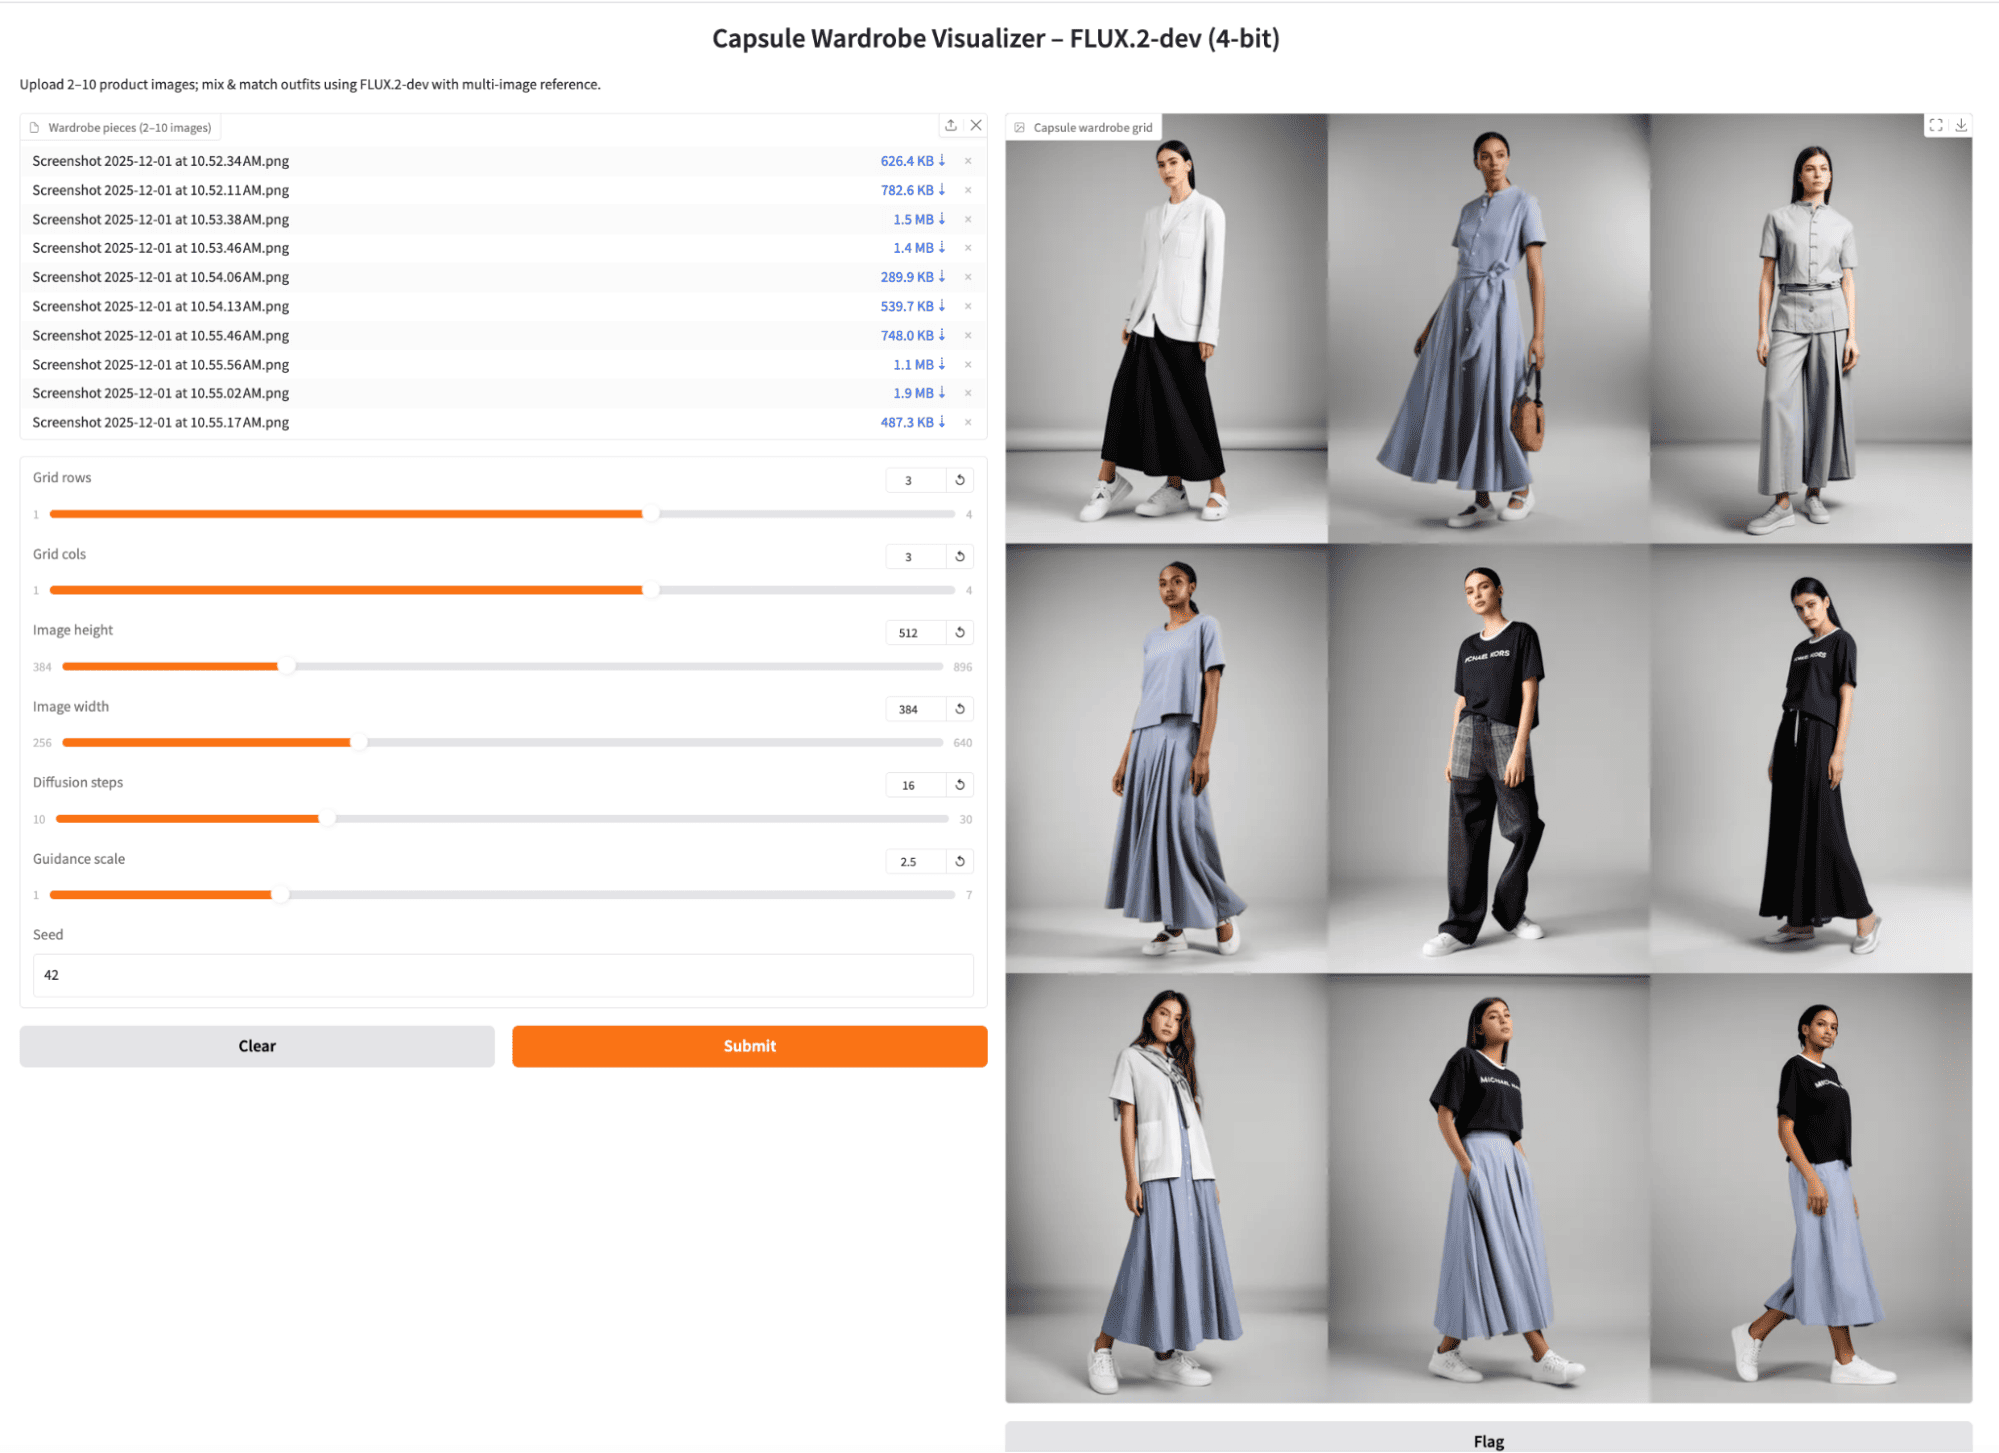
Berikutnya, saya mempertahankan gambar referensi yang sama tetapi menaikkan langkah difusi menjadi 28 (dan sedikit menyesuaikan guidance). Grid menjadi sedikit lebih tajam dan lebih rapi, namun tetap fokus mengombinasikan pakaian inti yang sama. Komprominya adalah peningkatan waktu generasi per batch yang kecil namun terasa.
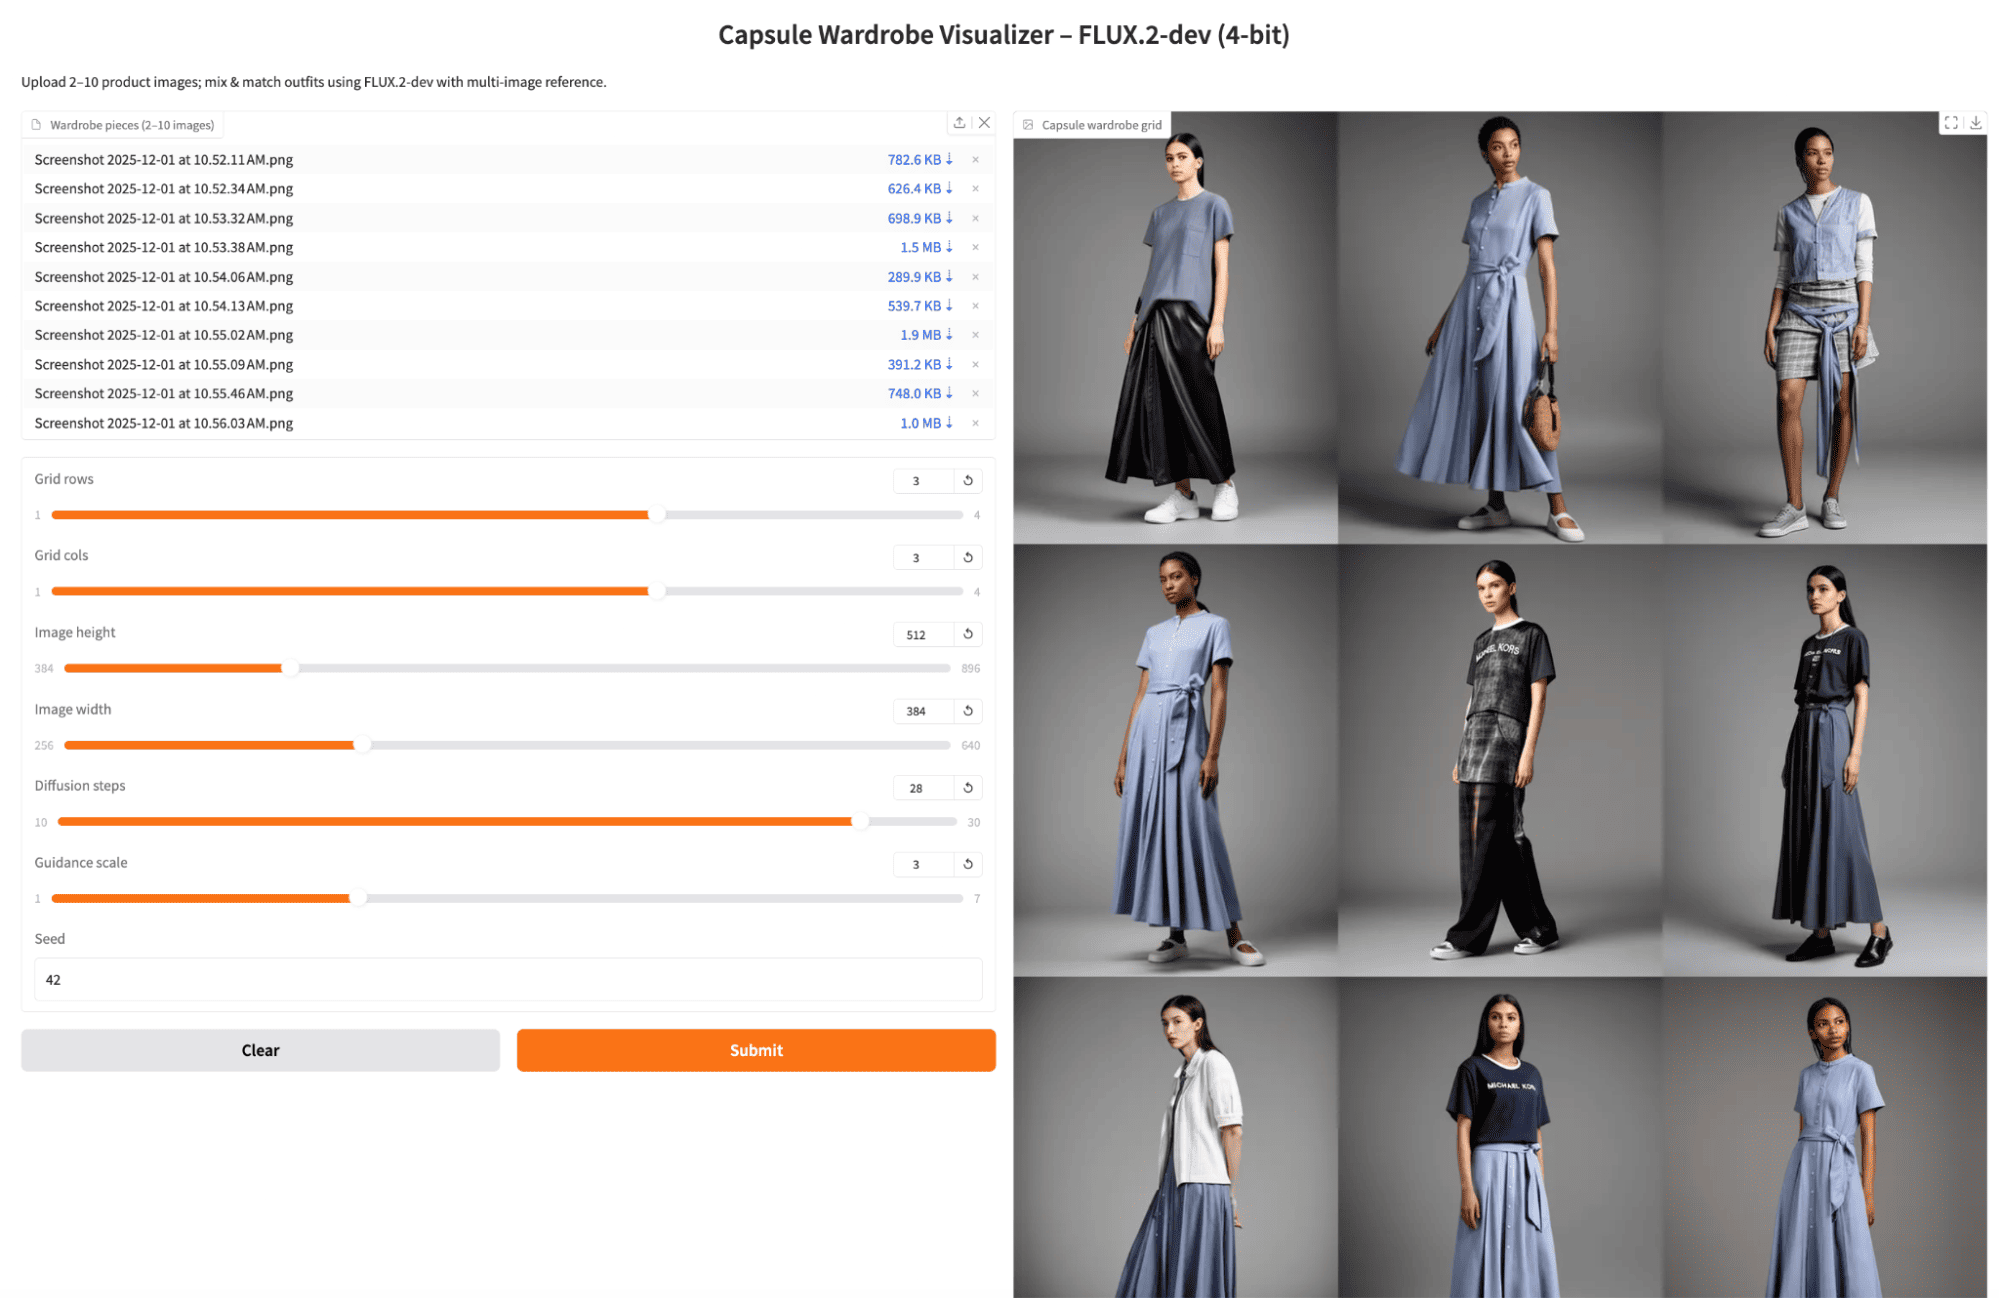
Terakhir, saya mengunggah satu foto produk per pakaian berbeda dan menghasilkan grid 3x3 lainnya. Outfit yang dihasilkan jauh lebih bervariasi di seluruh sel, memadukan atasan dan bawahan berbeda dengan cara yang menarik. Beberapa pengulangan masih muncul, tetapi secara keseluruhan, grid terasa lebih mendekati capsule wardrobe sejati, dengan kombinasi lebih beragam untuk seed dan pengaturan yang sama.
FLUX.2-dev dalam bentuk 4-bit adalah model yang hebat untuk aplikasi gambar. Dalam tutorial ini, kita menyiapkan pipeline FLUX.2-dev 4-bit dengan diffusers dan membangun alur kerja referensi multi-gambar yang memperlakukan potongan lemari sebagai petunjuk conditioning, serta membungkus semuanya dalam aplikasi Gradio.
Hasilnya adalah Capsule Wardrobe Visualizer yang kuat yang dapat bertindak sebagai prototipe untuk peranti e-commerce fesyen, atau sekadar cara menyenangkan untuk me-remix lemari Anda sendiri. Dari sini, Anda dapat menyambungkan pipeline yang sama ke sistem agens yang lebih luas, seperti LLM yang menyarankan outfit berdasarkan dress code atau cuaca, atau menghubungkannya ke backend katalog produk nyata.
Kursus Teratas DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



