
course
PyTorch के साथ इमेज के लिए डीप लर्निंग
4 घंटा
13.6K
FLUX.2 एक आधुनिक टेक्स्ट-टू-इमेज मॉडल है जिसे उच्च-गुणवत्ता और नियंत्रित जेनरेशन के लिए बनाया गया है। इस ट्यूटोरियल में, मैं आपको FLUX.2-dev वेरिएंट का उपयोग करके एक Capsule Wardrobe Visualizer बनाना सिखाऊंगा, जिसमें हम 2–10 कपड़ों की इमेज (शर्ट, पैंट, जैकेट, जूते, आदि) अपलोड करते हैं, मॉडल उन पीसेज़ के कॉम्बिनेशन सैंपल करता है, और ऐप अलग-अलग तरीकों से उन्हें मिलाकर आउटफिट्स का एक ग्रिड लौटाता है।
नतीजा एक इंटरैक्टिव टूल है जो आपको आउटफिट कॉम्बिनेशन को विज़ुअली एक्सप्लोर करने देता है, जिसे GPU मेमोरी के लिए ऑप्टिमाइज़्ड डिफ्यूज़न मॉडल पावर करता है।
यदि आप इस ट्यूटोरियल के पीछे के सिद्धांतों के बारे में और जानना चाहते हैं, तो मैं Deep Learning for Images with PyTorch कोर्स देखने की सलाह देता/देती हूँ।
FLUX.2 टेक्स्ट-टू-इमेज मॉडलों का एक परिवार है जो गुणवत्ता, गति, और लचीलापन के स्पेक्ट्रम के अलग-अलग बिंदुओं के लिए ऑप्टिमाइज़्ड हैं, किसी एक मोनोलिथिक चेकपॉइंट की बजाय। यह कई महत्वपूर्ण क्षमताएँ लाता है:
व्यवहार में, आप आमतौर पर तीन मुख्य वेरिएंट देखते हैं:
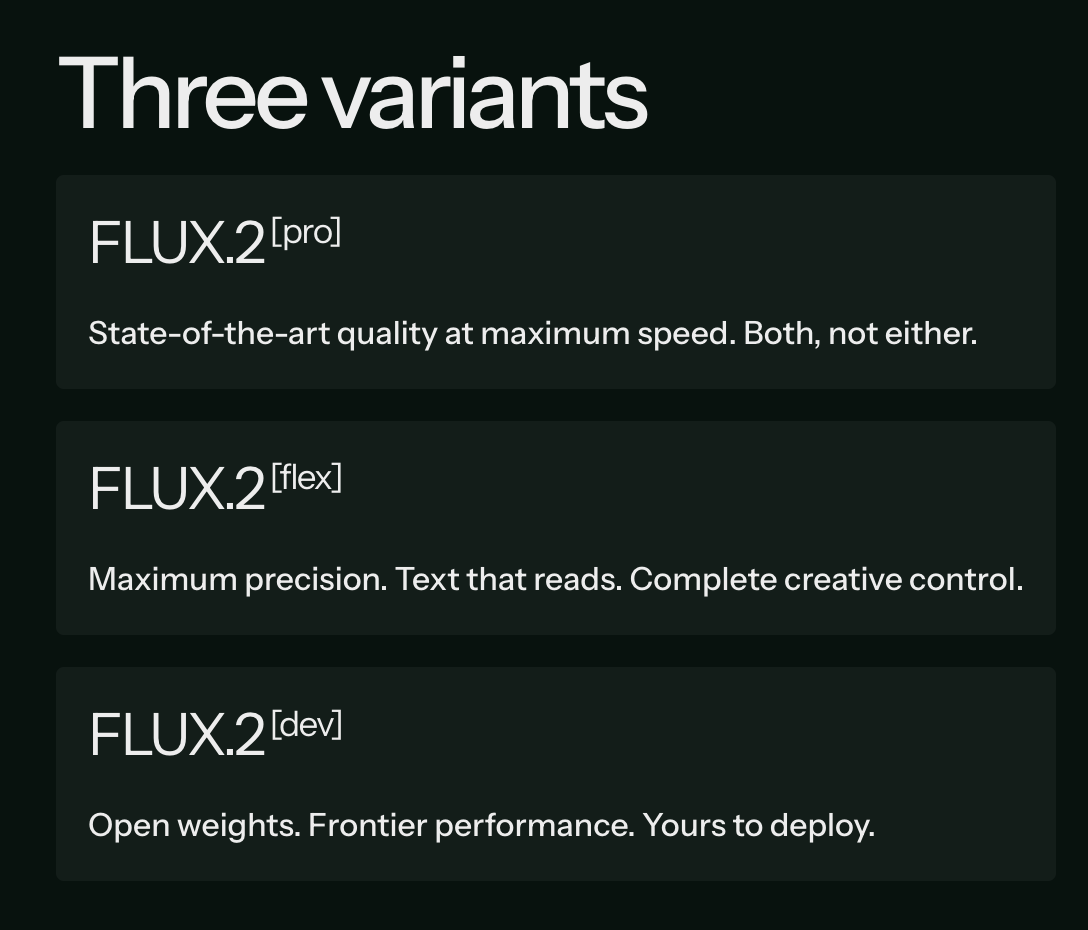
Pro और Flex की तुलना में, Dev वेरिएंट खासकर उन लोगों के लिए डिज़ाइन किया गया है जो प्रयोग करना चाहते हैं, और यह हमारे इंटरैक्टिव कैप्सूल-वार्डरोब ग्रिड के लिए बिल्कुल सही है।
मूल FLUX.2 लाइन पहले से ही शक्तिशाली है, लेकिन FLUX.2-Dev और 4-बिट क्वांटाइज़ेशन इस डेमो को चलाना, इटरेट करना, और बढ़ाना काफी आसान बना देता है। वजहें ये हैं:
संक्षेप में, FLUX.2-Dev (4-बिट) हमें एक इंटरैक्टिव कैप्सूल वार्डरोब टूल के लिए मेमोरी, गति, और गुणवत्ता का बेहतरीन मेल देता है।
इस भाग में, हम Gradio एप्लिकेशन में लिपटे FLUX 2 मॉडल के साथ एक कैप्सूल वार्डरोब विज़ुअलाइज़र लागू करेंगे। उच्च स्तर पर, ऐप तीन काम करता है:
नीचे दिए गए वीडियो में, आप वर्कफ़्लो का संक्षिप्त संस्करण देख सकते हैं। डेमो के लिए वीडियो की गति बढ़ाई गई है (वास्तविक जेनरेशन प्रक्रिया में कई मिनट लग सकते हैं):
सबसे पहले, GitHub से नवीनतम diffusers लाइब्रेरी और अन्य निर्भरताएँ इंस्टॉल करें।
!pip install -q "git+https://github.com/huggingface/diffusers.git@main" \
               "transformers>=4.44.0" accelerate safetensors bitsandbytes gradio pillow
इसके बाद Hugging Face में लॉग इन करें ताकि आप 4-बिट FLUX.2-dev वेट्स पुल कर सकें:
from huggingface_hub import login
login()
निर्देश मिलने पर HF टोकन पास करें और मॉडल पुल करने के लिए HF में लॉग इन करें। फिर एक त्वरित sanity चेक करें कि CUDA उपलब्ध है या नहीं और हम किस GPU पर हैं:
import torch, diffusers, bitsandbytes as bnb
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smi
यदि आप nvidia-smi आउटपुट में अपना GPU देखते हैं और CUDA available: True है, तो आप तैयार हैं।
अब हम diffusers/FLUX.2-dev-bnb-4bit रिपॉजिटरी से 4-बिट FLUX.2-dev कॉम्पोनेंट्स लोड करेंगे।
from diffusers import Flux2Pipeline, Flux2Transformer2DModel
from transformers import Mistral3ForConditionalGeneration
import torch
bnb_repo = "diffusers/FLUX.2-dev-bnb-4bit"
torch_dtype = torch.bfloat16
device = "cuda"
print("Loading 4-bit transformer...")
transformer = Flux2Transformer2DModel.from_pretrained(
    bnb_repo,
    subfolder="transformer",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Loading 4-bit text encoder...")
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
    bnb_repo,
    subfolder="text_encoder",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Building Flux2 pipeline...")
pipe = Flux2Pipeline.from_pretrained(
    bnb_repo,
    transformer=transformer,
    text_encoder=text_encoder,
    torch_dtype=torch_dtype,
).to(device)
pipe.set_progress_bar_config(disable=False)
print("Loaded. Example param device:", next(pipe.transformer.parameters()).device)
एक बार निर्भरताएँ इंस्टॉल हो जाने के बाद, हम diffusers लाइब्रेरी का उपयोग करके FLUX.2 लोड कर सकते हैं और इसे transformers से Mistral 3 टेक्स्ट एनकोडर के साथ पेयर कर सकते हैं। कोड में यह इस प्रकार दिखता है:
Flux2Transformer2DModel: यह डी-नॉइज़िंग प्रक्रिया के लिए जिम्मेदार कोर U-Net जैसे ट्रांसफॉर्मर है और 4-बिट क्वांटाइज़्ड रूप में लोड होता है।Mistral3ForConditionalGeneration: यह मॉडल टेक्स्ट एनकोडर के रूप में उपयोग होता है, जो आपके टेक्स्ट प्रॉम्प्ट को डिफ्यूज़न प्रक्रिया के लिए कंडीशनिंग सिग्नल्स में बदलता है।Flux2Pipeline: यह पाइपलाइन ट्रांसफॉर्मर, टेक्स्ट एनकोडर, और सपोर्टिंग कॉम्पोनेंट्स को एक एकल, कॉल करने योग्य इंटरफ़ेस में संयोजित करती है ताकि इमेज जेनरेशन हो सके।device_map="auto" और torch_dtype=torch.bfloat16 का उपयोग विभिन्न GPU सेटअप्स पर चीज़ों को लचीला रखते हुए मेमोरी-इफिशिएंट बनाए रखता है।
ऐप उपयोगकर्ताओं को कई वार्डरोब इमेज अपलोड करने देता है। हमें कुछ यूटिलिटीज़ चाहिए:
import gradio as gr
import random, json
from typing import List, Union
from PIL import Image
MAX_REFS = 10
def files_to_pil(files: List[Union[str, dict]]) -> List[Image.Image]:
    images = []
    for f in files:
        path = f.get("name") if isinstance(f, dict) else f
        if not path:
            continue
        img = Image.open(path).convert("RGB")
        images.append(img)
    return images
def preprocess_refs(refs: List[Image.Image], max_size: int = 512) -> List[Image.Image]:
    processed = []
    for img in refs:
        img = img.convert("RGB")
        img.thumbnail((max_size, max_size), Image.LANCZOS)
        processed.append(img)
    return processed
ऊपर दिए गए कोड में दो प्रमुख हेल्पर फ़ंक्शंस परिभाषित हैं।
files_to_pil() फ़ंक्शन Gradio द्वारा लौटाए गए फ़ाइल ऑब्जेक्ट्स को लेता है, उनके पथ निकालता है, और प्रत्येक फ़ाइल को RGB PIL.Image के रूप में खोलता है।preprocess_refs() फ़ंक्शन इन इमेजेस को उनका आस्पेक्ट रेशियो बनाए रखते हुए अधिकतम 512 × 512 के आकार में रिज़ाइज़ करता है, जो गति और मेमोरी उपयोग दोनों के लिए महत्वपूर्ण है।इसके अलावा, हम कंडीशनिंग सेट को ओवरलोड होने से बचाने के लिए MAX_REFS = 10 के साथ रेफरेंस इमेज की संख्या सीमित करते हैं।
एक सिंगल फ्लैट टेक्स्ट प्रॉम्प्ट भेजने के बजाय, मैंने एक संरचित JSON-जैसा प्रॉम्प्ट बनाया है जो वर्णन करता है:
def build_outfit_prompt(outfit_indices: List[int], labels: List[str]) -> str:
    item_phrases = [
        f"{labels[idx]} from reference image {idx+1}" for idx in outfit_indices
    ]
    outfit_items_str = ", ".join(item_phrases)
    mistral_prompt = """A professional full-body studio photograph of a high-end fashion editorial shoot, set against a flawless seamless neutral gray backdrop (#f5f5f5) in a controlled studio environment. The scene is bathed in soft, diffused three-point lighting (key, fill, and subtle rim) that eliminates harsh shadows, ensuring even illumination across the subject while preserving dimensionality and texture.
At the center of the frame stands a full-body adult model, exuding quiet confidence in a relaxed yet poised stance—one foot slightly forward, weight balanced, body angled subtly to the right. The model’s expression is natural, with a neutral gaze directed just off-camera, evoking a modern, minimalist lookbook aesthetic.
The outfit—meticulously styled and tailored—is the focal point, captured with ultra-realistic 8K resolution and razor-sharp detail. Fabrics display tactile depth: the weave of knits, the drape of silks, the sheen of leathers, and the crispness of cotton are all rendered with commercial-grade precision. The shallow depth of field (50mm prime lens, f/2.8) keeps the subject in crystalline focus while softly blurring the backdrop, emphasizing the outfit’s textures and proportions.
The composition adheres to classic fashion photography rules: vertical framing, ample headroom, and a slightly dynamic angle (eye-level) that flatters the model’s posture. The color palette is controlled and sophisticated, dominated by the outfit’s hues against the neutral gray, with subtle tonal contrasts to highlight layers and accessories.
Every element—from the studio-quality lighting to the catalog-ready styling—conveys luxury, clarity, and commercial appeal, designed to showcase the outfit as a covetable, high-end ensemble."""
    prompt_dict = {
        "scene": mistral_prompt,
        "subjects": [
            {
                "description": (
                    "The model is styled in an outfit composed of: "
                    + outfit_items_str
                    + ". Each garment should closely match the color, fabric, and key design details of its reference image."
                )
            }
        ]
    }
    return json.dumps(prompt_dict)
build_outfit_prompt() फ़ंक्शन तीन महत्वपूर्ण काम करता है:
outfit_indices और labels का उपयोग करके ऐसे वाक्यांश बनाता है जैसे "reference image 1 से wardrobe piece 1", जिन्हें इस विशेष आउटफिट के लिए चुने गए परिधानों का वर्णन करने वाले एक सिंगल स्ट्रिंग में जोड़ा जाता है।scene और subjects फ़ील्ड वाले prompt_dict में लपेटते हैं, फिर उस डिक्शनरी को JSON में सीरियलाइज़ करते हैं ताकि उसे पाइपलाइन को एक सिंगल प्रॉम्प्ट स्ट्रिंग के रूप में पास किया जा सके।कॉन्सेप्चुअली, हम हर अपलोड की गई वार्डरोब इमेज को “wardrobe piece i” मानते हैं और मॉडल से कहते हैं “wardrobe piece 1, wardrobe piece 3, और wardrobe piece 4 का उपयोग करते हुए एक आउटफिट तैयार करें,” जबकि हर पीस के रंग, फैब्रिक, और प्रमुख डिज़ाइन डिटेल्स को संरक्षित रखें।
नोट: चूँकि हम इस पाइपलाइन में टेक्स्ट एनकोडर के रूप में Mistral मॉडल का उपयोग करते हैं, मैंने Meta प्रॉम्प्टिंग के जरिए लंबे स्टूडियो-वर्णन प्रॉम्प्ट (mistral_prompt) का ड्राफ्ट तैयार करने में भी Mistral का उपयोग किया। इससे शैली उस चीज़ के अनुरूप रहती है जिसकी एनकोडर को “उम्मीद” है, और सीधे कोड में वर्डिंग को ट्यून करना आसान हो जाता है।
डेमो का हृदय capsule_fn है, जो:
def make_grid(images: List[Image.Image], rows: int, cols: int) -> Image.Image:
    w, h = images[0].size
    grid = Image.new("RGB", (cols * w, rows * h), (255, 255, 255))
    for idx, img in enumerate(images):
        r, c = divmod(idx, cols)
        grid.paste(img, (c * w, r * h))
    return grid
def capsule_fn(files, rows, cols, height, width, steps, guidance, seed):
    if not files or len(files) < 2:
        return None
    images = files_to_pil(files)
    images = images[:MAX_REFS]
    refs = preprocess_refs(images, max_size=512)
    labels = [f"wardrobe piece {i+1}" for i in range(len(refs))]
    random.seed(int(seed))
    tiles = []
    num_tiles = rows * cols
    for i in range(num_tiles):
        k = min(len(refs), random.randint(2, 3))
        outfit_idxs = random.sample(range(len(refs)), k=k)
        prompt = build_outfit_prompt(outfit_idxs, labels)
        generator = torch.Generator(device=device).manual_seed(int(seed) + i)
        out = pipe(
            prompt=prompt,
            image=refs,
            height=height,
            width=width,
            num_inference_steps=steps,
            guidance_scale=guidance,
            generator=generator,
        )
        tiles.append(out.images[0])
    grid = make_grid(tiles, rows, cols)
    return grid
ऊपर दिए गए दो फ़ंक्शंस कैप्सूल वार्डरोब डेमो के कोर इंजन का निर्माण करते हैं।
make_grid() फ़ंक्शन पंक्तियाँ × कॉलम लेआउट के लिए पर्याप्त बड़ा एक खाली कैनवस बनाता है, फिर प्रत्येक जेनरेटेड आउटफिट इमेज को सही स्थान पर पेस्ट करता है, और एक सिंगल ग्रिड इमेज तैयार करता है।capsule_fn() फ़ंक्शन उपयोगकर्ता की वार्डरोब इमेजेस को रेफरेंस के रूप में तैयार करता है, प्रति टाइल 2–3 पीसेज़ को रैंडम चुनता है, एक संरचित आउटफिट प्रॉम्प्ट बनाता है, और चुनी गई रेज़ोल्यूशन, स्टेप्स, गाइडेंस, और सीड के साथ FLUX.2 पाइपलाइन को कॉल करता है। यह सभी जेनरेटेड टाइल्स इकट्ठा करता है और make_grid() फ़ंक्शन को पास करता है, ताकि उपयोगकर्ता को मिक्स-एंड-मैच आउटफिट्स का अंतिम ग्रिड दिखे।यह चरण कैप्सूल वार्डरोब इंजन को Gradio ऐप से जोड़ता है। उपयोगकर्ता वार्डरोब इमेज अपलोड करता है, ग्रिड और जेनरेशन सेटिंग्स चुनता है, और बदले में एक संयुक्त आउटफिट ग्रिड प्राप्त करता है।
inputs = [
    gr.File(file_types=["image"], file_count="multiple", label="Wardrobe pieces (2–10 images)"),
    gr.Slider(1, 4, value=2, step=1, label="Grid rows"),
    gr.Slider(1, 4, value=2, step=1, label="Grid cols"),
    gr.Slider(384, 896, value=512, step=64, label="Image height"),
    gr.Slider(256, 640, value=384, step=64, label="Image width"),
    gr.Slider(10, 30, value=16, step=2, label="Diffusion steps"),
    gr.Slider(1.0, 7.0, value=2.5, step=0.5, label="Guidance scale"),
    gr.Number(value=42, precision=0, label="Seed")
]
iface = gr.Interface(
    fn=capsule_fn,
    inputs=inputs,
    outputs=gr.Image(type="pil", label="Capsule wardrobe grid"),
    title="Capsule Wardrobe Visualizer – FLUX.2-dev (4-bit)",
    description="Upload 2–10 product images; mix & match outfits using FLUX.2-dev with multi-image reference.",
)
iface.launch(share=True, debug = True)
हम Gradio ऐप इस प्रकार बनाते हैं:
gr.Interface कॉल इन इनपुट्स को capsule_fn फ़ंक्शन से जोड़ता है और एकल gr.Image आउटपुट घोषित करता है। launch(share=True, debug=True) कॉल Gradio सर्वर शुरू करता है, डेमो के लिए एक पब्लिक शेयर करने योग्य लिंक एक्सपोज़ करता है, और कंसोल में डिबग लॉगिंग सक्षम करता है ताकि किसी भी समस्या का निदान करने में मदद मिले।इंटरफ़ेस लाइव होने के बाद:
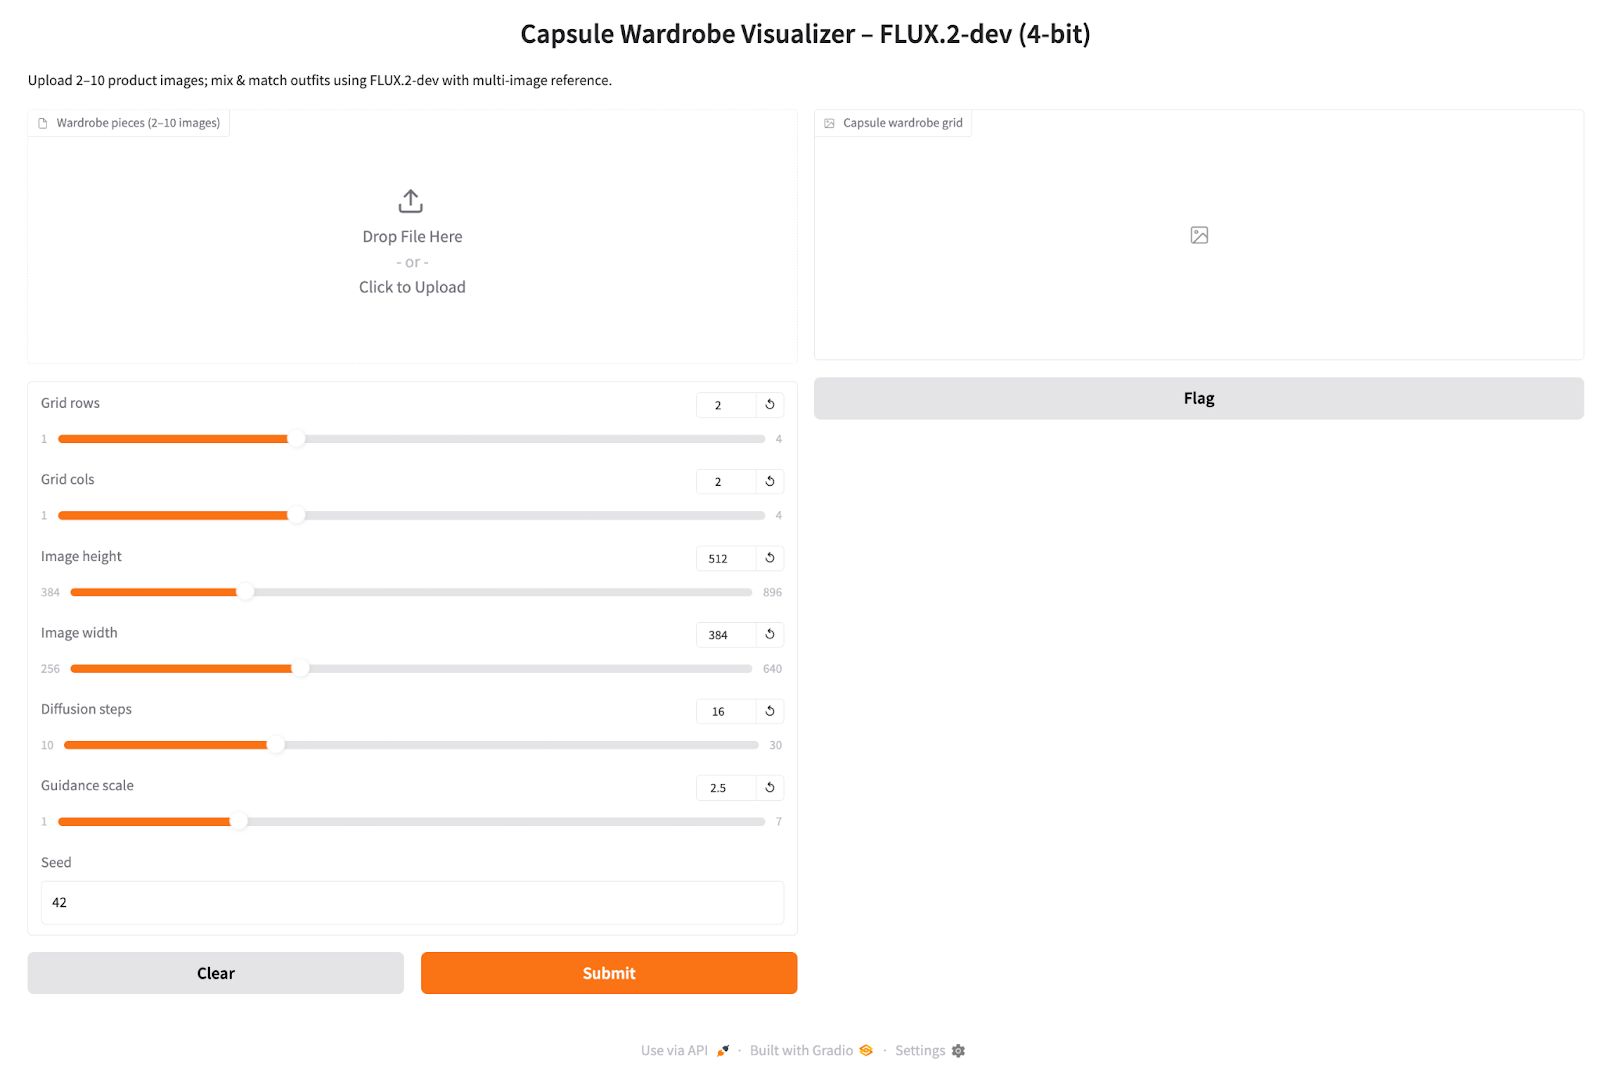
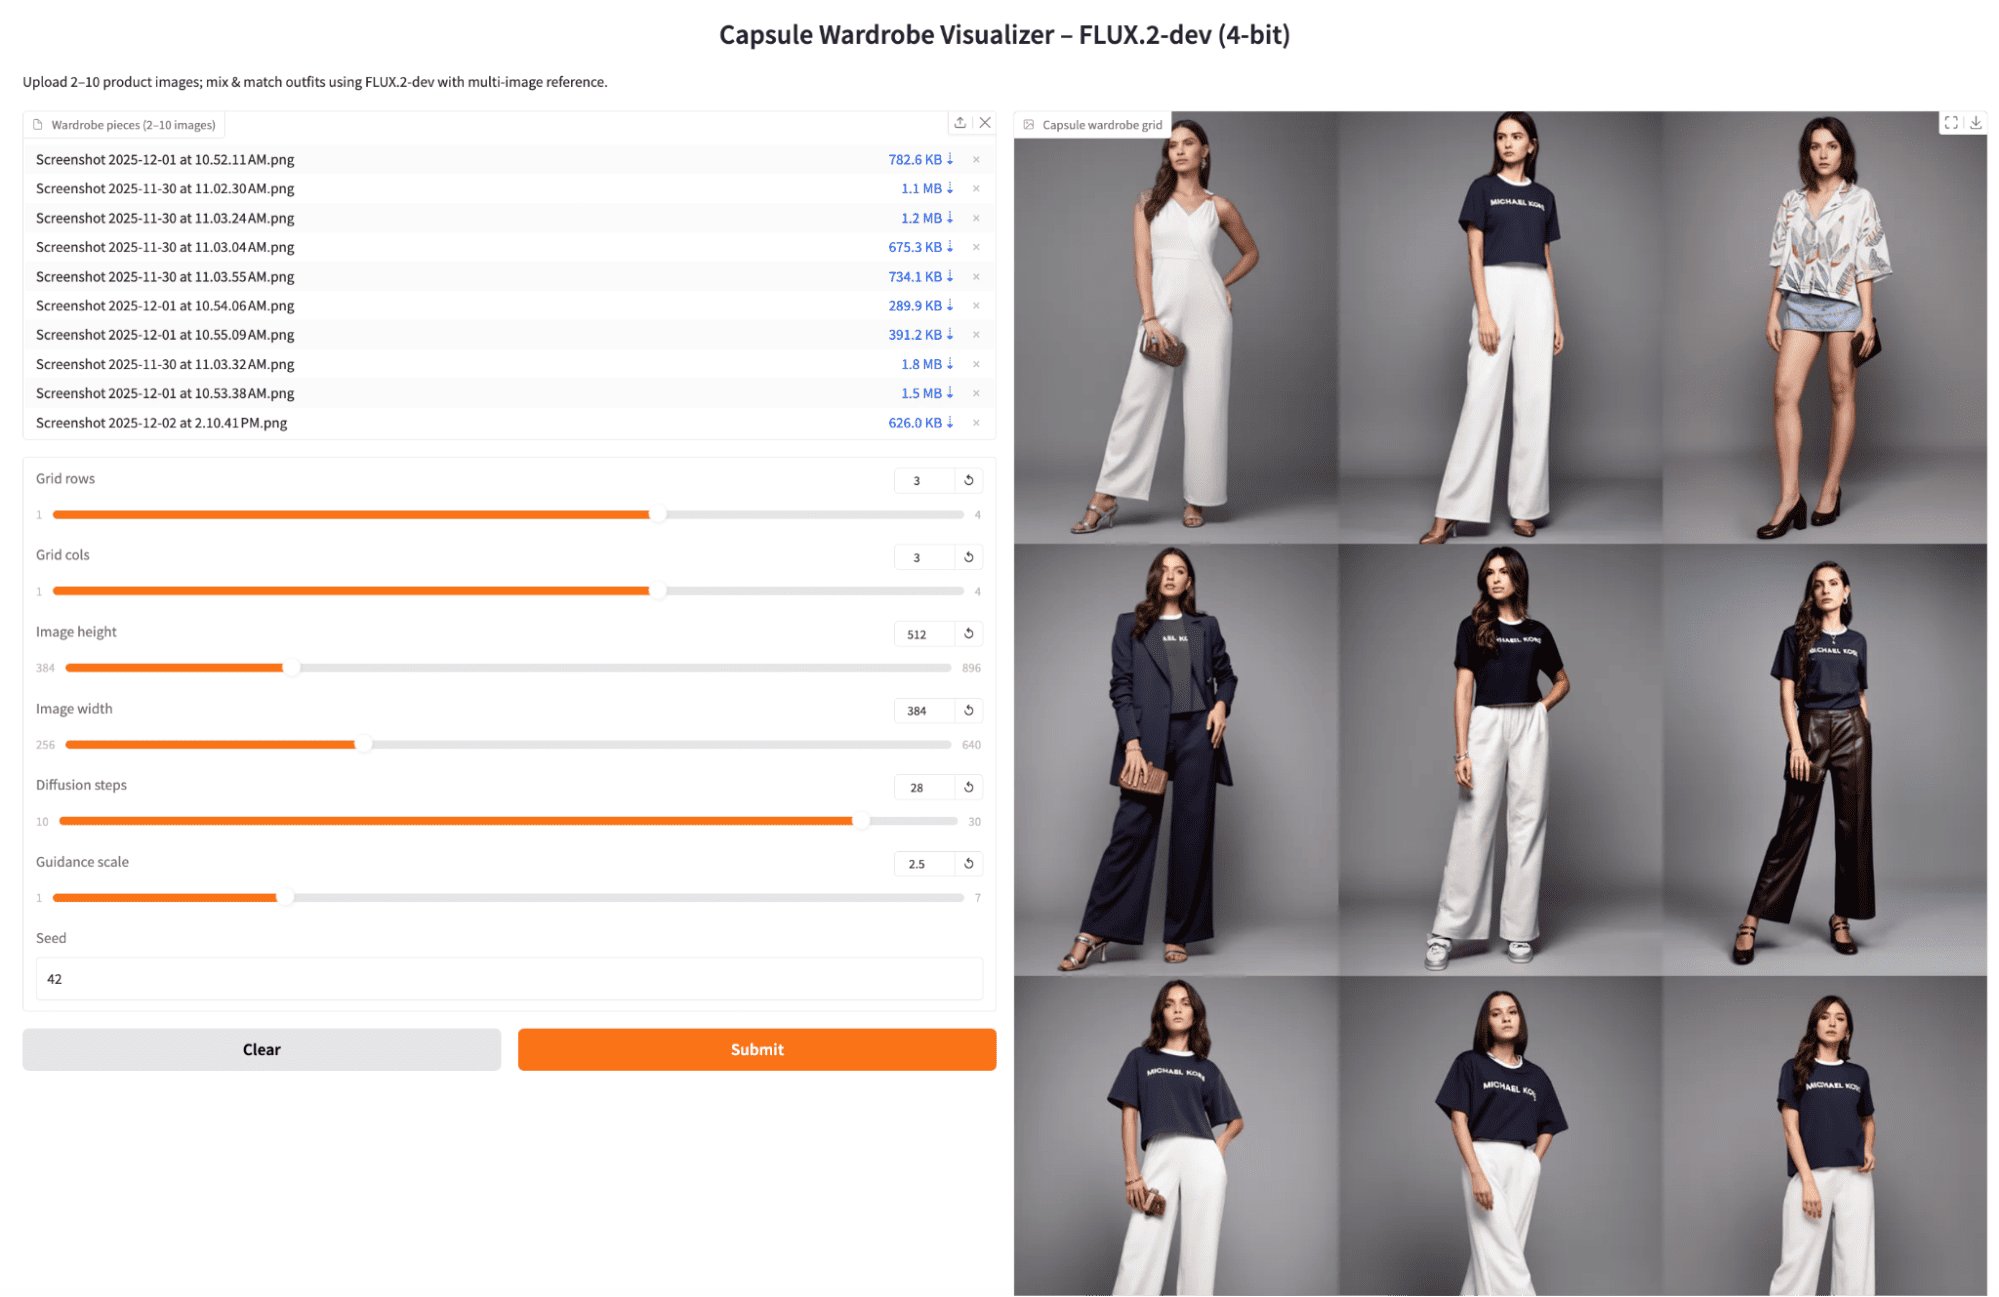
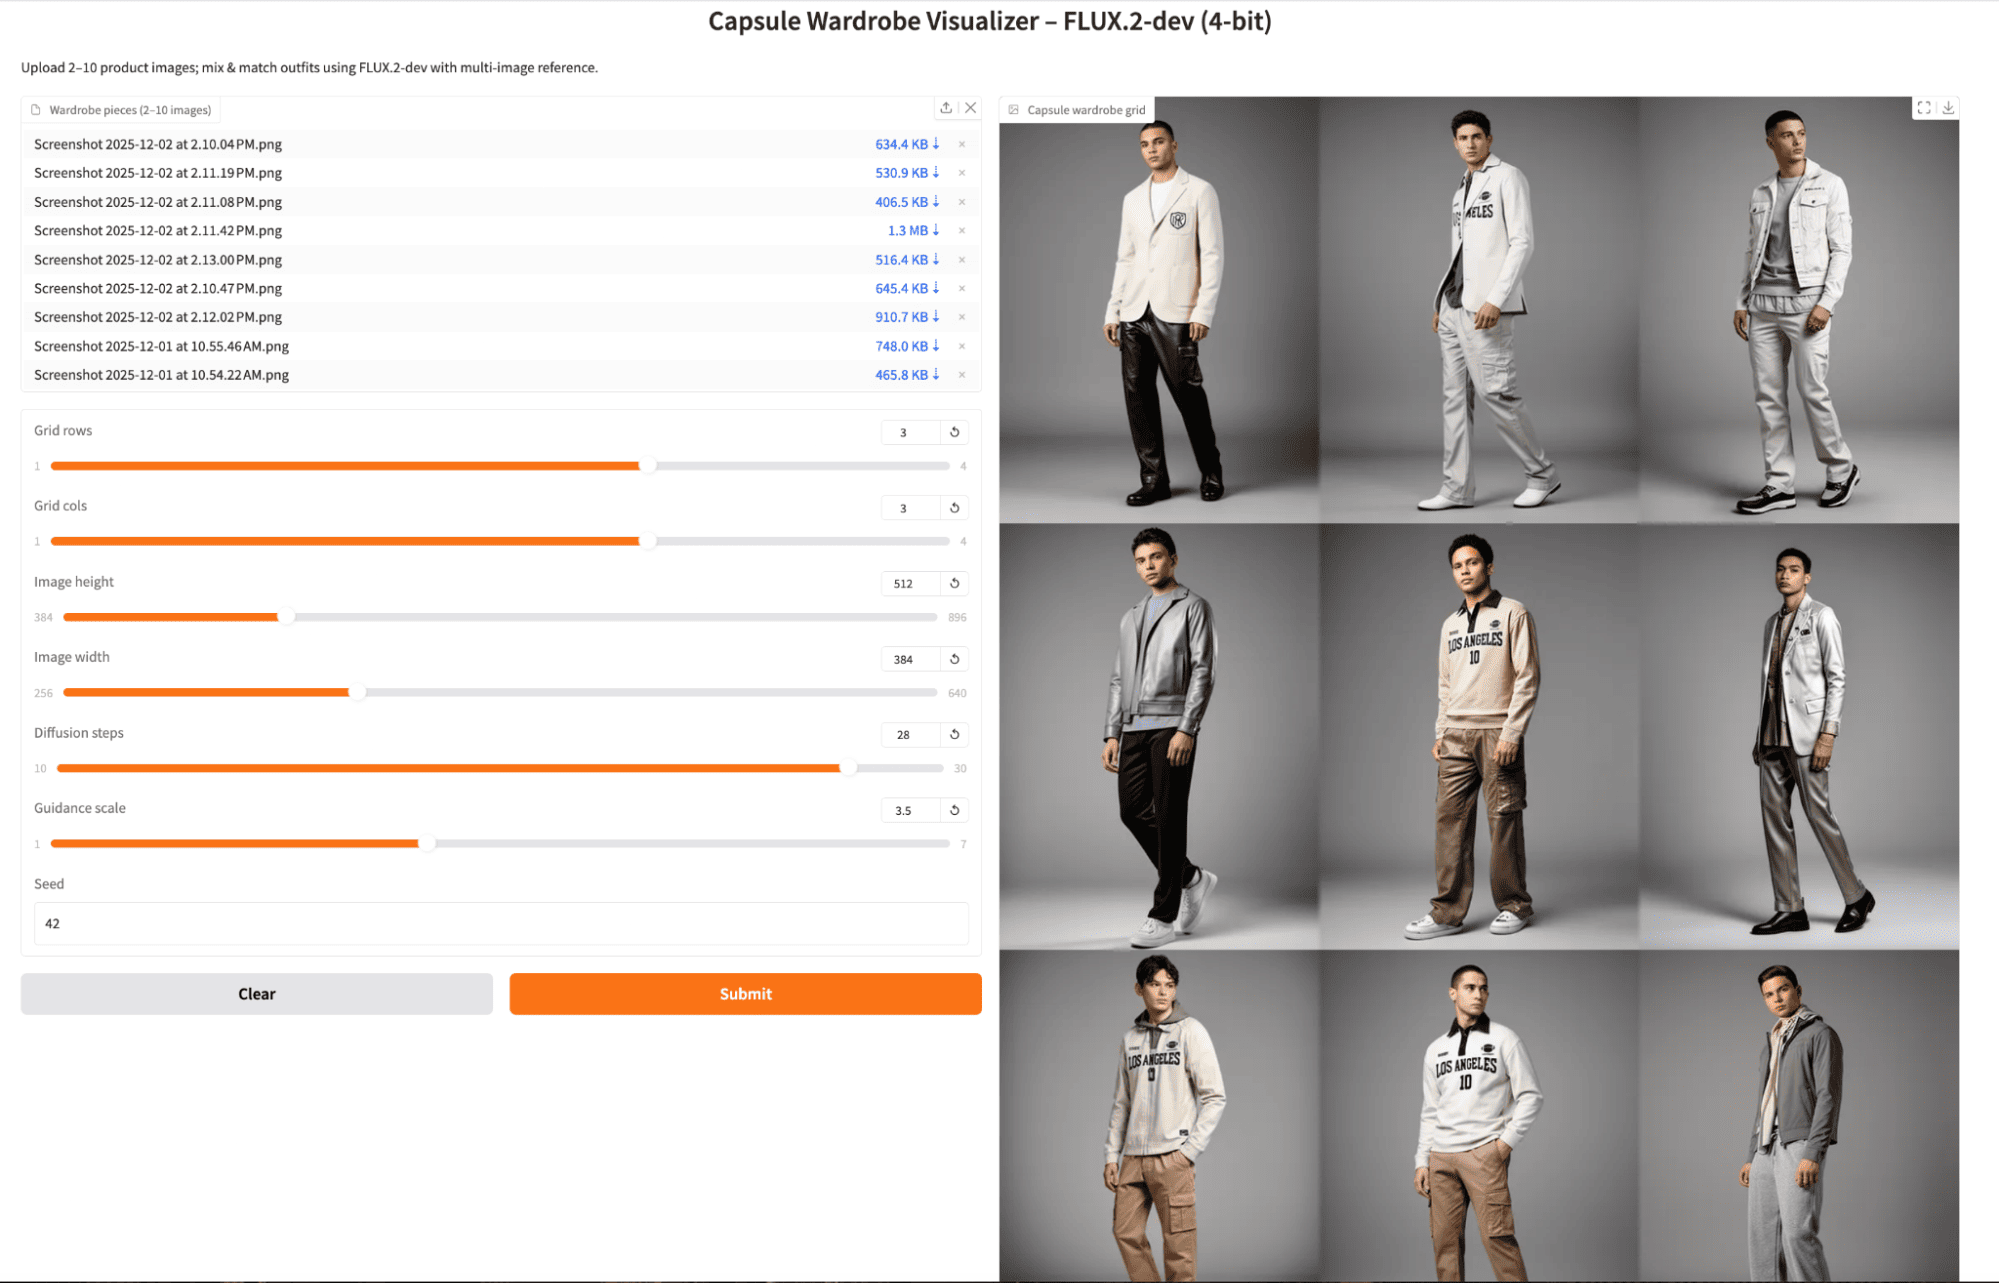
यह समझने के लिए कि व्यवहार में FLUX.2-dev कैसा बर्ताव करता है, मैंने अंतिम ऐप के साथ कुछ छोटे प्रयोग चलाए। मैंने डिफ्यूज़न स्टेप्स और गाइडेंस स्केल में बदलाव किया, और यह भी आज़माया कि एक ही परिधान की कई इमेज और हर यूनिक परिधान की एक-एक इमेज के साथ मॉडल कितना वैरायटी पैदा करता है।
मैंने पहले एक ही आउटफिट की अलग-अलग एंगल्स से ली गई कई इमेज अपलोड कीं, डिफॉल्ट डिफ्यूज़न स्टेप्स और मध्यम गाइडेंस रखा। मॉडल ने सुसंगत स्टूडियो लाइटिंग और फैब्रिक डिटेल्स के साथ, ऐसे आउटफिट्स बनाए जो एक ही कैप्सूल सेट के वैरिएशंस जैसे लगे।
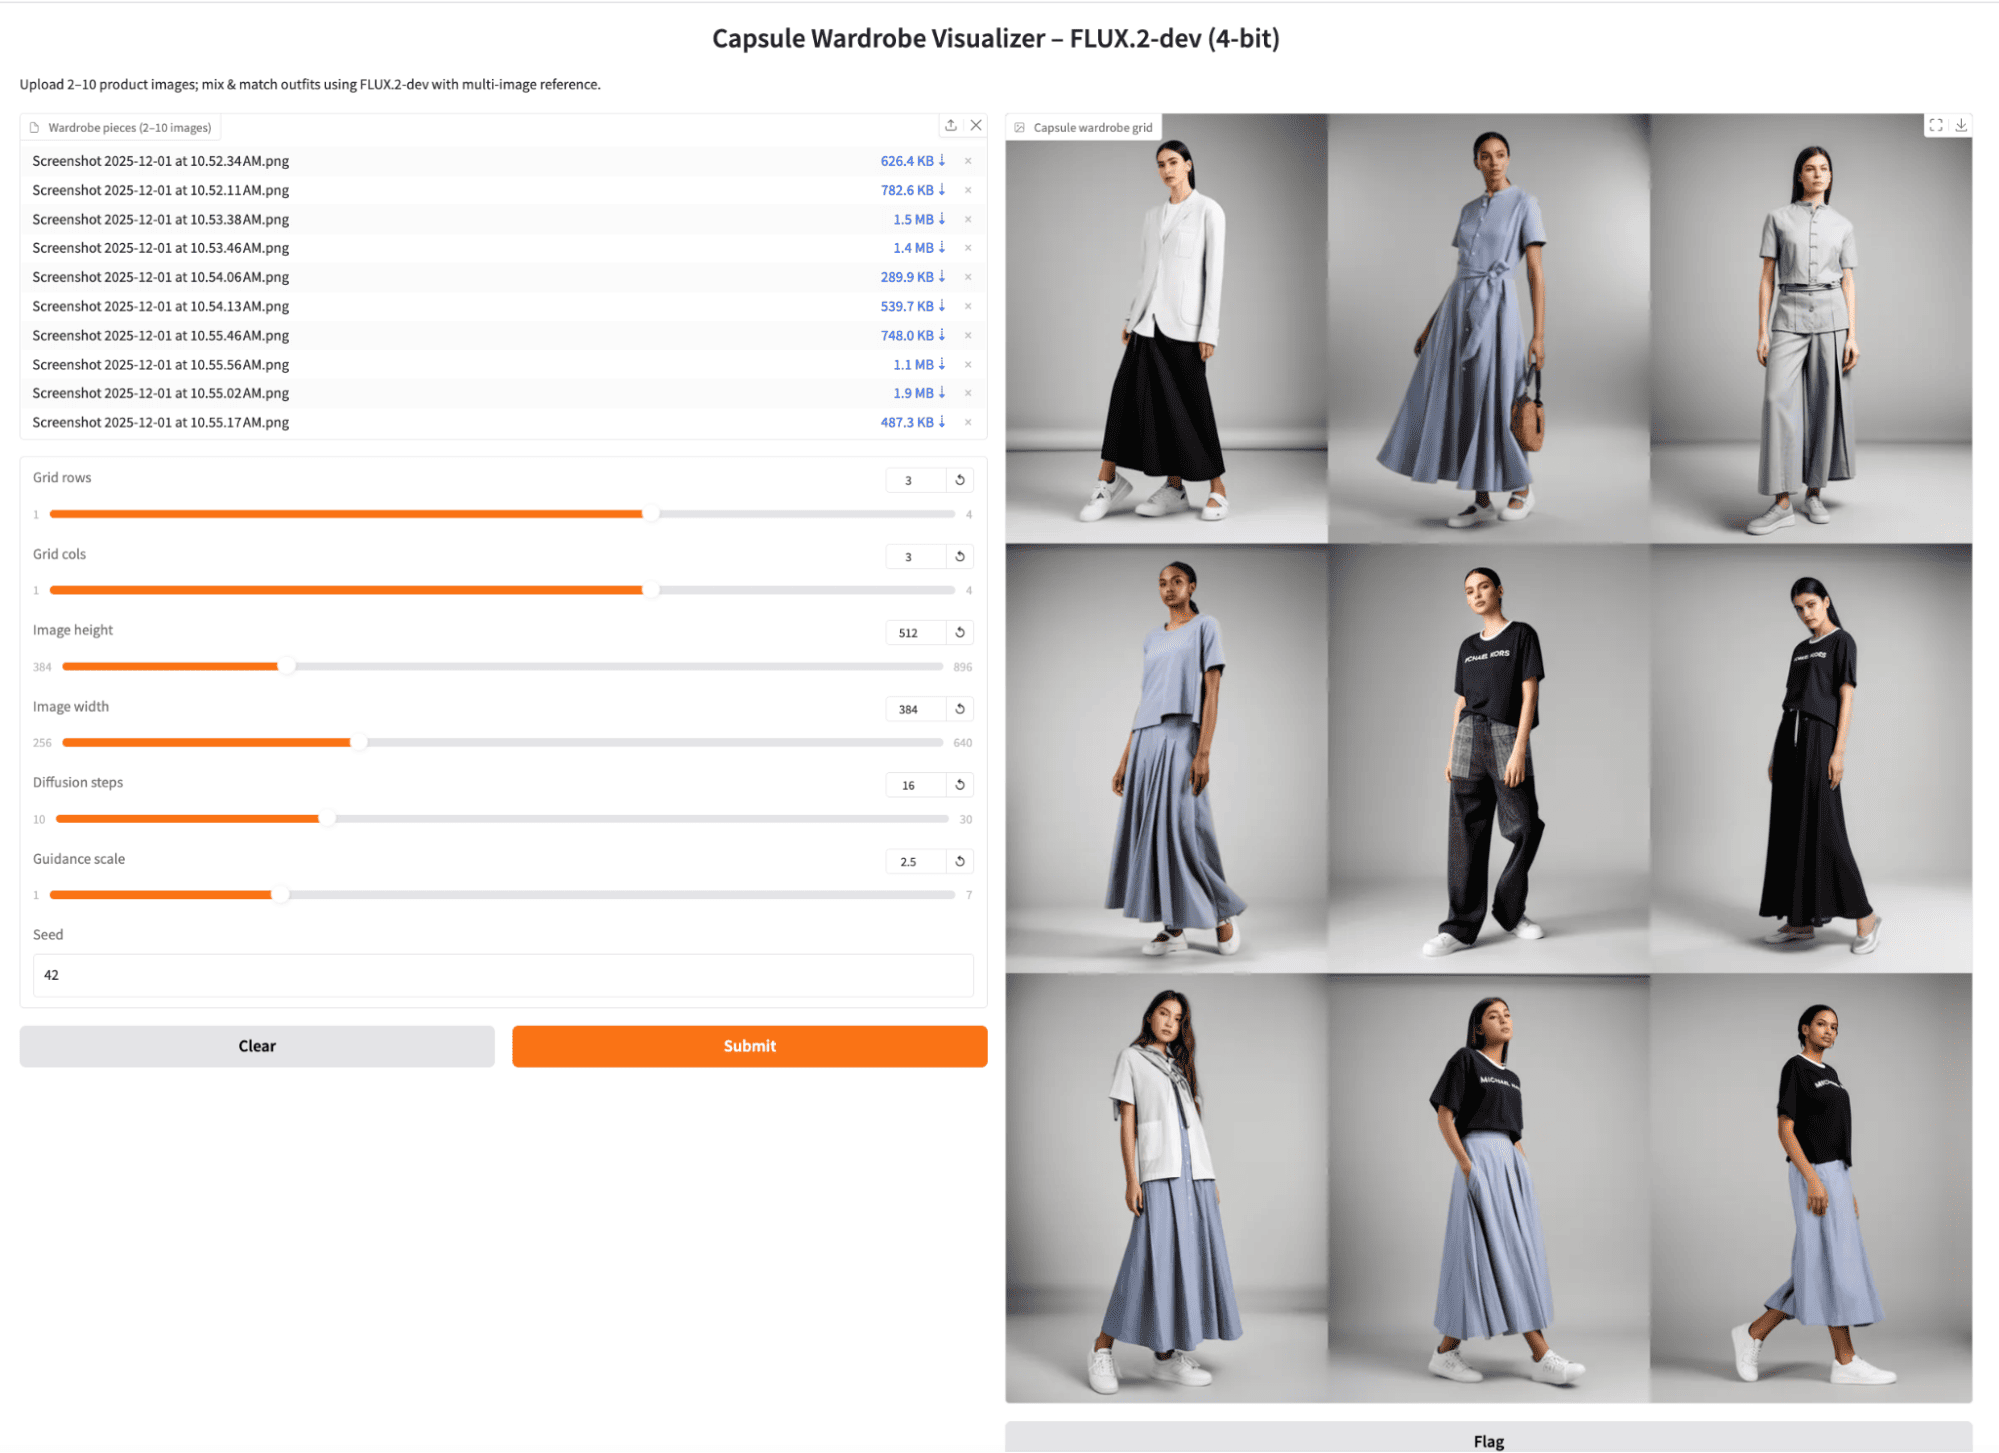
इसके बाद, मैंने वही रेफरेंस इमेज रखीं लेकिन डिफ्यूज़न स्टेप्स को 28 तक बढ़ाया (और गाइडेंस थोड़ा समायोजित किया)। ग्रिड कुछ और शार्प और पॉलिश्ड हो गया, पर अभी भी वही कोर परिधानों को पुनर्संयोजित करने पर केंद्रित रहा। समझौता यह था कि प्रति बैच जेनरेशन समय में थोड़ा लेकिन ध्यान देने योग्य इज़ाफ़ा हुआ।
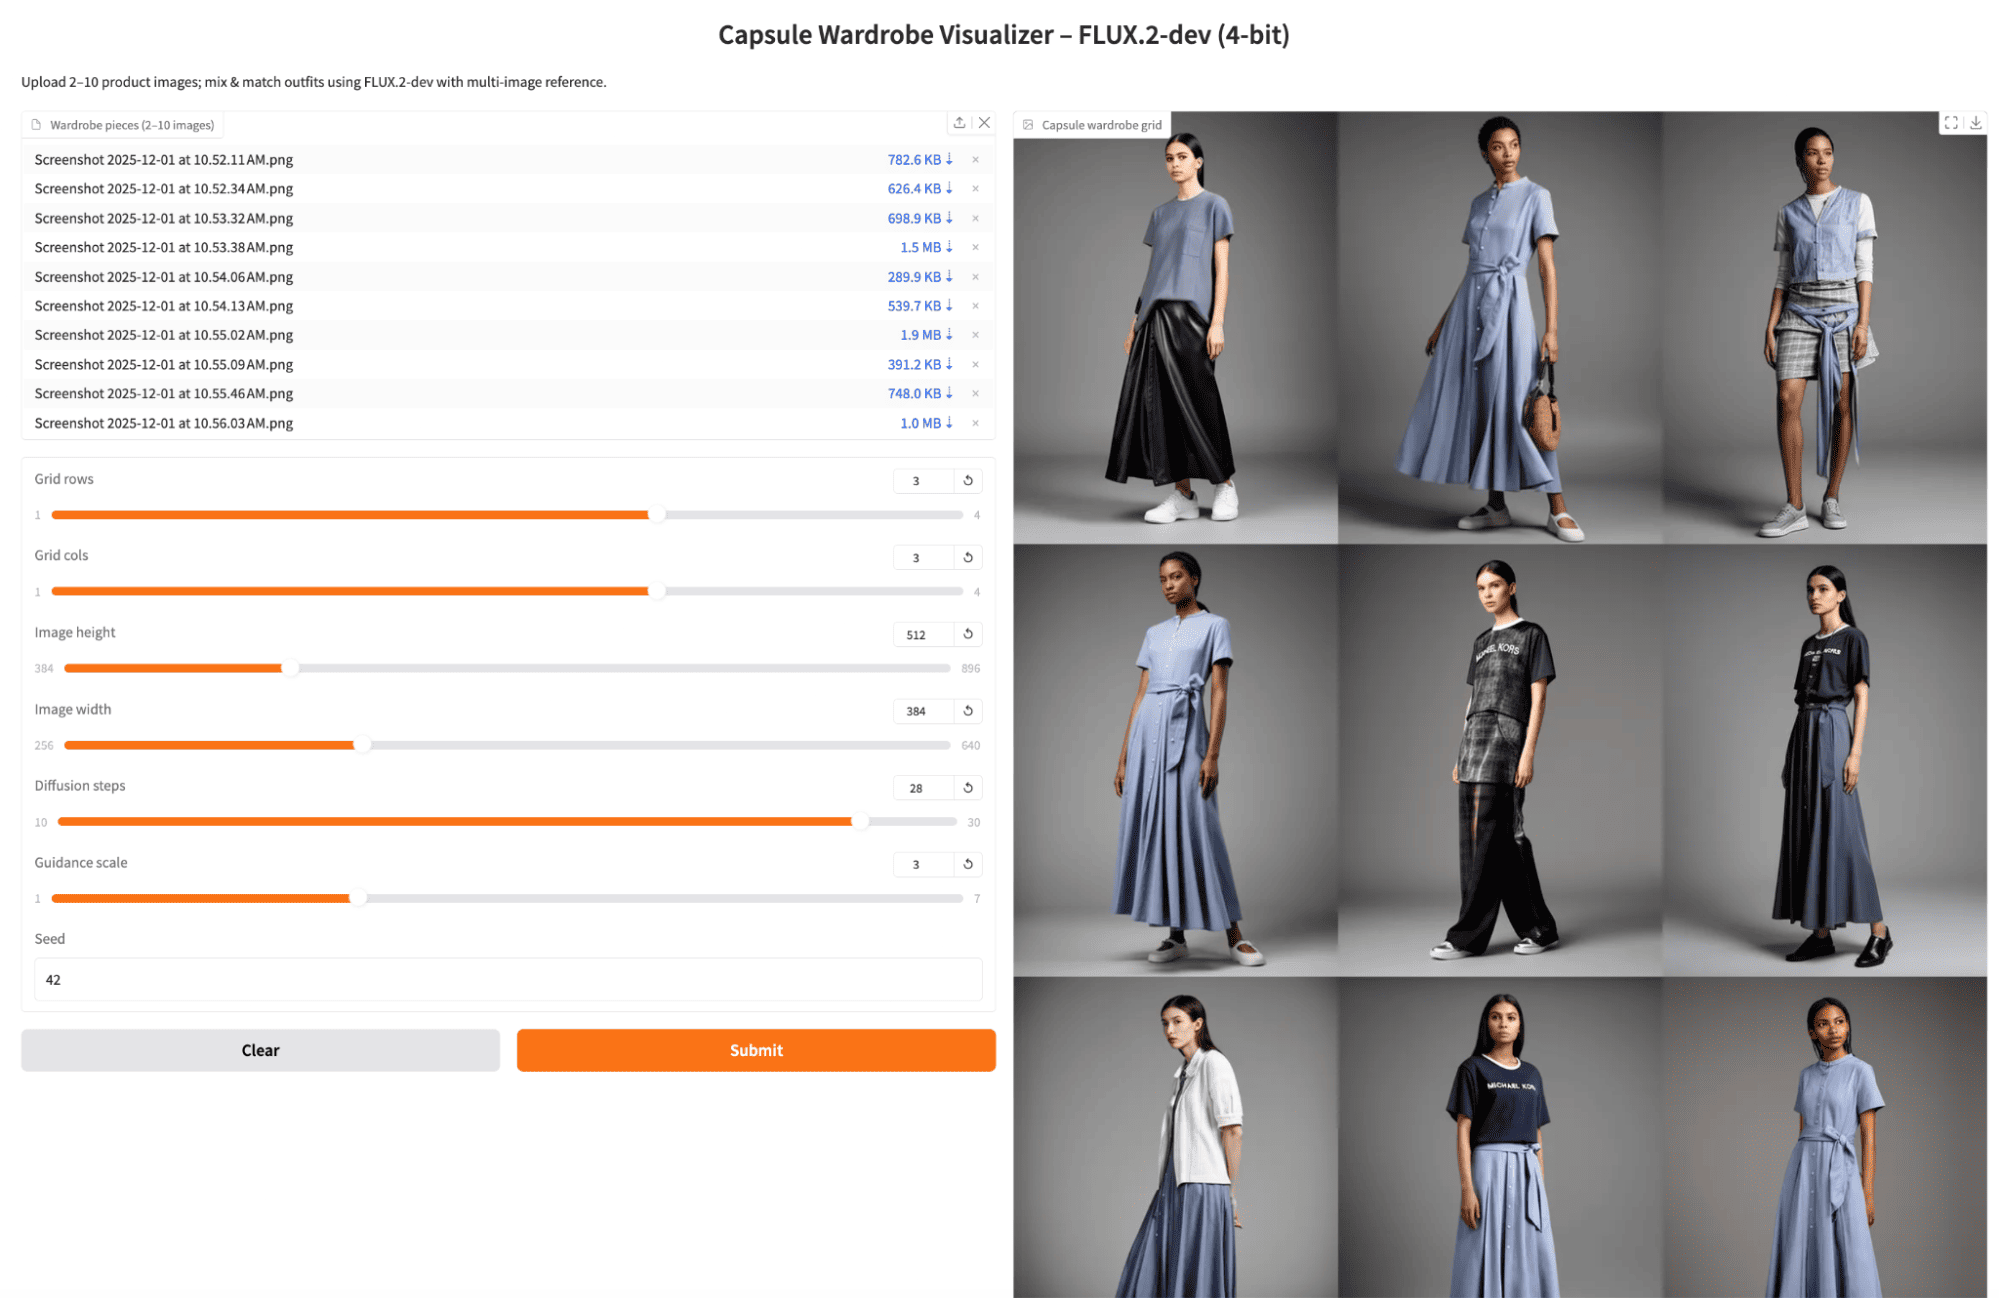
अंत में, मैंने प्रत्येक विशिष्ट परिधान के लिए एक-एक प्रोडक्ट शॉट अपलोड किया और एक और 3x3 ग्रिड जनरेट किया। नतीजे में आने वाले आउटफिट्स सेल्स में कहीं अधिक विविध थे, जो अलग-अलग टॉप्स और बॉटम्स को रोचक तरीकों से मिलाते थे। कुछ रिपीटेशन फिर भी दिखा, पर कुल मिलाकर ग्रिड एक वास्तविक कैप्सूल वार्डरोब के और करीब लगा, जिसमें एक ही सीड और सेटिंग्स पर अधिक विविध कॉम्बिनेशन थे।
4-बिट रूप में FLUX.2-dev इमेज एप्लिकेशन्स के लिए एक बढ़िया मॉडल है। इस ट्यूटोरियल में, हमने diffusers के साथ 4-बिट FLUX.2-dev पाइपलाइन सेटअप की, एक मल्टी-इमेज रेफरेंस वर्कफ़्लो बनाया जो वार्डरोब पीसेज़ को कंडीशनिंग हिंट्स के रूप में लेता है, और सब कुछ Gradio ऐप में रैप किया।
परिणाम एक शक्तिशाली Capsule Wardrobe Visualizer है, जो फैशन ई-कॉमर्स टूलिंग के लिए प्रोटोटाइप के रूप में काम कर सकता है, या बस अपनी अलमारी को खेल-खेल में रीमिक्स करने का तरीका हो सकता है। यहाँ से, आप इसी पाइपलाइन को व्यापक एजेंटिक सिस्टम्स में प्लग कर सकते हैं, जैसे कोई LLM जो ड्रेस कोड या मौसम के आधार पर आउटफिट सुझाए, या इसे किसी वास्तविक प्रोडक्ट कैटलॉग बैकएंड से जोड़ें।
शीर्ष DataCamp कोर्स
course
course
course