

Bước 1: Thiết lập môi trường
Đầu tiên, cài đặt thư viện diffusers mới nhất từ GitHub và các phụ thuộc khác.
!pip install -q "git+https://github.com/huggingface/diffusers.git@main" \
"transformers>=4.44.0" accelerate safetensors bitsandbytes gradio pillowSau đó đăng nhập Hugging Face để bạn có thể tải trọng số FLUX.2-dev 4-bit:
from huggingface_hub import login
login() Truyền HF Token khi được nhắc và đăng nhập HF để kéo mô hình. Tiếp đến, thực hiện kiểm tra nhanh để xem CUDA có sẵn không và ta đang dùng GPU nào:
import torch, diffusers, bitsandbytes as bnb
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smiNếu bạn thấy GPU của mình trong đầu ra nvidia-smi và CUDA available: True, bạn đã sẵn sàng.
Bước 2: Mô hình FLUX.2-dev (4-bit)
Giờ chúng ta tải các thành phần FLUX.2-dev 4-bit từ repo diffusers/FLUX.2-dev-bnb-4bit.
from diffusers import Flux2Pipeline, Flux2Transformer2DModel
from transformers import Mistral3ForConditionalGeneration
import torch
bnb_repo = "diffusers/FLUX.2-dev-bnb-4bit"
torch_dtype = torch.bfloat16
device = "cuda"
print("Loading 4-bit transformer...")
transformer = Flux2Transformer2DModel.from_pretrained(
bnb_repo,
subfolder="transformer",
torch_dtype=torch_dtype,
device_map="auto",
)
print("Loading 4-bit text encoder...")
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
bnb_repo,
subfolder="text_encoder",
torch_dtype=torch_dtype,
device_map="auto",
)
print("Building Flux2 pipeline...")
pipe = Flux2Pipeline.from_pretrained(
bnb_repo,
transformer=transformer,
text_encoder=text_encoder,
torch_dtype=torch_dtype,
).to(device)
pipe.set_progress_bar_config(disable=False)
print("Loaded. Example param device:", next(pipe.transformer.parameters()).device)Khi đã cài đặt phụ thuộc, ta có thể tải FLUX.2 bằng thư viện diffusers và ghép với bộ mã hóa văn bản Mistral 3 từ transformers. Cụ thể trong code như sau:
Flux2Transformer2DModel: Lõi transformer dạng U-Net chịu trách nhiệm khử nhiễu, được tải ở dạng lượng tử 4-bit.Mistral3ForConditionalGeneration: Mô hình dùng làm bộ mã hóa văn bản, biến prompt của bạn thành tín hiệu điều kiện cho quá trình khuếch tán.Flux2Pipeline: Pipeline tổng hợp transformer, bộ mã hóa văn bản và các thành phần hỗ trợ vào một giao diện gọi duy nhất để sinh ảnh.
Dùng device_map="auto" và torch_dtype=torch.bfloat16 giúp linh hoạt trên nhiều thiết lập GPU khác nhau trong khi vẫn tiết kiệm bộ nhớ.
Bước 3: Tiền xử lý ảnh
Ứng dụng cho phép người dùng tải lên nhiều ảnh tủ đồ. Ta cần một vài tiện ích để làm việc này:
- Chuyển đối tượng tệp của Gradio thành ảnh PIL
- Resize về kích thước phù hợp để điều kiện hóa
import gradio as gr
import random, json
from typing import List, Union
from PIL import Image
MAX_REFS = 10
def files_to_pil(files: List[Union[str, dict]]) -> List[Image.Image]:
images = []
for f in files:
path = f.get("name") if isinstance(f, dict) else f
if not path:
continue
img = Image.open(path).convert("RGB")
images.append(img)
return images
def preprocess_refs(refs: List[Image.Image], max_size: int = 512) -> List[Image.Image]:
processed = []
for img in refs:
img = img.convert("RGB")
img.thumbnail((max_size, max_size), Image.LANCZOS)
processed.append(img)
return processedĐoạn code trên định nghĩa hai hàm trợ giúp chính.
- Hàm
files_to_pil()nhận các đối tượng tệp do Gradio trả về, trích xuất đường dẫn và mở mỗi tệp dưới dạngPIL.ImageRGB. - Hàm
preprocess_refs()resize các ảnh này về kích thước tối đa 512 × 512 trong khi giữ nguyên tỉ lệ, điều quan trọng cho cả tốc độ và bộ nhớ.
Ngoài ra, ta giới hạn số ảnh tham chiếu với MAX_REFS = 10 để không quá tải tập điều kiện hóa.
Bước 4: Prompt cho trang phục
Thay vì gửi một prompt văn bản phẳng, tôi tạo một prompt có cấu trúc kiểu JSON mô tả:
- Bối cảnh studio
- Chủ thể và tư thế
- Các món đồ trang phục (liên kết với ảnh tham chiếu)
- Ánh sáng, tâm trạng và thông tin máy ảnh
def build_outfit_prompt(outfit_indices: List[int], labels: List[str]) -> str:
item_phrases = [
f"{labels[idx]} from reference image {idx+1}" for idx in outfit_indices
]
outfit_items_str = ", ".join(item_phrases)
mistral_prompt = """A professional full-body studio photograph of a high-end fashion editorial shoot, set against a flawless seamless neutral gray backdrop (#f5f5f5) in a controlled studio environment. The scene is bathed in soft, diffused three-point lighting (key, fill, and subtle rim) that eliminates harsh shadows, ensuring even illumination across the subject while preserving dimensionality and texture.
At the center of the frame stands a full-body adult model, exuding quiet confidence in a relaxed yet poised stance—one foot slightly forward, weight balanced, body angled subtly to the right. The model’s expression is natural, with a neutral gaze directed just off-camera, evoking a modern, minimalist lookbook aesthetic.
The outfit—meticulously styled and tailored—is the focal point, captured with ultra-realistic 8K resolution and razor-sharp detail. Fabrics display tactile depth: the weave of knits, the drape of silks, the sheen of leathers, and the crispness of cotton are all rendered with commercial-grade precision. The shallow depth of field (50mm prime lens, f/2.8) keeps the subject in crystalline focus while softly blurring the backdrop, emphasizing the outfit’s textures and proportions.
The composition adheres to classic fashion photography rules: vertical framing, ample headroom, and a slightly dynamic angle (eye-level) that flatters the model’s posture. The color palette is controlled and sophisticated, dominated by the outfit’s hues against the neutral gray, with subtle tonal contrasts to highlight layers and accessories.
Every element—from the studio-quality lighting to the catalog-ready styling—conveys luxury, clarity, and commercial appeal, designed to showcase the outfit as a covetable, high-end ensemble."""
prompt_dict = {
"scene": mistral_prompt,
"subjects": [
{
"description": (
"The model is styled in an outfit composed of: "
+ outfit_items_str
+ ". Each garment should closely match the color, fabric, and key design details of its reference image."
)
}
]
}
return json.dumps(prompt_dict)Hàm build_outfit_prompt() làm ba việc quan trọng:
- Thứ nhất, dùng
outfit_indicesvàlabelsđể tạo các cụm như "món tủ đồ 1 từ ảnh tham chiếu 1", rồi nối thành một chuỗi mô tả các món đồ được chọn cho outfit này. - Thứ hai, nhúng các món đồ này vào một mistral_prompt ngôn ngữ tự nhiên định nghĩa môi trường studio, thiết lập ánh sáng, ống kính, độ sâu trường ảnh, v.v.
- Cuối cùng, ta bọc mọi thứ vào
prompt_dictvới trường scene và subjects, rồi tuần tự hóa thành JSON để truyền như một chuỗi prompt duy nhất cho pipeline.
Về ý tưởng, ta coi mỗi ảnh tủ đồ tải lên là “món tủ đồ i” và yêu cầu mô hình “phối một outfit dùng món 1, món 3 và món 4”, đồng thời giữ nguyên màu sắc, chất liệu và chi tiết thiết kế chính của từng món.
Lưu ý: Vì ta dùng một mô hình Mistral làm bộ mã hóa văn bản trong pipeline này, tôi cũng dùng Mistral để hỗ trợ soạn prompt mô tả studio dài (mistral_prompt) qua Meta prompting. Cách này giữ phong cách phù hợp với những gì bộ mã hóa “mong đợi” và giúp dễ chỉnh sửa câu chữ trực tiếp trong code.
Bước 5: Sinh lưới trang phục
Trọng tâm của demo là capsule_fn, hàm này:
- Nhận ảnh tải lên và các tham số UI
- Chọn ngẫu nhiên các tập con món tủ đồ cho mỗi ô
- Sau đó gọi pipeline FLUX.2-dev để sinh nhiều ảnh
- Cuối cùng, ghép chúng thành một lưới duy nhất
def make_grid(images: List[Image.Image], rows: int, cols: int) -> Image.Image:
w, h = images[0].size
grid = Image.new("RGB", (cols * w, rows * h), (255, 255, 255))
for idx, img in enumerate(images):
r, c = divmod(idx, cols)
grid.paste(img, (c * w, r * h))
return grid
def capsule_fn(files, rows, cols, height, width, steps, guidance, seed):
if not files or len(files) < 2:
return None
images = files_to_pil(files)
images = images[:MAX_REFS]
refs = preprocess_refs(images, max_size=512)
labels = [f"wardrobe piece {i+1}" for i in range(len(refs))]
random.seed(int(seed))
tiles = []
num_tiles = rows * cols
for i in range(num_tiles):
k = min(len(refs), random.randint(2, 3))
outfit_idxs = random.sample(range(len(refs)), k=k)
prompt = build_outfit_prompt(outfit_idxs, labels)
generator = torch.Generator(device=device).manual_seed(int(seed) + i)
out = pipe(
prompt=prompt,
image=refs,
height=height,
width=width,
num_inference_steps=steps,
guidance_scale=guidance,
generator=generator,
)
tiles.append(out.images[0])
grid = make_grid(tiles, rows, cols)
return gridHai hàm trên tạo thành động cơ cốt lõi của demo capsule wardrobe.
- Hàm
make_grid()tạo một canvas trống đủ lớn cho bố cục hàng × cột, rồi dán từng ảnh outfit sinh vào vị trí đúng, tạo ra một ảnh lưới duy nhất. - Hàm
capsule_fn()chuẩn bị ảnh tủ đồ của người dùng làm tham chiếu, chọn ngẫu nhiên 2–3 món mỗi ô, xây prompt outfit có cấu trúc, và gọi pipeline FLUX.2 với độ phân giải, số bước, guidance và seed đã chọn. Nó thu thập tất cả các ô sinh được và chuyển chomake_grid()để người dùng thấy lưới phối đồ cuối cùng.
Bước 6: Giao diện Gradio
Bước này kết nối động cơ capsule wardrobe với ứng dụng Gradio. Người dùng tải ảnh tủ đồ, chọn cài đặt lưới và sinh, và nhận lại lưới outfit tổng hợp.
inputs = [
gr.File(file_types=["image"], file_count="multiple", label="Wardrobe pieces (2–10 images)"),
gr.Slider(1, 4, value=2, step=1, label="Grid rows"),
gr.Slider(1, 4, value=2, step=1, label="Grid cols"),
gr.Slider(384, 896, value=512, step=64, label="Image height"),
gr.Slider(256, 640, value=384, step=64, label="Image width"),
gr.Slider(10, 30, value=16, step=2, label="Diffusion steps"),
gr.Slider(1.0, 7.0, value=2.5, step=0.5, label="Guidance scale"),
gr.Number(value=42, precision=0, label="Seed")
]
iface = gr.Interface(
fn=capsule_fn,
inputs=inputs,
outputs=gr.Image(type="pil", label="Capsule wardrobe grid"),
title="Capsule Wardrobe Visualizer – FLUX.2-dev (4-bit)",
description="Upload 2–10 product images; mix & match outfits using FLUX.2-dev with multi-image reference.",
)
iface.launch(share=True, debug = True)Cách ta xây ứng dụng Gradio:
- Danh sách inputs định nghĩa tất cả điều khiển tương tác cho ứng dụng. Input món tủ đồ là tải nhiều tệp cho 2–10 ảnh quần áo hoặc sản phẩm, trong khi các thanh trượt hàng và cột đặt hình dạng lưới, tức số outfit sinh mỗi đợt.
- Các thanh trượt chiều cao và chiều rộng ảnh điều khiển độ phân giải mỗi ô; giá trị cao hơn dùng nhiều VRAM và thời gian hơn.
- Thanh trượt số bước khuếch tán quyết định số bước khử nhiễu mô hình chạy (16–24 là mặc định tốt), và guidance scale điều khiển mức mô hình bám theo prompt văn bản so với ảnh tham chiếu.
- Lệnh
gr.Interfacekết nối các input này với hàmcapsule_fnvà khai báo một outputgr.Imageduy nhất. Lệnhlaunch(share=True, debug=True)khởi động máy chủ Gradio, cung cấp liên kết chia sẻ công khai cho demo và bật ghi log debug trong console để hỗ trợ chẩn đoán sự cố.
Khi giao diện đã chạy:
- Tải một bộ nhỏ món quần áo (ví dụ, 2 áo, 2 quần, 1 áo khoác, 1 đôi giày).
- Chọn lưới 3x3 hoặc 2x2, độ phân giải 512x384, ~20 bước, và guidance 2.5.
- Nhấn Submit và xem lưới được lấp đầy bằng ảnh phong cách editorial.
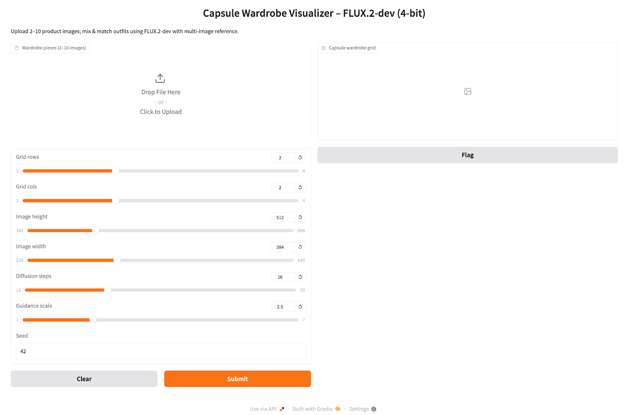
Ví dụ và nhận xét về Flux 2
Để hiểu FLUX.2-dev hoạt động thực tế ra sao, tôi đã chạy vài thử nghiệm nhỏ với ứng dụng cuối. Tôi thay đổi số bước khuếch tán và guidance, và thử cả nhiều ảnh của cùng một món đồ lẫn mỗi ảnh cho một món độc nhất để xem mô hình tạo ra mức đa dạng thế nào.
- Số bước khuếch tán và guidance chủ yếu ảnh hưởng tốc độ và độ sắc nét, không ảnh hưởng bộ nhớ. Tăng số bước từ 28 lên 30 và guidance từ 2.5 lên 5.0 giữ mức dùng VRAM gần như không đổi nhưng làm mỗi lô chậm hơn chút, đồng thời cho outfit sắc sảo. Tuy nhiên, về lý thuyết, số bước rất cao (như 50) có thể làm thay đổi đáng kể diện mạo lưới và tăng độ trễ với chất lượng cao hơn.
- Trên A100, 4-bit là mặc định rất thoải mái. Với checkpoint FLUX.2-dev 4-bit, lưới 3x3 ở 512x384 với ~20–28 bước cho cảm giác nhanh và an toàn cho demo một GPU. Nếu bạn có H100 và có thể tải checkpoint gốc (không lượng tử), bạn thường đạt chất lượng ảnh cao hơn với độ trễ tương tự. Tất nhiên, trải nghiệm thực tế phụ thuộc VRAM và kích thước lô.
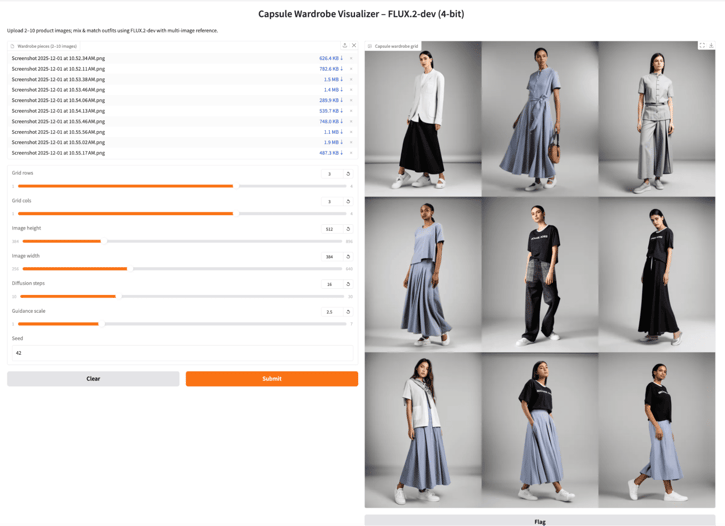
Ví dụ 1: Thiết lập mặc định với nhiều góc chụp của cùng một món
Đầu tiên, tôi tải lên vài ảnh của cùng một outfit chụp từ các góc khác nhau, giữ số bước khuếch tán mặc định và guidance vừa phải. Mô hình tạo ánh sáng studio nhất quán và chi tiết chất liệu tốt, với các outfit giống như biến thể của một bộ capsule duy nhất.
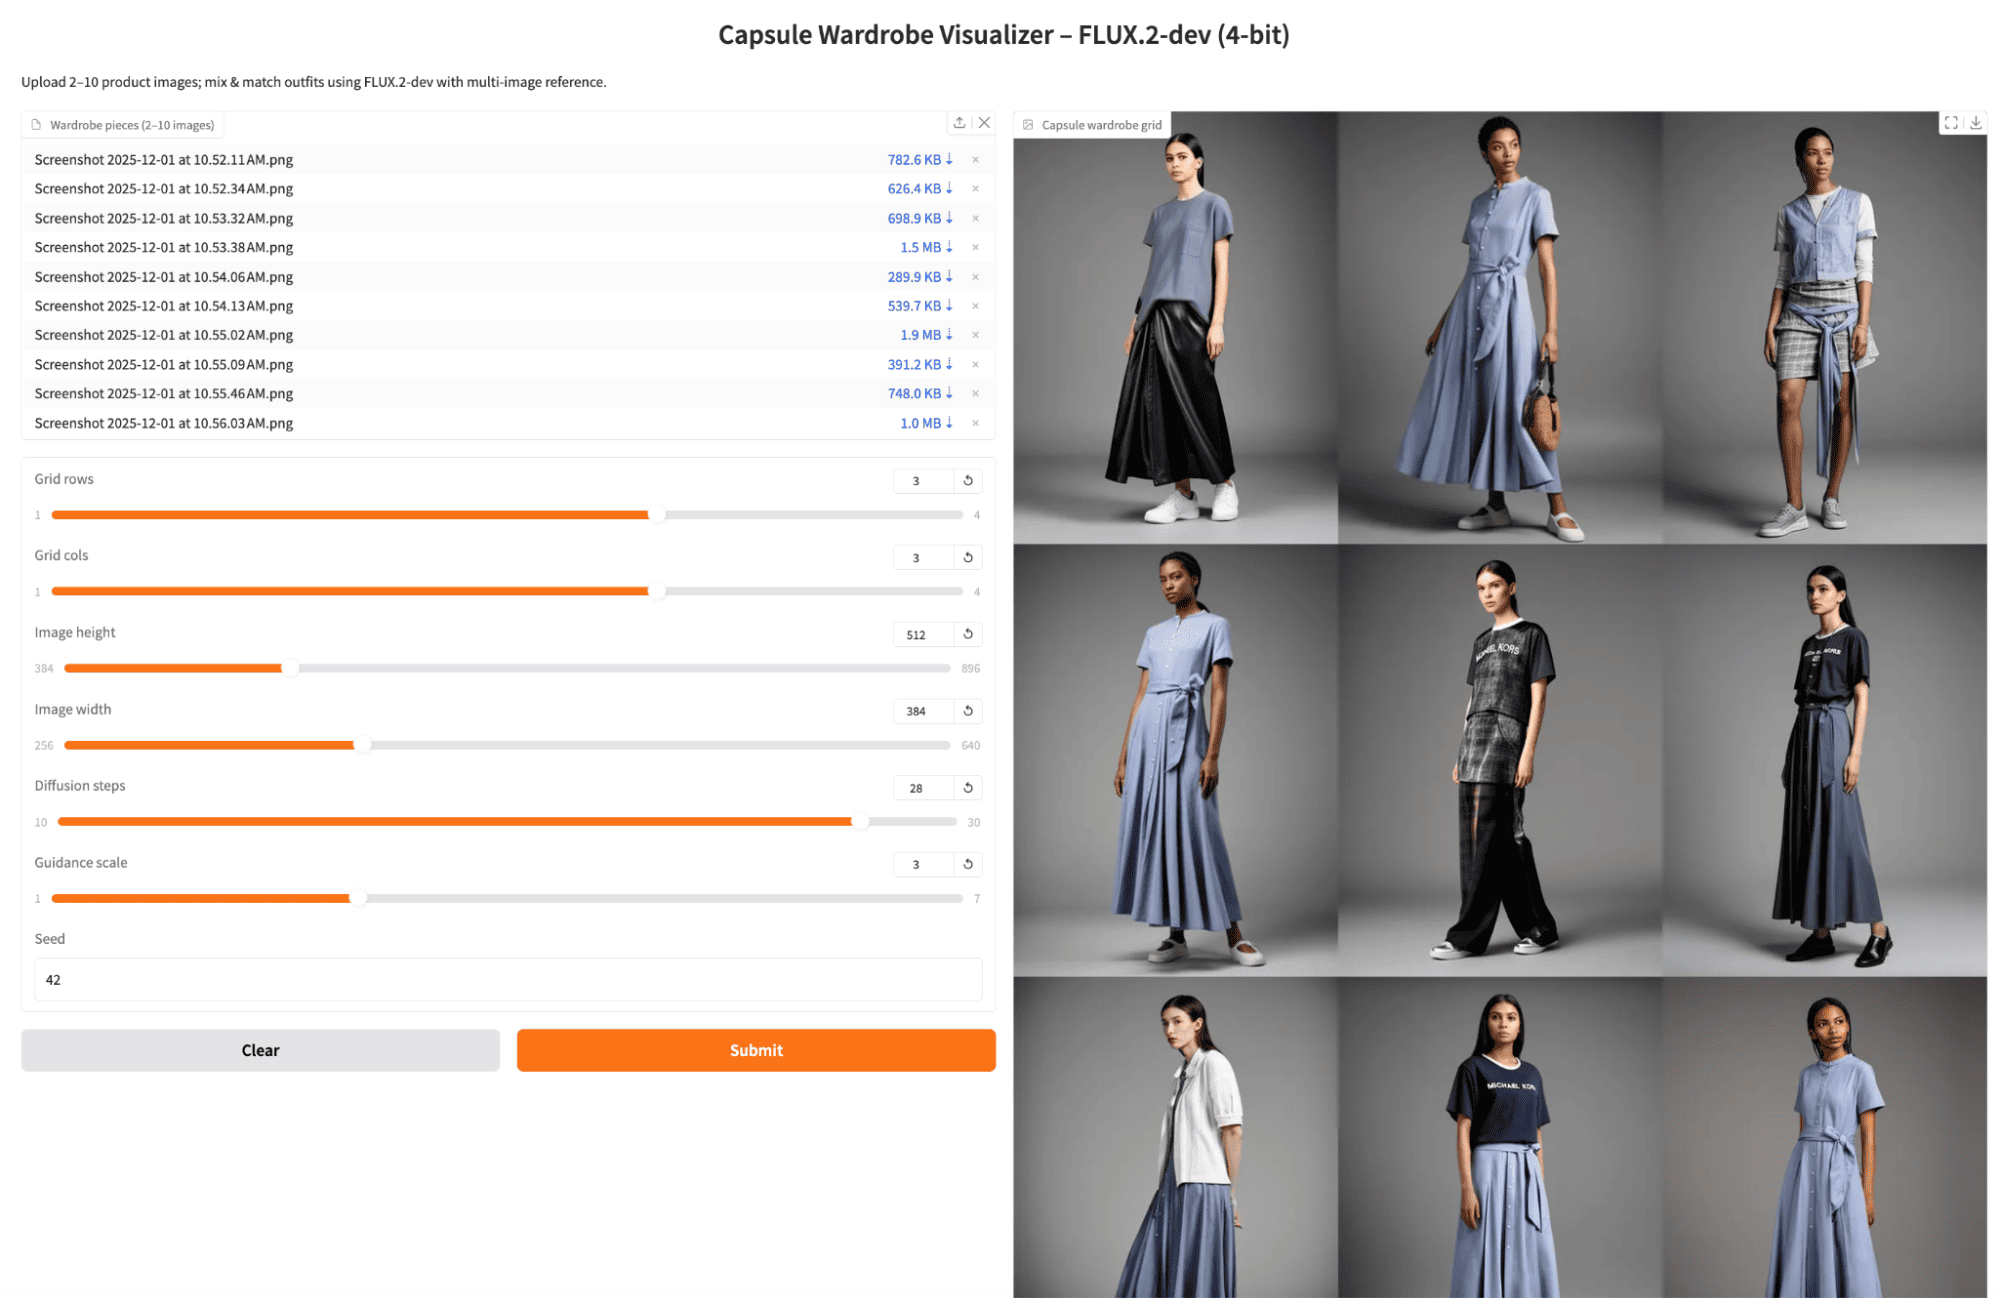
Ví dụ 2: Tăng số bước khuếch tán với nhiều góc chụp của cùng một món
Tiếp theo, tôi giữ nguyên ảnh tham chiếu nhưng tăng số bước khuếch tán lên 28 (và chỉnh nhẹ guidance). Lưới trở nên sắc nét và chỉn chu hơn chút, nhưng vẫn tập trung tái phối cùng các món cốt lõi. Đánh đổi là thời gian sinh mỗi lô tăng nhẹ nhưng nhận thấy được.
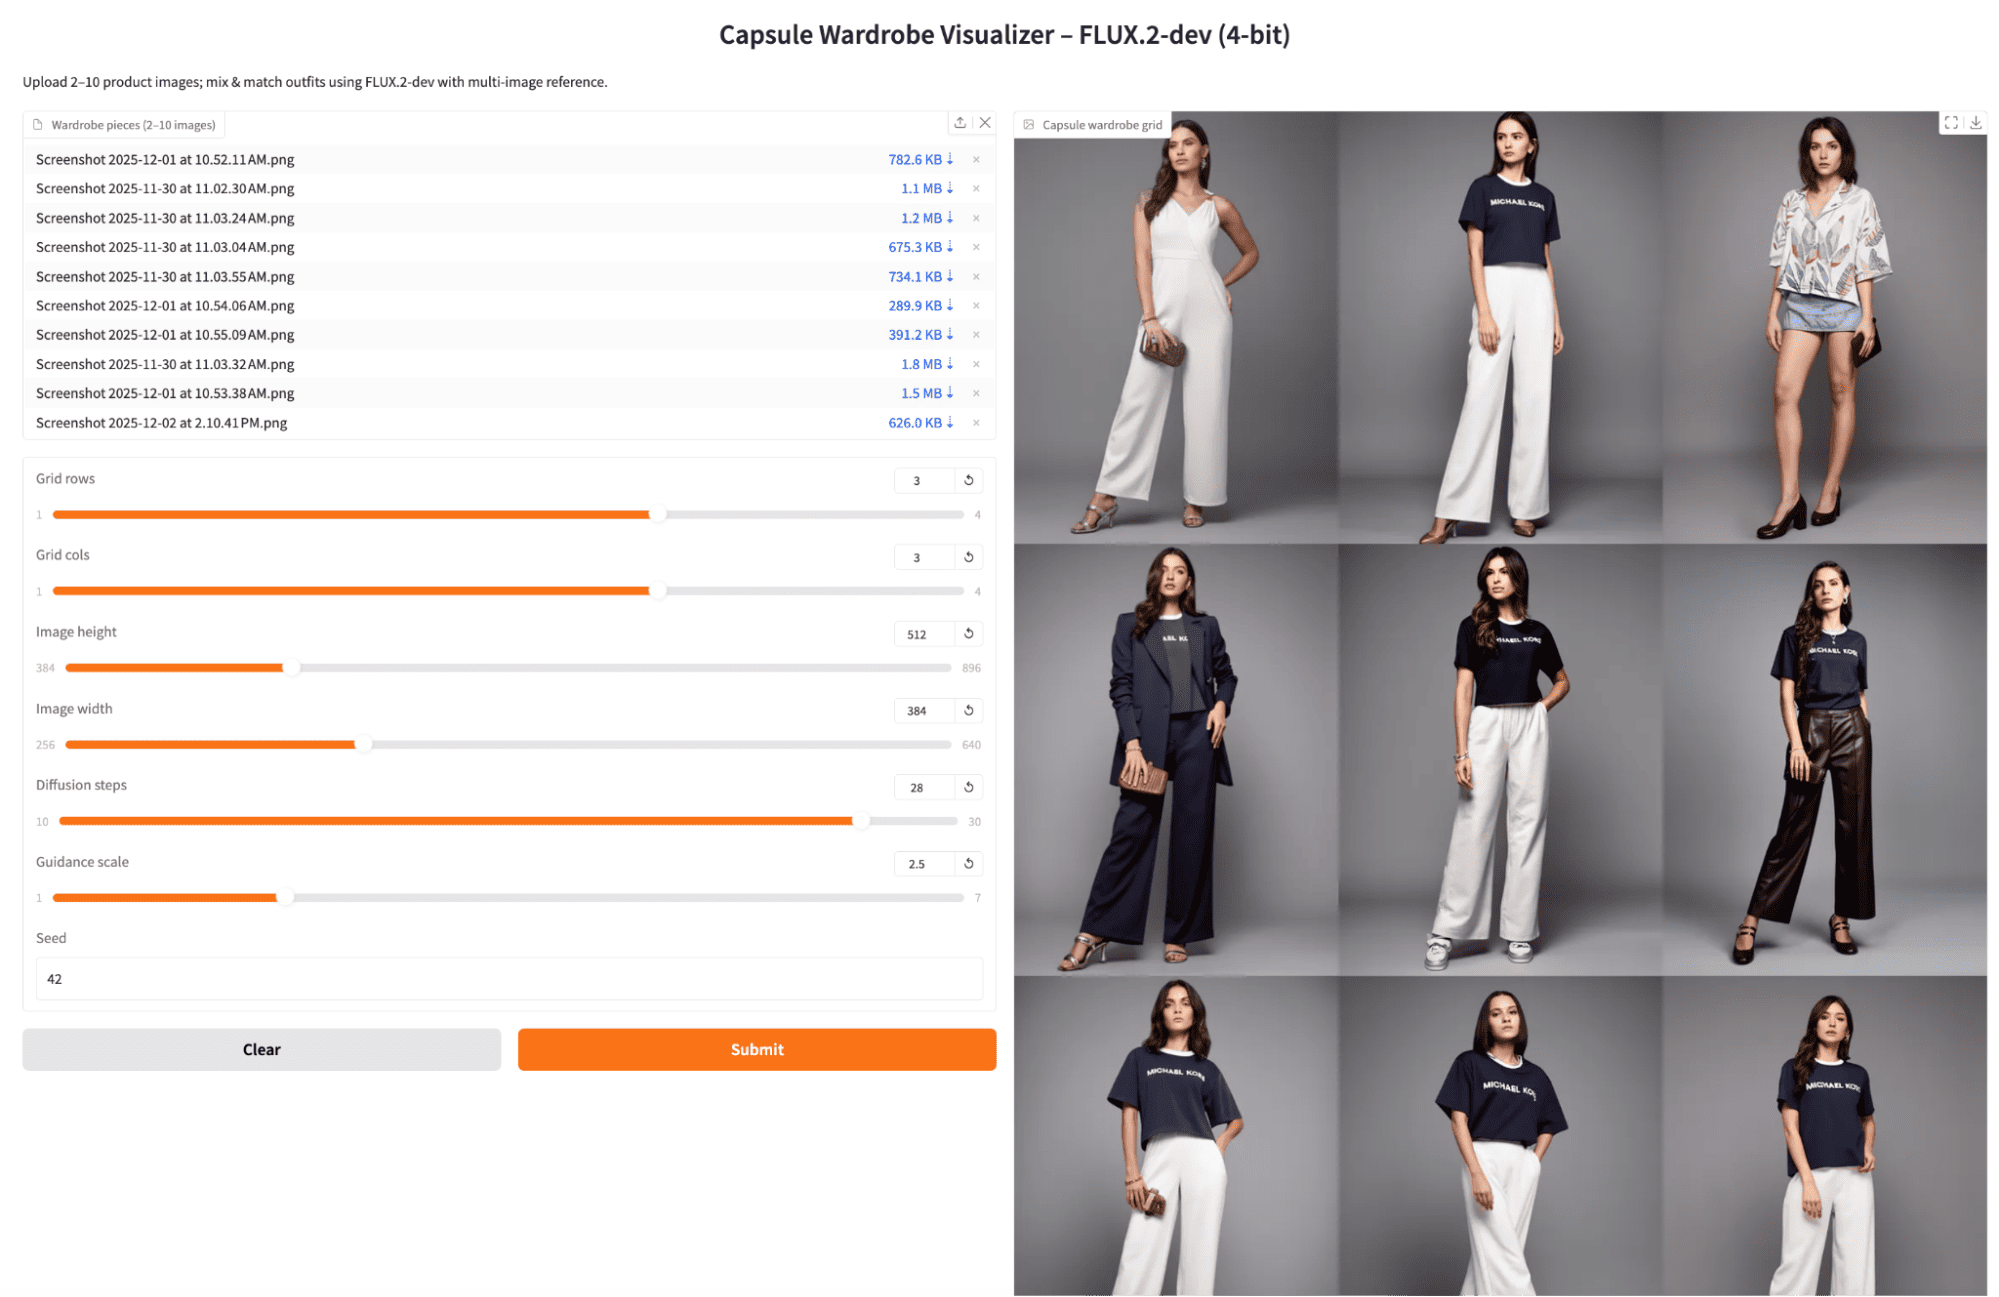
Thử nghiệm 3: Mỗi ảnh cho một món đồ độc nhất
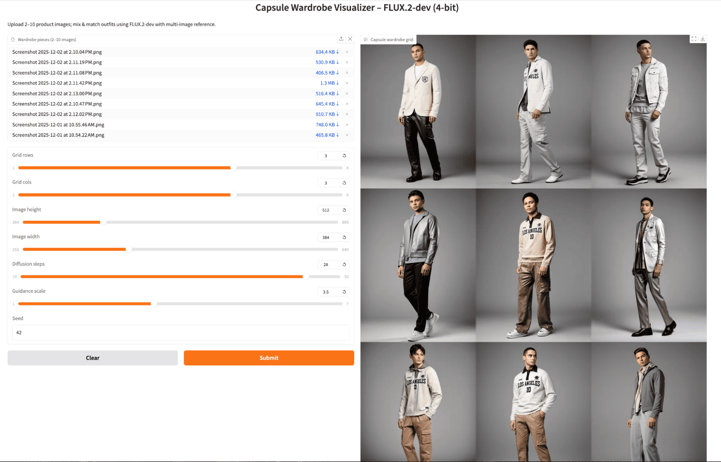
Cuối cùng, tôi tải lên mỗi ảnh sản phẩm cho một món đồ khác nhau và sinh một lưới 3x3 khác. Các outfit kết quả đa dạng hơn nhiều giữa các ô, phối nhiều kiểu áo và quần theo cách thú vị. Vẫn có lặp lại đôi chút, nhưng nhìn chung lưới giống một capsule wardrobe thực thụ hơn, với nhiều kết hợp đa dạng cho cùng seed và cài đặt.
Kết luận
FLUX.2-dev ở dạng 4-bit là một mô hình tuyệt vời cho các ứng dụng hình ảnh. Trong hướng dẫn này, chúng ta đã thiết lập pipeline FLUX.2-dev 4-bit với diffusers và xây dựng quy trình tham chiếu đa ảnh coi các món tủ đồ như tín hiệu điều kiện hóa, rồi bọc tất cả trong một ứng dụng Gradio.
Kết quả là một Trình trực quan hóa Capsule Wardrobe mạnh mẽ có thể đóng vai trò nguyên mẫu cho công cụ thương mại điện tử thời trang, hoặc đơn giản là cách thú vị để remix tủ đồ của chính bạn. Từ đây, bạn có thể cắm cùng pipeline vào các hệ thống agentic rộng hơn, như một LLM gợi ý outfit theo dress code hoặc thời tiết, hay kết nối với backend danh mục sản phẩm thực.
Câu hỏi thường gặp về FLUX.2
Tôi có thể dùng pipeline FLUX.2-Dev (4-bit) mà không phải dựa vào bộ mã hóa văn bản Mistral cục bộ không?
Có. FLUX.2 hỗ trợ mã hóa văn bản từ xa qua dịch vụ text-encoder của Hugging Face, có thể giảm đáng kể mức dùng VRAM. Thay vì tải Mistral3ForConditionalGeneration cục bộ, bạn có thể truyền prompt_embeds lấy từ bộ mã hóa từ xa. Điều này hữu ích cho GPU VRAM thấp (ví dụ, RTX 4090 hoặc GPU di động).
Tôi nên định dạng hay chuẩn bị ảnh tham chiếu tủ đồ như thế nào để có kết quả tốt nhất?
Mặc dù mô hình chấp nhận ảnh tùy ý, kết quả sẽ cải thiện khi:
- Ảnh quần áo có nền sạch
- Ảnh đủ sáng và gần như chụp chính diện
- Trang phục không bị che khuất nhiều
- Tất cả món có khung hình tương tự (ví dụ, ảnh sản phẩm căn giữa)
FLUX.2 có thể đảm bảo outfit luôn gồm một áo, một quần và một đôi giày không?
Không mặc định. Mô hình không hiểu “nhóm danh mục trang phục” trừ khi bạn mã hóa rõ ràng và áp đặt logic chọn trong ứng dụng của bạn.
Bạn có thể áp đặt cấu trúc bằng cách:
- Dùng nhãn như “áo từ ảnh tham chiếu 1”, “quần từ ảnh tham chiếu 2”
- Hoặc thêm chọn lựa theo luật trong capsule_fn
Làm sao ngăn trang phục bị hòa trộn hoặc biến dạng với nhau trong ảnh sinh?
Chế độ tham chiếu đa ảnh có thể khiến các món đồ hòa trộn nếu:
- Các món trông giống nhau,
- Bạn truyền nhiều tham chiếu (8–10),
- Hoặc prompt của bạn quá mơ hồ. Để giảm hòa trộn:
- Dùng ít ảnh tham chiếu hơn cho mỗi ô (tối đa 2–3).
- Tăng sức nặng của prompt với mô tả như “các lớp tách bạch rõ ràng”, “không hòa trộn”, “giữ nguyên đường nét (silhouette)”.
- Đảm bảo ảnh tham chiếu khác biệt rõ về hình dáng/màu sắc.
FLUX.2 thực tế xử lý được bao nhiêu ảnh tham chiếu trước khi chất lượng giảm?
FLUX.2 hỗ trợ tối đa 10 ảnh tham chiếu, nhưng chất lượng không tăng tuyến tính. Trong thực tế:
- 1–4 tham chiếu → giữ trung thực mạnh với từng món
- 5–7 tham chiếu → suy yếu phần nào ở khớp chi tiết tinh
- 8–10 tham chiếu → rủi ro hòa trộn hoặc ranh giới món đồ mơ hồ cao hơn
Điều này là do cách khối điều kiện hóa đa ảnh của FLUX hợp nhất các embedding thị giác vào transformer khử nhiễu. Càng truyền nhiều embedding, transformer càng phải dung hòa nhiều tín hiệu không gian và phong cách cạnh tranh.

Tôi là Chuyên gia Google Developers trong lĩnh vực ML (Gen AI), Chuyên gia Kaggle 3x và Đại sứ Women Techmakers với hơn 3 năm kinh nghiệm trong ngành công nghệ. Tôi đồng sáng lập một startup công nghệ y tế vào năm 2020 và hiện đang theo học thạc sĩ khoa học máy tính tại Georgia Tech, chuyên sâu về học máy.


FLUX.2 là một mô hình chuyển văn bản thành hình ảnh hiện đại được xây dựng để tạo sinh chất lượng cao, có thể kiểm soát. Trong hướng dẫn này, tôi sẽ chỉ bạn cách dùng biến thể FLUX.2-dev để xây dựng một Trình trực quan hóa Capsule Wardrobe cho phép tải lên 2–10 ảnh quần áo (áo, quần, áo khoác, giày, v.v.), mô hình sẽ lấy mẫu các tổ hợp của những món đồ đó, và ứng dụng trả về một lưới trang phục phối đồ theo nhiều cách khác nhau.
Kết quả là một công cụ tương tác cho phép bạn khám phá trực quan các cách phối đồ, được vận hành bởi một mô hình khuếch tán tối ưu cho bộ nhớ GPU.
Nếu bạn muốn tìm hiểu thêm về các nguyên lý phía sau hướng dẫn này, tôi khuyên bạn nên xem khóa học Deep Learning for Images with PyTorch.
FLUX 2 là gì?
FLUX.2 là một họ mô hình văn bản-thành-hình ảnh được tối ưu cho các điểm cân bằng khác nhau giữa chất lượng, tốc độ và tính linh hoạt, thay vì một checkpoint đơn nhất. Nó giới thiệu một số khả năng quan trọng:
Trong thực tế, bạn sẽ thường thấy ba biến thể cốt lõi:
So với Pro và Flex, biến thể Dev được thiết kế riêng cho người muốn thử nghiệm và chính xác là thứ chúng ta cần cho lưới capsule-wardrobe tương tác.
Vì sao chọn FLUX.2-Dev (4-bit)?
Dòng FLUX.2 gốc đã rất mạnh, nhưng FLUX.2-Dev cộng với lượng tử hóa 4-bit giúp demo này dễ chạy, lặp và mở rộng hơn nhiều. Lý do:
Tóm lại, FLUX.2-Dev (4-bit) cho ta sự kết hợp tốt nhất giữa bộ nhớ, tốc độ và chất lượng cho công cụ capsule wardrobe tương tác.
Tổng quan demo Flux 2: Trình trực quan hóa Capsule Wardrobe
Trong phần này, ta sẽ triển khai một trình trực quan hóa capsule wardrobe với mô hình FLUX 2 gói trong ứng dụng Gradio. Ở mức cao, ứng dụng làm ba việc:
Trong video dưới đây, bạn có thể thấy phiên bản rút gọn của quy trình. Video được tua nhanh cho mục đích minh họa (quá trình sinh thực tế có thể mất vài phút):