
Cours
Deep Learning pour l’image avec PyTorch
4 h
13.6K
FLUX.2 est un modèle de texte vers image moderne, conçu pour une génération de haute qualité et hautement contrôlable. Dans ce tutoriel, je vous montre comment utiliser la variante FLUX.2-dev pour créer un visualiseur de garde-robe capsule où l'on importe 2 à 10 images de vêtements (chemises, pantalons, vestes, chaussures, etc.), le modèle échantillonne des combinaisons de ces pièces, et l'application renvoie une grille de tenues qui les mixent et les assortissent de différentes façons.
Le résultat est un outil interactif qui vous permet d'explorer visuellement des combinaisons de tenues, propulsé par un modèle de diffusion optimisé pour la mémoire GPU.
Si vous souhaitez approfondir les principes derrière ce tutoriel, je vous recommande le cours Deep Learning for Images with PyTorch.
FLUX.2 est une famille de modèles texte‑image optimisés pour différents compromis entre qualité, vitesse et flexibilité, plutôt qu'un unique point de contrôle monolithique. Elle introduit plusieurs capacités importantes :
En pratique, on trouve généralement trois variantes principales :
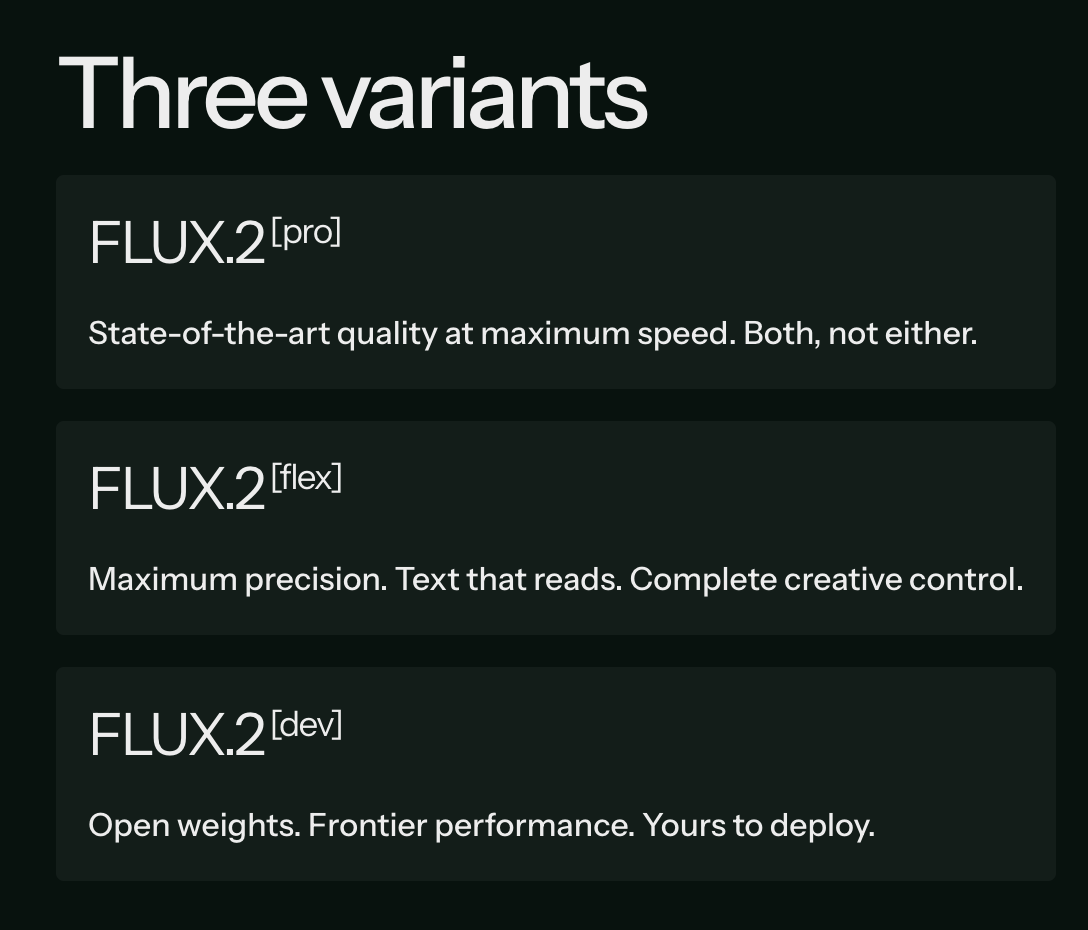
Par rapport à Pro et Flex, Dev est conçue pour l'expérimentation, exactement ce qu'il nous faut pour notre grille de garde‑robe capsule interactive.
La gamme FLUX.2 d'origine est déjà puissante, mais FLUX.2‑Dev associé à une quantification en 4 bits rend cette démo beaucoup plus simple à exécuter, itérer et étendre. Voici pourquoi :
En bref, FLUX.2‑Dev (4 bits) offre le meilleur équilibre mémoire, vitesse et qualité pour un outil interactif de garde‑robe capsule.
Dans cette section, nous allons implémenter un visualiseur de garde‑robe capsule avec un modèle FLUX 2 intégré dans une application Gradio. À haut niveau, l'app fait trois choses :
Dans la vidéo ci‑dessous, vous voyez une version condensée du flux de travail. La vidéo est accélérée pour la démonstration (la génération réelle peut prendre plusieurs minutes) :
Commencez par installer la dernière bibliothèque diffusers depuis GitHub ainsi que les autres dépendances.
!pip install -q "git+https://github.com/huggingface/diffusers.git@main" \
               "transformers>=4.44.0" accelerate safetensors bitsandbytes gradio pillow
Connectez-vous ensuite à Hugging Face pour pouvoir récupérer les poids FLUX.2‑dev en 4 bits :
from huggingface_hub import login
login()
Saisissez le token HF quand demandé et connectez‑vous à HF pour récupérer le modèle. Faites ensuite un rapide sanity check pour vérifier si CUDA est disponible et quelle GPU est détectée :
import torch, diffusers, bitsandbytes as bnb
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smi
Si vous voyez votre GPU dans la sortie nvidia-smi et CUDA available: True, vous êtes prêt.
Nous chargeons maintenant les composants FLUX.2‑dev en 4 bits depuis le dépôt diffusers/FLUX.2-dev-bnb-4bit.
from diffusers import Flux2Pipeline, Flux2Transformer2DModel
from transformers import Mistral3ForConditionalGeneration
import torch
bnb_repo = "diffusers/FLUX.2-dev-bnb-4bit"
torch_dtype = torch.bfloat16
device = "cuda"
print("Loading 4-bit transformer...")
transformer = Flux2Transformer2DModel.from_pretrained(
    bnb_repo,
    subfolder="transformer",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Loading 4-bit text encoder...")
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
    bnb_repo,
    subfolder="text_encoder",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Building Flux2 pipeline...")
pipe = Flux2Pipeline.from_pretrained(
    bnb_repo,
    transformer=transformer,
    text_encoder=text_encoder,
    torch_dtype=torch_dtype,
).to(device)
pipe.set_progress_bar_config(disable=False)
print("Loaded. Example param device:", next(pipe.transformer.parameters()).device)
Une fois les dépendances installées, nous pouvons charger FLUX.2 avec la bibliothèque diffusers et l'associer à un encodeur de texte Mistral 3 de transformers. Voici ce que fait chaque composant :
Flux2Transformer2DModel : le cœur de type U‑Net/transformer responsable du débruitage, chargé en forme quantifiée 4 bits.Mistral3ForConditionalGeneration : utilisé comme encodeur de texte, il transforme votre prompt en signaux de conditionnement pour la diffusion.Flux2Pipeline : assemble le transformer, l'encodeur de texte et les composants de support en une interface unique et appelable pour la génération d'images.L'usage de device_map="auto" et torch_dtype=torch.bfloat16 garde de la flexibilité selon les configurations GPU tout en restant économe en mémoire.
L'application permet d'importer plusieurs images de garde‑robe. Nous avons besoin de quelques utilitaires :
import gradio as gr
import random, json
from typing import List, Union
from PIL import Image
MAX_REFS = 10
def files_to_pil(files: List[Union[str, dict]]) -> List[Image.Image]:
    images = []
    for f in files:
        path = f.get("name") if isinstance(f, dict) else f
        if not path:
            continue
        img = Image.open(path).convert("RGB")
        images.append(img)
    return images
def preprocess_refs(refs: List[Image.Image], max_size: int = 512) -> List[Image.Image]:
    processed = []
    for img in refs:
        img = img.convert("RGB")
        img.thumbnail((max_size, max_size), Image.LANCZOS)
        processed.append(img)
    return processed
Le code ci‑dessus définit deux fonctions d'aide essentielles.
files_to_pil() prend les objets fichiers renvoyés par Gradio, extrait leurs chemins et ouvre chaque fichier en PIL.Image RGB.preprocess_refs() redimensionne ces images à une taille maximale de 512 × 512 tout en préservant le ratio, important pour la vitesse et l'usage mémoire.De plus, nous plafonnons le nombre d'images de référence avec MAX_REFS = 10 pour ne pas surcharger le set de conditionnement.
Au lieu d'envoyer un simple prompt texte, j'ai construit un prompt structuré de type JSON qui décrit :
def build_outfit_prompt(outfit_indices: List[int], labels: List[str]) -> str:
    item_phrases = [
        f"{labels[idx]} from reference image {idx+1}" for idx in outfit_indices
    ]
    outfit_items_str = ", ".join(item_phrases)
    mistral_prompt = """A professional full-body studio photograph of a high-end fashion editorial shoot, set against a flawless seamless neutral gray backdrop (#f5f5f5) in a controlled studio environment. The scene is bathed in soft, diffused three-point lighting (key, fill, and subtle rim) that eliminates harsh shadows, ensuring even illumination across the subject while preserving dimensionality and texture.
At the center of the frame stands a full-body adult model, exuding quiet confidence in a relaxed yet poised stance—one foot slightly forward, weight balanced, body angled subtly to the right. The model’s expression is natural, with a neutral gaze directed just off-camera, evoking a modern, minimalist lookbook aesthetic.
The outfit—meticulously styled and tailored—is the focal point, captured with ultra-realistic 8K resolution and razor-sharp detail. Fabrics display tactile depth: the weave of knits, the drape of silks, the sheen of leathers, and the crispness of cotton are all rendered with commercial-grade precision. The shallow depth of field (50mm prime lens, f/2.8) keeps the subject in crystalline focus while softly blurring the backdrop, emphasizing the outfit’s textures and proportions.
The composition adheres to classic fashion photography rules: vertical framing, ample headroom, and a slightly dynamic angle (eye-level) that flatters the model’s posture. The color palette is controlled and sophisticated, dominated by the outfit’s hues against the neutral gray, with subtle tonal contrasts to highlight layers and accessories.
Every element—from the studio-quality lighting to the catalog-ready styling—conveys luxury, clarity, and commercial appeal, designed to showcase the outfit as a covetable, high-end ensemble."""
    prompt_dict = {
        "scene": mistral_prompt,
        "subjects": [
            {
                "description": (
                    "The model is styled in an outfit composed of: "
                    + outfit_items_str
                    + ". Each garment should closely match the color, fabric, and key design details of its reference image."
                )
            }
        ]
    }
    return json.dumps(prompt_dict)
La fonction build_outfit_prompt() fait trois choses importantes :
outfit_indices et labels pour générer des expressions du type « pièce de garde‑robe 1 from reference image 1 », réunies en une seule chaîne décrivant les vêtements sélectionnés pour cette tenue.prompt_dict avec des champs scene et subjects, puis sérialisons en JSON pour le passer comme un seul prompt à la pipeline.Conceptuellement, nous traitons chaque image importée comme une « pièce de garde‑robe i » et demandons au modèle de « composer une tenue avec la pièce 1, la pièce 3 et la pièce 4 », tout en préservant la couleur, le tissu et les détails clés de chaque pièce.
Remarque : comme nous utilisons un modèle Mistral comme encodeur de texte dans cette pipeline, j'ai également utilisé Mistral pour aider à rédiger le long prompt de description de studio (mistral_prompt) via du meta‑prompting. Cela aligne le style avec ce que l'encodeur « attend » et facilite les ajustements directement dans le code.
Le cœur de la démo est capsule_fn, qui :
def make_grid(images: List[Image.Image], rows: int, cols: int) -> Image.Image:
    w, h = images[0].size
    grid = Image.new("RGB", (cols * w, rows * h), (255, 255, 255))
    for idx, img in enumerate(images):
        r, c = divmod(idx, cols)
        grid.paste(img, (c * w, r * h))
    return grid
def capsule_fn(files, rows, cols, height, width, steps, guidance, seed):
    if not files or len(files) < 2:
        return None
    images = files_to_pil(files)
    images = images[:MAX_REFS]
    refs = preprocess_refs(images, max_size=512)
    labels = [f"wardrobe piece {i+1}" for i in range(len(refs))]
    random.seed(int(seed))
    tiles = []
    num_tiles = rows * cols
    for i in range(num_tiles):
        k = min(len(refs), random.randint(2, 3))
        outfit_idxs = random.sample(range(len(refs)), k=k)
        prompt = build_outfit_prompt(outfit_idxs, labels)
        generator = torch.Generator(device=device).manual_seed(int(seed) + i)
        out = pipe(
            prompt=prompt,
            image=refs,
            height=height,
            width=width,
            num_inference_steps=steps,
            guidance_scale=guidance,
            generator=generator,
        )
        tiles.append(out.images[0])
    grid = make_grid(tiles, rows, cols)
    return grid
Ces deux fonctions constituent le moteur de la démo de garde‑robe capsule.
make_grid() crée une toile blanche assez grande pour une mise en page lignes × colonnes, puis colle chaque image de tenue générée à la bonne position pour produire une seule image en grille.capsule_fn() prépare les images de garde‑robe en références, sélectionne aléatoirement 2 à 3 pièces par case, construit un prompt structuré et appelle la pipeline FLUX.2 avec la résolution, le nombre d'étapes, la guidance et la seed choisis. Elle collecte toutes les cases générées et les passe à make_grid() pour afficher une grille finale de tenues mix & match.Cette étape relie le moteur de garde‑robe capsule à l'application Gradio. L'utilisateur importe des images, choisit les réglages de grille et de génération, puis obtient une grille composite de tenues.
inputs = [
    gr.File(file_types=["image"], file_count="multiple", label="Wardrobe pieces (2–10 images)"),
    gr.Slider(1, 4, value=2, step=1, label="Grid rows"),
    gr.Slider(1, 4, value=2, step=1, label="Grid cols"),
    gr.Slider(384, 896, value=512, step=64, label="Image height"),
    gr.Slider(256, 640, value=384, step=64, label="Image width"),
    gr.Slider(10, 30, value=16, step=2, label="Diffusion steps"),
    gr.Slider(1.0, 7.0, value=2.5, step=0.5, label="Guidance scale"),
    gr.Number(value=42, precision=0, label="Seed")
]
iface = gr.Interface(
    fn=capsule_fn,
    inputs=inputs,
    outputs=gr.Image(type="pil", label="Capsule wardrobe grid"),
    title="Capsule Wardrobe Visualizer – FLUX.2-dev (4-bit)",
    description="Upload 2–10 product images; mix & match outfits using FLUX.2-dev with multi-image reference.",
)
iface.launch(share=True, debug = True)
Voici comment nous construisons l'application Gradio :
gr.Interface connecte ces entrées à la fonction capsule_fn et déclare une sortie gr.Image unique. L'appel launch(share=True, debug=True) démarre le serveur Gradio, expose un lien partageable pour les démos et active les logs de debug en console pour diagnostiquer d'éventuels problèmes.Une fois l'interface en ligne :
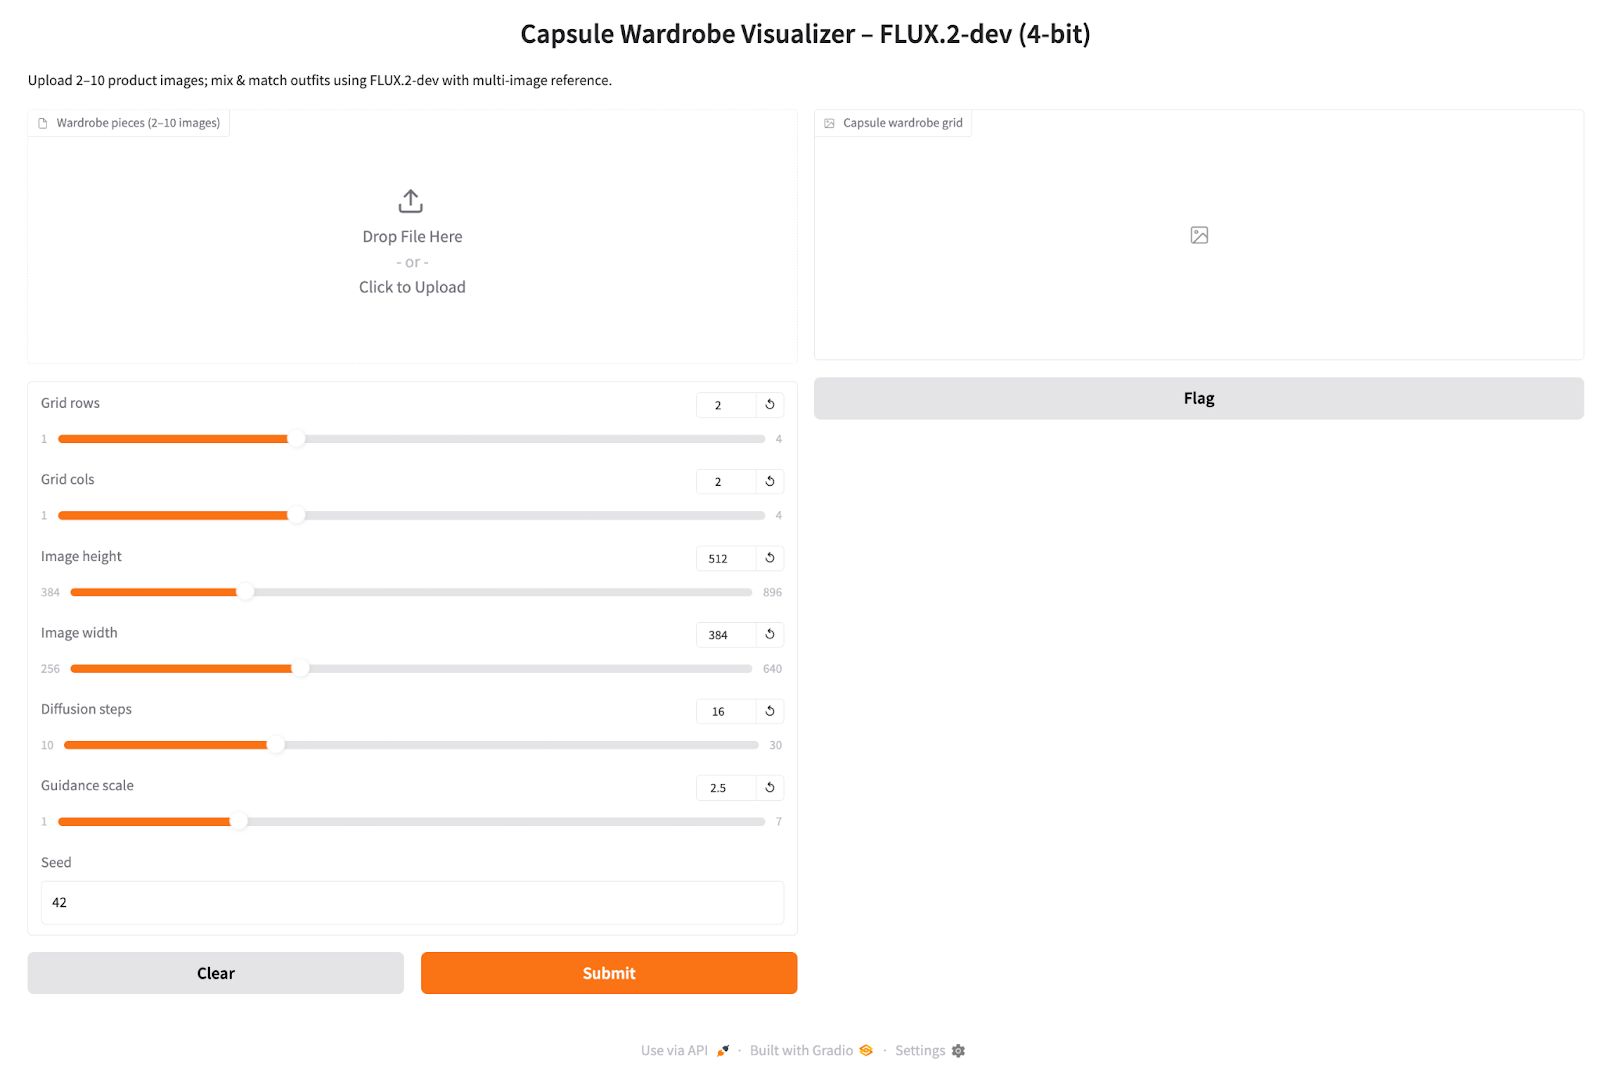
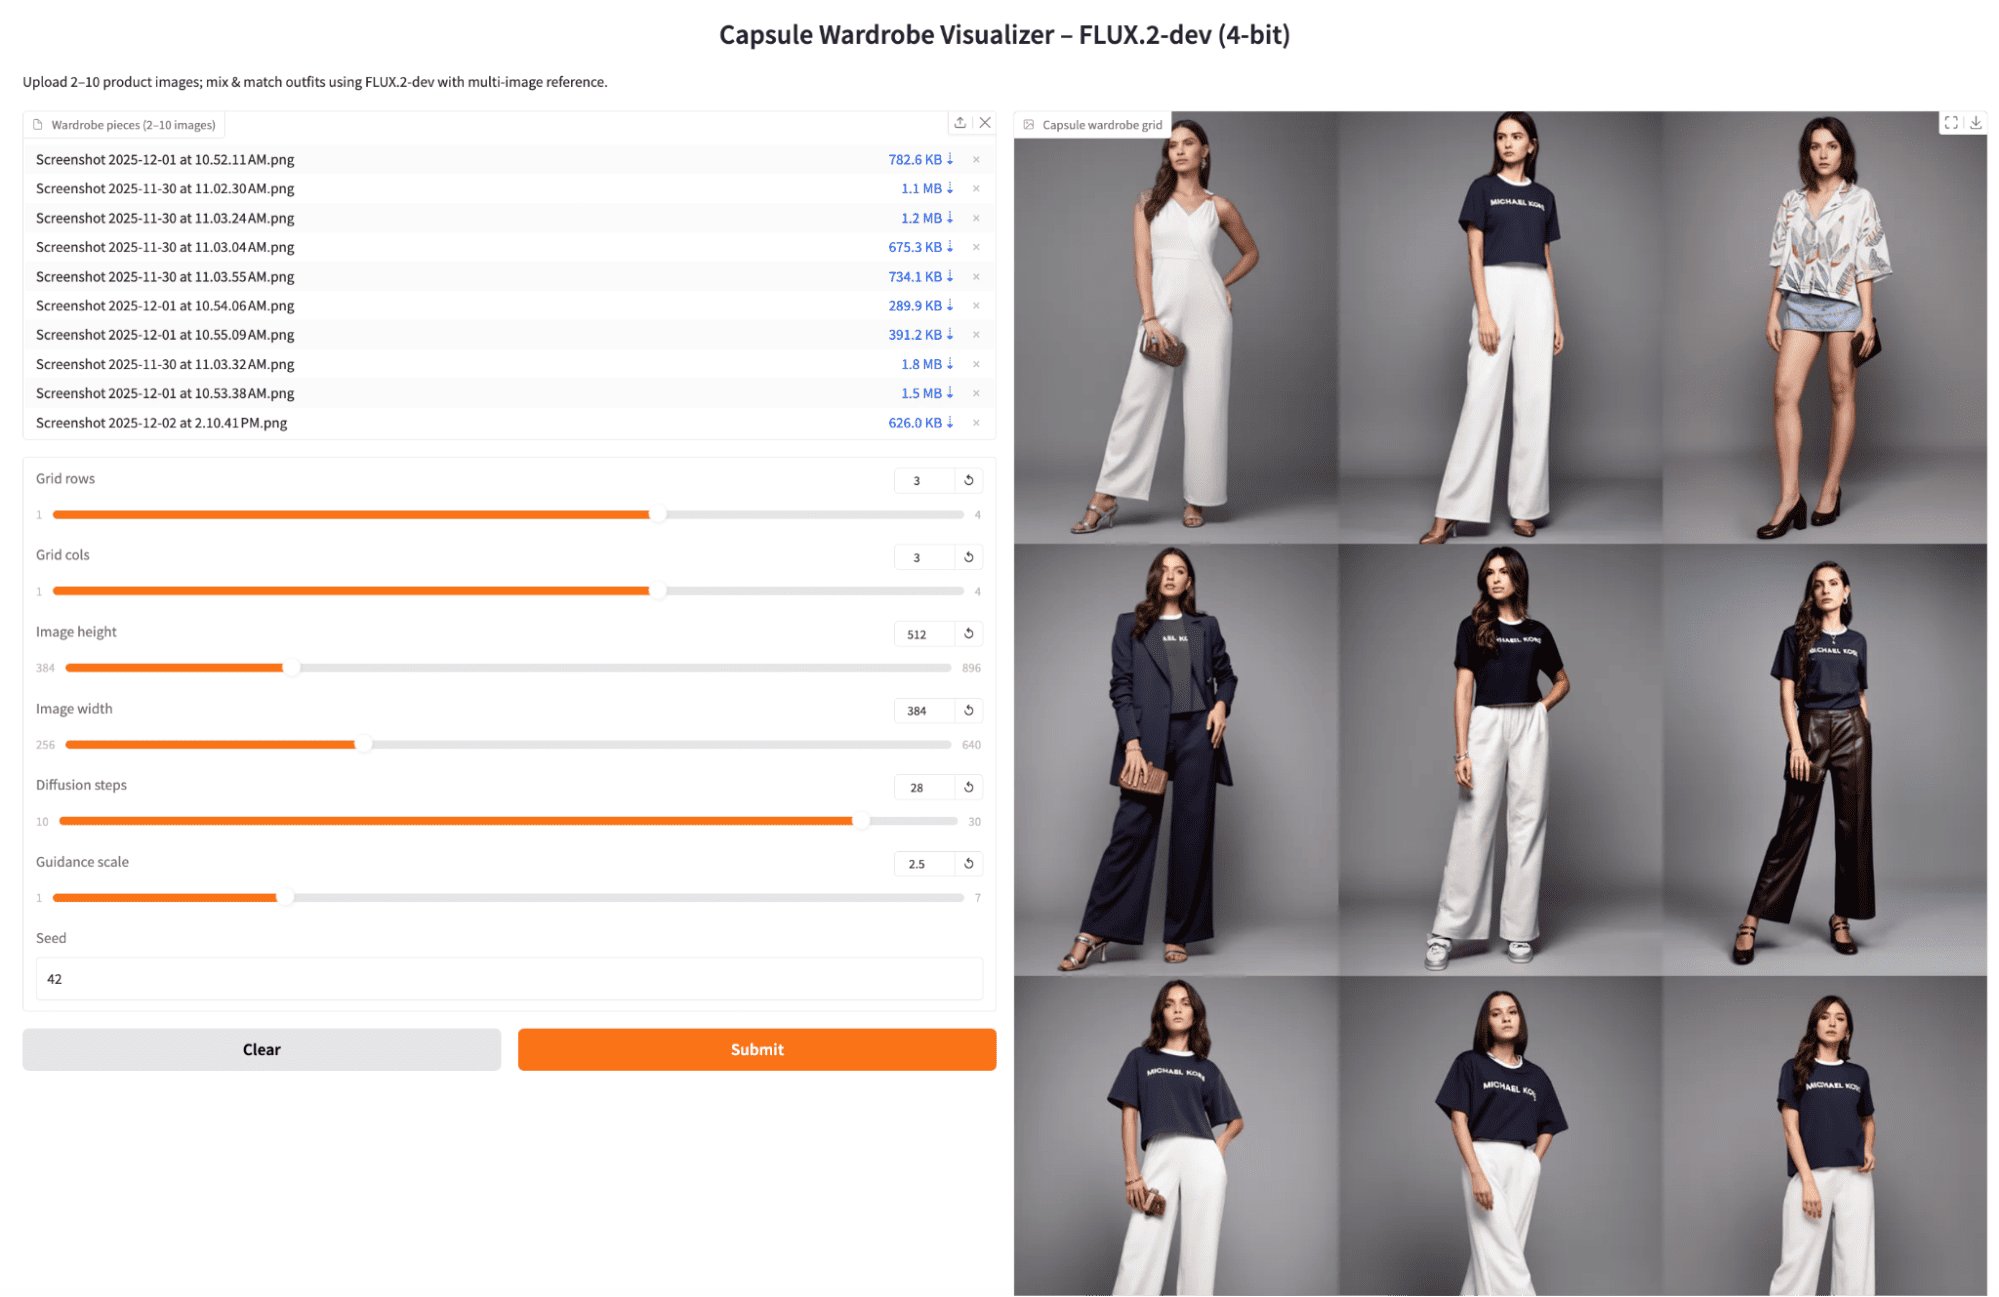
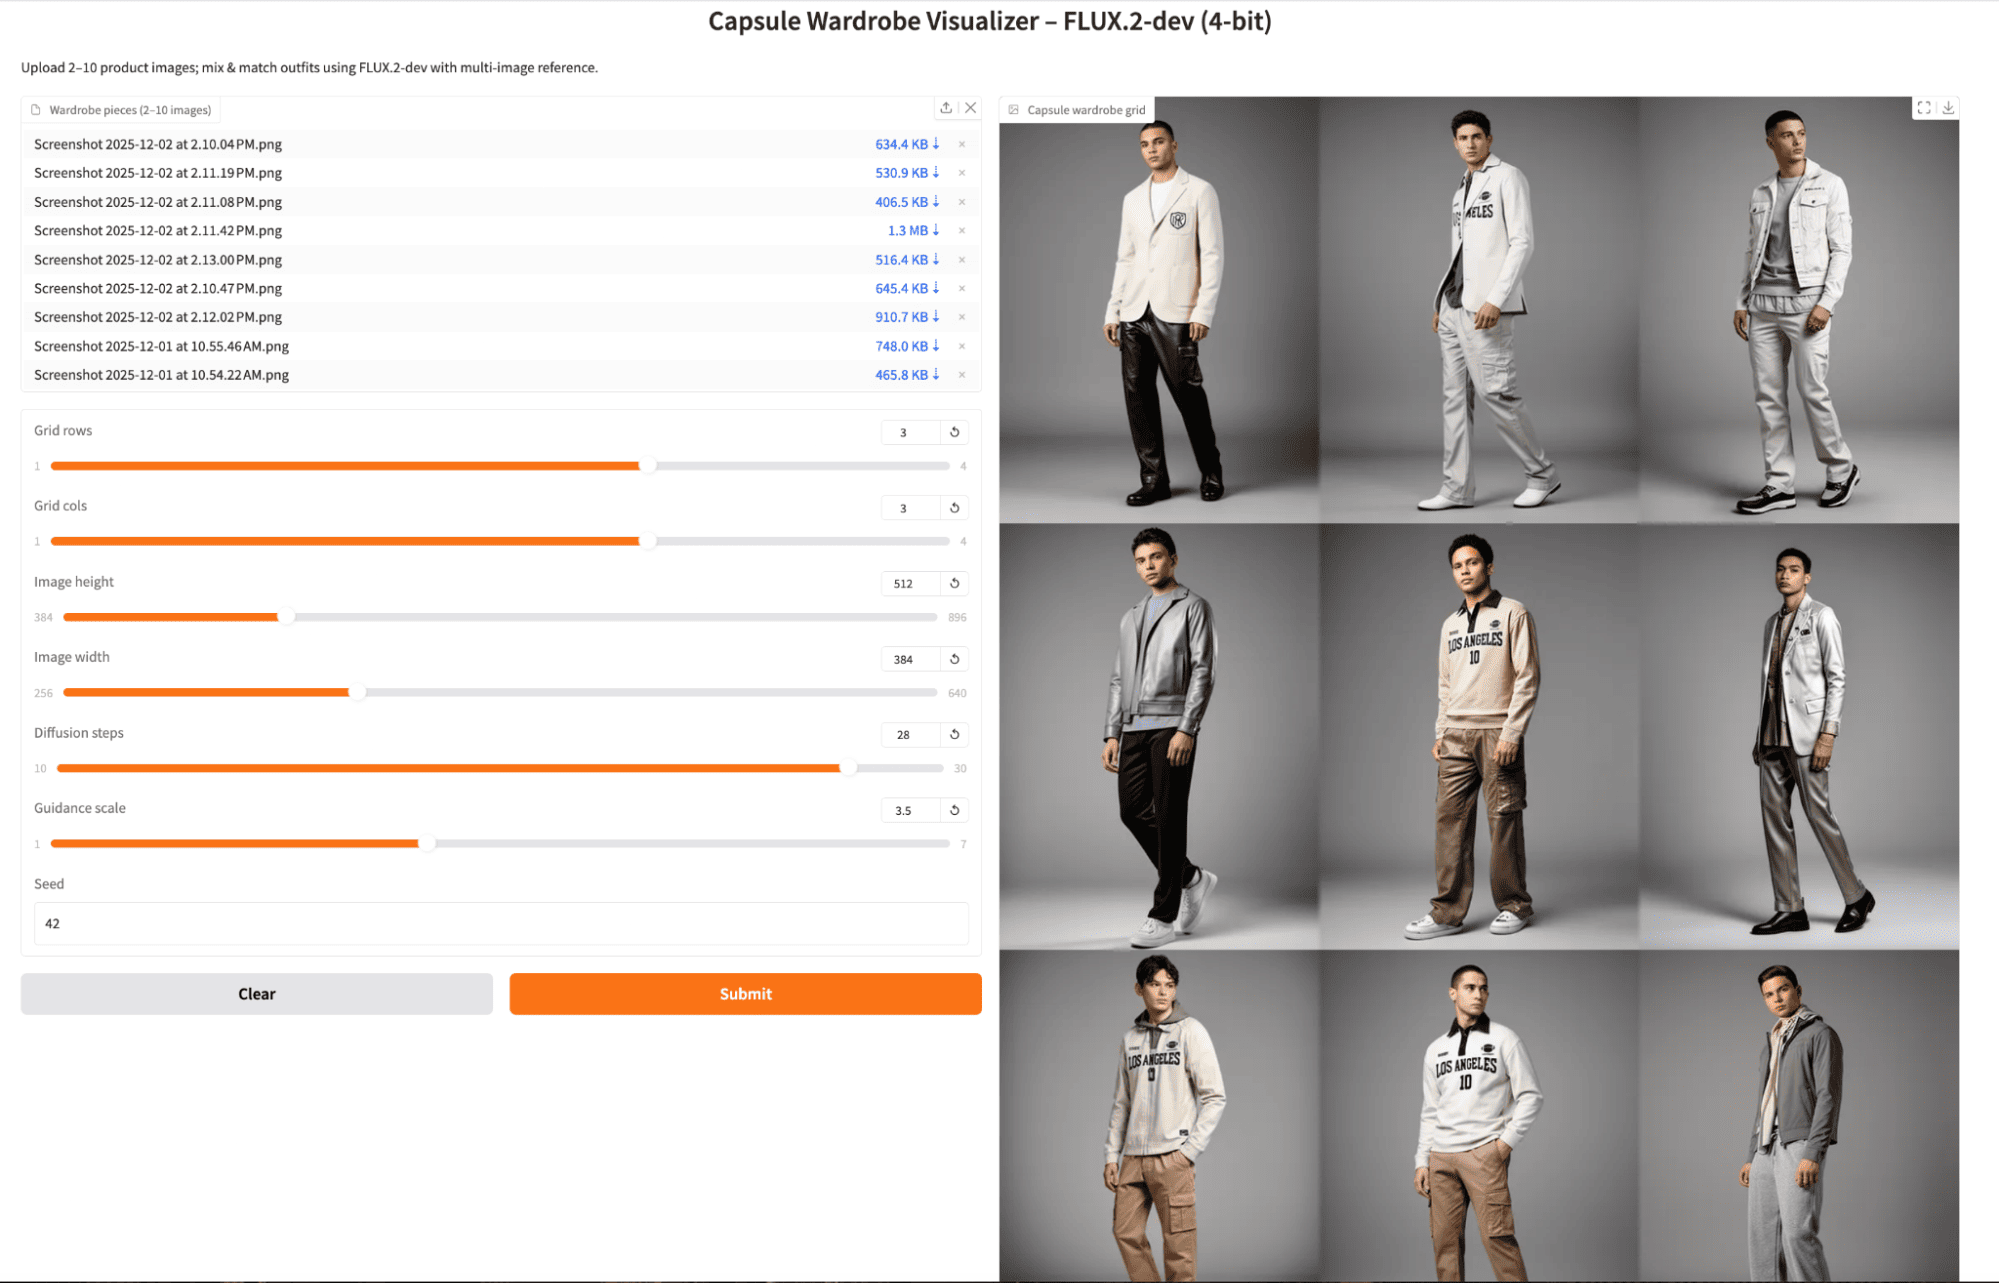
Pour comprendre le comportement de FLUX.2‑dev en pratique, j'ai réalisé quelques petites expériences avec l'application finale. J'ai fait varier le nombre d'étapes de diffusion et l'échelle de guidance, et j'ai testé à la fois plusieurs images d'un même vêtement et une image par vêtement unique pour évaluer la variété produite.
J'ai d'abord importé plusieurs images de la même tenue prises sous différents angles, conservé les étapes par défaut et une guidance modérée. Le modèle a produit un éclairage studio cohérent et des détails de tissu crédibles, avec des tenues qui sonnaient comme des variations d'une même capsule.
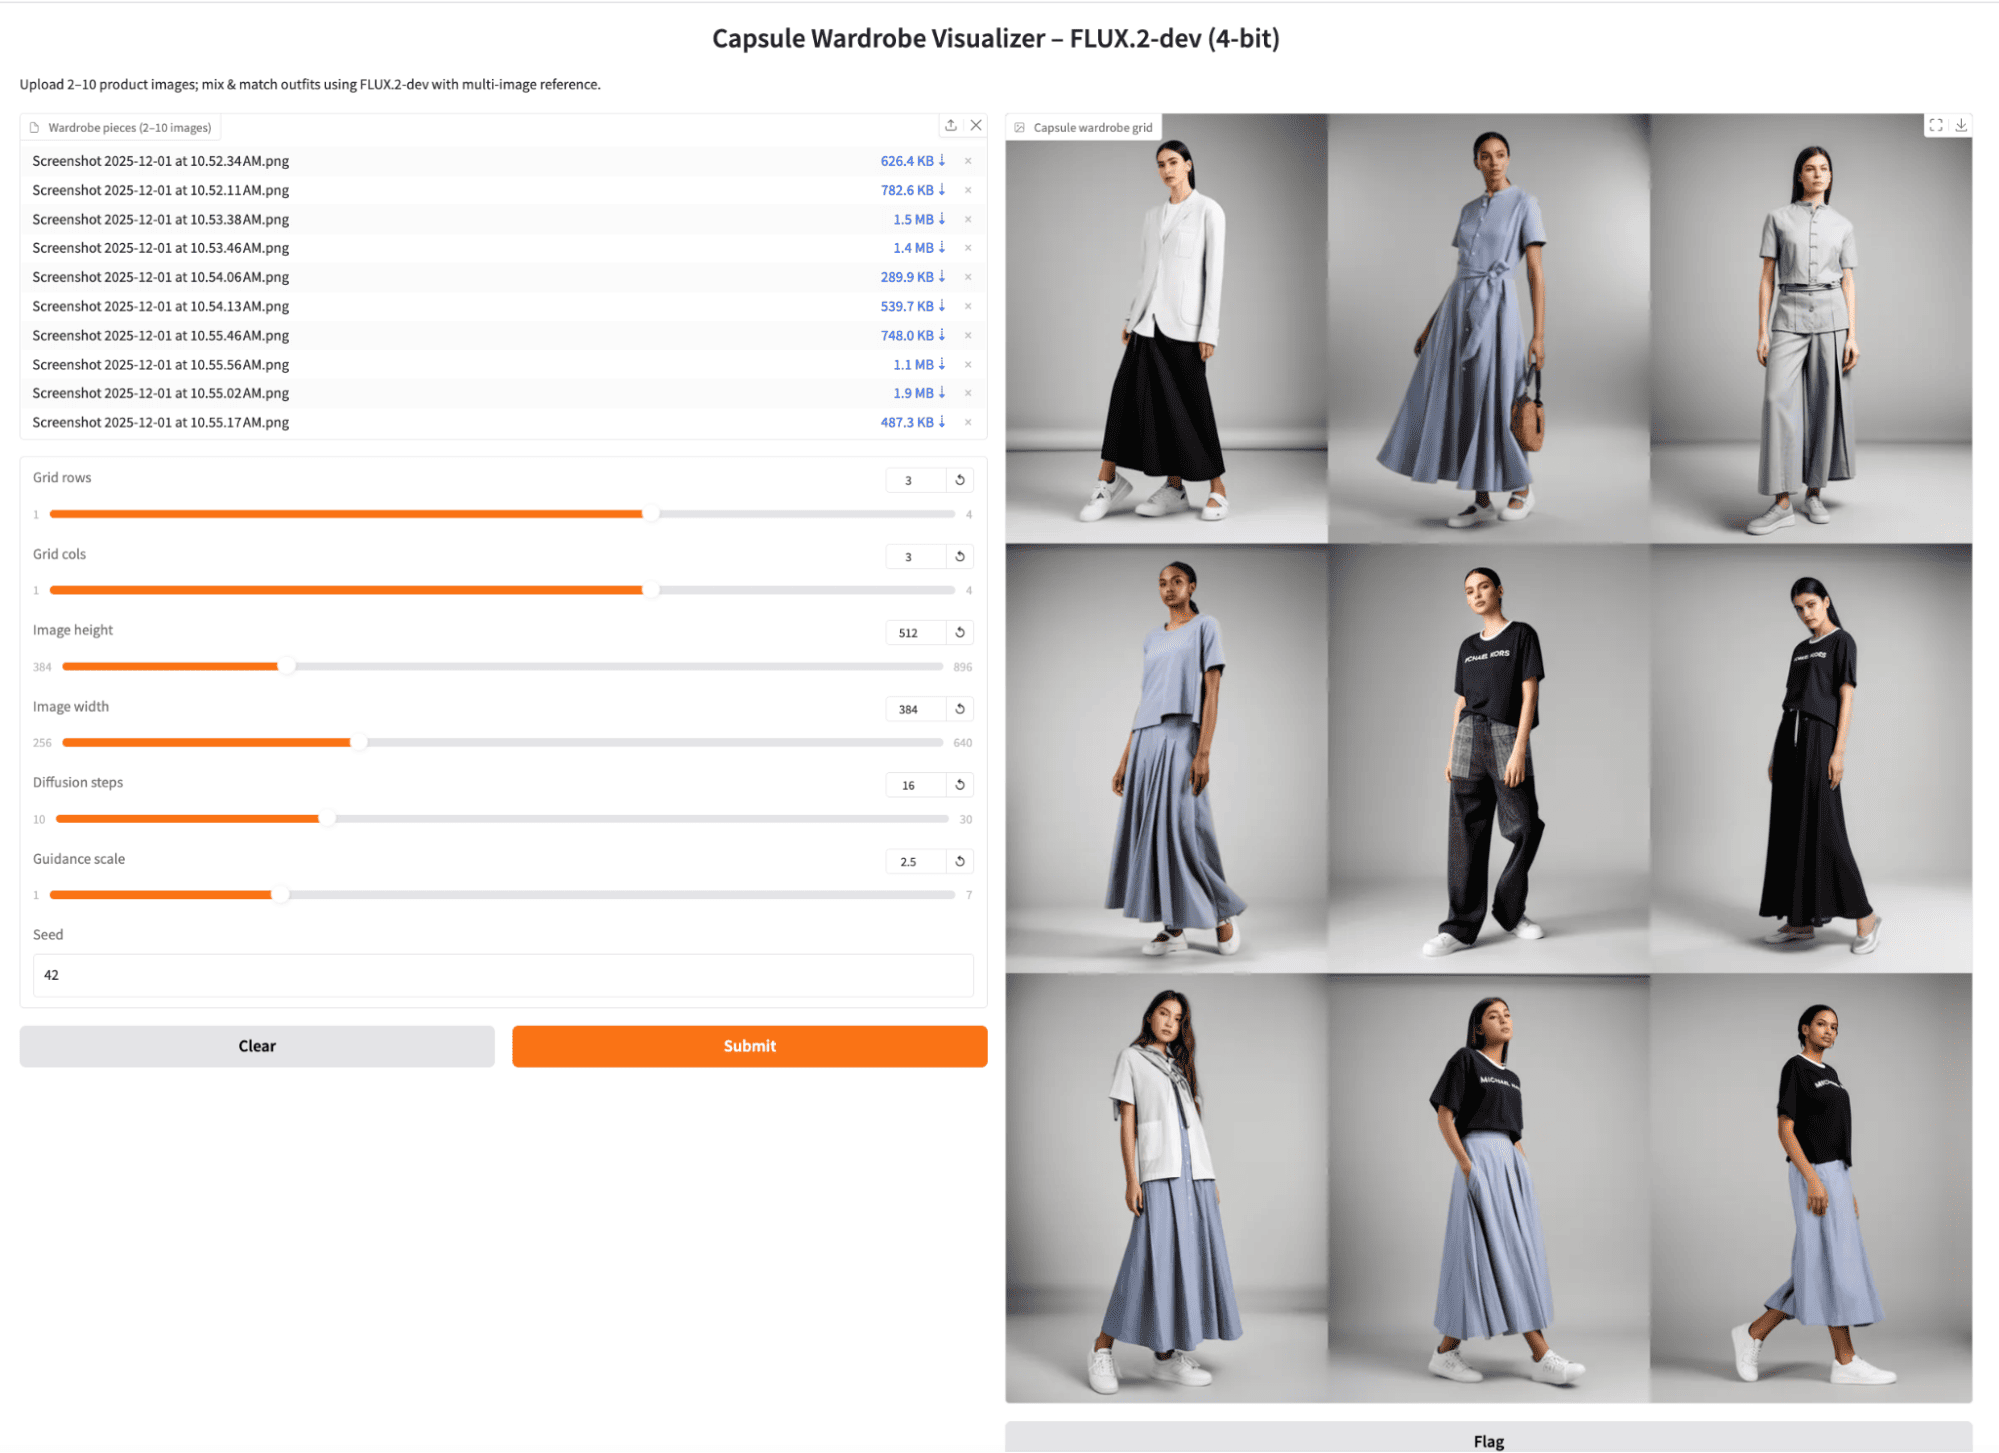
Ensuite, j'ai gardé les mêmes références mais augmenté les étapes de diffusion à 28 (et ajusté légèrement la guidance). La grille est devenue un peu plus nette et plus soignée, tout en recombinants les mêmes pièces. La contrepartie : un temps de génération par lot un peu plus long.
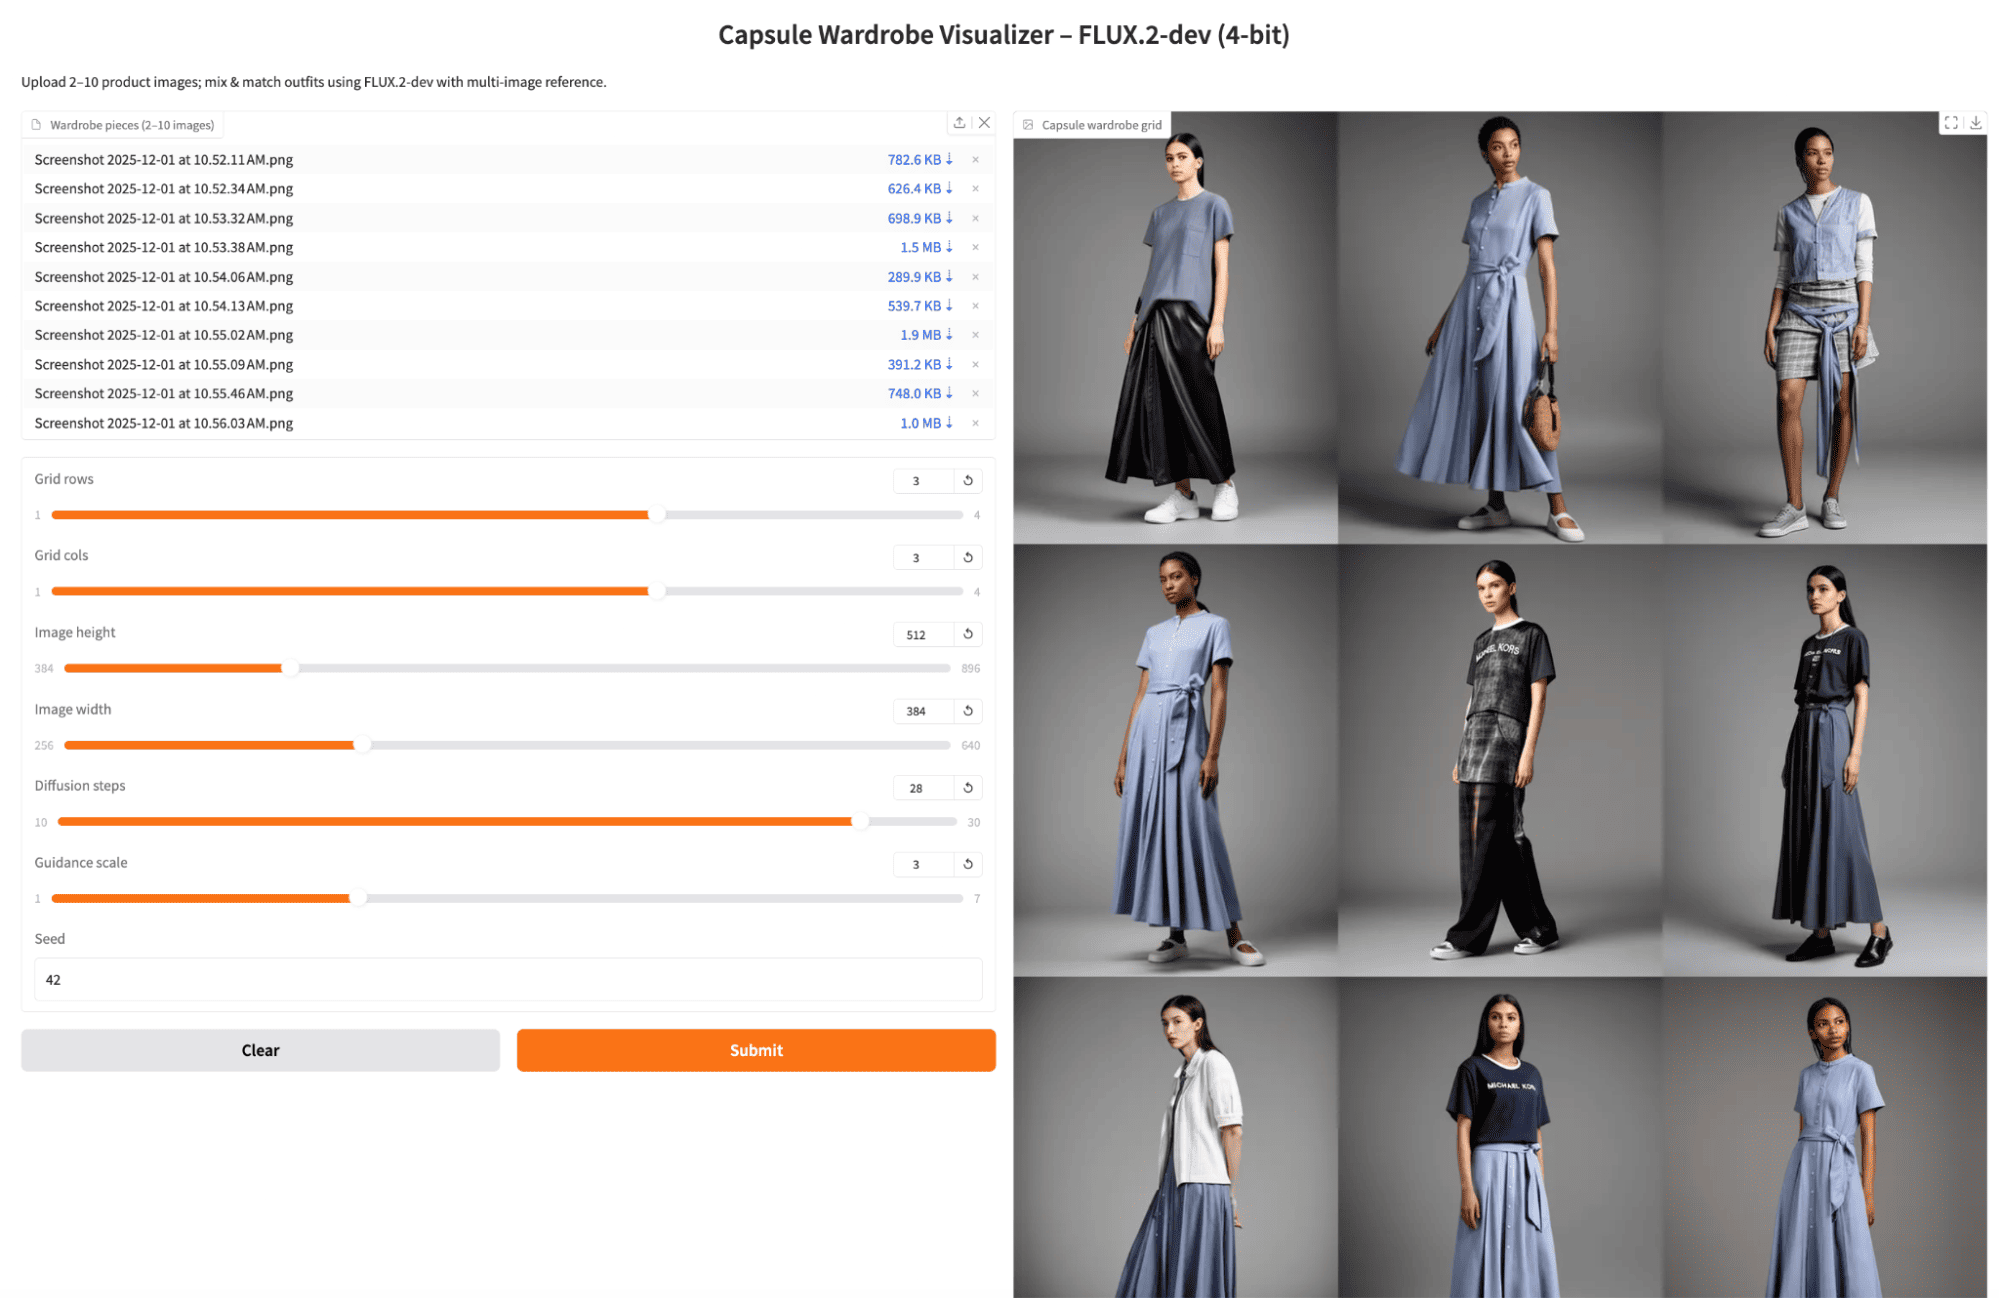
Enfin, j'ai importé un visuel produit par vêtement distinct et généré une autre grille 3×3. Les tenues étaient bien plus variées d'une case à l'autre, en mixant différents hauts et bas de manière intéressante. Un peu de répétition subsiste, mais l'ensemble se rapproche d'une véritable garde‑robe capsule, avec davantage de combinaisons pour la même seed et les mêmes réglages.
FLUX.2‑dev en 4 bits est un excellent modèle pour les applications d'image. Dans ce tutoriel, nous avons mis en place une pipeline FLUX.2‑dev en 4 bits avec diffusers, conçu un flux multi‑références qui traite les pièces de garde‑robe comme des indices de conditionnement et intégré le tout dans une app Gradio.
Le résultat : un visualiseur de garde‑robe capsule puissant qui peut servir de prototype pour des outils e‑commerce mode, ou tout simplement d'approche ludique pour remixer votre dressing. À partir d'ici, vous pouvez brancher la même pipeline à des systèmes agentiques plus larges, comme un LLM qui suggère des tenues selon un dress code ou la météo, ou la connecter à un véritable catalogue produit.
Meilleurs cours DataCamp
Cours
Cours
Cours