
Cursus
Deep Learning voor afbeeldingen met PyTorch
4 uur
13.8K
FLUX.2 is een modern text-naar-beeldmodel voor hoogwaardige, stuurbare generatie. In deze tutorial laat ik je zien hoe je de FLUX.2-dev-variant gebruikt om een Capsule Wardrobe Visualizer te bouwen waarin we 2–10 kledingafbeeldingen uploaden (overhemden, broeken, jassen, schoenen, enz.), het model combinaties van die items sampelt, en de app een raster met outfits teruggeeft die ze op verschillende manieren mixen en matchen.
Het resultaat is een interactieve tool waarmee je outfitcombinaties visueel kunt verkennen, aangestuurd door een diffusiemodel dat is geoptimaliseerd voor GPU-geheugen.
Wil je meer leren over de principes achter deze tutorial, bekijk dan de Deep Learning for Images with PyTorch-cursus.
FLUX.2 is een familie van text-naar-beeldmodellen die zijn geoptimaliseerd voor verschillende punten op het spectrum van kwaliteit, snelheid en flexibiliteit, in plaats van één monolithische checkpoint. Het introduceert een aantal belangrijke mogelijkheden:
In de praktijk zie je meestal drie kernvarianten:
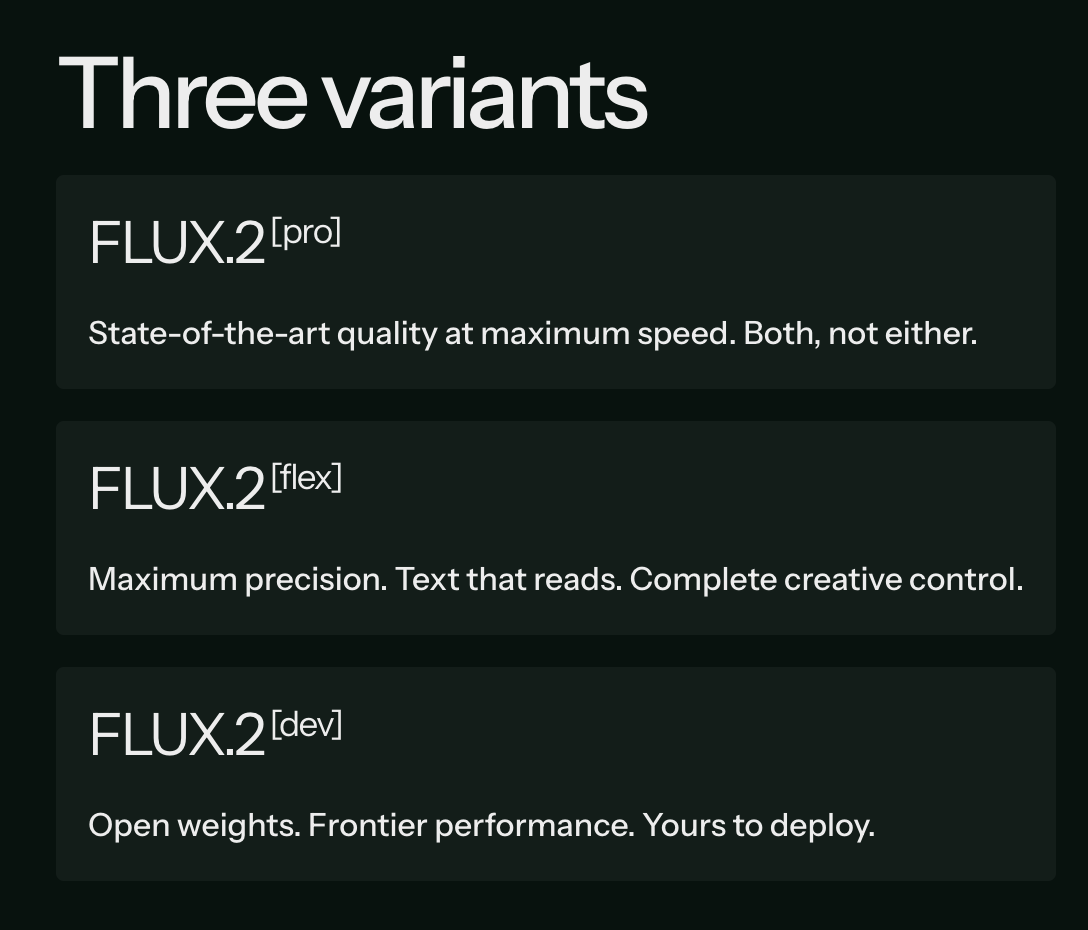
Vergeleken met Pro en Flex is de Dev-variant specifiek ontworpen voor wie wil experimenteren en precies wat we nodig hebben voor ons interactieve capsule-wardrobe-raster.
De originele FLUX.2-lijn is al krachtig, maar FLUX.2-Dev plus 4-bit kwantisatie maakt deze demo veel makkelijker om te draaien, itereren en uit te breiden. Daarom:
Kortom, FLUX.2-Dev (4-bit) geeft ons de beste mix van geheugen, snelheid en kwaliteit voor een interactieve capsule-wardrobe-tool.
In deze sectie implementeren we een capsule-wardrobe-visualizer met een FLUX 2-model verpakt in een Gradio-applicatie. Op hoofdlijnen doet de app drie dingen:
In de video hieronder zie je een verkorte versie van de workflow. De video is versneld voor demonstratiedoeleinden (het daadwerkelijke generatieproces kan enkele minuten duren):
Installeer eerst de nieuwste diffusers-bibliotheek vanaf GitHub en de andere afhankelijkheden.
!pip install -q "git+https://github.com/huggingface/diffusers.git@main" \
               "transformers>=4.44.0" accelerate safetensors bitsandbytes gradio pillow
Log vervolgens in bij Hugging Face zodat je de 4-bit FLUX.2-dev-gewichten kunt ophalen:
from huggingface_hub import login
login()
Voer bij de prompt de HF-token in en log in bij HF om het model op te halen. Voer daarna een snelle sanity check uit om te zien of CUDA beschikbaar is en welke GPU we gebruiken:
import torch, diffusers, bitsandbytes as bnb
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smi
Als je je GPU ziet in de uitvoer van nvidia-smi en CUDA available: True, dan ben je klaar om te starten.
Nu laden we de 4-bit FLUX.2-dev-componenten uit de repo diffusers/FLUX.2-dev-bnb-4bit.
from diffusers import Flux2Pipeline, Flux2Transformer2DModel
from transformers import Mistral3ForConditionalGeneration
import torch
bnb_repo = "diffusers/FLUX.2-dev-bnb-4bit"
torch_dtype = torch.bfloat16
device = "cuda"
print("Loading 4-bit transformer...")
transformer = Flux2Transformer2DModel.from_pretrained(
    bnb_repo,
    subfolder="transformer",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Loading 4-bit text encoder...")
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
    bnb_repo,
    subfolder="text_encoder",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Building Flux2 pipeline...")
pipe = Flux2Pipeline.from_pretrained(
    bnb_repo,
    transformer=transformer,
    text_encoder=text_encoder,
    torch_dtype=torch_dtype,
).to(device)
pipe.set_progress_bar_config(disable=False)
print("Loaded. Example param device:", next(pipe.transformer.parameters()).device)
Zodra de afhankelijkheden zijn geïnstalleerd, kunnen we FLUX.2 laden met de diffusers-bibliotheek en het koppelen aan een Mistral 3-tekencoder uit transformers. Zo ziet dat eruit in code:
Flux2Transformer2DModel: Dit is de kerntransformer, vergelijkbaar met een U-Net, die verantwoordelijk is voor het denoisen en in 4-bit gequantiseerde vorm wordt geladen.Mistral3ForConditionalGeneration: Dit model wordt als tekencoder gebruikt en zet je tekstprompt om in conditioneringssignalen voor het diffusieproces.Flux2Pipeline: Deze pipeline voegt de transformer, tekencoder en ondersteunende componenten samen tot één aanroepbare interface voor beeldgeneratie.Met device_map="auto" en torch_dtype=torch.bfloat16 blijft het flexibel over verschillende GPU-sets, terwijl het geheugen efficiënt blijft.
De app laat gebruikers meerdere kledingafbeeldingen uploaden. We hebben een paar hulpfuncties nodig om dat te doen:
import gradio as gr
import random, json
from typing import List, Union
from PIL import Image
MAX_REFS = 10
def files_to_pil(files: List[Union[str, dict]]) -> List[Image.Image]:
    images = []
    for f in files:
        path = f.get("name") if isinstance(f, dict) else f
        if not path:
            continue
        img = Image.open(path).convert("RGB")
        images.append(img)
    return images
def preprocess_refs(refs: List[Image.Image], max_size: int = 512) -> List[Image.Image]:
    processed = []
    for img in refs:
        img = img.convert("RGB")
        img.thumbnail((max_size, max_size), Image.LANCZOS)
        processed.append(img)
    return processed
De bovenstaande code definieert twee belangrijke helperfuncties.
files_to_pil() neemt de bestandsobjecten die door Gradio worden teruggegeven, extraheert hun paden en opent elk bestand als een RGB-PIL.Image.preprocess_refs() resizet deze afbeeldingen naar maximaal 512 × 512 met behoud van de beeldverhouding, wat belangrijk is voor zowel snelheid als geheugengebruik.Daarnaast begrenzen we het aantal referentieafbeeldingen met MAX_REFS = 10 zodat we de conditioneringsset niet overladen.
In plaats van één platte tekstprompt te sturen, heb ik een gestructureerde, JSON-achtige prompt gemaakt die het volgende beschrijft:
def build_outfit_prompt(outfit_indices: List[int], labels: List[str]) -> str:
    item_phrases = [
        f"{labels[idx]} from reference image {idx+1}" for idx in outfit_indices
    ]
    outfit_items_str = ", ".join(item_phrases)
    mistral_prompt = """A professional full-body studio photograph of a high-end fashion editorial shoot, set against a flawless seamless neutral gray backdrop (#f5f5f5) in a controlled studio environment. The scene is bathed in soft, diffused three-point lighting (key, fill, and subtle rim) that eliminates harsh shadows, ensuring even illumination across the subject while preserving dimensionality and texture.
At the center of the frame stands a full-body adult model, exuding quiet confidence in a relaxed yet poised stance—one foot slightly forward, weight balanced, body angled subtly to the right. The model’s expression is natural, with a neutral gaze directed just off-camera, evoking a modern, minimalist lookbook aesthetic.
The outfit—meticulously styled and tailored—is the focal point, captured with ultra-realistic 8K resolution and razor-sharp detail. Fabrics display tactile depth: the weave of knits, the drape of silks, the sheen of leathers, and the crispness of cotton are all rendered with commercial-grade precision. The shallow depth of field (50mm prime lens, f/2.8) keeps the subject in crystalline focus while softly blurring the backdrop, emphasizing the outfit’s textures and proportions.
The composition adheres to classic fashion photography rules: vertical framing, ample headroom, and a slightly dynamic angle (eye-level) that flatters the model’s posture. The color palette is controlled and sophisticated, dominated by the outfit’s hues against the neutral gray, with subtle tonal contrasts to highlight layers and accessories.
Every element—from the studio-quality lighting to the catalog-ready styling—conveys luxury, clarity, and commercial appeal, designed to showcase the outfit as a covetable, high-end ensemble."""
    prompt_dict = {
        "scene": mistral_prompt,
        "subjects": [
            {
                "description": (
                    "The model is styled in an outfit composed of: "
                    + outfit_items_str
                    + ". Each garment should closely match the color, fabric, and key design details of its reference image."
                )
            }
        ]
    }
    return json.dumps(prompt_dict)
De functie build_outfit_prompt() doet drie belangrijke dingen:
outfit_indices en labels om zinnen te genereren zoals "wardrobe piece 1 from reference image 1", die worden samengevoegd tot één string die de geselecteerde kledingstukken voor deze specifieke outfit beschrijft.prompt_dict met een scene- en subjects-veld en serialiseren we die dictionary naar JSON, zodat hij als één promptstring naar de pipeline kan worden doorgegeven.Conceptueel behandelen we elke geüploade kledingafbeelding als een “wardrobe piece i” en vragen we het model om “een outfit te componeren met wardrobe piece 1, wardrobe piece 3 en wardrobe piece 4”, terwijl we de kleur, stof en belangrijkste ontwerpelementen van elk stuk behouden.
Let op: Omdat we een Mistral-model als tekencoder gebruiken in deze pipeline, heb ik Mistral ook gebruikt om via meta-prompting de lange studiobeschrijvingsprompt (mistral_prompt) te helpen opstellen. Dit houdt de stijl in lijn met wat de encoder “verwacht” en maakt het makkelijk om de bewoording direct in code bij te schaven.
De kern van de demo is capsule_fn, die:
def make_grid(images: List[Image.Image], rows: int, cols: int) -> Image.Image:
    w, h = images[0].size
    grid = Image.new("RGB", (cols * w, rows * h), (255, 255, 255))
    for idx, img in enumerate(images):
        r, c = divmod(idx, cols)
        grid.paste(img, (c * w, r * h))
    return grid
def capsule_fn(files, rows, cols, height, width, steps, guidance, seed):
    if not files or len(files) < 2:
        return None
    images = files_to_pil(files)
    images = images[:MAX_REFS]
    refs = preprocess_refs(images, max_size=512)
    labels = [f"wardrobe piece {i+1}" for i in range(len(refs))]
    random.seed(int(seed))
    tiles = []
    num_tiles = rows * cols
    for i in range(num_tiles):
        k = min(len(refs), random.randint(2, 3))
        outfit_idxs = random.sample(range(len(refs)), k=k)
        prompt = build_outfit_prompt(outfit_idxs, labels)
        generator = torch.Generator(device=device).manual_seed(int(seed) + i)
        out = pipe(
            prompt=prompt,
            image=refs,
            height=height,
            width=width,
            num_inference_steps=steps,
            guidance_scale=guidance,
            generator=generator,
        )
        tiles.append(out.images[0])
    grid = make_grid(tiles, rows, cols)
    return grid
De twee functies hierboven vormen de kernengine van de capsule-wardrobe-demo.
make_grid() maakt een leeg canvas groot genoeg voor een layout van rijen × kolommen en plakt vervolgens elke gegenereerde outfitafbeelding op de juiste positie, wat één rasterafbeelding oplevert.capsule_fn() bereidt de kledingafbeeldingen van de gebruiker voor als referenties, selecteert willekeurig 2–3 stukken per tegel, bouwt een gestructureerde outfitprompt en roept de FLUX.2-pipeline aan met de gekozen resolutie, stappen, guidance en seed. Hij verzamelt alle tegels en geeft ze door aan make_grid(), zodat de gebruiker een eindraster van mix-and-match-outfits ziet.In deze stap koppelen we de capsule-wardrobe-engine aan de Gradio-app. De gebruiker uploadt kledingafbeeldingen, kiest raster- en generatiesettings en krijgt een samengesteld outfitraster terug.
inputs = [
    gr.File(file_types=["image"], file_count="multiple", label="Wardrobe pieces (2–10 images)"),
    gr.Slider(1, 4, value=2, step=1, label="Grid rows"),
    gr.Slider(1, 4, value=2, step=1, label="Grid cols"),
    gr.Slider(384, 896, value=512, step=64, label="Image height"),
    gr.Slider(256, 640, value=384, step=64, label="Image width"),
    gr.Slider(10, 30, value=16, step=2, label="Diffusion steps"),
    gr.Slider(1.0, 7.0, value=2.5, step=0.5, label="Guidance scale"),
    gr.Number(value=42, precision=0, label="Seed")
]
iface = gr.Interface(
    fn=capsule_fn,
    inputs=inputs,
    outputs=gr.Image(type="pil", label="Capsule wardrobe grid"),
    title="Capsule Wardrobe Visualizer – FLUX.2-dev (4-bit)",
    description="Upload 2–10 product images; mix & match outfits using FLUX.2-dev with multi-image reference.",
)
iface.launch(share=True, debug = True)
Zo bouwen we de Gradio-app:
gr.Interface koppelt deze inputs aan de functie capsule_fn en declareert één gr.Image-output. De aanroep launch(share=True, debug=True) start de Gradio-server, biedt een openbaar deelbare link voor demo’s en schakelt debuglogging in de console in om eventuele problemen te diagnosticeren.Zodra de interface live is:
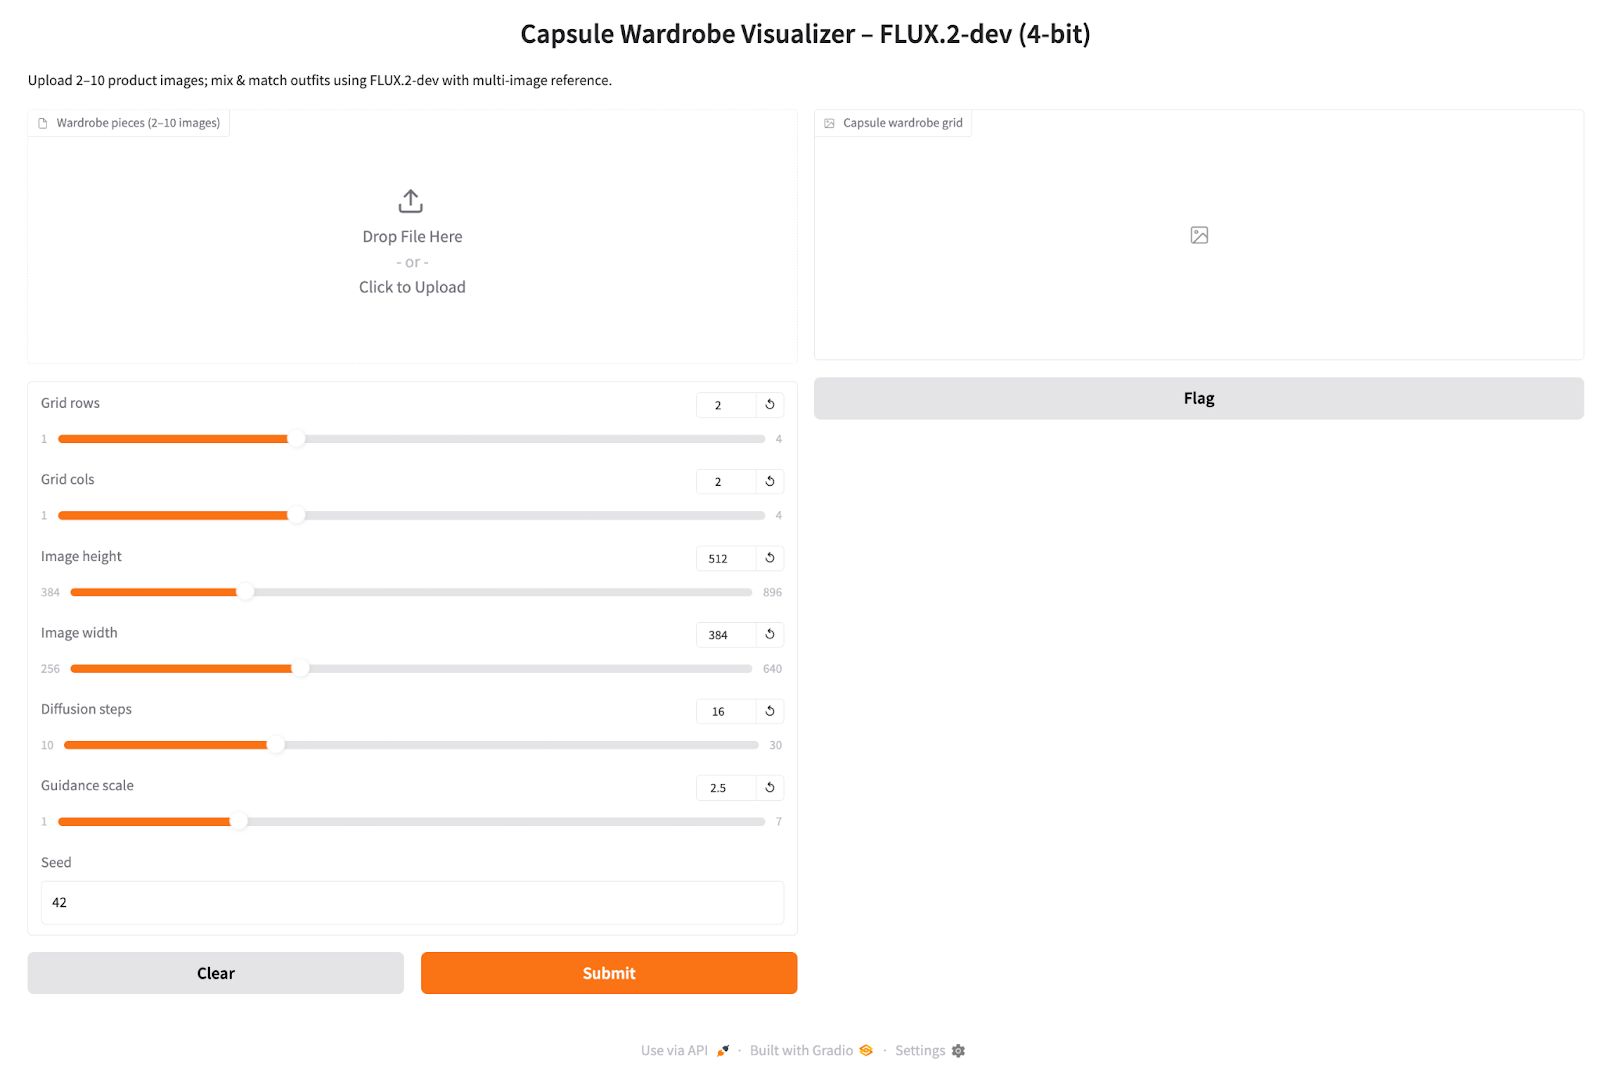
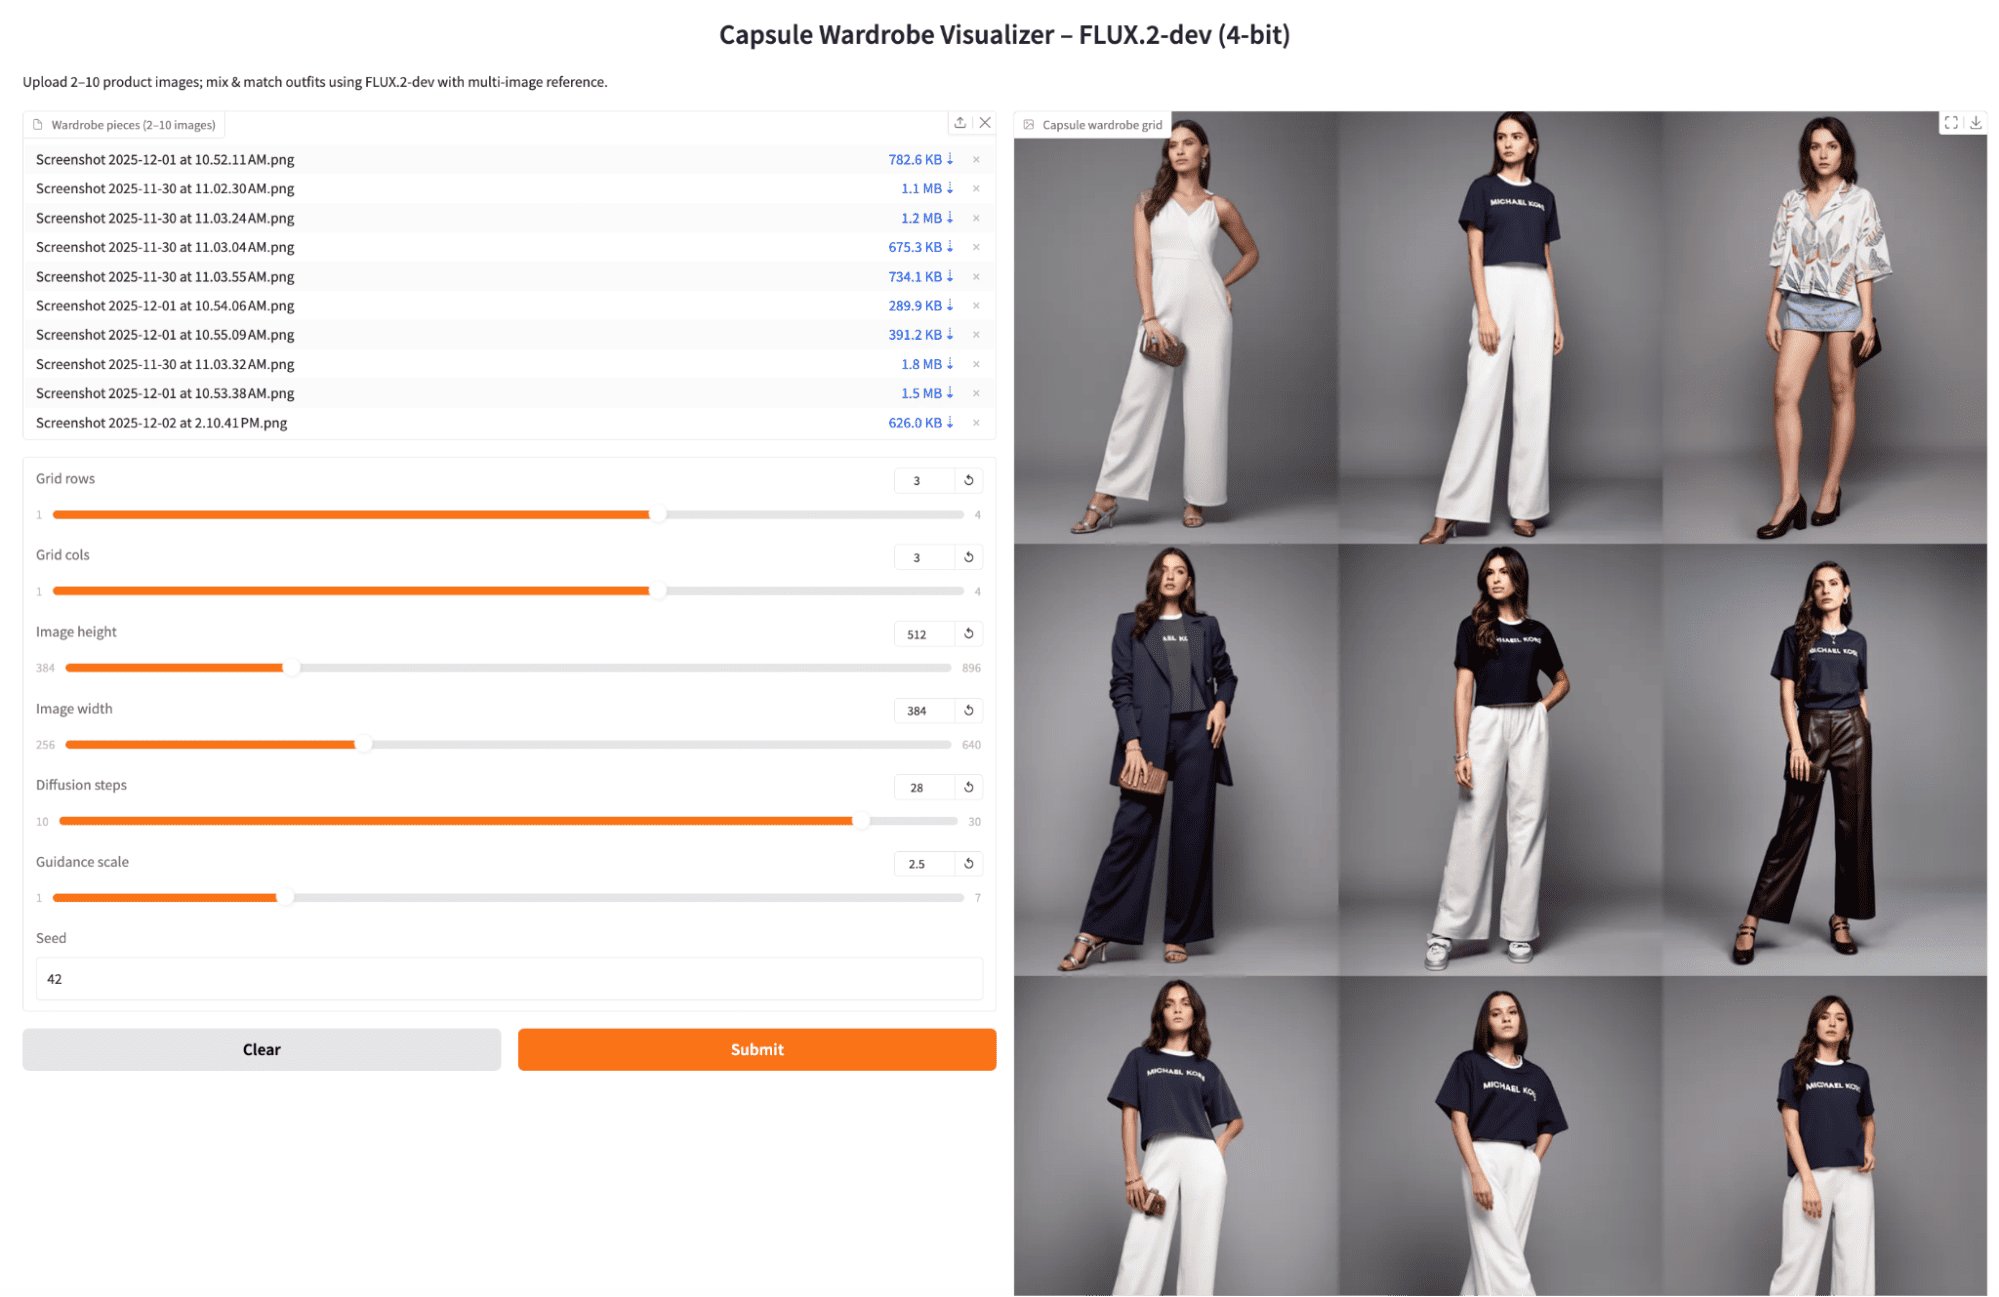
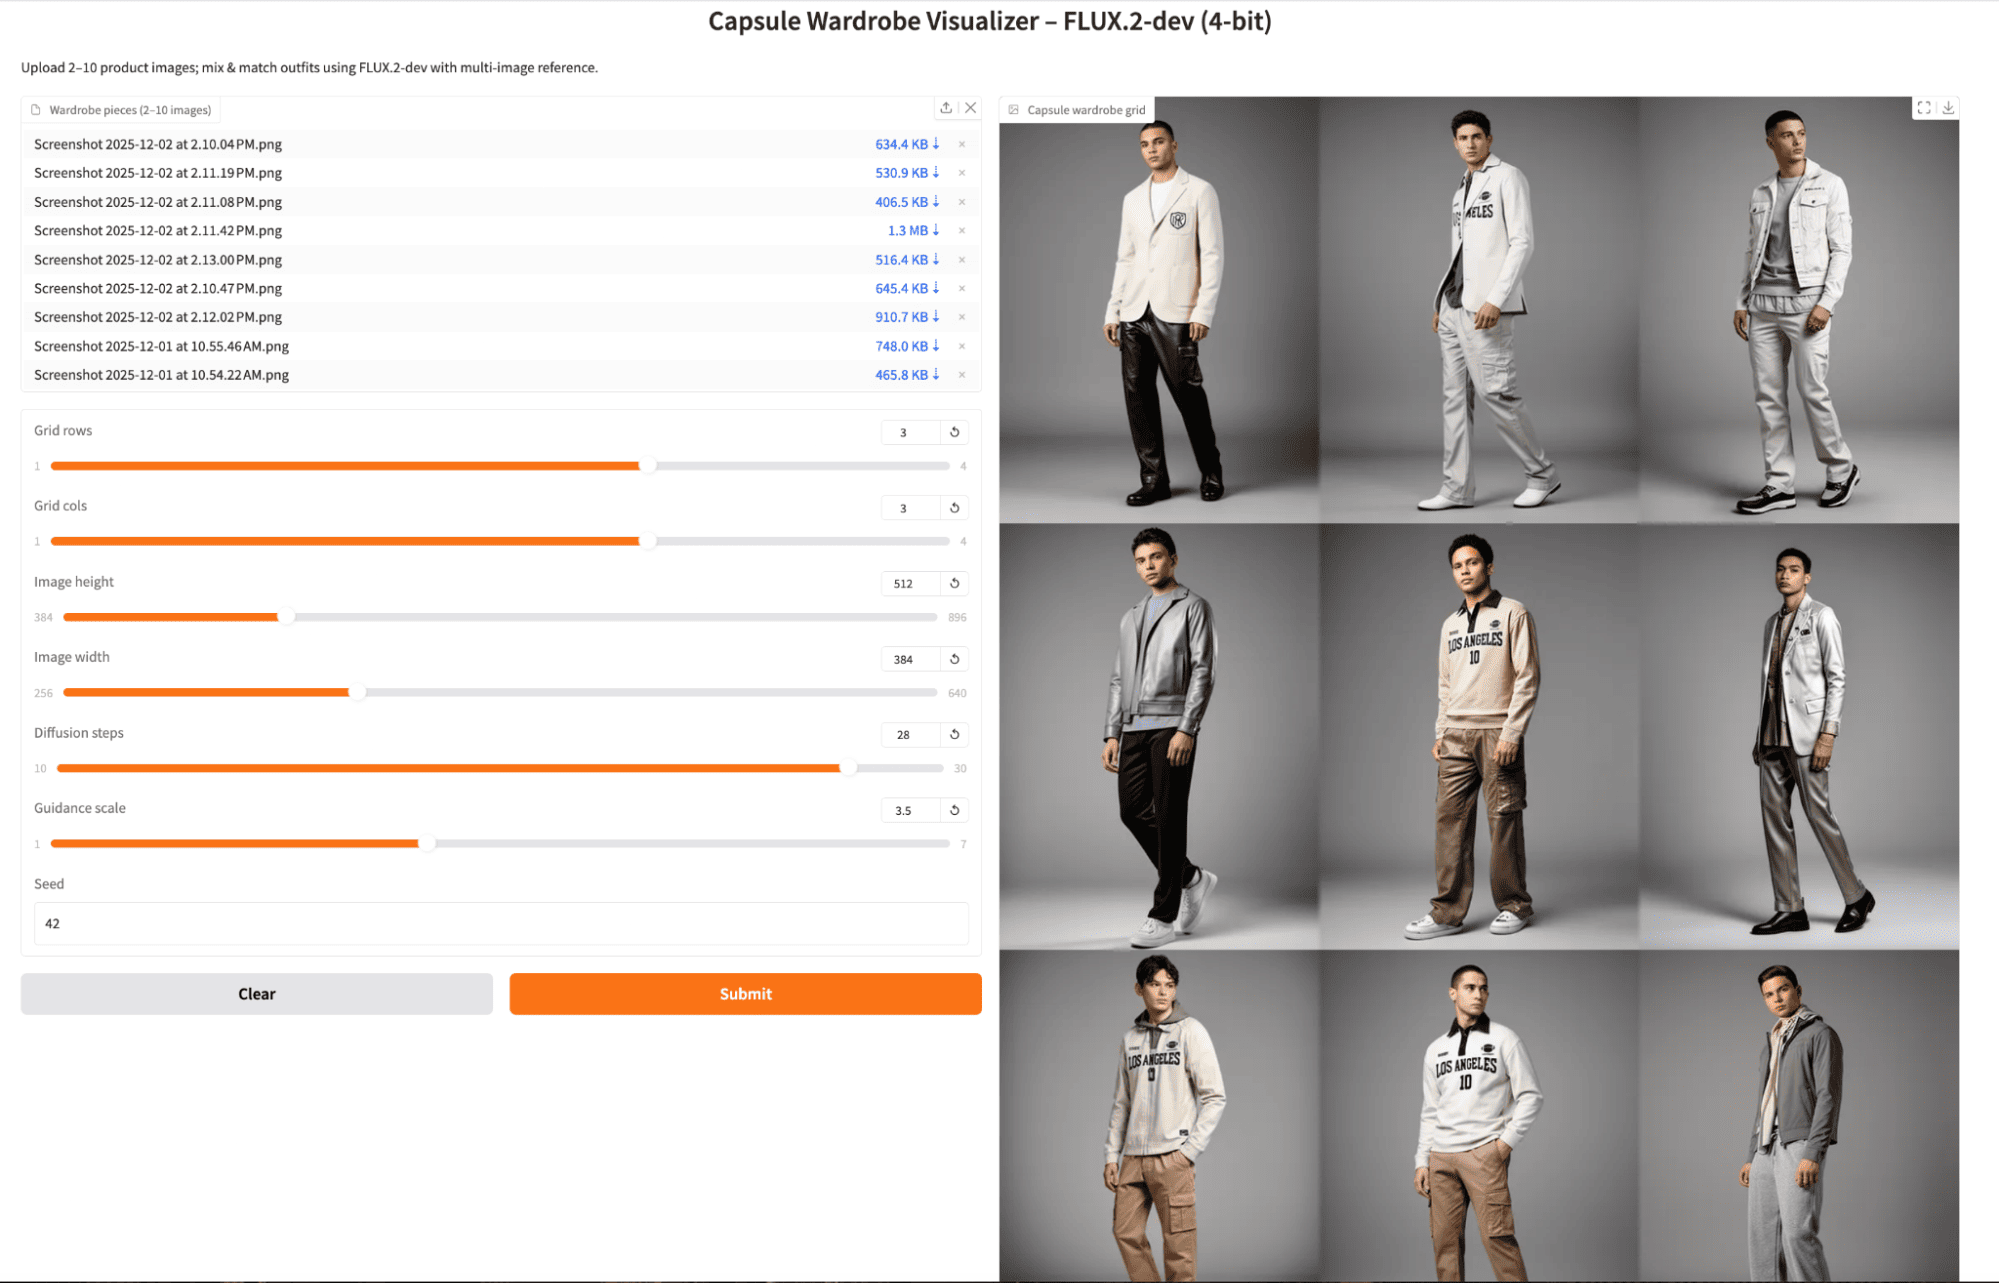
Om te begrijpen hoe FLUX.2-dev zich in de praktijk gedraagt, heb ik een paar kleine experimenten gedraaid met de uiteindelijke app. Ik varieerde de diffusiestappen en de guidance-schaal, en probeerde zowel meerdere afbeeldingen van hetzelfde kledingstuk als één afbeelding per uniek kledingstuk om te zien hoeveel variatie het model produceert.
Ik uploadde eerst meerdere afbeeldingen van dezelfde outfit vanuit verschillende hoeken, hield de standaard diffusiestappen en een gematigde guidance aan. Het model produceerde consistente studiobelichting en stofdetails, met outfits die aanvoelden als variaties op één capsuleset.
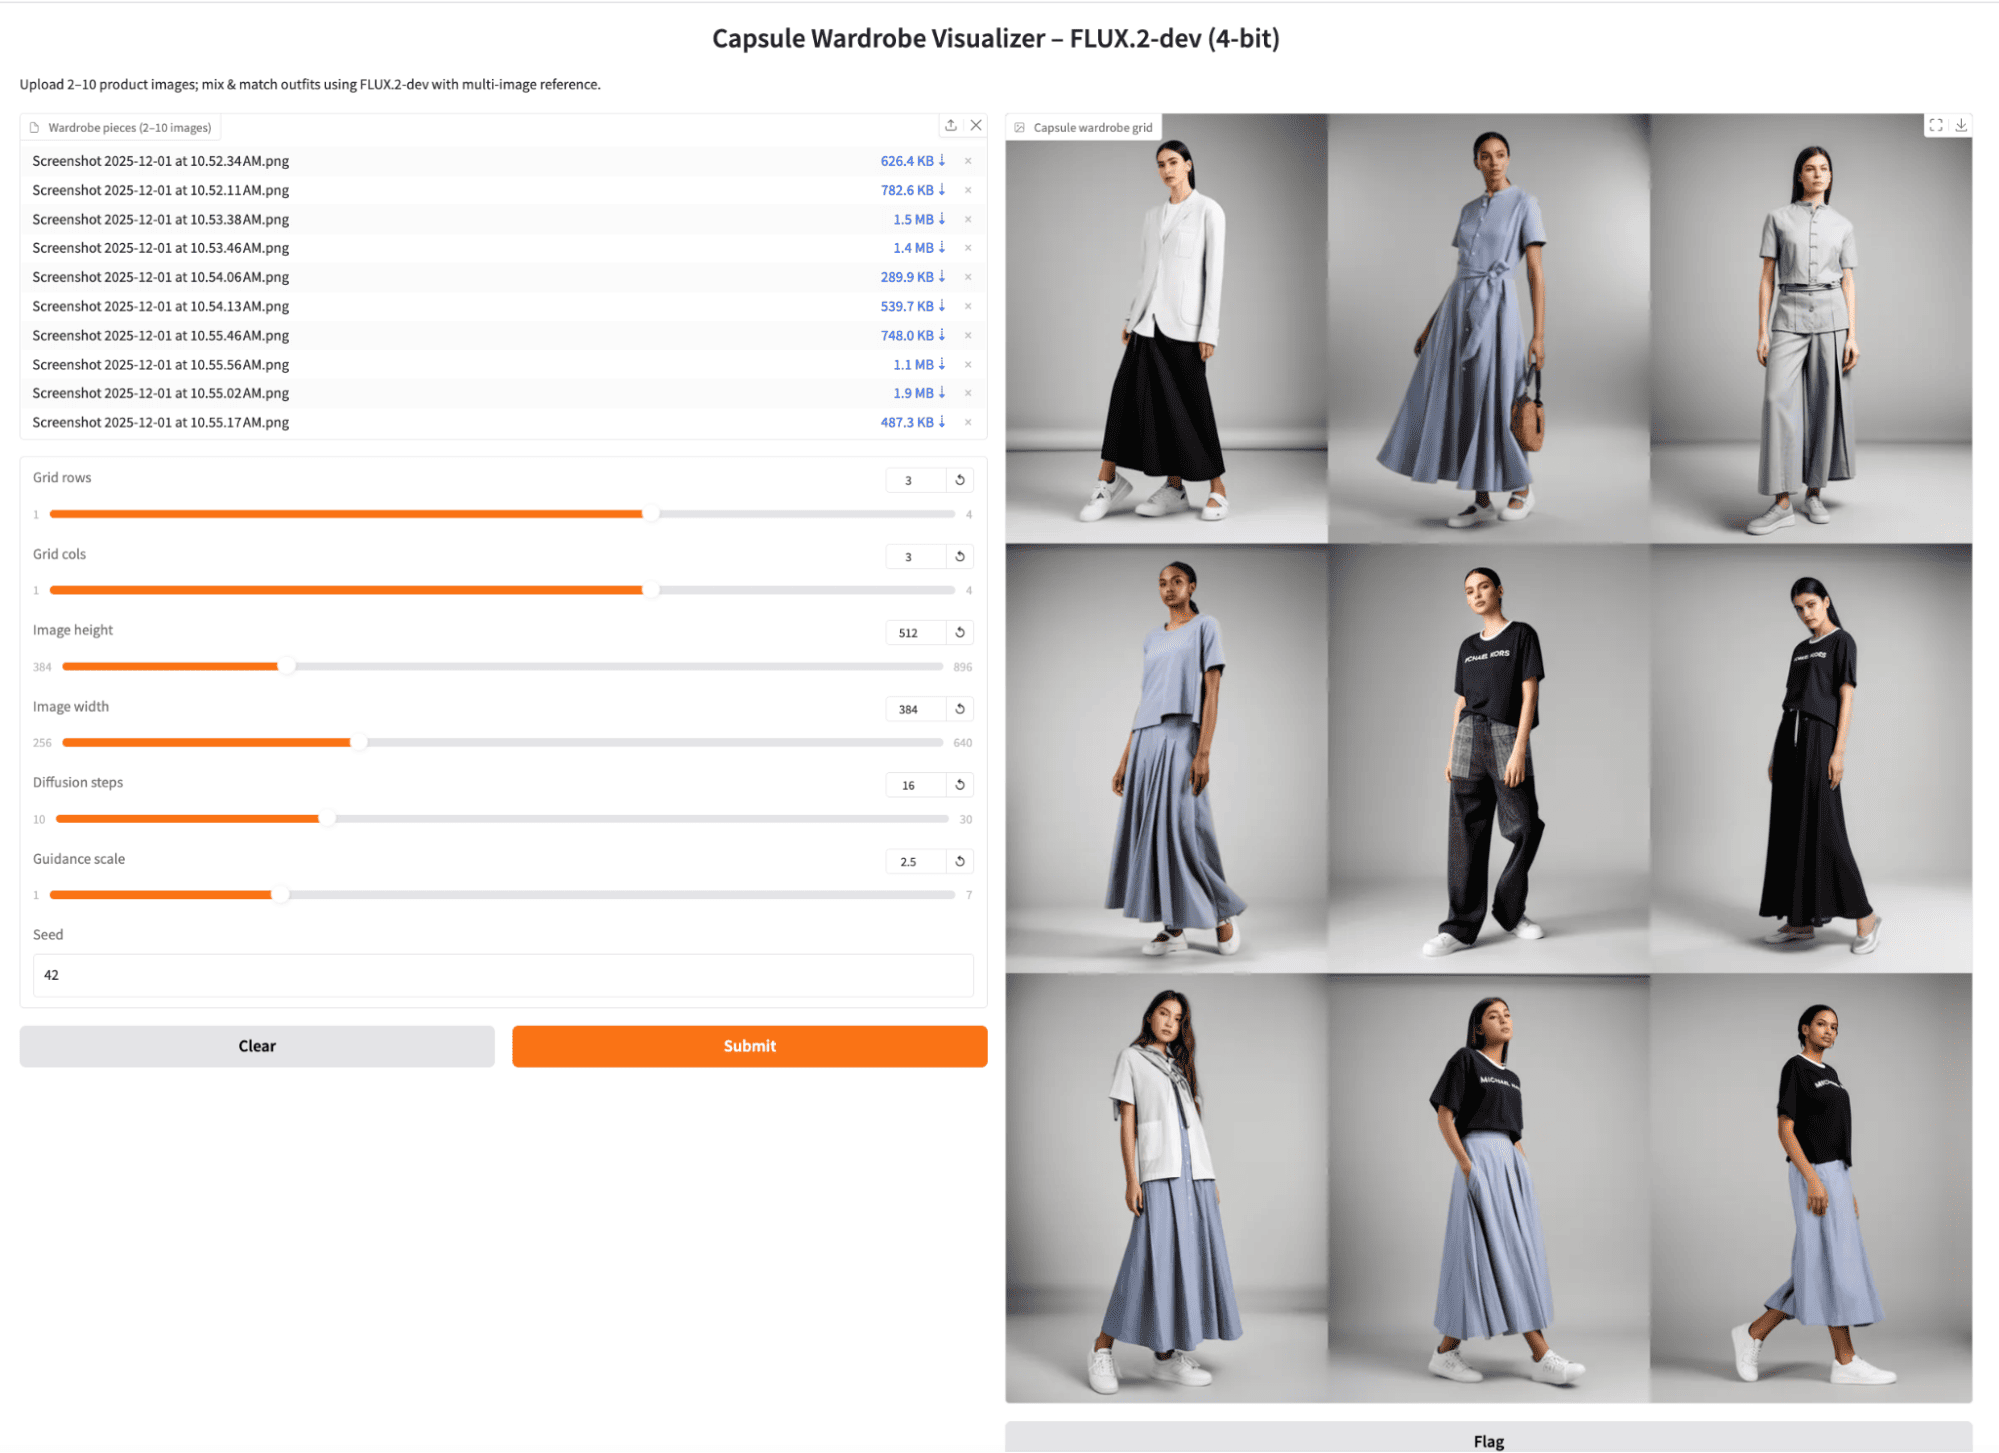
Vervolgens hield ik dezelfde referentieafbeeldingen, maar verhoogde de diffusiestappen naar 28 (en paste de guidance licht aan). Het raster werd iets scherper en meer gepolijst, maar bleef focussen op het hercombineren van dezelfde kernkledingstukken. De trade-off was een kleine maar merkbare toename in generatietijd per batch.
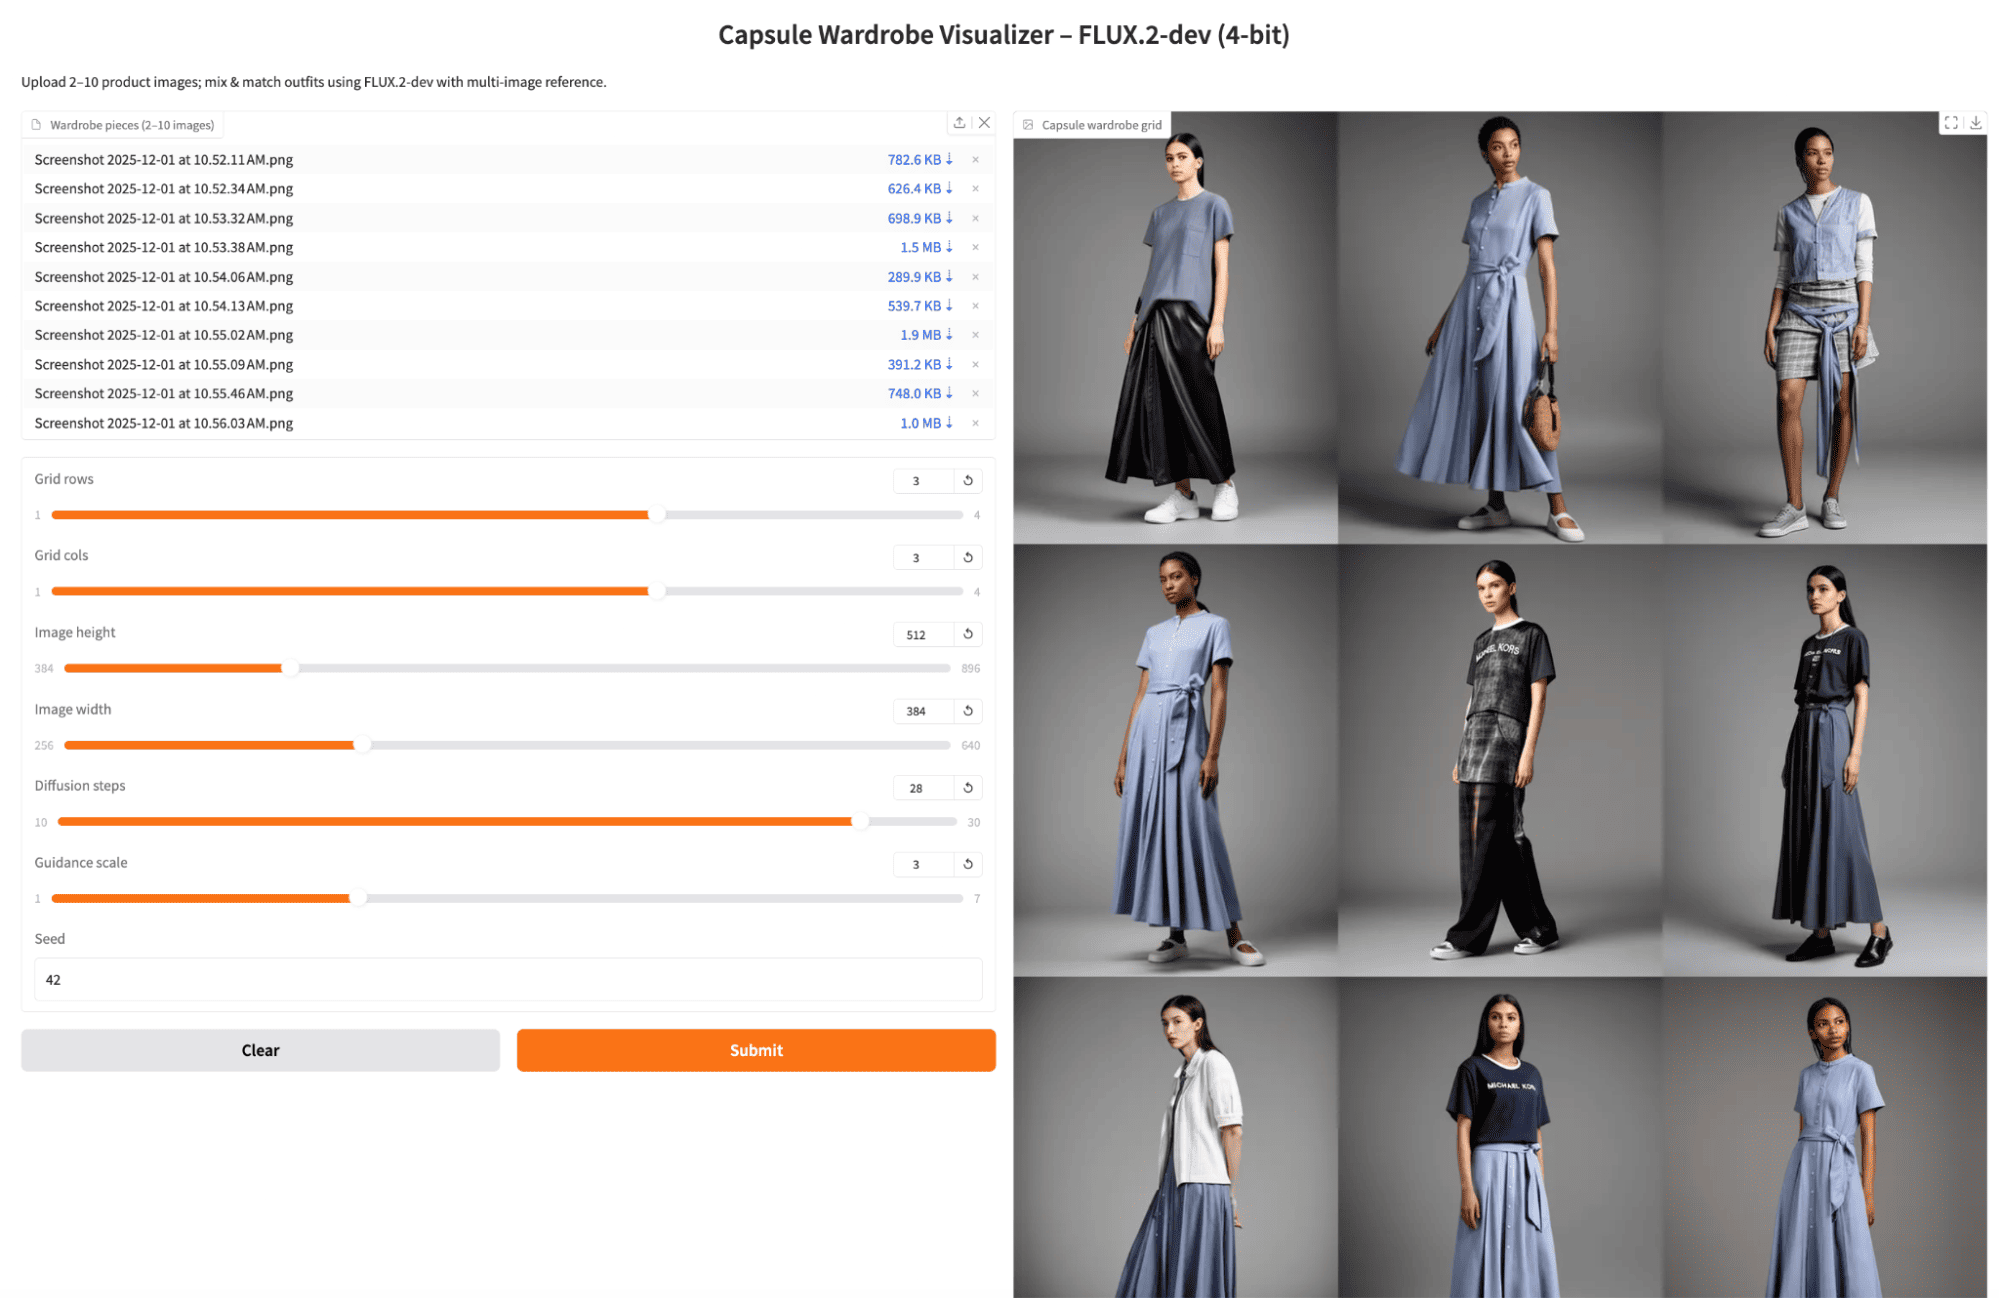
Tot slot uploadde ik één productshot per afzonderlijk kledingstuk en genereerde ik nog een 3x3-raster. De resulterende outfits waren veel gevarieerder over de cellen, met interessante combinaties van verschillende tops en bottoms. Er verscheen nog wat herhaling, maar al met al voelde het raster dichter bij een echte capsule wardrobe, met meer diverse combinaties voor dezelfde seed en instellingen.
FLUX.2-dev in 4-bit-vorm is een uitstekend model voor beeldtoepassingen. In deze tutorial hebben we een 4-bit FLUX.2-dev-pipeline opgezet met diffusers, een workflow met meerdere referentieafbeeldingen gebouwd die kledingstukken behandelt als conditioneringshints, en alles verpakt in een Gradio-app.
Het resultaat is een krachtige Capsule Wardrobe Visualizer die kan dienen als prototype voor fashion e-commerce tooling, of gewoon een speelse manier om je eigen kast te remixen. Vanaf hier kun je dezelfde pipeline aansluiten op bredere agentische systemen, zoals een LLM die outfits voorstelt op basis van dresscode of weer, of verbinding maken met een echte productcatalogus-backend.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

