Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
FLUX.2 é um modelo de texto para imagem moderno, feito para geração de alta qualidade e com controle fino. Neste tutorial, vou mostrar como usar a variante FLUX.2-dev para construir um visualizador de guarda-roupa cápsula em que você envia de 2 a 10 imagens de roupas (camisas, calças, jaquetas, sapatos etc.), o modelo cria amostras de combinações dessas peças e o app retorna uma grade de looks que as misturam de diferentes formas.
O resultado é uma ferramenta interativa que permite explorar visualmente combinações de looks, alimentada por um modelo de difusão otimizado para memória de GPU.
Se você quer se aprofundar nos princípios por trás deste tutorial, recomendo conferir o curso Deep Learning for Images with PyTorch.
FLUX.2 é uma família de modelos texto para imagem, cada um otimizado para pontos diferentes no espectro de qualidade, velocidade e flexibilidade, em vez de um único checkpoint monolítico. Ele traz várias capacidades importantes:
Na prática, você verá três variantes principais:
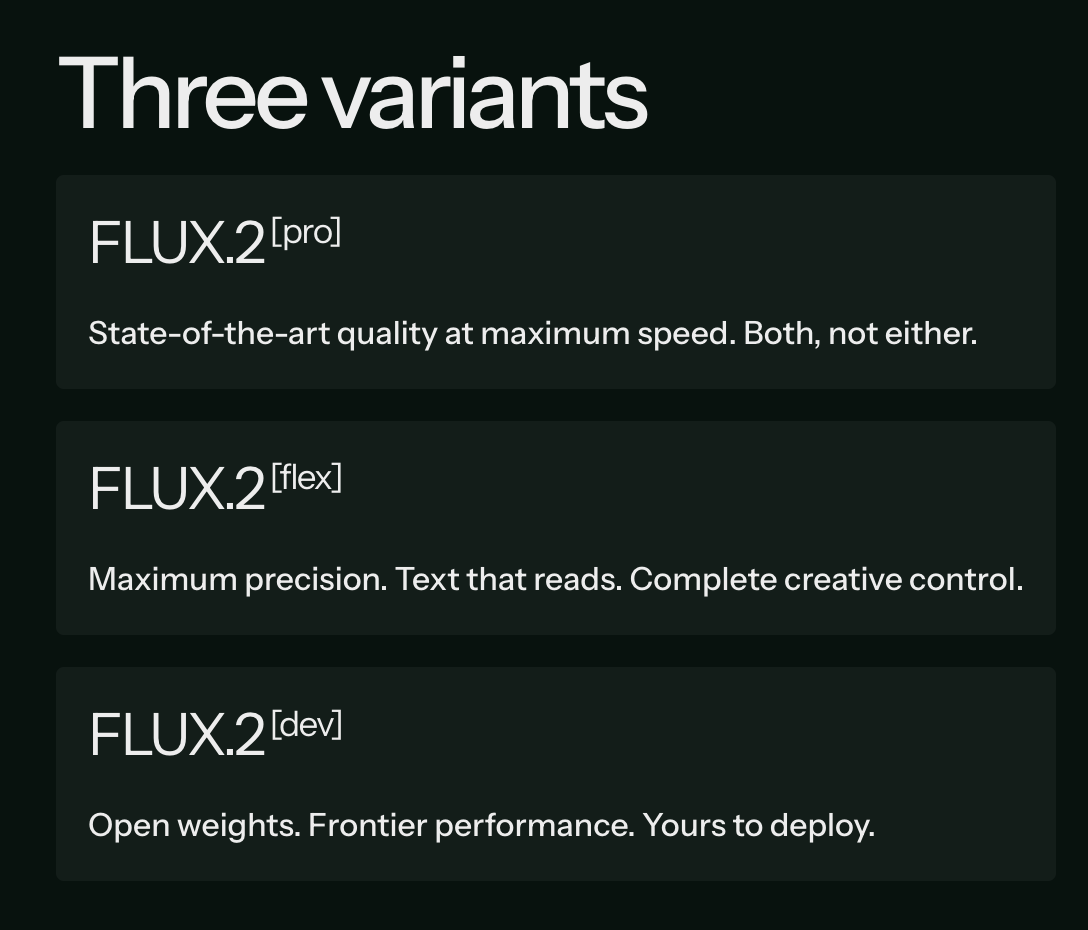
Em comparação com Pro e Flex, a Dev foi feita para quem quer experimentar — exatamente o que precisamos para a nossa grade interativa de guarda-roupa cápsula.
A linha FLUX.2 original já é poderosa, mas FLUX.2-Dev com quantização de 4 bits torna esta demo muito mais fácil de rodar, iterar e evoluir. Eis o porquê:
Resumindo: FLUX.2-Dev (4 bits) oferece o melhor equilíbrio entre memória, velocidade e qualidade para uma ferramenta interativa de guarda-roupa cápsula.
Nesta seção, vamos implementar um visualizador de guarda-roupa cápsula com um modelo FLUX 2 empacotado em um app Gradio. Em alto nível, o app faz três coisas:
No vídeo abaixo, você vê uma versão resumida do fluxo. O vídeo está acelerado para demonstração (a geração real pode levar alguns minutos):
Primeiro, instale a versão mais recente da biblioteca diffusers a partir do GitHub e as demais dependências.
!pip install -q "git+https://github.com/huggingface/diffusers.git@main" \
               "transformers>=4.44.0" accelerate safetensors bitsandbytes gradio pillow
Depois, faça login no Hugging Face para baixar os pesos 4-bit do FLUX.2-dev:
from huggingface_hub import login
login()
Informe seu token da HF quando solicitado e faça login para puxar o modelo. Em seguida, faça um sanity check rápido para ver se o CUDA está disponível e qual GPU está sendo usada:
import torch, diffusers, bitsandbytes as bnb
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smi
Se você enxergar sua GPU na saída do nvidia-smi e CUDA available: True, está tudo certo.
Agora vamos carregar os componentes 4-bit do FLUX.2-dev do repositório diffusers/FLUX.2-dev-bnb-4bit.
from diffusers import Flux2Pipeline, Flux2Transformer2DModel
from transformers import Mistral3ForConditionalGeneration
import torch
bnb_repo = "diffusers/FLUX.2-dev-bnb-4bit"
torch_dtype = torch.bfloat16
device = "cuda"
print("Loading 4-bit transformer...")
transformer = Flux2Transformer2DModel.from_pretrained(
    bnb_repo,
    subfolder="transformer",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Loading 4-bit text encoder...")
text_encoder = Mistral3ForConditionalGeneration.from_pretrained(
    bnb_repo,
    subfolder="text_encoder",
    torch_dtype=torch_dtype,
    device_map="auto",
)
print("Building Flux2 pipeline...")
pipe = Flux2Pipeline.from_pretrained(
    bnb_repo,
    transformer=transformer,
    text_encoder=text_encoder,
    torch_dtype=torch_dtype,
).to(device)
pipe.set_progress_bar_config(disable=False)
print("Loaded. Example param device:", next(pipe.transformer.parameters()).device)
Com as dependências instaladas, podemos carregar o FLUX.2 usando a biblioteca diffusers e pareá-lo com um codificador de texto Mistral 3 do transformers. Em código, fica assim:
Flux2Transformer2DModel: o transformador do tipo U-Net responsável pelo processo de remoção de ruído, carregado na forma quantizada em 4 bits.Mistral3ForConditionalGeneration: usado como codificador de texto, convertendo seu prompt em sinais de condicionamento para o processo de difusão.Flux2Pipeline: compõe o transformador, o codificador de texto e componentes de suporte em uma interface única e chamável para geração de imagens.Usar device_map="auto" e torch_dtype=torch.bfloat16 mantém tudo flexível entre diferentes GPUs, sem abrir mão da eficiência de memória.
O app permite que o usuário envie várias imagens de roupas. Precisamos de alguns utilitários para isso:
import gradio as gr
import random, json
from typing import List, Union
from PIL import Image
MAX_REFS = 10
def files_to_pil(files: List[Union[str, dict]]) -> List[Image.Image]:
    images = []
    for f in files:
        path = f.get("name") if isinstance(f, dict) else f
        if not path:
            continue
        img = Image.open(path).convert("RGB")
        images.append(img)
    return images
def preprocess_refs(refs: List[Image.Image], max_size: int = 512) -> List[Image.Image]:
    processed = []
    for img in refs:
        img = img.convert("RGB")
        img.thumbnail((max_size, max_size), Image.LANCZOS)
        processed.append(img)
    return processed
O código acima define duas funções auxiliares importantes.
files_to_pil() recebe os objetos de arquivo retornados pelo Gradio, extrai seus caminhos e abre cada arquivo como um PIL.Image em RGB.preprocess_refs() redimensiona essas imagens para no máximo 512 × 512 preservando a proporção, o que é importante para velocidade e uso de memória.Além disso, limitamos o número de imagens de referência com MAX_REFS = 10 para não sobrecarregar o conjunto de condicionamento.
Em vez de enviar um prompt simples, criei um prompt estruturado, no estilo JSON, que descreve:
def build_outfit_prompt(outfit_indices: List[int], labels: List[str]) -> str:
    item_phrases = [
        f"{labels[idx]} from reference image {idx+1}" for idx in outfit_indices
    ]
    outfit_items_str = ", ".join(item_phrases)
    mistral_prompt = """A professional full-body studio photograph of a high-end fashion editorial shoot, set against a flawless seamless neutral gray backdrop (#f5f5f5) in a controlled studio environment. The scene is bathed in soft, diffused three-point lighting (key, fill, and subtle rim) that eliminates harsh shadows, ensuring even illumination across the subject while preserving dimensionality and texture.
At the center of the frame stands a full-body adult model, exuding quiet confidence in a relaxed yet poised stance—one foot slightly forward, weight balanced, body angled subtly to the right. The model’s expression is natural, with a neutral gaze directed just off-camera, evoking a modern, minimalist lookbook aesthetic.
The outfit—meticulously styled and tailored—is the focal point, captured with ultra-realistic 8K resolution and razor-sharp detail. Fabrics display tactile depth: the weave of knits, the drape of silks, the sheen of leathers, and the crispness of cotton are all rendered with commercial-grade precision. The shallow depth of field (50mm prime lens, f/2.8) keeps the subject in crystalline focus while softly blurring the backdrop, emphasizing the outfit’s textures and proportions.
The composition adheres to classic fashion photography rules: vertical framing, ample headroom, and a slightly dynamic angle (eye-level) that flatters the model’s posture. The color palette is controlled and sophisticated, dominated by the outfit’s hues against the neutral gray, with subtle tonal contrasts to highlight layers and accessories.
Every element—from the studio-quality lighting to the catalog-ready styling—conveys luxury, clarity, and commercial appeal, designed to showcase the outfit as a covetable, high-end ensemble."""
    prompt_dict = {
        "scene": mistral_prompt,
        "subjects": [
            {
                "description": (
                    "The model is styled in an outfit composed of: "
                    + outfit_items_str
                    + ". Each garment should closely match the color, fabric, and key design details of its reference image."
                )
            }
        ]
    }
    return json.dumps(prompt_dict)
A função build_outfit_prompt() faz três coisas importantes:
outfit_indices e labels para gerar frases como "peça do guarda-roupa 1 da imagem de referência 1", unindo tudo em uma única string que descreve as peças selecionadas para aquele look.prompt_dict com campos de cena e sujeitos, e serializamos para JSON para que possa ser enviado como uma única string de prompt ao pipeline.Conceitualmente, tratamos cada imagem enviada como uma “peça do guarda-roupa i” e pedimos ao modelo para “montar um look usando a peça 1, a peça 3 e a peça 4”, preservando cor, tecido e detalhes-chave de cada peça.
Observação: como usamos um modelo Mistral como codificador de texto neste pipeline, também usei o Mistral para ajudar a redigir o prompt longo de descrição de estúdio (mistral_prompt) via meta prompting. Isso mantém o estilo alinhado com o que o codificador “espera” e facilita ajustar o texto diretamente no código.
O coração da demo é a capsule_fn, que:
def make_grid(images: List[Image.Image], rows: int, cols: int) -> Image.Image:
    w, h = images[0].size
    grid = Image.new("RGB", (cols * w, rows * h), (255, 255, 255))
    for idx, img in enumerate(images):
        r, c = divmod(idx, cols)
        grid.paste(img, (c * w, r * h))
    return grid
def capsule_fn(files, rows, cols, height, width, steps, guidance, seed):
    if not files or len(files) < 2:
        return None
    images = files_to_pil(files)
    images = images[:MAX_REFS]
    refs = preprocess_refs(images, max_size=512)
    labels = [f"wardrobe piece {i+1}" for i in range(len(refs))]
    random.seed(int(seed))
    tiles = []
    num_tiles = rows * cols
    for i in range(num_tiles):
        k = min(len(refs), random.randint(2, 3))
        outfit_idxs = random.sample(range(len(refs)), k=k)
        prompt = build_outfit_prompt(outfit_idxs, labels)
        generator = torch.Generator(device=device).manual_seed(int(seed) + i)
        out = pipe(
            prompt=prompt,
            image=refs,
            height=height,
            width=width,
            num_inference_steps=steps,
            guidance_scale=guidance,
            generator=generator,
        )
        tiles.append(out.images[0])
    grid = make_grid(tiles, rows, cols)
    return grid
Essas duas funções formam o motor principal da nossa demo de guarda-roupa cápsula.
make_grid() cria uma tela em branco do tamanho necessário para o layout de linhas × colunas e cola cada imagem de look na posição correta, gerando uma única imagem em grade.capsule_fn() prepara as imagens do usuário como referências, seleciona aleatoriamente 2–3 peças por célula, constrói um prompt estruturado e chama o pipeline FLUX.2 com a resolução, etapas, guidance e seed escolhidas. Ela coleta todas as células geradas e as envia para make_grid(), para que o usuário veja a grade final com looks mix & match.Agora conectamos o motor do guarda-roupa cápsula ao app em Gradio. O usuário envia imagens, escolhe as configurações de grade e geração e recebe de volta a grade composta de looks.
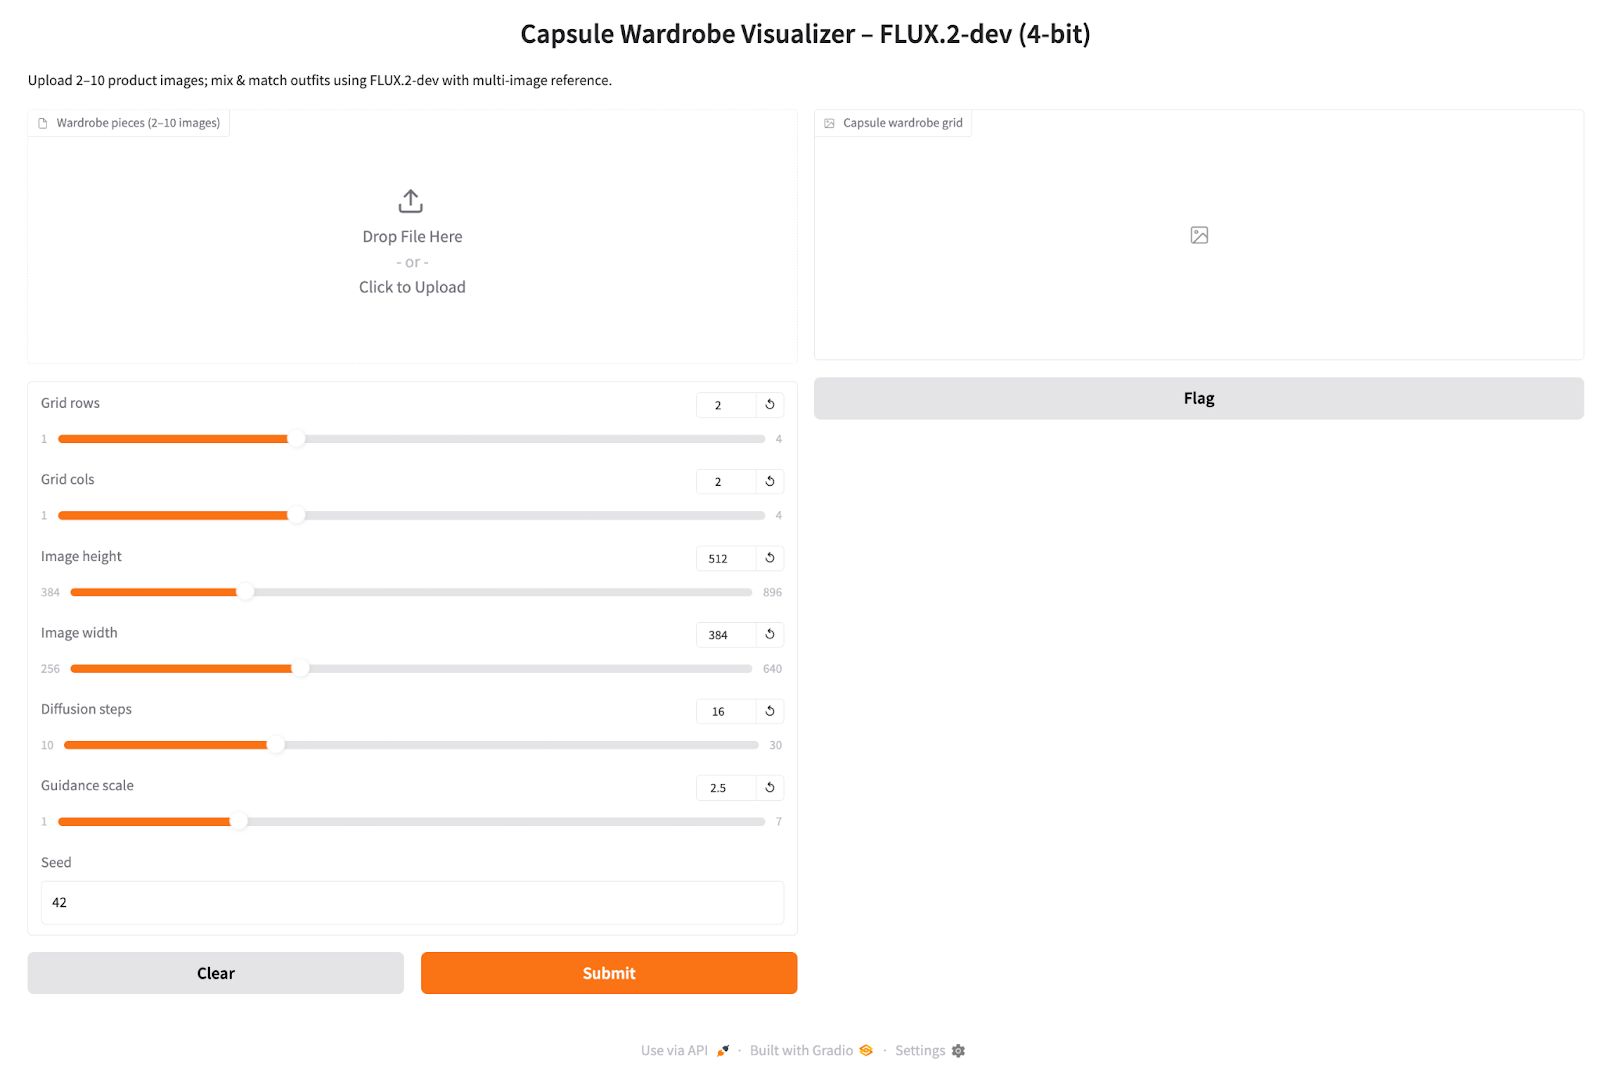
inputs = [
    gr.File(file_types=["image"], file_count="multiple", label="Wardrobe pieces (2–10 images)"),
    gr.Slider(1, 4, value=2, step=1, label="Grid rows"),
    gr.Slider(1, 4, value=2, step=1, label="Grid cols"),
    gr.Slider(384, 896, value=512, step=64, label="Image height"),
    gr.Slider(256, 640, value=384, step=64, label="Image width"),
    gr.Slider(10, 30, value=16, step=2, label="Diffusion steps"),
    gr.Slider(1.0, 7.0, value=2.5, step=0.5, label="Guidance scale"),
    gr.Number(value=42, precision=0, label="Seed")
]
iface = gr.Interface(
    fn=capsule_fn,
    inputs=inputs,
    outputs=gr.Image(type="pil", label="Capsule wardrobe grid"),
    title="Capsule Wardrobe Visualizer – FLUX.2-dev (4-bit)",
    description="Upload 2–10 product images; mix & match outfits using FLUX.2-dev with multi-image reference.",
)
iface.launch(share=True, debug = True)
Como montamos o app em Gradio:
gr.Interface conecta esses inputs à função capsule_fn e declara uma única saída gr.Image. O launch(share=True, debug=True) inicia o servidor do Gradio, expõe um link público para demos e habilita logs de debug no console para ajudar no diagnóstico.Com a interface no ar:
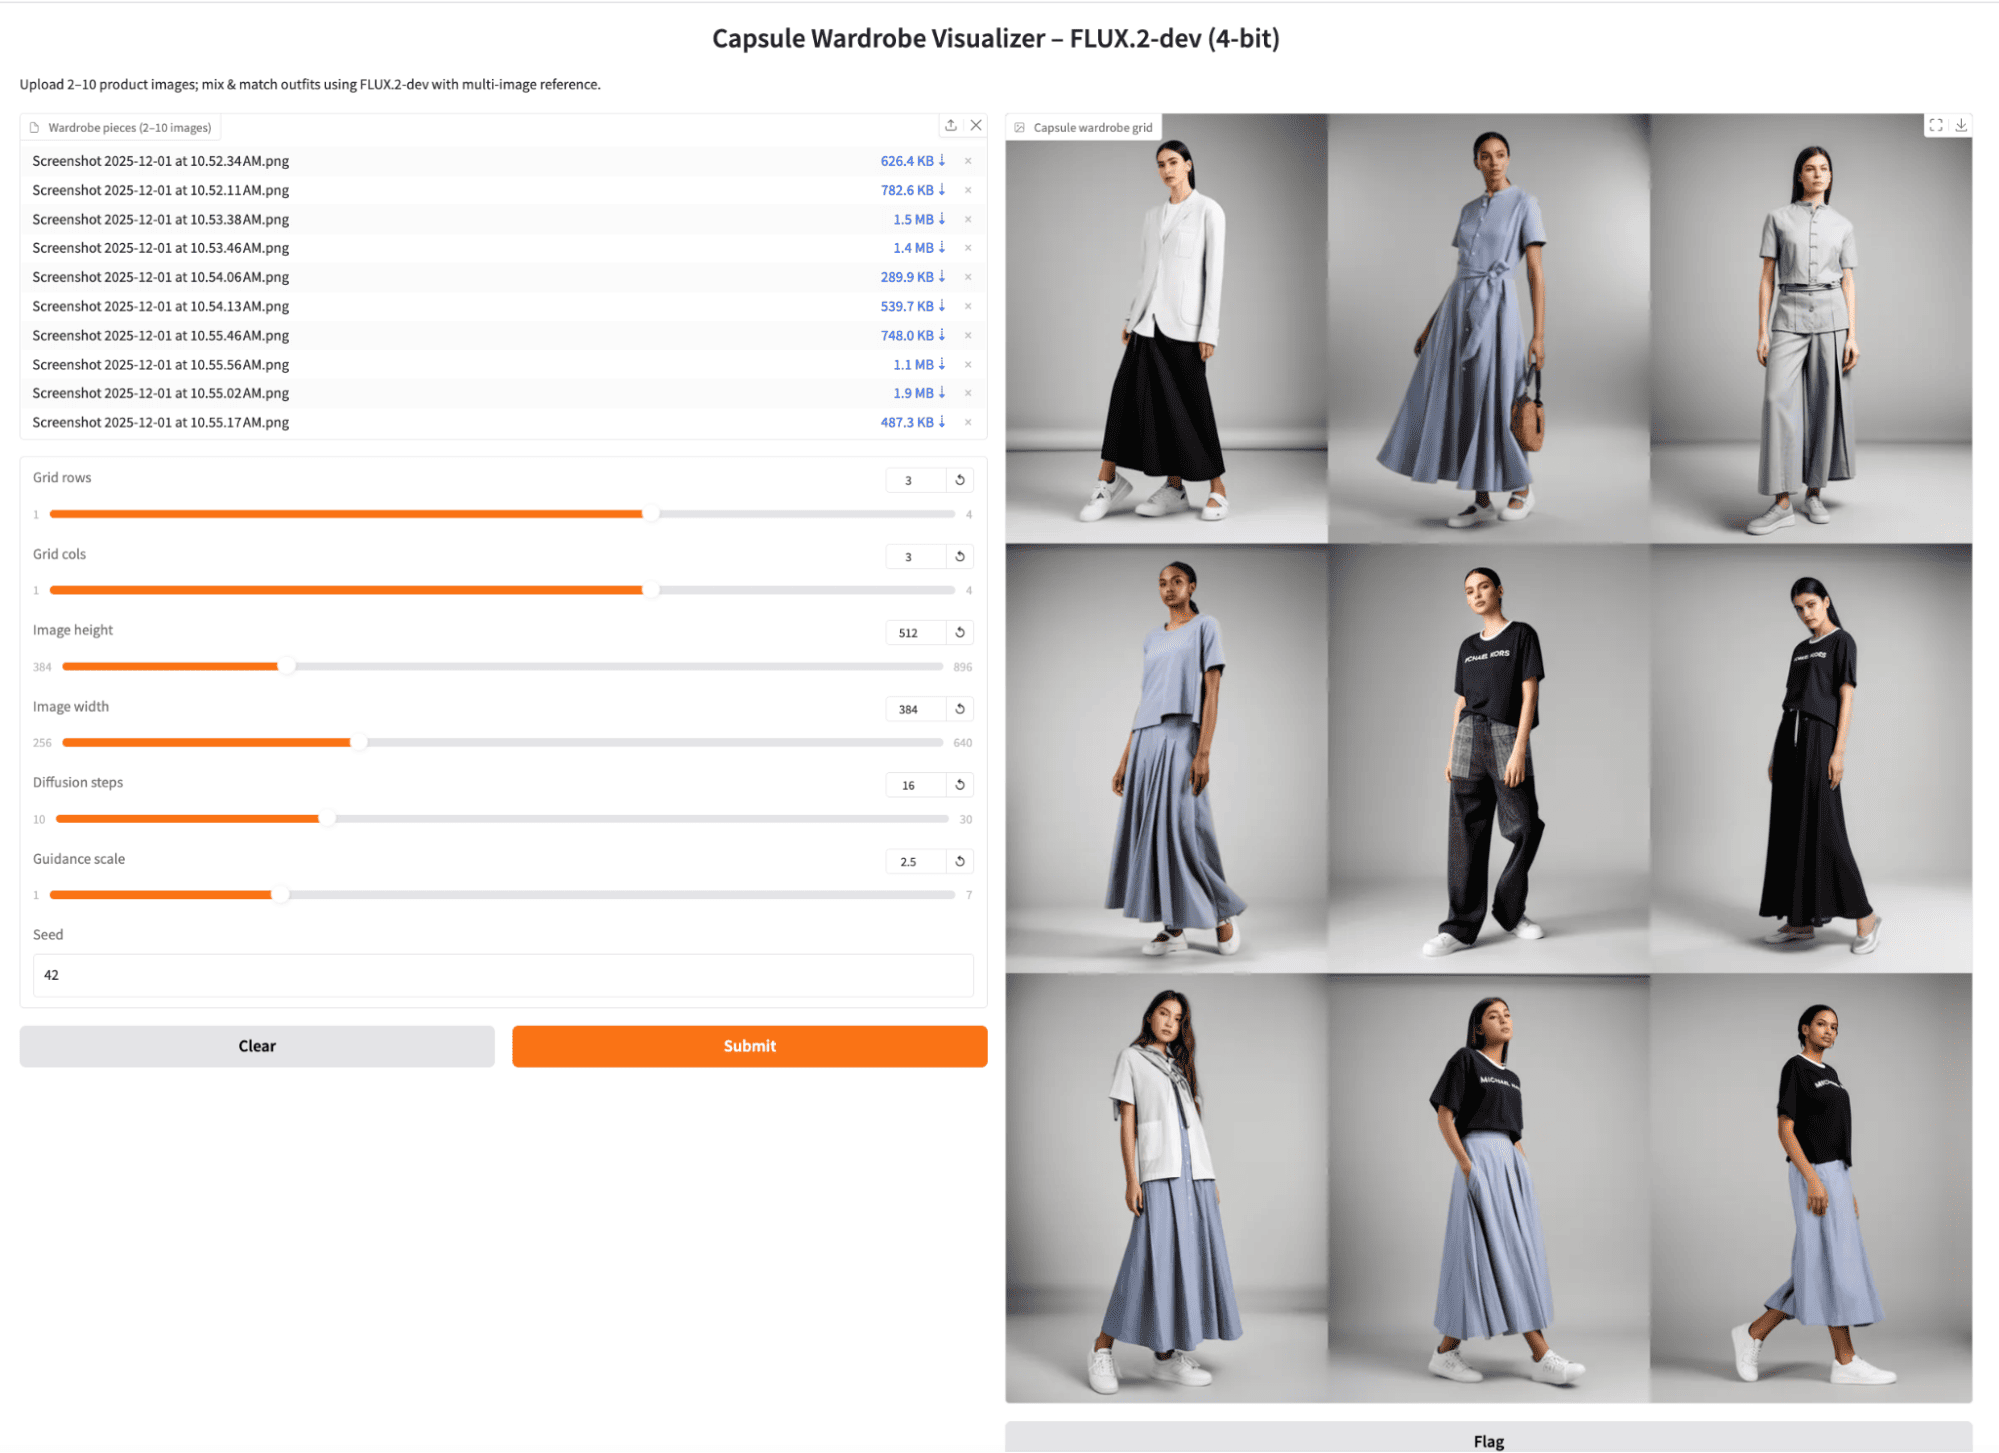
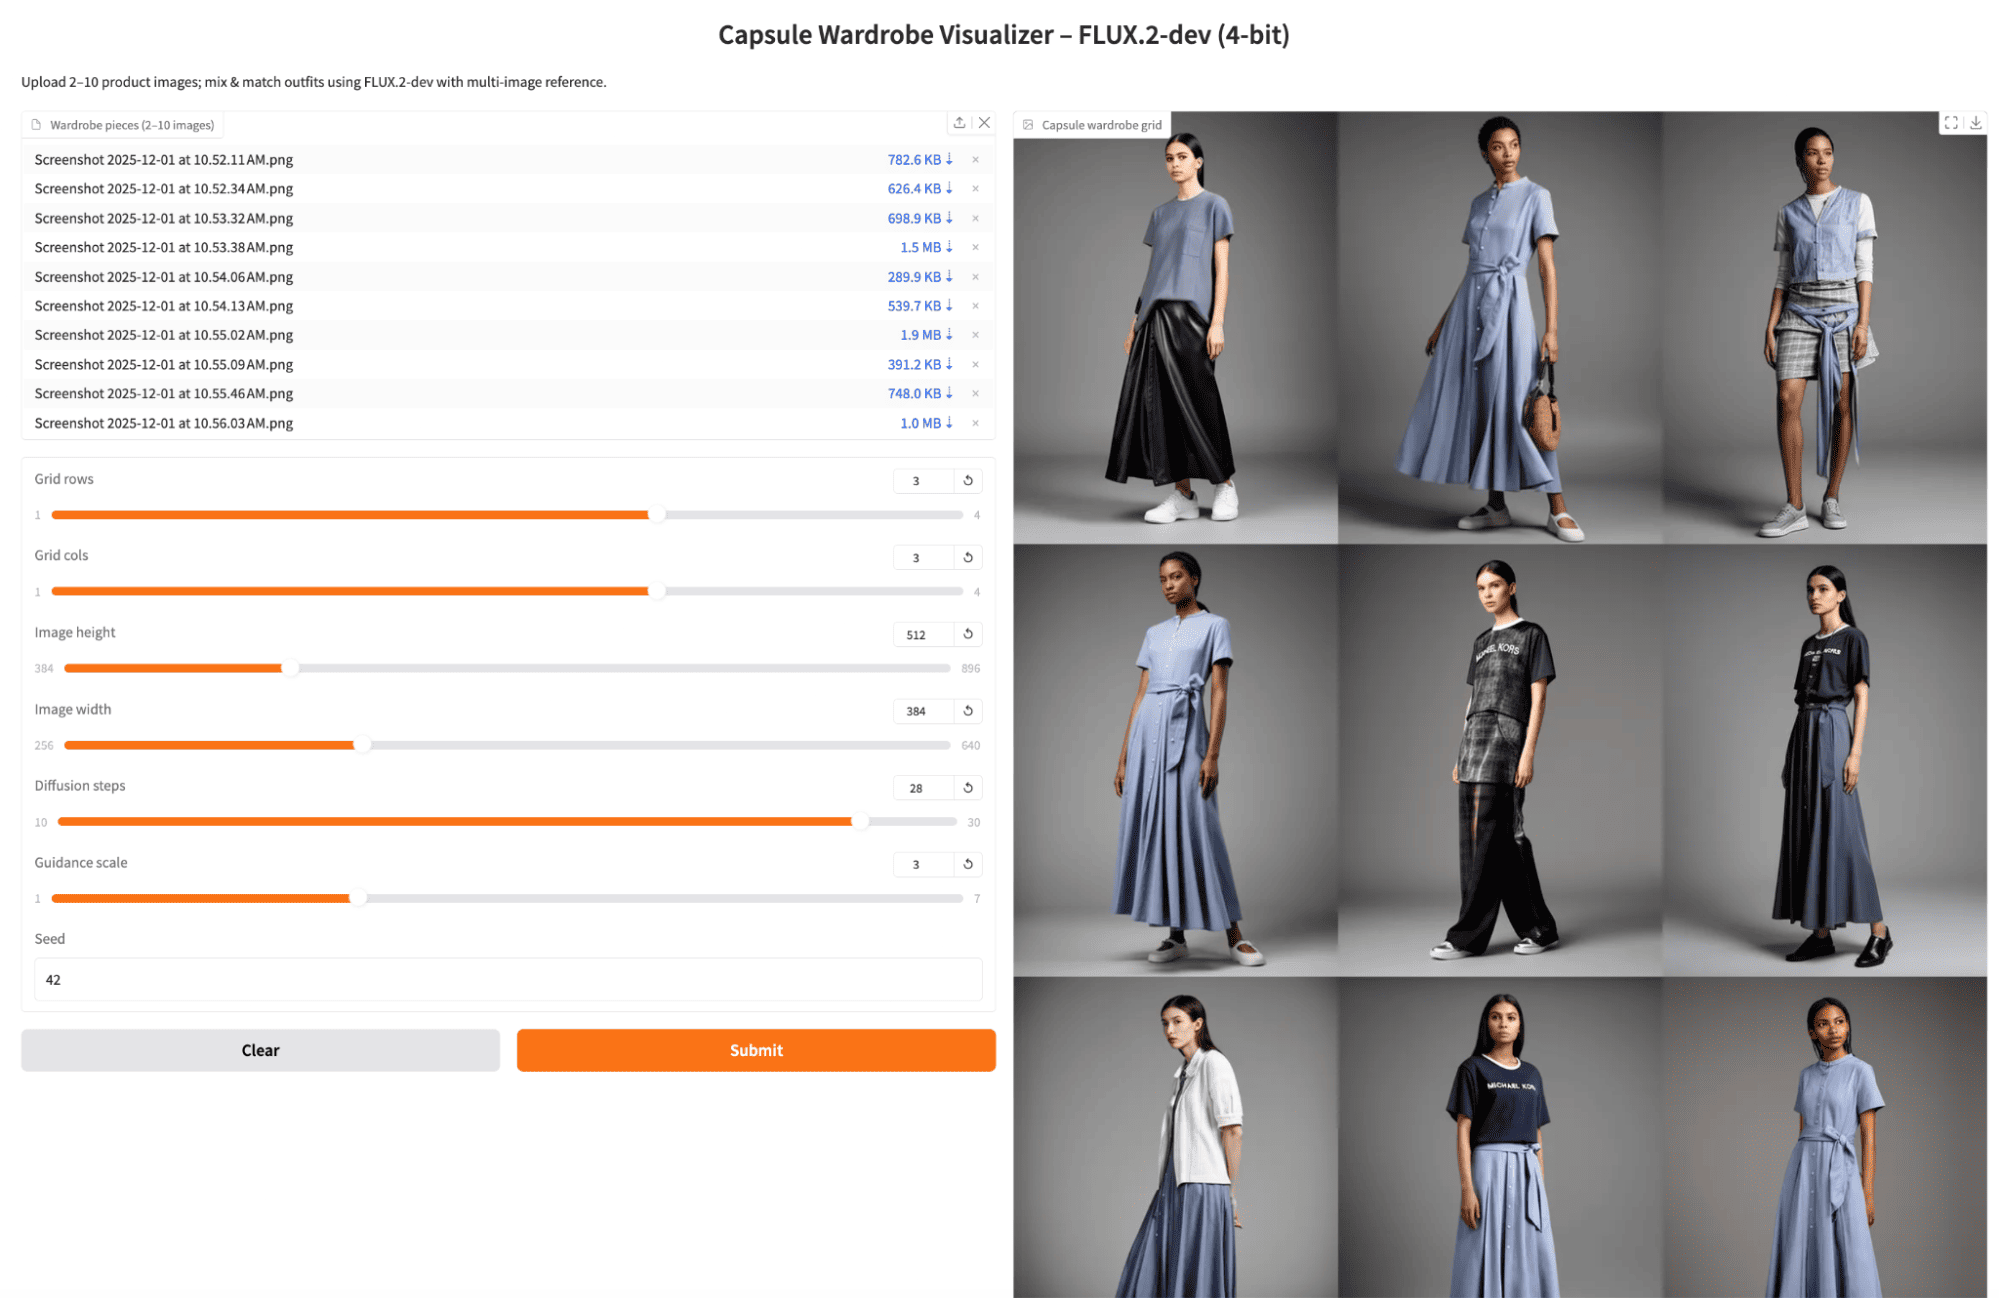
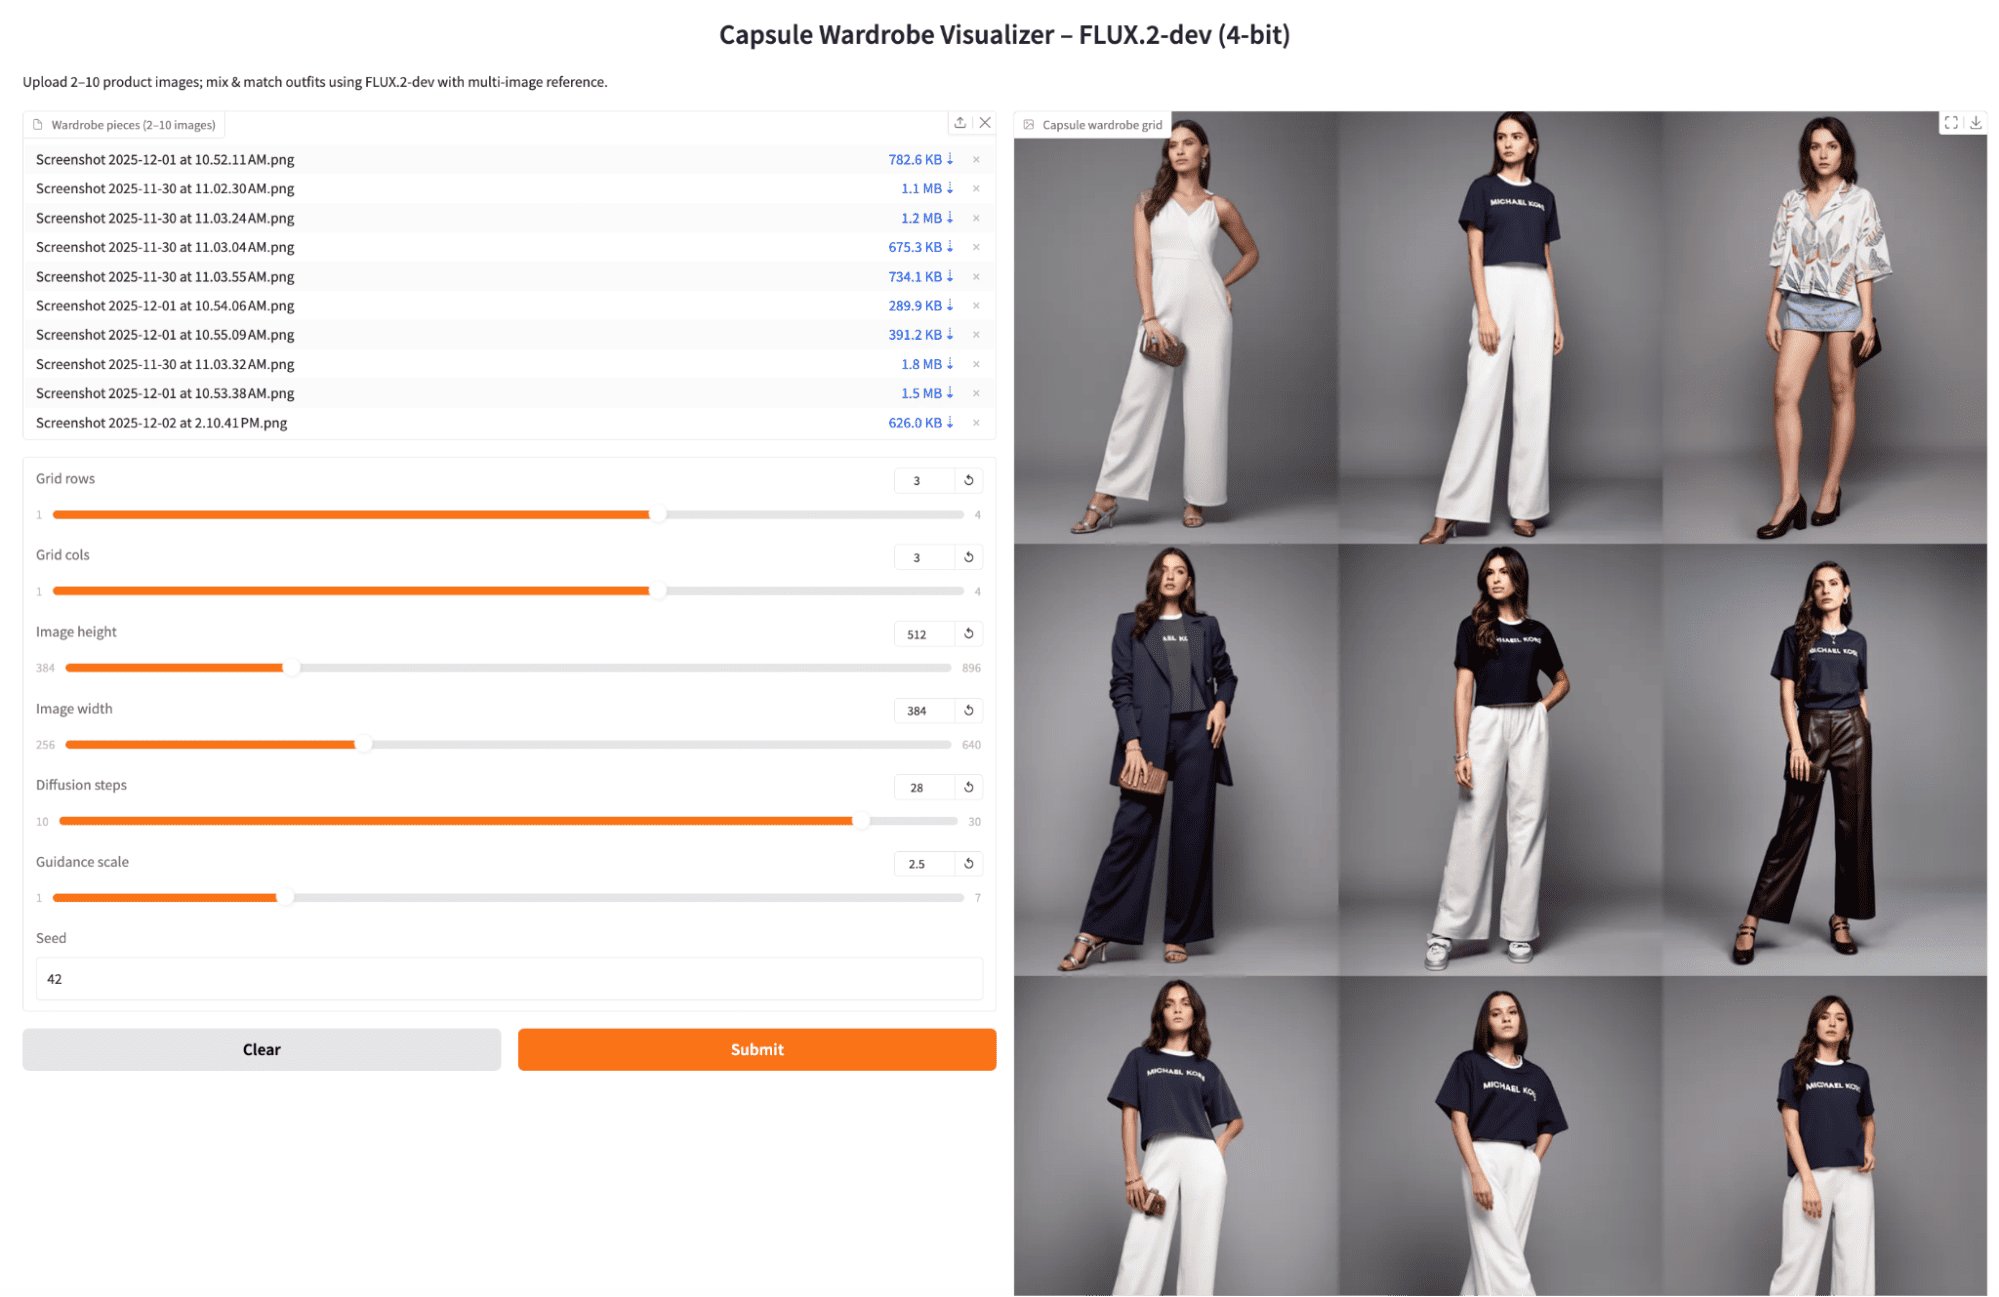
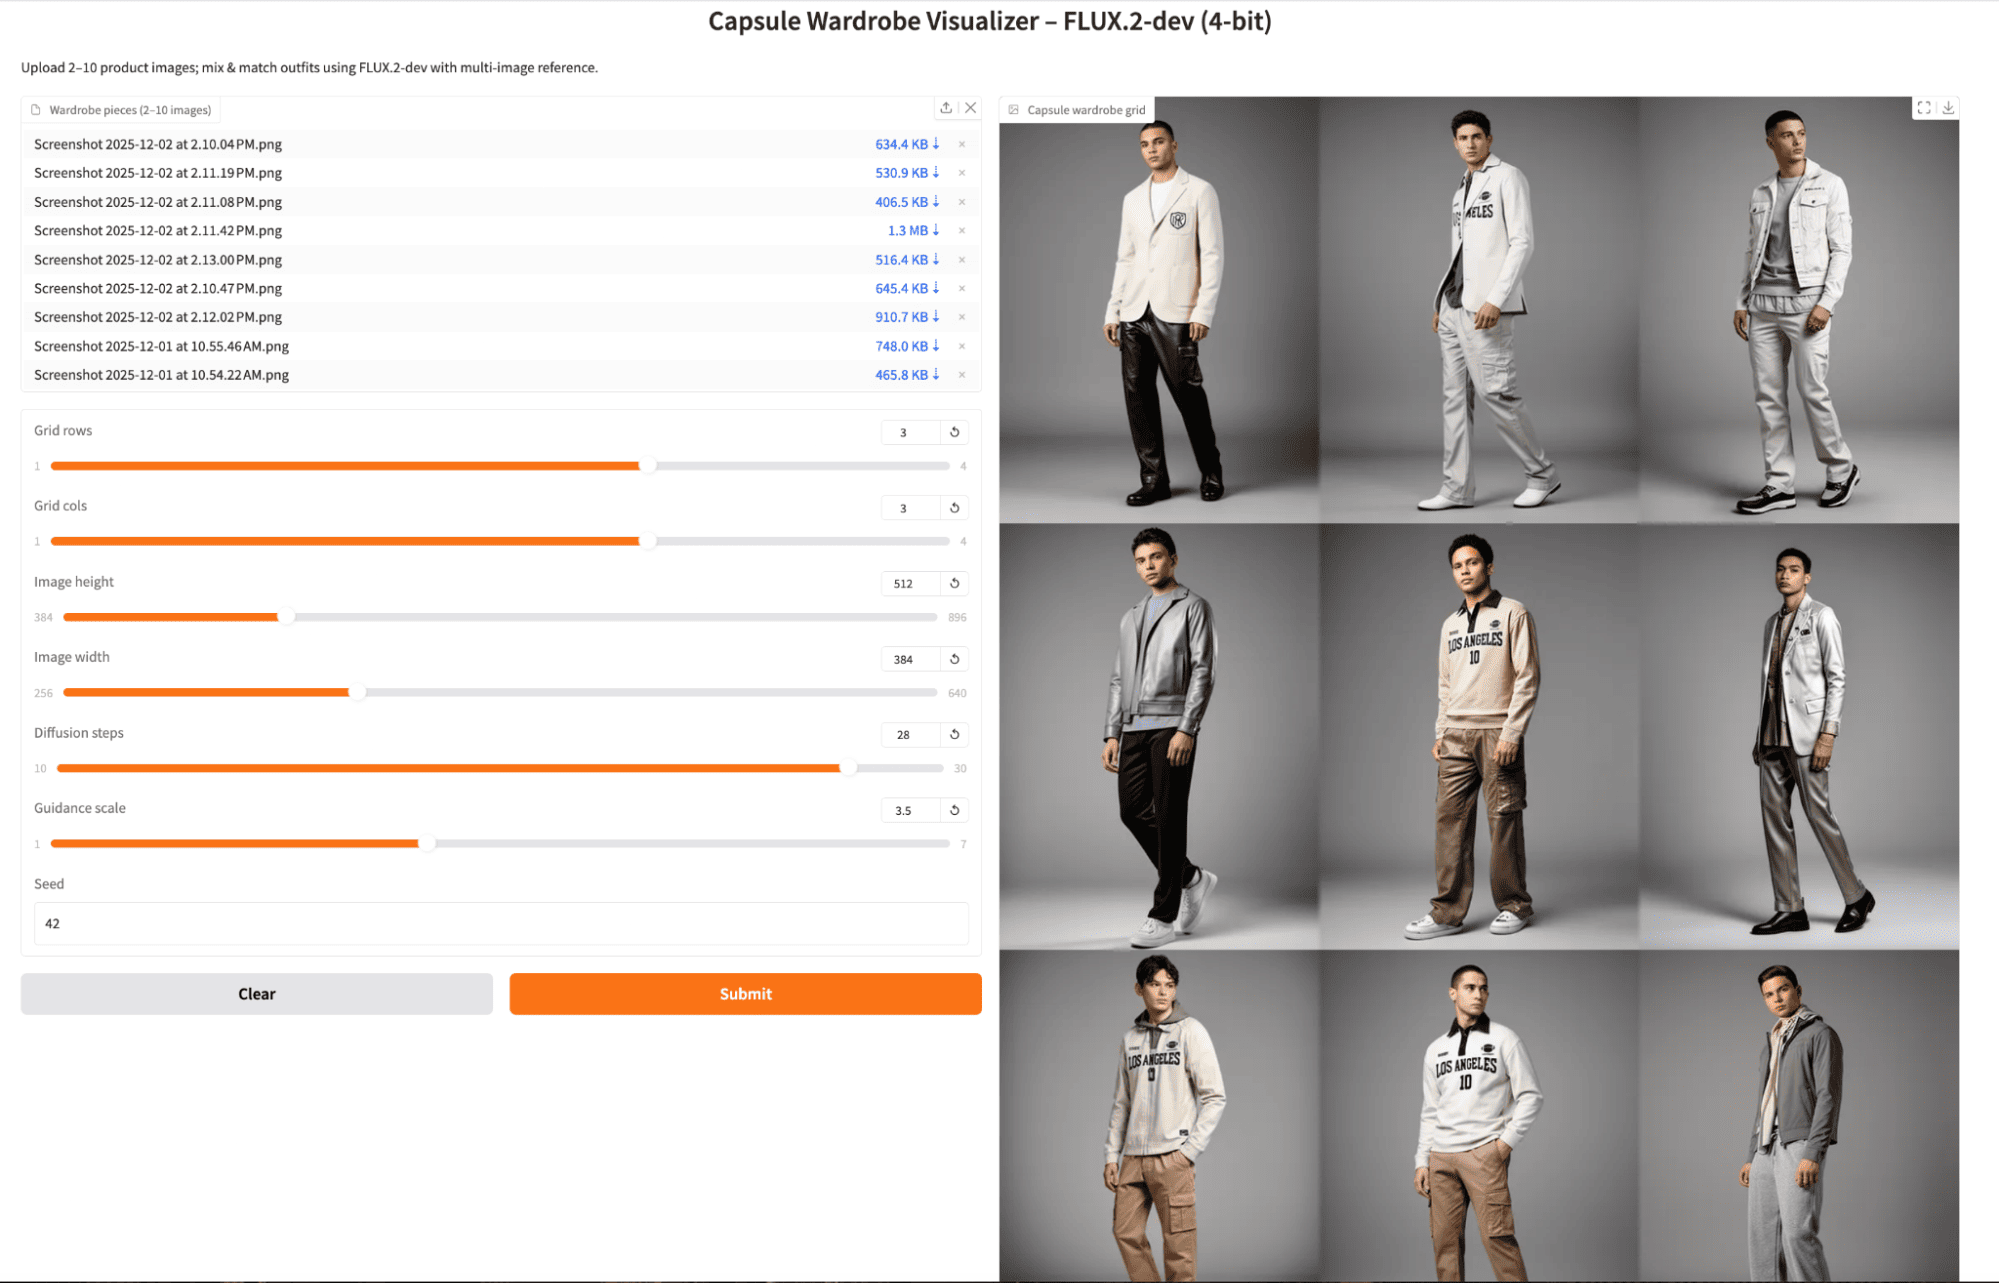
Para entender o comportamento do FLUX.2-dev na prática, rodei alguns experimentos rápidos com o app final. Variei as etapas de difusão e a guidance scale, e testei tanto múltiplas imagens da mesma peça quanto uma imagem por peça única para ver quanta variedade o modelo produz.
Primeiro, enviei várias imagens do mesmo look em ângulos diferentes, mantive as etapas padrão e guidance moderada. O modelo produziu iluminação de estúdio consistente e detalhes de tecido fiéis, com looks que parecem variações de um mesmo conjunto cápsula.
Depois, mantive as mesmas referências, aumentei as etapas de difusão para 28 (e ajustei levemente a guidance). A grade ficou um pouco mais nítida e polida, ainda recombinando as mesmas peças principais. A troca foi um aumento pequeno, mas perceptível, no tempo por lote.
Por fim, enviei um produto por peça distinta e gerei outra grade 3x3. Os looks ficaram bem mais variados entre as células, misturando diferentes partes de cima e de baixo de formas interessantes. Ainda houve alguma repetição, mas, no geral, a grade ficou mais próxima de um guarda-roupa cápsula real, com combinações mais diversas para a mesma seed e configurações.
O FLUX.2-dev em 4 bits é um ótimo modelo para aplicações de imagem. Neste tutorial, configuramos um pipeline FLUX.2-dev em 4 bits com o diffusers, construímos um fluxo de referência com múltiplas imagens que trata as peças do guarda-roupa como pistas de condicionamento e empacotamos tudo em um app Gradio.
O resultado é um visualizador de guarda-roupa cápsula poderoso, que pode servir como protótipo para ferramentas de e-commerce de moda ou simplesmente uma forma divertida de remixar seu próprio armário. A partir daqui, você pode conectar o mesmo pipeline a sistemas mais agentivos, como um LLM que sugere looks por dress code ou clima, ou integrá-lo ao backend de um catálogo real de produtos.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Amberle McKee
15 min
Tutorial
Amberle McKee
15 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Moez Ali
12 min