
Kursus
Bekerja dengan OpenAI API
3 jam
185.3K
Dalam tutorial ini, kita akan mempelajari cara membuat pipeline rekayasa data end-to-end menggunakan GPT-5.2 Codex melalui ekstensi VSCode. Alih-alih meminta model membangun semuanya sekaligus, kita akan membangun MVP selapis demi selapis, membimbing agen langkah demi langkah melalui desain, implementasi, dan pengujian.
Pendekatan ini mencerminkan cara kerja GPT-5.2 Codex yang paling efektif dalam praktik dan meniru alur kerja rekayasa data di dunia nyata. Pastikan untuk melihat panduan kami tentang versi model yang lebih baru, GPT-5.3 Codex, dan model berpikir baru dari OpenAI, GPT-5.4.
Jika Anda ingin mempelajari lebih lanjut tentang bekerja dengan ekosistem OpenAI, saya sarankan untuk melihat kursus Working with the OpenAI API.
GPT 5.2 Codex adalah generasi terbaru dari model agentic coding OpenAI, dibuat untuk alur kerja rekayasa perangkat lunak di dunia nyata. Model ini dibangun di atas peningkatan terbaru dalam pemahaman konteks panjang, refactor dan migrasi berskala besar, penggunaan alat yang andal, serta dukungan native Windows yang kuat.
Peningkatan ini membuatnya sangat efektif untuk pekerjaan pengembangan end-to-end yang berjalan lama di dalam IDE seperti VSCode. Dalam beberapa bulan terakhir, ekstensi OpenAI Codex VSCode telah meningkat secara signifikan dan kini bersaing langsung dengan Claude Code untuk pengembangan kompleks yang digerakkan agen.
Kita akan mulai dengan membuat repositori GitHub baru untuk MVP rekayasa data kita.
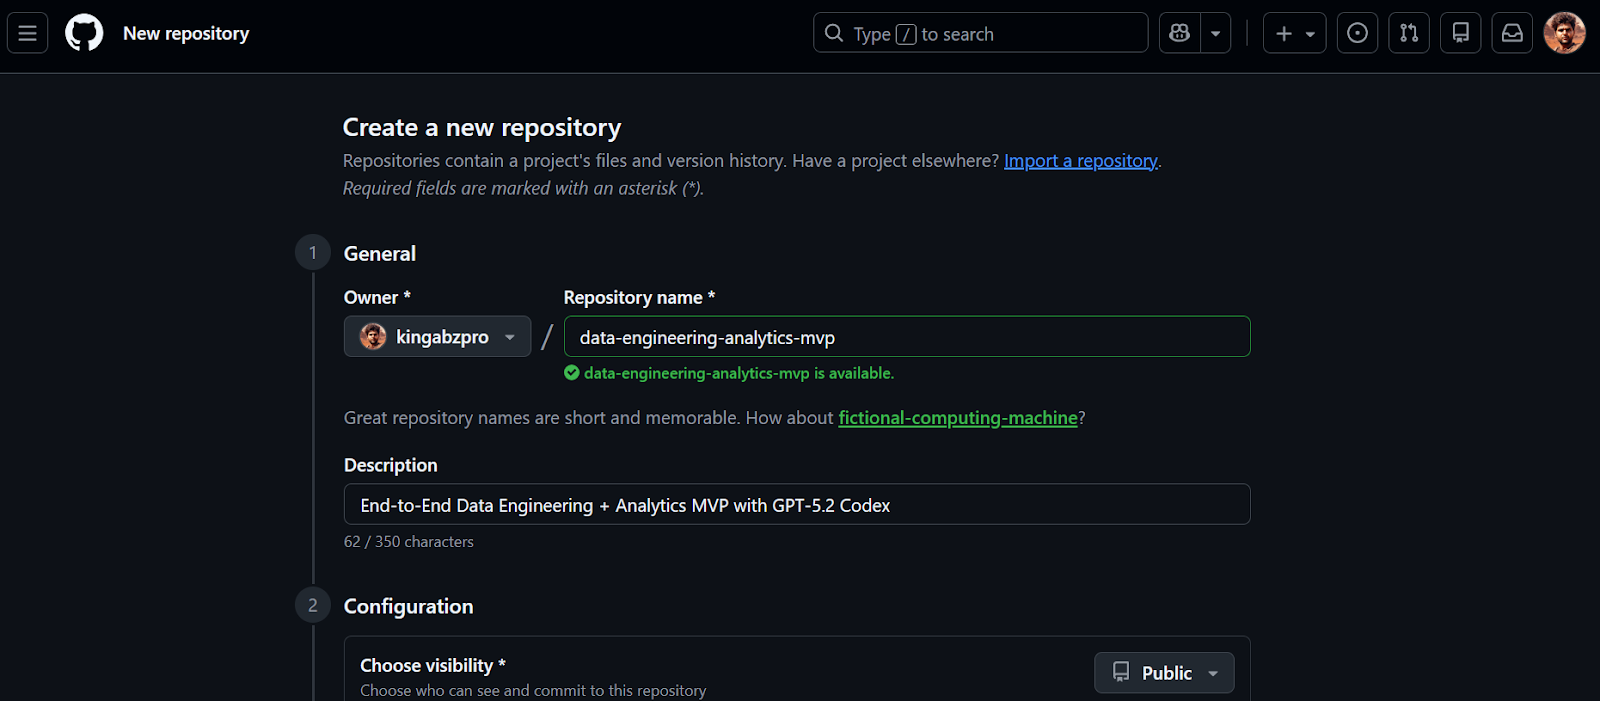
Setelah repositori dibuat, salin URL repositori. Kita akan menggunakan URL ini pada langkah berikutnya untuk mengkloning proyek secara lokal.
Sebelum memulai, pastikan Anda telah memasang Visual Studio Code dan memiliki akun ChatGPT Plus yang aktif. Paket Free dan Go tidak menyediakan akses ke model Codex di ekstensi VSCode.
1. Klon repositori menggunakan URL yang Anda salin sebelumnya.
2. Ubah direktori ke repositori dan jalankan VSCode.
git clone https://github.com/kingabzpro/data-engineering-analytics-mvp.git
cd data-engineering-analytics-mvp
code .
3. Buka Extensions (Ctrl + Shift + X), cari OpenAI Codex, dan instal. Ini hanya memerlukan beberapa detik.
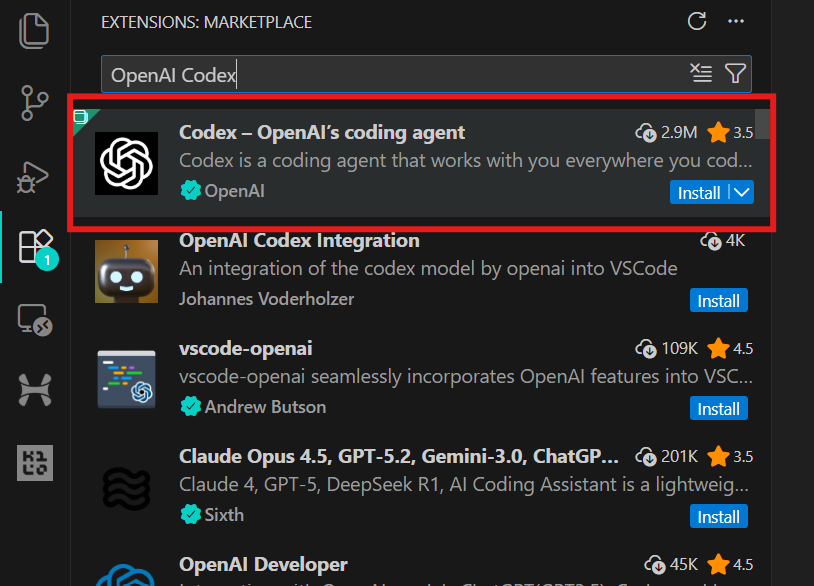
4. Klik ikon OpenAI di panel kiri untuk meluncurkan ekstensi Codex. Anda akan diminta untuk masuk menggunakan akun ChatGPT atau akun API. Pilih akun ChatGPT, yang akan mengarahkan Anda ke browser untuk menyetujui akses. Setelah disetujui, kembali ke VSCode, dan Codex siap digunakan.
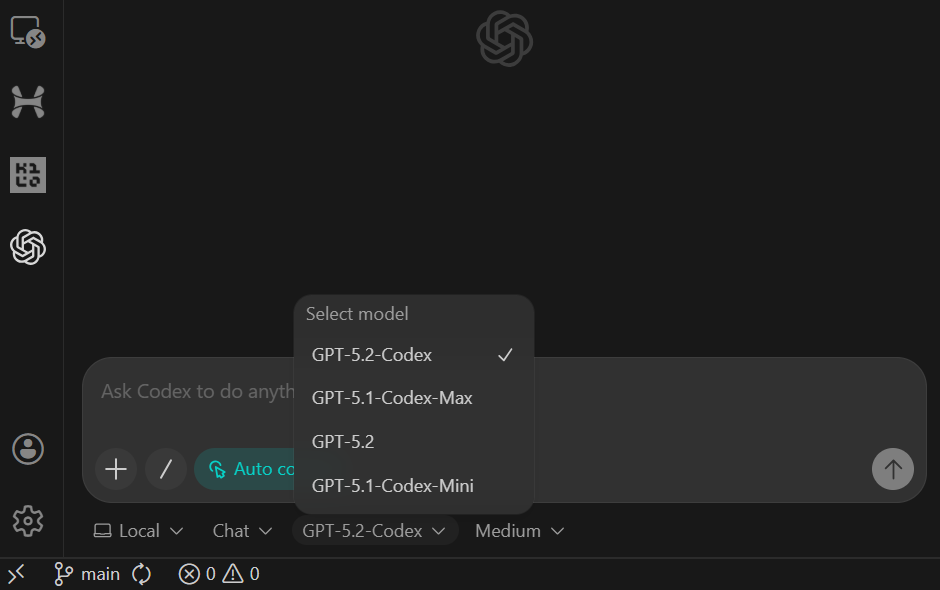
Proyek ini dengan sengaja ditetapkan ruang lingkupnya sebagai Minimum Viable Product (MVP). Tujuannya bukan membangun platform data kelas produksi, tetapi membuat irisan rekayasa data yang lengkap end-to-end yang menunjukkan bagaimana sistem analitik nyata disusun.
Dalam MVP ini, kita membangun pipeline analitik yang sederhana namun kredibel yang:
raw_events)fct_events)Alur lengkapnya seperti ini:
CSV file
  ↓
raw_events        (raw ingestion, 1:1 with source)
  ↓
fct_events        (typed, deduplicated, transformed)
  ↓
metrics           (daily count, 7-day rolling avg, top category)
  ↓
Streamlit UI (local dashboard)Pada langkah ini, kita menggunakan GPT-5.2 Codex untuk menghasilkan struktur awal proyek. Tujuannya bukan membangun fitur dulu, melainkan membuat fondasi yang bersih dan dapat dijalankan yang akan kita kembangkan selangkah demi selangkah.
Agar Codex tetap fokus, kita menggunakan blok kontrol kecil bernama Codex Harness. Harness ini ditempelkan di bagian atas setiap prompt dan memastikan Codex tetap dalam lingkup MVP, menghasilkan output yang konsisten, serta melakukan commit perubahan yang bersih dan mudah ditinjau.
Codex Harness (tempelkan ke setiap tugas):
You are GPT-5.2 Codex working in my GitHub repository.

MVP ONLY:
CSV → raw table → transform → 3 metrics → Streamlit dashboard.

SCOPE RULES:
- Implement ONLY what this task asks.
- No auth, schedulers, cloud services, or extra pages.

OUTPUT:
- Be descriptive.
- After changes include:
  1) What changed
  2) Files touched
  3) How to run locally
  4) Quick verification step
- Commit after each major step with a clear message.
Sebelum menulis kode apa pun, Codex secara eksplisit diarahkan untuk menggunakan penelusuran web guna memverifikasi versi terbaru semua dependensi yang kompatibel dengan Python 3.11. Ini menghindari pemasangan paket yang kedaluwarsa atau tidak kompatibel.
IMPORTANT: USE WEB SEARCH FIRST
TASK 1 (SCAFFOLD):
Use Python 3.11 + uv + DuckDB + Streamlit + Pydantic + pytest.

Create repo structure:
- backend/
  - db.py
  - ingest.py
  - pipeline.py
  - models.py
  - sql/
- app/
  - app.py
- data/
  - sample.csv
- tests/

Add:
1) data/sample.csv (~50 rows) with columns:
   event_time, user_id, event_name, category, amount
2) DuckDB schema for raw_events
3) a command to ingest sample.csv and print row count
4) pyproject.toml for uv
5) README with exact local run steps

Stop after scaffolding. Commit.
Tugas scaffolding membuat:
sample.csvraw_eventspyproject.toml dan README yang berfungsiSetelah menempelkan prompt, ganti model ke Agent (Full Access) dan pastikan GPT-5.2 Codex terpilih (ini adalah default).
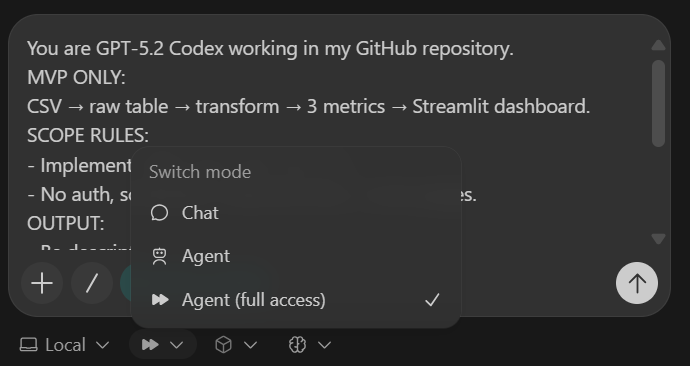
Setelah tugas selesai, Anda akan melihat semua folder dan file dibuat secara otomatis.
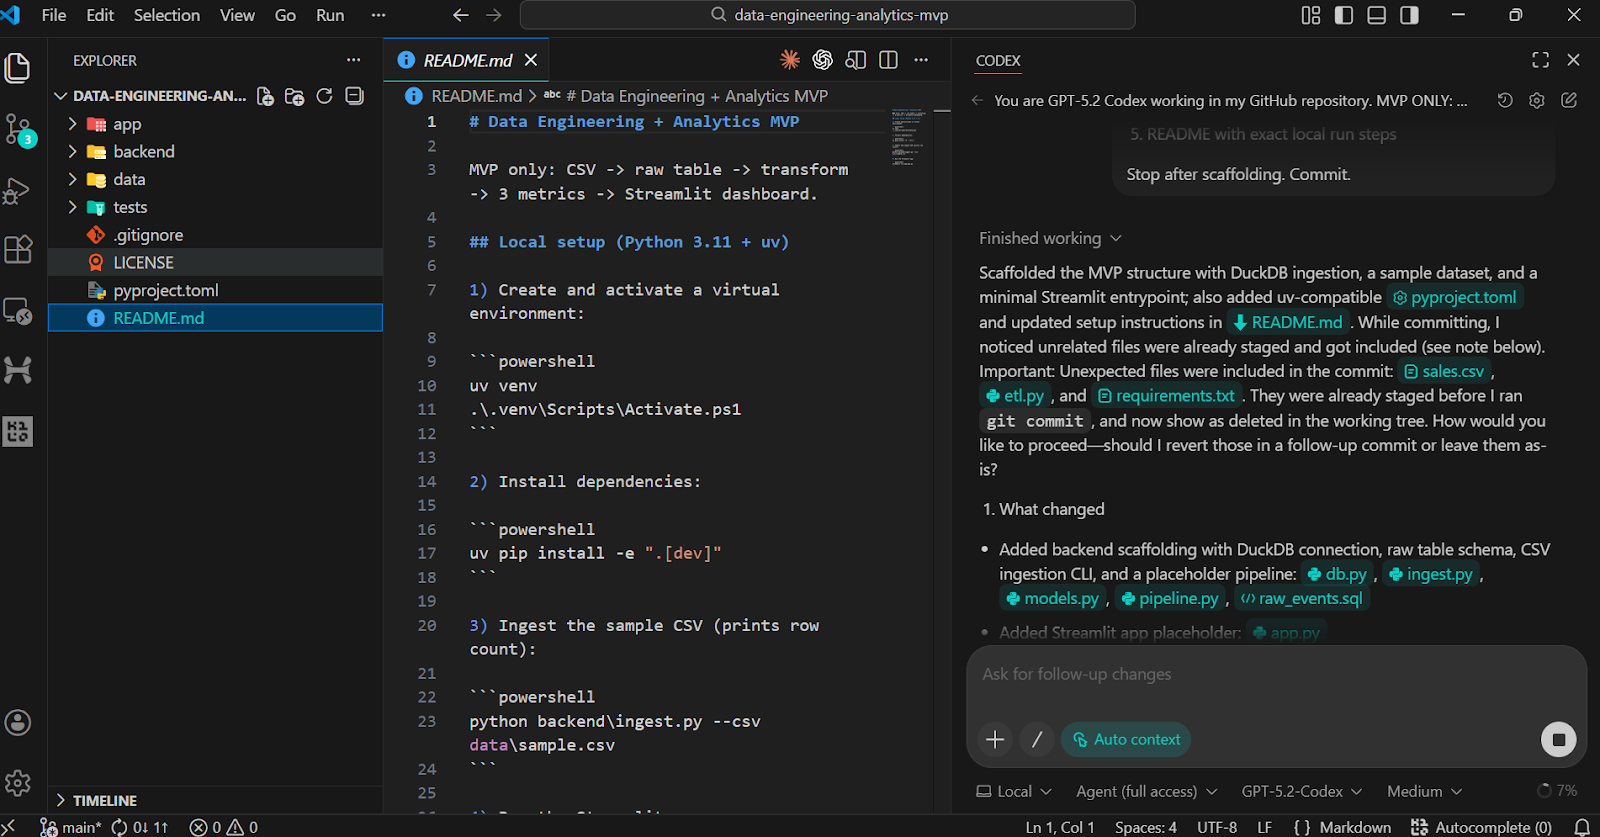
Untuk memvalidasi scaffold, minta Codex menjalankan langkah instalasi dan verifikasi secara lokal.
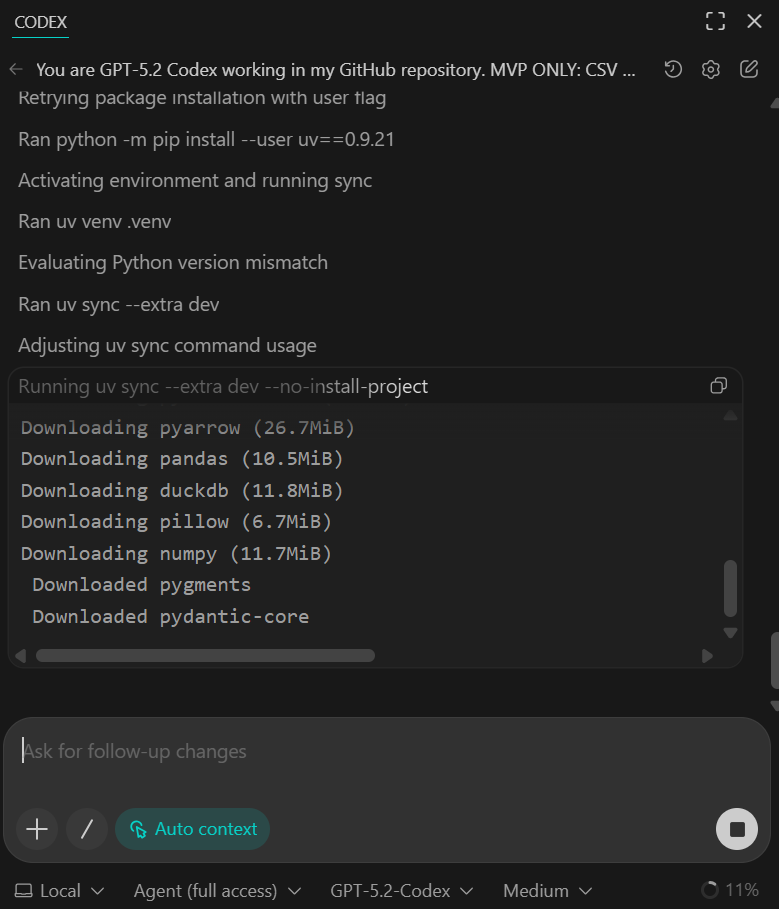
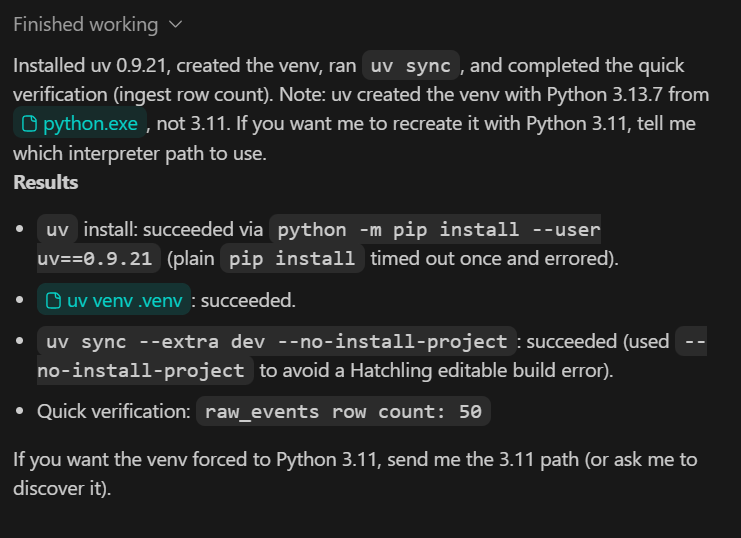
Anda seharusnya melihat semua dependensi berhasil diinstal dan skrip verifikasi cepat mengonfirmasi bahwa 50 baris telah diinjestasikan dari dataset contoh.
Pada tahap ini, data contoh sengaja dibuat kecil. Pada langkah selanjutnya, kita akan menggantinya dengan dataset yang lebih besar dan lebih realistis.
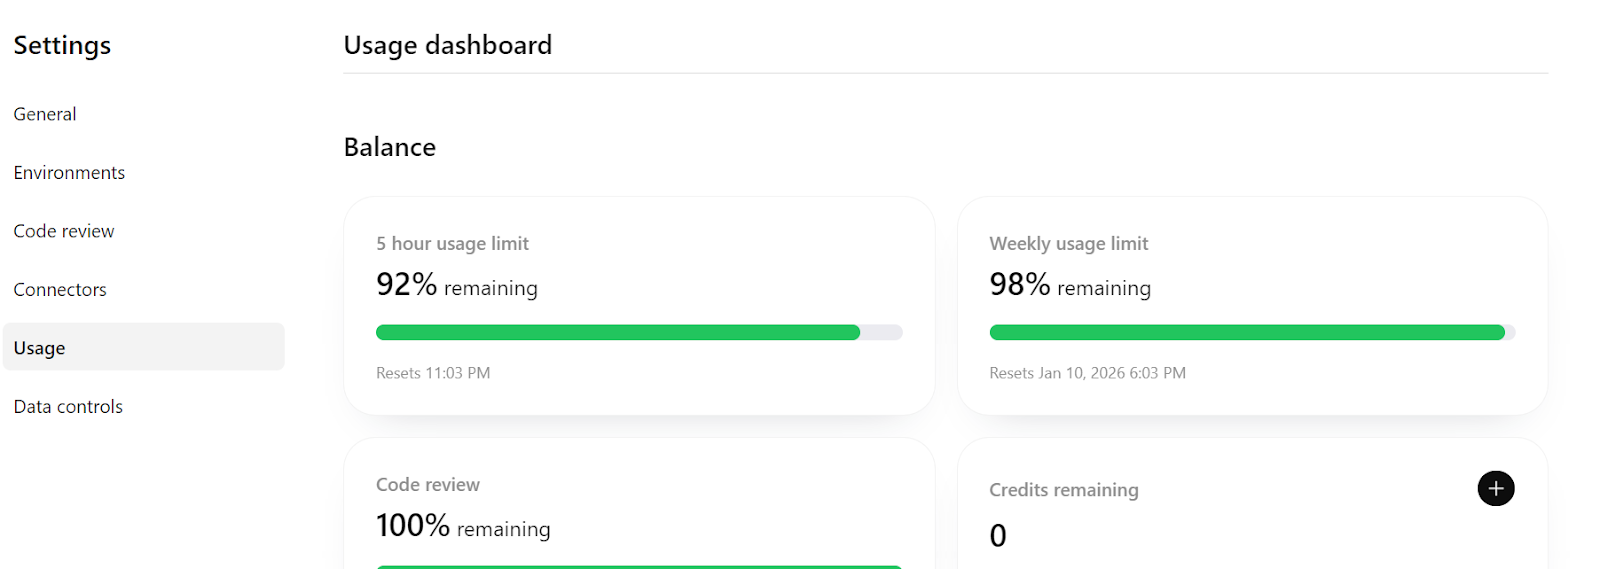
Terakhir, jika Anda memeriksa https://chatgpt.com/codex/settings/usage, Anda akan melihat bahwa sebagian besar kuota penggunaan Anda masih tersedia, artinya Anda dapat dengan nyaman melanjutkan membangun dan melakukan iterasi pada proyek ini, bahkan memperluasnya menuju pipeline yang lebih siap produksi jika diperlukan.
Pada langkah ini, kita memastikan proses ingestion bersifat idempoten, artinya dapat dijalankan ulang dengan aman tanpa membuat data duplikat. Ini merupakan persyaratan mendasar dalam rekayasa data, karena pekerjaan ingestion sering kali perlu dicoba ulang atau dieksekusi kembali.
TASK 2 (IDEMPOTENT INGEST):
Make CSV ingestion idempotent.
- Rerunning ingest must not duplicate rows
- Validate required columns
- Validate event_time parseable and amount numeric

Add pytest:
- ingest twice → row count unchanged

Update README verification section.
Commit.
Capaian langkah ini:
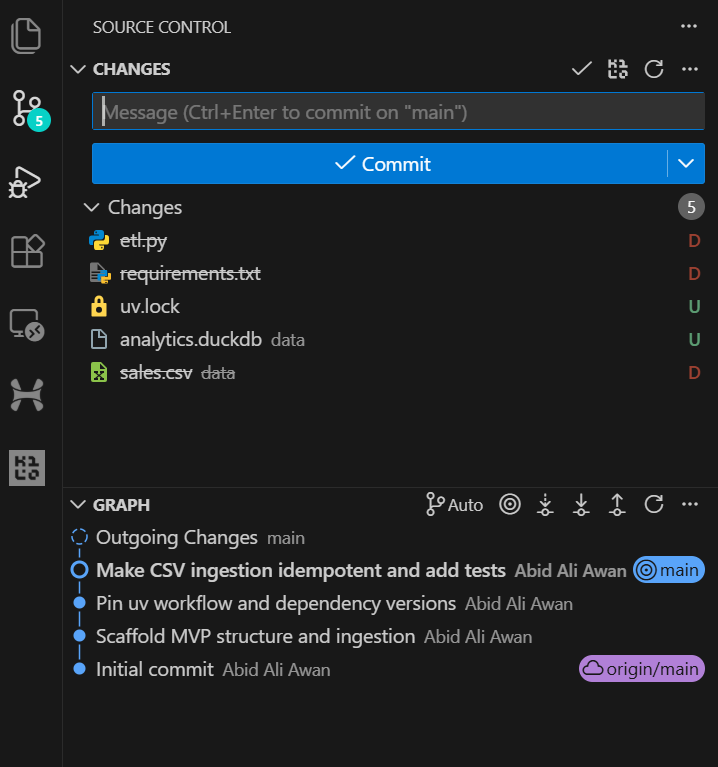
Setelah tugas selesai, Anda dapat meninjau riwayat Git di VSCode dan melihat bahwa agen AI melakukan commit perubahan secara otomatis setelah pembaruan besar. Ini memberikan riwayat pengembangan yang bersih dan mudah ditelusuri.
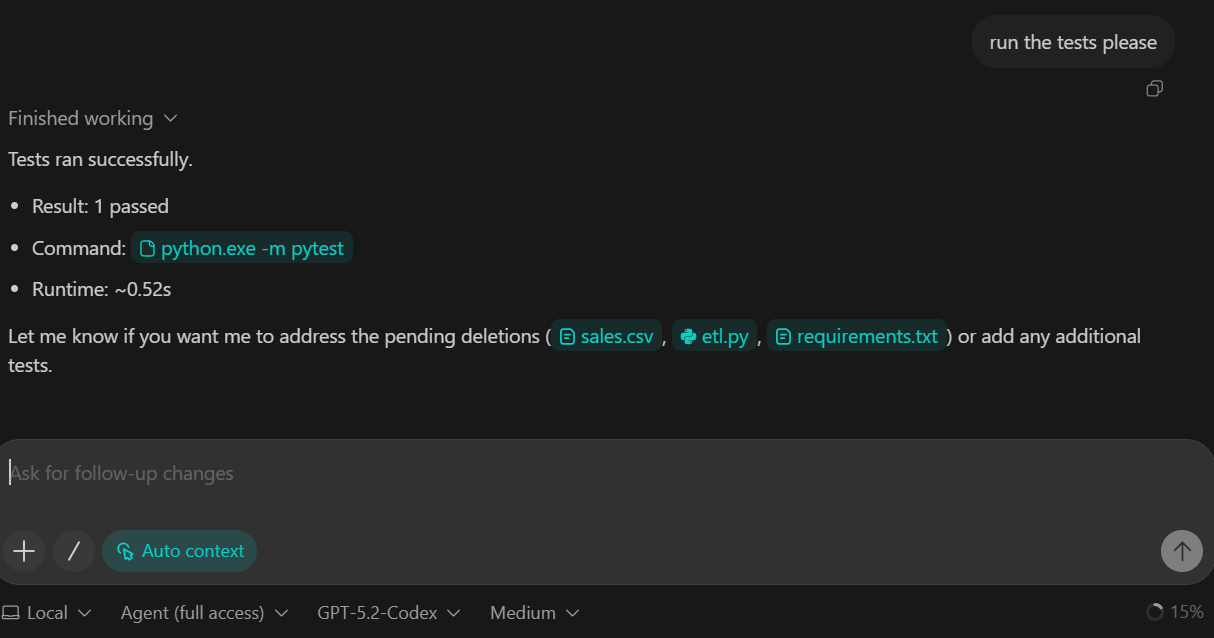
Kami meminta GPT-5.2 Codex untuk menjalankan rangkaian pengujian sebagai bagian dari tugas ini. Hasilnya, pengujian berhasil dijalankan dan semua pemeriksaan lulus.
Pada langkah ini, kita memperkenalkan lapisan transformasi dari pipeline. Transformasi diimplementasikan menggunakan DuckDB SQL, yang memungkinkan kita mengonversi data mentah hasil ingestion menjadi tabel fakta yang bersih dan siap analitik.
TASK 3 (TRANSFORM SQL):
Create backend/sql/010_fct_events.sql:
- typed columns
- deterministic dedupe

Execute transform from backend/pipeline.py.
Add sanity checks to README:
- raw_events count
- fct_events count

Commit.
Capaian langkah ini:
raw_events menjadi fct_events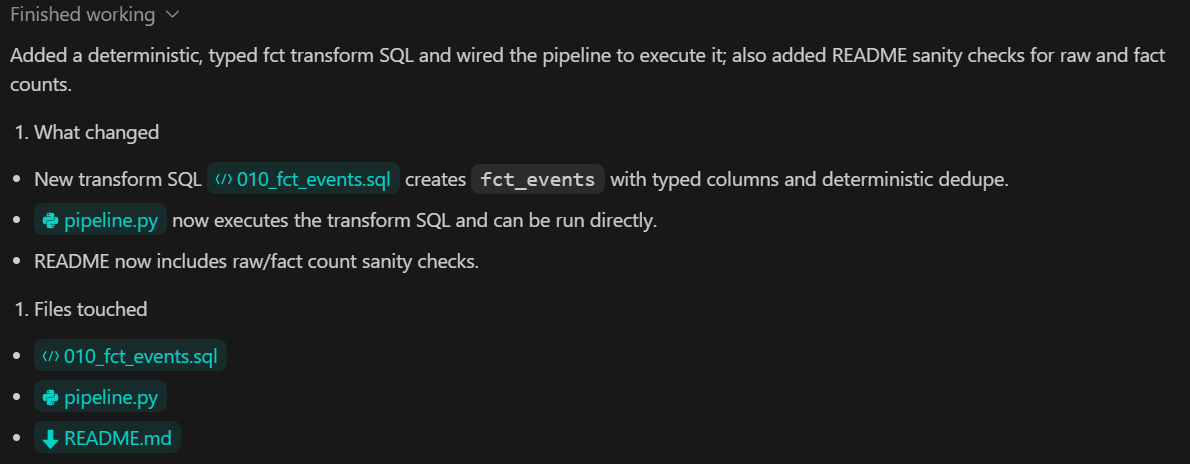
Pada langkah ini, kita menambahkan lapisan metrik, yang bertanggung jawab menghitung output analitik dari data yang telah ditransformasikan. Metrik diturunkan menggunakan DuckDB SQL dan diekspos ke bagian lain sistem melalui antarmuka Python yang bertipe.
TASK 4 (METRICS):
Create backend/sql/020_metrics.sql.
Expose metrics via a Python function returning a Pydantic model.

Add pytest validating:
- keys exist
- types correct

Commit.
Capaian langkah ini:
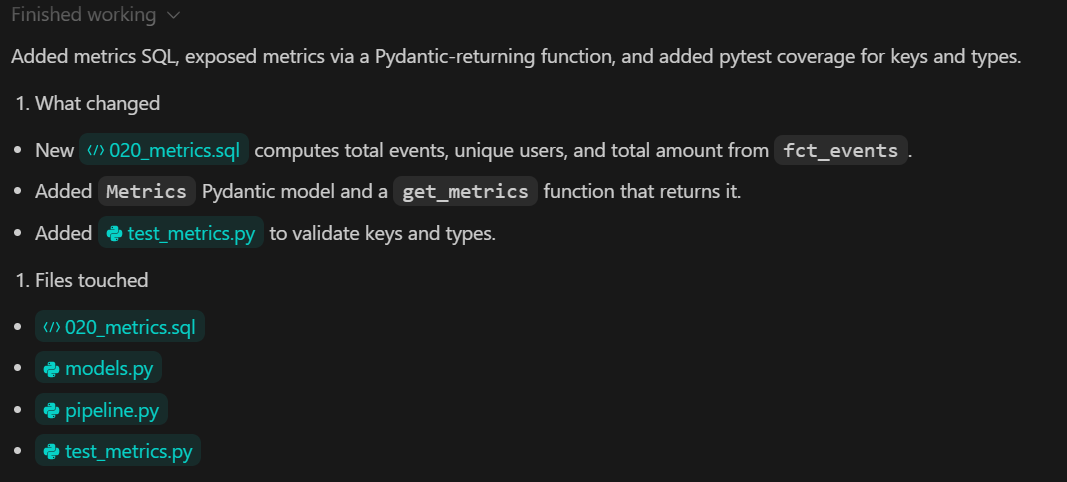
Pada langkah ini, kita membangun dasbor analitik lokal menggunakan Streamlit. Dasbor hanya bertanggung jawab untuk visualisasi. Ia tidak menghitung metrik atau mentransformasi data. Semua nilai dibaca dari lapisan metrik yang dibuat pada langkah sebelumnya.
TASK 5 (STREAMLIT UI):
Build app/app.py:
- 3 KPI cards
- line chart for daily_count
- UI calls backend metrics function

Add a minimal smoke test.
Commit.
Setelah tugas selesai, Codex menyediakan instruksi untuk membangun ulang basis data DuckDB dan menjalankan seluruh pipeline data. Untuk langkah ini, kita menggunakan basis data baru yang diisi dengan dataset yang lebih besar.
python backend\ingest.py --csv data\sample.csv
python backend\pipeline.py
Setelah menjalankan ingestion, output mengonfirmasi jumlah peristiwa mentah yang dimuat ke DuckDB:
raw_events row count: 3738Setelah pipeline selesai, jalankan aplikasi Streamlit:
streamlit run app\app.pyAnda dapat mengakses dasbor dengan membuka URL http://localhost:8501 di browser Anda.
You can now view your Streamlit app in your browser.

  Local URL: http://localhost:8501
  Network URL: http://192.168.18.10:8501
Jika muncul galat saat dasbor pertama kali dimuat, hal ini wajar pada iterasi awal. Salin pesan galatnya dan berikan kepada GPT-5.2 Codex.
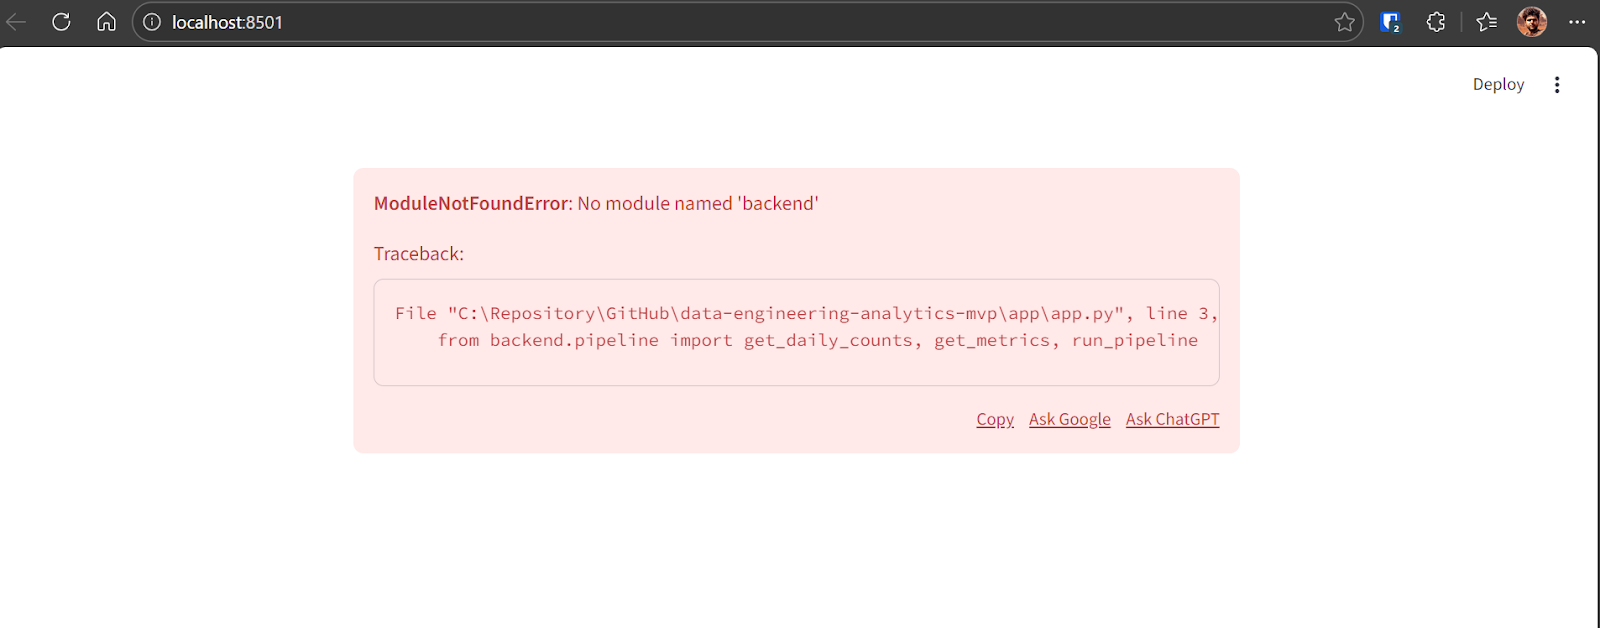
Codex akan mengidentifikasi masalah dan menerapkan perbaikan yang diperlukan. Setelah koreksi, aplikasi berjalan dengan sukses dan menampilkan:
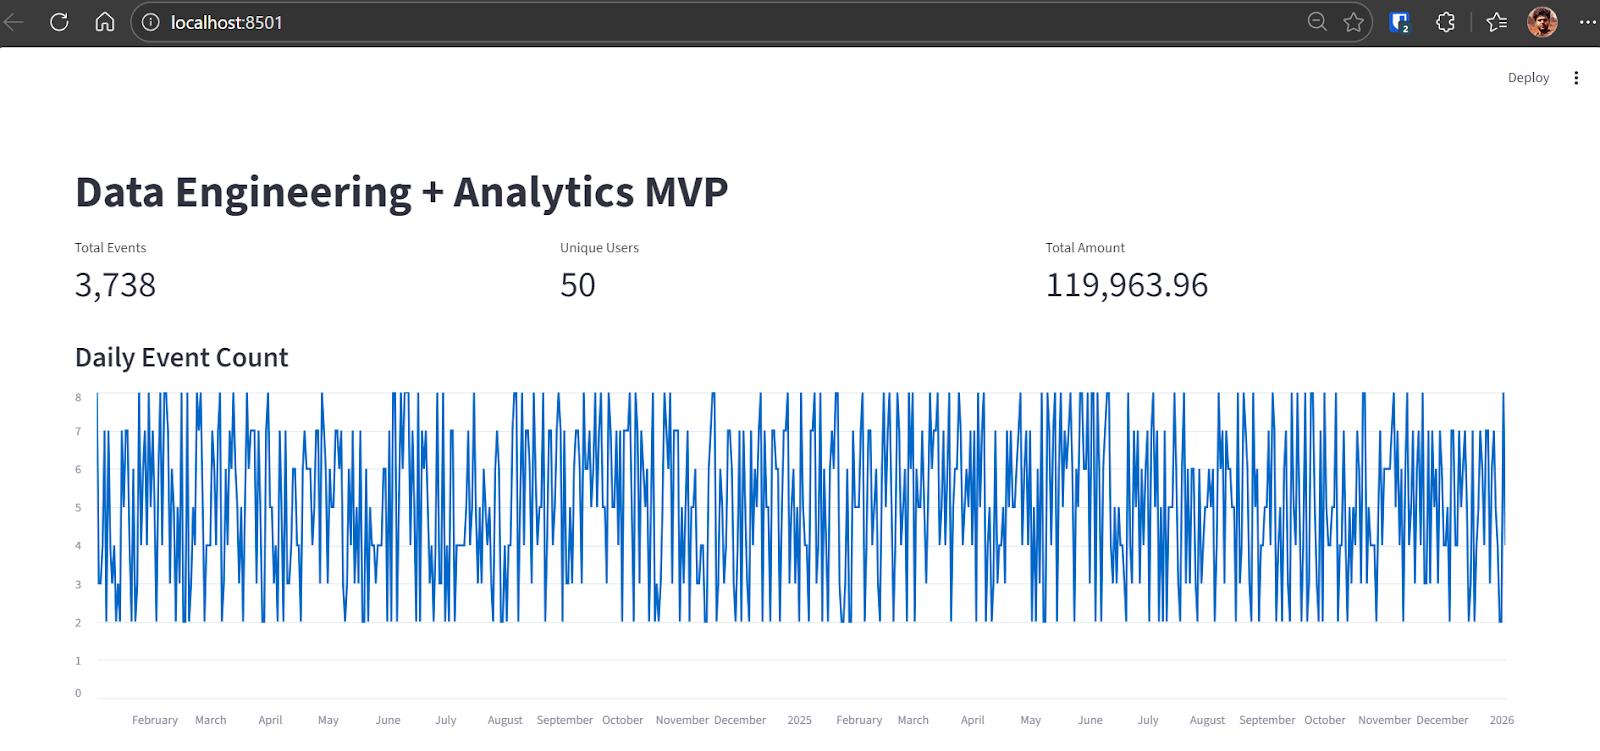
Pada titik ini, pipeline MVP end-to-end telah lengkap dan berfungsi penuh.
Pada langkah terakhir ini, kita fokus pada verifikasi dan keandalan. Tujuannya adalah menyediakan satu perintah yang membuktikan seluruh pipeline bekerja dengan benar dari ingestion hingga metrik dan pengujian.
TASK 6 (VERIFY):
Add a verify command that:
- rebuilds DB from scratch
- ingests sample.csv
- runs transforms
- runs pytest

Document as "Local Demo" and "Verify" in README.
Commit.
Capaian langkah ini:
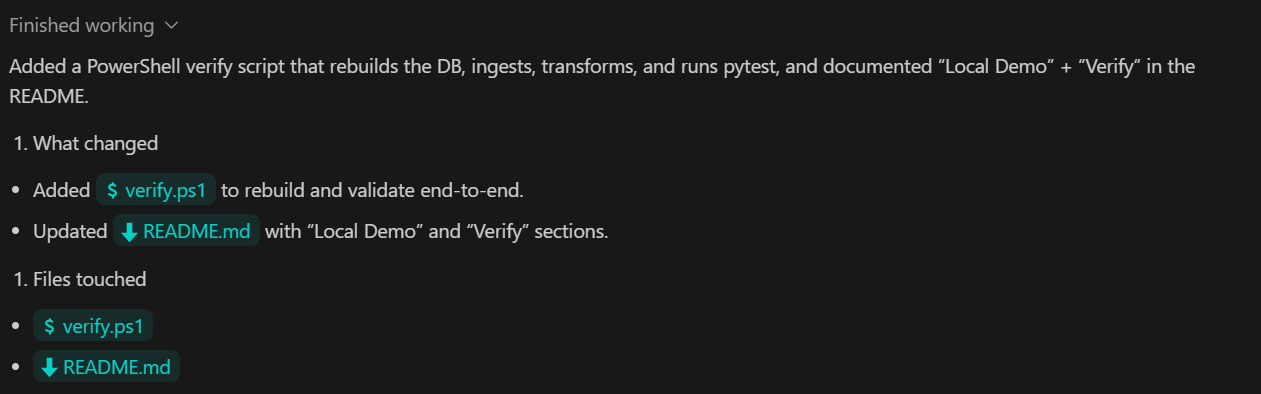
Kami meminta Codex untuk memperbarui README, melakukan commit semua perubahan, dan mendorongnya ke repositori jarak jauh GitHub.
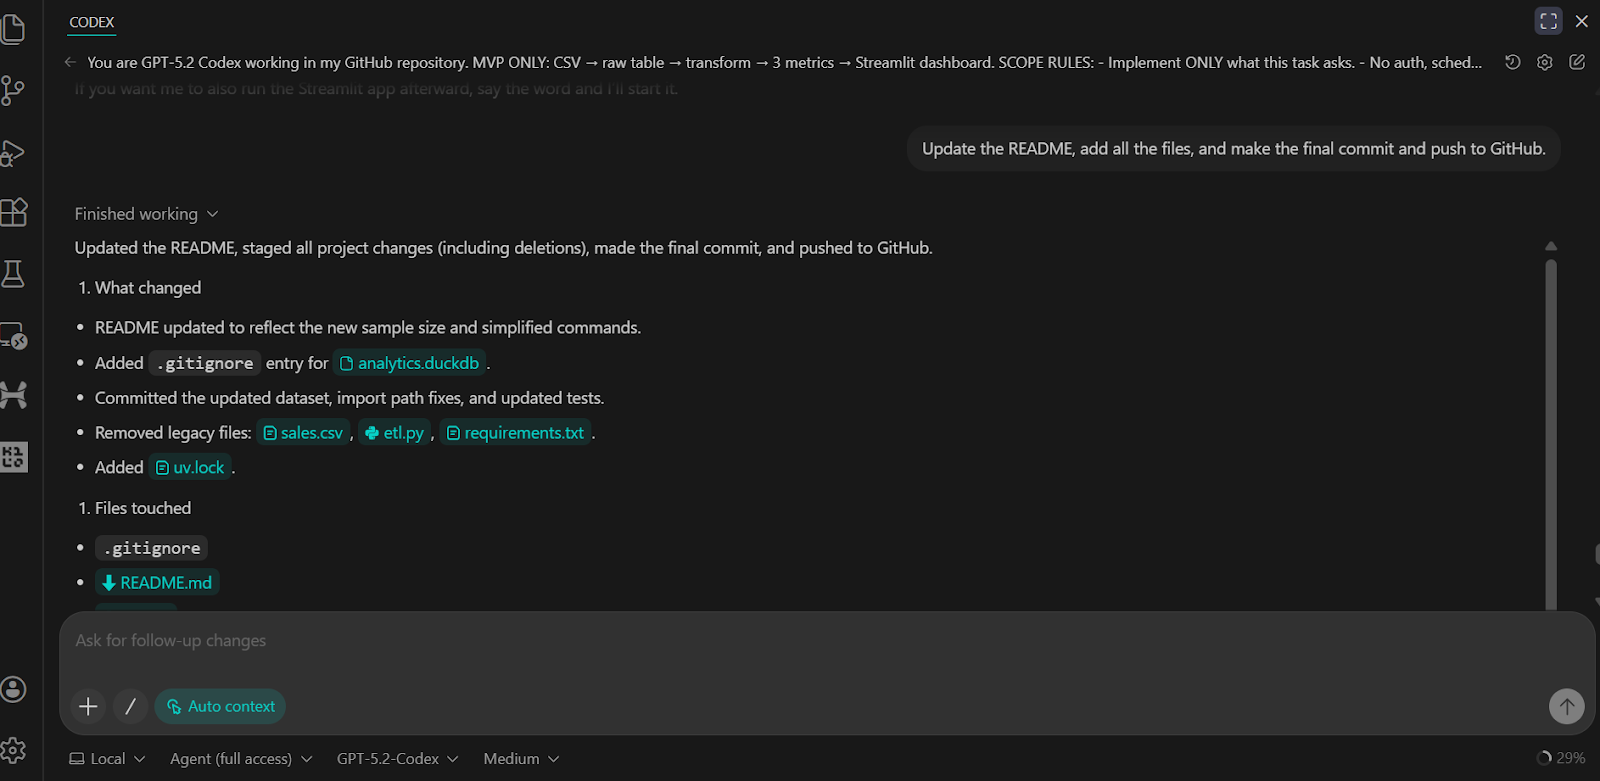
Hasilnya adalah repositori GitHub yang lengkap dan terstruktur dengan baik yang mencakup semua skrip, pengujian, logika backend, dan instruksi yang jelas untuk menjalankan dan memverifikasi proyek.
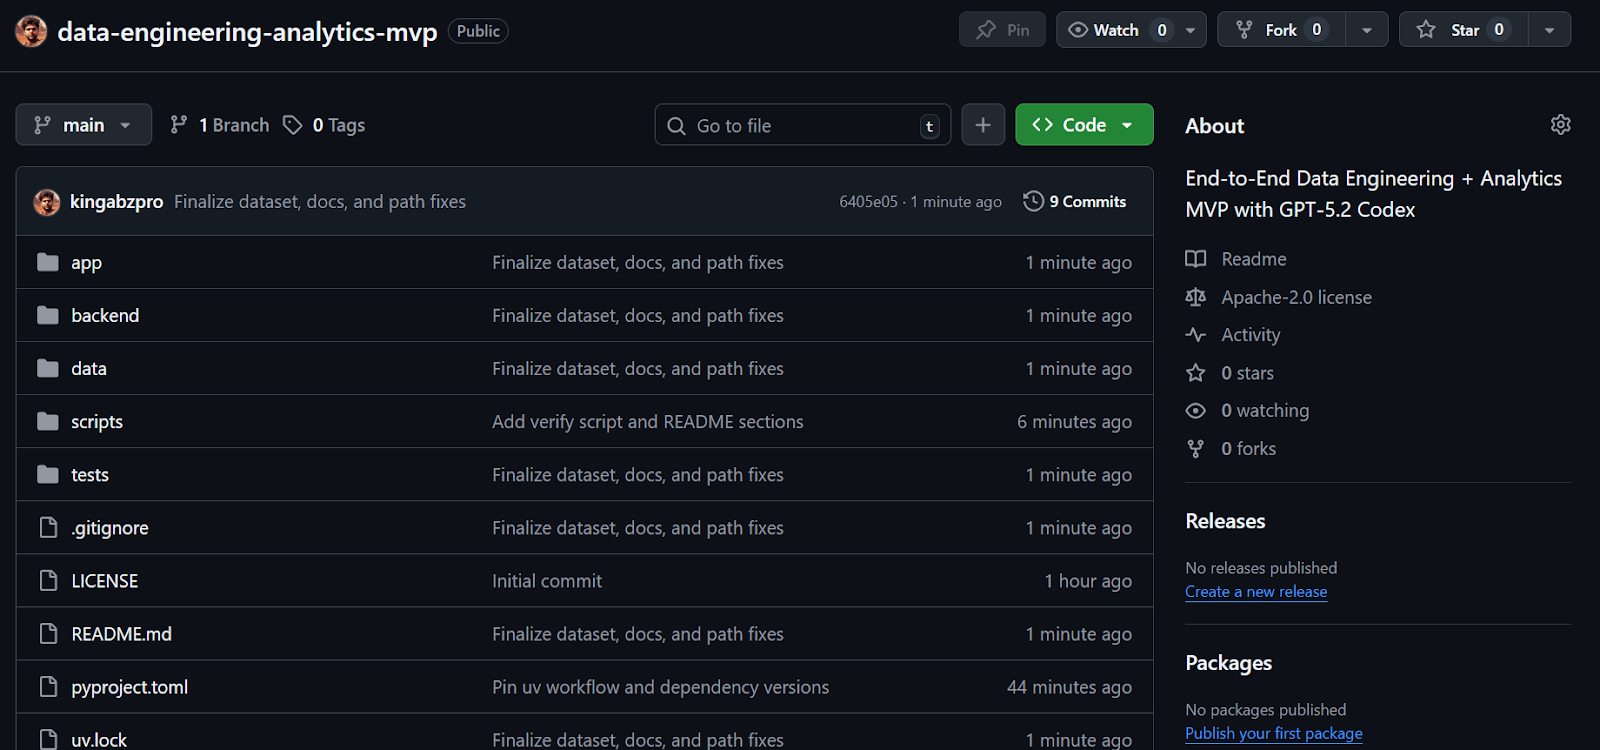
Sumber: kingabzpro/data-engineering-analytics-mvp
Saya telah menggunakan Codex melalui CLI dan di VSCode dari waktu ke waktu di masa lalu, tetapi pembaruan terbaru dengan GPT-5.2 Codex membuat perbedaan yang terasa. Model ini jauh lebih baik dalam membangun sistem yang lengkap, men-debug masalah, dan bekerja dengan alat seperti MCP dan tooling internal. Model ini juga menunjukkan pemahaman yang jauh lebih kuat terhadap basis kode yang sudah ada, yang membuat pengembangan iteratif jauh lebih efisien.
Dari awal hingga akhir, seluruh MVP ini memakan waktu kurang dari tiga puluh menit bagi saya untuk men-scaffold, men-debug, dan menjalankannya end-to-end. Codex menangani penyiapan repositori, manajemen dependensi, ingestion data, transformasi SQL, pengujian, dan dasbor Streamlit dengan sangat sedikit intervensi manual. Siklus pengembangannya terasa rapat dan dapat diprediksi, yang merupakan hal yang Anda inginkan saat membangun dengan cepat.
Proyek ini dengan sengaja merupakan sebuah MVP. Proyek ini akan memerlukan iterasi tambahan dan penguatan untuk menjadi siap produksi. Meski begitu, struktur intinya sangat mencerminkan bagaimana sistem rekayasa data nyata dirancang, sehingga menjadi fondasi yang solid untuk dikembangkan.
Jika Anda tertarik memperluas proyek ini menuju platform data yang lebih berorientasi produksi, komponen berikut adalah langkah lanjutan yang alami namun sengaja dikecualikan di sini untuk menjaga fokus ruang lingkup:
Alat-alat ini umum di sistem produksi, tetapi mengecualikannya di sini membuat proyek tetap sederhana, lokal, dan mudah dipahami, sekaligus tetap mencerminkan pola rekayasa data di dunia nyata.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt



