
Khóa học
Làm việc với OpenAI API
3 giờ
185.3K
Trong hướng dẫn này, chúng ta sẽ học cách tạo một pipeline kỹ thuật dữ liệu end-to-end bằng GPT-5.2 Codex thông qua tiện ích mở rộng VSCode. Thay vì yêu cầu mô hình xây dựng mọi thứ cùng lúc, chúng ta sẽ xây dựng MVP theo từng lớp, dẫn dắt agent từng bước qua thiết kế, triển khai và kiểm thử.
Cách tiếp cận này phản ánh cách GPT-5.2 Codex hoạt động hiệu quả nhất trong thực tế và mô phỏng quy trình kỹ thuật dữ liệu ngoài đời. Hãy xem thêm hướng dẫn về phiên bản mới hơn của mô hình, GPT-5.3 Codex, và mô hình tư duy mới của OpenAI, GPT-5.4.
Nếu bạn muốn tìm hiểu thêm về hệ sinh thái OpenAI, tôi khuyến nghị xem khóa học Làm việc với OpenAI API.
GPT 5.2 Codex là thế hệ mới nhất của các mô hình mã hóa agentic của OpenAI, được xây dựng cho quy trình kỹ thuật phần mềm thực tế. Nó kế thừa các cải tiến gần đây về hiểu ngữ cảnh dài, tái cấu trúc và di trú lớn, sử dụng công cụ đáng tin cậy, và hỗ trợ Windows gốc mạnh mẽ.
Những cải tiến này khiến nó đặc biệt hiệu quả cho công việc phát triển dài hơi, end-to-end bên trong các IDE như VSCode. Trong vài tháng qua, tiện ích mở rộng OpenAI Codex VSCode đã được cải thiện đáng kể và hiện cạnh tranh trực tiếp với Claude Code cho phát triển phức tạp, dẫn dắt bởi agent.
Chúng ta sẽ bắt đầu bằng cách tạo một GitHub repository mới cho MVP kỹ thuật dữ liệu của mình.
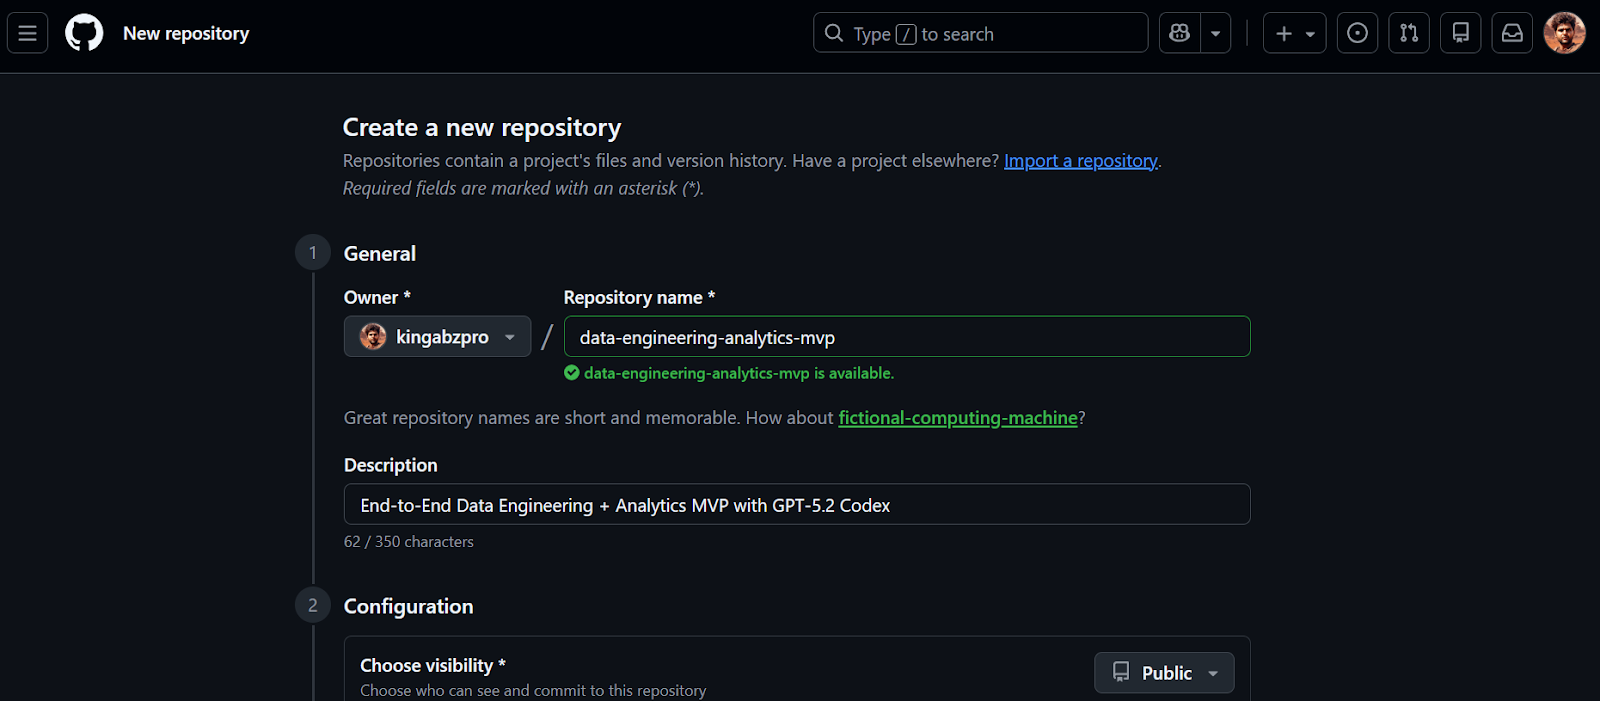
Sau khi repository được tạo, hãy sao chép URL của repository. Chúng ta sẽ dùng URL này ở bước tiếp theo để clone dự án về máy.
Trước khi bắt đầu, hãy đảm bảo bạn đã cài đặt Visual Studio Code và có tài khoản ChatGPT Plus đang hoạt động. Gói miễn phí và Go không cung cấp quyền truy cập mô hình Codex trong tiện ích mở rộng VSCode.
1. Clone repository bằng URL bạn đã sao chép trước đó.
2. Chuyển thư mục sang repository và khởi chạy VSCode.
git clone https://github.com/kingabzpro/data-engineering-analytics-mvp.git
cd data-engineering-analytics-mvp
code .
3. Vào Extensions (Ctrl + Shift + X), tìm OpenAI Codex và cài đặt. Thao tác này chỉ mất vài giây.
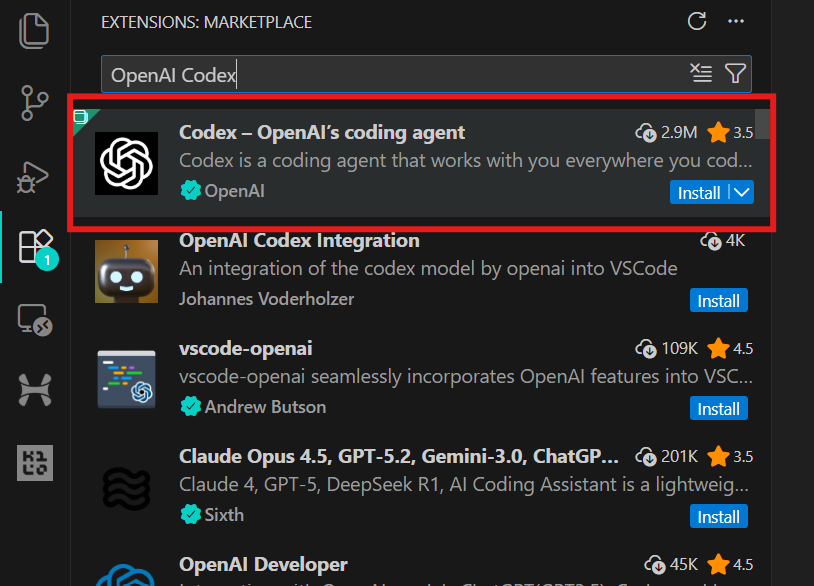
4. Nhấp biểu tượng OpenAI ở bảng trái để khởi chạy tiện ích Codex. Bạn sẽ được nhắc đăng nhập bằng tài khoản ChatGPT hoặc tài khoản API. Chọn tài khoản ChatGPT, trình duyệt sẽ mở để phê duyệt quyền truy cập. Khi đã phê duyệt, quay lại VSCode và Codex sẽ sẵn sàng sử dụng.
Dự án này được cố ý giới hạn trong phạm vi một Sản phẩm Tối thiểu khả dụng (MVP). Mục tiêu không phải xây dựng một nền tảng dữ liệu cấp sản xuất, mà là tạo một lát cắt kỹ thuật dữ liệu end-to-end hoàn chỉnh, thể hiện cấu trúc của các hệ thống phân tích thực tế.
Trong MVP này, chúng ta xây dựng một pipeline phân tích đơn giản nhưng đáng tin cậy, bao gồm:
raw_events)fct_events)Luồng đầy đủ như sau:
CSV file
  ↓
raw_events        (raw ingestion, 1:1 with source)
  ↓
fct_events        (typed, deduplicated, transformed)
  ↓
metrics           (daily count, 7-day rolling avg, top category)
  ↓
Streamlit UI (local dashboard)Ở bước này, chúng ta dùng GPT-5.2 Codex để sinh cấu trúc ban đầu của dự án. Mục tiêu chưa phải triển khai tính năng, mà là tạo nền tảng sạch, có thể chạy được để mở rộng từng bước.
Để giữ cho Codex tập trung, chúng ta dùng một khối điều khiển nhỏ gọi là Codex Harness. Khối này được dán ở đầu mỗi prompt và đảm bảo Codex giữ đúng phạm vi MVP, tạo đầu ra nhất quán, và commit thay đổi sạch, dễ review.
Codex Harness (dán vào mọi tác vụ):
You are GPT-5.2 Codex working in my GitHub repository.

MVP ONLY:
CSV → raw table → transform → 3 metrics → Streamlit dashboard.

SCOPE RULES:
- Implement ONLY what this task asks.
- No auth, schedulers, cloud services, or extra pages.

OUTPUT:
- Be descriptive.
- After changes include:
  1) What changed
  2) Files touched
  3) How to run locally
  4) Quick verification step
- Commit after each major step with a clear message.
Trước khi viết bất kỳ mã nào, Codex được chỉ dẫn rõ ràng sử dụng tìm kiếm web để xác minh các phiên bản phụ thuộc tương thích Python 3.11 mới nhất. Điều này giúp tránh cài đặt gói lỗi thời hoặc không tương thích.
IMPORTANT: USE WEB SEARCH FIRST
TASK 1 (SCAFFOLD):
Use Python 3.11 + uv + DuckDB + Streamlit + Pydantic + pytest.

Create repo structure:
- backend/
  - db.py
  - ingest.py
  - pipeline.py
  - models.py
  - sql/
- app/
  - app.py
- data/
  - sample.csv
- tests/

Add:
1) data/sample.csv (~50 rows) with columns:
   event_time, user_id, event_name, category, amount
2) DuckDB schema for raw_events
3) a command to ingest sample.csv and print row count
4) pyproject.toml for uv
5) README with exact local run steps

Stop after scaffolding. Commit.
Tác vụ scaffolding tạo ra:
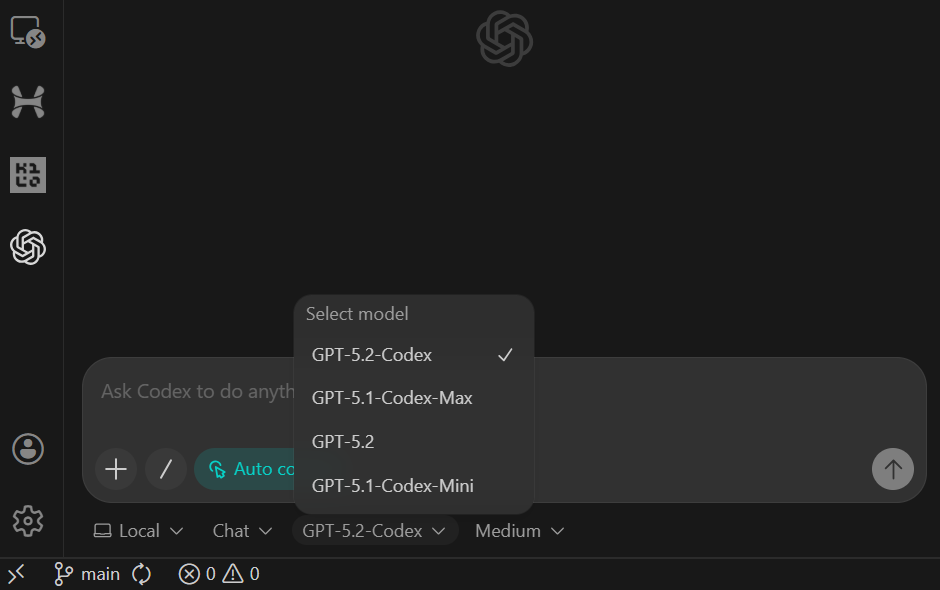
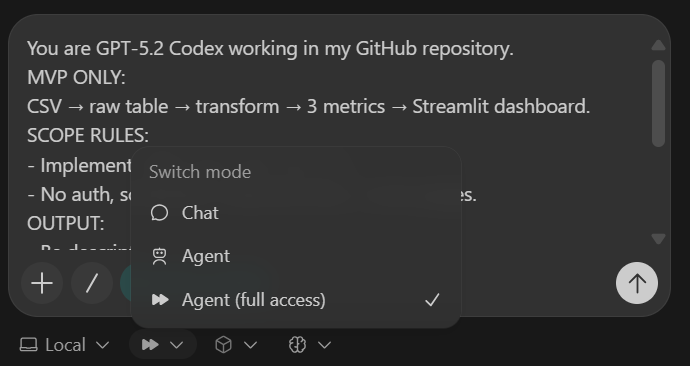
sample.csv raw_eventspyproject.toml và README hoạt độngSau khi dán prompt, hãy chuyển mô hình sang Agent (Full Access) và xác nhận rằng GPT-5.2 Codex đã được chọn (mặc định là vậy).
Khi tác vụ hoàn tất, bạn sẽ thấy tất cả thư mục và tệp đã được tạo tự động.
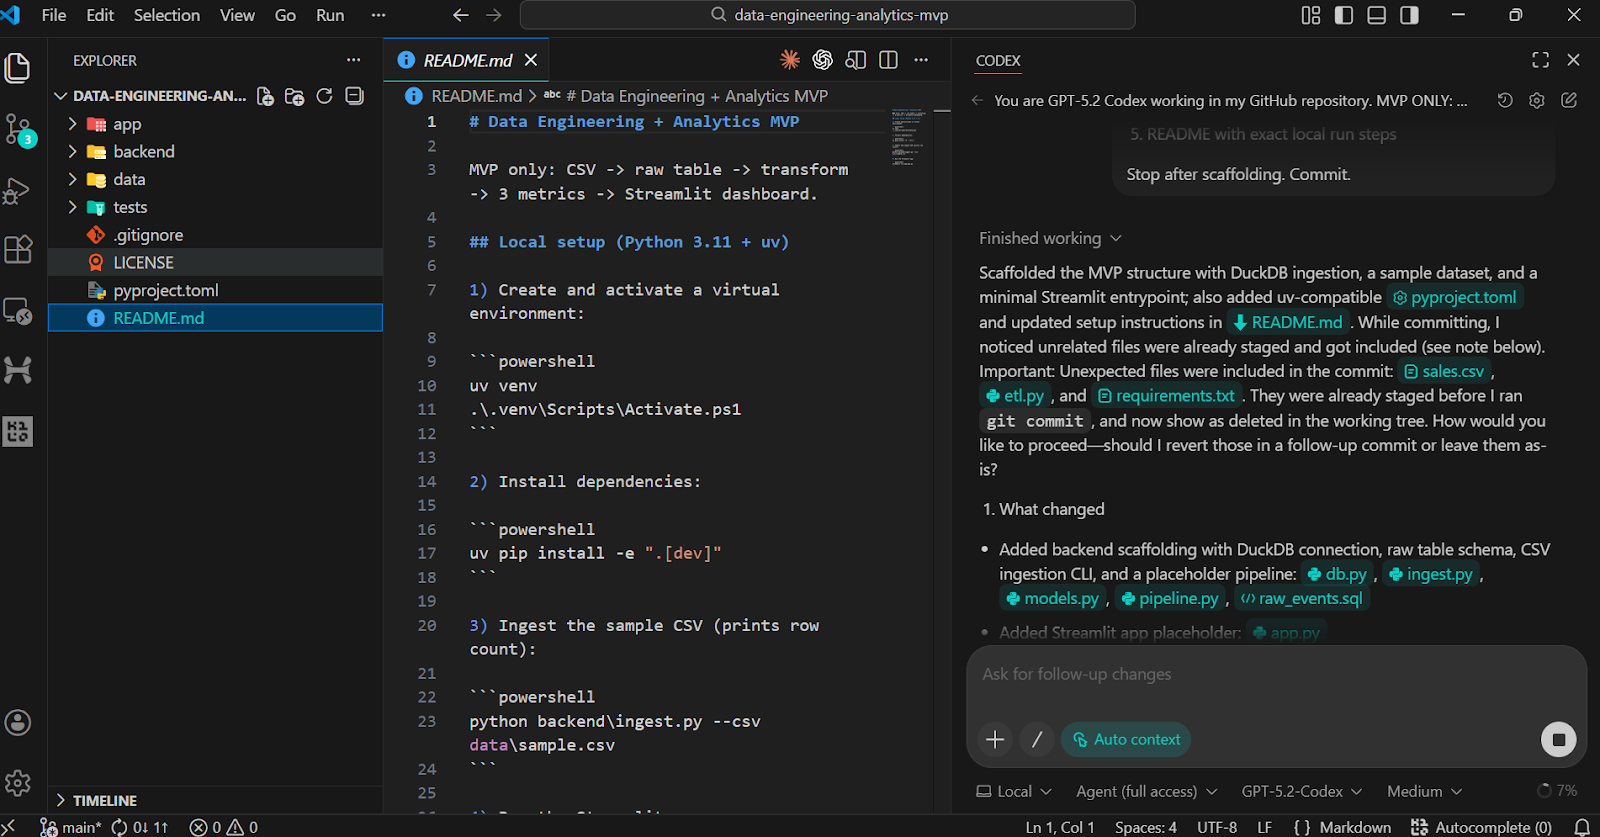
Để xác thực scaffold, hãy yêu cầu Codex chạy các bước cài đặt và kiểm tra tại chỗ.
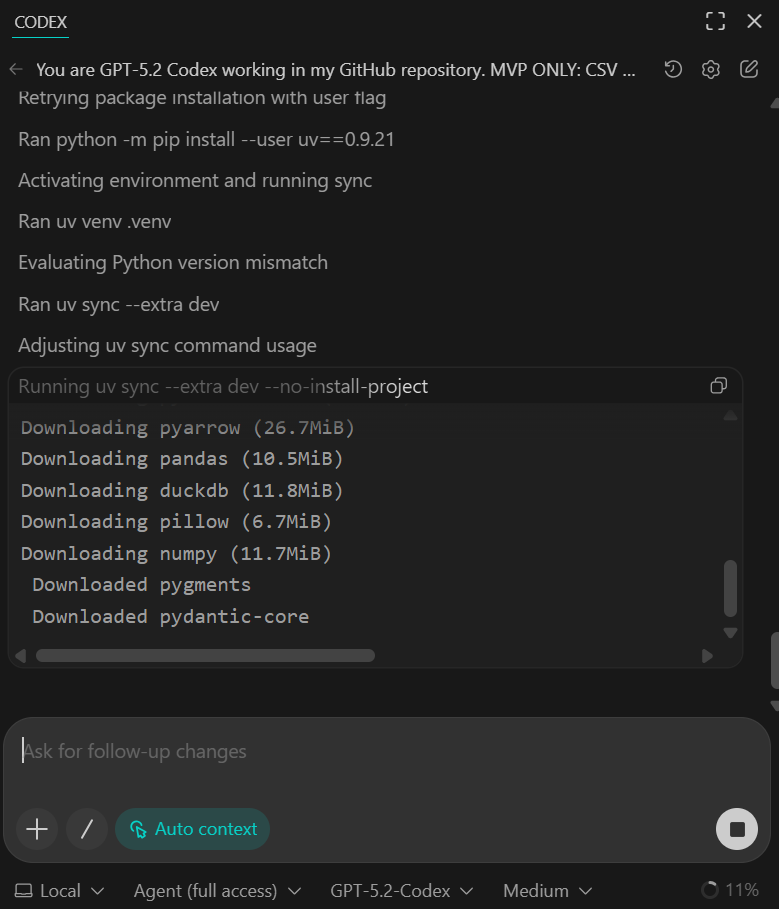
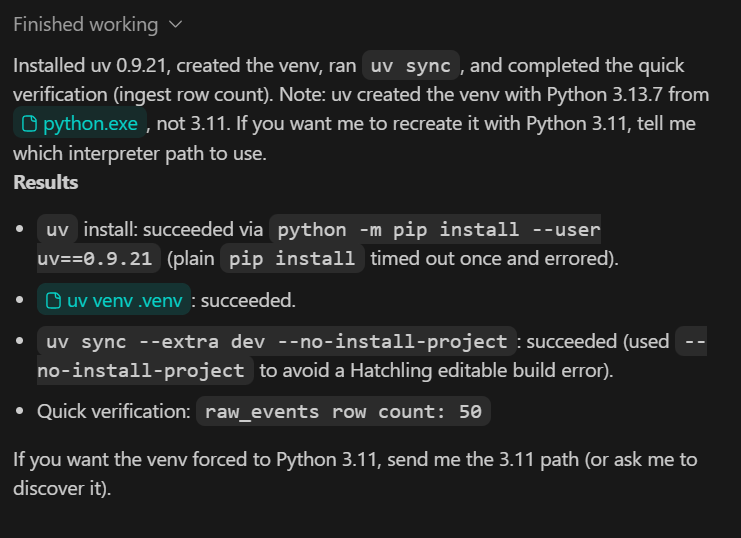
Bạn sẽ thấy tất cả phụ thuộc được cài thành công và script xác minh nhanh xác nhận đã ingest 50 dòng từ tập dữ liệu mẫu.
Ở giai đoạn này, dữ liệu mẫu được cố ý để nhỏ. Ở các bước sau, chúng ta sẽ thay thế bằng tập dữ liệu lớn hơn, thực tế hơn.
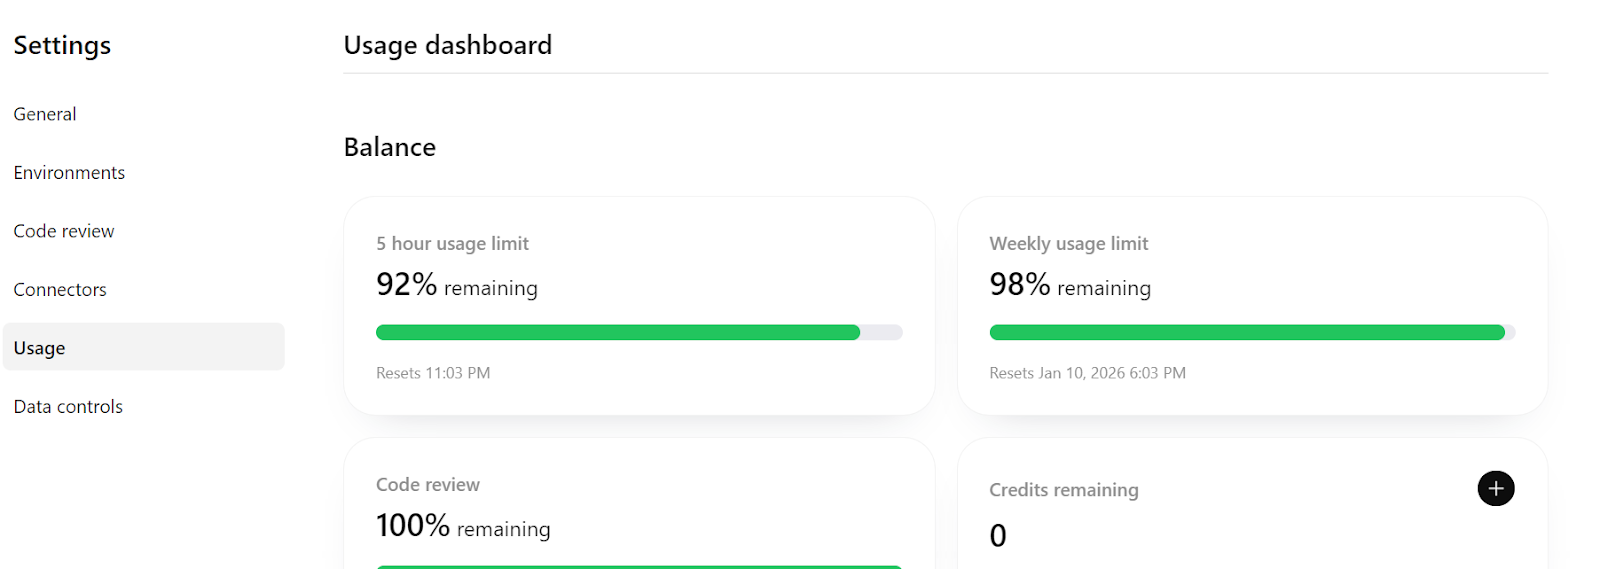
Cuối cùng, nếu bạn kiểm tra https://chatgpt.com/codex/settings/usage, bạn sẽ thấy phần lớn hạn mức sử dụng vẫn còn, nghĩa là bạn có thể thoải mái tiếp tục xây dựng và lặp lại dự án này, thậm chí mở rộng hướng tới pipeline sẵn sàng sản xuất nếu cần.
Ở bước này, chúng ta đảm bảo quy trình ingestion có tính idempotent, nghĩa là có thể chạy lại an toàn mà không tạo dữ liệu trùng lặp. Đây là yêu cầu cơ bản trong kỹ thuật dữ liệu, vì các job ingestion thường cần thử lại hoặc chạy lại.
TASK 2 (IDEMPOTENT INGEST):
Make CSV ingestion idempotent.
- Rerunning ingest must not duplicate rows
- Validate required columns
- Validate event_time parseable and amount numeric

Add pytest:
- ingest twice → row count unchanged

Update README verification section.
Commit.
Mục tiêu đạt được ở bước này:
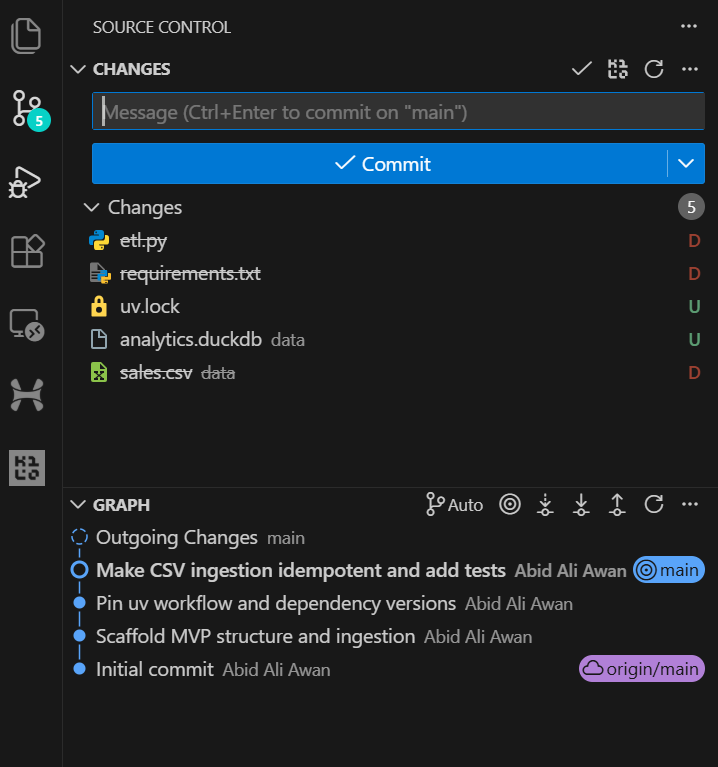
Sau khi tác vụ hoàn tất, bạn có thể xem lịch sử Git trong VSCode và thấy agent AI tự động commit thay đổi sau cập nhật lớn. Điều này mang lại lịch sử phát triển sạch và có thể truy vết.
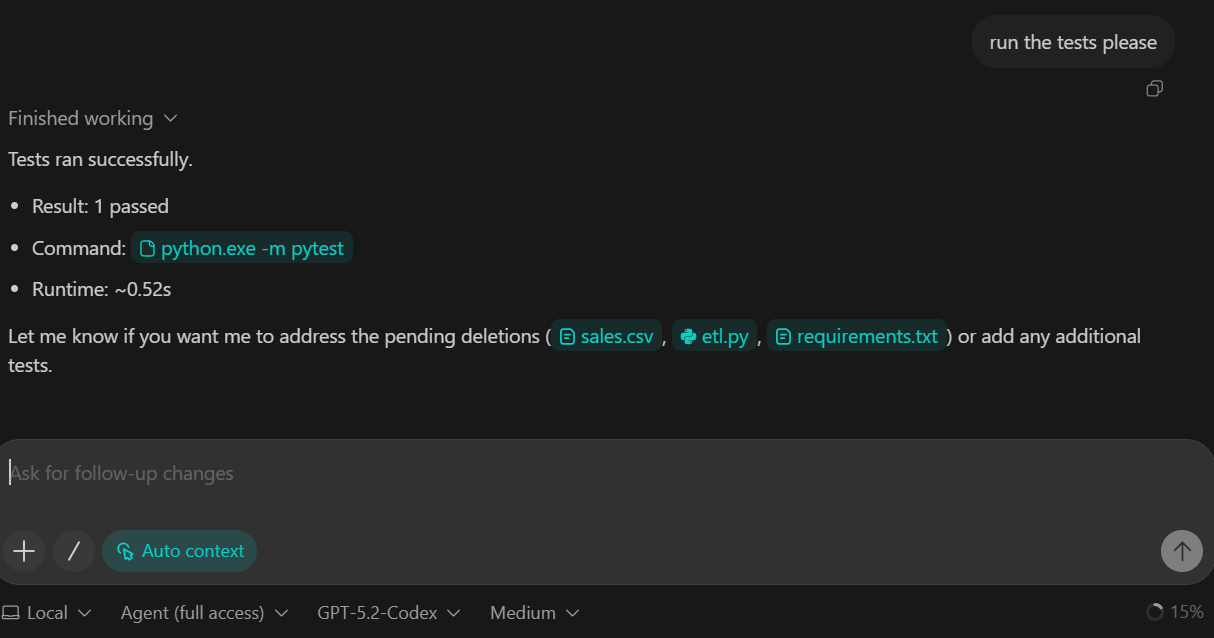
Chúng tôi đã yêu cầu GPT-5.2 Codex chạy bộ kiểm thử như một phần của tác vụ này. Kết quả là các kiểm thử đã chạy thành công và tất cả đều vượt qua.
Ở bước này, chúng ta giới thiệu lớp biến đổi của pipeline. Các biến đổi được triển khai bằng DuckDB SQL, cho phép chúng ta chuyển dữ liệu thô đã ingest thành bảng fact sạch, sẵn sàng phân tích.
TASK 3 (TRANSFORM SQL):
Create backend/sql/010_fct_events.sql:
- typed columns
- deterministic dedupe

Execute transform from backend/pipeline.py.
Add sanity checks to README:
- raw_events count
- fct_events count

Commit.
Mục tiêu đạt được ở bước này:
raw_events thành fct_events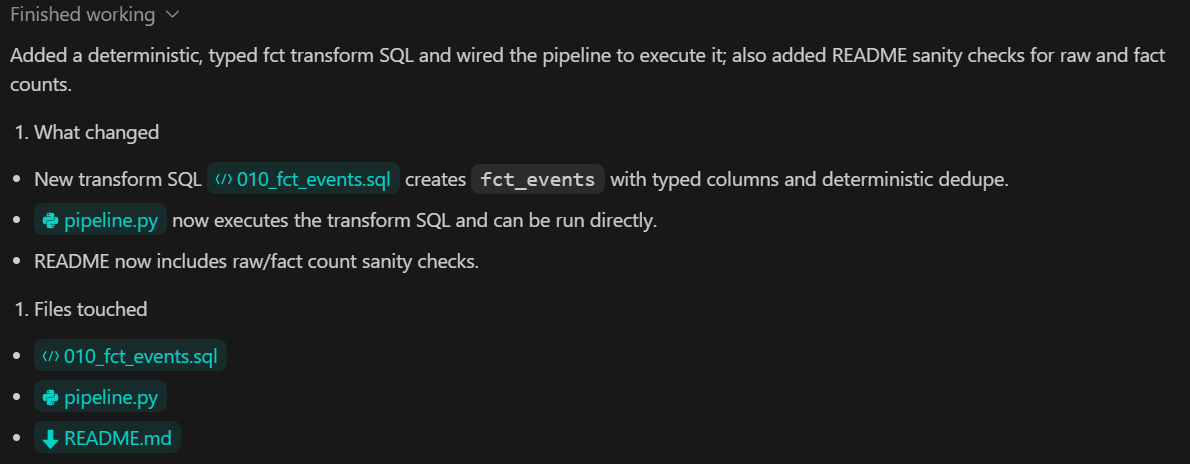
Ở bước này, chúng ta thêm lớp chỉ số, chịu trách nhiệm tính toán các đầu ra phân tích từ dữ liệu đã biến đổi. Các chỉ số được suy ra bằng DuckDB SQL và được cung cấp cho phần còn lại của hệ thống thông qua một giao diện Python có kiểu.
TASK 4 (METRICS):
Create backend/sql/020_metrics.sql.
Expose metrics via a Python function returning a Pydantic model.

Add pytest validating:
- keys exist
- types correct

Commit.
Mục tiêu đạt được ở bước này:
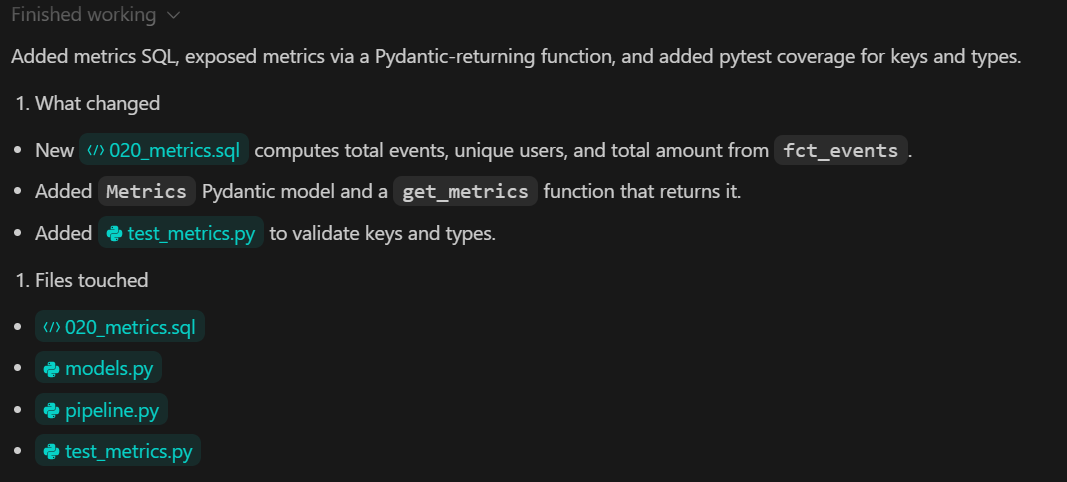
Ở bước này, chúng ta xây dựng bảng điều khiển phân tích cục bộ bằng Streamlit. Bảng điều khiển chỉ chịu trách nhiệm hiển thị. Nó không tính chỉ số hay biến đổi dữ liệu. Tất cả giá trị được đọc từ lớp chỉ số đã tạo ở bước trước.
TASK 5 (STREAMLIT UI):
Build app/app.py:
- 3 KPI cards
- line chart for daily_count
- UI calls backend metrics function

Add a minimal smoke test.
Commit.
Sau khi hoàn thành tác vụ, Codex cung cấp hướng dẫn để dựng lại cơ sở dữ liệu DuckDB và chạy toàn bộ pipeline dữ liệu. Ở bước này, chúng ta dùng một cơ sở dữ liệu mới được điền bằng tập dữ liệu lớn hơn.
python backend\ingest.py --csv data\sample.csv
python backend\pipeline.py
Sau khi chạy ingestion, đầu ra xác nhận số sự kiện thô đã nạp vào DuckDB:
raw_events row count: 3738Khi pipeline hoàn tất, khởi chạy ứng dụng Streamlit:
streamlit run app\app.pyBạn có thể truy cập bảng điều khiển bằng cách mở URL http://localhost:8501 trong trình duyệt.
You can now view your Streamlit app in your browser.

  Local URL: http://localhost:8501
  Network URL: http://192.168.18.10:8501
Nếu khi bảng điều khiển tải lần đầu có lỗi, điều này là bình thường trong các lần lặp đầu. Hãy sao chép thông báo lỗi và cung cấp cho GPT-5.2 Codex.
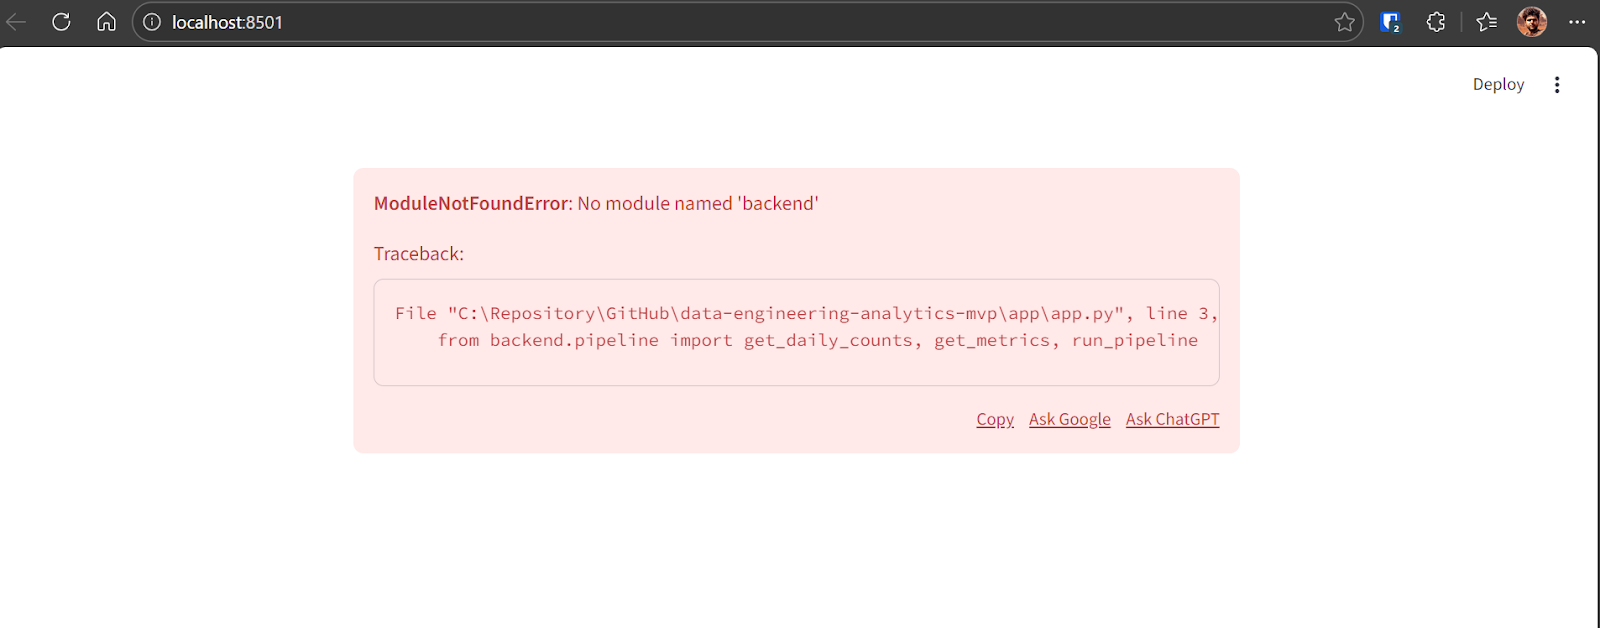
Codex sẽ xác định vấn đề và áp dụng bản vá cần thiết. Sau khi sửa, ứng dụng chạy thành công và hiển thị:
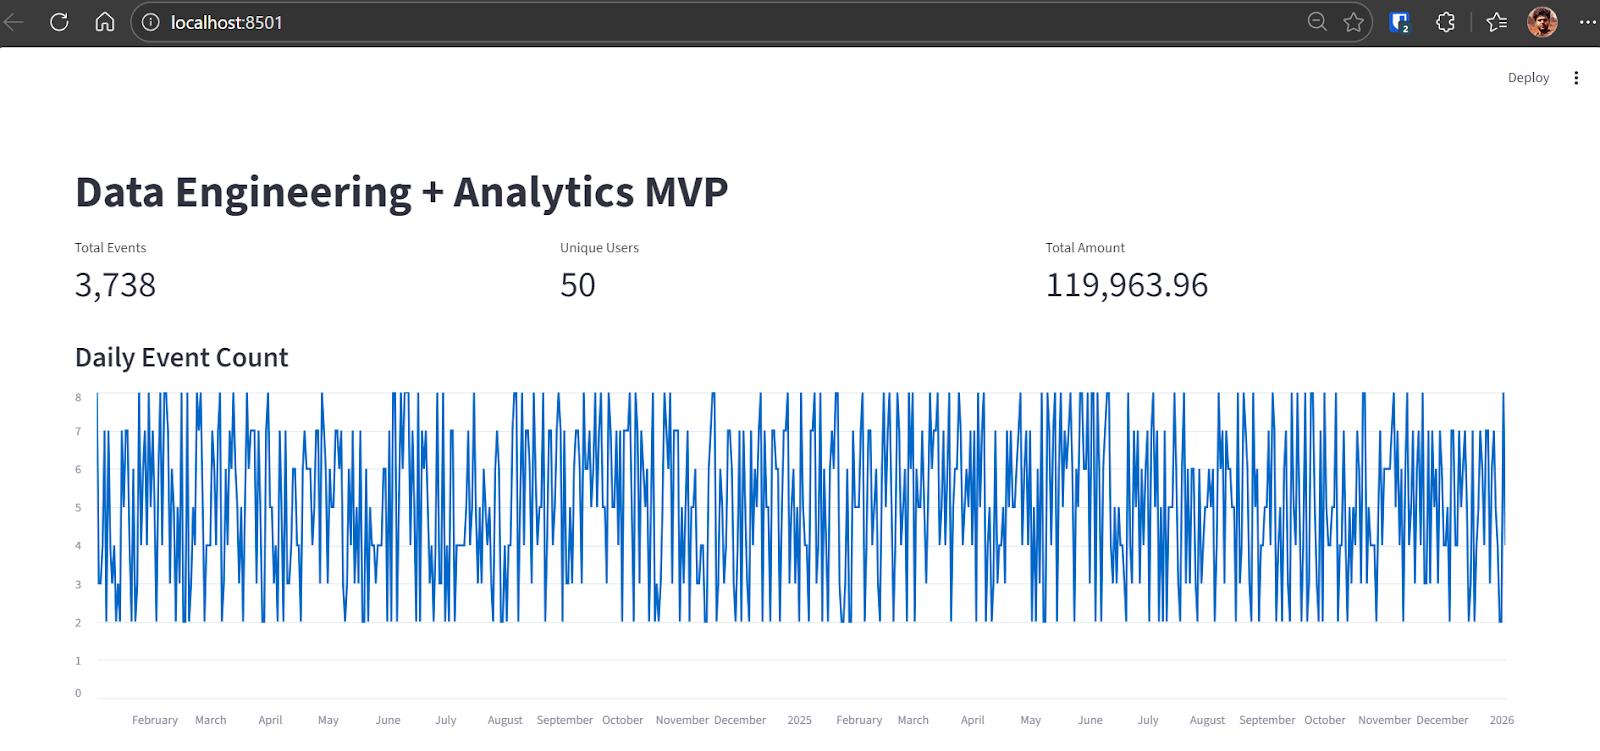
Tại thời điểm này, pipeline MVP end-to-end đã hoàn chỉnh và hoạt động đầy đủ.
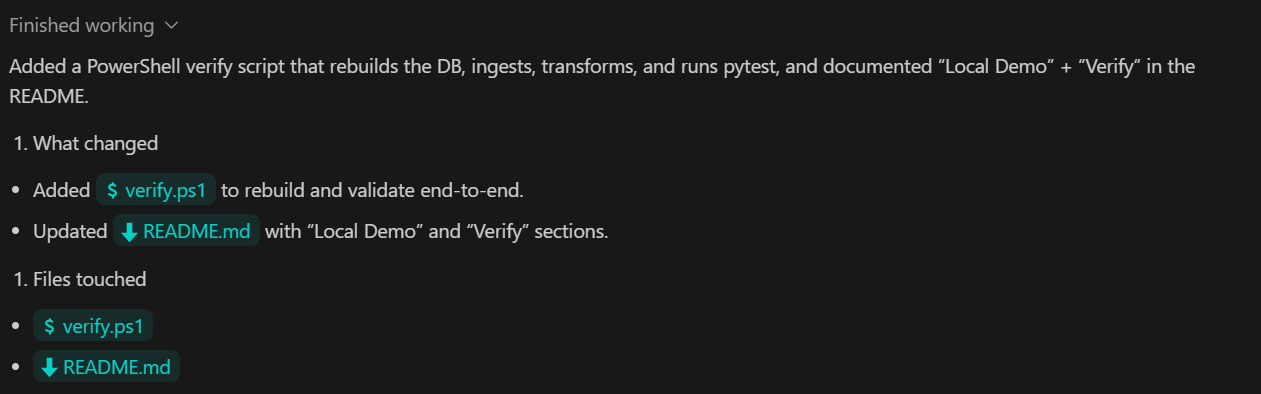
Ở bước cuối, chúng ta tập trung vào xác minh và độ tin cậy. Mục tiêu là cung cấp một lệnh duy nhất chứng minh toàn bộ pipeline hoạt động đúng từ ingestion đến chỉ số và kiểm thử.
TASK 6 (VERIFY):
Add a verify command that:
- rebuilds DB from scratch
- ingests sample.csv
- runs transforms
- runs pytest

Document as "Local Demo" and "Verify" in README.
Commit.
Mục tiêu đạt được ở bước này:
Chúng tôi đã yêu cầu Codex cập nhật README, commit mọi thay đổi và đẩy chúng lên repository từ xa trên GitHub.
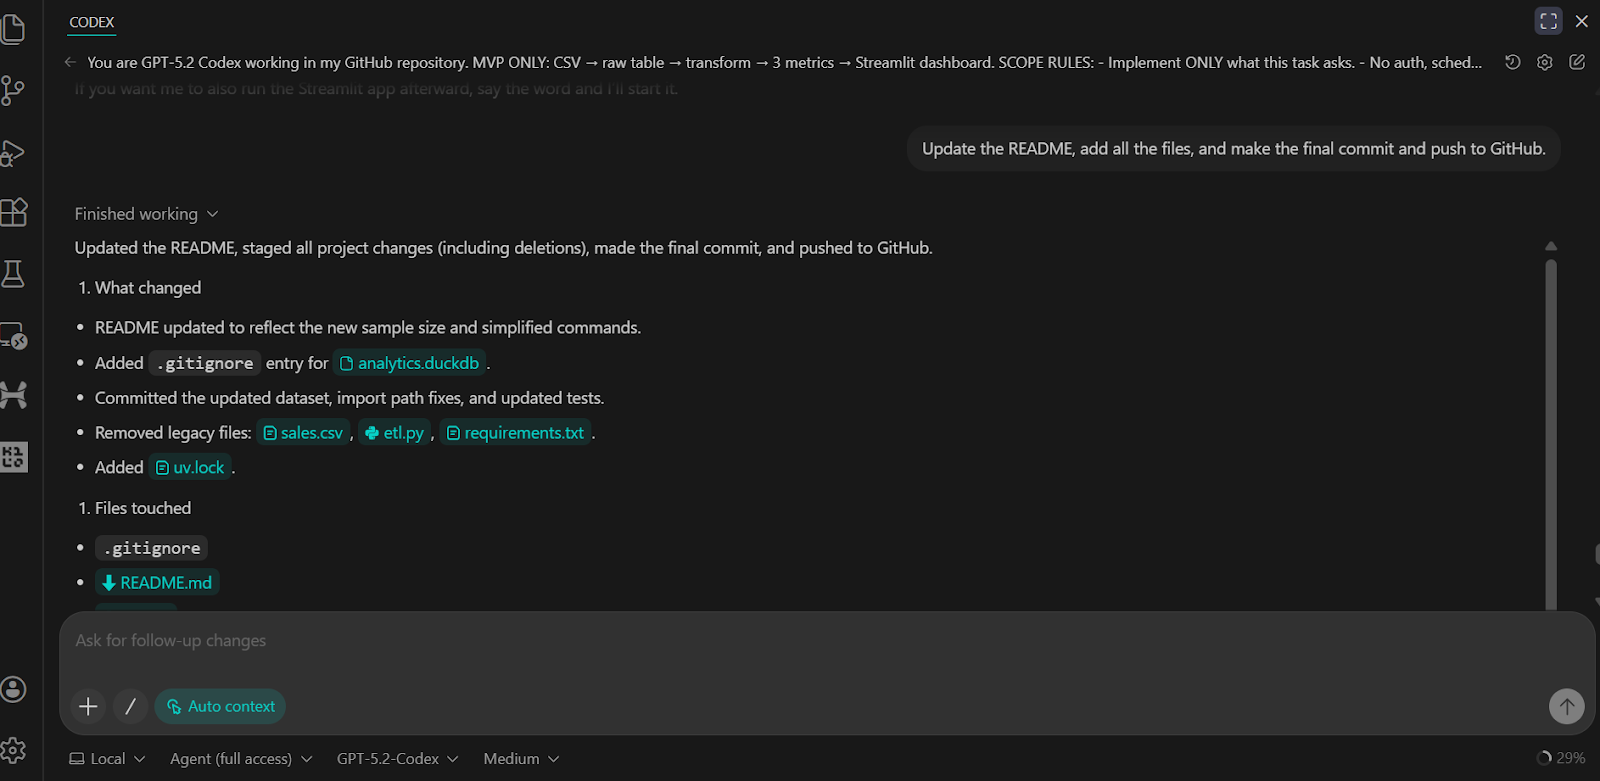
Kết quả là một GitHub repository hoàn chỉnh và được tổ chức tốt, bao gồm mọi script, kiểm thử, logic backend và hướng dẫn rõ ràng để chạy và xác minh dự án.
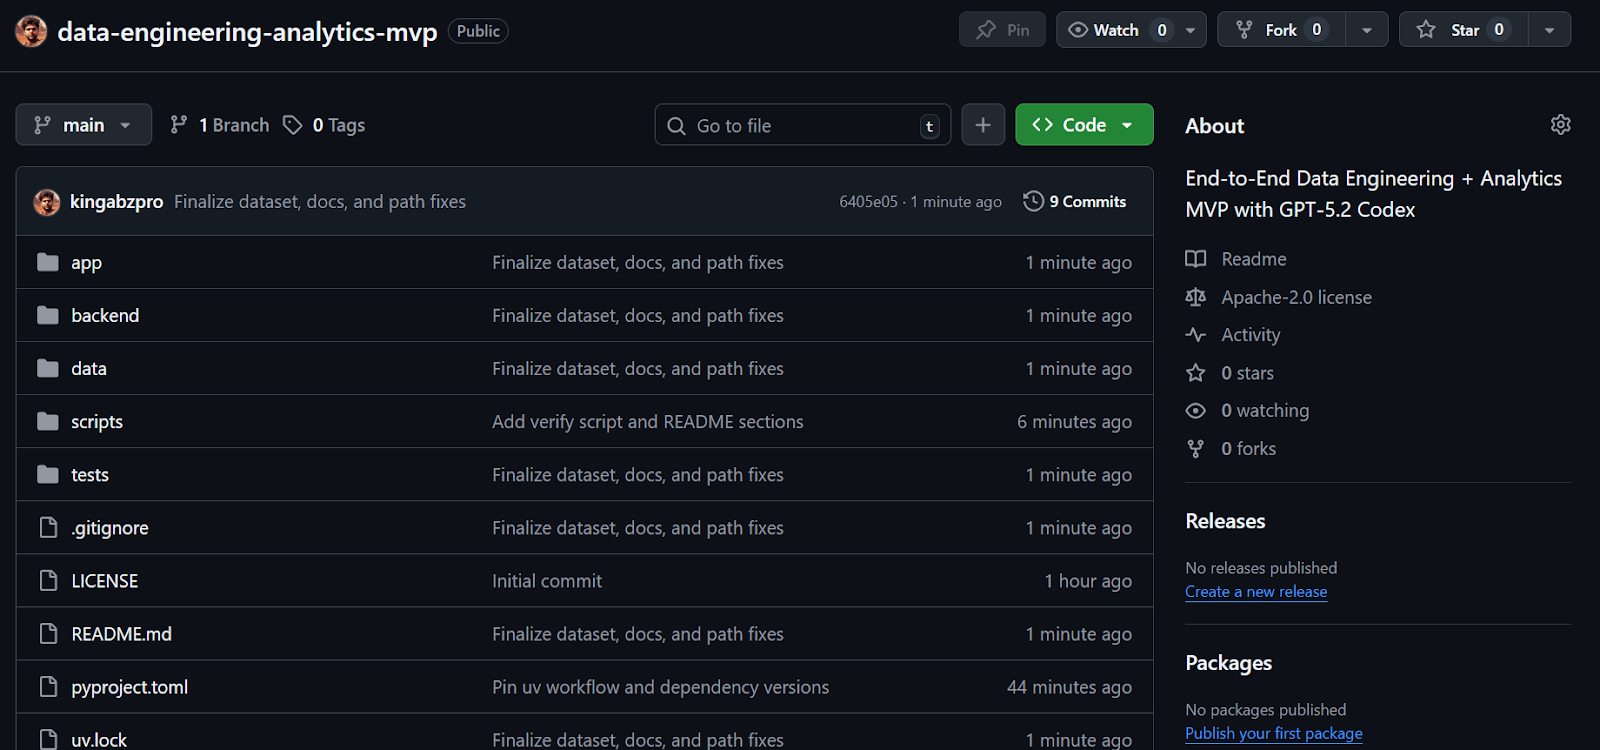
Nguồn: kingabzpro/data-engineering-analytics-mvp
Trước đây tôi đã dùng Codex qua CLI và trong VSCode theo thời gian, nhưng các cập nhật gần đây với GPT-5.2 Codex đã tạo ra khác biệt rõ rệt. Mô hình tốt hơn đáng kể trong việc xây dựng hệ thống hoàn chỉnh, gỡ lỗi và làm việc với các công cụ như MCP và tooling nội bộ. Nó cũng thể hiện hiểu biết mạnh hơn nhiều về codebase hiện có, giúp việc phát triển lặp lại hiệu quả hơn rất nhiều.
Từ đầu đến cuối, toàn bộ MVP này tốn của tôi chưa đến ba mươi phút để scaffold, gỡ lỗi và chạy end-to-end. Codex xử lý thiết lập repository, quản lý phụ thuộc, ingestion dữ liệu, biến đổi SQL, kiểm thử và bảng điều khiển Streamlit với rất ít can thiệp thủ công. Vòng lặp phát triển cảm giác chặt chẽ và dễ đoán, đúng như những gì bạn mong muốn khi xây nhanh.
Dự án này được cố ý là MVP. Nó sẽ cần thêm lặp lại và gia cố để sẵn sàng sản xuất. Dù vậy, cấu trúc lõi phản chiếu khá sát cách thiết kế hệ thống kỹ thuật dữ liệu thực tế, khiến nó trở thành nền tảng vững chắc để xây tiếp.
Nếu bạn muốn mở rộng dự án này hướng tới nền tảng dữ liệu thiên về sản xuất, các thành phần sau là bước tiếp theo tự nhiên nhưng đã được cố ý loại trừ ở đây để giữ phạm vi tập trung:
Những công cụ này phổ biến trong hệ thống sản xuất, nhưng việc loại trừ chúng ở đây giúp dự án đơn giản, cục bộ và dễ suy luận, đồng thời vẫn phản ánh các mẫu hình kỹ thuật dữ liệu trong thực tế.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
