
Kurs
OpenAI API ile Çalışmak
3 sa
184.8K
Bu eğitimde, VSCode uzantısı üzerinden GPT-5.2 Codex kullanarak uçtan uca bir veri mühendisliği hattı oluşturmayı öğreneceğiz. Modelden her şeyi bir kerede oluşturmasını istemek yerine, MVP’yi katman katman inşa edecek, temsilciyi tasarım, uygulama ve test aşamalarında adım adım yönlendireceğiz.
Bu yaklaşım, GPT-5.2 Codex’in pratikte en iyi nasıl çalıştığını yansıtır ve gerçek dünyadaki veri mühendisliği iş akışlarını örnekler. Modelin yeni sürümü olan GPT-5.3 Codex ve OpenAI’nin yeni düşünme modeli GPT-5.4 hakkındaki rehberimize de mutlaka göz atın.
OpenAI ekosistemiyle çalışmak hakkında daha fazla bilgi edinmek isterseniz, OpenAI API ile Çalışma kursuna göz atmanızı öneririm.
GPT 5.2 Codex, OpenAI’nin gerçek dünya yazılım mühendisliği iş akışları için geliştirilmiş en yeni nesil ajan tabanlı kodlama modelleridir. Uzun bağlam anlama, büyük çaplı yeniden düzenlemeler ve geçişler, güvenilir araç kullanımı ve güçlü yerel Windows desteğindeki son iyileştirmeler üzerine inşa edilmiştir.
Bu iyileştirmeler, VSCode gibi IDE’ler içinde uzun süreli, uçtan uca geliştirme çalışmaları için özellikle etkilidir. Son birkaç ayda OpenAI Codex VSCode uzantısı önemli ölçüde gelişti ve artık karmaşık, ajan odaklı geliştirmelerde Claude Code ile doğrudan rekabet ediyor.
Veri mühendisliği MVP’miz için yeni bir GitHub deposu oluşturarak başlayacağız.
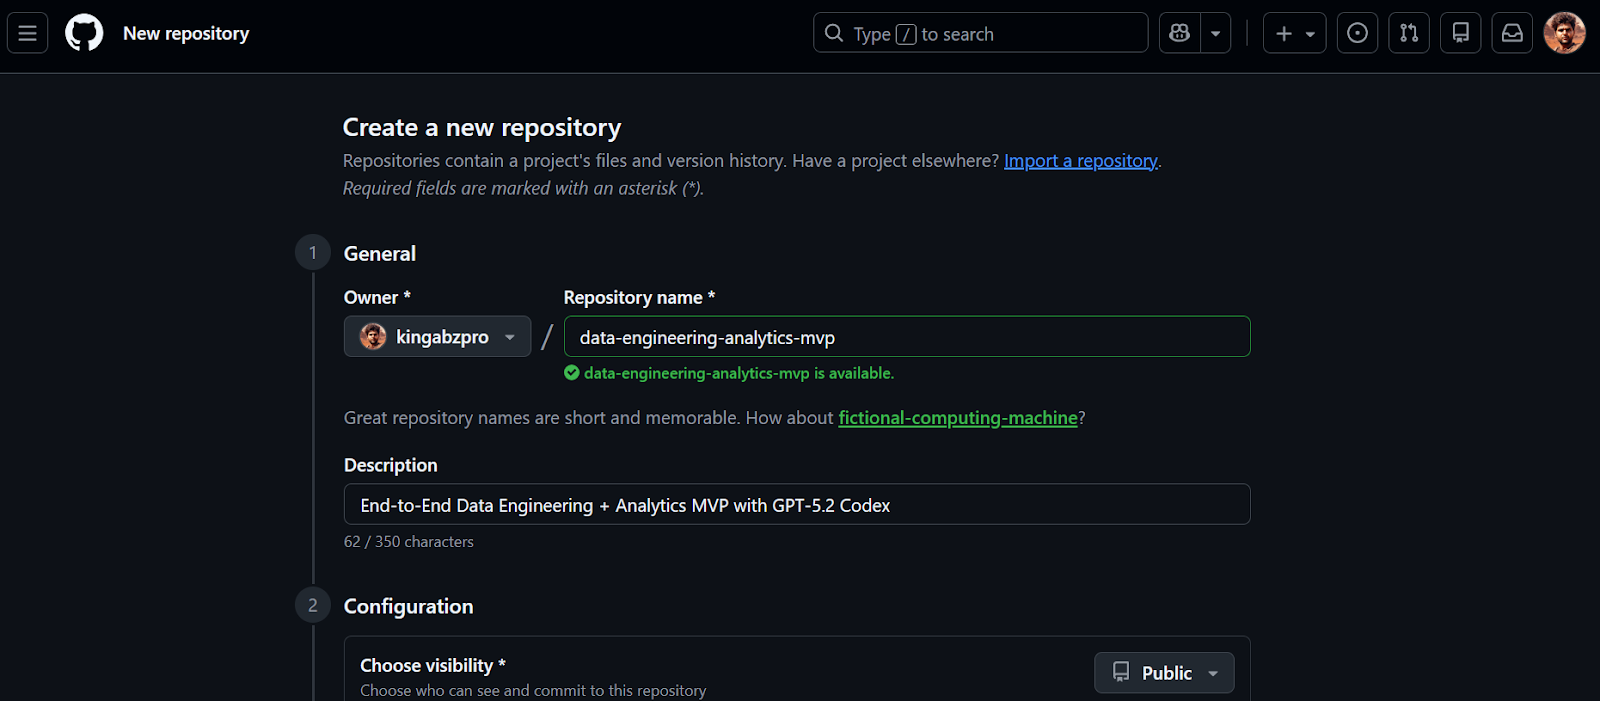
Depo oluşturulduktan sonra depo URL’sini kopyalayın. Bir sonraki adımda projeyi yerel olarak klonlamak için bu URL’yi kullanacağız.
Başlamadan önce, Visual Studio Code’un kurulu olduğundan ve etkin bir ChatGPT Plus hesabınız bulunduğundan emin olun. Ücretsiz ve Go planları, VSCode uzantısında Codex modellerine erişim sağlamaz.
1. Daha önce kopyaladığınız URL’yi kullanarak depoyu klonlayın.
2. Depo dizinine geçin ve VSCode’u başlatın.
git clone https://github.com/kingabzpro/data-engineering-analytics-mvp.git
cd data-engineering-analytics-mvp
code .
3. Uzantılar’a (Ctrl + Shift + X) gidin, OpenAI Codex’i arayın ve yükleyin. Bu işlem sadece birkaç saniye sürecektir.
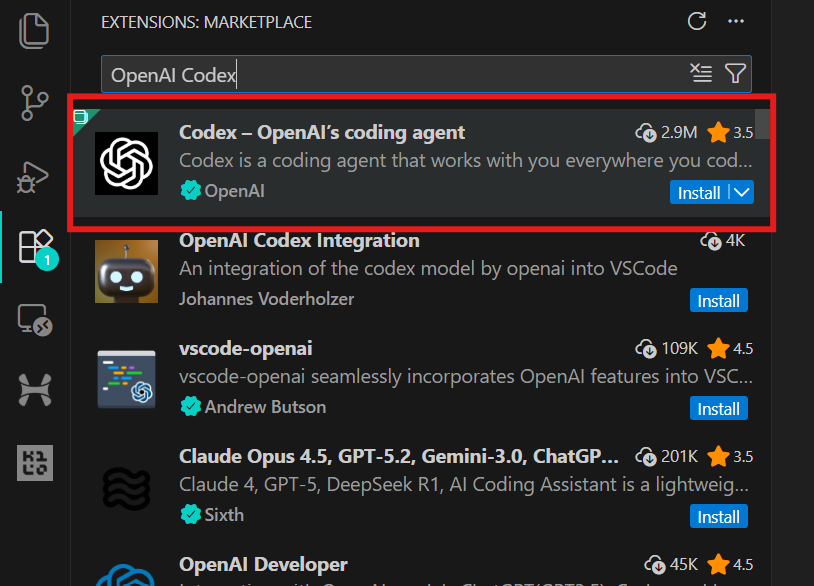
4. Codex uzantısını başlatmak için sol paneldeki OpenAI simgesine tıklayın. ChatGPT hesabınız veya bir API hesabı ile oturum açmanız istenecektir. ChatGPT hesabını seçin; bu, erişimi onaylamak üzere sizi tarayıcıya yönlendirecektir. Onayladıktan sonra VSCode’a dönün ve Codex kullanıma hazır olacaktır.
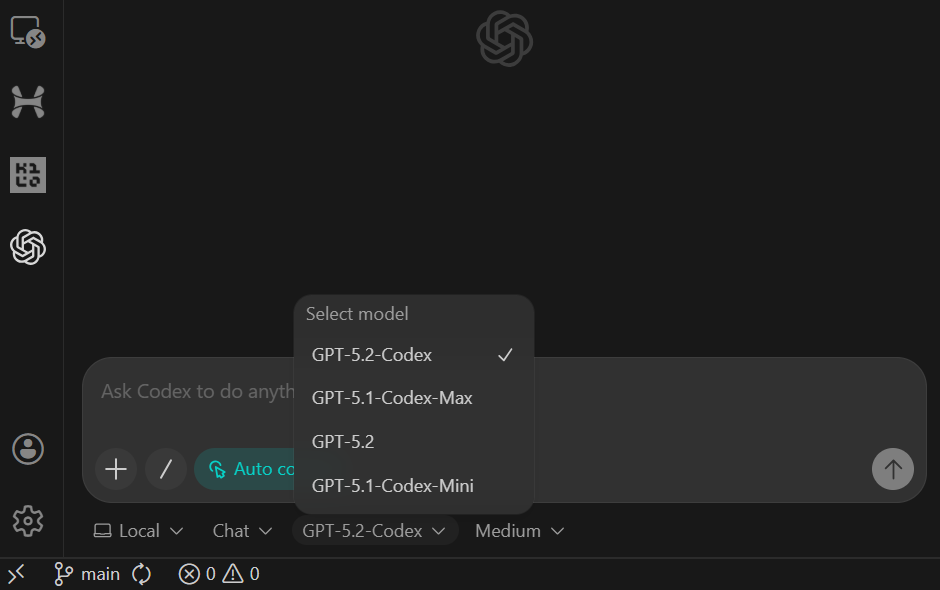
Bu proje, bilerek Asgari Uygulanabilir Ürün (MVP) kapsamıyla tasarlanmıştır. Amaç, üretim düzeyinde bir veri platformu kurmak değil; gerçek analitik sistemlerin nasıl yapılandığını gösteren, uçtan uca tamamlanmış bir veri mühendisliği dilimi oluşturmaktır.
Bu MVP’de, aşağıdakileri yapan basit ama güvenilir bir analitik hattı kuruyoruz:
raw_events)fct_events)Tüm akış şu şekildedir:
CSV file
  ↓
raw_events        (raw ingestion, 1:1 with source)
  ↓
fct_events        (typed, deduplicated, transformed)
  ↓
metrics           (daily count, 7-day rolling avg, top category)
  ↓
Streamlit UI (local dashboard)Bu adımda, projenin başlangıç yapısını oluşturmak için GPT-5.2 Codex’i kullanıyoruz. Amaç henüz özellikleri geliştirmek değil; adım adım genişleteceğimiz temiz ve çalıştırılabilir bir temel oluşturmaktır.
Codex’i odakta tutmak için, Codex Harness adlı küçük bir kontrol bloğu kullanıyoruz. Bu kılavuz, her istemin başına yapıştırılır ve Codex’in MVP kapsamı içinde kalmasını, tutarlı çıktılar üretmesini ve temiz, incelenebilir değişiklikler işlemesini sağlar.
Codex Harness (her göreve yapıştırın):
You are GPT-5.2 Codex working in my GitHub repository.

MVP ONLY:
CSV → raw table → transform → 3 metrics → Streamlit dashboard.

SCOPE RULES:
- Implement ONLY what this task asks.
- No auth, schedulers, cloud services, or extra pages.

OUTPUT:
- Be descriptive.
- After changes include:
  1) What changed
  2) Files touched
  3) How to run locally
  4) Quick verification step
- Commit after each major step with a clear message.
Herhangi bir kod yazmadan önce, Codex’e tüm bağımlılıkların Python 3.11 ile uyumlu en güncel sürümlerini doğrulamak için web aramasını kullanması açıkça talimatlandırılır. Bu, eski veya uyumsuz paketlerin yüklenmesini önler.
IMPORTANT: USE WEB SEARCH FIRST
TASK 1 (SCAFFOLD):
Use Python 3.11 + uv + DuckDB + Streamlit + Pydantic + pytest.

Create repo structure:
- backend/
  - db.py
  - ingest.py
  - pipeline.py
  - models.py
  - sql/
- app/
  - app.py
- data/
  - sample.csv
- tests/

Add:
1) data/sample.csv (~50 rows) with columns:
   event_time, user_id, event_name, category, amount
2) DuckDB schema for raw_events
3) a command to ingest sample.csv and print row count
4) pyproject.toml for uv
5) README with exact local run steps

Stop after scaffolding. Commit.
İskelet oluşturma görevi şunları yaratır:
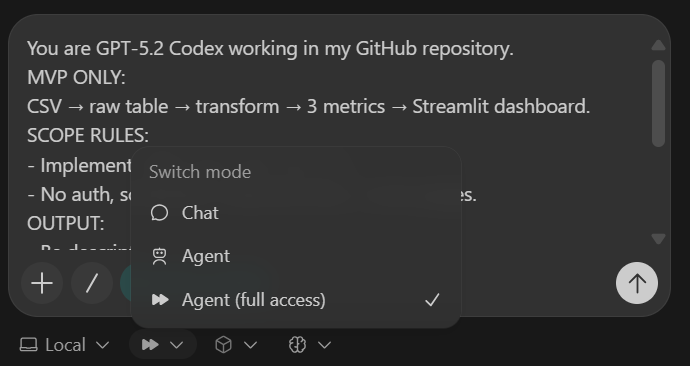
sample.csv veri kümesiraw_events tablo şemasıpyproject.toml ve READMEİstemi yapıştırdıktan sonra, modeli Agent (Full Access) olarak değiştirin ve GPT-5.2 Codex’in seçili olduğunu doğrulayın (varsayılan budur).
Görev tamamlandığında, tüm klasör ve dosyaların otomatik olarak oluşturulduğunu göreceksiniz.
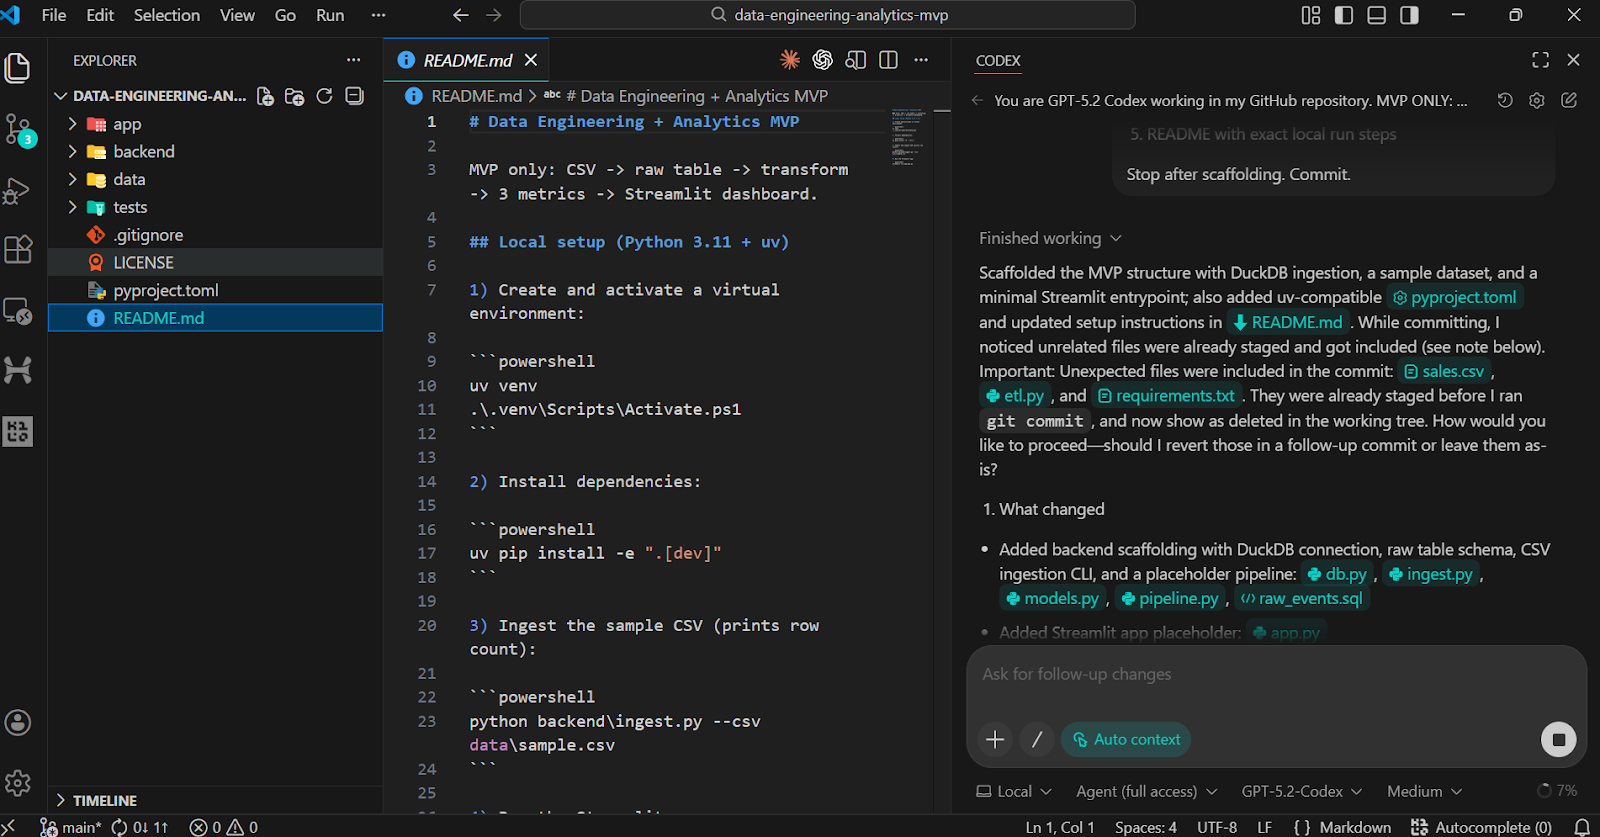
İskeleti doğrulamak için, Codex’ten kurulum ve doğrulama adımlarını yerelde çalıştırmasını isteyin.
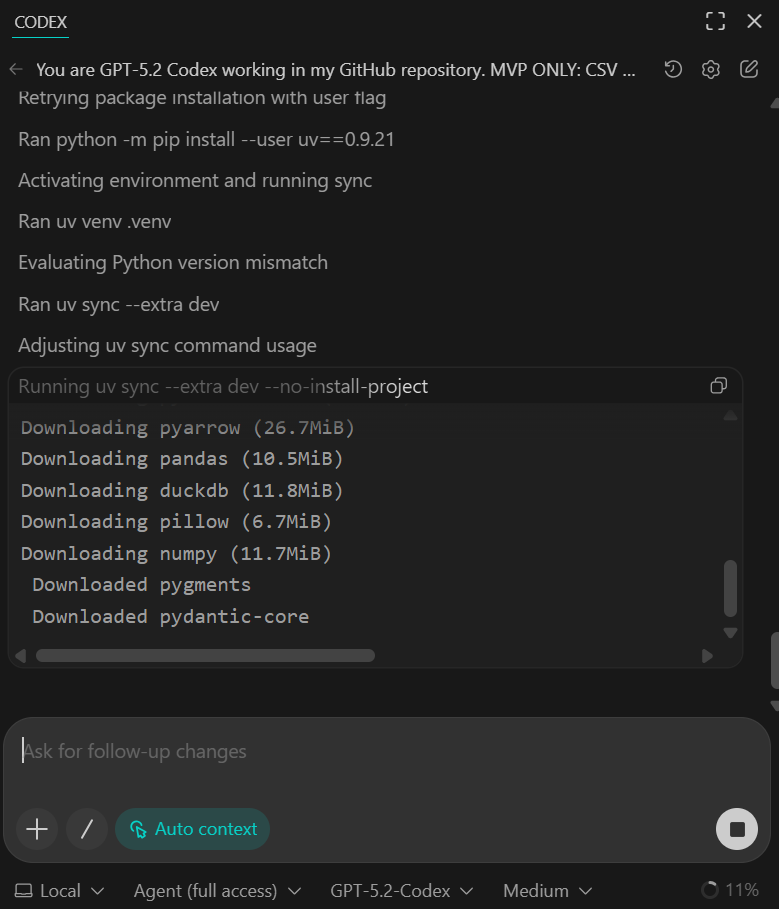
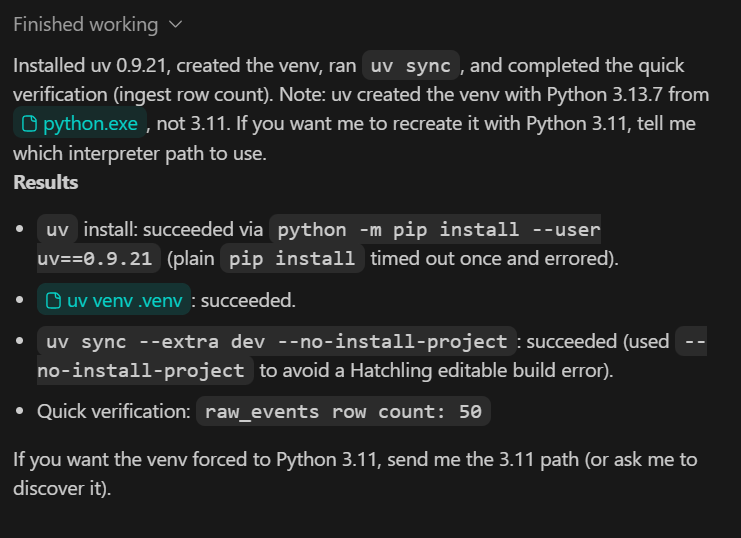
Tüm bağımlılıkların başarıyla yüklendiğini ve hızlı doğrulama betiğinin örnek veri kümesinden 50 satırın içe aktarıldığını doğruladığını görmelisiniz.
Bu aşamada örnek veri bilerek küçüktür. İlerleyen adımlarda bunu daha büyük ve gerçekçi bir veri kümesiyle değiştireceğiz.
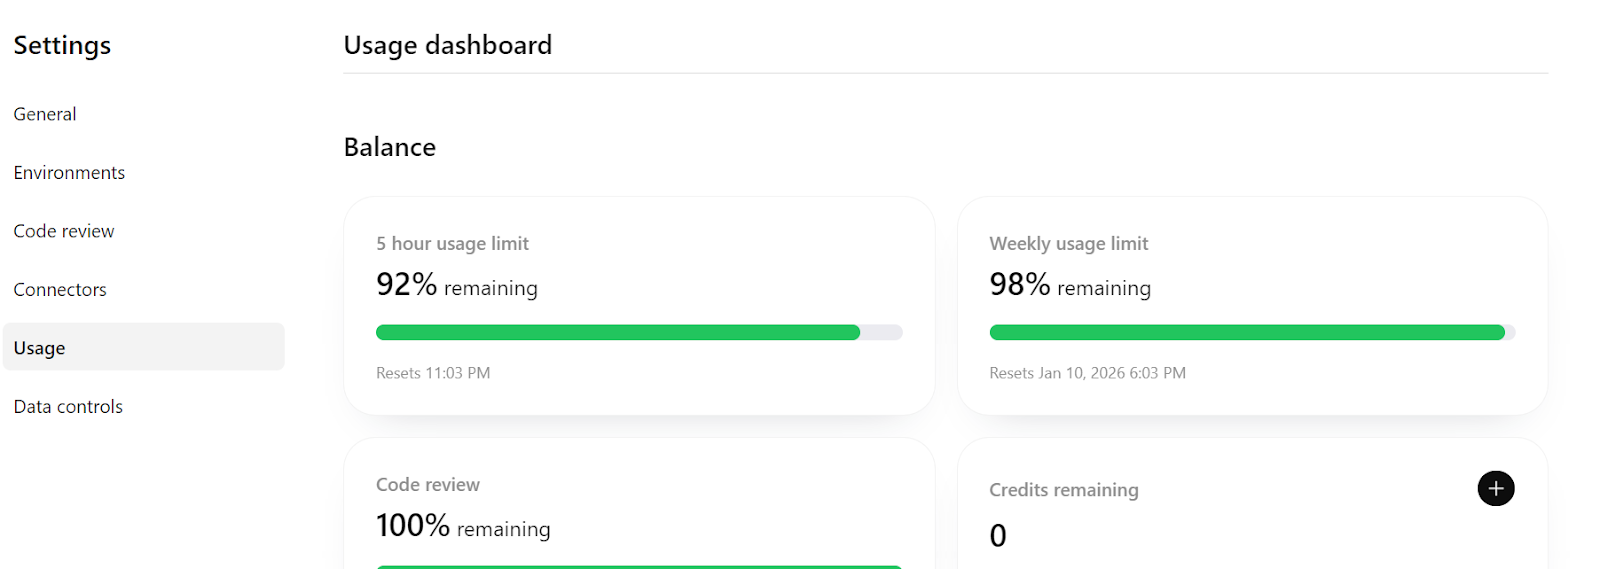
Son olarak, https://chatgpt.com/codex/settings/usage adresine bakarsanız, kullanım kotanızın büyük bölümünün hâlâ mevcut olduğunu göreceksiniz; bu da, gerekirse projeyi daha üretim odaklı bir hatta doğru genişletecek şekilde, rahatça kurmaya ve yinelemeye devam edebileceğiniz anlamına gelir.
Bu adımda, içe aktarma sürecinin idempotent olmasını, yani yinelemeli olarak güvenle çalıştırılabilmesini ve yinelenen veri oluşturmamasını sağlarız. Bu, veri mühendisliğinde temel bir gereksinimdir; zira içe aktarma işlerleri sık sık yeniden denenmek veya yeniden yürütülmek zorunda kalır.
TASK 2 (IDEMPOTENT INGEST):
Make CSV ingestion idempotent.
- Rerunning ingest must not duplicate rows
- Validate required columns
- Validate event_time parseable and amount numeric

Add pytest:
- ingest twice → row count unchanged

Update README verification section.
Commit.
Bu adımın sağladıkları:
Görev tamamlandıktan sonra, VSCode’daki Git geçmişini inceleyebilir ve büyük güncellemeden sonra yapay zekâ temsilcisinin değişiklikleri otomatik olarak işlediğini görebilirsiniz. Bu, temiz ve takip edilebilir bir geliştirme geçmişi sağlar.
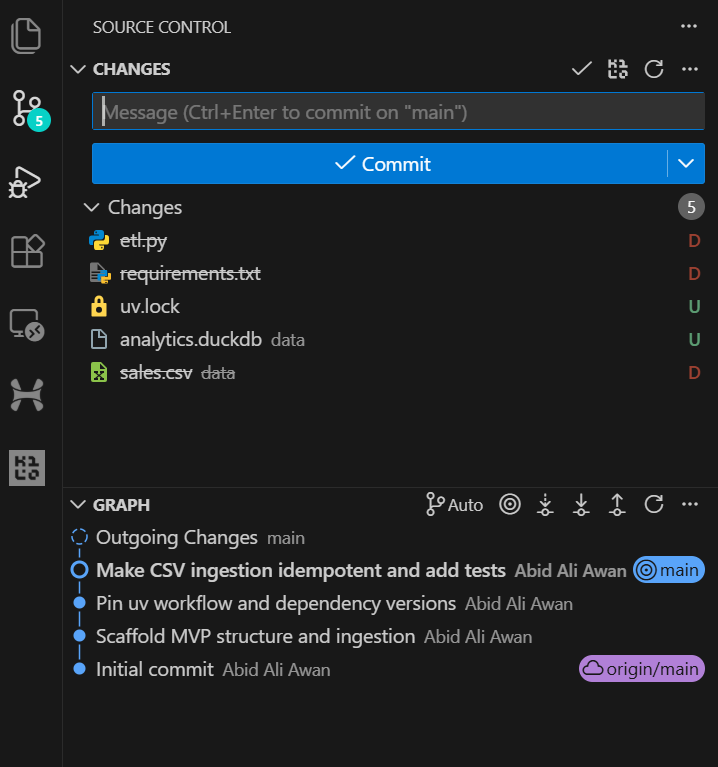
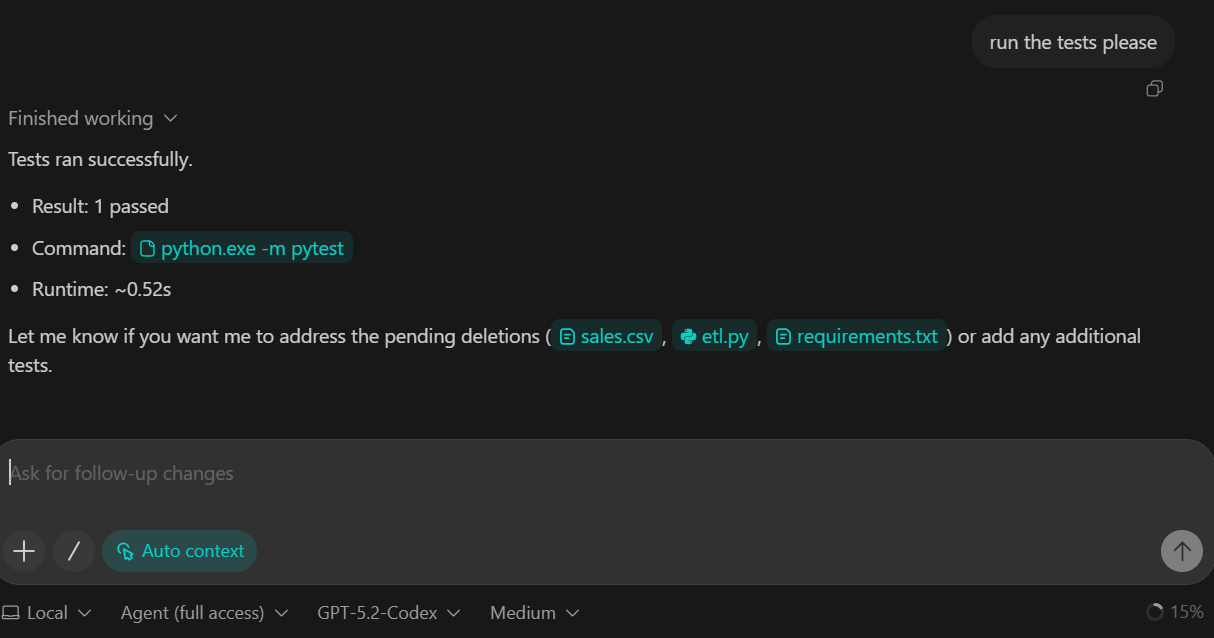
Bu görevin bir parçası olarak GPT-5.2 Codex’ten test paketini çalıştırmasını istedik. Sonuç olarak testler başarıyla yürütüldü ve tüm kontroller geçti.
Bu adımda, hattın dönüşüm katmanını ekliyoruz. Dönüşümler, ham içe aktarılan verileri temiz, analitiğe hazır bir olgu tablosuna dönüştürmemizi sağlayan DuckDB SQL kullanılarak uygulanır.
TASK 3 (TRANSFORM SQL):
Create backend/sql/010_fct_events.sql:
- typed columns
- deterministic dedupe

Execute transform from backend/pipeline.py.
Add sanity checks to README:
- raw_events count
- fct_events count

Commit.
Bu adımın sağladıkları:
raw_events tablosunu fct_events tablosuna dönüştüren SQL tabanlı bir dönüşüm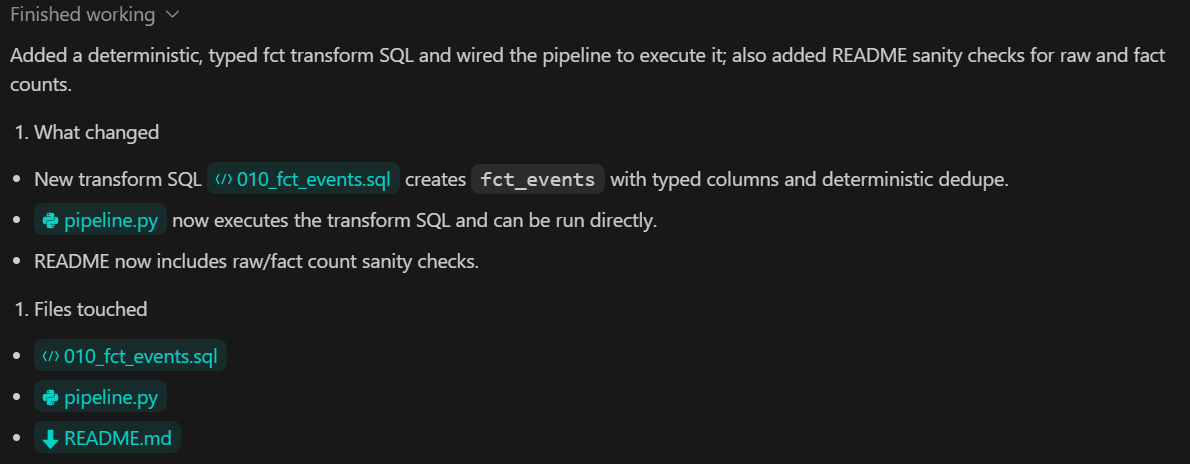
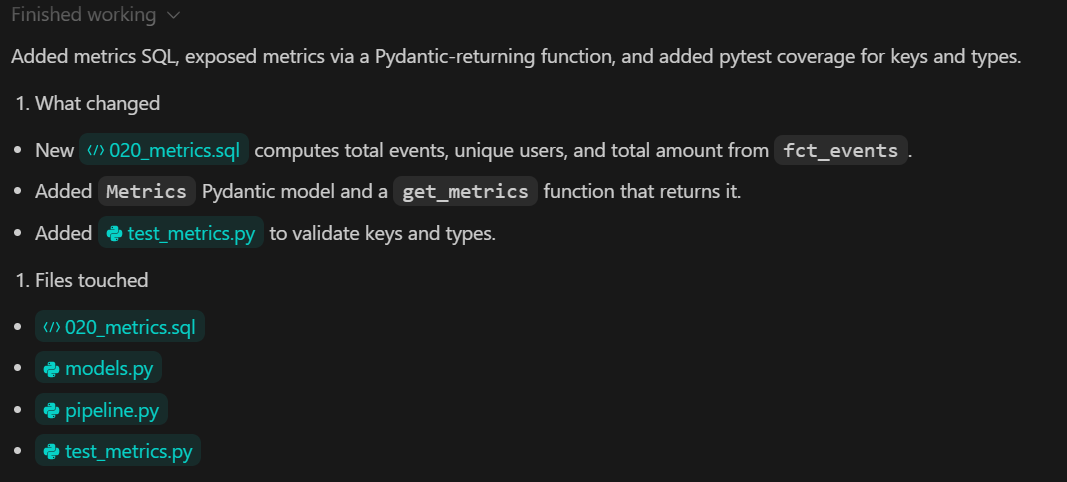
Bu adımda, dönüştürülmüş verilerden analitik çıktıları hesaplamakla sorumlu metrikler katmanını ekliyoruz. Metrikler DuckDB SQL kullanılarak türetilir ve sistemin geri kalanına türlenmiş bir Python arayüzü aracılığıyla sunulur.
TASK 4 (METRICS):
Create backend/sql/020_metrics.sql.
Expose metrics via a Python function returning a Pydantic model.

Add pytest validating:
- keys exist
- types correct

Commit.
Bu adımın sağladıkları:
Bu adımda, Streamlit kullanarak yerel analitik panoyu oluşturuyoruz. Pano yalnızca görselleştirmeden sorumludur. Metrik hesaplamaz veya veri dönüştürmez. Tüm değerler, bir önceki adımda oluşturulan metrikler katmanından okunur.
TASK 5 (STREAMLIT UI):
Build app/app.py:
- 3 KPI cards
- line chart for daily_count
- UI calls backend metrics function

Add a minimal smoke test.
Commit.
Görev tamamlandıktan sonra, Codex DuckDB veritabanını yeniden oluşturma ve tam veri hattını çalıştırma talimatlarını sağlar. Bu adımda, daha büyük bir veri kümesiyle doldurulmuş yeni bir veritabanı kullanıyoruz.
python backend\ingest.py --csv data\sample.csv
python backend\pipeline.py
İçe aktarma çalıştırıldıktan sonra, çıktı DuckDB’ye yüklenen ham olay sayısını doğrular:
raw_events row count: 3738Hat tamamlandıktan sonra Streamlit uygulamasını başlatın:
streamlit run app\app.pyPanoya, tarayıcınızda http://localhost:8501 adresini açarak erişebilirsiniz.
You can now view your Streamlit app in your browser.

  Local URL: http://localhost:8501
  Network URL: http://192.168.18.10:8501
Pano ilk yüklendiğinde bir hata görünürse, bu erken yinelemelerde beklenir. Hata iletisini kopyalayın ve GPT-5.2 Codex’e iletin.
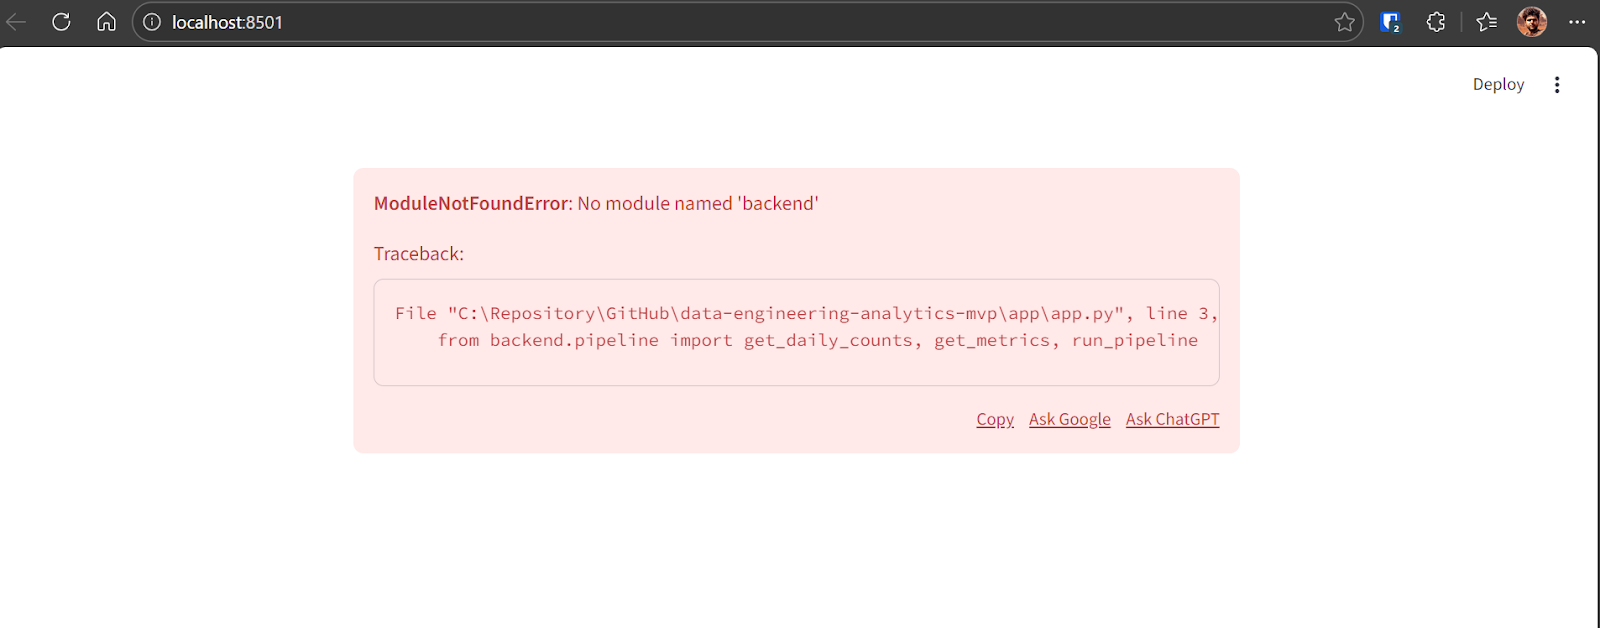
Codex sorunu tespit edip gerekli düzeltmeyi uygulayacaktır. Düzeltmeden sonra uygulama başarıyla çalışır ve şunları gösterir:
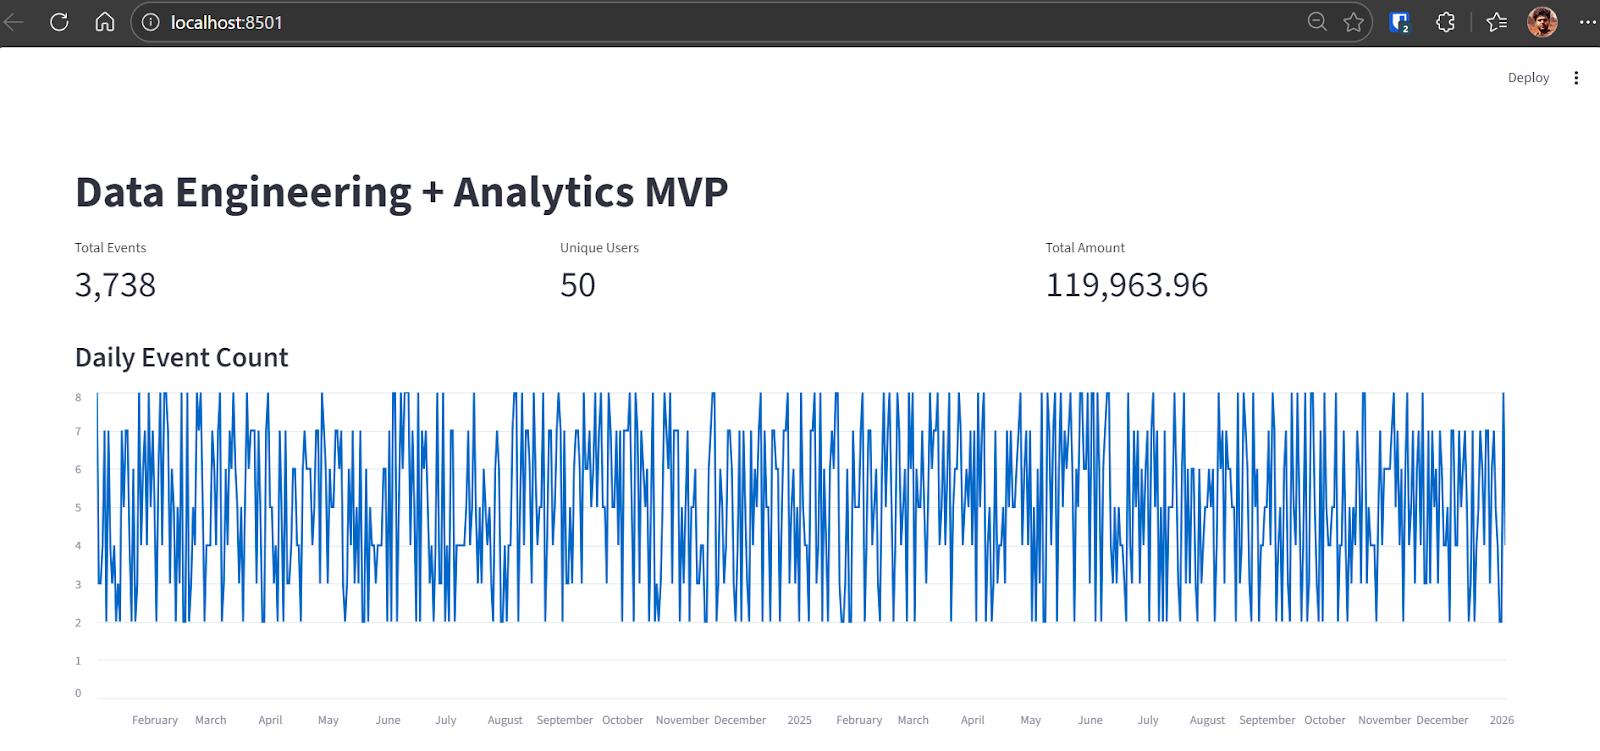
Bu noktada, uçtan uca MVP hattı tamamlanmış ve tamamen işlevseldir.
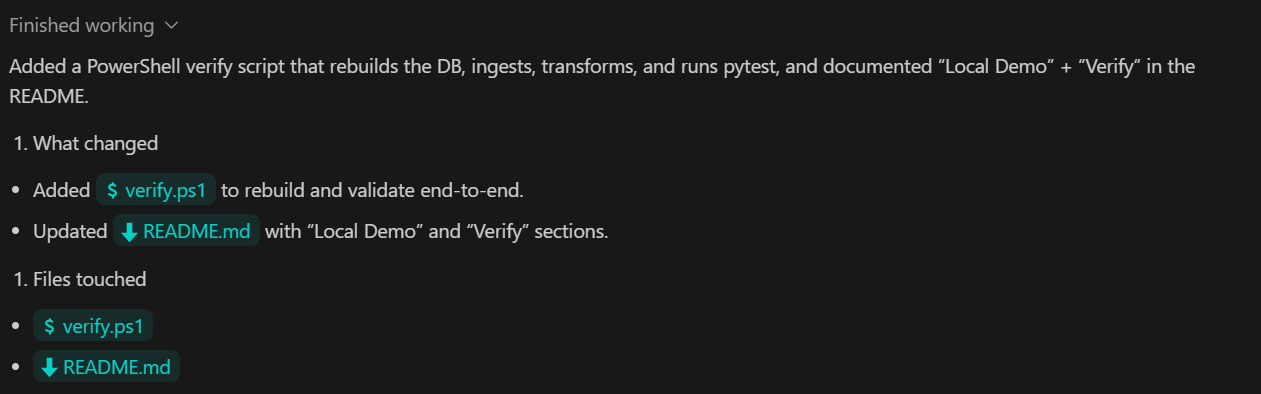
Son adımda doğrulama ve güvenilirliğe odaklanıyoruz. Amaç, içe aktarmadan metriklere ve testlere kadar tüm hattın doğru çalıştığını kanıtlayan tek bir komut sağlamaktır.
TASK 6 (VERIFY):
Add a verify command that:
- rebuilds DB from scratch
- ingests sample.csv
- runs transforms
- runs pytest

Document as "Local Demo" and "Verify" in README.
Commit.
Bu adımın sağladıkları:
Codex’ten README’yi güncellemesini, tüm değişiklikleri işlemeye ve GitHub uzak deposuna göndermesini istedik.
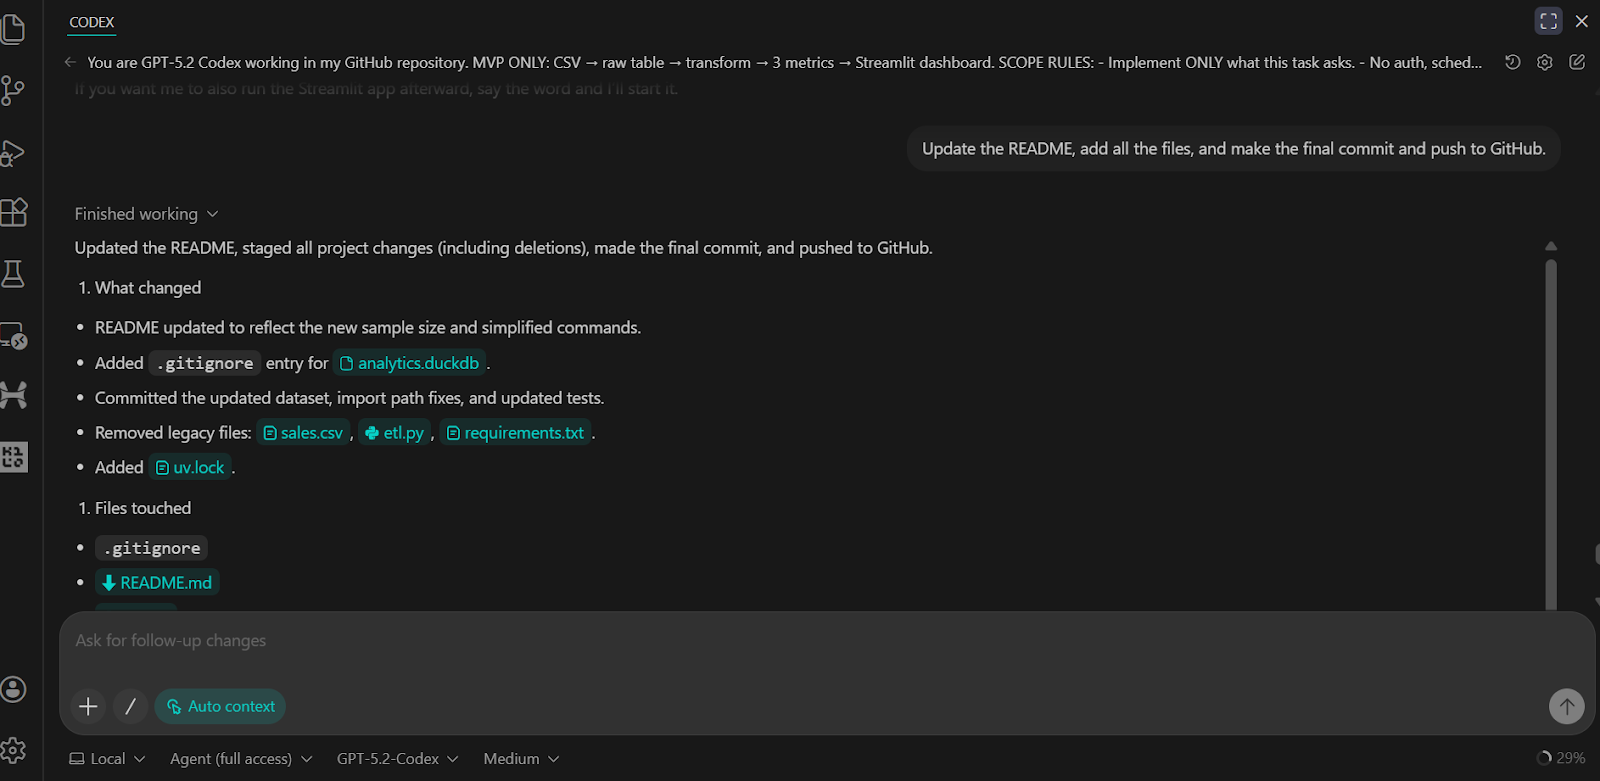
Ortaya çıkan sonuç; tüm betikleri, testleri, arka uç mantığını ve projeyi çalıştırma ve doğrulama talimatlarını içeren eksiksiz ve iyi yapılandırılmış bir GitHub deposudur.
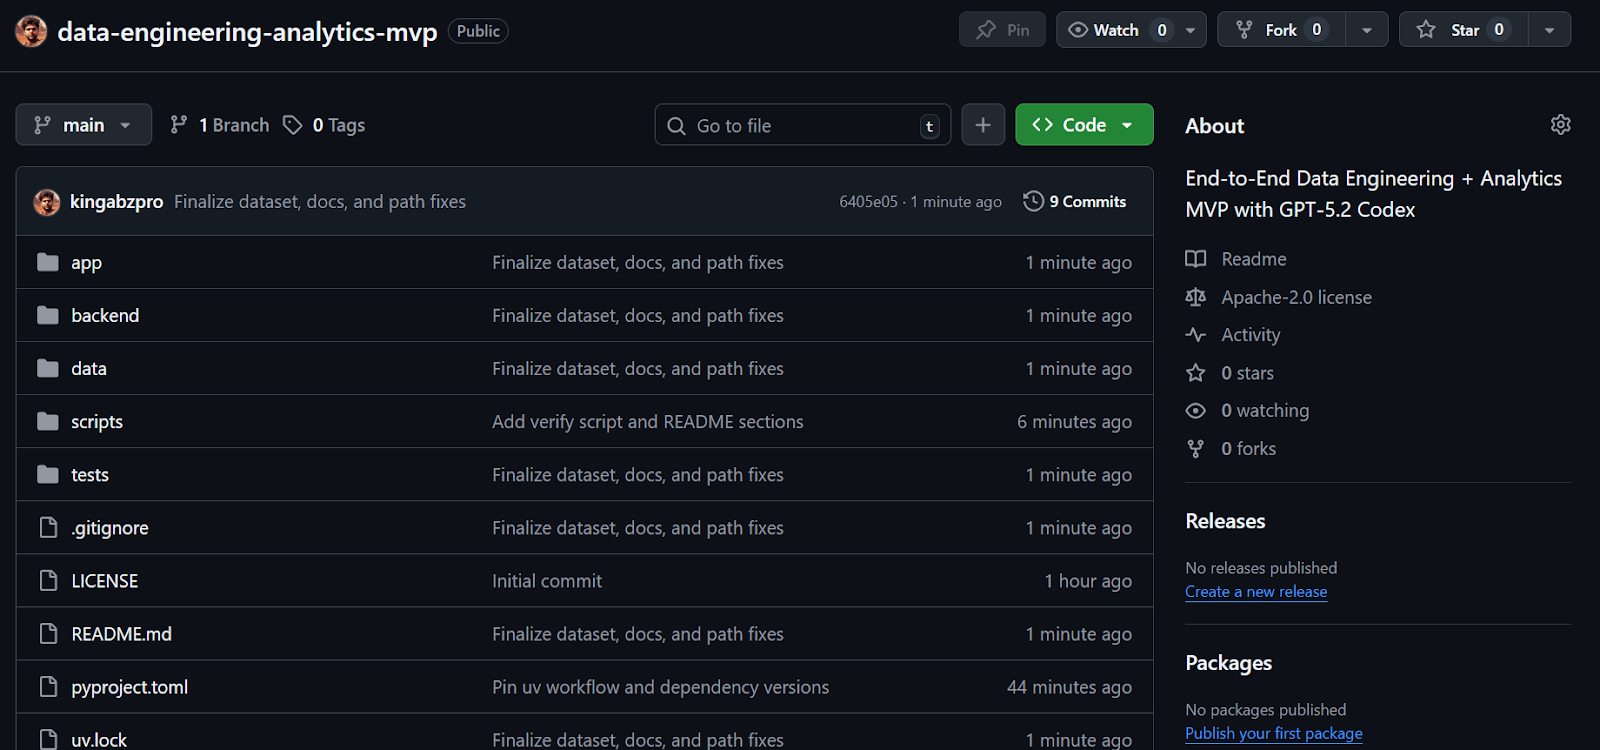
Kaynak: kingabzpro/data-engineering-analytics-mvp
Geçmişte zaman zaman CLI ve VSCode üzerinden Codex kullandım, ancak GPT-5.2 Codex ile gelen son güncellemeler gözle görülür bir fark yarattı. Model, bütünlüklü sistemler kurmada, sorunları ayıklamada ve MCP ile dahili araçlar gibi araçlarla çalışmada belirgin şekilde daha iyi. Ayrıca mevcut bir kod tabanını çok daha güçlü anlıyor; bu da yinelemeli geliştirmeyi çok daha verimli kılıyor.
Başından sonuna, bu MVP’nin tamamını iskeletlemek, hata ayıklamak ve uçtan uca çalıştırmak otuz dakikadan az sürdü. Codex, depo kurulumu, bağımlılık yönetimi, veri içe aktarma, SQL dönüşümleri, testler ve Streamlit panosunu çok az manuel müdahale ile halletti. Geliştirme döngüsü sıkı ve öngörülebilir hissettirdi; hızlı geliştirirken tam da istediğiniz şey budur.
Bu proje kasıtlı olarak bir MVP’dir. Üretime hazır hale gelmesi için ek yineleme ve sertleştirme gerekir. Bununla birlikte, çekirdek yapı gerçek veri mühendisliği sistemlerinin nasıl tasarlandığını yakından yansıtır; bu da üzerine inşa etmek için sağlam bir temel oluşturur.
Bu projeyi daha üretim odaklı bir veri platformuna doğru genişletmekle ilgileniyorsanız, aşağıdaki bileşenler doğal sonraki adımlardır; ancak kapsamı odaklı tutmak için burada bilerek hariç tutulmuştur:
Bu araçlar üretim sistemlerinde yaygındır; ancak burada hariç tutulmaları, projeyi basit, yerel ve kolay anlaşılır kılarken gerçek dünya veri mühendisliği kalıplarını yansıtmaya devam eder.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



