
Corso
Lavorare con l'API di OpenAI
3 ore
184.8K
In questo tutorial impareremo a creare una pipeline di data engineering end-to-end usando GPT-5.2 Codex tramite l’estensione per VSCode. Invece di chiedere al modello di costruire tutto in una volta, costruiremo l’MVP strato dopo strato, guidando l’agente passo passo attraverso progettazione, implementazione e test.
Questo approccio riflette come GPT-5.2 Codex funziona meglio nella pratica e rispecchia i flussi di lavoro reali del data engineering. Assicurati di consultare anche la nostra guida sulla versione più recente del modello, GPT-5.3 Codex, e il nuovo modello di ragionamento di OpenAI, GPT-5.4.
Se vuoi saperne di più su come lavorare con l’ecosistema OpenAI, ti consiglio di dare un’occhiata al corso Working with the OpenAI API.
GPT 5.2 Codex è la ultima generazione dei modelli di agentic coding di OpenAI, pensata per flussi di lavoro di ingegneria del software reali. Si basa su recenti miglioramenti nella comprensione di contesti lunghi, grandi refactoring e migrazioni, uso affidabile degli strumenti e un solido supporto nativo per Windows.
Questi miglioramenti lo rendono particolarmente efficace per lavori di sviluppo end-to-end e di lunga durata all’interno di IDE come VSCode. Negli ultimi mesi, l’estensione OpenAI Codex VSCode è migliorata sensibilmente e ora compete direttamente con Claude Code per lo sviluppo complesso guidato da agenti.
Inizieremo creando un nuovo repository GitHub per il nostro MVP di data engineering.
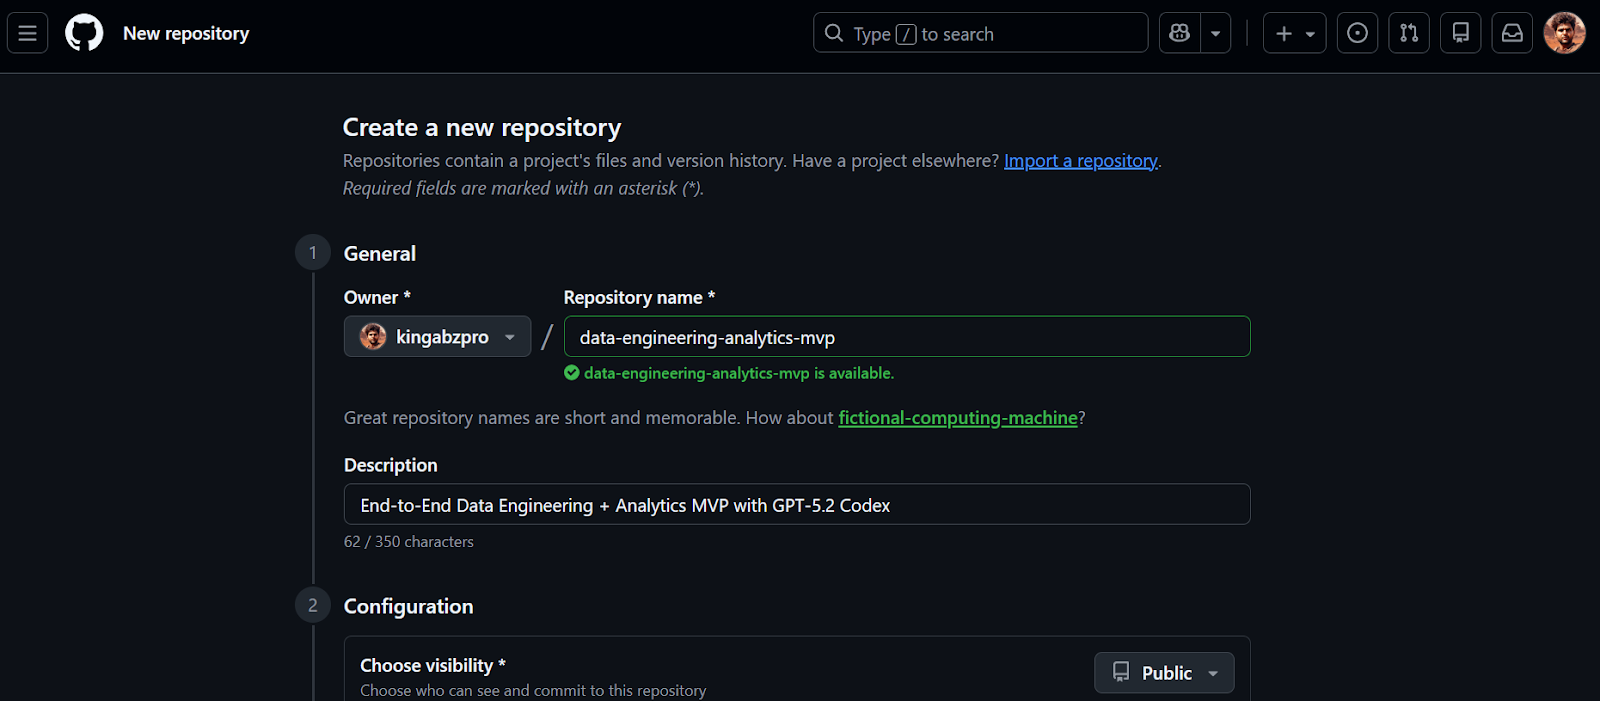
Una volta creato il repository, copia l’URL del repository. Useremo questo URL nel prossimo passaggio per clonare il progetto in locale.
Prima di iniziare, assicurati di avere installato Visual Studio Code e un account ChatGPT Plus attivo. I piani Free e Go non forniscono accesso ai modelli Codex nell’estensione VSCode.
1. Clona il repository usando l’URL che hai copiato in precedenza.
2. Entra nella directory del repository e avvia VSCode.
git clone https://github.com/kingabzpro/data-engineering-analytics-mvp.git
cd data-engineering-analytics-mvp
code .
3. Vai su Estensioni (Ctrl + Shift + X), cerca OpenAI Codex e installala. Dovrebbe richiedere solo pochi secondi.
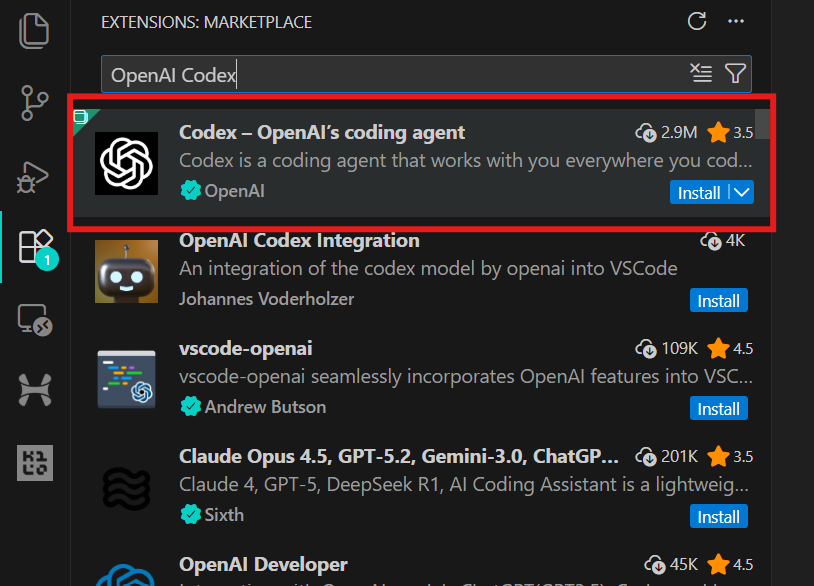
4. Fai clic sull’icona OpenAI nel pannello di sinistra per avviare l’estensione Codex. Ti verrà chiesto di accedere usando il tuo account ChatGPT o un account API. Seleziona l’account ChatGPT: verrai reindirizzato al browser per approvare l’accesso. Una volta approvato, torna in VSCode e Codex sarà pronto all’uso.
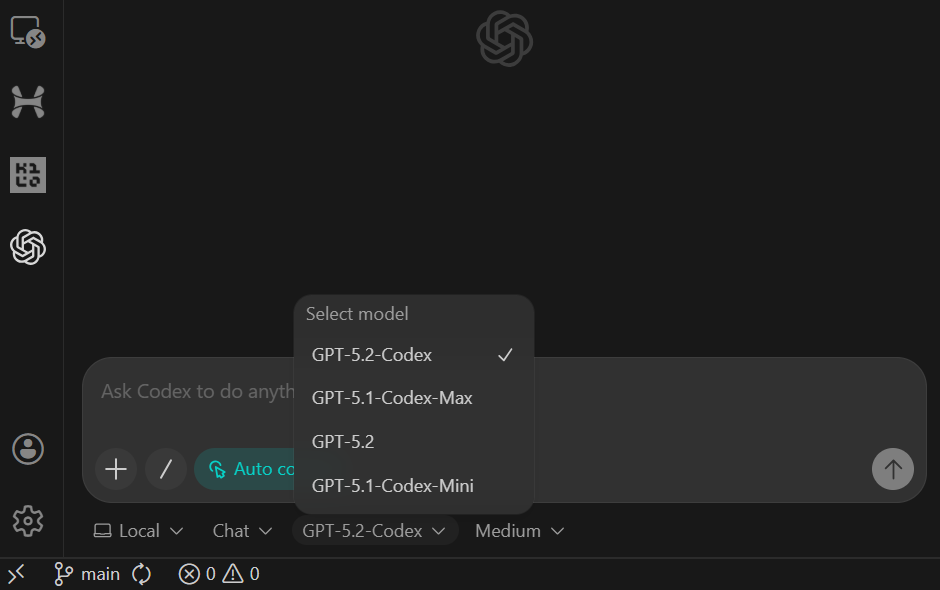
Questo progetto è volutamente circoscritto come Minimum Viable Product (MVP). L’obiettivo non è costruire una piattaforma dati di livello production, ma creare una sezione completa end-to-end di data engineering che mostri come sono strutturati i sistemi di analytics reali.
In questo MVP, costruiamo una pipeline analitica semplice ma credibile che:
raw_events)fct_events)Il flusso completo è questo:
CSV file
  ↓
raw_events        (raw ingestion, 1:1 with source)
  ↓
fct_events        (typed, deduplicated, transformed)
  ↓
metrics           (daily count, 7-day rolling avg, top category)
  ↓
Streamlit UI (local dashboard)In questo passaggio, usiamo GPT-5.2 Codex per generare la struttura iniziale del progetto. L’obiettivo non è ancora costruire funzionalità, ma creare una base pulita ed eseguibile che estenderemo passo dopo passo.
Per mantenere Codex focalizzato, usiamo un piccolo blocco di controllo chiamato Codex Harness. Questo harness viene incollato all’inizio di ogni prompt e fa sì che Codex rimanga entro lo scope dell’MVP, produca output coerenti e crei commit puliti e facilmente revisionabili.
Codex Harness (incolla in ogni task):
You are GPT-5.2 Codex working in my GitHub repository.

MVP ONLY:
CSV → raw table → transform → 3 metrics → Streamlit dashboard.

SCOPE RULES:
- Implement ONLY what this task asks.
- No auth, schedulers, cloud services, or extra pages.

OUTPUT:
- Be descriptive.
- After changes include:
  1) What changed
  2) Files touched
  3) How to run locally
  4) Quick verification step
- Commit after each major step with a clear message.
Prima di scrivere qualsiasi codice, Codex viene istruito esplicitamente a usare la ricerca web per verificare le versioni più recenti e compatibili con Python 3.11 di tutte le dipendenze. Questo evita di installare pacchetti obsoleti o incompatibili.
IMPORTANT: USE WEB SEARCH FIRST
TASK 1 (SCAFFOLD):
Use Python 3.11 + uv + DuckDB + Streamlit + Pydantic + pytest.

Create repo structure:
- backend/
  - db.py
  - ingest.py
  - pipeline.py
  - models.py
  - sql/
- app/
  - app.py
- data/
  - sample.csv
- tests/

Add:
1) data/sample.csv (~50 rows) with columns:
   event_time, user_id, event_name, category, amount
2) DuckDB schema for raw_events
3) a command to ingest sample.csv and print row count
4) pyproject.toml for uv
5) README with exact local run steps

Stop after scaffolding. Commit.
Il task di scaffolding crea:
sample.csv raw_eventspyproject.toml funzionante e un READMEDopo aver incollato il prompt, passa il modello ad Agent (Full Access) e conferma che GPT-5.2 Codex sia selezionato (è l’impostazione predefinita).
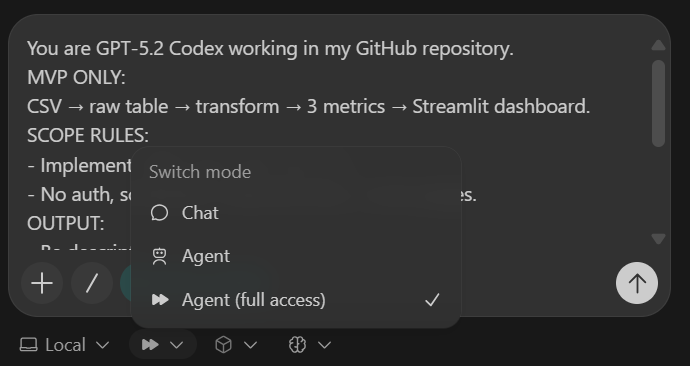
Una volta completato il task, vedrai che tutte le cartelle e i file sono stati creati automaticamente.
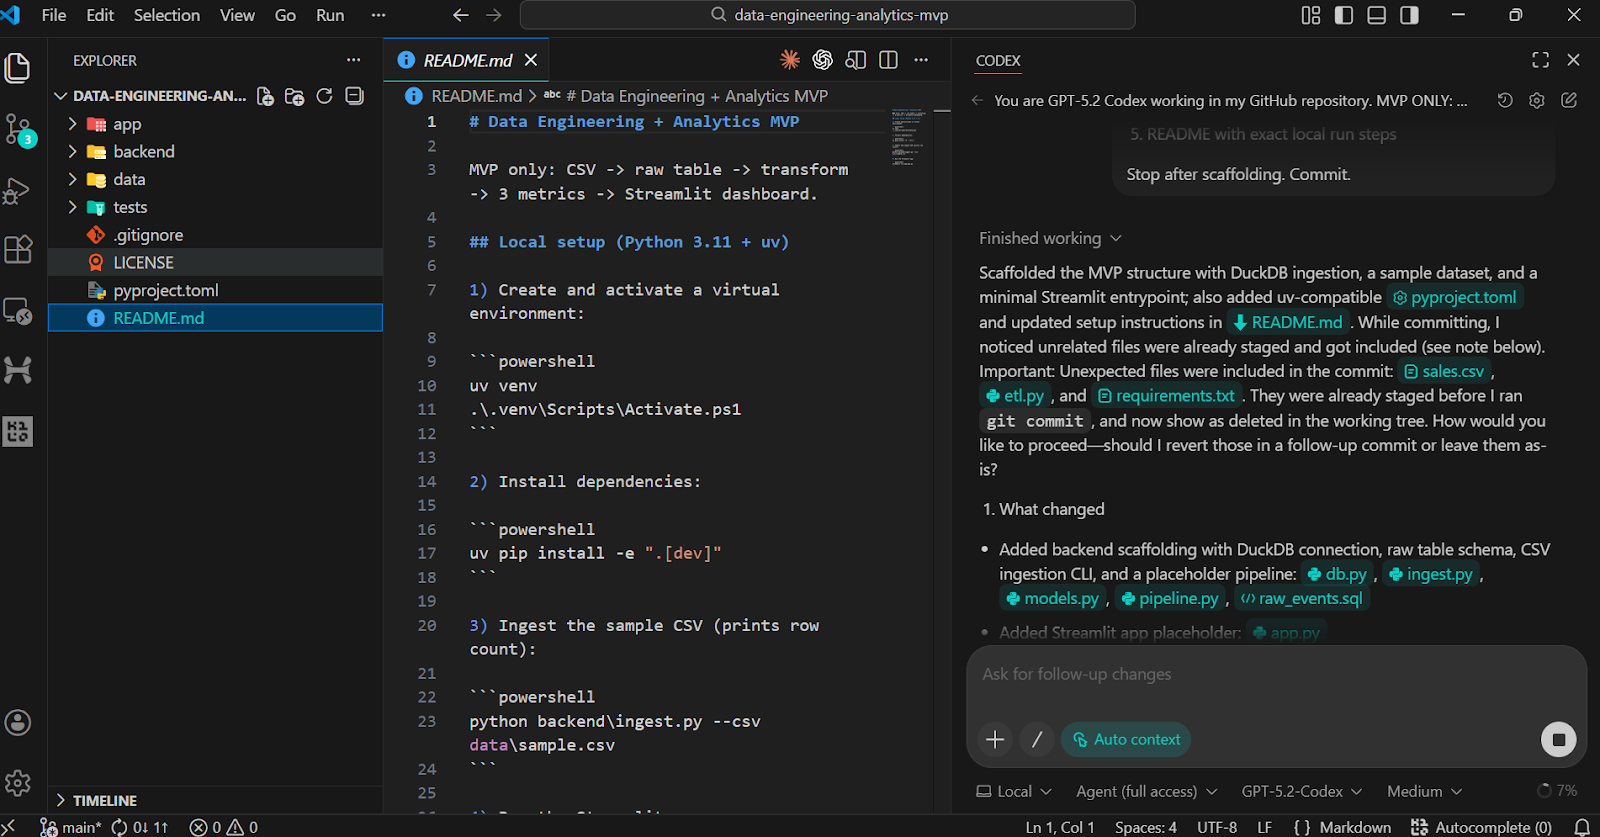
Per validare lo scaffolding, chiedi a Codex di eseguire localmente i passaggi di installazione e verifica.
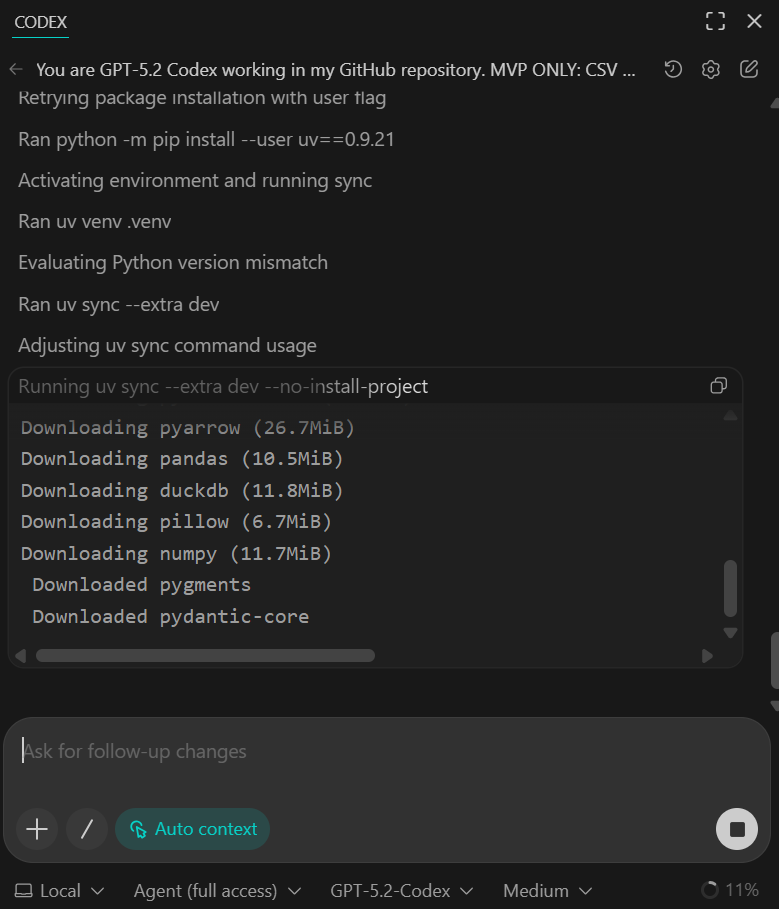
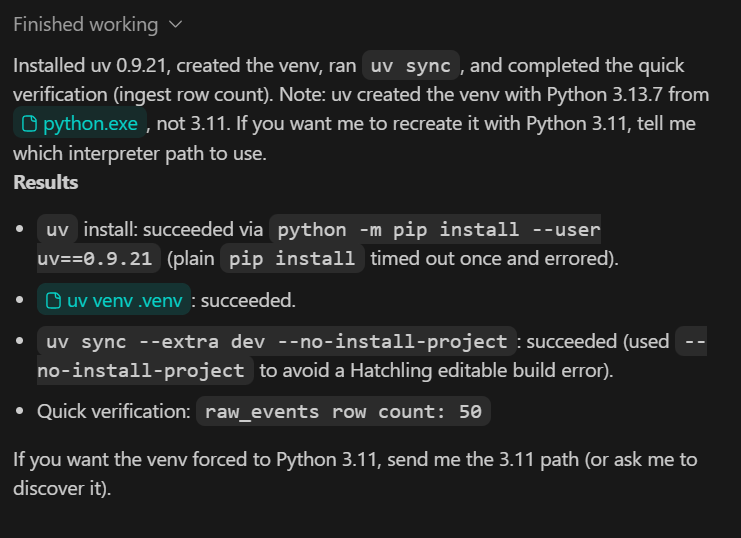
Dovresti vedere tutte le dipendenze installate correttamente e lo script di verifica rapida che conferma che 50 righe sono state acquisite dal dataset di esempio.
A questo stadio, i dati di esempio sono volutamente ridotti. Nei passaggi successivi li sostituiremo con un dataset più ampio e realistico.
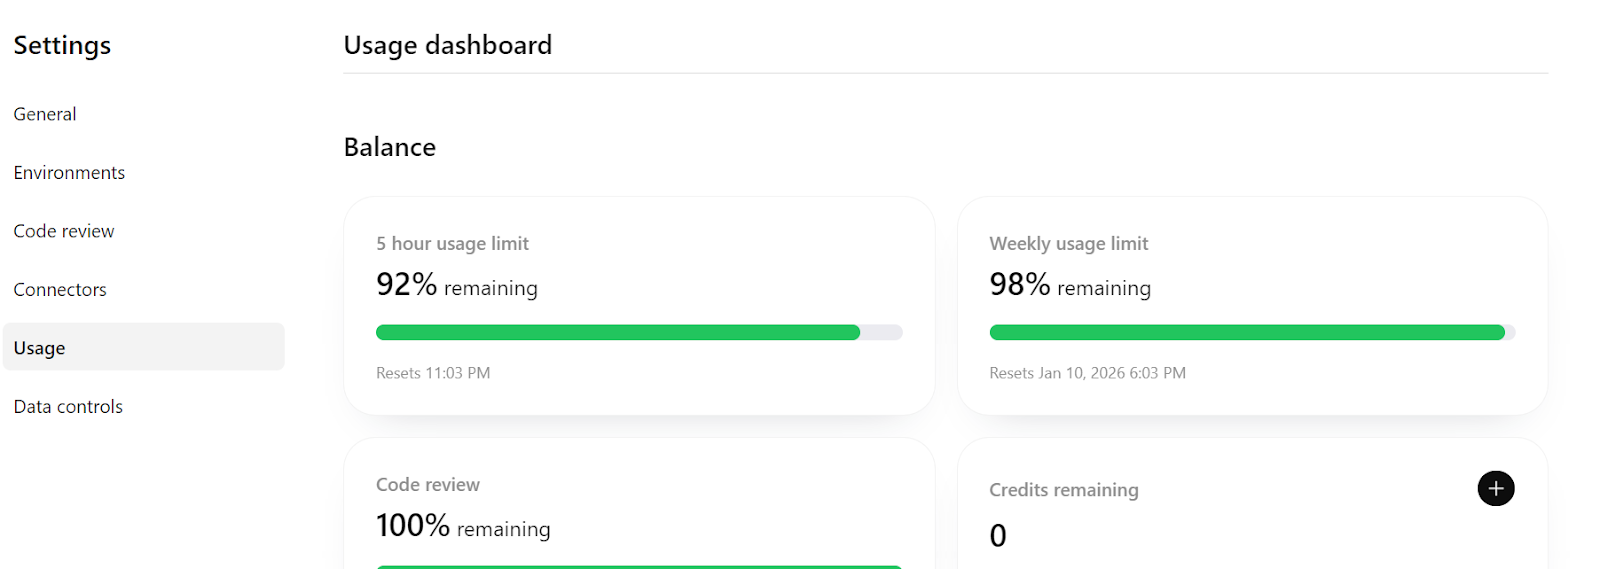
Infine, se controlli https://chatgpt.com/codex/settings/usage, noterai che la maggior parte della tua quota di utilizzo è ancora disponibile, il che significa che puoi continuare a costruire e iterare comodamente su questo progetto, estendendolo anche verso una pipeline più vicina alla produzione se necessario.
In questo passaggio, ci assicuriamo che il processo di ingestion sia idempotente, cioè che possa essere rieseguito in sicurezza senza creare duplicati. Questo è un requisito fondamentale nel data engineering, poiché i job di ingestion spesso devono essere riprovati o rieseguiti.
TASK 2 (IDEMPOTENT INGEST):
Make CSV ingestion idempotent.
- Rerunning ingest must not duplicate rows
- Validate required columns
- Validate event_time parseable and amount numeric

Add pytest:
- ingest twice → row count unchanged

Update README verification section.
Commit.
Cosa ottieni con questo passaggio:
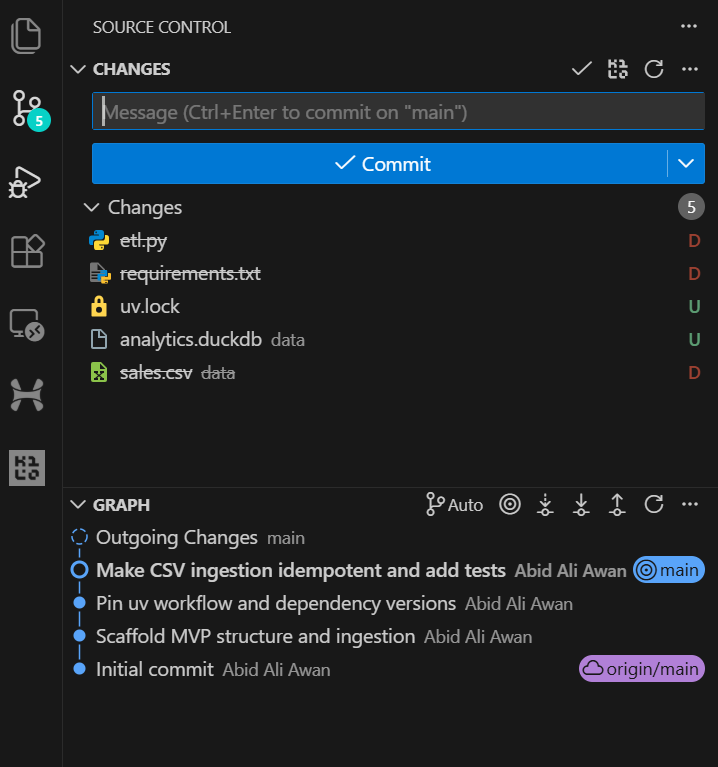
Dopo il completamento del task, puoi rivedere la cronologia Git in VSCode e vedere che l’agente IA esegue automaticamente i commit dopo l’aggiornamento principale. Questo fornisce una storia di sviluppo pulita e tracciabile.
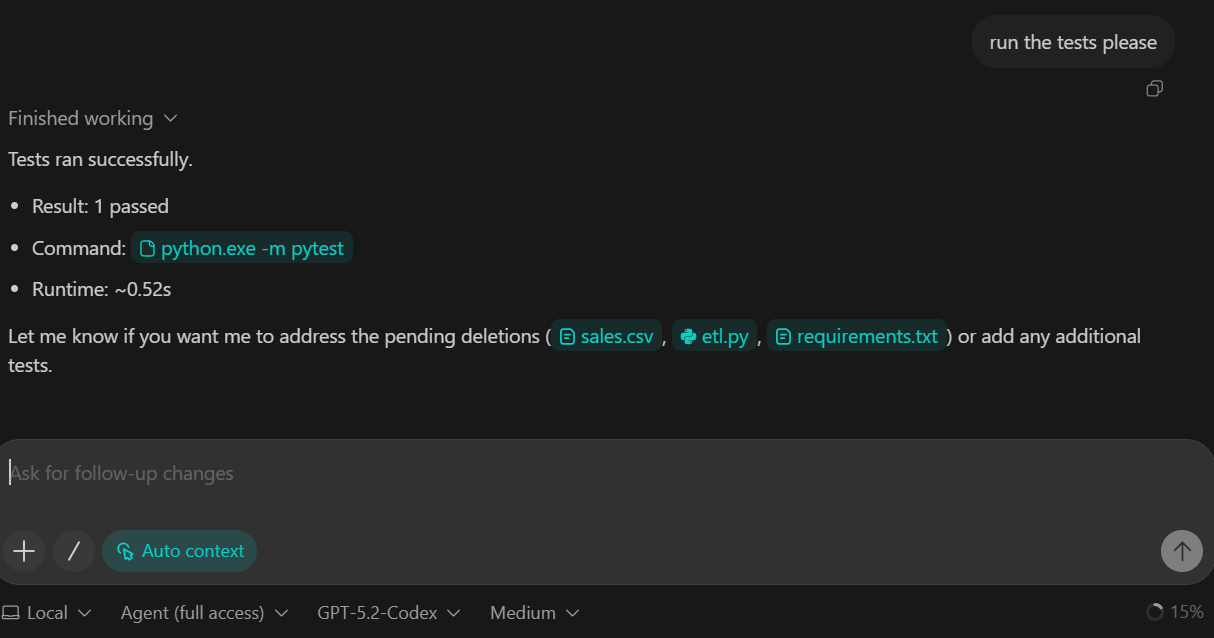
Abbiamo chiesto a GPT-5.2 Codex di eseguire la suite di test come parte di questo task. Di conseguenza, i test sono stati eseguiti con successo e tutti i controlli sono passati.
In questo passaggio introduciamo il livello di trasformazione della pipeline. Le trasformazioni sono implementate usando DuckDB SQL, che ci consente di convertire i dati grezzi acquisiti in una tabella fact pulita e pronta per l’analisi.
TASK 3 (TRANSFORM SQL):
Create backend/sql/010_fct_events.sql:
- typed columns
- deterministic dedupe

Execute transform from backend/pipeline.py.
Add sanity checks to README:
- raw_events count
- fct_events count

Commit.
Cosa ottieni con questo passaggio:
raw_events in fct_events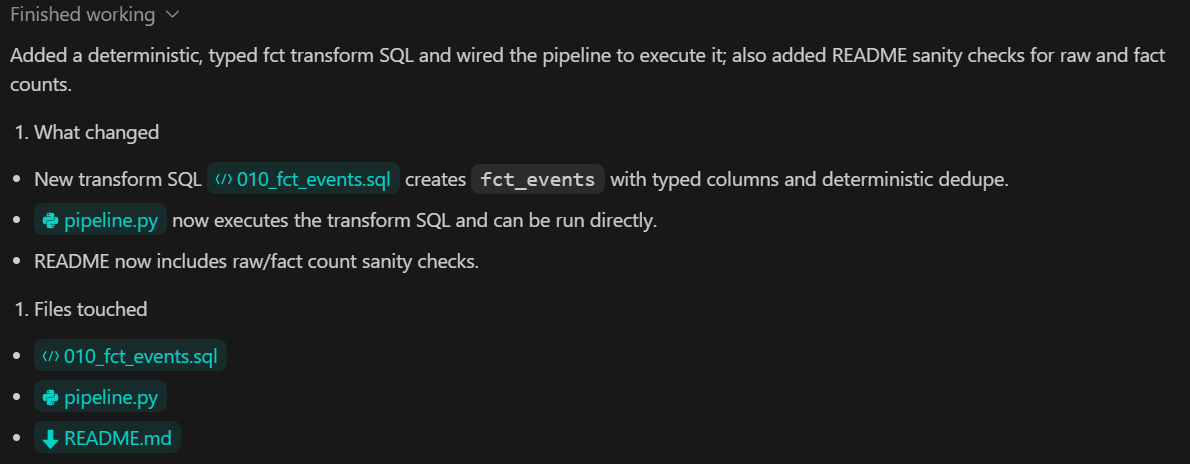
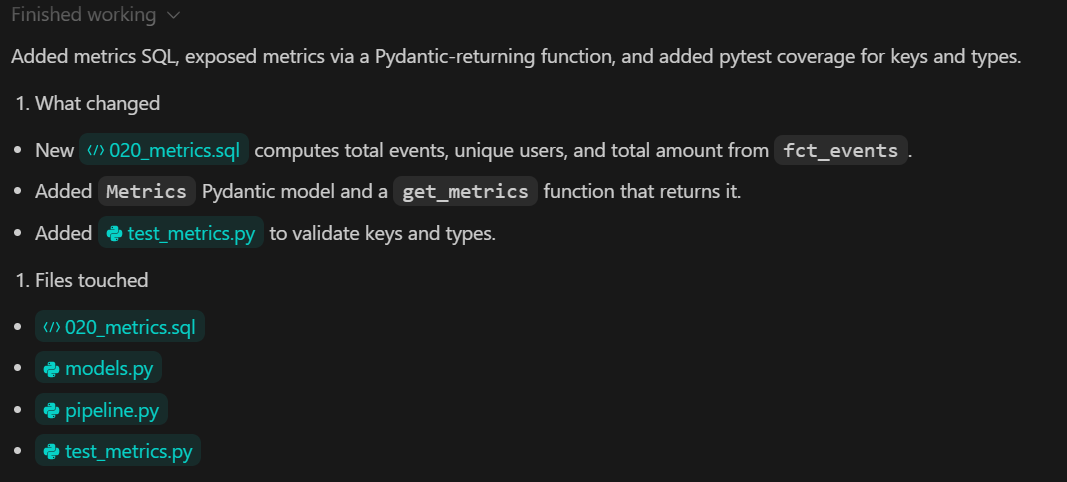
In questo passaggio aggiungiamo il livello delle metriche, responsabile del calcolo degli output analitici a partire dai dati trasformati. Le metriche sono derivate usando DuckDB SQL ed esposte al resto del sistema tramite un’interfaccia Python tipizzata.
TASK 4 (METRICS):
Create backend/sql/020_metrics.sql.
Expose metrics via a Python function returning a Pydantic model.

Add pytest validating:
- keys exist
- types correct

Commit.
Cosa ottieni con questo passaggio:
In questo passaggio, costruiamo la dashboard analitica locale usando Streamlit. La dashboard si occupa solo della visualizzazione. Non calcola metriche né trasforma dati. Tutti i valori sono letti dal livello delle metriche creato nel passaggio precedente.
TASK 5 (STREAMLIT UI):
Build app/app.py:
- 3 KPI cards
- line chart for daily_count
- UI calls backend metrics function

Add a minimal smoke test.
Commit.
Dopo il completamento del task, Codex fornisce le istruzioni per ricostruire il database DuckDB ed eseguire l’intera pipeline dati. Per questo passaggio, usiamo un nuovo database popolato con un dataset più ampio.
python backend\ingest.py --csv data\sample.csv
python backend\pipeline.py
Dopo l’ingestion, l’output conferma il numero di eventi grezzi caricati in DuckDB:
raw_events row count: 3738Una volta completata la pipeline, avvia l’applicazione Streamlit:
streamlit run app\app.pyPuoi accedere alla dashboard aprendo l’URL http://localhost:8501 nel browser.
You can now view your Streamlit app in your browser.

  Local URL: http://localhost:8501
  Network URL: http://192.168.18.10:8501
Se compare un errore al primo caricamento della dashboard, è normale nelle prime iterazioni. Copia il messaggio d’errore e fornisci l’informazione a GPT-5.2 Codex.
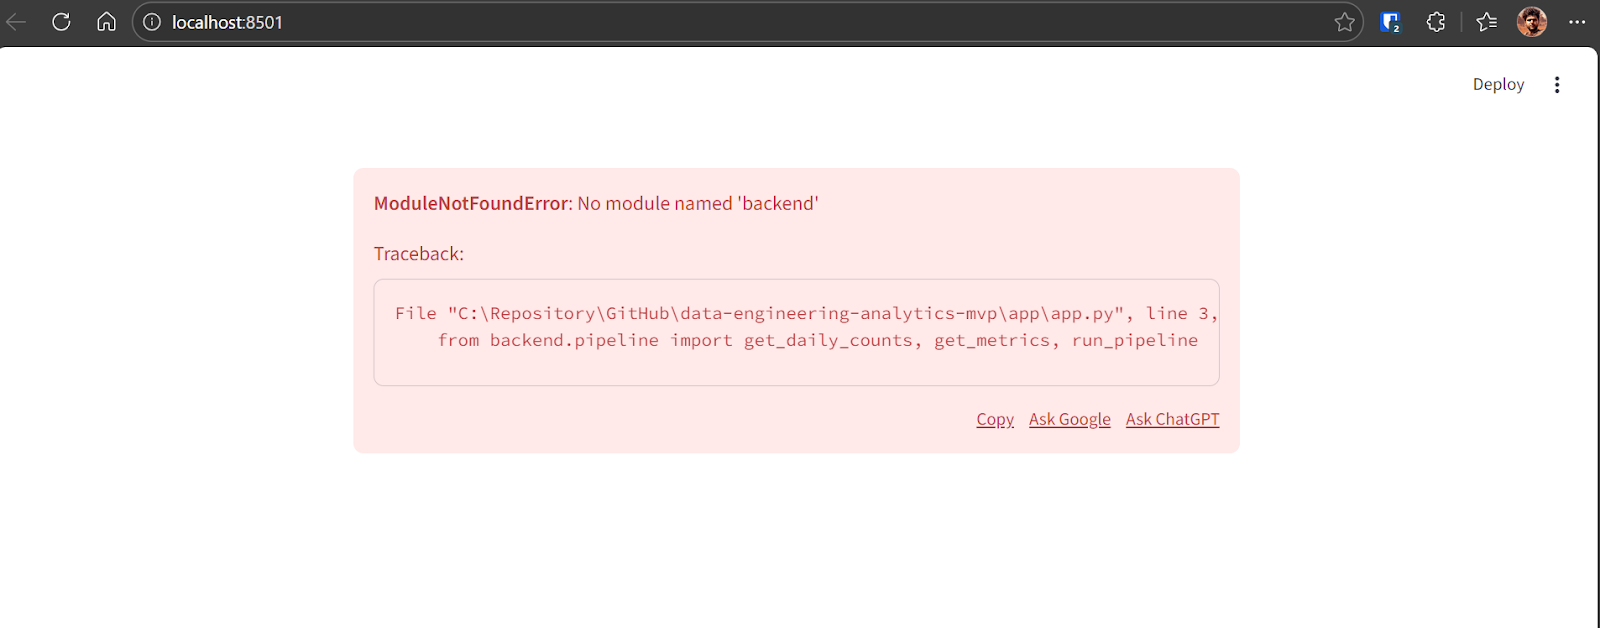
Codex identificherà il problema e applicherà la correzione necessaria. Dopo la correzione, l’applicazione viene eseguita correttamente e mostra:
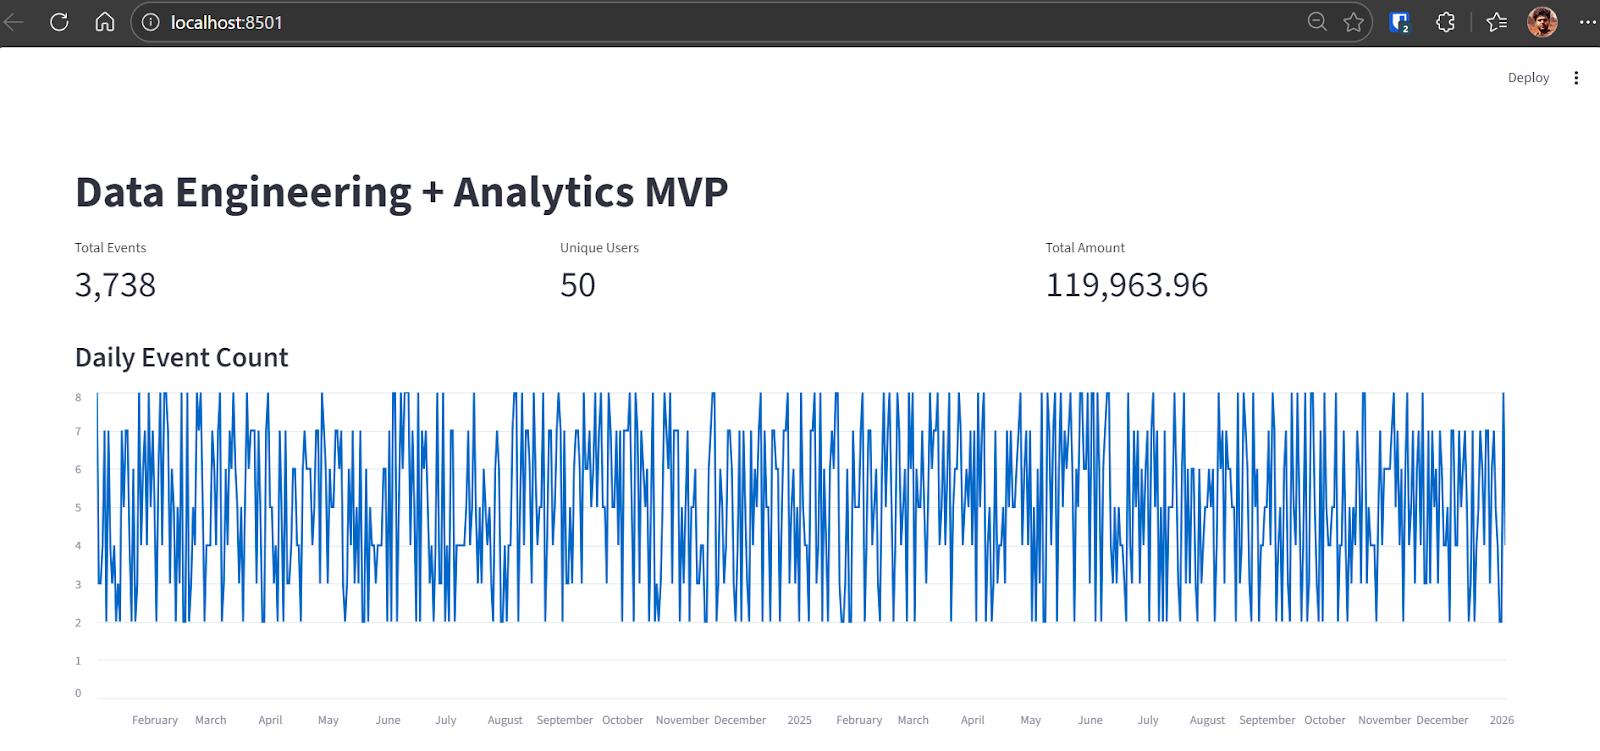
A questo punto, la pipeline MVP end-to-end è completa e pienamente funzionante.
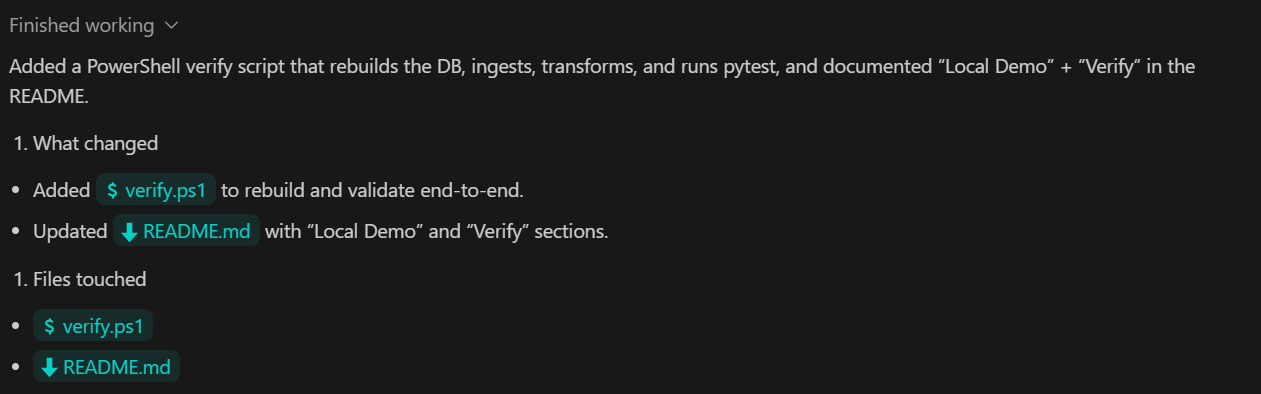
In questo passaggio finale ci concentriamo su verifica e affidabilità. L’obiettivo è fornire un singolo comando che dimostri che l’intera pipeline funziona correttamente dall’ingestion alle metriche e ai test.
TASK 6 (VERIFY):
Add a verify command that:
- rebuilds DB from scratch
- ingests sample.csv
- runs transforms
- runs pytest

Document as "Local Demo" and "Verify" in README.
Commit.
Cosa ottieni con questo passaggio:
Abbiamo chiesto a Codex di aggiornare il README, fare il commit di tutte le modifiche e pusharle sul repository remoto GitHub.
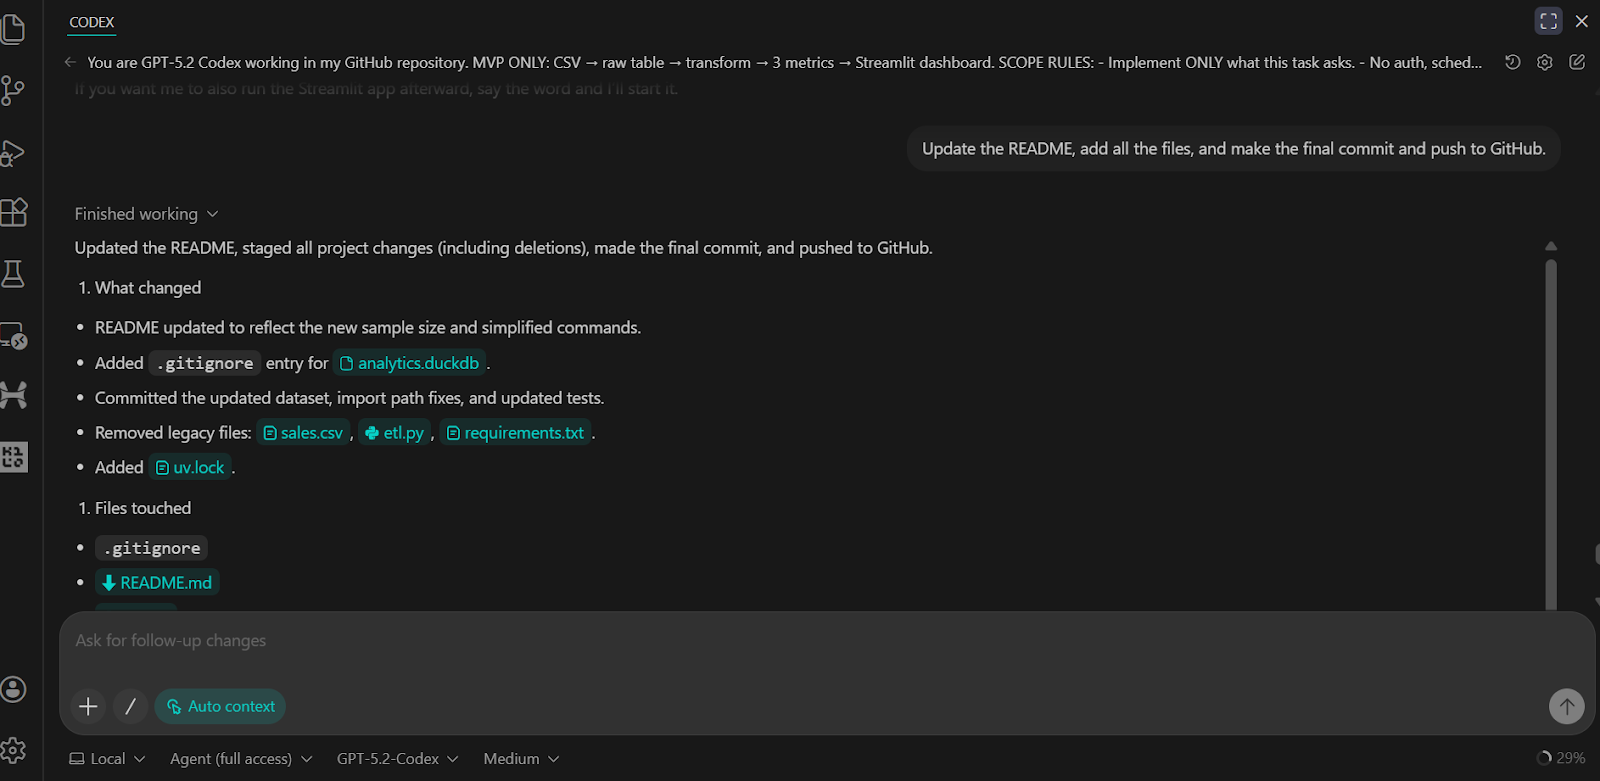
Il risultato è un repository GitHub completo e ben strutturato che include tutti gli script, i test, la logica backend e istruzioni chiare per eseguire e verificare il progetto.
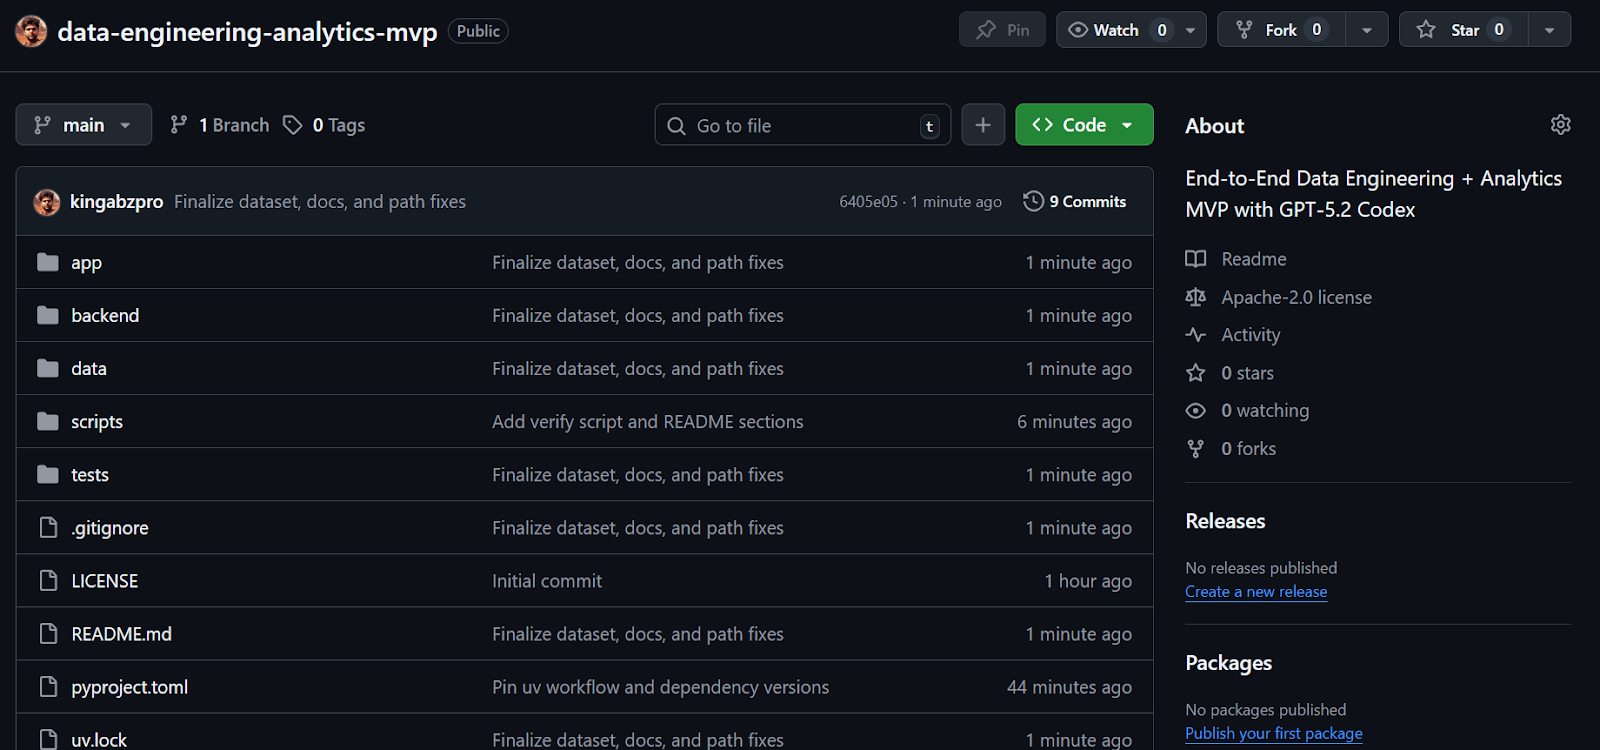
Fonte: kingabzpro/data-engineering-analytics-mvp
In passato ho usato Codex saltuariamente tramite CLI e in VSCode, ma gli aggiornamenti recenti con GPT-5.2 Codex hanno fatto davvero la differenza. Il modello è nettamente migliore nel costruire sistemi completi, nel fare debugging e nel lavorare con strumenti come MCP e tool interni. Mostra anche una comprensione molto più solida di una codebase esistente, il che rende lo sviluppo iterativo molto più efficiente.
Dall’inizio alla fine, mi sono bastati meno di trenta minuti per creare lo scheletro di questo MVP, fare il debug ed eseguirlo end-to-end. Codex ha gestito setup del repository, gestione delle dipendenze, ingestion dei dati, trasformazioni SQL, test e la dashboard Streamlit con pochissima intervento manuale. Il ciclo di sviluppo è stato serrato e prevedibile, esattamente ciò che serve quando si costruisce in velocità.
Questo progetto è intenzionalmente un MVP. Richiederebbe ulteriori iterazioni e indurimento per essere pronto alla produzione. Detto questo, la struttura di base rispecchia da vicino il modo in cui sono progettati i sistemi di data engineering reali, il che lo rende una solida base su cui costruire.
Se sei interessato a estendere questo progetto verso una piattaforma dati più orientata alla produzione, i seguenti componenti sono i prossimi passi naturali ma sono stati volutamente esclusi qui per mantenere lo scope focalizzato:
Questi strumenti sono comuni nei sistemi di produzione, ma escluderli qui mantiene il progetto semplice, locale e facile da comprendere, pur rispecchiando i pattern reali del data engineering.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



