
Kursus
Sistem Multi-Agen dengan LangGraph
2 Hr 45 Min
8.6K
Beri satu tugas pada agen, dan hasilnya baik-baik saja. Beri tiga, dan lihat apa yang terjadi di serah terima kedua: ia lupa apa yang ditemukannya di langkah pertama, menilai drafnya sendiri dengan murah hati, dan mengumumkan sukses saat keluarannya masih belum selesai.
Perdebatan soal pola itu memuncak pertengahan Juli 2026, ketika "graph engineering" menjadi perbincangan di X (sebelumnya Twitter) dan linimasa langsung terbelah antara yang mengumumkan akhir dari agent loop dan yang menyebut istilah itu sekadar pengisi konten pabrik tulisan.
Pendapat saya: label graph engineering itu opsional, tapi eskalasi yang mendasarinya tidak—yang akan saya coba jelaskan sebelum kita menulis kode apa pun.
Sebagian besar yang Anda bangun bulan ini seharusnya masih berupa satu loop, dan cara tercepat membuang waktu seminggu adalah menggambar diagram dengan 6 kotak untuk pekerjaan yang butuh 1.
Sebuah agent graph punya 3 bagian:
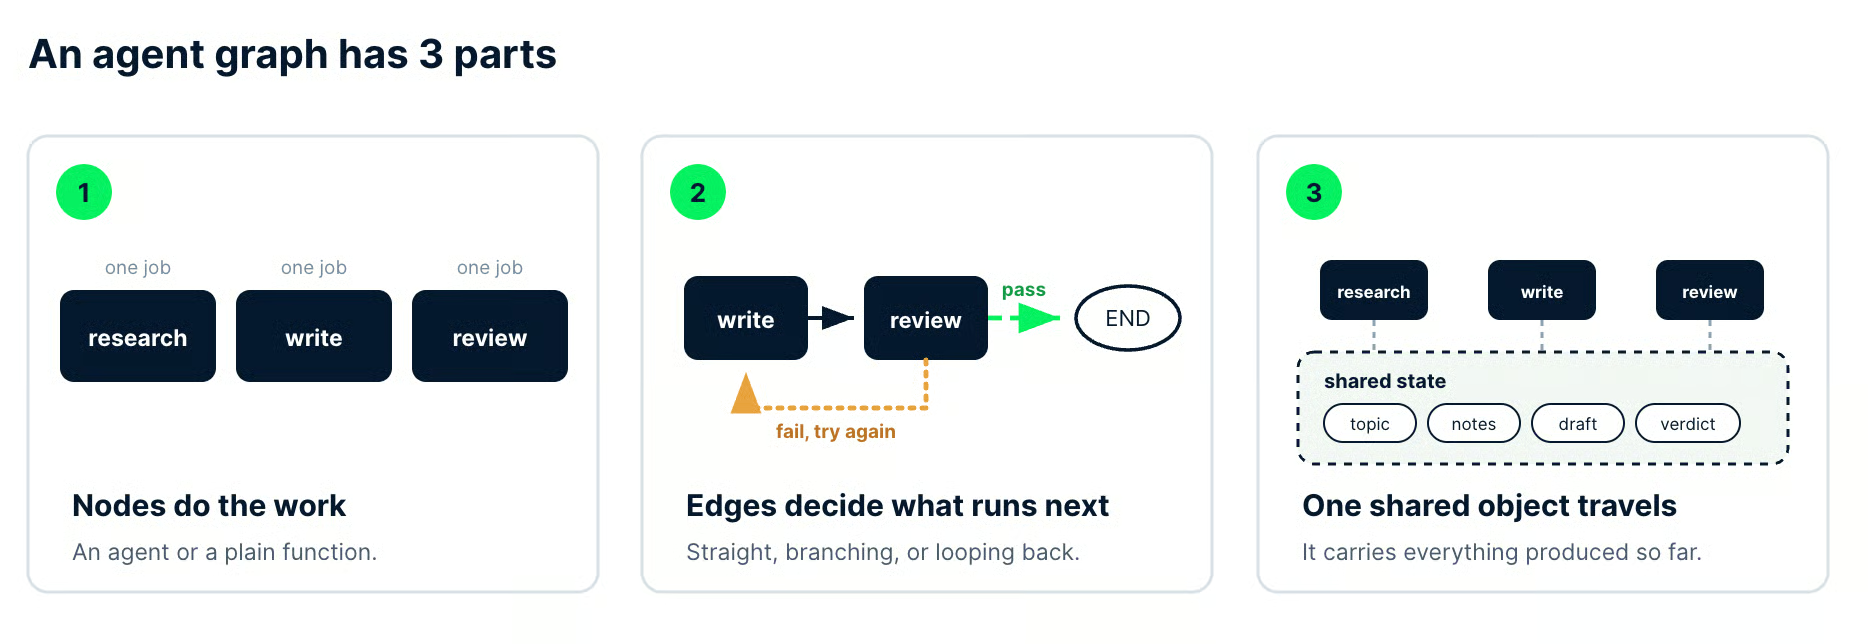
Gambar oleh Penulis. Tiga bagian yang ditampilkan pada pipeline yang kita bangun nanti: 3 node bernama, satu pass edge, satu retry edge, dan satu objek state yang mengumpulkan topic, notes, draft, dan verdict.
Mendeklarasikan ketiganya sejak awal, alih-alih membiarkan satu agen mengimprovisasi jalurnya sendiri, adalah yang dimaksud dengan graph engineering.
Tutorial ini membangun pipeline peneliti, penulis, dan peninjau yang berfungsi di Python dengan LangGraph, termasuk edge bersyarat yang mengembalikan draf gagal untuk direvisi.
Anda membutuhkan Python, pip, dan sedikit pemahaman tentang large language model (LLM) atau agen AI. Jika agen masih baru bagi Anda, kursus kami Introduction to AI Agents membahas konsep yang diasumsikan artikel ini, dan tutorial agen LangGraph kami membahas sisi praktiknya.
Graph engineering adalah praktik membuat alur kontrol sistem agen menjadi eksplisit di kode, bukan menyerahkannya pada penilaian model.
Anda mendeklarasikan pekerja spesialis mana yang ada, transisi apa antar mereka yang diizinkan, dan informasi apa yang dibawa sepanjang transisi itu.
Agen tetap bernalar bebas, tetapi bernalar di dalam satu node, bukan melintasi seluruh pekerjaan.
Kalimat terakhir itu adalah seluruh pembedanya.
Dalam loop, Anda menetapkan tujuan dan standar kualitas, dan agen memilih jalurnya sendiri untuk mencapainya. Dalam graph, Anda menetapkan jalur dan titik pemeriksaan, sehingga otonomi model dibatasi oleh struktur yang dapat Anda baca dalam diff.
Label itu ramai di X pada Juli 2026, tetapi tidak dimulai di sana. Itamar Friedman dari CodiumAI (kini Qodo) menggambarkan pergeseran "dari prompt engineering ke flow (/graph) engineering" pada Februari 2024, dan makalah AlphaCodium timnya memberikan angkanya.
Akurasi pass@5 GPT-4 pada himpunan validasi CodeContests naik dari 19% dengan satu prompt yang dirancang baik menjadi 44% dengan alur multi-tahap. Itu 5 percobaan per masalah pada kedua kondisi, bukan sekali jalan.
Yang terjadi pada Juli 2026 adalah penguatannya.
Pada 18 Juli, Peter Steinberger bertanya di X, "Apakah kita masih membicarakan loop atau sudah beralih ke graph?", seminggu setelah Mike Masson memposting tangga prompt, context, harness, loop, graph. Pertanyaan itu menarik 3,1 juta tayangan, dan frasa yang disebarkannya sudah digunakan.
Penolakan datang cepat. Harrison Chase, salah satu pendiri LangChain dari tim di balik LangGraph, bertanya apakah semuanya "pada dasarnya hanya langgraph?"
Dale Everett mendorong dari sisi lain, berargumen bahwa loop selalu merupakan graph dengan satu node, jadi euforia Juli itu menemukan kembali hal lama. Retrospektif LangChain sendiri, 3 Years of Graph Engineering with LangGraph, mengambil garis serupa, membingkai agent graph sebagai pola yang telah mereka bangun selama 3 tahun.
Jadi saya menempatkan istilah itu sebagai singkatan yang berguna.
Yang diberikannya adalah nama bersama untuk pertanyaan desain yang dulu tersembunyi di dokumentasi kerangka kerja, dan sebuah nama berguna saat Anda berdebat tentang arsitektur di pull request.
Graph engineering mendeskripsikan struktur eksekusi, yang membedakannya dari dua hal yang meminjam kosakatanya.
Knowledge graph dan GraphRAG mendeskripsikan data.
Keduanya mengubah dokumen menjadi entitas dan relasi sehingga sistem retrieval dapat menelusuri keterhubungan fakta, dan perkakas, penyimpanan, serta metrik evaluasinya semuanya berbeda.
Untuk sisi istilah itu, tutorial kami tentang menggunakan knowledge graph untuk menerapkan aplikasi RAG adalah titik awal yang tepat, dengan pengantar teori graph kami membahas matematika di bawah keduanya.
Hal kedua yang bukan: kemampuan baru.
LangGraph, Agent Development Kit (ADK) Google, dan Microsoft AutoGen semuanya merilis orkestrasi multi-agen sebelum labelnya viral, jadi jika Anda pernah menulis StateGraph Anda sudah melakukannya.
Banyak pembaca akan mendapati mereka telah melakukan graph engineering selama setahun dengan nama "pipeline LangGraph saya."
Setiap lapisan AI engineering mengambil kendali atas sesuatu satu langkah lebih jauh dari model.
Cara berguna membaca tabel ini adalah kolom kanan, yang memberi tahu apa yang sebenarnya rusak saat Anda melewatkan satu anak tangga tapi tetap membangun di atasnya.
| Layer | Apa yang Anda kendalikan | Apa yang rusak jika dilewati |
|---|---|---|
| Prompt | Perumusan permintaan | Model menjawab pertanyaan yang tidak Anda ajukan |
| Context | Input mana yang mencapai model | Model bernalar baik atas materi yang salah |
| Harness | Tools, memori, akses file dan API | Model tidak dapat menyentuh apa pun di luar jendela chat |
| Loop | Siklus ulangi-hingga-selesai | Model berhenti terlalu dini, atau tidak pernah berhenti |
| Graph | Pekerja mana yang berjalan berikutnya, dan atas apa | Satu agen mencoba menjadi 4 agen dan lupa 3 di antaranya |
Melewatkan satu anak tangga adalah cara paling umum proyek graph gagal, dan kegagalannya jarang terlihat jelas.
Tiga node yang tidak andal disambung bersama tidak serta-merta menjadi sistem yang andal.
Mereka menghasilkan sistem yang gagal di lebih banyak tempat, lebih mahal per kegagalan, dan lebih lama didiagnosis karena keluaran buruknya kini berjarak 2 serah terima dari node penyebabnya.
Agent graph apa pun, entah 3 atau 30 node, terurai menjadi node, edge, dan shared state.
Begitu Anda bisa menamai ketiga bagian itu dalam suatu basis kode, kebanyakan kerangka orkestrasi menjadi dapat dibaca tanpa dokumentasinya.
Sebuah node adalah satu unit kerja dengan nama dan satu tanggung jawab.
Ia bisa berupa panggilan LLM dengan prompt khusus dan toolnya sendiri, atau fungsi Python biasa yang menanyakan basis data, memvalidasi skema, atau menulis berkas.
Sisihkan panggilan model untuk langkah yang butuh penilaian semantik.
Jika sebuah aturan punya jawaban pasti, letakkan di Python, yang berjalan dalam mikrodetik, tanpa biaya, dan mengembalikan hasil yang sama dua kali.
Ini uji yang saya pakai untuk menentukan apakah sesuatu perlu dipisah: coba jelaskan node itu dalam satu kalimat tanpa konjungsi.
Sebuah node yang "mengambil sumber dan memutuskan apakah sudah cukup" sudah gagal uji, karena Anda tidak bisa menukar bagian retrieval tanpa mengusik bagian penilaiannya.
Sebuah edge menentukan apa yang berjalan setelah node saat ini selesai.
Empat bentuk mencakup hampir semua yang akan Anda bangun:
Edge juga tempat logika penghentian Anda berada. Batas percobaan ulang, gerbang kualitas, dan aturan eskalasi semuanya keputusan perutean, dan menyimpannya di fungsi edge berarti Anda bisa mengaudit alur kontrol di satu tempat alih-alih memburunya di dalam tubuh node.
Shared state adalah satu objek yang dibaca dan ditulis setiap node seiring run berlangsung.
Tanpanya, Anda punya beberapa agen yang bekerja berdekatan tanpa saling memberi apa pun, sehingga penulis tidak bisa melihat temuan peneliti, dan peninjau tidak bisa melihat keduanya.
Di LangGraph, state biasanya sebuah TypedDict.
Kita akan mengakumulasi topik, catatan peneliti, draf saat ini, putusan dan umpan balik peninjau, serta penghitung revisi. Setiap node hanya mengembalikan field yang diubahnya, dan kerangka kerjanya menggabungkan hasil itu ke objek berjalan.
Kepemilikan penulisan adalah tempat graph paling cepat membusuk.
Putuskan sebelum menulis kode node mana yang boleh menulis tiap field, karena objek state yang bisa ditimpa 3 node berbeda adalah sesi debugging yang sudah Anda jadwalkan sendiri.
Loop engineering merancang siklus yang diulang satu agen hingga selesai, dan graph engineering merancang koordinasi di antara beberapa siklus tersebut.
Ini keputusan paling berdampak di artikel ini, jadi datang sebelum tutorial.
Jawaban baku adalah loop.
Satu agen yang ruang lingkupnya jelas dengan verifier ketat lebih cepat dibangun, lebih murah dijalankan, dan jauh lebih mudah di-debug dibanding graph mana pun yang melakukan pekerjaan sama.
Ini bukan hanya preferensi saya.
Tim UC Berkeley (penulis pertama Mert Cemri) memulai dari pengamatan bahwa keuntungan multi-agen atas setup agen tunggal sering minimal, lalu memberi anotasi 1.600+ jejak eksekusi dari 7 kerangka multi-agen untuk mencari tahu alasannya (arXiv:2503.13657, v3).
Taksonomi mereka, dibangun dari pembacaan cermat 150 jejak itu, menamai 14 mode kegagalan berbeda.
Ke-14 mode itu tersortir ke 3 kategori: isu desain sistem, ketidakselarasan antar-agen, dan verifikasi tugas.
Simpan yang ketiga sampai kita tiba di node peninjau.
Perlakukan ini sebagai pemicu, bukan daftar cek.
Satu jawaban ya yang jelas di kolom kanan sudah cukup, dan 5 yang samar belum.
| Pertanyaan tentang tugas Anda | Loop menanganinya | Anda butuh graph |
|---|---|---|
| Bisakah Anda menulis pekerjaan itu sebagai satu instruksi? | Bisa, dan seseorang bisa mengikutinya dari awal hingga akhir | Terdengar seperti serah terima antara 2 peran berbeda |
| Apakah setiap langkah menginginkan model yang sama? | Satu model dan satu set tool sepanjang proses | Mengumpulkan ingin murah dan cepat, menilai ingin tajam |
| Adakah langkah yang tidak saling bergantung? | Setiap langkah butuh keluaran langkah sebelumnya | Beberapa lookup yang bisa berjalan sekaligus |
| Siapa yang memutuskan keluaran sudah cukup baik? | Agen meninjau ulang karyanya sendiri | Sesuatu yang tidak menulisnya harus menyetujui |
| Apa yang harus terjadi jika satu langkah gagal? | Coba ulang dan lanjutkan | Isolasi kegagalan agar sisa run tetap berjalan |
| Adakah yang harus mengaudit jalur yang diambil? | Trace untuk Anda dan rekan tim | Orang luar perlu melihat langkah mana yang berjalan, dan mengapa |
Versi berlebihan yang paling sering saya temui bahkan bukan soal agen. Seseorang perlu membersihkan dan geocode daftar 800 alamat hotel, dan itu datang sebagai graph 5 node: node loader, normalizer, geocoder, validator, dan writer, dengan shared state yang menjahit di antaranya.
Setiap langkah itu deterministik, jadi yang sebenarnya dibangun adalah skrip Python 40 baris yang memakai kerangka kerja, dan kini biayanya per baris serta gagal dengan cara yang pandas tidak akan lakukan.
Versi berukuran tepat adalah yang akan kita bangun.
Menghasilkan brief riset singkat terbelah menjadi pekerjaan yang sulit untuk satu loop: mengumpulkan bahan mentah, mengubahnya jadi prosa, lalu menilai prosa itu dari luar.
Langkah ketiga adalah alasan graph itu ada, karena agen yang meninjau drafnya sendiri bukanlah meninjau.
Tiga hal membenarkan satu node.
Jika Anda tidak bisa menunjuk salah satunya untuk setiap node yang Anda tambahkan, hapus node itu dan gabungkan pekerjaannya ke tetangga.
Spesialisasi nyata datang pertama.
Peneliti kita menginginkan model yang murah dan cepat serta, di produksi, tool pencarian. Penulis tidak butuh keduanya dan diuntungkan model yang lebih kuat, jadi pemisahan ini bekerja sungguhan, bukan hiasan diagram.
Kedua, paralelisme yang benar-benar terasa.
Fan-out menguntungkan saat cabang independen dan penghematan waktu nyata penting bagi seseorang, dan menambah kompleksitas saat keduanya tidak benar.
Ketiga, dan ini yang paling akan saya bela, verifikasi independen.
Agen yang menilai PR-nya sendiri akan dermawan, jadi node peninjau terpisah yang hanya baca terhadap draf biasanya adalah node paling bernilai dalam graph mana pun.
Untuk pandangan di tingkat kerangka tentang bagaimana pustaka berbeda mengekspresikan pola ini, perbandingan kami CrewAI vs LangGraph vs AutoGen menguraikan trade-offnya.
Kita akan membangun pipeline multi-agen LangGraph dengan peneliti, penulis, dan peninjau yang menghasilkan brief riset singkat dan mengembalikan draf gagal untuk direvisi.
LangGraph adalah kerangka orkestrasi tingkat rendah untuk agen stateful, dan StateGraph-nya hampir satu banding satu dengan node, edge, dan state dari bagian sebelumnya.
Semua di bawah ini dicek terhadap langgraph 1.2.11 dan langchain-anthropic 1.7.1 pada September 2026.
Jika pustaka ini baru bagi Anda, tutorial LangGraph kami membahas dasarnya. Bagian ini bergerak cepat, dan panduan kami tentang LangChain vs LangGraph vs LangSmith vs LangFlow menjernihkan peran tiap anggota keluarganya.
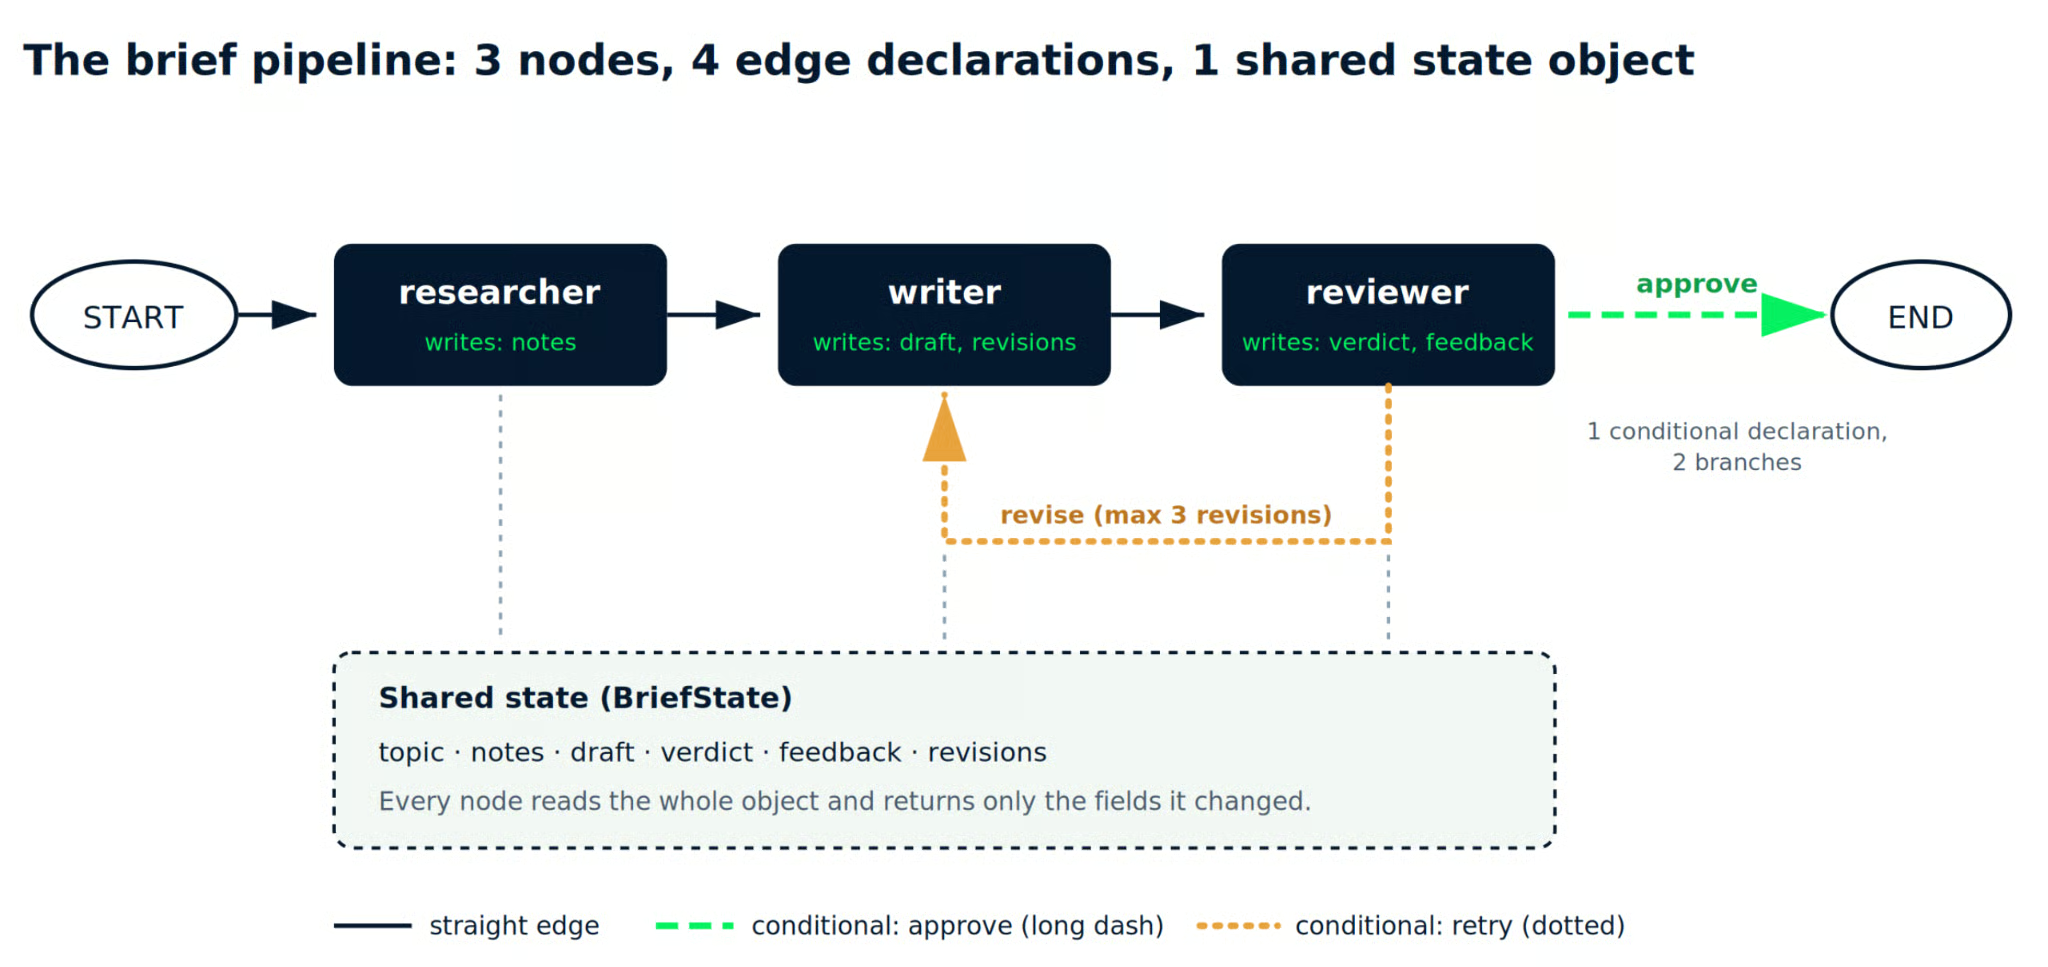
Gambar oleh Penulis. Pipeline yang akan kita bangun. Garis solid adalah 3 edge lurus; garis putus-putus dan titik-titik adalah 2 cabang dari satu edge bersyarat.
Instal paket-paketnya, plus python-dotenv agar kunci Anda tidak berada di sumber:
pip install langgraph langchain-anthropic python-dotenvBuat berkas .env di sebelah skrip Anda:
ANTHROPIC_API_KEY=sk-ant-your-key-hereSekarang impor dan skema state-nya. Menulis TypedDict lebih dulu layak 2 menitnya, karena itu kontrak yang disetujui setiap node:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Dua model, bukan satu. Itulah pemicu "model berbeda per langkah" dari tabel keputusan yang muncul dalam kode nyata, karena riset adalah pekerjaan volume tinggi dan ber-penilaian rendah yang tidak butuh model mahal.
MAX_REVISIONS melakukan pekerjaan sunyi namun penting di sini.
Tanpa batas, peninjau ketat dan penulis keras kepala akan saling mengoper draf hingga tagihan Anda makin menarik.
Setiap node mengikuti kontrak yang sama. Ia menerima state saat ini, mengerjakan satu tugasnya, dan mengembalikan dictionary berisi field yang diubahnya saja.
Peneliti mengumpulkan bahan mentah dan menuliskannya ke notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
Versi produksi node ini akan memanggil tool pencarian alih-alih mengandalkan pengetahuan model.
Saya pertahankan satu panggilan .invoke() agar struktur graph tetap terlihat, jadi perlakukan catatan yang dihasilkannya sebagai belum terverifikasi.
Penulis membaca catatan itu dan menghasilkan draf. Ia juga memeriksa umpan balik peninjau, yang memberi edge retry sesuatu untuk dikerjakan:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Peninjau menilai draf.
Ia tidak melihat penalaran penulis dan tidak menghasilkan teksnya, jadi ia bisa tegas soal hasilnya.
Inilah kategori kegagalan ketiga dalam taksonomi Berkeley, diberi satu node tersendiri.
Verifikasi tugas gagal ketika tidak ada yang independen memeriksa keluaran, jadi perbaikannya adalah pekerja yang tidak bisa menilai PR-nya sendiri:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Perhatikan .text alih-alih .content pada ketiga node.
Keduanya mengembalikan string untuk jawaban sederhana, tetapi .text juga berlaku saat respons datang sebagai beberapa blok konten, yang menyelamatkan Anda dari AttributeError: 'list' object has no attribute 'strip' yang membingungkan nanti.
Mengurai putusan dari baris pertama membuatnya tetap mudah dibaca, dan itu rapuh.
Untuk apa pun yang berjalan tanpa pengawasan, tukar pemeriksaan string itu dengan structured output LangChain sehingga putusan kembali sebagai field bertipe, bukan prefiks yang Anda harap akan dipatuhi model.
Fungsi perutean adalah edge bersyarat. Ia membaca state setelah peninjau berjalan dan mengembalikan nama apa pun yang seharusnya terjadi berikutnya:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Jaga fungsi itu tetap sunyi. print() di dalamnya mendarat di stdout saat loop stream masih mencetak potongan sebelumnya, sehingga pemberitahuan batas muncul satu langkah lebih awal dan trace tampak tidak berurutan.
Batas revisi berada di sini, bukan di dalam node, karena penghentian adalah keputusan alur kontrol dan alur kontrol tempatnya di edge.
Sekarang rakit graph-nya. Node, lalu edge, lalu kompilasi:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Argumen ketiga ke .add_conditional_edges() adalah peta jalur.
Ia mencantumkan setiap tujuan yang mungkin dikembalikan fungsi perutean, dan LangGraph menggunakannya untuk menggambar cabang sebelum node mana pun berjalan.
Panggil graph terkompilasi dengan state awal. Hanya topic dan revisions yang butuh nilai, karena field lain akan terisi saat eksekusi mengalir:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Itu memberi Anda state akhir dan tidak lebih. Kurang membantu saat satu run melenceng.
Tukar .invoke() dengan .stream() memakai stream_mode="updates" untuk melihat setiap node melaporkan apa yang ditulisnya. Setiap pemanggilan adalah run terpisah dengan panggilan modelnya sendiri, jadi gunakan salah satu alih-alih menjalankan keduanya:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Pada run ketika peninjau menolak draf pertama, itu akan mencetak:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Dua hal terlihat di sana yang disembunyikan state akhir.
Peneliti berjalan sekali, dan catatannya bertahan melalui dua kali penulisan, jadi percobaan ulang tidak melakukan riset ulang. Setiap node juga hanya menyentuh field miliknya, menjadikan aturan kepemilikan penulisan tadi sesuatu yang bisa Anda verifikasi.
Hitung panggilan sambil di sini.
Jalur yang ditolak itu berbiaya 5 panggilan model dibanding kira-kira 1 untuk versi loop tunggal dari tugas yang sama, dan satu-satunya cara mengetahui apakah 4 ekstra itu ada gunanya adalah mencatat putusan dan membacanya.
Anda tidak butuh perkakas tambahan untuk melihat bentuk yang Anda bangun:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Keluaran Mermaid merender cabang bersyarat sebagai garis putus-putus dari reviewer ke __end__ dan kembali ke writer.
Itu mengonfirmasi edge retry Anda ada sebelum Anda membelanjakan apa pun untuk panggilan model. Tampilan ASCII hanya menggambar jalur lurus dari start ke end, jadi gunakan keluaran Mermaid saat Anda ingin melihat loop.
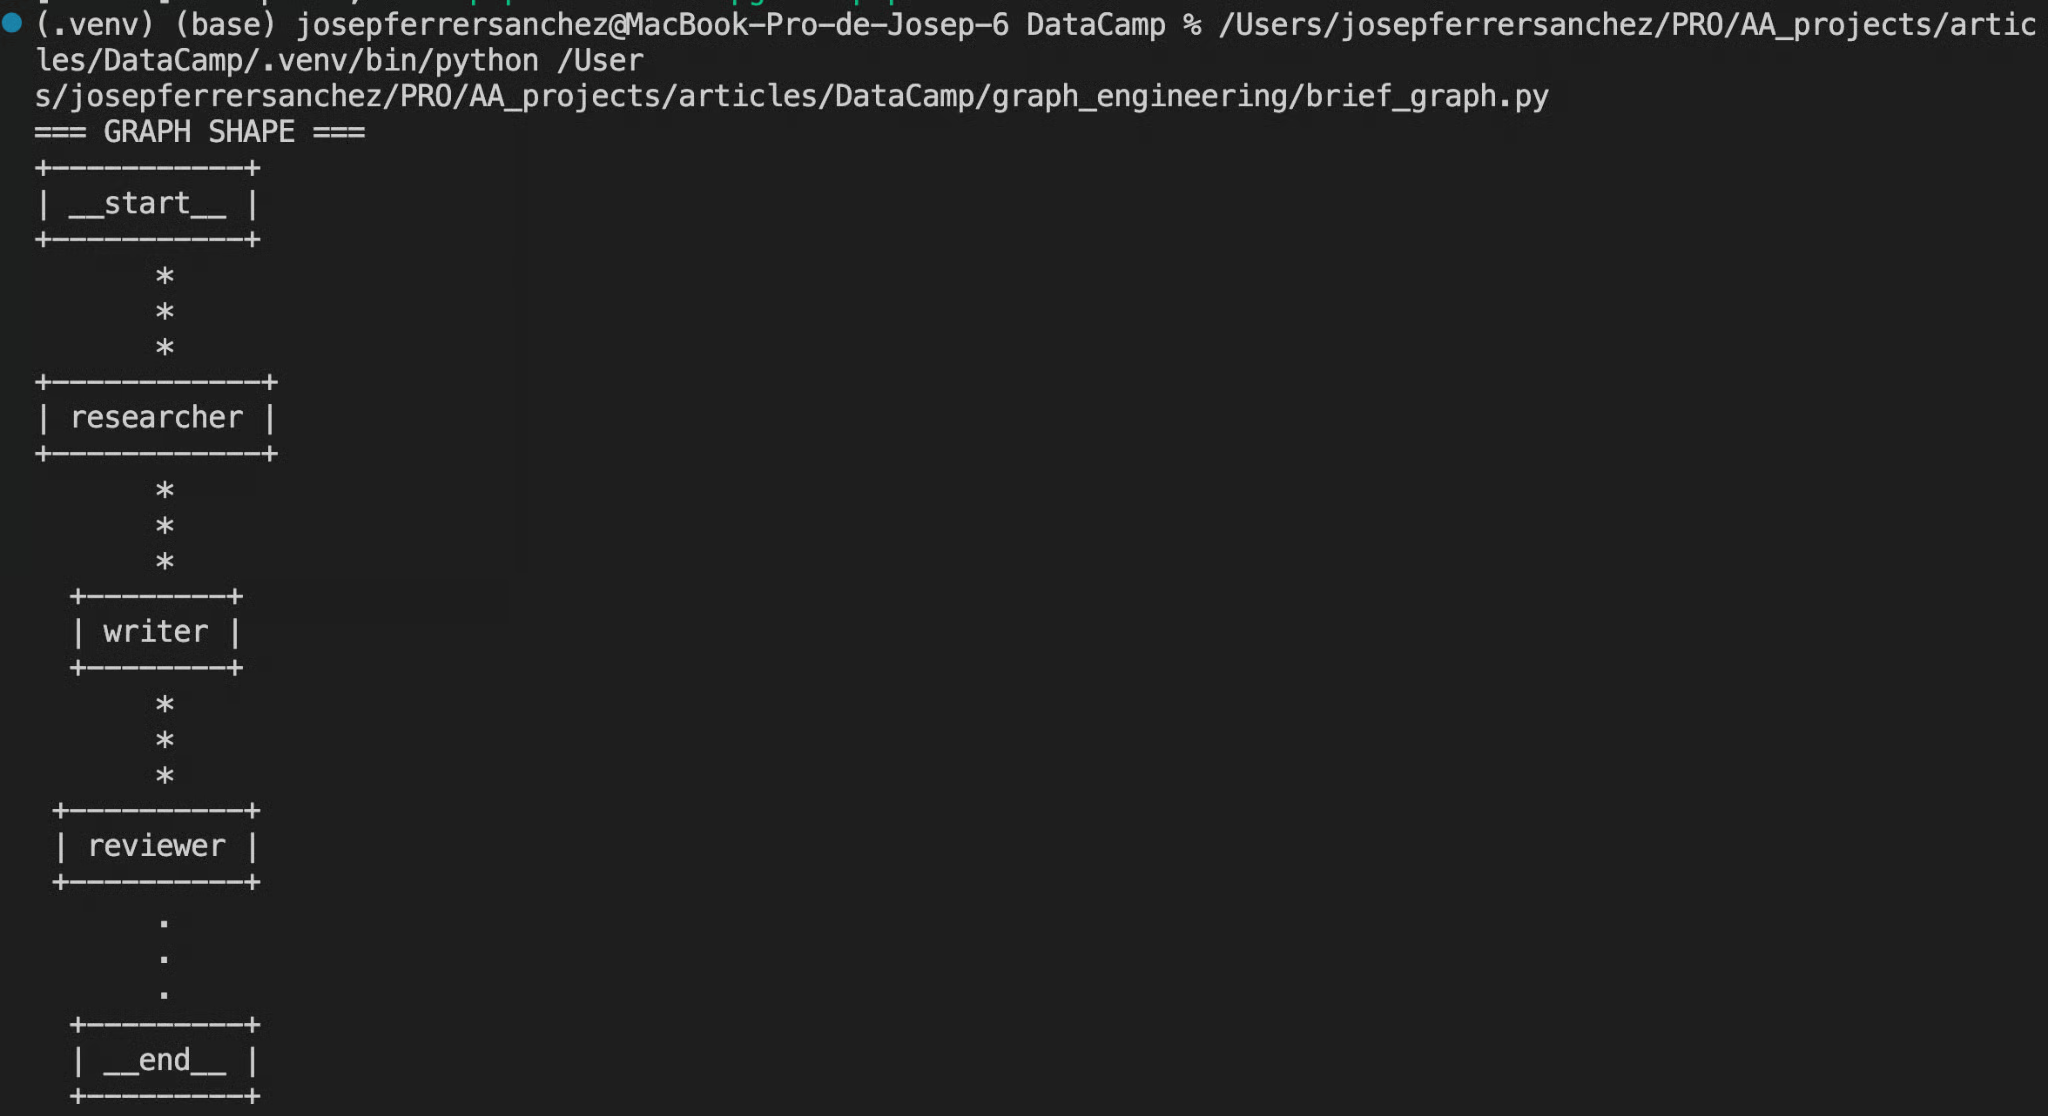
Tangkapan layar oleh Penulis. Terminal menampilkan keluaran .draw_ascii(), dengan __start__, researcher, writer, reviewer, dan __end__ tersusun vertikal dan terhubung.
Untuk debugging langkah per langkah dengan inspeksi state di tiap node, LangGraph Studio terhubung ke server lokal. Itu butuh paket tersendiri dan berkas konfigurasi, jadi lakukan pip install "langgraph-cli[inmem]", tambahkan langgraph.json yang menunjuk ke objek graph terkompilasi Anda, lalu jalankan langgraph dev dan buka URL Studio yang ditampilkan.
Panduan LangGraph Studio kami menjelaskan antarmukanya (berasal dari 2024, jadi cocokkan langkah penyiapannya dengan perintah di atas), dan tutorial agen LangGraph kami membahas penambahan tool nyata ke node seperti peneliti kita.
Satu catatan ruang lingkup.
Pipeline ini bersifat sekuensial, jadi tidak menunjukkan fan-out, pola ketika peneliti akan menanyakan beberapa sumber sekaligus, dan sebuah node gabung akan menggabungkan hasilnya.
Itu adalah perluasan alami berikutnya, dan juga tempat biaya paling cepat berlipat.
Mode kegagalan dalam graph engineering AI agentic cukup sering berulang hingga bisa dinamai. Ini tiga hal yang saya cek sebelum merilis apa pun.
Setiap node adalah loop tersendiri, dengan prompt, tool, dan definisi selesai.
Menyambung 3 node yang goyah memberi Anda sistem goyah dengan luas permukaan tiga kali lipat dan cerita debugging yang jauh lebih buruk.
Buat satu node bekerja sendiri terlebih dahulu.
Peneliti yang mengembalikan catatan samar saat Anda panggil langsung akan mengembalikan catatan samar di dalam graph juga, dan penulis di hilir akan dengan yakin membangunnya.
Tahan diri memasukkan logika ke node ketika seharusnya berada di edge.
Kondisi penghentian, keputusan cabang, dan batas retry adalah perutean, dan perutean tempatnya di fungsi edge, tempat Anda bisa membacanya sekaligus.
Terapkan uji tanpa konjungsi dari sebelumnya.
Sebuah node yang mencari sumber dan memutuskan apakah jumlahnya cukup adalah 2 node yang berbagi tanda tangan fungsi.
Fan-out dan loop retry melipatgandakan penggunaan token dengan cara yang sepenuhnya tersembunyi oleh diagram.
Fan-out 5 cabang yang memberi makan node gabung dengan batas 3 retry bukan 5 panggilan, dan tergantung di mana retry duduk, itu bisa menjadi 15 atau lebih sebelum Anda menghitung gabungannya.
Tetapkan batasnya secara eksplisit, seperti yang kita lakukan dengan MAX_REVISIONS. Lalu catat jumlah token per node dan baca setelah seminggu, karena node yang Anda anggap murah biasanya justru yang paling sering berjalan.
AutoGen masih sering direkomendasikan untuk orkestrasi graph, dan karya eksperimental GraphFlow-nya adalah karya awal yang nyata, tetapi repositorinya berada pada mode pemeliharaan per September 2026, tanpa fitur baru.
Microsoft mengarahkan pengguna baru ke Microsoft Agent Framework, yang memiliki alur kerja berbasis graphnya sendiri, melalui panduan migrasi yang dipublikasikan.
Mulai hari ini, LangGraph, ADK Google, atau Microsoft Agent Framework adalah pilihan yang lebih aman, dan kursus kami Building AI Agents with Google ADK membahas ADK secara mendalam.
Graph engineering adalah lapisan koordinasi di atas loop engineering.
Node mengerjakan tugas, edge memutuskan apa yang berjalan berikutnya, dan satu objek bersama membawa informasi di antaranya.
Singkirkan keramaian linimasa Juli 2026, dan itulah seluruh modelnya.
Pipeline kita sengaja tetap kecil: 3 node, 4 deklarasi edge (1 di antaranya bersyarat, jadi menggambar 2 cabang), dan batas revisi agar retry tidak lepas kendali.
Itu sudah cukup struktur untuk membuat draf ditinjau oleh sesuatu yang tidak menulisnya, dan properti tunggal itulah yang tidak bisa ditawarkan loop.
Raih graph ketika pekerjaan terbelah ke fase-fase yang butuh spesialis berbeda, dan tidak satu node lebih awal. Para skeptis benar bahwa mekanismenya sudah puluhan tahun dan sebagian besar tulisan seputar istilah itu adalah kebisingan.
Mereka juga benar tentang bagian yang penting pada Selasa sore.
Verifier yang lemah yang dipasang pada masalah berbentuk loop tidak akan membaik hanya karena Anda menggambar lebih banyak kotak di sekelilingnya.
Untuk membawa pola ini lebih jauh, kursus kami Multi-Agent Systems with LangGraph membahas desain supervisor dan jaringan yang tidak dibahas tutorial ini.
Untuk sisi data dari istilah itu, Graph RAG with LangChain and Neo4j adalah langkah berikut yang baik. Untuk tetap di sisi orkestrasi, Text-to-Query Agents with MongoDB and LangGraph membangun pipeline LangGraph terhadap basis data langsung, dan LLM Agents Explained melengkapi arsitektur di bawah semuanya.
Skrip lengkap ada di repositori GitHub saya, beserta pembantu perenderan graph dan catatan singkat tentang biaya tiap run.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus