Courses
Multi-Agent Systems with LangGraph
2 45
8.6K
มอบงานให้เอเจนต์หนึ่งงาน ก็ทำได้ดี มอบให้สามงาน แล้วลองดูตรงการส่งต่องานครั้งที่สอง: มันลืมสิ่งที่หาได้ในขั้นแรก ให้คะแนนร่างของตัวเองสูง และประกาศความสำเร็จทั้งที่ผลลัพธ์ยังไม่เสร็จ
ข้อถกเถียงเรื่องรูปแบบนั้นเดือดขึ้นกลางเดือนกรกฎาคม 2026 เมื่อคำว่า "graph engineering" ติดเทรนด์บน X (เดิมคือ Twitter) และไทม์ไลน์ก็แบ่งทันทีระหว่างคนที่ประกาศการสิ้นสุดของ agent loop กับคนที่บอกว่าคำนี้เป็นแค่ฟิลเลอร์ของฟาร์มคอนเทนต์
มุมมองคือ ป้ายชื่อ graph engineering จะใช้หรือไม่ก็ได้ แต่การยกระดับกลไกข้างใต้หลีกเลี่ยงไม่ได้ ซึ่งจะพยายามอธิบายให้ชัดก่อนเขียนโค้ด
ส่วนใหญ่ที่ควรสร้างในเดือนนี้ยังคงเป็นลูปเดี่ยว และวิธีเร็วที่สุดที่จะเสียเวลาหนึ่งสัปดาห์คือวาดไดอะแกรม 6 กล่องสำหรับงานที่ต้องการแค่ 1
กราฟเอเจนต์มี 3 ส่วน:
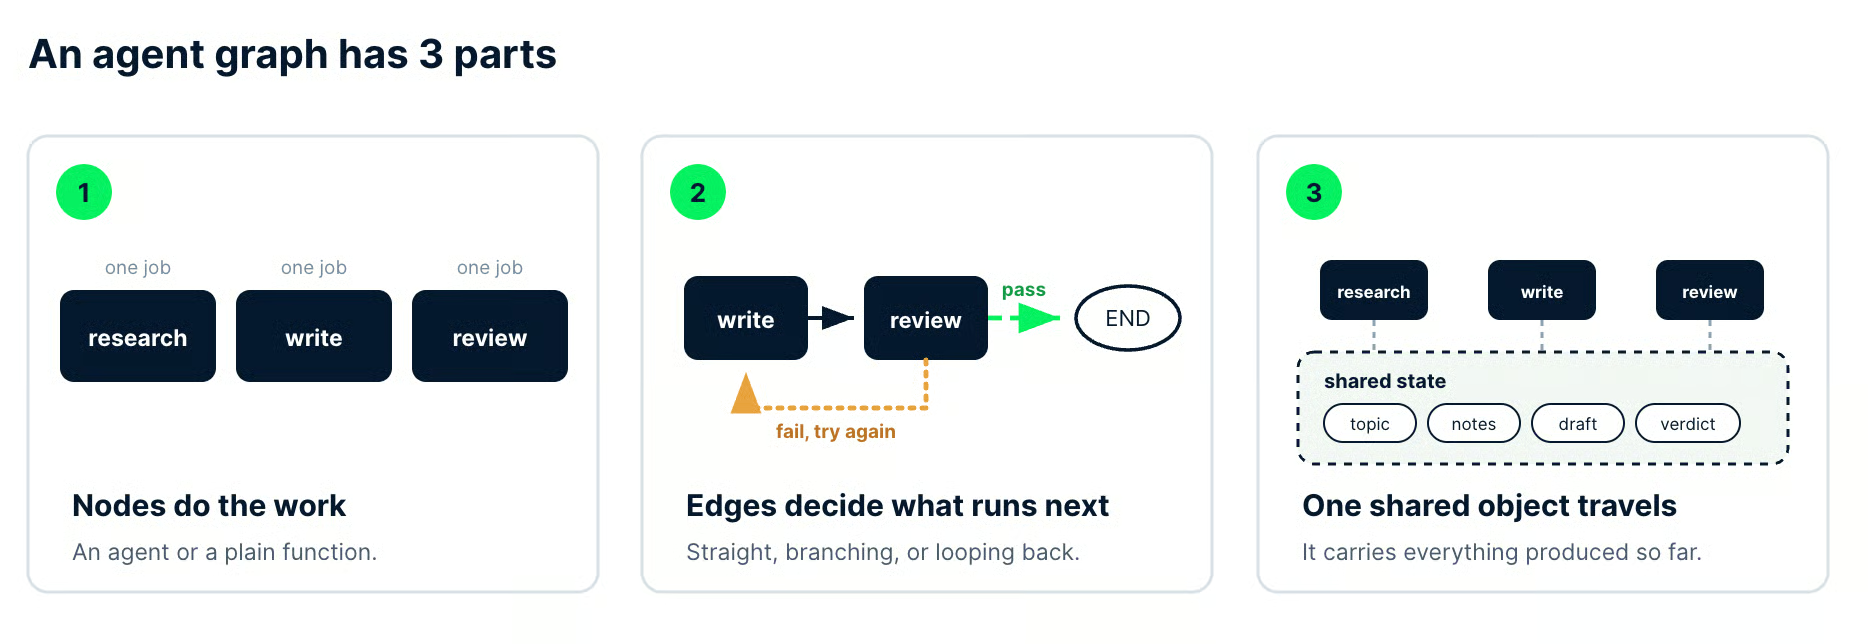
ภาพโดยผู้เขียน แสดง 3 ส่วนบนไปป์ไลน์ที่สร้างภายหลัง: โหนด 3 ตัวที่มีชื่อ, เอจแบบ pass, เอจแบบ retry และอ็อบเจ็กต์สถานะหนึ่งตัวที่สะสม topic, notes, draft และ verdict
การประกาศทั้ง 3 ส่วนล่วงหน้า แทนที่จะปล่อยให้เอเจนต์ตัวเดียวด้นสดเส้นทางของตัวเอง คือสิ่งที่คำว่า graph engineering อธิบาย
บทเรียนนี้สร้างไปป์ไลน์ researcher, writer และ reviewer ที่ใช้งานได้จริงใน Python ด้วย LangGraph รวมถึงเอจแบบมีเงื่อนไขที่ส่งร่างที่ไม่ผ่านกลับไปแก้ไข
ต้องมี Python, pip และคุ้นเคยกับโมเดลภาษาขนาดใหญ่ (LLMs) หรือเอเจนต์ AI ระดับหนึ่ง หากยังใหม่ แนะนำคอร์ส Introduction to AI Agents ที่ครอบคลุมแนวคิดที่บทความนี้อ้างอิง และบทเรียน LangGraph agents สำหรับภาคปฏิบัติ
Graph engineering คือการทำให้ control flow ของระบบเอเจนต์ชัดเจนในโค้ด แทนที่จะปล่อยให้เป็นวิจารณญาณของโมเดล
ต้องประกาศว่ามีแรงงานผู้เชี่ยวชาญใดบ้าง อนุญาตให้เปลี่ยนผ่านระหว่างกันแบบใด และข้อมูลอะไรเดินทางไปตามเส้นทางเหล่านั้น
เอเจนต์ยังคงใช้เหตุผลได้อย่างอิสระ แต่ใช้ภายในโหนดเดียว ไม่ใช่ข้ามทั้งงาน
ประโยคสุดท้ายนี่แหละคือความแตกต่างทั้งหมด
ในลูป เรากำหนดเป้าหมายและเกณฑ์คุณภาพ แล้วเอเจนต์จะเลือกเส้นทางเองเพื่อให้ผ่านเกณฑ์ ในกราฟ เราตรึงเส้นทางและจุดตรวจสอบ ทำให้อิสระของโมเดลถูกจำกัดด้วยโครงสร้างที่อ่านได้จาก diff
คำนี้ดังบน X ในกรกฎาคม 2026 แต่ไม่ได้เริ่มที่นั่น Itamar Friedman จาก CodiumAI (ปัจจุบัน Qodo) ได้อธิบายการเปลี่ยนจาก "prompt engineering ไปสู่ flow (/graph) engineering" ตั้งแต่กุมภาพันธ์ 2024 และ งาน AlphaCodium ของทีมก็มีตัวเลขรองรับ
ความแม่นยำ pass@5 ของ GPT-4 บนชุดตรวจสอบ CodeContests เพิ่มจาก 19% ด้วยพรอมป์ต์เดี่ยวที่ออกแบบมาดี เป็น 44% ด้วยโฟลว์หลายขั้น ซึ่งทั้งสองเงื่อนไขคือ 5 ครั้งต่อหนึ่งปัญหา ไม่ใช่ยิงทีเดียว
สิ่งที่เกิดในกรกฎาคม 2026 คือการขยายเสียง
วันที่ 18 กรกฎาคม Peter Steinberger ถามบน X ว่า "ยังคุยเรื่องลูปอยู่หรือเปลี่ยนเป็นกราฟแล้ว?" หนึ่งสัปดาห์หลัง Mike Masson โพสต์บันได prompt, context, harness, loop, graph คำถามนั้นได้ 3.1 ล้านวิว และวลีที่แพร่ก็ถูกใช้กันอยู่แล้ว
การโต้กลับมาเร็ว Harrison Chase ผู้ร่วมก่อตั้ง LangChain จากทีมเบื้องหลัง LangGraph ถาม ว่าทั้งหมดนั้น "ก็แค่ langgraph ใช่ไหม?"
Dale Everett ผลักจากอีกด้าน โต้ว่า ลูปก็คือกราฟที่มีโหนดเดียวอยู่แล้ว ดังนั้นความตื่นเต้นในเดือนกรกฎาคมเป็นการค้นพบสิ่งเก่าใหม่ บทสรุปย้อนหลังของ LangChain เอง 3 Years of Graph Engineering with LangGraph ก็อยู่ในทำนองเดียวกัน จัดกราฟเอเจนต์เป็นแพทเทิร์นที่สร้างมานาน 3 ปี
จึงจัดคำนี้ไว้เป็นชวเลขที่มีประโยชน์
สิ่งที่ได้คือชื่อเรียกร่วมกันสำหรับคำถามด้านออกแบบที่เคยนอนอยู่ในเอกสารเฟรมเวิร์ก และชื่อเรียกมีคุณค่าเมื่อกำลังถกสถาปัตยกรรมใน pull request
Graph engineering อธิบายโครงสร้างการรัน ซึ่งแยกออกจากสองเรื่องที่ยืมศัพท์ไปใช้
Knowledge graph และ GraphRAG อธิบายข้อมูล
พวกมันแป้งเอกสารให้เป็นเอนทิตีและความสัมพันธ์ เพื่อให้ระบบดึงคืนข้อมูลเดินตามความเชื่อมโยงของข้อเท็จจริง เครื่องมือ การจัดเก็บ และเมตริกประเมินล้วนต่างกัน
สำหรับด้านนั้นของคำ แนะนำบทเรียน ใช้ knowledge graph เพื่อสร้างแอป RAG เป็นจุดเริ่มต้นที่ถูกต้อง พร้อมบทนำ ทฤษฎีกราฟ ที่ครอบคลุมคณิตศาสตร์รองรับทั้งสองฝั่ง
อย่างที่สองที่ไม่ใช่ คือความสามารถใหม่
LangGraph, Agent Development Kit (ADK) ของ Google และ Microsoft AutoGen ต่างก็ปล่อย orchestration แบบหลายเอเจนต์มาก่อนที่ฉลากนี้จะไวรัล ดังนั้นหากเคยเขียน StateGraph ก็ทำสิ่งนี้อยู่แล้ว
ผู้อ่านจำนวนไม่น้อยจะพบว่าทำ graph engineering มาหนึ่งปีแล้วภายใต้ชื่อ "ไปป์ไลน์ LangGraph ของฉัน"
แต่ละชั้นของวิศวกรรม AI ควบคุมสิ่งที่ไกลออกไปจากโมเดลอีกหนึ่งขั้น
วิธีอ่านตารางที่มีประโยชน์คือคอลัมน์ขวาสุด ซึ่งบอกว่าสิ่งใดพังเมื่อข้ามขั้นไปแล้วดันทับซ้อนสร้างต่อ
| ชั้น | ควบคุมอะไร | อะไรพังหากข้ามชั้น |
|---|---|---|
| Prompt | ถ้อยคำของคำขอ | โมเดลตอบคำถามที่ไม่ได้ถาม |
| Context | อินพุตใดไปถึงโมเดล | ใช้เหตุผลเก่งกับข้อมูลที่ไม่ถูกต้อง |
| Harness | เครื่องมือ หน่วยความจำ การเข้าถึงไฟล์และ API | แตะสิ่งใดนอกหน้าต่างแชตไม่ได้ |
| Loop | วัฏจักรทำซ้ำจนเสร็จ | หยุดเร็วไป หรือไม่หยุดเลย |
| Graph | แรงงานคนใดรันต่อ และบนข้อมูลใด | เอเจนต์ตัวเดียวพยายามเป็น 4 ตัวและลืม 3 ตัวนั้น |
การข้ามขั้นคือวิธีพังที่พบบ่อยสุดของโปรเจกต์กราฟ และความล้มเหลวมักไม่เด่นชัด
โหนดที่ไม่น่าเชื่อถือสามโหนดต่อกันไม่ได้ถัวเฉลี่ยเป็นระบบที่เชื่อถือได้
พวกมันให้ระบบที่พังได้มากขึ้น ต้นทุนต่อความพังสูงขึ้น และใช้เวลาวินิจฉัยนานขึ้น เพราะเอาต์พุตที่เสียตอนนี้อยู่ห่างจากโหนดต้นเหตุไปอีก 2 การส่งต่อ
ไม่ว่ากราฟเอเจนต์จะมี 3 โหนดหรือ 30 ก็แยกเป็น โหนด เอจ และสถานะแชร์
พอระบุชื่อสามส่วนนี้ในฐานโค้ดได้ เฟรมเวิร์ก orchestration ส่วนใหญ่ก็อ่านออกโดยไม่ต้องเปิดเอกสาร
โหนดคือหน่วยงานหนึ่งงาน มีชื่อและความรับผิดชอบเดียว
อาจเป็นการเรียก LLM ด้วยพรอมป์ต์เฉพาะและเครื่องมือของตัวเอง หรือเป็นฟังก์ชัน Python ธรรมดาที่คิวรีฐานข้อมูล ตรวจสคีมา หรือเขียนไฟล์
เก็บการเรียกโมเดลไว้สำหรับขั้นตอนที่ต้องการวิจารณญาณเชิงความหมาย
ถ้ากฎให้คำตอบแน่ชัด ใส่ไว้ใน Python ซึ่งรันในระดับไมโครวินาที ไม่เสียค่าใช้จ่าย และคืนคำตอบเดิมได้ซ้ำ
นี่คือบททดสอบว่าจะต้องแยกหรือไม่: ลองบรรยายโหนดในประโยคเดียวโดยไม่มีสันธาน
โหนดที่ "ดึงแหล่งข้อมูลและตัดสินว่ามีพอหรือไม่" สอบตกแล้ว เพราะไม่สามารถสลับส่วนดึงข้อมูลออกจากส่วนตัดสินได้โดยไม่รบกวนกัน
เอจตัดสินว่าอะไรจะรันหลังโหนดปัจจุบันจบ
สี่รูปแบบครอบคลุมเกือบทั้งหมดที่ต้องสร้าง:
เอจยังเป็นที่ที่ควรวางตรรกะการหยุดด้วย เพดานรีทไร เกณฑ์คุณภาพ และกฎการยกระดับ ล้วนเป็นการตัดสินใจด้านเส้นทาง การเก็บไว้ในฟังก์ชันเอจทำให้ตรวจสอบ control flow ได้ในที่เดียว แทนการตามหาในตัวโหนด
สถานะแชร์คืออ็อบเจ็กต์เดียวที่ทุกโหนดอ่านและเขียนระหว่างการรัน
ถ้าไม่มี จะมีเอเจนต์หลายตัวทำงานติดกันแต่ไม่ส่งอะไรให้กัน ทำให้ผู้เขียนมองไม่เห็นสิ่งที่ผู้วิจัยหาได้ และรีวิวเวอร์ก็มองไม่เห็นทั้งคู่
ใน LangGraph สถานะมักเป็น TypedDict
ของเราสะสมหัวข้อ โน้ตของผู้วิจัย ร่าง คำตัดสินและฟีดแบ็กของรีวิวเวอร์ รวมถึงตัวนับการแก้ไข แต่ละโหนดคืนเฉพาะฟิลด์ที่เปลี่ยน และเฟรมเวิร์กจะรวมค่าที่คืนเข้ากับอ็อบเจ็กต์ที่กำลังรัน
สิทธิ์การเขียนคือจุดที่กราฟเริ่มเสื่อมก่อน
ตัดสินใจก่อนเขียนโค้ดว่าโหนดใดมีสิทธิ์เขียนฟิลด์ไหน เพราะสถานะที่มี 3 โหนดเขียนทับกันได้ คือการดีบักที่จองไว้ล่วงหน้า
วิศวกรรมลูปออกแบบวัฏจักรที่เอเจนต์ตัวเดียวทำซ้ำจนเสร็จ และวิศวกรรมกราฟออกแบบการประสานงานระหว่างลูปเหล่านั้นหลายตัว
นี่เป็นการตัดสินใจที่สำคัญที่สุดในบทความ จึงมาก่อนบทเรียน
คำตอบปริยายคือลูป
เอเจนต์เดี่ยวที่สโคปชัดและมีตัวตรวจเข้มงวด สร้างได้เร็วกว่า ถูกกว่า และดีบักง่ายกว่ากราฟใด ๆ ที่ทำงานเดียวกัน
ไม่ใช่แค่ความชอบส่วนตัว
ทีม UC Berkeley (ผู้เขียนคนแรก Mert Cemri) เริ่มจากข้อสังเกตว่าผลได้ของหลายเอเจนต์เหนือเอเจนต์เดี่ยวนั้นมักน้อย แล้วตีความร่องรอยการรันกว่า 1,600 รายการจาก 7 เฟรมเวิร์กหลายเอเจนต์เพื่อหาเหตุผล (arXiv:2503.13657, v3)
อนุกรมวิธานของพวกเขา สร้างจากการอ่านอย่างละเอียด 150 ร่องรอย ตั้งชื่อโหมดล้มเหลว 14 แบบ
14 แบบนั้นจัดเป็น 3 หมวด: ปัญหาดีไซน์ระบบ การไม่สอดคล้องกันระหว่างเอเจนต์ และการตรวจสอบงาน
เก็บหมวดที่สามไว้อีกนิดจนถึงโหนดรีวิวเวอร์
มองสิ่งเหล่านี้เป็นทริกเกอร์ ไม่ใช่เช็กลิสต์
คำตอบใช่ที่ชัดเจนข้างขวาหนึ่งข้อก็พอ และคำตอบใช่แบบเลือนลางห้าข้อไม่พอ
| คำถามเกี่ยวกับงาน | ลูปรับมือได้ | ควรใช้กราฟ |
|---|---|---|
| เขียนงานเป็นคำสั่งเดียวได้ไหม? | ได้ และคนก็ทำตามตั้งแต่ต้นจนจบได้ | อ่านแล้วเหมือนการส่งต่องานระหว่าง 2 บทบาท |
| ทุกขั้นต้องการโมเดลเดียวกันไหม? | โมเดลเดียว เครื่องมือชุดเดียวตลอด | การเก็บต้องการถูกและเร็ว การตัดสินต้องคม |
| มีขั้นไหนไม่ขึ้นต่อกันไหม? | แต่ละขั้นต้องใช้ผลลัพธ์จากขั้นก่อนหน้า | การค้นหลายครั้งที่รันพร้อมกันได้ |
| ใครตัดสินว่าเอาต์พุตดีพอ? | เอเจนต์อ่านงานตัวเองซ้ำ | สิ่งที่ไม่ได้เขียนต้องลงนามอนุมัติ |
| ควรเกิดอะไรขึ้นเมื่อขั้นใดล้มเหลว? | รีทไรแล้วเดินหน้าต่อ | กักความล้มเหลวไว้เพื่อให้ส่วนที่เหลือรอด |
| มีใครต้องตรวจสอบเส้นทางที่ใช้ไหม? | ทรซเป็นของทีมภายใน | คนนอกต้องเห็นว่าขั้นไหนรัน และเพราะอะไร |
เวอร์ชันโอเวอร์เอนจิเนียร์ที่เจอบ่อยยังไม่ใช่เรื่องเอเจนต์ด้วยซ้ำ ต้องทำความสะอาดและ geocode รายชื่อที่อยู่โรงแรม 800 รายการ แต่มาถึงในรูปกราฟ 5 โหนด: โหนดโหลด โหนดทำให้เป็นมาตรฐาน โหนด geocode โหนดตรวจสอบ และโหนดเขียน พร้อมสถานะที่ร้อยผ่านทั้งหมด
ทุกขั้นนั้นเป็นดีเทอร์มินิสติก สิ่งที่สร้างจริง ๆ คือสคริปต์ Python 40 บรรทัดที่สวมเฟรมเวิร์กไว้ และตอนนี้มีค่าใช้จ่ายต่อแถวและล้มเหลวในแบบที่ pandas จะไม่เป็น
เวอร์ชันขนาดพอดีคือสิ่งที่จะสร้างต่อไปนี้
การผลิตบรีฟสั้น ๆ ที่ผ่านการค้นคว้า แยกเป็นงานที่ลูปเดี่ยวลำบาก: เก็บวัตถุดิบ แปลงเป็นร้อยแก้ว แล้วตัดสินร้อยแก้วนั้นจากคนนอก
ขั้นที่สามคือเหตุผลที่กราฟต้องมี เพราะเอเจนต์ที่รีวิวร่างของตัวเองไม่ใช่การรีวิว
มีสามอย่างที่ทำให้โหนดสมเหตุสมผล
ถ้าชี้สิ่งใดสิ่งหนึ่งให้กับทุกโหนดที่เพิ่มไม่ได้ ให้ลบโหนดนั้นและรวมงานเข้ากับโหนดข้างเคียง
อย่างแรกคือความเชี่ยวชาญจริง
ผู้วิจัยต้องการโมเดลที่ถูกและเร็ว และในโปรดักชันคือเครื่องมือค้นหา ผู้เขียนไม่ต้องการทั้งสองอย่างและได้ประโยชน์จากโมเดลที่แข็งแรงกว่า ดังนั้นการแยกจึงทำงานจริง ไม่ใช่แค่ตกแต่งไดอะแกรม
อย่างที่สองคือความขนานที่รู้สึกได้จริง
แผ่ออกคุ้มเมื่อกิ่งอิสระต่อกันและการประหยัดเวลาจริงสำคัญต่อใครสักคน และจะเพิ่มความซับซ้อนเมื่อไม่ใช่ทั้งคู่
อย่างที่สาม และจะปกป้องข้อนี้มากที่สุด คือการตรวจสอบอิสระ
เอเจนต์ตรวจการบ้านตัวเองมักใจดี ดังนั้นโหนดรีวิวเวอร์ที่มีสิทธิ์อ่านร่างอย่างเดียวมักเป็นโหนดที่มีค่าสุดในกราฟใด ๆ
สำหรับภาพระดับเฟรมเวิร์กว่าไลบรารีต่าง ๆ แสดงแพทเทิร์นเหล่านี้อย่างไร บทเปรียบเทียบ CrewAI vs LangGraph vs AutoGen อธิบายข้อแลกเปลี่ยน
กำลังสร้างไปป์ไลน์หลายเอเจนต์ของ LangGraph ที่มีผู้วิจัย ผู้เขียน และรีวิวเวอร์ ซึ่งผลิตบรีฟสั้น ๆ ที่ผ่านการค้นคว้า และส่งร่างที่ไม่ผ่านกลับไปแก้ไข
LangGraph เป็นเฟรมเวิร์ก orchestration ระดับล่างสำหรับเอเจนต์ที่มีสถานะ และ StateGraph แมปแทบหนึ่งต่อหนึ่งกับโหนด เอจ และสถานะจากส่วนก่อนหน้า
ทั้งหมดด้านล่างตรวจสอบกับ langgraph 1.2.11 และ langchain-anthropic 1.7.1 ในเดือนกันยายน 2026
หากยังใหม่กับไลบรารี แนะนำ บทเรียน LangGraph สำหรับพื้นฐาน ส่วนนี้จะไปเร็ว และคู่มือ LangChain vs LangGraph vs LangSmith vs LangFlow ช่วยแยกบทบาทในตระกูลนี้
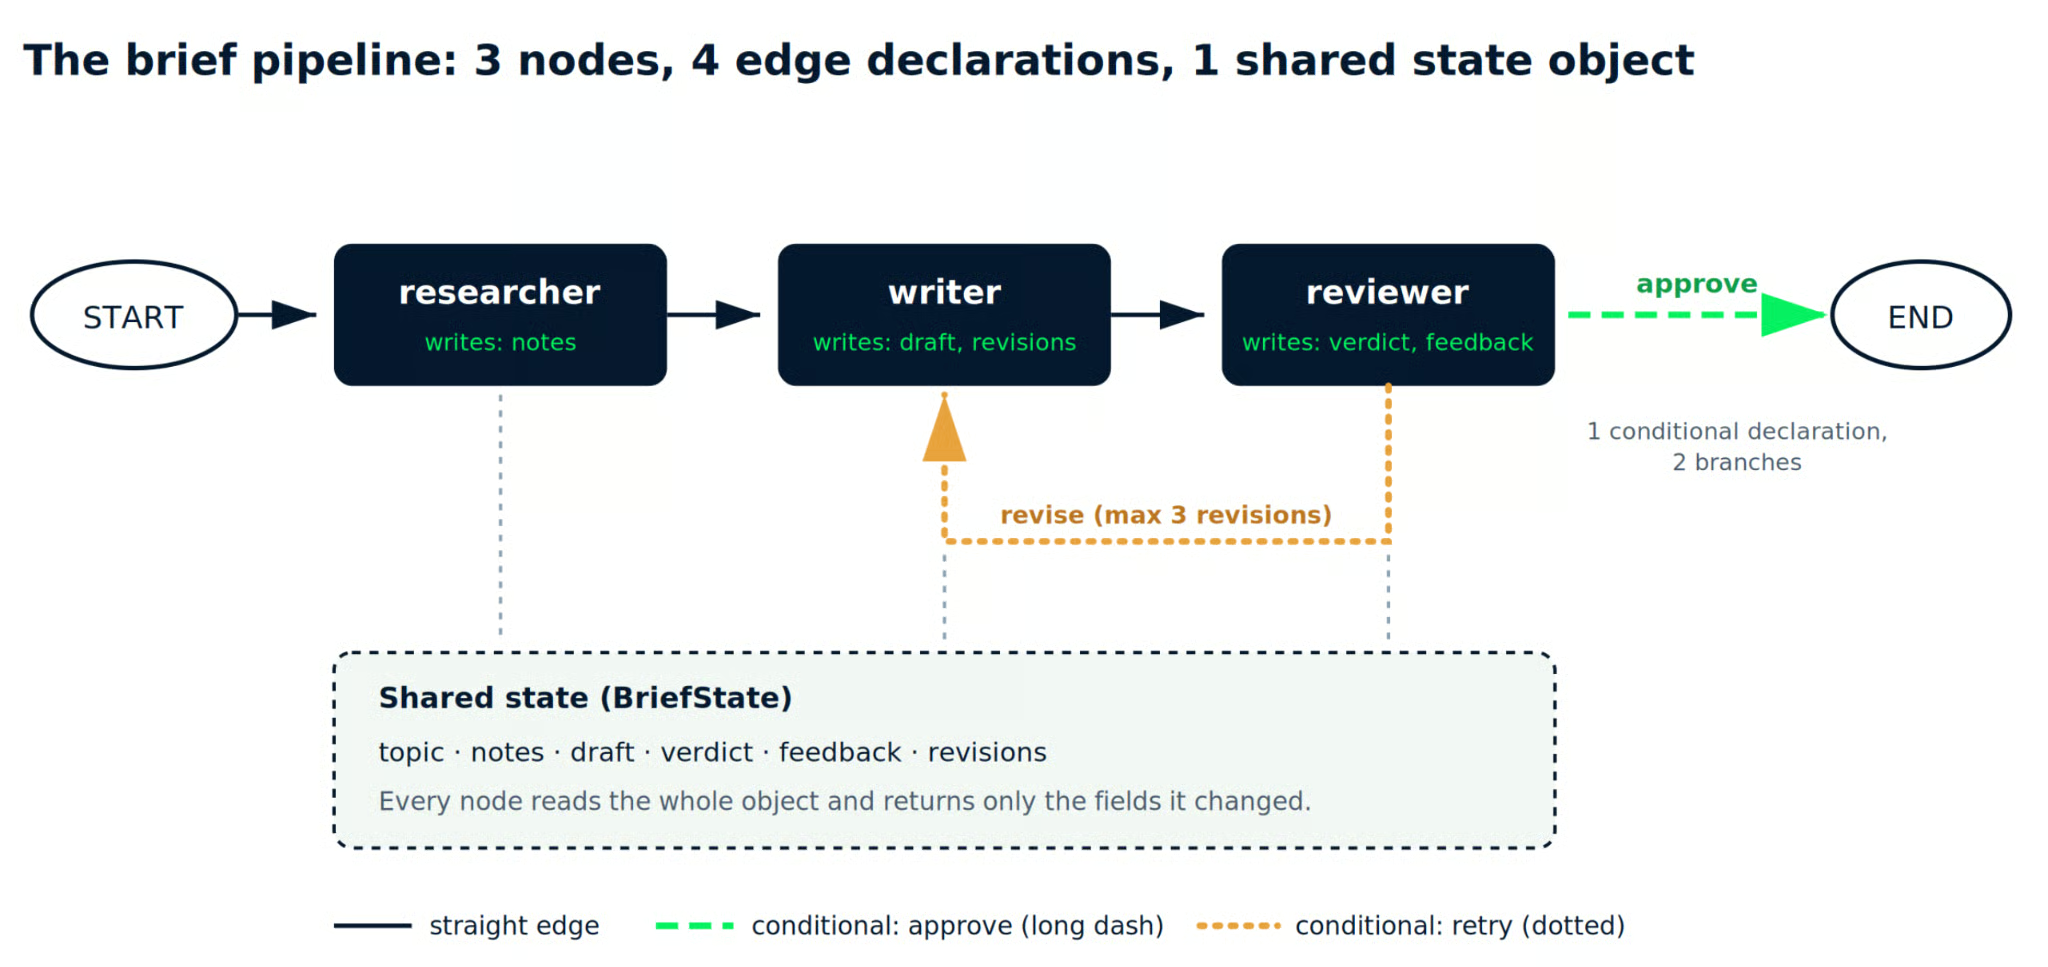
ภาพโดยผู้เขียน ไปป์ไลน์ที่จะสร้างต่อไปนี้ เส้นทึบคือเอจตรง 3 เส้น เส้นประและเส้นจุดคือ 2 สาขาของเอจมีเงื่อนไขเดียวกัน
ติดตั้งแพ็กเกจ พร้อม python-dotenv เพื่อซ่อนคีย์ออกจากซอร์ส:
pip install langgraph langchain-anthropic python-dotenvสร้างไฟล์ .env ข้างสคริปต์:
ANTHROPIC_API_KEY=sk-ant-your-key-hereต่อไปคือการนำเข้าและสคีมาของสถานะ เขียน TypedDict ก่อนคุ้มค่าสองนาที เพราะเป็นสัญญาที่ทุกโหนดยอมรับร่วมกัน:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
สองโมเดล ไม่ใช่หนึ่ง นี่คือทริกเกอร์ "โมเดลต่างกันต่อขั้น" จากตารางตัดสินใจที่โผล่ในโค้ดจริง เพราะงานค้นคว้าคือปริมาณสูงและใช้วิจารณญาณน้อย ไม่ต้องพึ่งโมเดลแพง
MAX_REVISIONS กำลังทำงานสำคัญแบบเงียบ ๆ
ถ้าไม่ตั้งเพดาน รีวิวเวอร์ที่เข้มงวดกับผู้เขียนที่ดื้อจะโยนร่างไปมาจนใบแจ้งหนี้น่าสนใจ
ทุกโหนดทำตามสัญญาเดียวกัน รับสถานะปัจจุบัน ทำงานของตัวเอง และคืนดิกชันนารีที่มีเฉพาะฟิลด์ที่เปลี่ยน
ผู้วิจัยรวบรวมวัตถุดิบและเขียนลง notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
เวอร์ชันโปรดักชันของโหนดนี้ควรเรียกเครื่องมือค้นหาแทนพึ่งพาความรู้ในโมเดลเอง
ที่นี่คงไว้แค่เรียก .invoke() เดียวเพื่อให้โครงสร้างกราฟยังมองเห็นได้ จึงถือว่าโน้ตที่ได้ยังไม่ผ่านการยืนยัน
ผู้เขียนอ่านโน้ตเหล่านั้นและผลิตร่าง นอกจากนี้ยังตรวจฟีดแบ็กจากรีวิวเวอร์ เพื่อให้เอจรีทไรทำงานได้:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
รีวิวเวอร์ให้คะแนนร่าง
มันไม่เห็นการให้เหตุผลของผู้เขียนและไม่ได้ผลิตข้อความ จึงพูดตรง ๆ กับผลลัพธ์ได้
นี่คือหมวดความล้มเหลวที่สามของอนุกรมวิธาน Berkeley ที่ได้รับโหนดของตัวเอง
การตรวจสอบงานพังเมื่อไม่มีสิ่งใดอิสระมาตรวจเอาต์พุต วิธีแก้คือแรงงานที่ตรวจการบ้านตัวเองไม่ได้:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
สังเกต .text แทน .content ในทั้งสามโหนด
ทั้งสองเมธ็อดคืนสตริงสำหรับคำตอบง่าย ๆ แต่ .text ยังทำถูกต้องเมื่อคำตอบมาเป็นหลายบล็อกคอนเทนต์ ซึ่งช่วยหลีกเลี่ยง AttributeError: 'list' object has no attribute 'strip' ที่ชวนงงภายหลัง
การพาร์สคำตัดสินจากบรรทัดแรกอ่านง่าย แต่เปราะบาง
สำหรับสิ่งที่รันอัตโนมัติ ควรสลับจากเช็กสตริงเป็น structured output ของ LangChain เพื่อให้คำตัดสินกลับมาเป็นฟิลด์ที่มีชนิด ไม่ใช่คำนำหน้าที่หวังว่าโมเดลจะเคารพ
ฟังก์ชัน routing คือเอจมีเงื่อนไข มันอ่านสถานะหลังรีวิวเวอร์รันเสร็จ และคืนชื่อของสิ่งที่ควรเกิดถัดไป:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
เก็บฟังก์ชันนี้ให้เงียบ print() ข้างในจะไปลง stdout ขณะลูปสตรีมยังพิมพ์ชังก์ก่อนหน้าอยู่ ทำให้ข้อความแจ้งเพดานแสดงก่อนหนึ่งขั้นและทรซดูสลับลำดับ
เพดานการแก้ไขอยู่ที่นี่แทนที่จะอยู่ในโหนด เพราะการหยุดคือการตัดสินใจด้าน control flow และ control flow ควรอยู่บนเอจ
ตอนนี้ประกอบกราฟ โหนด จากนั้นเอจ แล้วคอมไพล์:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
อาร์กิวเมนต์ที่สามของ .add_conditional_edges() คือ path map
มันระบุปลายทางทั้งหมดที่ฟังก์ชัน routing อาจคืนค่า และ LangGraph ใช้มันวาดสาขาก่อนจะมีโหนดไหนรัน
เรียกกราฟที่คอมไพล์แล้วโดยให้สถานะแรกเริ่ม ต้องมีค่าเฉพาะ topic และ revisions เพราะฟิลด์อื่นจะถูกเติมระหว่างรัน:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
นั่นให้สถานะสุดท้ายอย่างเดียว ช่วยอะไรไม่มากเมื่อการรันออกนอกทาง
สลับ .invoke() เป็น .stream() พร้อม stream_mode="updates" เพื่อดูแต่ละโหนดรายงานสิ่งที่เขียน แต่ละคำเรียกคือการรันแยกที่มีการเรียกโมเดลของตัวเอง จึงควรใช้แบบใดแบบหนึ่งแทนการรันทั้งคู่:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
การรันที่รีวิวเวอร์ไม่ผ่านร่างแรก จะพิมพ์ดังนี้:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
มีสองสิ่งที่เห็นได้ซึ่งสถานะสุดท้ายซ่อนไว้
ผู้วิจัยรันครั้งเดียว และโน้ตยังอยู่ผ่านการเขียนทั้งสองรอบ จึงไม่มีการ re-research เมื่อรีทไร แต่ละโหนดยังแตะเฉพาะฟิลด์ของตัวเอง ทำให้กฎสิทธิ์การเขียนจากก่อนหน้านี้ตรวจสอบได้
นับจำนวนการเรียกในระหว่างนี้
เส้นทางที่ถูกปฏิเสธนั้นมีค่าใช้จ่าย 5 การเรียกโมเดล เทียบกับราว ๆ 1 ครั้งสำหรับเวอร์ชันลูปเดี่ยวของงานเดียวกัน และวิธีเดียวที่จะรู้ว่าที่เพิ่มอีก 4 ครั้งนั้นคุ้มไหมคือบันทึกคำตัดสินและอ่านมัน
ไม่ต้องมีเครื่องมือเพิ่มเพื่อเห็นรูปทรงของสิ่งที่สร้าง:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
เอาต์พุต Mermaid เรนเดอร์สาขามีเงื่อนไขเป็นเส้นประจาก reviewer ไปยัง __end__ และย้อนกลับไป writer
นั่นยืนยันว่าเอจรีทไรมีอยู่ก่อนใช้เงินกับการเรียกโมเดล มุมมอง ASCII วาดเฉพาะเส้นตรงจากเริ่มถึงจบ จึงใช้ Mermaid เมื่อต้องการเห็นลูป
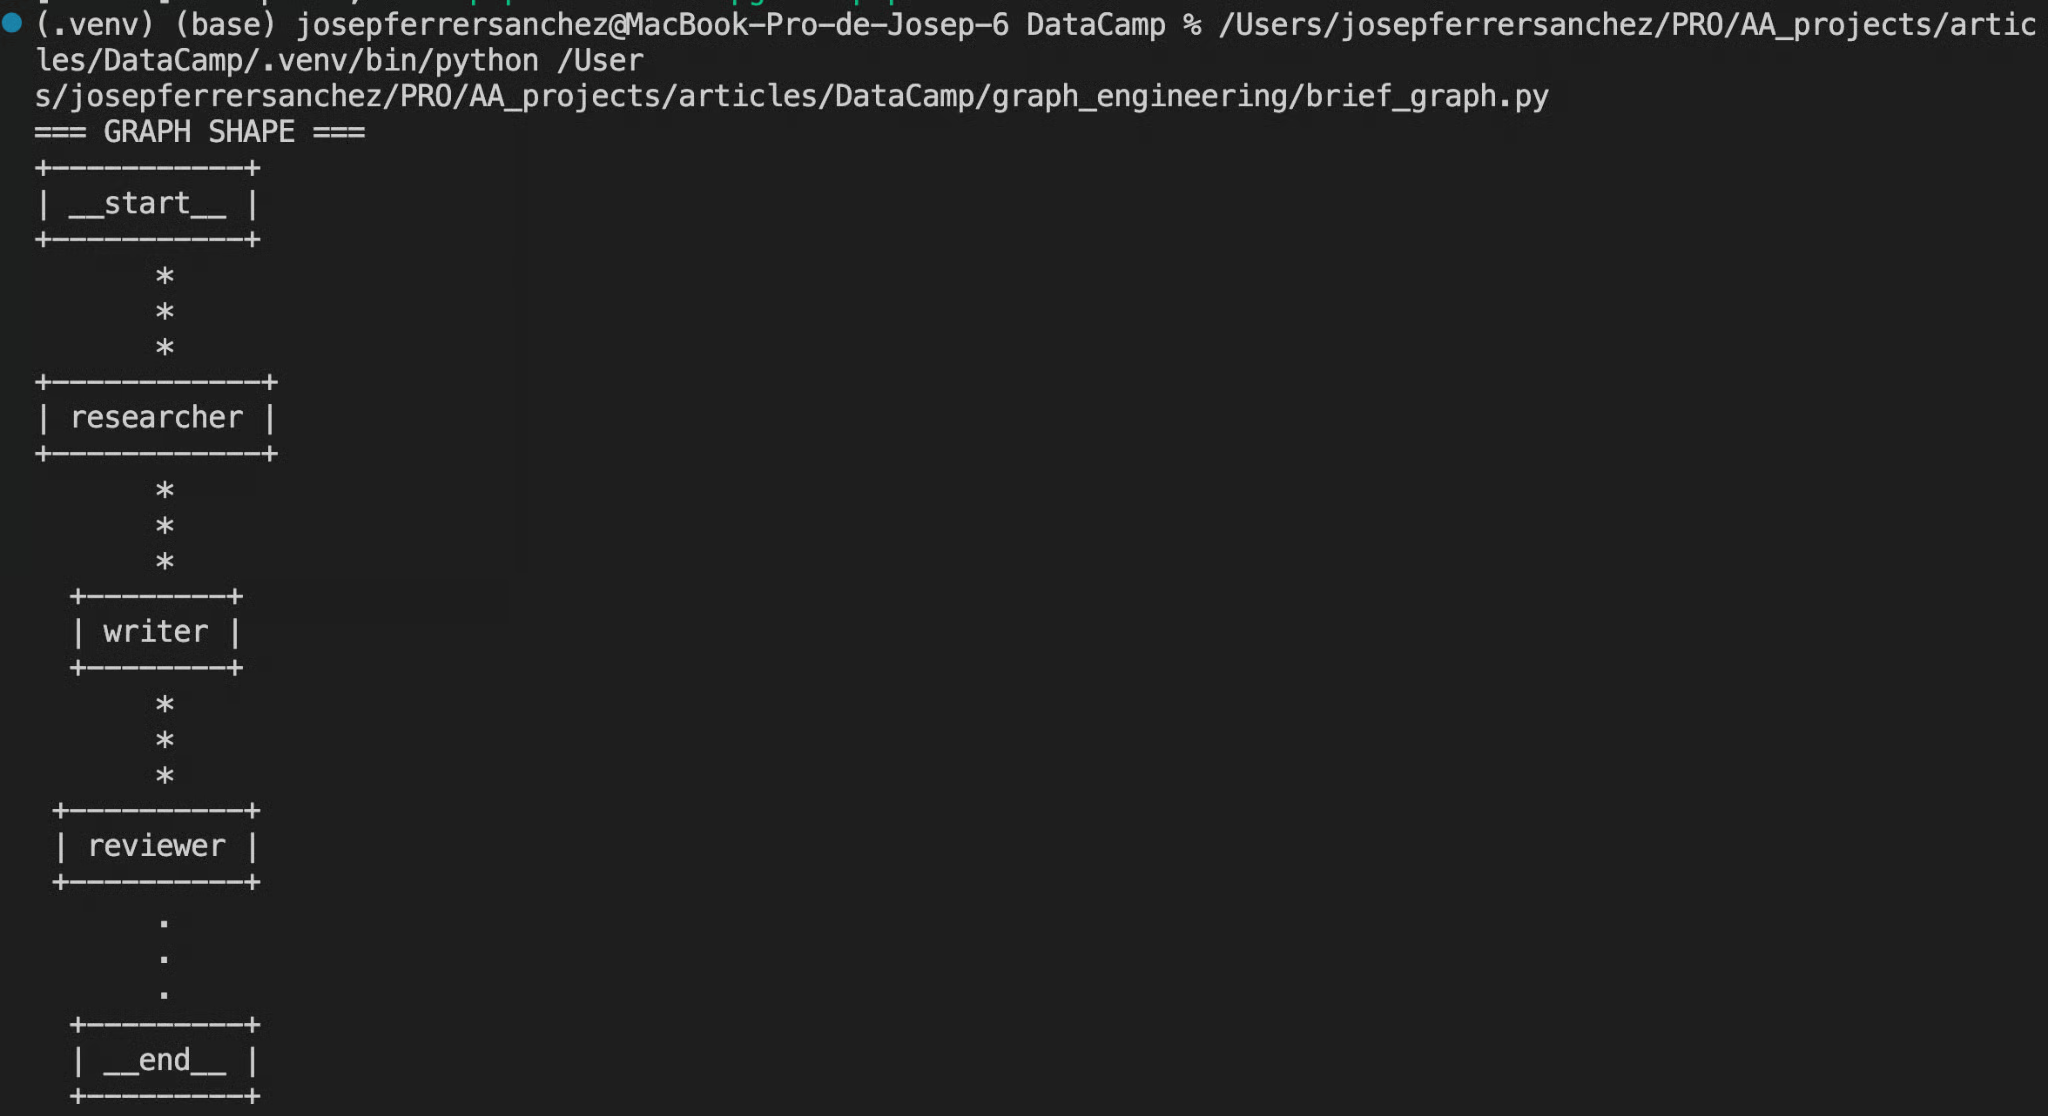
สกรีนช็อตโดยผู้เขียน เทอร์มินัลแสดงผล .draw_ascii() โดยมี __start__, researcher, writer, reviewer และ __end__ เรียงแนวตั้งเชื่อมต่อกัน
สำหรับดีบักแบบก้าวทีละขั้นพร้อมตรวจสถานะที่แต่ละโหนด LangGraph Studio เชื่อมต่อกับเซิร์ฟเวอร์โลคัล ต้องใช้แพ็กเกจและไฟล์คอนฟิกของตัวเอง จึง pip install "langgraph-cli[inmem]" เพิ่ม langgraph.json ที่ชี้ไปยังอ็อบเจ็กต์ graph ที่คอมไพล์แล้ว จากนั้นรัน langgraph dev และเปิด URL ของ Studio ที่พิมพ์ออกมา
คู่มือ LangGraph Studio ของเราพาเดินดูอินเทอร์เฟซ (ลงวันที่จากปี 2024 จึงควรตรวจขั้นตอนตั้งค่ากับคำสั่งด้านบน) และ บทเรียน LangGraph agents ครอบคลุมการเพิ่มเครื่องมือจริงให้โหนดแบบผู้วิจัยของเรา
หมายเหตุด้านสโคปหนึ่งข้อ
ไปป์ไลน์นี้เป็นลำดับ จึงไม่สาธิตการแผ่ออก ซึ่งเป็นแพทเทิร์นที่ผู้วิจัยจะคิวรีหลายแหล่งพร้อมกัน และโหนดรวมจะรวมผลลัพธ์
นั่นคือส่วนขยายธรรมชาติถัดไป และยังเป็นจุดที่ค่าใช้จ่ายพุ่งไวที่สุด
โหมดล้มเหลวใน graph engineering แบบ agentic AI เกิดซ้ำพอที่จะตั้งชื่อได้ ต่อไปนี้คือสามข้อที่ตรวจเสมอก่อนปล่อย
ทุกโหนดคือลูปในตัว มีพรอมป์ต์ เครื่องมือ และคำจำกัดความของความเสร็จ
เดินสายโหนดที่สั่นคลอน 3 โหนดเข้าด้วยกัน ให้ระบบที่สั่นคลอนพร้อมพื้นที่ผิวเพิ่มสามเท่าและเรื่องดีบักที่แย่ลงมาก
ทำให้โหนดเดียวทำงานดีลำพังก่อน
ผู้วิจัยที่คืนโน้ตเลือนลางเมื่อเรียกตรง ๆ ก็จะคืนโน้ตเลือนลางเมื่ออยู่ในกราฟ และผู้เขียนปลายน้ำจะเขียนต่ออย่างมั่นใจบนโน้ตนั้น
ต้านทานการยัดตรรกะไว้ในโหนดเมื่อมันควรอยู่บนเอจ
เงื่อนไขหยุด การตัดสินใจแยกกิ่ง และเพดานรีทไรคือการจัดเส้นทาง และการจัดเส้นทางควรอยู่ในฟังก์ชันเอจ ที่อ่านทั้งหมดได้ในครั้งเดียว
ใช้บททดสอบไม่มีสันธานจากก่อนหน้า
โหนดที่ค้นแหล่งข้อมูลและตัดสินว่าพอหรือยัง คือ 2 โหนดที่แชร์ซิกเนเจอร์ฟังก์ชัน
แผ่ออกและลูปรีทไรคูณการใช้โทเคนในแบบที่ไดอะแกรมซ่อนไว้หมด
แผ่ออก 5 ทางเข้าหาโหนดรวมที่มีเพดานรีทไร 3 ไม่ใช่ 5 คำเรียก และขึ้นกับตำแหน่งรีทไร มันอาจเป็น 15 หรือมากกว่านั้นก่อนนับโหนดรวม
ตั้งเพดานให้ชัดเจนเหมือนที่ทำกับ MAX_REVISIONS แล้วบันทึกจำนวนโทเคนต่อโหนดและอ่านหลังหนึ่งสัปดาห์ เพราะโหนดที่คิดว่าถูกมักเป็นโหนดที่รันบ่อยสุด
AutoGen ยังถูกแนะนำสำหรับ orchestration แบบกราฟ และงานทดลอง GraphFlow ก็เป็นงานก่อนหน้าอย่างแท้จริง แต่รีโพอยู่ในโหมดบำรุงรักษาตั้งแต่กันยายน 2026 ไม่มีฟีเจอร์ใหม่
Microsoft ชี้ผู้ใช้ใหม่ไปที่ Microsoft Agent Framework ซึ่งมีเวิร์กโฟลว์แบบกราฟของตัวเอง ผ่าน คู่มือย้าย ที่เผยแพร่แล้ว
ณ วันนี้ LangGraph, ADK ของ Google หรือ Microsoft Agent Framework เป็นตัวเลือกที่ปลอดภัยกว่า และคอร์ส Building AI Agents with Google ADK ครอบคลุม ADK อย่างลึก
Graph engineering คือชั้นประสานงานเหนือ loop engineering
โหนดทำงาน เอจตัดสินว่าจะรันอะไรต่อ และอ็อบเจ็กต์เดียวที่แชร์กันขนข้อมูลระหว่างกัน
ตัดเสียงรบกวนของไทม์ไลน์กรกฎาคม 2026 ออก ก็มีแค่นี้
ไปป์ไลน์ตั้งใจให้เล็ก: 3 โหนด คำประกาศเอจ 4 เส้น (หนึ่งเส้นเป็นแบบมีเงื่อนไขจึงวาดออกมาเป็น 2 สาขา) และเพดานการแก้ไขเพื่อไม่ให้รีทไรวิ่งหนีเรา
เท่านี้ก็พอจะให้ร่างถูกรีวิวโดยสิ่งที่ไม่ได้เป็นคนเขียน และคุณสมบัตินี้เองที่ลูปให้ไม่ได้
หยิบกราฟใช้เมื่อการงานแตกเป็นเฟสที่ต้องการผู้เชี่ยวชาญต่างกัน และไม่ควรก่อนหน้านั้นหนึ่งโหนด ผู้สงสัยทั้งหลายพูดถูกว่ากลไกเก่าแก่หลายทศวรรษ และบทความมากมายรอบคำนี้มีแต่เสียงรบกวน
พวกเขาก็ถูกในส่วนที่สำคัญในบ่ายวันอังคาร
ตัวตรวจอ่อนแอที่ผูกกับปัญหาแบบลูปจะไม่ดีขึ้นเพราะวาดกล่องเพิ่มรอบ ๆ
เพื่อนำแพทเทิร์นเหล่านี้ไปไกลขึ้น คอร์ส Multi-Agent Systems with LangGraph ครอบคลุมดีไซน์แบบ supervisor และแบบเครือข่ายที่บทเรียนนี้ยังไม่แตะ
สำหรับด้านข้อมูลของคำว่า graph แนะนำ Graph RAG with LangChain and Neo4j เป็นก้าวถัดไป หากต้องการอยู่ฝั่ง orchestration ให้ดู Text-to-Query Agents with MongoDB and LangGraph ที่สร้างไปป์ไลน์ LangGraph กับฐานข้อมูลจริง และ LLM Agents Explained เติมสถาปัตยกรรมใต้ทุกอย่างนี้
สคริปต์ฉบับเต็มอยู่ใน รีโพ GitHub ของฉัน พร้อมตัวช่วยเรนเดอร์กราฟและบันทึกสั้น ๆ ว่าแต่ละการรันมีค่าใช้จ่ายเท่าไร
หลักสูตรเด่นจาก DataCamp
Courses
Courses
Courses