Courses
LangGraph で学ぶ Multi-Agent Systems
2時間45分
8.6K
エージェントに仕事を1つ任せればうまくやる。3つ任せるとどうなるかは、2回目の引き継ぎあたりで見えてくる。最初の手順で見つけたことを忘れ、自分の下書きに甘い採点をし、出力が未完成のまま成功を宣言する。
このパターンをめぐる議論が過熱したのが2026年7月中旬。「グラフエンジニアリング」がX(旧Twitter)でバズり、タイムラインは、エージェントループの終焉を宣言する人々と、その言葉をコンテンツ量産用のフィラーだと切り捨てる人々に、瞬時に割れた。
私見では、「グラフエンジニアリング」というラベル自体は任意だが、背後にあるエスカレーションは任意ではない。その理由を、コードを書く前にできるだけ納得感をもって示したい。
今月つくるものの大半は、依然として単一のループで十分だ。1つで済む仕事に6個の箱を描いた図から着手するのは、1週間を無駄にする最短ルートである。
エージェントグラフは3つの要素からなる。
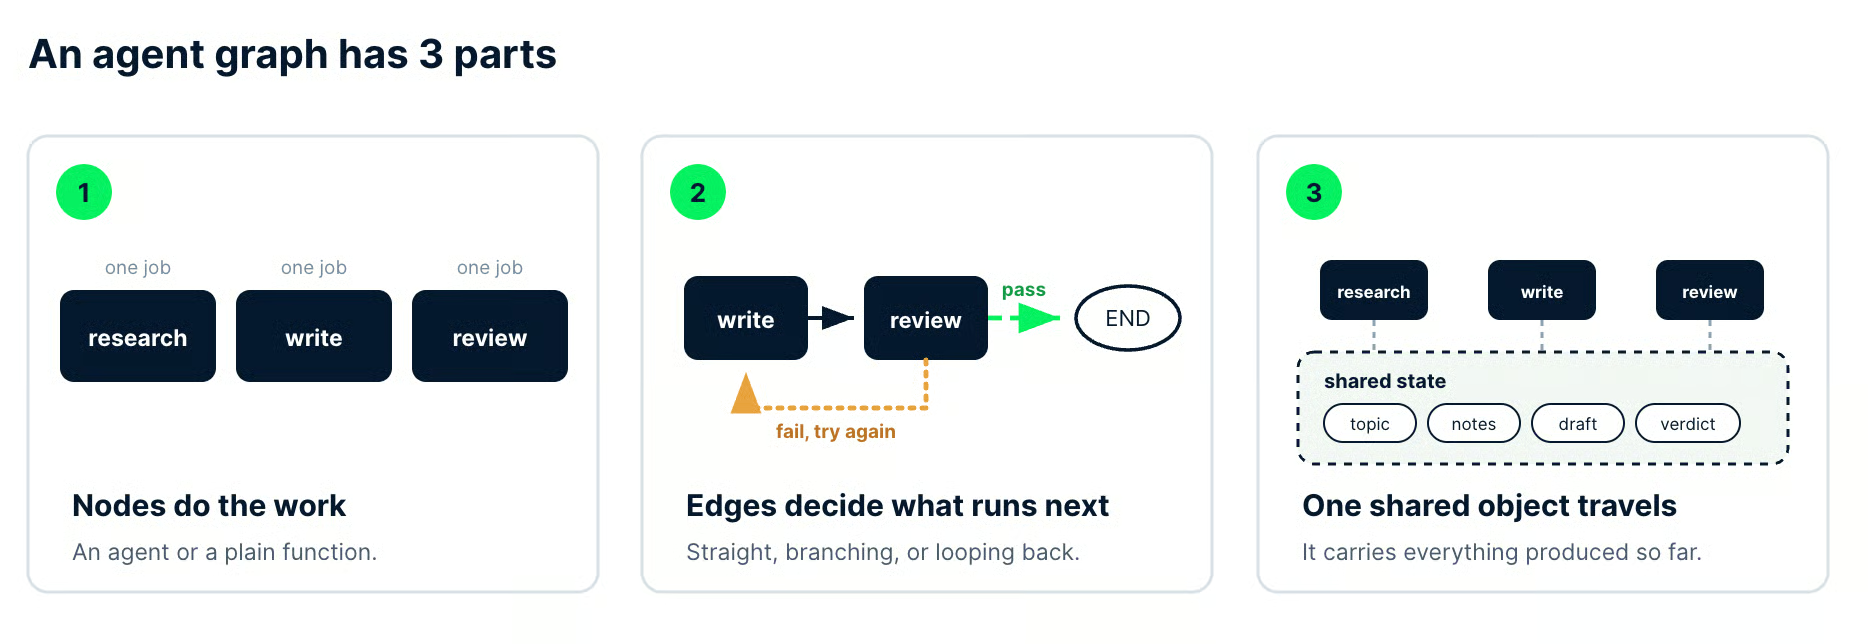
筆者作成。後で構築するパイプライン上に示した3要素: 名称付き3ノード、passエッジとretryエッジ、そしてtopic・notes・draft・verdictを集約する1つのstateオブジェクト。
単一エージェントに経路の即興を任せず、最初にこの3つを明示的に宣言する——それを指してグラフエンジニアリングと呼ぶ。
本チュートリアルでは、LangGraphを用い、研究者・ライター・レビュアーから成る実働パイプラインをPythonで構築する。失敗した下書きを差し戻すための条件付きエッジも含める。
必要なのはPython、pip、そして大規模言語モデル(LLM)やAIエージェントに関する基本知識。エージェントが初めてなら、Introduction to AI Agentsコースで本稿が前提とする概念を、LangGraph agentsチュートリアルで手を動かす部分を補ってほしい。
グラフエンジニアリングとは、エージェントシステムの制御フローをモデルの判断に委ねず、コード上で明示する実践である。
どの専門ワーカーが存在するのか、どの遷移が許されるのか、その遷移に沿ってどんな情報が運ばれるのかを宣言する。
エージェントは依然として自由に推論する。ただし、仕事全体ではなく1つのノード内部で行う。
この最後の一文が、違いのすべてだ。
ループでは、目標と品質基準を設定し、エージェントがそれらを満たすための経路を自ら選ぶ。グラフでは、経路とチェックポイントを固定し、モデルの自律性を、差分で読める構造の範囲内に収める。
このラベルがXで大きく騒がれたのは2026年7月だが、起源はそこでない。CodiumAI(現Qodo)のItamar Friedmanは2024年2月に、"prompt engineeringからflow(/graph)engineeringへのシフト"を語り、チームのAlphaCodium論文で数値を示した。
CodeContestsのvalidationセットにおけるGPT-4のpass@5精度は、よく設計された単一プロンプトの19%から、マルチステージ・フローで44%へ上がった。いずれも1問あたり5回試行であり、単発ではない。
2026年7月に起きたのは拡声だ。
7月18日、Peter SteinbergerがXで問いかけた。「まだループの話をしている?それとももうグラフに移った?」。その1週間前、Mike Massonが、prompt、context、harness、loop、graphという梯子を投稿していた。この問いは310万回表示され、既に使われていた語が一気に広まった。
反発も速かった。LangGraphを生んだチームの共同創業者、LangChainのHarrison Chaseは、「結局ただのlanggraphなのでは?」と問い返した。
逆側からはDale Everettが、ループは常に1ノードのグラフなのだから、7月の熱狂は古い地面の再発見だと主張。LangChain自身の回顧3 Years of Graph Engineering with LangGraphも同趣旨で、エージェントグラフを3年前から築いてきたパターンとして位置づける。
私はこの用語を、有用な略記の棚に入れている。
これによって、これまでフレームワークのドキュメントに埋もれていた設計上の論点に共通の名前が与えられた。プルリクでアーキテクチャを議論する時、名は労に報いる。
グラフエンジニアリングは実行構造を指す。ゆえに、語彙を借りているが別物の2つと区別される。
ナレッジグラフとGraphRAGはデータを記述する。
ドキュメントを実体と関係に変換し、検索システムが事実間のつながりを辿れるようにする。そのためのツール、ストレージ、評価指標はすべて異なる。
この側面に関しては、ナレッジグラフでRAGアプリを実装するチュートリアルが出発点として適切で、グラフ理論入門が両者の基礎にある数学をカバーしている。
2つ目は、新しい能力ではないという点。
LangGraph、GoogleのAgent Development Kit(ADK)、Microsoft AutoGenはいずれも、このラベルがバズる前からマルチエージェント・オーケストレーションを提供している。StateGraphを書いたことがあるなら、すでにやっていたはずだ。
多くの読者は、「自分のLangGraphパイプライン」という名前で、この1年グラフエンジニアリングをしていたと気づくだろう。
AIエンジニアリングの各層は、モデルから一歩外側の何かを制御する。
この表は、右列から読むのが有益だ。飛ばした段が、上に積もうとした時に実際に何を壊すのかがわかる。
| 層 | 制御するもの | 飛ばすと何が壊れるか |
|---|---|---|
| Prompt | 依頼の言い回し | モデルが、頼んでもいない質問に答える |
| Context | モデルに届く入力 | 的はずれな材料に対して優れた推論をする |
| Harness | ツール、メモリ、ファイルとAPIのアクセス | チャット画面の外に一切触れない |
| Loop | 完了まで繰り返すサイクル | 早すぎる停止、あるいは永久に止まらない |
| Graph | 次にどのワーカーが、何に対して動くか | 1つのエージェントが4役を演じ、3つを忘れる |
段を飛ばすのは、グラフ案件が失敗する最も一般的な理由であり、その失敗は往々にして見えづらい。
不安定なノードを3つ束ねても、安定したシステムの平均にはならない。
失敗箇所は増え、1回あたりのコストは上がり、原因ノードから2回の引き継ぎを経た先で悪い出力が現れるため、診断に時間がかかる。
ノード数が3であれ30であれ、どのエージェントグラフもノード・エッジ・共有状態に分解できる。
この3つをコードベースの中で指さして言えるようになれば、多くのオーケストレーションフレームワークはドキュメントなしでも読めるようになる。
ノードは、名前と単一責任を持つ1単位の仕事である。
専門プロンプトと独自ツールを持つLLM呼び出しでもいいし、データベースを叩き、スキーマを検証し、ファイルを書く普通のPython関数でもよい。
意味判断が必要な手順にのみ、モデル呼び出しを割り当てる。
答えが決まっている規則はPythonに入れる。マイクロ秒で動き、コストはかからず、同じ入力には同じ結果を返す。
分割すべきかの判断には、私は次のテストを使う。接続詞なしの1文でそのノードを説明してみること。
「情報源を取得し、十分かどうか判断する」ノードは既に落第だ。取得と判断を分けずに、どちらか一方だけを差し替えることができないからだ。
エッジは、現在のノードが終わったあと、何を走らせるかを決める。
4つの形で、ほとんどの構成をカバーできる。
停止ロジックの置き場もエッジだ。リトライ上限、品質ゲート、エスカレーション規則はすべてルーティング判断であり、エッジ関数にまとめておけば、制御フローをノード本体を漁らずに一箇所で監査できる。
共有状態は、実行の進行に合わせて、すべてのノードが読み書きする単一のオブジェクトである。
これがないと、隣接する仕事をするエージェントが互いに何も渡さず、ライターはリサーチ結果を見られず、レビュアーもまた見られない。
LangGraphでは、状態はたいていTypedDictだ。
我々の状態は、トピック、リサーチャーのノート、現在の下書き、レビュアーの評定とフィードバック、改稿回数を蓄積する。各ノードは自分が変更したフィールドだけを返し、フレームワークがそれを走行中のオブジェクトへマージする。
書き込み権限こそ、グラフが最初に崩れる場所だ。
どのノードがどのフィールドを書けるのか、コードを書く前に決めること。3つのノードが上書きできる状態オブジェクトは、すでに予約済みのデバッグセッションである。
ループエンジニアリングは、単一のエージェントが完了まで繰り返すサイクルを設計し、グラフエンジニアリングは、そのようなサイクル同士の調整を設計する。
この記事で最も重要な判断なので、チュートリアルの前に置く。
デフォルトの答えはループだ。
きちんとスコープされた単一エージェントに厳格な検証器を付けたものは、同じ仕事をするどんなグラフよりも、構築が速く、実行が安く、デバッグがはるかに容易だ。
これは単なる好みではない。
UCバークレーのチーム(筆頭著者Mert Cemri)は、マルチエージェントの利得が単一エージェント構成に対してしばしば最小であるという観察から出発し、7つのマルチエージェントフレームワークから1,600超の実行トレースに注釈を付け、原因を探った(arXiv:2503.13657, v3)。
150本を精読して作られたタクソノミーは、14の異なる失敗モードに名前を与える。
その14は、システム設計上の問題、エージェント間の不整合、タスク検証の3カテゴリに分類される。
3つ目は、レビュアーノードに到達するまで覚えておいてほしい。
チェックリストではなく、トリガーとして扱ってほしい。
右列の明確な「はい」が1つあれば十分で、曖昧な5つは不十分だ。
| タスクに関する質問 | ループで足りる | グラフが欲しい |
|---|---|---|
| 仕事を1つの指示で書けるか? | はい。人が最初から最後まで従える | 2つの異なる役割間の引き継ぎのように読める |
| すべての手順が同じモデルを望むか? | 全工程で1つのモデルと1組のツール | 収集は安く速く、判断は鋭さが要る |
| 相互に依存しない手順があるか? | 各手順が直前の出力を必要とする | 並行で走らせられる複数の参照がある |
| 十分な出来か誰が決める? | エージェントが自分の成果を読み直す | 書いていない何かが承認しなければならない |
| 手順が失敗したらどうすべき? | リトライして続行する | 失敗を封じ込み、残りの実行を生かす |
| 実行経路を監査する必要があるか? | トレースは自分とチーム向け | 外部の誰かが、どの手順がなぜ走ったかを見る必要がある |
私が最もよく遭遇する過剰設計は、エージェントですらない案件だ。800のホテル住所リストのクレンジングとジオコーディングが必要だというのに、ローダー、ノーマライザー、ジオコーダー、バリデーター、ライターという5ノードのグラフで届く。共有状態がそれらを貫いている。
それぞれの手順は決定的なので、実際にできあがっているのは、フレームワークを着せた40行のPythonスクリプトだ。今や1行ごとにお金がかかり、pandasなら起きない壊れ方をする。
適正サイズ版が、これから作るものだ。
短いリサーチ済みブリーフの作成は、単一ループが苦手とする仕事に分かれる。生素材の収集、それを文章にすること、そして書き手の外からその文章を評価することだ。
3つ目がグラフの存在理由である。自分の下書きを自分でレビューするのは、レビューではないからだ。
ノードを正当化するのは3つ。
追加した各ノードについて、このうち1つを指し示せないなら、そのノードを削除して隣に畳み込む。
まず本物の専門化。
我々のリサーチャーは安価で速いモデルと(本番では)検索ツールを望む。ライターはそれらを望まず、より強いモデルの恩恵を受ける。ゆえにこの分割は、図を飾るのではなく仕事をしている。
次に、実際に体感できる並列性。
ファンアウトは、枝が独立していて壁時計の短縮が誰かにとって意味がある時に効く。一方で、そのどちらも真でないなら、複雑さが余計にのしかかる。
3つ目、そして私が最も強く擁護するのが、独立した検証だ。
自分の宿題を自分で採点するエージェントは甘い。したがって、下書きに対する読み取り専用アクセスだけを持つ別のレビュアーノードは、たいていどのグラフでも最も価値がある。
フレームワークレベルで各ライブラリがこれらのパターンをどう表現するかは、CrewAI vs LangGraph vs AutoGenの比較がトレードオフを整理している。
研究者・ライター・レビュアーで構成されるLangGraphのマルチエージェントパイプラインを作り、短いリサーチ済みブリーフを生成し、失敗した下書きを改稿に差し戻す。
LangGraphはステートフルなエージェント向けの低レベル・オーケストレーションフレームワークであり、そのStateGraphは、前節のノード・エッジ・状態にほぼ一対一で対応する。
以下のすべては、2026年9月時点でlanggraph 1.2.11とlangchain-anthropic 1.7.1で検証した。
ライブラリが初めてなら、LangGraphチュートリアルで基礎を確認してほしい。本節はテンポが速い。ファミリー内の役割分担は、LangChain vs LangGraph vs LangSmith vs LangFlowが整理する。
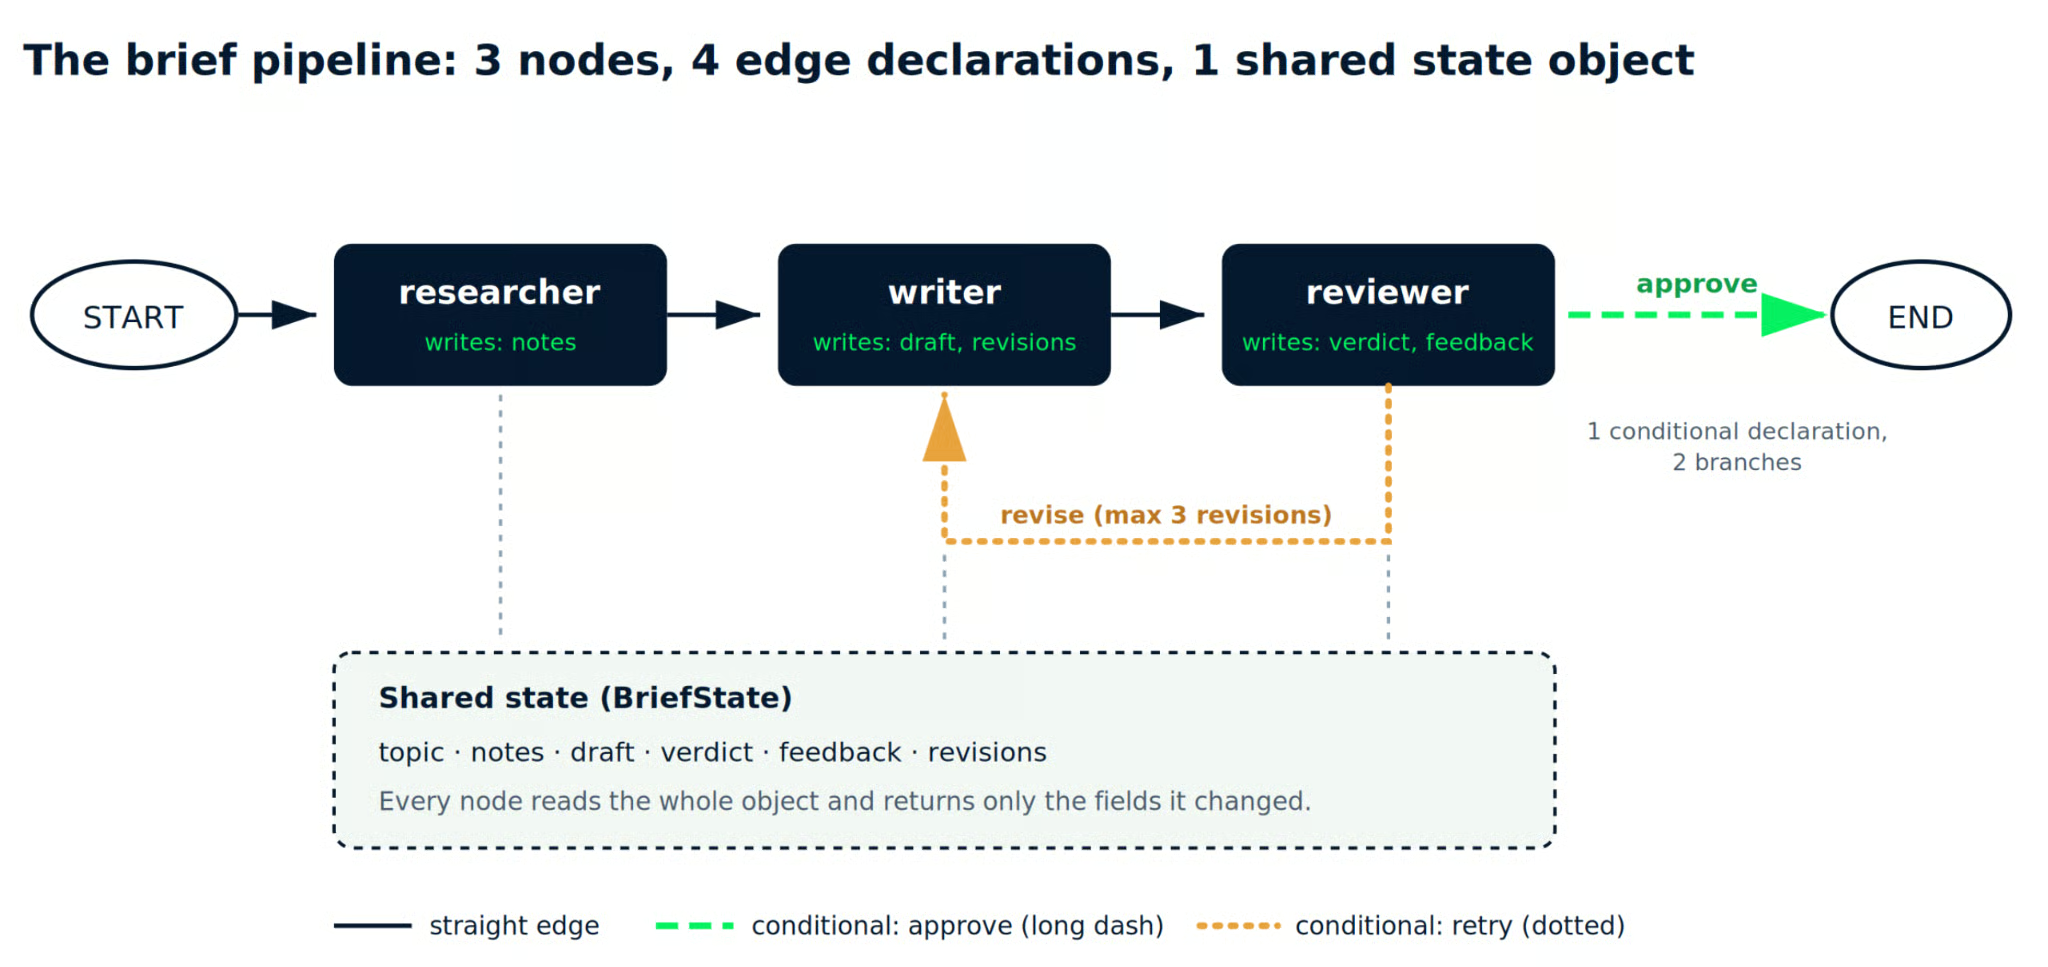
筆者作成。これから構築するパイプライン。実線は3つの直列エッジ。破線と点線は、1つの条件付きエッジの2分岐。
パッケージをインストールする。キーをソースから分離するためpython-dotenvも入れる。
pip install langgraph langchain-anthropic python-dotenvスクリプトと同じ場所に.envファイルを作る。
ANTHROPIC_API_KEY=sk-ant-your-key-hereではインポートと状態スキーマ。TypedDictを先に書く2分は価値がある。全ノードが合意する契約になるからだ。
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
1つではなく2つのモデル。これは判断表の「手順ごとに異なるモデル」のトリガーがコードに現れた例だ。リサーチは大量で低判断の仕事なので高価なモデルは不要。
MAX_REVISIONSは目立たないが重要だ。
上限がなければ、厳格なレビュアーと頑固なライターが下書きを延々と行き来させ、請求書が面白いことになる。
各ノードは同じ契約に従う。現在の状態を受け取り、1つの仕事を果たし、変更したフィールドだけを含む辞書を返す。
リサーチャーは生素材を集め、notesに書き込む。
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
本番では、このノードはモデルの知識に頼らず検索ツールを呼ぶだろう。
ここではグラフ構造が見えるよう.invoke()を1回にとどめた。出てくるノートは未検証として扱ってほしい。
ライターはノートを読み、下書きを作る。同時にレビュアーのフィードバックを確認し、リトライエッジが働けるようにする。
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
レビュアーは下書きを採点する。
書き手の推論を見ておらず、文面も産んでいないため、結果に対して容赦なくなれる。
これが、バークレーのタクソノミーにおける3番目の失敗カテゴリを1ノードとして与えた理由だ。
タスク検証は、独立したチェックがなければ破綻する。ゆえに、自己採点をできないワーカーを置くのが解決策になる。
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
return {"verdict": verdict, "feedback": text}3ノードすべてで.contentではなく.textを使っている点に注意。
どちらも単純な応答では文字列を返すが、.textは応答が複数のコンテンツブロックで届く場合にも正しく扱う。後でAttributeError: 'list' object has no attribute 'strip'に困らずに済む。
評定を1行目からパースするのは読みやすいが、脆い。
無人運転にするなら、文字列判定はLangChainの構造化出力に置き換え、モデルの気まぐれなプレフィックスではなく、型付きフィールドとして評定を受け取るべきだ。
ルーティング関数が条件付きエッジだ。レビュアー実行後の状態を読み、次に何が起きるべきかの名前を返す。
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
return "writer"この関数は黙らせておくこと。中でprint()すると、ストリームループが前のチャンクを出力中にstdoutへ流れ、上限制御の通知が1手早く出て、トレースの順番が狂って見える。
改稿上限はノード内ではなくここに置く。停止は制御フロー上の判断であり、制御フローはエッジに属するからだ。
ではグラフを組み立てる。ノード、エッジ、そしてコンパイルの順。
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile().add_conditional_edges()の第3引数はパスのマップだ。
ルーティング関数が返しうる行き先をすべて列挙し、LangGraphは、どのノードもまだ走っていなくても、その分岐を図示できる。
初期状態を与えてコンパイル済みグラフを呼び出す。topicとrevisionsだけ値があればよい。残りは実行の流れに沿って埋まる。
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
得られるのは最終状態だけだ。行き違った時の手がかりとしては心許ない。
.invoke()を、各ノードが自分の書き込みを報告する.stream()(stream_mode="updates")に置き換える。どちらも別個の実行で独自にモデルを呼ぶので、両方を続けては使わないこと。
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
初稿をレビュアーが却下した実行では、次のように出る。
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
最終状態では見えない2点が見える。
リサーチャーは1回だけ走り、そのノートは2度の執筆を通じて保持された。つまりリトライは再リサーチをしない。また各ノードは自分のフィールドにしか触れていない。先ほどの「書き込み権限」ルールが、検証可能な形になっている。
この機会に呼び出し回数も数えておこう。
却下パスはモデル呼び出しが5回。対して同じ仕事の単一ループ版はおおよそ1回だ。余分な4回が価値を生んだかどうかは、評定をログに取り、実際に読む以外にわからない。
形を見るのに追加ツールは要らない。
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid()) # paste into any Mermaid rendererMermaidの出力では、reviewerから__end__とwriterへの条件分岐が破線で描かれる。
モデル呼び出しにお金を使う前に、リトライエッジが存在することを確認できる。ASCIIビューは開始から終了までの直列経路だけを描くので、ループを見たい時はMermaid出力を使う。
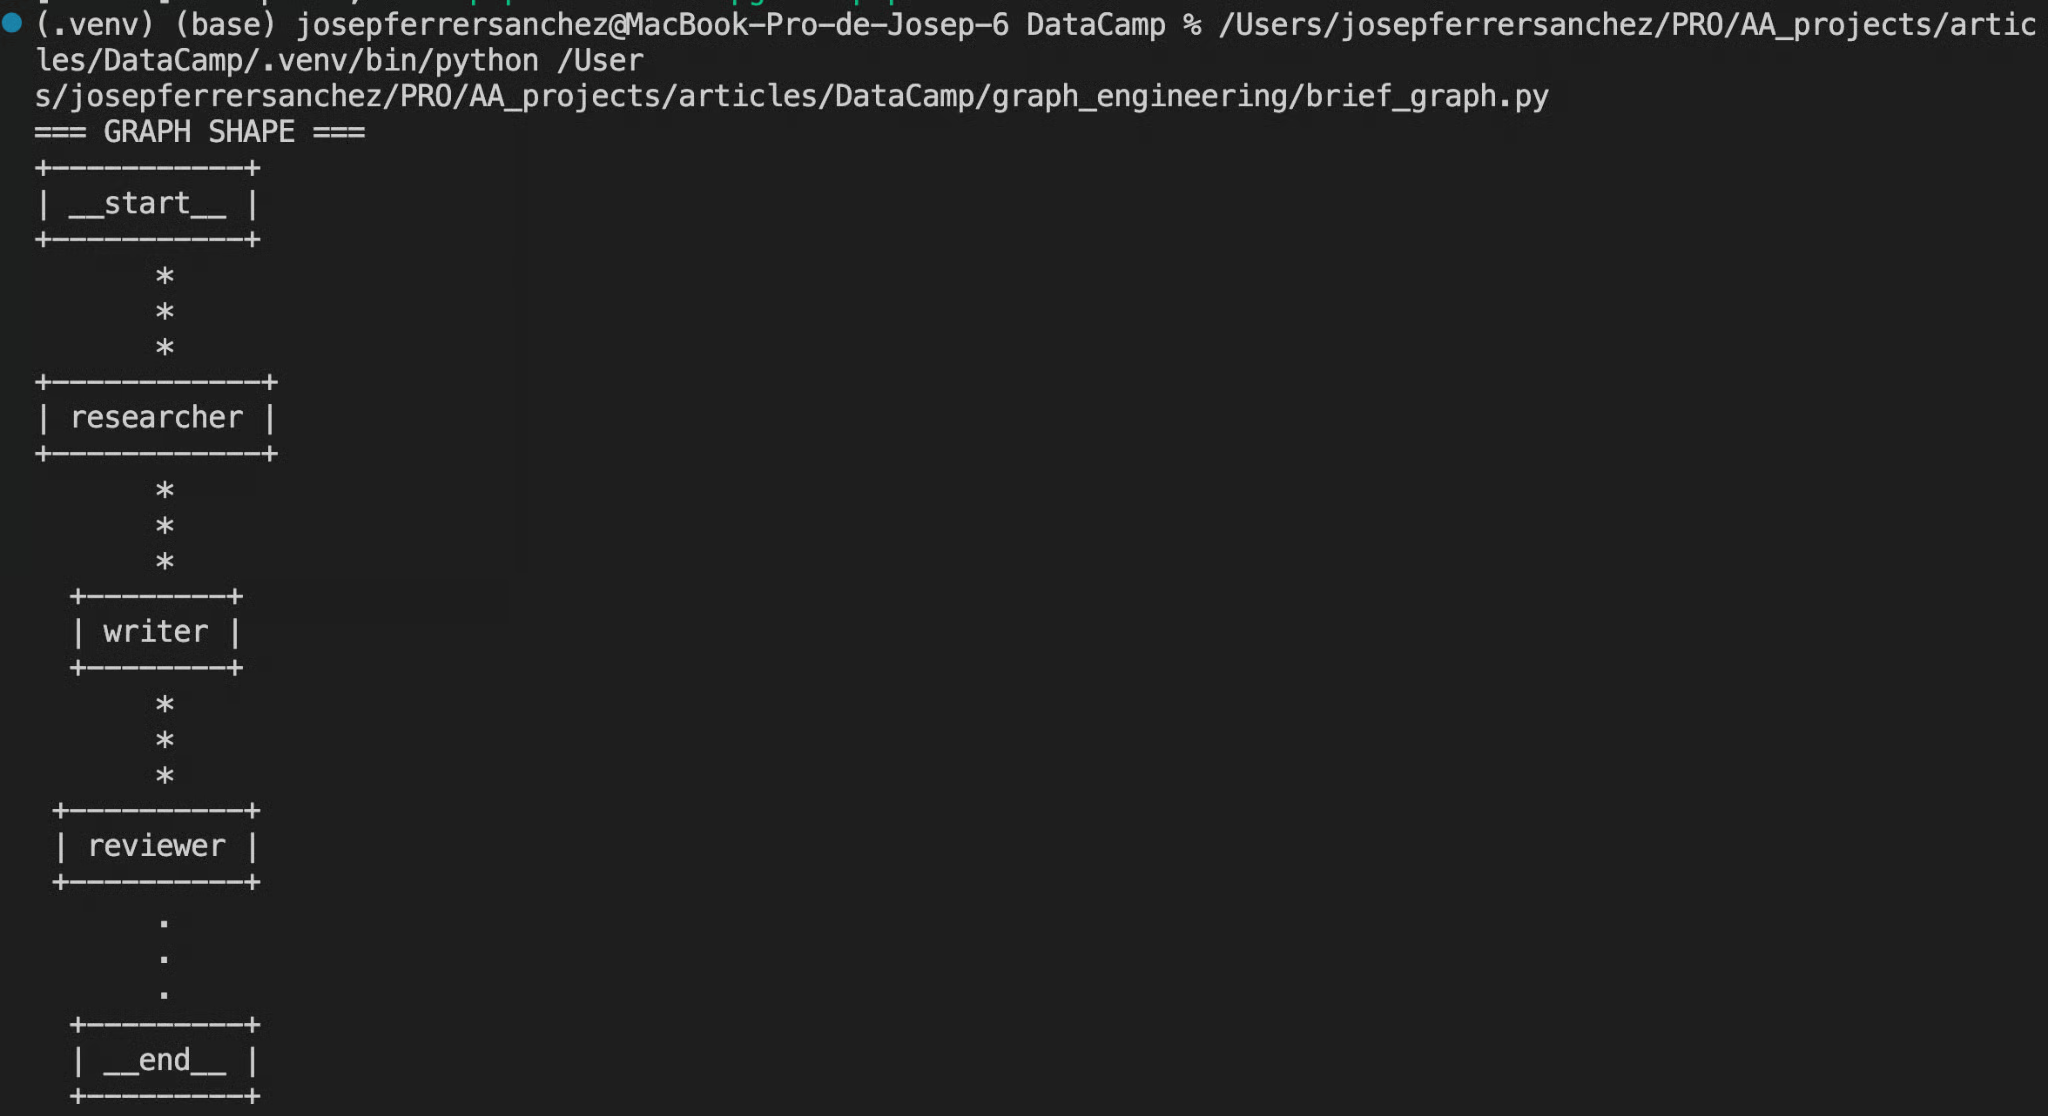
筆者撮影。ターミナルに表示された .draw_ascii() の出力。__start__、researcher、writer、reviewer、__end__が縦に積まれて接続。
ノードごとの状態確認をしながらのステップ実行には、LangGraph Studioがローカルサーバーに接続する。専用パッケージと設定ファイルが必要なので、pip install "langgraph-cli[inmem]"を実行し、コンパイル済みのgraphオブジェクトを指すlanggraph.jsonを追加、langgraph devを実行して表示されるStudioのURLを開く。
LangGraph Studioガイドでインターフェースを解説している(2024年の記事なので、セットアップ手順は上記コマンドと付き合わせて確認を)。LangGraph agentsチュートリアルでは、今回のリサーチャーのようなノードに実ツールを追加する方法も扱う。
スコープに関する注意を1つ。
このパイプラインは直列で、ファンアウト(例えばリサーチャーが複数ソースを同時に問い合わせ、ジョインノードで結果をマージする)を示さない。
それは自然な次の拡張であり、同時にコストが最速で増える場所でもある。
エージェントAIのグラフエンジニアリングでの失敗パターンは、名前を付けられるほど繰り返される。出荷前に必ず見るのはこの3つだ。
各ノードは、それ自体が1つのループであり、プロンプト、ツール、完了定義を持つ。
3つの不安定なノードを配線すると、表面積が3倍でデバッグがはるかに厄介な、不安定なシステムができあがる。
まず1ノードを単体で動かし切る。
単体呼び出しで曖昧なノートしか返さないリサーチャーは、グラフ内でも曖昧なノートを返し、下流のライターはそれに自信満々で積み上げる。
ノードに入れたくなるロジックでも、エッジに属するものは抵抗して外に出す。
停止条件、分岐判断、リトライ上限はルーティングであり、エッジ関数に置けば、すべてを一望できる。
先の「接続詞なしテスト」を適用する。
情報源を検索して十分かどうか判断するノードは、関数シグネチャを共有する2つのノードである。
ファンアウトとリトライループは、図では完全に隠れる形でトークン使用を乗算する。
5分岐のファンアウトが、3回リトライ上限のジョインノードに流れ込む場合、それは5回の呼び出しではない。リトライ位置によっては、ジョインを数える前に15回以上になる。
明示的に上限を設定する(今回のMAX_REVISIONSのように)。その上で、ノードごとのトークン数をログに取り、1週間後に読む。安いと思い込んでいたノードが、実は最も頻繁に走っていることが多い。
AutoGenは今でもグラフオーケストレーションで勧められることがあるし、実験的なGraphFlowは確かに先行事例だったが、リポジトリは2026年9月時点でメンテナンスモードにあり、新機能はない。
Microsoftは新規ユーザーをMicrosoft Agent Frameworkへ誘導しており、グラフ型ワークフローを持つ。移行は公開されたガイドがある。
現時点で安全な選択肢は、LangGraph、GoogleのADK、Microsoft Agent Frameworkだ。ADKはコースBuilding AI Agents with Google ADKで詳しく扱っている。
グラフエンジニアリングは、ループエンジニアリングの上に載る調整レイヤーだ。
ノードが仕事をし、エッジが次の実行を決め、1つの共有オブジェクトが情報を運ぶ。
2026年7月のタイムラインの雑音を取り除けば、モデルはそれだけである。
今回は意図して小さく保った。3ノード、4つのエッジ宣言(うち1つは条件付きなので図では2分岐)、そしてリトライ暴走を防ぐ改稿上限。
それだけの構造で、書き手とは別の何かによるレビューを実現できた。これこそ、ループでは提供できなかった性質だ。
仕事が異なる専門家を要する段階に分かれる時にだけ、グラフを手に取る——それより1ノードでも早くはしない。懐疑派が言うとおり、仕組み自体は何十年も前からあり、用語を巡る文章の多くはノイズだ。
そして、火曜の午後に効く大事な点でも彼らは正しい。
ループ型の問題に弱い検証器を付けても、箱を増やしただけでは良くならない。
さらに踏み込みたいなら、Multi-Agent Systems with LangGraphコースで、本稿が扱わなかったスーパーバイザやネットワーク設計を学べる。
語のデータ側に進むなら、Graph RAG with LangChain and Neo4jが次の一歩として良い。オーケストレーション側にとどまるなら、Text-to-Query Agents with MongoDB and LangGraphは実データベースを相手にLangGraphパイプラインを構築し、LLM Agents Explainedがその基盤となるアーキテクチャを補完する。
完成版スクリプトは私のGitHubリポジトリにあり、グラフ描画のヘルパーと、各実行のコストに関する短いメモを付けてある。
Top DataCamp Courses
Courses
Courses
Courses