
Cours
Systèmes multi‑agents avec LangGraph
2 h 45 min
8.6K
Confiez une tâche à un agent, il s'en sort. Donnez-lui trois missions, et observez le passage de relais : il oublie ce qu'il a trouvé à l'étape 1, s'autoévalue avec indulgence, puis annonce la réussite alors que la sortie n'est pas terminée.
Le débat autour de ce schéma a explosé mi-juillet 2026, quand le « graph engineering » a débarqué sur X (ex-Twitter) et que la timeline s'est aussitôt divisée entre ceux proclamant la fin des boucles d'agents et ceux qualifiant le terme de bruit pour ferme à contenu.
Mon opinion : l'étiquette « graph engineering » est optionnelle, l'escalade sous-jacente ne l'est pas. Je vais tenter de le justifier avant d'écrire la moindre ligne de code.
La plupart de ce que vous construirez ce mois-ci devrait encore être une seule boucle, et la façon la plus rapide de perdre une semaine est de dessiner un schéma à 6 cases pour un travail qui n'en nécessitait qu'1.
Un graphe d'agents réunit 3 éléments :
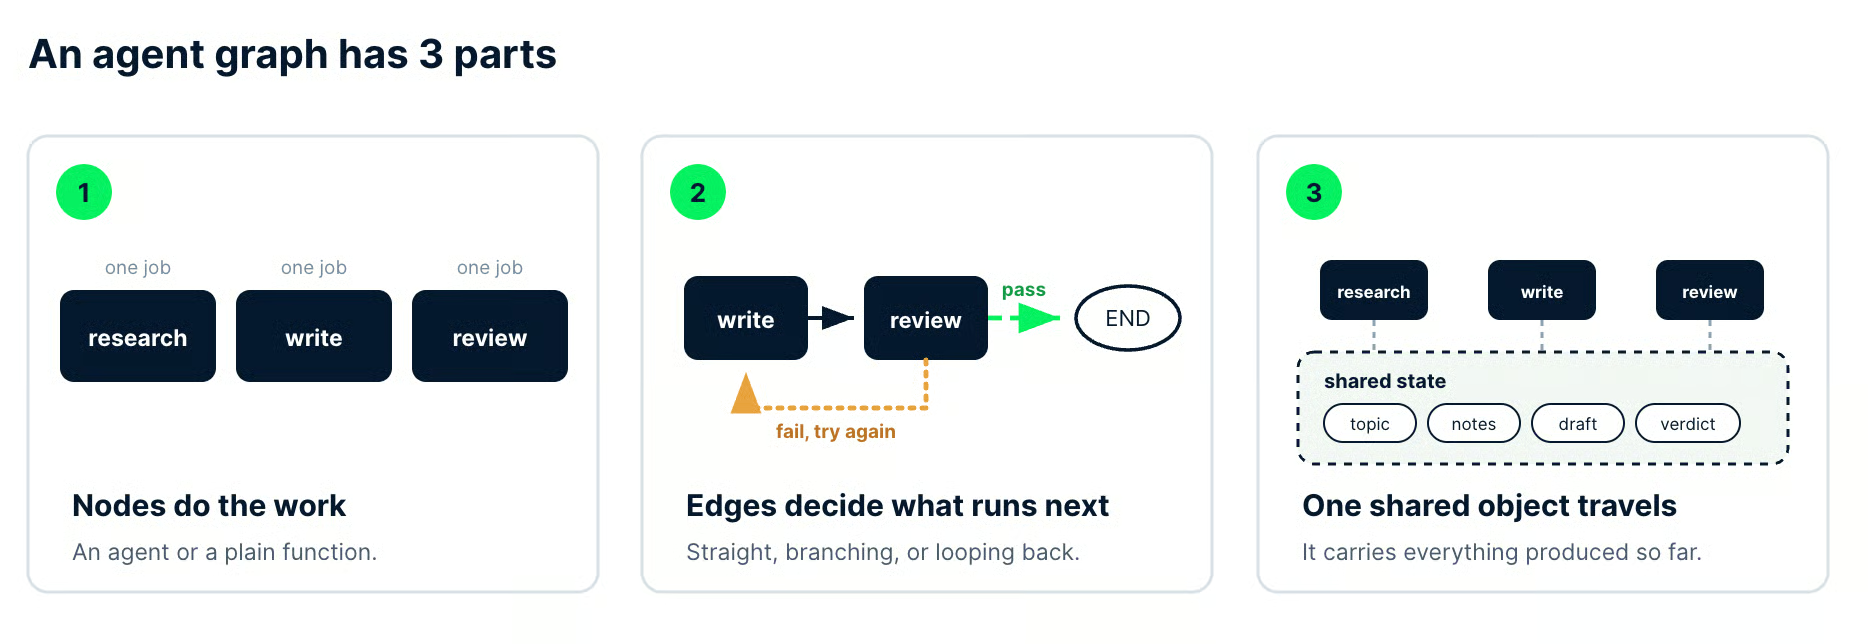
Image de l'auteur. Les 3 parties illustrées sur le pipeline que nous construirons plus loin : 3 nœuds nommés, une arête « pass » et une arête de révision, et un objet d'état qui collecte le sujet, les notes, le brouillon et le verdict.
Déclarer ces 3 éléments à l'avance, au lieu de laisser un agent improviser son propre chemin, c'est précisément ce que recouvre le terme graph engineering.
Ce tutoriel met en place un pipeline opérationnel chercheur, rédacteur et relecteur en Python avec LangGraph, incluant une arête conditionnelle qui renvoie les brouillons refusés en révision.
Vous aurez besoin de Python, de pip, et d'une certaine familiarité avec les grands modèles de langage (LLM) ou les agents IA. Si les agents sont nouveaux pour vous, notre cours Introduction to AI Agents couvre les concepts supposés par cet article, et notre tutoriel sur les agents LangGraph couvre la partie pratique.
Le graph engineering consiste à rendre explicite en code le flux de contrôle d'un système d'agents, plutôt que de l'abandonner au jugement du modèle.
Vous déclarez quels travailleurs spécialisés existent, quelles transitions entre eux sont autorisées, et quelles informations circulent le long de ces transitions.
L'agent raisonne toujours librement, mais à l'intérieur d'un nœud, pas à l'échelle de toute la mission.
Cette dernière phrase fait toute la différence.
Dans une boucle, vous fixez un objectif et un niveau de qualité, et l'agent choisit sa propre route pour les atteindre. Dans un graphe, vous figez la route et les points de contrôle, donc l'autonomie du modèle est bornée par une structure lisible dans un diff.
Le terme a fait du bruit sur X en juillet 2026, mais il n'a pas commencé là. Itamar Friedman de CodiumAI (devenu Qodo) décrivait déjà en février 2024 un passage « from prompt engineering to flow (/graph) engineering », et le papier AlphaCodium de son équipe l'a quantifié.
La précision pass@5 de GPT-4 sur l'ensemble de validation CodeContests est passée de 19 % avec une seule invite bien conçue à 44 % avec un flux multi-étapes. Il s'agit de 5 tentatives par problème dans les deux cas, pas d'un tir unique.
En juillet 2026, il y a surtout eu amplification.
Le 18 juillet, Peter Steinberger demandait sur X : « Parle-t-on encore de boucles ou a-t-on déjà basculé vers des graphes ? », une semaine après que Mike Masson a posté l'échelle prompt, contexte, harnais, boucle, graphe. La question a fait 3,1 millions de vues, et l'expression qu'elle a propagée existait déjà.
Les critiques n'ont pas tardé. Harrison Chase, cofondateur de LangChain et membre de l'équipe derrière LangGraph, a demandé si tout cela n'était « pas juste langgraph, en gros ? »
Dale Everett a poussé dans l'autre sens, arguant qu'une boucle était de toute façon un graphe à un nœud, donc l'engouement de juillet redécouvrait un terrain connu. Le rétrospectif de LangChain, 3 Years of Graph Engineering with LangGraph, tient un propos similaire, présentant les graphes d'agents comme un motif qu'ils construisent depuis 3 ans.
Je classe donc le terme comme un raccourci utile.
Il nous offre un nom partagé pour des questions de conception qui restaient enfouies dans la documentation des frameworks, et un nom rend service quand on débat d'architecture dans une pull request.
Le graph engineering décrit la structure d'exécution, ce qui le distingue de deux notions qui empruntent son vocabulaire.
Les knowledge graphs et GraphRAG décrivent les données.
Ils transforment des documents en entités et relations pour qu'un système de recherche parcoure les connexions entre faits, et l'outillage, le stockage, et les métriques d'évaluation diffèrent totalement.
Pour ce volet, notre tutoriel sur l'utilisation d'un knowledge graph pour implémenter une application RAG est le bon point de départ, avec notre introduction à la théorie des graphes pour les bases mathématiques communes.
Deuxième chose : ce n'est pas une nouvelle capacité.
LangGraph, l'Agent Development Kit (ADK) de Google et Microsoft AutoGen orchestroient du multi-agents depuis avant que le label ne devienne viral, donc si vous avez écrit un StateGraph, vous en faisiez déjà.
Beaucoup de lecteurs constateront qu'ils font du graph engineering depuis un an sous le nom « mon pipeline LangGraph ».
Chaque couche d'ingénierie IA prend le contrôle d'un élément un cran plus éloigné du modèle.
La bonne lecture de ce tableau est la colonne de droite, qui vous dit ce qui casse réellement quand vous grillez une marche et que vous construisez tout de même par-dessus.
| Couche | Ce que vous contrôlez | Ce qui casse si vous la sautez |
|---|---|---|
| Prompt | La formulation de la demande | Le modèle répond à une question que vous n'avez pas posée |
| Contexte | Quels intrants parviennent au modèle | Il raisonne bien… sur le mauvais matériau |
| Harnais | Outils, mémoire, accès fichiers et API | Il ne peut rien toucher hors de la fenêtre de chat |
| Boucle | Le cycle répéter-jusqu'à-terminé | Il s'arrête trop tôt, ou ne s'arrête jamais |
| Graphe | Quel travailleur s'exécute ensuite, et sur quoi | Un agent essaie d'en être 4 et en oublie 3 |
Sauter une marche est la manière la plus courante dont les projets de graphes échouent, et l'échec est rarement évident.
Trois nœuds peu fiables câblés ensemble ne s'additionnent pas en un système fiable.
Ils produisent un système qui échoue à plus d'endroits, coûte plus cher à chaque échec, et prend plus de temps à diagnostiquer parce que la mauvaise sortie se trouve désormais à 2 passages de relais du nœud qui l'a causée.
N'importe quel graphe d'agents, qu'il ait 3 nœuds ou 30, se décompose en nœuds, arêtes et état partagé.
Une fois ces 3 parties identifiées dans une base de code, la plupart des frameworks d'orchestration deviennent lisibles sans leur documentation.
Un nœud est une unité de travail avec un nom et une responsabilité unique.
Il peut s'agir d'un appel LLM avec une invite spécialisée et ses propres outils, ou d'une simple fonction Python qui interroge une base, valide un schéma, ou écrit un fichier.
Réservez les appels au modèle aux étapes qui exigent un jugement sémantique.
Si une règle a une réponse connue, codez-la en Python, où elle s'exécute en microsecondes, ne coûte rien et renvoie deux fois le même résultat.
Voici mon test pour décider si quelque chose doit être scindé : essayez de décrire le nœud en une phrase sans conjonction.
Un nœud qui « récupère les sources et décide si nous en avons assez » a déjà échoué au test, car vous ne pouvez pas remplacer la partie récupération sans perturber la partie jugement.
Une arête détermine ce qui s'exécute après la fin du nœud courant.
Quatre formes couvrent presque tout ce que vous allez construire :
Les arêtes sont aussi l'endroit naturel pour votre logique d'arrêt. Plafonds de tentatives, seuils de qualité et règles d'escalade sont des décisions de routage, et les garder dans les fonctions d'arête vous permet d'auditer le flux de contrôle en un seul endroit plutôt que de fouiller l'intérieur des nœuds.
L'état partagé est l'objet unique que chaque nœud lit et écrit au fil de l'exécution.
Sans lui, vous avez plusieurs agents qui travaillent côte à côte sans rien se transmettre, donc le rédacteur ne voit pas ce que le chercheur a trouvé, et le relecteur ne voit ni l'un ni l'autre.
Dans LangGraph, l'état est généralement un TypedDict.
Le nôtre accumule le sujet, les notes du chercheur, le brouillon courant, le verdict et le retour du relecteur, et un compteur de révisions. Chaque nœud ne renvoie que les champs qu'il a modifiés, et le framework fusionne ces retours dans l'objet en cours.
La propriété d'écriture est là où les graphes se dégradent d'abord.
Décidez avant de coder quel nœud a le droit d'écrire chaque champ, car un objet d'état que 3 nœuds peuvent écraser est une séance de débogage que vous avez déjà planifiée.
La loop engineering conçoit le cycle qu'un seul agent répète jusqu'à terminer, et la graph engineering conçoit la coordination entre plusieurs de ces cycles.
C'est la décision la plus structurante de l'article, donc elle vient avant le tutoriel.
Par défaut, choisissez la boucle.
Un agent bien cadré avec un vérificateur strict est plus rapide à construire, moins cher à exécuter et bien plus simple à déboguer que n'importe quel graphe pour le même travail.
Ce n'est pas qu'une préférence personnelle.
Une équipe de l'UC Berkeley (premier auteur : Mert Cemri) part du constat que les gains multi-agents sur des configurations mono-agent sont souvent minimes, puis annote plus de 1 600 traces d'exécution de 7 frameworks multi-agents pour comprendre pourquoi (arXiv:2503.13657, v3).
Leur taxonomie, issue de la lecture attentive de 150 de ces traces, nomme 14 modes de défaillance distincts.
Ces 14 modes se rangent en 3 catégories : conception du système, mésalignement inter-agents, et vérification des tâches.
Gardez en tête ce troisième point jusqu'au nœud relecteur.
Traitez ces critères comme des déclencheurs, pas comme une checklist.
Un « oui » net dans la colonne de droite suffit, et 5 « peut-être » ne suffisent pas.
| Question sur votre tâche | Une boucle suffit | Vous voulez un graphe |
|---|---|---|
| Peut-on formuler la mission en une seule instruction ? | Oui, et une personne pourrait la suivre de bout en bout | Elle ressemble à un passage de relais entre 2 rôles |
| Toutes les étapes veulent-elles le même modèle ? | Un modèle et un jeu d'outils uniques | Collecter veut du rapide et pas cher, juger veut du précis |
| Des étapes sont-elles indépendantes ? | Chaque étape dépend de la sortie de la précédente | Plusieurs recherches pourraient tourner en parallèle |
| Qui décide que la sortie est suffisante ? | L'agent se relit lui-même | Quelque chose qui ne l'a pas écrite doit valider |
| Que faire lorsqu'une étape échoue ? | Relancer et continuer | Contenir l'échec pour sauver le reste de l'exécution |
| Quelqu'un doit-il auditer le chemin suivi ? | La trace suffit pour vous et votre équipe | Un tiers doit voir quelle étape a tourné, et pourquoi |
La sur‑ingénierie la plus fréquente que je croise ne concerne même pas les agents. On doit nettoyer et géocoder une liste de 800 adresses d'hôtels, et elle arrive sous forme d'un graphe à 5 nœuds : un chargeur, un normaliseur, un géocodeur, un validateur et un écrivain, avec un état partagé qui file entre eux.
Chacune de ces étapes est déterministe ; ce qu'ils ont réellement construit, c'est un script Python de 40 lignes grimé en framework, qui coûte maintenant de l'argent par ligne et échoue d'une manière dont pandas ne souffrirait pas.
La version à la bonne échelle est celle que nous allons construire.
Produire une courte note documentée se décompose en tâches qui mettent une seule boucle en difficulté : collecter la matière brute, la transformer en prose, puis juger cette prose de l'extérieur.
La troisième étape justifie l'existence du graphe, parce qu'un agent qui relit son propre brouillon ne fait pas de la relecture.
Trois éléments justifient un nœud.
Si vous ne pouvez en pointer aucun pour chaque nœud ajouté, supprimez-le et pliez son travail dans un voisin.
D'abord, la vraie spécialisation.
Notre chercheur veut un modèle rapide et économique et, en production, des outils de recherche. Le rédacteur ne veut ni l'un ni l'autre et bénéficie d'un modèle plus fort : la séparation rend un vrai service, elle ne décore pas un schéma.
Ensuite, le parallélisme qui se voit vraiment.
Le fan-out paie quand les branches sont indépendantes et que le gain en temps mur compte pour quelqu'un, et il vous coûte de la complexité sinon.
Enfin, et c'est le point que je défendrais le plus fermement, la vérification indépendante.
Un agent qui note son propre devoir note avec indulgence ; un nœud relecteur séparé, en lecture seule sur le brouillon, est souvent le plus précieux de tout graphe.
Pour une vue framework‑level de la façon dont les bibliothèques expriment ces motifs, notre comparaison CrewAI vs LangGraph vs AutoGen expose les compromis.
Nous allons construire un pipeline multi-agents LangGraph avec un chercheur, un rédacteur et un relecteur qui produit une courte note documentée et renvoie les brouillons refusés en révision.
LangGraph est un framework d'orchestration bas niveau pour agents à état, et son StateGraph correspond quasiment un pour un aux nœuds, arêtes et état décrits plus haut.
Tout ce qui suit a été vérifié avec langgraph 1.2.11 et langchain-anthropic 1.7.1 en septembre 2026.
Si la bibliothèque est nouvelle pour vous, notre tutoriel LangGraph couvre les fondamentaux. Cette section va vite, et notre guide LangChain vs LangGraph vs LangSmith vs LangFlow clarifie le rôle de chaque brique de la famille.
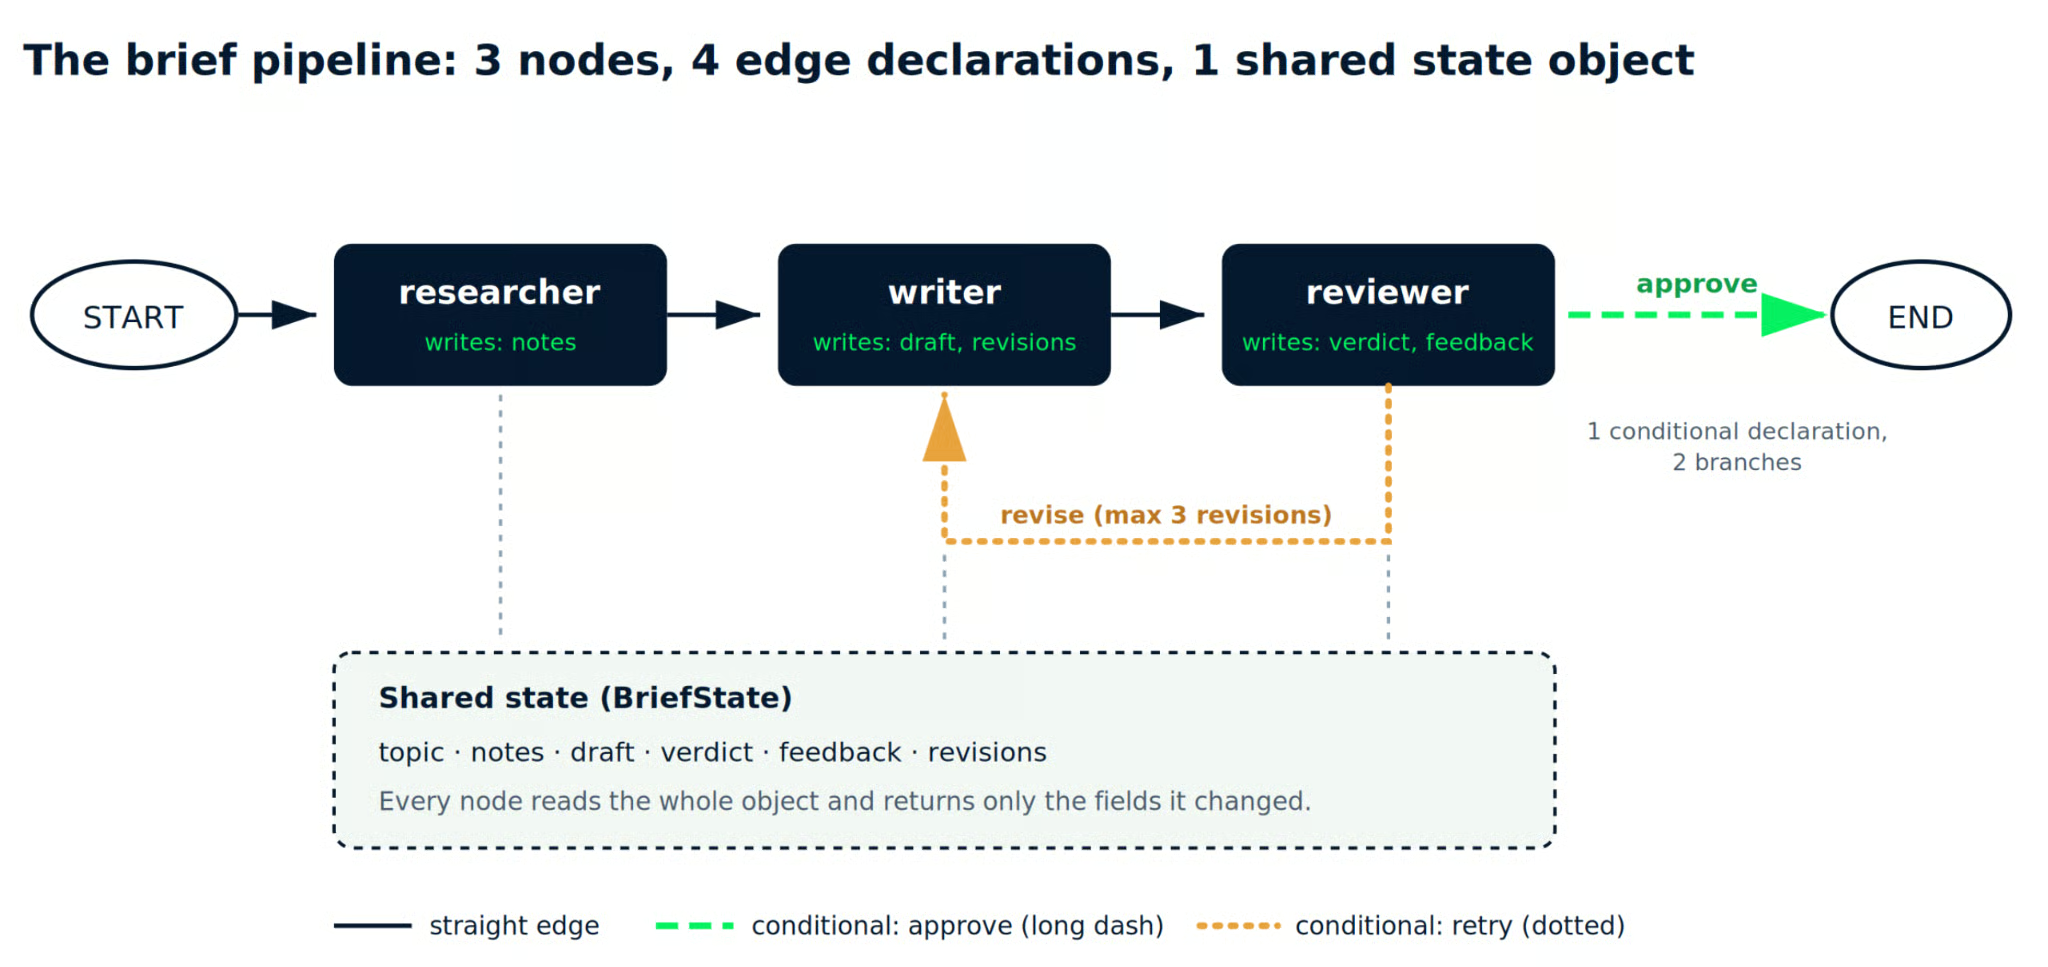
Image de l'auteur. Le pipeline que nous allons construire. Les lignes pleines sont les 3 arêtes droites ; les pointillées et hachurées sont les 2 branches d'une même arête conditionnelle.
Installez les paquets, plus python-dotenv pour garder votre clé hors du code source :
pip install langgraph langchain-anthropic python-dotenvCréez un fichier .env à côté de votre script :
ANTHROPIC_API_KEY=sk-ant-your-key-hereMaintenant les imports et le schéma d'état. Écrire le TypedDict en premier vaut ces 2 minutes : c'est le contrat auquel chaque nœud adhère.
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# Un modèle économique pour la collecte, un plus fort pour la rédaction et la relecture.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Deux modèles, pas un. C'est le déclencheur « modèle différent par étape » du tableau de décision, traduit en code réel : la recherche est un travail volumineux et peu jugeant qui n'a pas besoin du modèle coûteux.
MAX_REVISIONS fait ici un travail discret mais crucial.
Sans plafond, un relecteur strict et un rédacteur têtu s'échangeront un brouillon jusqu'à ce que votre facture devienne intéressante.
Chaque nœud suit le même contrat. Il reçoit l'état courant, fait sa mission, et renvoie un dictionnaire ne contenant que les champs qu'il a modifiés.
Le chercheur collecte la matière brute et l'écrit dans notes :
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
En production, ce nœud appellerait un outil de recherche au lieu de s'appuyer sur les connaissances du modèle.
Je l'ai gardé en un seul appel .invoke() pour que la structure du graphe reste visible ; traitez donc les notes produites comme non vérifiées.
Le rédacteur lit ces notes et produit un brouillon. Il vérifie aussi s'il y a un retour du relecteur, ce qui donne de la matière à l'arête de révision :
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Le relecteur évalue le brouillon.
Il n'a pas vu le raisonnement du rédacteur et n'a produit aucun texte, donc il peut être franc sur le résultat.
C'est la troisième catégorie de la taxonomie de Berkeley, dotée de son propre nœud.
La vérification des tâches échoue quand rien d'indépendant ne contrôle la sortie ; le correctif, c'est un travailleur qui ne peut pas corriger sa propre copie :
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Notez .text plutôt que .content sur les trois nœuds.
Les deux renvoient une chaîne pour une réponse simple, mais .text gère aussi correctement les réponses en plusieurs blocs, ce qui vous évite un AttributeError: 'list' object has no attribute 'strip' déroutant plus tard.
Parser le verdict sur la première ligne reste lisible, et c'est fragile.
Pour un système non supervisé, remplacez ce test de chaîne par la sortie structurée de LangChain afin que le verdict revienne comme un champ typé, pas comme un préfixe que vous espériez voir respecté par le modèle.
La fonction de routage est l'arête conditionnelle. Elle lit l'état après l'exécution du relecteur et renvoie le nom de ce qui doit se passer ensuite :
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions compte chaque brouillon, y compris le premier, donc ">" autorise
    # 1 brouillon initial plus MAX_REVISIONS réécritures.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Gardez cette fonction muette. Un print() à l'intérieur s'affiche sur stdout alors que la boucle de flux imprime encore le bloc précédent, donc l'avis de plafond apparaît une étape trop tôt et la trace semble désordonnée.
Le plafond de révisions vit ici, pas dans un nœud, car s'arrêter est une décision de flux de contrôle, et le flux de contrôle appartient aux arêtes.
Assemblez maintenant le graphe. Nœuds, puis arêtes, puis compilation :
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Le troisième argument de .add_conditional_edges() est la carte des chemins.
Elle énumère chaque destination que la fonction de routage peut renvoyer, et LangGraph l'utilise pour dessiner la branche avant que le moindre nœud n'ait tourné.
Invoquez le graphe compilé avec un état initial. Seuls topic et revisions ont besoin de valeurs, les autres champs se remplissent au fil de l'exécution :
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Vous n'obtenez que l'état final, et rien d'autre. Peu utile quand une exécution dévie.
Remplacez .invoke() par .stream() avec stream_mode="updates" pour regarder chaque nœud annoncer ce qu'il a écrit. Chaque appel est une exécution distincte avec ses propres appels au modèle : utilisez l'un ou l'autre, pas les deux à la suite.
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Sur une exécution où le relecteur rejette le premier brouillon, cela affiche :
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Deux choses s'y voient que l'état final cache.
Le chercheur n'a tourné qu'une fois, et ses notes ont persisté sur les deux passages d'écriture, donc une révision ne relance pas la recherche. Chaque nœud n'a touché que ses propres champs, transformant la règle de propriété d'écriture en quelque chose de vérifiable.
Comptez les appels pendant que vous y êtes.
Ce chemin de refus coûte 5 appels de modèle contre environ 1 pour une version en boucle unique de la même tâche, et la seule façon de savoir si les 4 supplémentaires vous ont apporté quelque chose est de journaliser les verdicts et de les lire.
Pas besoin d'outils supplémentaires pour voir la forme de ce que vous avez construit :
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
La sortie Mermaid représente la branche conditionnelle par des lignes pointillées entre reviewer, __end__ et le retour vers writer.
Cela confirme l'existence de votre arête de révision avant toute dépense en appels de modèle. La vue ASCII ne dessine que le chemin droit du début à la fin ; utilisez Mermaid si vous voulez voir la boucle.
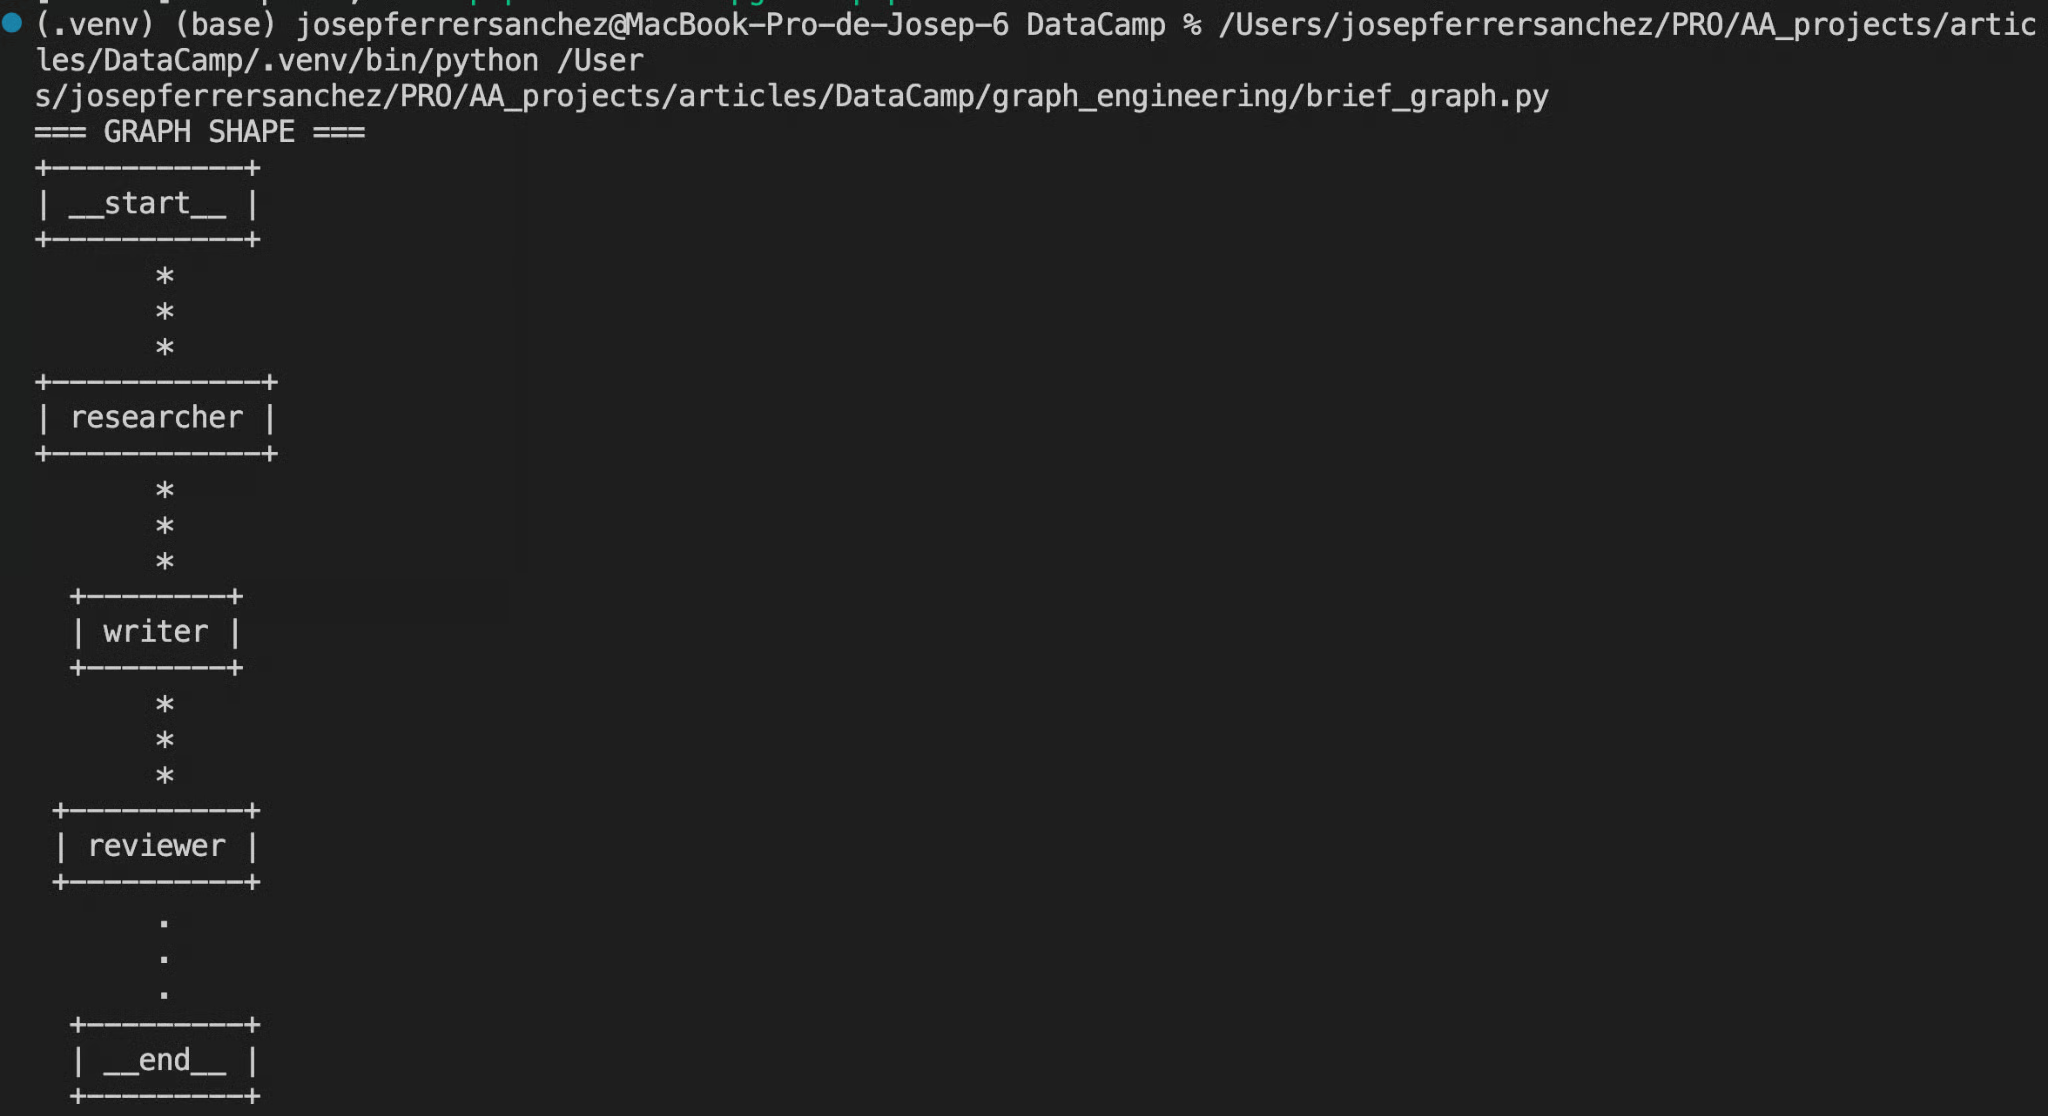
Capture d'écran de l'auteur. Terminal affichant la sortie .draw_ascii(), avec __start__, researcher, writer, reviewer et __end__ empilés verticalement et reliés.
Pour un pas-à-pas avec inspection de l'état à chaque nœud, LangGraph Studio se connecte à un serveur local. Il faut un paquet dédié et un fichier de config : pip install "langgraph-cli[inmem]", ajoutez un langgraph.json pointant sur votre objet graph compilé, puis lancez langgraph dev et ouvrez l'URL de Studio affichée.
Notre guide LangGraph Studio parcourt l'interface (il date de 2024, vérifiez ses étapes d'installation par rapport aux commandes ci-dessus), et notre tutoriel agents LangGraph couvre l'ajout d'outils réels à un nœud comme notre chercheur.
Une remarque de périmètre.
Ce pipeline est séquentiel, donc il ne démontre pas le fan-out, le motif où le chercheur interrogerait plusieurs sources en parallèle et un nœud de jonction fusionnerait les résultats.
C'est l'extension naturelle suivante, et aussi l'endroit où les coûts explosent le plus vite.
Les modes d'échec en IA agentique avec graphes reviennent assez souvent pour être nommés. Voici les trois points que je vérifie avant d'expédier quoi que ce soit.
Chaque nœud est une boucle à part entière, avec un prompt, des outils et une définition de terminé.
Câbler 3 nœuds bancals donne un système bancal, avec une surface triplée et une histoire de débogage bien pire.
Faites fonctionner un nœud seul d'abord.
Un chercheur qui renvoie des notes vagues en appel direct renverra des notes vagues dans un graphe aussi, et le rédacteur en aval bâtira dessus avec assurance.
Résistez à mettre de la logique dans un nœud quand elle appartient à une arête.
Conditions d'arrêt, décisions de branchement et plafonds de révision relèvent du routage, donc appartiennent à la fonction d'arête, où vous pouvez tout lire d'un coup.
Appliquez le test sans conjonction évoqué plus haut.
Un nœud qui recherche des sources et décide s'il y en a assez, c'est 2 nœuds qui partagent une signature de fonction.
Le fan-out et les boucles de révision multiplient l'usage de tokens de manière qu'un schéma ne montre pas.
Un fan-out à 5 branches alimentant un nœud de jonction avec un plafond de 3 révisions, ce n'est pas 5 appels ; selon l'emplacement de la révision, cela peut en faire 15 ou plus, avant même de compter la jonction.
Fixez explicitement le plafond, comme nous l'avons fait avec MAX_REVISIONS. Puis journalisez les comptes de tokens par nœud et lisez-les après une semaine, car le nœud supposé « bon marché » est souvent celui qui tourne le plus.
AutoGen est encore recommandé pour l'orchestration en graphe, et son travail expérimental GraphFlow a été un véritable précédent, mais le dépôt est en mode maintenance en septembre 2026, sans nouvelles fonctionnalités.
Microsoft oriente les nouveaux utilisateurs vers le Microsoft Agent Framework, qui propose ses propres workflows à base de graphes, via un guide de migration publié.
À date, LangGraph, l'ADK de Google, ou Microsoft Agent Framework sont des choix plus sûrs, et notre cours Building AI Agents with Google ADK couvre ADK en profondeur.
Le graph engineering est la couche de coordination au‑dessus de la loop engineering.
Les nœuds font le travail, les arêtes décident de la suite, et un objet partagé transporte l'information entre eux.
Si l'on met de côté le bruit de la timeline de juillet 2026, c'est tout le modèle.
Notre pipeline est resté volontairement minimal : 3 nœuds, 4 déclarations d'arêtes (dont 1 conditionnelle, donc 2 branches dessinées), et un plafond de révisions pour que la boucle ne s'emballe pas.
Cela suffisait pour faire relire un brouillon par quelque chose qui ne l'avait pas écrit, et cette seule propriété est ce qu'une boucle ne pouvait pas offrir.
Optez pour un graphe quand le travail se scinde en phases nécessitant des spécialistes différents, pas un nœud plus tôt. Les sceptiques avaient raison : la mécanique a des décennies, et la plupart des contenus autour du terme sont du bruit.
Ils avaient aussi raison sur l'essentiel, le mardi après-midi.
Un vérificateur faible attaché à un problème en forme de boucle n'améliore pas parce que vous avez dessiné plus de boîtes autour.
Pour aller plus loin, notre cours Multi-Agent Systems with LangGraph couvre les architectures superviseur et réseau que ce tutoriel n'aborde pas.
Côté données du terme, Graph RAG with LangChain and Neo4j est une bonne prochaine étape. Pour rester côté orchestration, Text-to-Query Agents with MongoDB and LangGraph construit un pipeline LangGraph contre une base active, et LLM Agents Explained complète l'architecture sous-jacente.
Le script complet se trouve dans mon dépôt GitHub, avec l'aide pour le rendu du graphe et une courte note sur le coût de chaque exécution.
Top DataCamp Courses
Cours
Cours
Cours