
Corso
Sistemi Multi-Agente con LangGraph
2 h 45 min
8.6K
Dai a un agent un solo compito e se la cava. Dagliene tre e guarda cosa succede al secondo passaggio: dimentica cosa ha trovato al primo step, valuta con indulgenza la propria bozza e annuncia il successo mentre l’output resta incompiuto.
La discussione su questo schema è esplosa a metà luglio 2026, quando "graph engineering" è arrivata su X (ex Twitter) e la timeline si è divisa tra chi annunciava la morte del loop dell’agent e chi bollava il termine come riempitivo da content farm.
La mia posizione è che l’etichetta graph engineering è opzionale, ma l’escalation sottostante no, cosa che proverò a giustificare prima di scrivere qualsiasi riga di codice.
La maggior parte di ciò che costruirai questo mese dovrebbe comunque essere un singolo loop, e il modo più rapido per sprecare una settimana è disegnare un diagramma con 6 riquadri per un lavoro che ne richiedeva 1.
Un grafo di agent ha 3 parti:
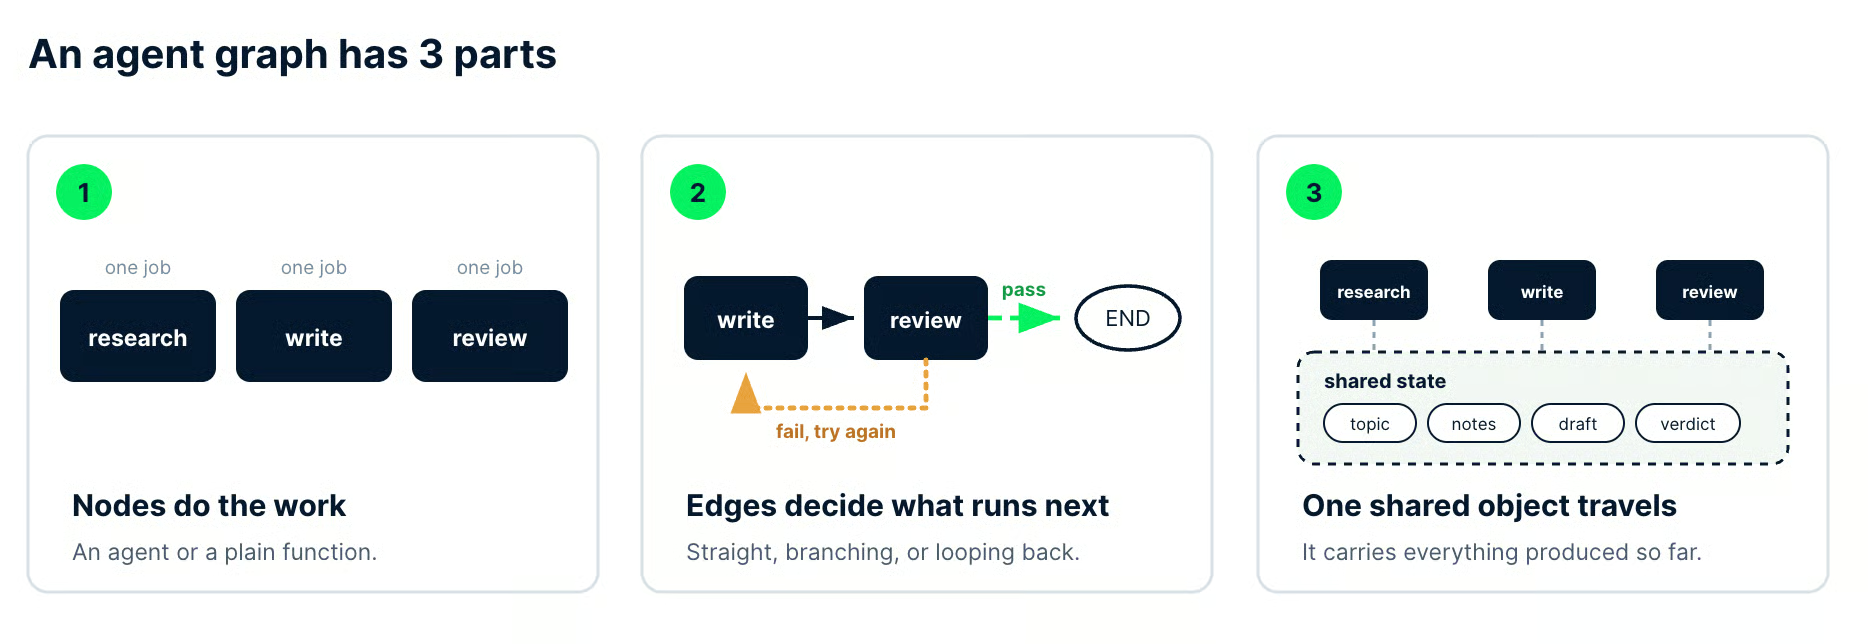
Immagine dell’autore. Le 3 parti mostrate sulla pipeline che costruiremo più avanti: 3 nodi nominati, un edge di passaggio e un edge di retry, e un unico oggetto di stato che raccoglie topic, notes, draft e verdict.
Dichiarare tutte e 3 fin da subito, invece di lasciare che un singolo agent improvvisi il proprio percorso, è ciò che il termine graph engineering descrive.
Questo tutorial costruisce in Python, con LangGraph, una pipeline funzionante di researcher, writer e reviewer, incluso un edge condizionale che rimanda le bozze bocciate per la revisione.
Ti servono Python, pip e un po’ di familiarità con i large language model (LLM) o con gli agent AI. Se gli agent sono una novità, il nostro corso Introduzione agli AI Agents copre i concetti dati per scontati in questo articolo, e il nostro tutorial sugli agent LangGraph copre la parte pratica.
La graph engineering è la pratica di rendere esplicito in codice il flusso di controllo di un sistema di agent, invece di lasciarlo al giudizio del modello.
Dichiari quali lavoratori specializzati esistono, quali transizioni tra loro sono consentite e quali informazioni viaggiano lungo tali transizioni.
L’agent continua a ragionare liberamente, ma lo fa all’interno di un nodo invece che su tutto il lavoro.
L’ultima frase è l’intera distinzione.
In un loop imposti un obiettivo e una soglia di qualità, e l’agent sceglie il proprio percorso per raggiungerli. In un grafo, fissi il percorso e i checkpoint, così l’autonomia del modello è delimitata da una struttura che puoi leggere in una diff.
L’etichetta è esplosa su X a luglio 2026, ma non è nata lì. Itamar Friedman di CodiumAI (ora Qodo) descrisse già nel febbraio 2024 un passaggio "dalla prompt engineering alla flow (/graph) engineering", e il paper AlphaCodium del suo team ne quantificò l’impatto.
La pass@5 accuracy di GPT-4 sul validation set di CodeContests passò dal 19% con un singolo prompt ben progettato al 44% con un flusso multi‑stage. Sono 5 tentativi per problema in entrambe le condizioni, non singolo colpo.
Quello che è successo a luglio 2026 è stata un’amplificazione.
Il 18 luglio, Peter Steinberger chiese su X: "Parliamo ancora di loop o siamo già passati ai grafi?", una settimana dopo che Mike Masson aveva pubblicato la scala che va da prompt, contesto, harness, loop, grafo. La domanda raccolse 3,1 milioni di visualizzazioni, e la frase che diffondeva era già in uso.
La reazione arrivò subito. Harrison Chase, cofondatore di LangChain dal team dietro LangGraph, chiese se in sostanza non fosse "praticamente solo langgraph?"
Dale Everett spinse dall’altro lato, sostenendo che un loop fosse sempre un grafo a un nodo, quindi l’entusiasmo di luglio stava riscoprendo un terreno noto. La stessa retrospettiva di LangChain, 3 Years of Graph Engineering with LangGraph, offre una lettura simile, inquadrando i grafi di agent come un pattern che costruisce da 3 anni.
Quindi per me il termine è una comoda abbreviazione.
Ci ha dato un nome condiviso per questioni di design che prima restavano sepolte nella documentazione dei framework, e un nome torna utile quando stai discutendo di architettura in una pull request.
La graph engineering descrive la struttura di esecuzione, il che la separa da due cose che prendono in prestito il suo vocabolario.
I knowledge graph e la GraphRAG descrivono i dati.
Trasformano i documenti in entità e relazioni così che un sistema di retrieval possa attraversare le connessioni tra i fatti, e tooling, storage e metriche di valutazione sono tutti diversi.
Per quel lato della parola, il nostro tutorial su come usare un knowledge graph per implementare una RAG application è il punto di partenza giusto, con la nostra introduzione alla teoria dei grafi che copre la matematica alla base di entrambi.
La seconda cosa che non è: una nuova capacità.
LangGraph, l’Agent Development Kit (ADK) di Google e Microsoft AutoGen avevano già rilasciato l’orchestrazione multi‑agent prima che l’etichetta diventasse virale, quindi se hai scritto uno StateGraph lo stavi già facendo.
Molti lettori scopriranno di aver fatto graph engineering per un anno chiamandola "la mia pipeline LangGraph".
Ogni layer dell’AI engineering prende il controllo di qualcosa un passo più esterno rispetto al modello.
Il modo utile di leggere questa tabella è la colonna di destra, che ti dice cosa si rompe davvero quando salti un gradino e provi comunque a costruire sopra di esso.
| Layer | Cosa controlli | Cosa si rompe se lo salti |
|---|---|---|
| Prompt | La formulazione della richiesta | Il modello risponde a una domanda che non hai fatto |
| Contesto | Quali input raggiungono il modello | Ragiona bene sul materiale sbagliato |
| Harness | Strumenti, memoria, accesso a file e API | Non può toccare nulla fuori dalla finestra della chat |
| Loop | Il ciclo ripeti‑finché‑finito | Si ferma troppo presto, o non si ferma mai |
| Grafo | Quale worker esegue dopo, e su cosa | Un agent tenta di essere 4 agent e ne dimentica 3 |
Saltare un gradino è il modo più comune in cui i progetti a grafo falliscono, e il fallimento raramente è evidente.
Tre nodi inaffidabili collegati tra loro non fanno la media in un sistema affidabile.
Producono un sistema che fallisce in più punti, costa di più per ogni fallimento e richiede più tempo per la diagnosi, perché il bad output ora è due passaggi di consegna lontano dal nodo che l’ha causato.
Qualsiasi grafo di agent, che abbia 3 nodi o 30, si scompone in nodi, edge e stato condiviso.
Una volta che sai nominare queste 3 parti in un codebase, la maggior parte dei framework di orchestrazione diventa leggibile anche senza la loro documentazione.
Un nodo è un’unità di lavoro con un nome e una singola responsabilità.
Può essere una chiamata LLM con un prompt specializzato e i propri tool, oppure una normale funzione Python che interroga un database, valida uno schema o scrive un file.
Riserva le chiamate al modello per gli step che richiedono giudizio semantico.
Se una regola ha una risposta nota, mettila in Python, dove gira in microsecondi, non costa nulla e restituisce lo stesso risultato due volte.
Ecco il test che uso per capire se qualcosa va separato: prova a descrivere il nodo in una frase senza congiunzioni.
Un nodo che "recupera le fonti e decide se ne abbiamo abbastanza" ha già fallito il test, perché non puoi sostituire la metà di retrieval senza disturbare la metà di giudizio.
Un edge determina cosa esegue dopo che il nodo corrente ha finito.
Quattro forme coprono quasi tutto ciò che costruirai:
Gli edge sono anche dove appartiene la tua logica di stop. Limiti di retry, quality gate e regole di escalation sono tutte decisioni di routing, e tenerle nelle funzioni degli edge significa poter controllare il flusso in un unico posto invece di cercarlo dentro i corpi dei nodi.
Lo stato condiviso è l’unico oggetto che ogni nodo legge e su cui scrive man mano che l’esecuzione procede.
Senza di esso hai più agent che fanno lavori adiacenti e non si passano nulla: lo scrittore non vede cosa ha trovato il ricercatore, e il reviewer non vede nessuno dei due.
In LangGraph, lo stato è di solito un TypedDict.
Il nostro accumula l’argomento, le note del ricercatore, la bozza corrente, il verdetto e il feedback del reviewer, e un contatore di revisioni. Ogni nodo restituisce solo i campi che ha modificato, e il framework unisce quei ritorni nell’oggetto in esecuzione.
La write ownership è dove i grafi decadono per primi.
Decidi prima di scrivere codice quale nodo può scrivere ciascun campo, perché un oggetto di stato che 3 nodi diversi possono sovrascrivere è una sessione di debug che ti sei già messo in agenda.
La loop engineering progetta il ciclo che un singolo agent ripete finché non finisce, e la graph engineering progetta il coordinamento tra diversi di quei cicli.
Questa è la decisione più importante dell’articolo, quindi viene prima del tutorial.
La risposta predefinita è il loop.
Un singolo agent ben delimitato con un verificatore severo è più veloce da costruire, più economico da eseguire e molto più facile da debuggare di qualsiasi grafo che faccia lo stesso lavoro.
Non è solo una mia preferenza.
Un team di UC Berkeley (primo autore Mert Cemri) parte dall’osservazione che i guadagni dei multi‑agent rispetto ai setup single‑agent sono spesso minimi, quindi annota oltre 1.600 tracce di esecuzione da 7 framework multi‑agent per scoprire perché (arXiv:2503.13657, v3).
La loro tassonomia, costruita leggendo da vicino 150 di quelle tracce, nomina 14 distinti failure mode.
Questi 14 si raggruppano in 3 categorie: problemi di system design, disallineamento tra agent e verifica del task.
Tieni a mente la terza finché non arriviamo al nodo reviewer.
Trattali come trigger, non come checklist.
Un sì chiaro nella colonna di destra basta, e 5 sì vaghi non bastano.
| Domanda sul tuo task | Un loop la gestisce | Ti serve un grafo |
|---|---|---|
| Puoi scrivere il lavoro come un’unica istruzione? | Sì, e una persona potrebbe seguirla dall’inizio alla fine | Sembra un passaggio di consegne tra 2 ruoli diversi |
| Ogni step vuole lo stesso modello? | Un modello e un set di tool per tutto | Raccolta vuole economico e veloce, giudizio vuole affilato |
| Ci sono step che non dipendono l’uno dall’altro? | Ogni step ha bisogno dell’output del precedente | Diverse ricerche che potrebbero girare tutte insieme |
| Chi decide che l’output è abbastanza buono? | L’agent si rilegge il lavoro | Qualcosa che non l’ha scritto deve fare il sign‑off |
| Cosa deve succedere quando uno step fallisce? | Riprovalo e prosegui | Confina il fallimento così il resto dell’esecuzione sopravvive |
| Qualcuno deve auditare il percorso seguito? | La trace è per te e i tuoi colleghi | Qualcuno esterno deve vedere quale step è girato e perché |
La versione over‑engineered che incontro più spesso non riguarda nemmeno gli agent. Qualcuno deve ripulire e geocodificare un elenco di 800 indirizzi di hotel, e arriva come un grafo a 5 nodi: un nodo loader, uno normalizer, uno geocoder, uno validator e uno writer, con lo stato condiviso che li attraversa.
Ognuno di quegli step è deterministico, quindi ciò che hanno costruito in realtà è uno script Python da 40 righe travestito da framework, e ora costa denaro per riga e fallisce in modi in cui pandas non fallirebbe mai.
La versione della dimensione giusta è quella che stiamo per costruire.
Produrre un breve testo con ricerca si divide in lavori con cui un singolo loop fatica: raccogliere materiale grezzo, trasformarlo in prosa e poi giudicare quella prosa dall’esterno.
Il terzo step è il motivo per cui il grafo esiste, perché un agent che revisiona la propria bozza non sta facendo davvero una revisione.
Tre cose giustificano un nodo.
Se non puoi indicarne una per ogni nodo che hai aggiunto, elimina il nodo e incorpora il suo lavoro in un vicino.
Prima viene la vera specializzazione.
Il nostro researcher vuole un modello economico e veloce e, in produzione, strumenti di ricerca. Il writer non vuole né l’uno né gli altri e beneficia di un modello più forte, quindi la separazione sta facendo lavoro invece di decorare un diagramma.
Secondo, il parallelismo che noterai davvero.
Il fan‑out ripaga quando i rami sono indipendenti e il risparmio sul tempo reale conta per qualcuno, e ti costa complessità extra quando nessuna delle due condizioni è vera.
Terzo, e questo lo difenderei più di tutto, la verifica indipendente.
Un agent che si corregge i compiti è indulgente, quindi un nodo reviewer separato con accesso in sola lettura alla bozza è di solito il nodo più prezioso in qualsiasi grafo.
Per una vista a livello di framework su come librerie diverse esprimono questi pattern, il nostro confronto CrewAI vs LangGraph vs AutoGen illustra i trade‑off.
Costruiamo una pipeline multi‑agent LangGraph con un researcher, un writer e un reviewer che produce un breve testo ricercato e rimanda le bozze bocciate per la revisione.
LangGraph è un framework di orchestrazione di basso livello per agent stateful, e il suo StateGraph mappa quasi uno‑a‑uno su nodi, edge e stato della sezione precedente.
Tutto quanto segue è stato verificato con langgraph 1.2.11 e langchain-anthropic 1.7.1 a settembre 2026.
Se la libreria è nuova per te, il nostro tutorial su LangGraph copre le basi. Questa sezione si muove veloce, e la nostra guida a LangChain vs LangGraph vs LangSmith vs LangFlow chiarisce cosa fa ciascun componente della famiglia.
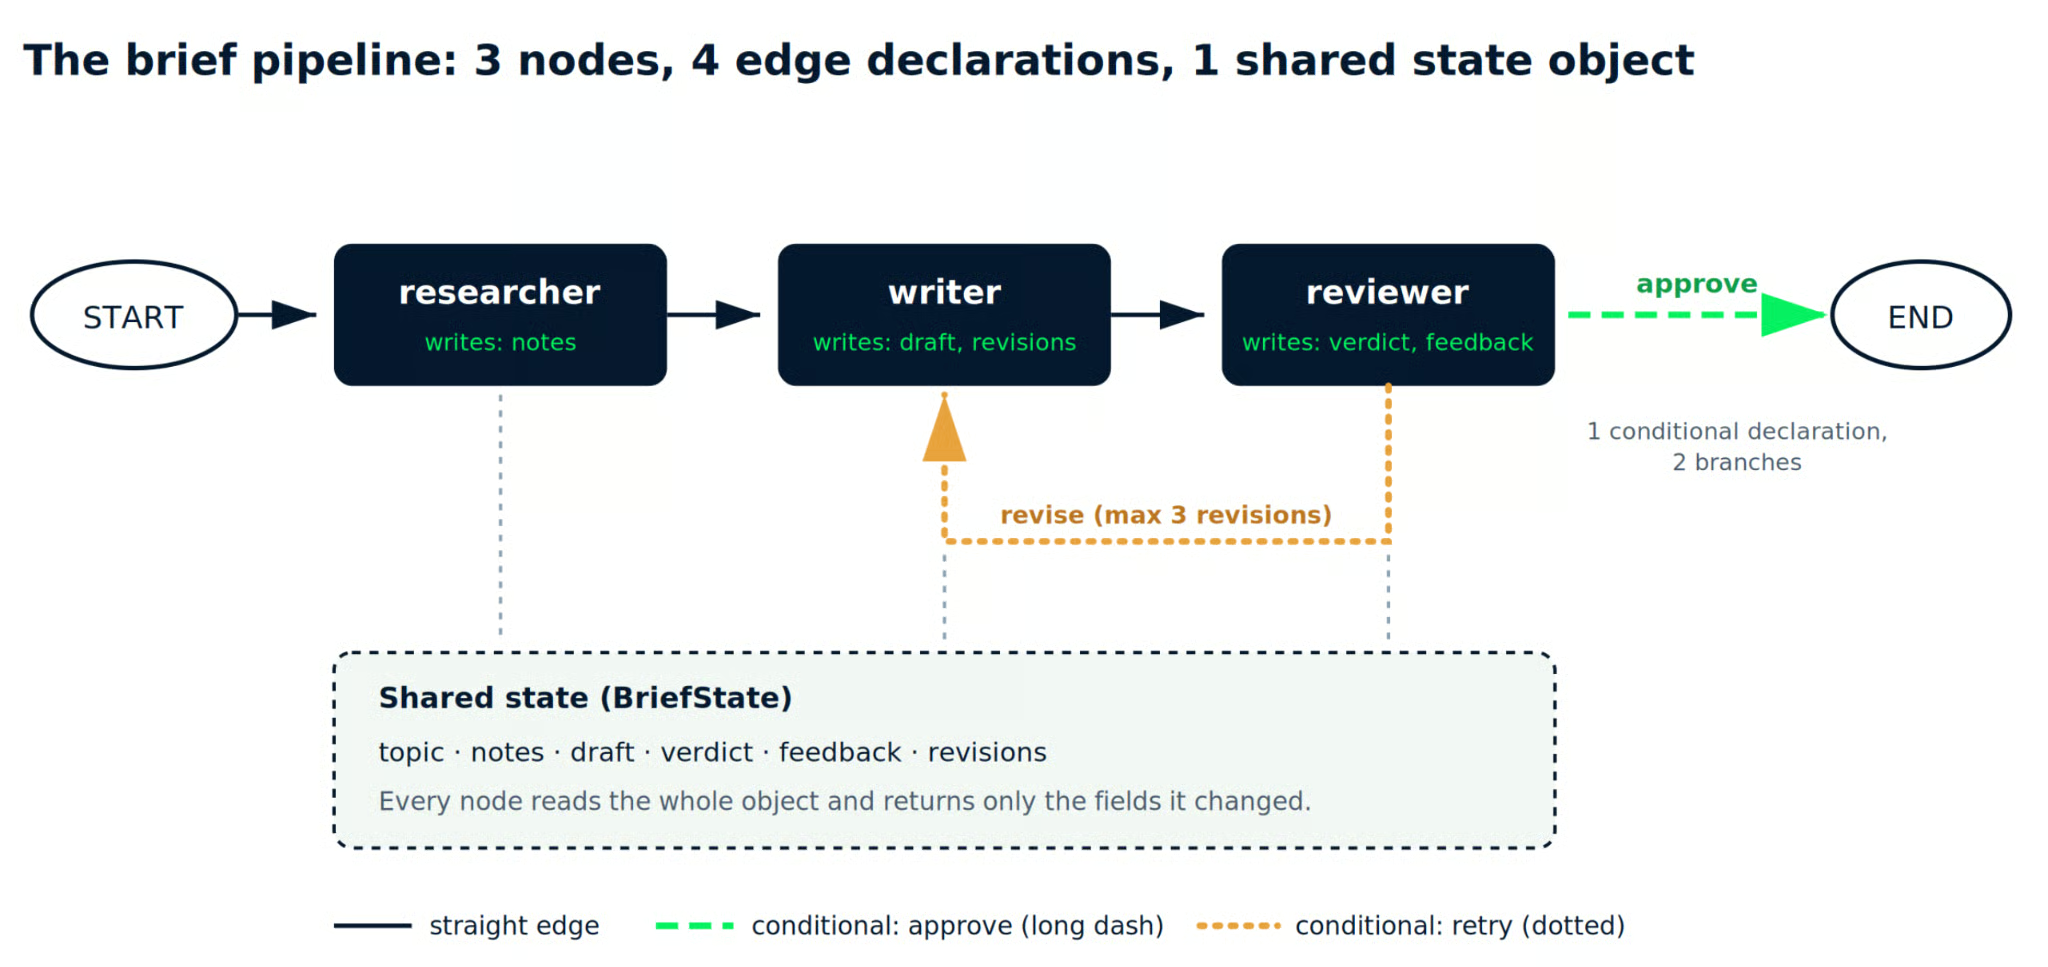
Immagine dell’autore. La pipeline che stiamo per costruire. Le linee continue sono i 3 edge dritti; le linee tratteggiate e puntinate sono i 2 rami di un singolo edge condizionale.
Installa i pacchetti, più python-dotenv così la tua chiave resta fuori dal sorgente:
pip install langgraph langchain-anthropic python-dotenvCrea un file .env accanto al tuo script:
ANTHROPIC_API_KEY=sk-ant-your-key-hereOra gli import e lo schema dello stato. Scrivere prima il TypedDict vale i 2 minuti, perché è il contratto a cui ogni nodo si attiene:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Due modelli, non uno. È il trigger "modello diverso per step" della tabella decisionale che si manifesta nel codice reale, dato che la ricerca è lavoro ad alto volume e basso giudizio che non richiede il modello costoso.
MAX_REVISIONS qui fa un lavoro silenzioso ma importante.
Senza un tetto, un reviewer severo e un writer testardo si passeranno la bozza avanti e indietro finché la tua fattura non diventa interessante.
Ogni nodo segue lo stesso contratto. Riceve lo stato corrente, fa il suo unico lavoro e restituisce un dizionario contenente solo i campi che ha modificato.
Il researcher raccoglie materiale grezzo e lo scrive in notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
Una versione di produzione di questo nodo chiamerebbe uno strumento di ricerca invece di affidarsi alla conoscenza interna del modello.
L’ho lasciato come una singola chiamata a .invoke() così la struttura del grafo resta visibile, quindi tratta le note che produce come non verificate.
Il writer legge quelle note e produce una bozza. Controlla anche l’eventuale feedback del reviewer, che dà all’edge di retry qualcosa su cui agire:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Il reviewer dà un punteggio alla bozza.
Non ha visto il ragionamento del writer e non ha prodotto il testo, quindi può essere schietto sul risultato.
Questa è la terza categoria della tassonomia di Berkeley, a cui diamo un nodo dedicato.
La verifica del task si rompe quando niente di indipendente controlla l’output, quindi la soluzione è un worker che non possa correggersi i compiti da solo:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Nota .text e non .content su tutti e tre i nodi.
Entrambi restituiscono una stringa per una risposta semplice, ma .text si comporta correttamente anche quando una risposta arriva come più blocchi di contenuto, evitandoti in seguito un confuso AttributeError: 'list' object has no attribute 'strip'.
Fare il parsing del verdetto dalla prima riga mantiene leggibile il codice, ma è fragile.
Per qualsiasi cosa giri senza supervisione, sostituisci quel controllo di stringa con l’output strutturato di LangChain, così il verdetto torna come campo tipizzato invece che come prefisso che speravi il modello rispettasse.
La funzione di instradamento è l’edge condizionale. Legge lo stato dopo l’esecuzione del reviewer e restituisce il nome di ciò che dovrebbe accadere dopo:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Tieni questa funzione silenziosa. Una print() al suo interno finisce su stdout mentre il loop di stream sta ancora stampando il blocco precedente, quindi l’avviso sul tetto appare uno step in anticipo e la trace sembra fuori ordine.
Il tetto alle revisioni vive qui e non dentro un nodo, perché fermarsi è una decisione di flusso di controllo e il flusso di controllo appartiene agli edge.
Ora assembla il grafo. Nodi, poi edge, poi compile:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Quel terzo argomento di .add_conditional_edges() è la mappa dei percorsi.
Elenca ogni destinazione che la funzione di routing potrebbe restituire, e LangGraph la usa per disegnare il ramo prima che qualsiasi nodo sia stato eseguito.
Invoca il grafo compilato con uno stato iniziale. Solo topic e revisions hanno bisogno di valori, perché gli altri campi vengono riempiti man mano che l’esecuzione scorre:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Questo ti dà lo stato finale e nient’altro. Non molto utile quando un’esecuzione deraglia.
Sostituisci .invoke() con .stream() con stream_mode="updates" per vedere ogni nodo riportare cosa ha scritto. Ogni chiamata è un’esecuzione separata con le sue chiamate al modello, quindi usa l’una o l’altra invece di eseguirle entrambe:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
In un’esecuzione in cui il reviewer respinge la prima bozza, stampa quanto segue:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Ci sono due cose visibili lì che lo stato finale nasconde.
Il researcher è girato una volta e le sue note sono rimaste per entrambi i passaggi di scrittura, quindi un retry non rifà la ricerca. Ogni nodo ha toccato solo i propri campi, trasformando la regola di write‑ownership di prima in qualcosa che puoi verificare.
Conta le chiamate finché sei qui.
Quel percorso con rifiuto costa 5 chiamate al modello contro circa 1 per una versione a singolo loop dello stesso task, e l’unico modo per sapere se le 4 extra ti hanno comprato qualcosa è loggare i verdetti e leggerli.
Non ti servono strumenti extra per vedere la forma di ciò che hai costruito:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
L’output Mermaid rende il ramo condizionale come linee tratteggiate che vanno da reviewer sia a __end__ che di nuovo a writer.
Questo conferma che il tuo edge di retry esiste prima di spendere qualcosa in chiamate al modello. La vista ASCII disegna solo il percorso dritto da start a end, quindi usa l’output Mermaid quando vuoi vedere il loop.
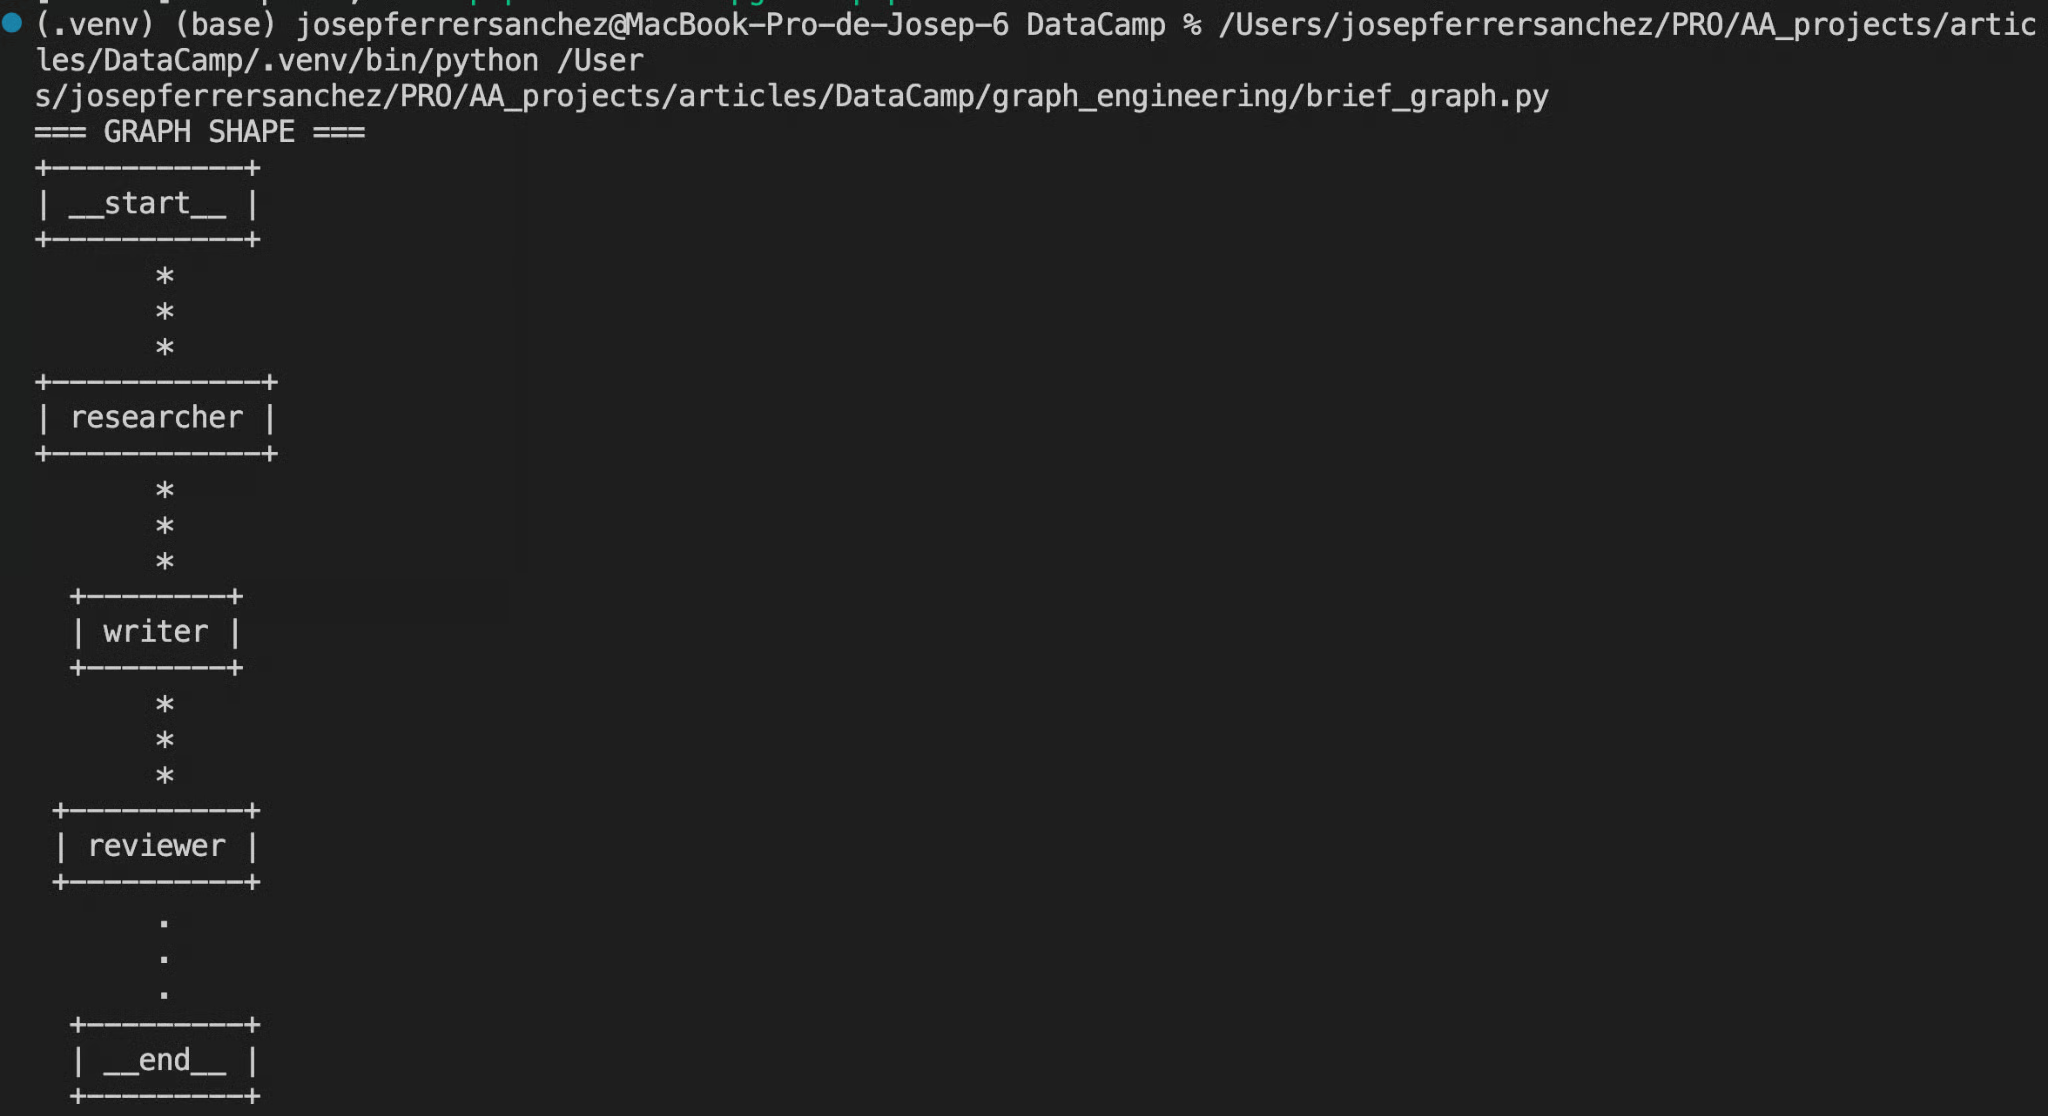
Screenshot dell’autore. Terminale che mostra l’output di .draw_ascii(), con __start__, researcher, writer, reviewer e __end__ impilati verticalmente e collegati.
Per il debug passo‑passo con ispezione dello stato a ogni nodo, LangGraph Studio si collega a un server locale. Serve un pacchetto a parte e un file di config, quindi esegui pip install "langgraph-cli[inmem]", aggiungi un langgraph.json che punti all’oggetto graph compilato, poi lancia langgraph dev e apri l’URL di Studio che stampa.
La nostra guida a LangGraph Studio illustra l’interfaccia (risale al 2024, quindi confronta i passaggi di setup con i comandi sopra), e il nostro tutorial sugli agent LangGraph copre l’aggiunta di tool reali a un nodo come il nostro researcher.
Una nota di scoping.
Questa pipeline è sequenziale, quindi non dimostra mai il fan‑out, il pattern in cui il researcher interrogherebbe diverse fonti in parallelo e un nodo di join unirebbe i risultati.
È la naturale estensione successiva, ed è anche dove i costi si moltiplicano più in fretta.
I failure mode nella graph engineering agentica si ripetono abbastanza spesso da poterli nominare. Questi sono i tre che controllo prima di spedire qualsiasi cosa.
Ogni nodo è un loop a sé, con un prompt, tool e una definizione di done.
Collegare 3 nodi traballanti ti dà un sistema traballante con tripla superficie e una storia di debug molto peggiore.
Fai funzionare bene un nodo da solo prima.
Un researcher che restituisce note vaghe quando lo chiami direttamente restituirà note vaghe anche dentro un grafo, e il writer a valle costruirà con sicurezza su di esse.
Resisti a mettere logica in un nodo quando appartiene a un edge.
Condizioni di stop, decisioni di branching e tetti ai retry sono routing, e il routing appartiene alla funzione dell’edge, dove puoi leggerlo tutto in una volta.
Applica il test senza congiunzioni di prima.
Un nodo che cerca le fonti e decide se sono abbastanza è 2 nodi che condividono una firma di funzione.
Fan‑out e loop di retry moltiplicano l’uso di token in modi che un diagramma nasconde del tutto.
Un fan‑out a 5 rami che alimenta un nodo di join con un tetto a 3 retry non è 5 chiamate, e a seconda di dove sta il retry può essere 15 o più, prima ancora di contare il join.
Imposta esplicitamente il tetto, come abbiamo fatto con MAX_REVISIONS. Poi registra i conteggi di token per nodo e rileggili dopo una settimana, perché il nodo che pensavi fosse economico è di solito quello che gira più spesso.
AutoGen viene ancora consigliato per l’orchestrazione a grafo, e il suo lavoro sperimentale GraphFlow è stato vero stato dell’arte, ma il repository è in maintenance mode a settembre 2026, senza nuove feature.
Microsoft indirizza i nuovi utenti al Microsoft Agent Framework, che ha propri workflow basati su grafo, tramite una guida di migrazione pubblicata.
Ad oggi, LangGraph, l’ADK di Google o Microsoft Agent Framework sono scelte più sicure, e il nostro corso Building AI Agents with Google ADK copre ADK in profondità.
La graph engineering è lo strato di coordinamento sopra la loop engineering.
I nodi fanno il lavoro, gli edge decidono cosa gira dopo e un unico oggetto condiviso porta le informazioni tra di loro.
Togli il rumore della timeline di luglio 2026, e questo è l’intero modello.
La nostra pipeline è rimasta piccola di proposito: 3 nodi, 4 dichiarazioni di edge (1 condizionale, quindi disegna 2 rami) e un tetto alle revisioni perché il retry non ci sfugga di mano.
È bastata quella struttura per far revisionare una bozza da qualcosa che non l’aveva scritta, e questa singola proprietà è ciò che un loop non poteva offrire.
Passa a un grafo quando il lavoro si divide in fasi che richiedono specialisti diversi, e non un nodo prima. Gli scettici avevano ragione sul fatto che la meccanica è vecchia di decenni e che gran parte della scrittura attorno al termine è rumore.
Avevano anche ragione sulla parte che conta in un martedì pomeriggio.
Un verificatore debole attaccato a un problema da loop non migliora perché ci disegni attorno più riquadri.
Per approfondire questi pattern, il nostro corso Multi‑Agent Systems with LangGraph copre i design con supervisor e network a cui questo tutorial si ferma un passo prima.
Per il lato dati della parola, Graph RAG with LangChain and Neo4j è un buon passo successivo. Per restare sul lato orchestrazione, Text‑to‑Query Agents with MongoDB and LangGraph costruisce una pipeline LangGraph contro un database live, e LLM Agents Explained completa l’architettura alla base di tutto.
Lo script completo è nel mio repo GitHub, con l’helper per il rendering del grafo e una breve nota sui costi per esecuzione.
I migliori corsi DataCamp
Corso
Corso
Corso