course
Sisteme multi-agent cu LangGraph
2 oră 45 min
8.6K
Dă-i unui agent o singură sarcină și se descurcă. Dă-i trei și urmărește ce se întâmplă pe la a doua predare: uită ce a găsit la primul pas, își notează cu generozitate propriul draft și anunță succesul în timp ce rezultatul stă neterminat.
Discuția despre acest tipar a explodat la mijlocul lui iulie 2026, când „graph engineering” a ajuns pe X (fostul Twitter), iar timeline-ul s-a împărțit imediat între cei care anunțau moartea loop-ului de agent și cei care numeau termenul umplutură pentru content farms.
Părerea mea este că eticheta graph engineering e opțională, dar escaladarea de dedesubt nu este — și voi încerca să justific asta înainte să scriem orice cod.
Majoritatea lucrurilor pe care le construiești luna asta ar trebui să fie tot un singur loop, iar cea mai rapidă cale să pierzi o săptămână e să desenezi o diagramă cu 6 căsuțe pentru o treabă care avea nevoie de 1.
Un graf de agenți are 3 părți:
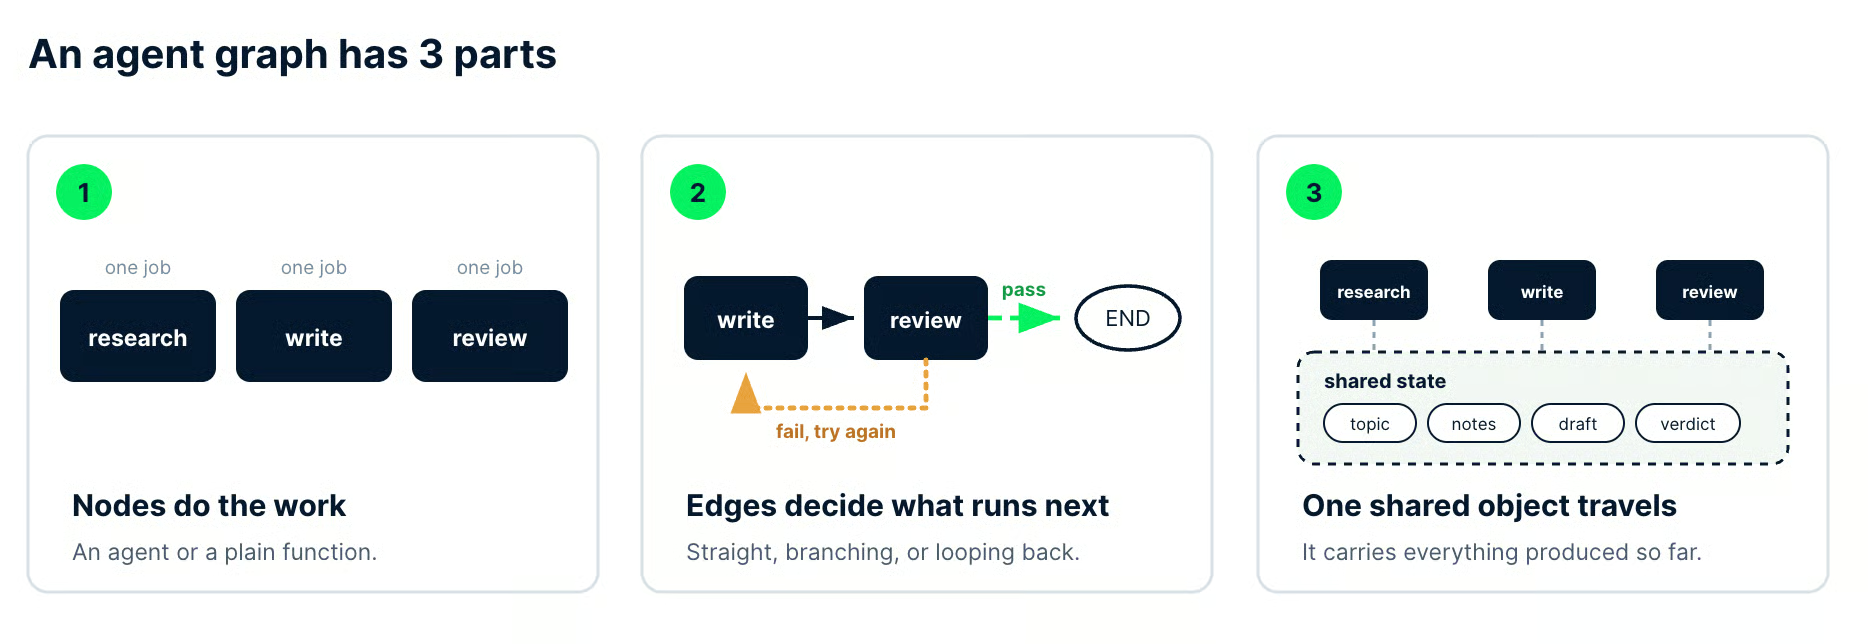
Imagine de autor. Cele 3 părți arătate pe pipeline-ul pe care îl construim mai târziu: 3 node-uri denumite, o muchie de pass și o muchie de retry, plus un obiect de stare care colectează topic, notes, draft și verdict.
Declararea tuturor celor 3 de la început, în loc să lași un singur agent să-și improvizeze drumul, este ceea ce descrie termenul graph engineering.
Acest tutorial construiește în Python, cu LangGraph, o „conductă” funcțională cu researcher, writer și reviewer, inclusiv o muchie condițională care trimite înapoi drafturile respinse pentru revizuire.
Ai nevoie de Python, pip și un pic de familiaritate cu modelele lingvistice mari (LLM) sau agenții AI. Dacă agenții sunt noi pentru tine, cursul nostru Introducere în agenți AI acoperă conceptele pe care acest articol le presupune, iar tutorialul nostru agenți LangGraph acoperă partea practică.
Graph engineering este practica de a face explicit în cod fluxul de control al unui sistem de agenți, în loc să-l lași la judecata modelului.
Declari ce lucrători specializați există, ce tranziții între ei sunt permise și ce informație călătorește pe acele tranziții.
Agentul tot raționează liber, dar o face într-un singur node, nu pe tot parcursul sarcinii.
Asta din urmă este toată deosebirea.
Într-un loop, setezi un obiectiv și un prag de calitate, iar agentul își alege singur ruta pentru a le atinge. Într-un graf, fixezi ruta și punctele de control, astfel încât autonomia modelului e delimitată de o structură pe care o poți citi într-un diff.
Eticheta a devenit zgomotoasă pe X în iulie 2026, dar nu a început acolo. Itamar Friedman de la CodiumAI (acum Qodo) a descris o trecere „de la prompt engineering la flow (/graph) engineering” încă din februarie 2024, iar lucrarea AlphaCodium a echipei lui a venit cu cifre.
Acuratețea GPT-4 pass@5 pe setul de validare CodeContests a trecut de la 19% cu un singur prompt bine proiectat la 44% cu un flux multi-etapă. Asta înseamnă 5 încercări per problemă în ambele condiții, nu single-shot.
Ce s-a întâmplat în iulie 2026 a fost amplificarea.
Pe 18 iulie, Peter Steinberger a întrebat pe X: „Mai vorbim despre loop-uri sau am trecut deja la grafuri?”, la o săptămână după ce Mike Masson a postat scara: prompt, context, harness, loop, graph. Întrebarea a strâns 3,1 milioane de vizualizări, iar expresia pe care a răspândit-o era deja în uz.
Contraargumentele au venit rapid. Harrison Chase, cofondator LangChain din echipa din spatele LangGraph, a întrebat dacă totul nu este „practic doar langgraph?”
Dale Everett a împins din cealaltă direcție, argumentând că un loop a fost mereu un graf cu un singur node, deci entuziasmul din iulie redescoperea teren vechi. Retrospectiva LangChain, 3 ani de Graph Engineering cu LangGraph, are o linie similară, încadrează grafurile de agenți drept un pattern pe care îl construiește de 3 ani.
Deci eu pun termenul sub scurtătură utilă.
Ne-a dat un nume comun pentru întrebări de design care stăteau îngropate în documentația framework-urilor, iar un nume își merită locul când discuți arhitectură într-un pull request.
Graph engineering descrie structura de execuție, ceea ce îl separă de două lucruri care împrumută vocabularul lui.
Knowledge graphs și GraphRAG descriu datele.
Ele transformă documentele în entități și relații astfel încât un sistem de căutare să poată parcurge conexiunile dintre fapte, iar instrumentele, stocarea și metricile de evaluare sunt toate diferite.
Pentru acea parte a cuvântului, tutorialul nostru despre folosirea unui knowledge graph pentru a implementa o aplicație RAG este punctul potrivit de plecare, iar introducerea în teoria grafurilor acoperă matematica de dedesubtul ambelor.
Al doilea lucru pe care nu îl este: o capabilitate nouă.
LangGraph, Agent Development Kit (ADK) de la Google și Microsoft AutoGen au livrat orchestrare multi-agent înainte ca eticheta să devină virală, așa că dacă ai scris un StateGraph deja făceai asta.
Destui cititori vor constata că au făcut graph engineering de un an sub numele „pipeline-ul meu LangGraph”.
Fiecare strat al ingineriei AI preia controlul asupra a ceva cu un pas mai în afară de model.
Modul util de a citi acest tabel este coloana din dreapta, care îți spune ce se strică de fapt când sari o treaptă și încerci totuși să construiești peste ea.
| Strat | Ce controlezi | Ce se strică dacă îl sari |
|---|---|---|
| Prompt | Formularea cererii | Modelul răspunde la o întrebare pe care n-ai pus-o |
| Context | Ce intrări ajung la model | Raționează bine peste materialul greșit |
| Harness | Tool-uri, memorie, acces la fișiere și API | Nu poate atinge nimic în afara ferestrei de chat |
| Loop | Ciclul repetă-până-termini | Se oprește prea devreme sau nu se mai oprește |
| Graph | Cine rulează după cine și pe ce | Un agent încearcă să fie 4 și uită 3 dintre ei |
Sărirea unei trepte e cel mai comun mod în care proiectele cu grafuri eșuează, iar eșecul rareori e evident.
Trei node-uri nesigure legate între ele nu se mediează într-un sistem sigur.
Produc un sistem care eșuează în mai multe locuri, costă mai mult per eșec și durează mai mult de diagnosticat pentru că ieșirea proastă e acum la 2 predări distanță de node-ul care a cauzat-o.
Orice graf de agenți, fie că are 3 node-uri sau 30, se descompune în node-uri, muchii și stare partajată.
Odată ce poți numi aceste 3 părți într-un codebase, majoritatea framework-urilor de orchestrare devin lizibile fără documentația lor.
Un node este o unitate de lucru cu un nume și o singură responsabilitate.
Poate fi un apel LLM cu un prompt specializat și tool-urile lui, sau poate fi o funcție Python obișnuită care interoghează o bază de date, validează o schemă sau scrie un fișier.
Rezervă apelurile către model pentru pașii care au nevoie de judecată semantică.
Dacă o regulă are un răspuns cunoscut, pune-l în Python, unde rulează în microsecunde, nu costă nimic și întoarce același rezultat de două ori.
Iată testul pe care îl folosesc pentru a decide dacă ceva trebuie separat: încearcă să descrii node-ul într-o singură propoziție fără conjuncții.
Un node care „trage sursele și decide dacă avem destule” a picat deja testul, pentru că nu poți schimba jumătatea de retrieval fără să deranjezi jumătatea de judecată.
O muchie determină ce rulează după ce node-ul curent termină.
Patru forme acoperă aproape tot ce vei construi:
Muchiile sunt și locul unde ar trebui să stea logica de oprire. Plafoanele de retry, porțile de calitate și regulile de escaladare sunt decizii de rutare, iar păstrarea lor în funcțiile de muchie înseamnă că poți audita fluxul de control într-un singur loc, în loc să sapi prin corpurile node-urilor.
Starea partajată este obiectul unic din care fiecare node citește și în care scrie pe măsură ce rularea progresează.
Fără ea, ai mai mulți agenți care fac lucru adiacent și nu-și pasează nimic, deci writer-ul nu vede ce a găsit researcher-ul, iar reviewer-ul nu vede niciunul.
În LangGraph, starea este de obicei un TypedDict.
A noastră acumulează subiectul, notițele researcher-ului, draftul curent, verdictul și feedback-ul reviewer-ului și un contor de revizii. Fiecare node întoarce doar câmpurile pe care le-a schimbat, iar framework-ul îmbină acele returnuri în obiectul în curs.
Ownership-ul la scriere e primul loc unde grafurile se degradează.
Decide înainte de a scrie cod care node are voie să scrie fiecare câmp, pentru că un obiect de stare pe care 3 node-uri diferite îl pot suprascrie este o sesiune de debugging deja programată de tine.
Loop engineering proiectează ciclul pe care îl repetă un singur agent până termină, iar graph engineering proiectează coordonarea dintre mai multe astfel de cicluri.
Asta e cea mai importantă decizie din articol, deci vine înainte de tutorial.
Răspunsul implicit este loop-ul.
Un singur agent bine delimitat, cu un verificator strict, e mai rapid de construit, mai ieftin de rulat și mult mai ușor de depanat decât orice graf care face aceeași treabă.
Nu e doar preferința mea.
O echipă de la UC Berkeley (primul autor Mert Cemri) pornește de la observația că câștigurile multi-agent față de setările single-agent sunt adesea minime, apoi adnotează peste 1.600 de urme de execuție din 7 framework-uri multi-agent ca să afle de ce (arXiv:2503.13657, v3).
Taxonomia lor, construită dintr-o lectură atentă a 150 dintre acele urme, numește 14 moduri distincte de eșec.
Acele 14 moduri se împart în 3 categorii: probleme de design de sistem, nealinieri între agenți și verificarea sarcinii.
Păstrează în minte a treia până ajungem la node-ul reviewer.
Tratează-le ca pe declanșatoare, nu ca pe o listă de bifat.
Un singur „da” clar în coloana din dreapta e suficient, iar 5 vagi nu sunt.
| Întrebare despre sarcina ta | Un loop o rezolvă | Ai nevoie de un graf |
|---|---|---|
| Poți scrie treaba ca o singură instrucțiune? | Da, și o persoană ar putea s-o urmeze cap-coadă | Sună ca o predare între 2 roluri diferite |
| Vrea fiecare pas același model? | Un model și același set de tool-uri peste tot | Colectarea vrea ieftin și rapid, judecata vrea ascuțit |
| Există pași care nu depind unii de alții? | Fiecare pas are nevoie de ieșirea pasului anterior | Câteva interogări care ar putea rula toate odată |
| Cine decide că ieșirea e suficient de bună? | Agentul își recitește propria muncă | Cineva care nu a scris-o trebuie să-și pună semnătura |
| Ce ar trebui să se întâmple când un pas eșuează? | Îl retrimiți și continui | Conține eșecul ca restul rulării să supraviețuiască |
| Trebuie cineva să auditeze calea urmată? | Urma e pentru tine și colegii tăi | Cineva din afară trebuie să vadă ce pas a rulat și de ce |
Versiunea suprainginerizată pe care o întâlnesc cel mai des nici măcar nu e despre agenți. Cineva trebuie să curețe și să geocodeze o listă de 800 de adrese de hotel și vine ca un graf cu 5 node-uri: loader, normalizer, geocoder, validator și writer, cu stare partajată filetată printre ele.
Fiecare dintre acești pași e determinist, așa că ce au construit de fapt este un script Python de 40 de linii purtând un framework, iar acum costă bani per rând și eșuează în moduri în care pandas n-ar face-o niciodată.
Versiunea de dimensiune potrivită e cea pe care urmează s-o construim.
Producerea unui scurt brief documentat se împarte în lucru la care un singur loop se chinuie: colectarea materialului brut, transformarea lui în text și apoi judecarea acelui text din exterior.
Al treilea pas e motivul pentru care graful există, pentru că un agent care își revizuiește propriul draft nu face o revizuire.
Trei lucruri justifică un node.
Dacă nu poți indica unul dintre ele pentru fiecare node adăugat, șterge node-ul și înglobează-i treaba într-un vecin.
Specializarea reală vine prima.
Researcher-ul nostru vrea un model ieftin și rapid și, în producție, tool-uri de căutare. Writer-ul nu vrea niciuna dintre acestea și beneficiază de un model mai puternic, deci separarea chiar face treabă, nu doar decorează o diagramă.
A doua, paralelismul pe care chiar îl vei simți.
Fan-out merită când ramurile sunt independente și economia de timp pe ceas contează pentru cineva, și te costă complexitate în plus când niciuna nu e adevărată.
A treia, și pe asta aș apăra-o cel mai tare, verificarea independentă.
Un agent care își corectează singur tema corectează cu blândețe, așa că un node reviewer separat, cu acces doar în citire la draft, e de obicei cel mai valoros node din orice graf.
Pentru o privire la nivel de framework despre cum exprimă librăriile aceste pattern-uri, comparația noastră CrewAI vs LangGraph vs AutoGen expune compromisurile.
Construim o „conductă” multi-agent în LangGraph cu un researcher, un writer și un reviewer care produce un scurt brief documentat și trimite înapoi drafturile respinse pentru revizuire.
LangGraph este un framework de orchestrare low-level pentru agenți stateful, iar StateGraph se potrivește aproape unu-la-unu cu node-urile, muchiile și starea din secțiunea anterioară.
Tot ce urmează a fost verificat cu langgraph 1.2.11 și langchain-anthropic 1.7.1 în septembrie 2026.
Dacă librăria îți e nouă, tutorialul nostru LangGraph acoperă elementele de bază. Secțiunea asta se mișcă repede, iar ghidul nostru LangChain vs LangGraph vs LangSmith vs LangFlow clarifică ce face fiecare piesă din familie.
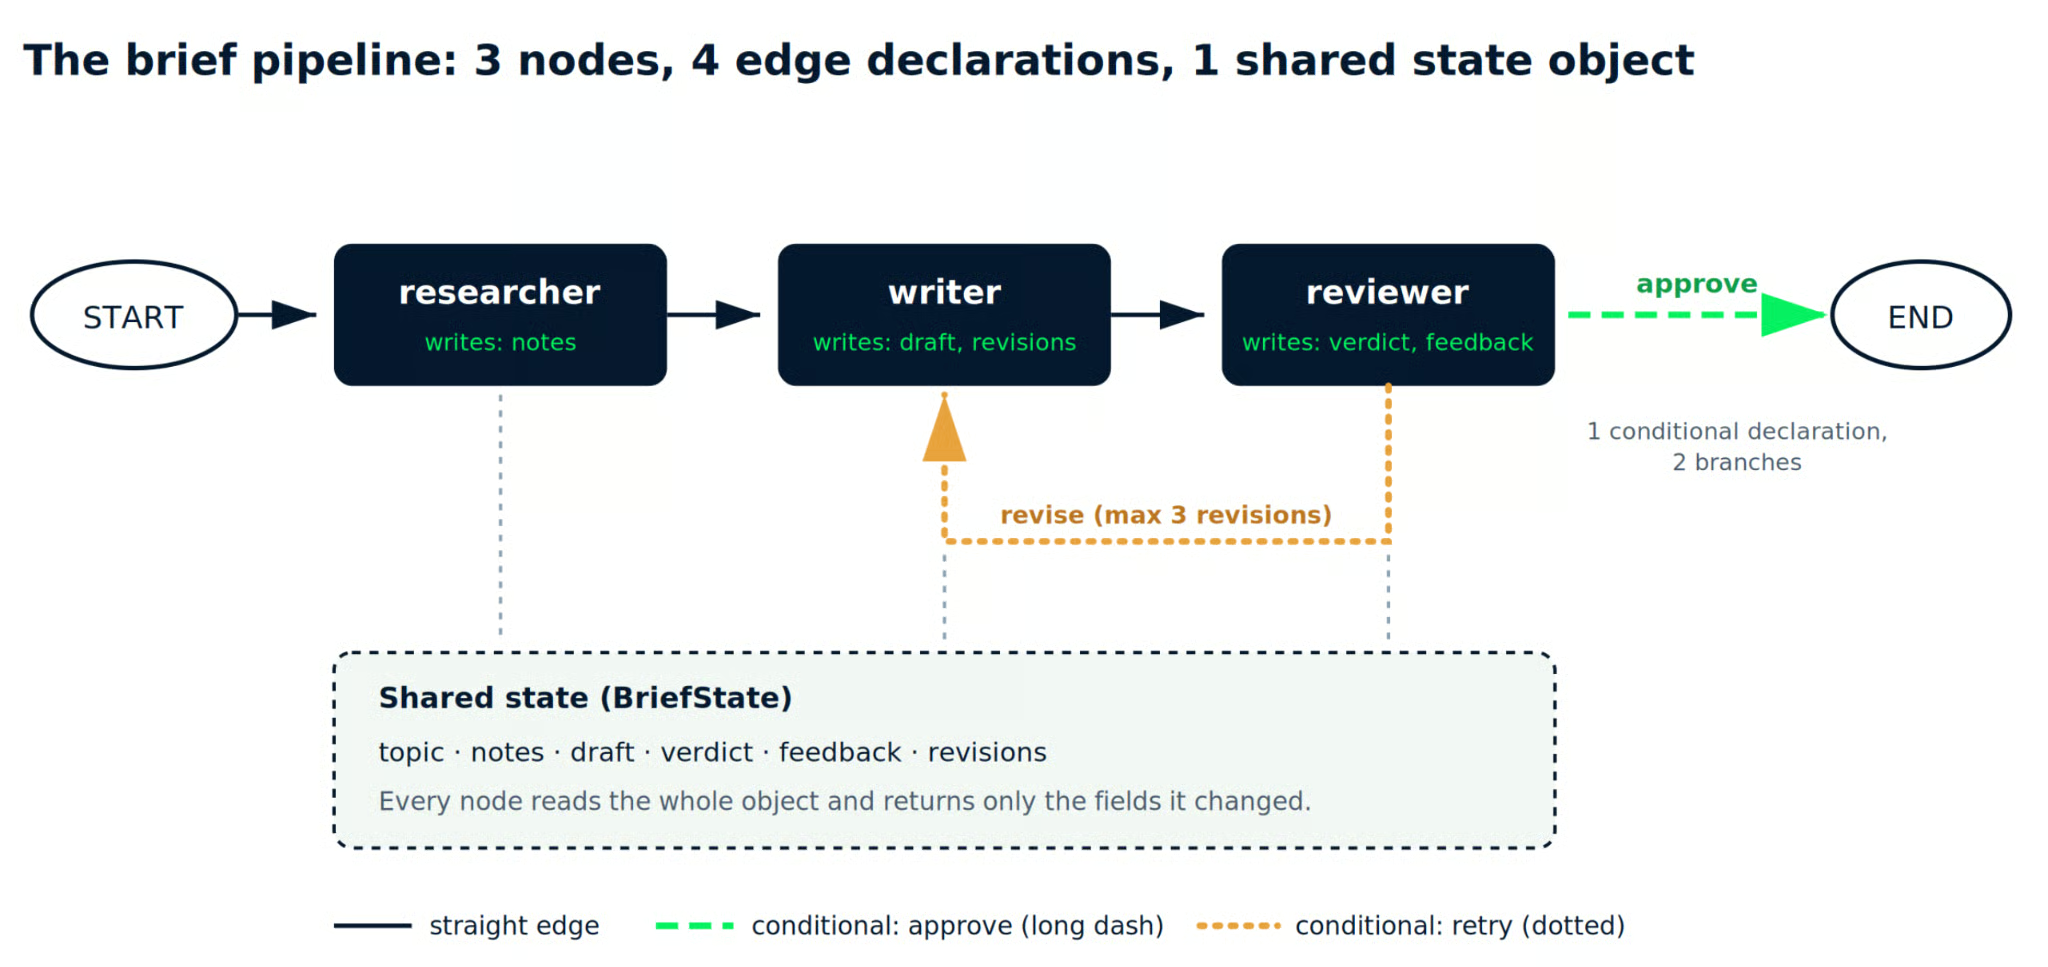
Imagine de autor. Pipeline-ul pe care urmează să-l construim. Liniile pline sunt cele 3 muchii directe; liniile punctate sunt cele 2 ramuri ale unei singure muchii condiționale.
Instalează pachetele, plus python-dotenv ca să-ți ții cheia în afara sursei:
pip install langgraph langchain-anthropic python-dotenvCreează un fișier .env lângă scriptul tău:
ANTHROPIC_API_KEY=sk-ant-your-key-hereAcum importurile și schema stării. Merită să scrii TypedDict mai întâi — sunt 2 minute — pentru că e contractul la care aderă fiecare node:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Două modele, nu unul. Asta e în cod „declanșatorul de model diferit per pas” din tabelul de decizie, deoarece research-ul e muncă cu volum mare și judecată redusă care nu are nevoie de modelul scump.
MAX_REVISIONS face aici o treabă tăcută, dar importantă.
Fără plafon, un reviewer strict și un writer încăpățânat își vor pasa draftul la nesfârșit până îți devine interesantă factura.
Fiecare node urmează același contract. Primește starea curentă, își face treaba și întoarce un dicționar care conține doar câmpurile pe care le-a schimbat.
Researcher-ul adună material brut și îl scrie în notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
O versiune de producție a acestui node ar apela un tool de căutare în loc să se bazeze pe cunoștințele proprii ale modelului.
Am păstrat-o ca un singur apel .invoke() ca să rămână vizibilă structura grafului, așa că tratează notițele produse ca neverificate.
Writer-ul citește acele notițe și produce un draft. Verifică și dacă există feedback de la reviewer, ceea ce oferă ceva asupra căruia să acționeze muchia de retry:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Reviewer-ul notează draftul.
Nu a văzut raționamentul writer-ului și nu a produs niciun text, deci poate fi tranșant cu rezultatul.
Asta e a treia categorie de eșec din taxonomia Berkeley, căreia i-am dat un node separat.
Verificarea sarcinii se rupe când nimic independent nu verifică ieșirea, așa că soluția e un lucrător care nu își poate marca singur tema:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Observă .text, nu .content, pe toate trei node-urile.
Ambele întorc un string pentru un răspuns simplu, dar .text face ce trebuie și când un răspuns vine ca mai multe blocuri de conținut, ceea ce te scapă de un confuz AttributeError: 'list' object has no attribute 'strip' mai târziu.
Parsatul verdictului de pe primul rând păstrează lizibilitatea, și e fragil.
Pentru orice rulează nesupravegheat, înlocuiește verificarea de string cu structured output din LangChain, ca verdictul să vină drept câmp tipizat, nu un prefix pe care speri că modelul îl respectă.
Funcția de rutare este muchia condițională. Citește starea după ce rulează reviewer-ul și întoarce numele a ceea ce ar trebui să se întâmple în continuare:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Păstrează funcția tăcută. Un print() în interiorul ei ajunge pe stdout în timp ce bucla de stream încă printează chunk-ul anterior, deci mesajul despre plafon apare cu un pas mai devreme și urma pare în dezordine.
Plafonul de revizii trăiește aici, nu într-un node, pentru că oprirea e o decizie de flux de control, iar fluxul de control aparține muchiilor.
Acum asamblează graful. Node-uri, apoi muchii, apoi compilează:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Al treilea argument pentru .add_conditional_edges() este harta de rute.
Listează fiecare destinație pe care o poate întoarce funcția de rutare, iar LangGraph o folosește ca să deseneze ramura înainte să fi rulat vreun node.
Invocă graful compilat cu o stare inițială. Doar topic și revisions au nevoie de valori, pentru că celelalte câmpuri se completează pe măsură ce execuția curge:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Asta îți dă starea finală și nimic altceva. Nu prea ajută când o rulare o ia razna.
Înlocuiește .invoke() cu .stream() cu stream_mode="updates" ca să vezi fiecare node raportând ce a scris. Fiecare apel e o rulare separată cu propriile apeluri la model, așa că folosește unul sau altul, nu ambele:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
La o rulare în care reviewer-ul respinge primul draft, asta printează următoarele:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Acolo sunt vizibile două lucruri pe care starea finală le ascunde.
Researcher-ul a rulat o dată, iar notițele lui au persistat prin ambele treceri de scriere, deci un retry nu reconectează research-ul. De asemenea, fiecare node a atins doar câmpurile lui, transformând regula de ownership de la scriere dinainte în ceva ce poți verifica.
Numără apelurile cât ești aici.
Acel traseu respins costă 5 apeluri de model față de circa 1 pentru o versiune cu un singur loop a aceleiași sarcini, iar singura cale să știi dacă cele 4 în plus ți-au cumpărat ceva e să loghezi verdictele și să le citești.
Nu ai nevoie de unelte în plus ca să vezi forma a ceea ce ai construit:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Ieșirea Mermaid redă ramura condițională ca linii punctate care pleacă din reviewer către __end__ și înapoi la writer.
Asta confirmă că muchia ta de retry există înainte să cheltui ceva pe apeluri de model. Vederea ASCII desenează doar calea directă de la start la end, deci folosește ieșirea Mermaid când vrei să vezi bucla.
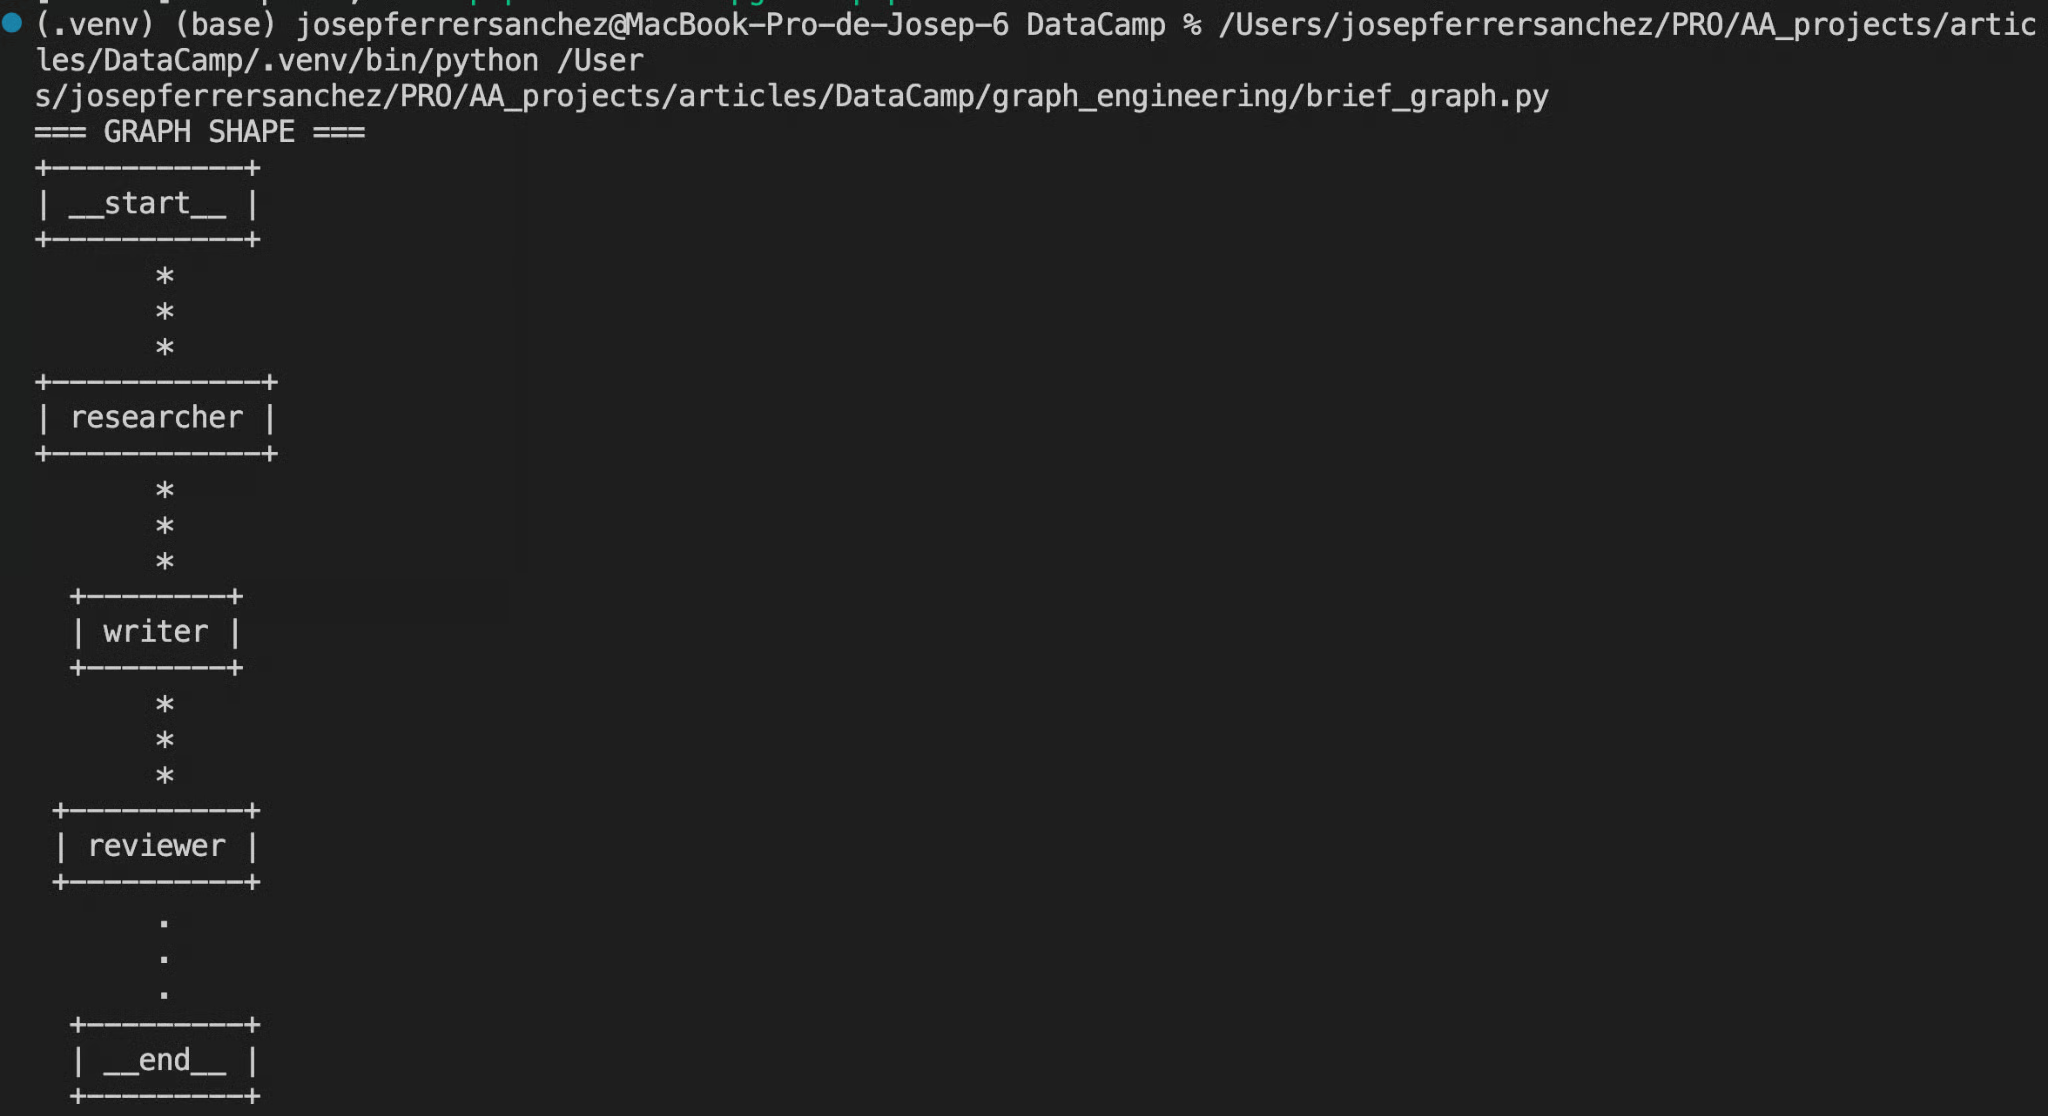
Captură de ecran de autor. Terminalul arătând ieșirea .draw_ascii(), cu __start__, researcher, writer, reviewer și __end__ stivuite vertical și conectate.
Pentru debug pas-cu-pas cu inspecția stării la fiecare node, LangGraph Studio se conectează la un server local. Asta cere propriul pachet și un fișier de config, deci pip install "langgraph-cli[inmem]", adaugă un langgraph.json care indică spre obiectul tău compilat graph, apoi rulează langgraph dev și deschide URL-ul Studio pe care îl printează.
Ghidul nostru pentru LangGraph Studio te plimbă prin interfață (datează din 2024, deci verifică pașii de setup față de comenzile de mai sus), iar tutorialul nostru despre agenți LangGraph acoperă adăugarea de tool-uri reale într-un node ca researcher-ul nostru.
O notă de scope.
Această „conductă” e secvențială, deci nu demonstrează fan-out, pattern-ul în care researcher-ul ar interoga mai multe surse odată, iar un node de join ar îmbina rezultatele.
Asta e extensia naturală următoare și, de asemenea, locul unde costurile se multiplică cel mai repede.
Modurile de eșec în graph engineering pentru AI agentic se repetă suficient de des încât să le poți numi. Acestea sunt cele trei pe care le verific înainte să livrez ceva.
Fiecare node este un loop în sine, cu un prompt, tool-uri și o definiție a „gata”.
Legarea a 3 node-uri șubrede îți dă un sistem șubred cu suprafață triplă și o poveste de debugging mult mai proastă.
Fă un node să meargă singur mai întâi.
Un researcher care întoarce notițe vagi când îl chemi direct întoarce notițe vagi și în interiorul unui graf, iar writer-ul din aval va construi încrezător pe ele.
Rezistă tentației de a pune logică într-un node când aparține pe o muchie.
Condițiile de oprire, deciziile de ramificare și plafoanele de retry sunt rutare, iar rutarea aparține în funcția de muchie, unde poți citi totul odată.
Aplică testul fără conjuncții de mai devreme.
Un node care caută surse și decide dacă sunt destule este 2 node-uri care împart aceeași semnătură.
Fan-out și buclele de retry multiplică folosirea de tokeni în moduri pe care o diagramă le ascunde complet.
Un fan-out în 5 care alimentează un node de join cu un plafon de 3 retry-uri nu înseamnă 5 apeluri; în funcție de unde stă retry-ul, pot fi 15 sau mai multe înainte de a număra join-ul.
Setează plafonul explicit, cum am făcut cu MAX_REVISIONS. Apoi loghează numărul de tokeni per node și citește-i după o săptămână, pentru că node-ul pe care l-ai presupus ieftin e de obicei cel care rulează cel mai des.
AutoGen e încă recomandat pentru orchestrare de graf, iar munca sa experimentală GraphFlow a fost un real precedent, dar repository-ul e în modul de mentenanță din septembrie 2026, fără funcționalități noi.
Microsoft direcționează noii utilizatori către Microsoft Agent Framework, care are propriile fluxuri bazate pe graf, printr-un ghid de migrare publicat.
Începând de azi, LangGraph, ADK-ul Google sau Microsoft Agent Framework sunt alegeri mai sigure, iar cursul nostru Building AI Agents with Google ADK acoperă ADK în profunzime.
Graph engineering este stratul de coordonare deasupra loop engineering.
Node-urile fac treaba, muchiile decid ce rulează în continuare, iar un singur obiect partajat poartă informația între ele.
Dacă înlături zgomotul timeline-ului din iulie 2026, acesta este întregul model.
Pipeline-ul nostru a rămas mic intenționat: 3 node-uri, 4 declarații de muchii (1 dintre ele condițională, deci desenează 2 ramuri) și un plafon de revizii ca retry-ul să nu o ia razna.
A fost suficientă structură pentru a obține un draft revizuit de ceva ce nu l-a scris, iar această proprietate singulară este ceea ce un loop nu putea oferi.
Apelează la un graf când munca se împarte în faze care au nevoie de specialiști diferiți — și nu un node mai devreme. Scepticii aveau dreptate că mecanica are decenii și că mare parte din scrisul pe tema termenului e zgomot.
Aveau dreptate și în privința părții care contează într-o marți după-amiază.
Un verificator slab atașat unei probleme în formă de loop nu se îmbunătățește pentru că ai desenat mai multe căsuțe în jurul ei.
Pentru a duce aceste pattern-uri mai departe, cursul nostru Multi-Agent Systems with LangGraph acoperă designurile cu supervizor și rețea la care acest tutorial se oprește.
Pe partea de date a cuvântului, Graph RAG cu LangChain și Neo4j e un pas bun următor. Dacă vrei să rămâi pe partea de orchestrare, Text-to-Query Agents cu MongoDB și LangGraph construiește o „conductă” LangGraph peste o bază de date live, iar LLM Agents Explained completează arhitectura de dedesubtul tuturor.
Scriptul complet este în repo-ul meu de pe GitHub, cu helperul pentru randarea grafului și o scurtă notă despre cât costă fiecare rulare.
Top DataCamp Courses
course
course
course