
course
LangGraph के साथ Multi-Agent Systems
2 घंटा 45 मिनट
8.6K
किसी एजेंट को एक काम दें, तो वह ठीक करता है। उसे तीन दें, और दूसरे हैंडऑफ के आसपास देखें क्या होता है: वह पहले चरण में जो पाया था, उसे भूल जाता है; वह अपने ही ड्राफ्ट को उदारता से रेट करता है; और आउटपुट अधूरा पड़ा होने पर भी सफलता घोषित कर देता है।
जुलाई 2026 के मध्य में इसी पैटर्न पर बहस तब जोर पकड़ गई जब "ग्राफ इंजीनियरिंग" X (पहले Twitter) पर ट्रेंड हुई, और टाइमलाइन तुरंत दो हिस्सों में बंट गई—कुछ लोग एजेंट लूप की मौत का ऐलान कर रहे थे और कुछ इस टर्म को कंटेंट-फार्म की भराई कह रहे थे।
मेरा मत है कि ग्राफ इंजीनियरिंग का लेबल वैकल्पिक है, पर भीतर की एस्केलेशन वैकल्पिक नहीं है—और कोड लिखने से पहले मैं इसे जायज़ ठहराने की कोशिश करूंगा।
इस महीने जो भी आप बनाएंगे, उसका अधिकांश हिस्सा अभी भी एक सिंगल लूप होना चाहिए; और एक ऐसे काम के लिए जिसे एक बॉक्स चाहिए था, 6 बॉक्स वाला डायग्राम बनाना एक हफ्ता बर्बाद करने का सबसे तेज़ तरीका है।
एक एजेंट ग्राफ के 3 हिस्से होते हैं:
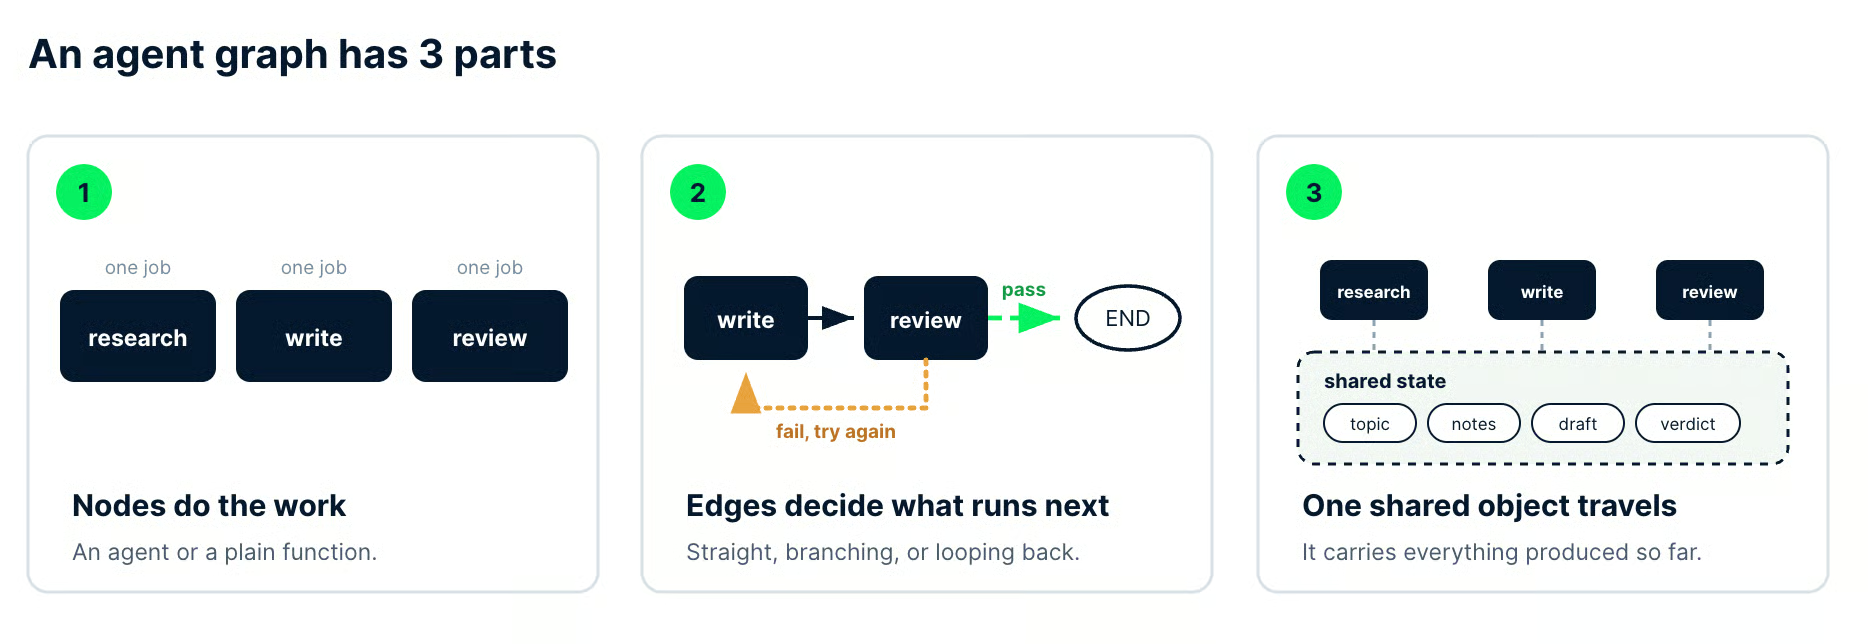
लेखक द्वारा इमेज। आगे बनने वाली पाइपलाइन पर दिखे 3 हिस्से: 3 नामित नोड्स, एक पास एज और एक रिट्राई एज, और एक स्टेट ऑब्जेक्ट जो topic, notes, draft और verdict इकट्ठा करता है।
इन तीनों को पहले से घोषित करना—बजाय इसके कि एक सिंगल एजेंट अपनी राह खुद गढ़े—ही वह चीज़ है जिसे ग्राफ इंजीनियरिंग कहा जाता है।
यह ट्यूटोरियल Python में LangGraph के साथ एक काम करने वाली researcher, writer, और reviewer पाइपलाइन बनाता है, जिसमें असफल ड्राफ्ट को संशोधन के लिए वापस भेजने वाला एक conditional edge भी शामिल है।
आपको Python, pip, और बड़े भाषा मॉडल (LLMs) या AI एजेंट्स का कुछ ज्ञान चाहिए। यदि एजेंट्स नए हैं, तो हमारा Introduction to AI Agents कोर्स इस लेख में मानी गई अवधारणाएँ कवर करता है, और हमारा LangGraph एजेंट्स ट्यूटोरियल हाथ-से-सीखने वाला भाग समझाता है।
ग्राफ इंजीनियरिंग का अर्थ है एजेंट सिस्टम के कंट्रोल फ्लो को मॉडल की सूझ-बूझ पर छोड़ने के बजाय कोड में स्पष्ट रूप से लिखना।
आप बताते हैं कि कौन से विशेषज्ञ वर्कर मौजूद हैं, उनके बीच कौन-से ट्रांज़िशन मान्य हैं, और उन ट्रांज़िशन के साथ कौन-सी जानकारी चलती है।
एजेंट अब भी स्वतंत्र रूप से तर्क करता है, लेकिन पूरे काम में नहीं—एक नोड के भीतर।
आखिरी वाक्य ही पूरा अंतर है।
लूप में, आप एक लक्ष्य और क्वालिटी बार सेट करते हैं, और एजेंट उसे पाने का रास्ता खुद चुनता है। ग्राफ में, आप रास्ता और चेकपॉइंट तय कर देते हैं, इसलिए मॉडल की स्वायत्तता एक ऐसे ढांचे में बंध जाती है जिसे आप एक डिफ़ में पढ़ सकते हैं।
यह लेबल जुलाई 2026 में X पर जोर से सुना गया, पर शुरुआत वहाँ नहीं हुई। CodiumAI (अब Qodo) के Itamar Friedman ने फरवरी 2024 में ही "prompt engineering से flow (/graph) engineering की ओर" शिफ्ट का ज़िक्र किया था, और उनकी टीम के AlphaCodium पेपर ने इसके आंकड़े दिए।
CodeContests वैलिडेशन सेट पर GPT-4 pass@5 सटीकता एक अच्छे प्रॉम्प्ट के साथ 19% से मल्टी-स्टेज फ्लो के साथ 44% हुई। दोनों ही स्थितियों में प्रति समस्या 5 प्रयास थे, सिंगल-शॉट नहीं।
जुलाई 2026 में जो हुआ, वह एम्प्लीफिकेशन था।
18 जुलाई को Peter Steinberger ने X पर पूछा, "क्या हम अब भी loops की बात कर रहे हैं या graphs पर शिफ्ट हो गए हैं?", Mike Masson द्वारा प्रॉम्प्ट, कॉन्टेक्स्ट, हार्नेस, लूप, ग्राफ वाली सीढ़ी पोस्ट करने के एक हफ्ते बाद। सवाल को 3.1 मिलियन व्यूज़ मिले, और जो वाक्यांश फैला, वह पहले से चलन में था।
पुशबैक भी तुरंत आया। LangGraph के पीछे की टीम LangChain के सह-संस्थापक Harrison Chase ने पूछा कि क्या पूरी चीज़ "बेसिकली बस langgraph?" ही है।
Dale Everett ने दूसरी तरफ से धक्का दिया, तर्क देते हुए कि लूप हमेशा एक-नोड ग्राफ रहा है, तो जुलाई का उत्साह पुराने ज़मीन की फिर खोज थी। LangChain की अपनी रेट्रोस्पेक्टिव, 3 Years of Graph Engineering with LangGraph, भी इसी लाइन पर जाती है, एजेंट ग्राफ्स को ऐसा पैटर्न मानते हुए जिसे वे 3 साल से बना रहे हैं।
तो मैं इस टर्म को उपयोगी शॉर्टहैंड के तहत रखता हूँ।
इसने हमें उन डिज़ाइन सवालों के लिए साझा नाम दिया जो पहले फ्रेमवर्क डॉक्यूमेंटेशन में दफ्न रहते थे—और कोई नाम तब काम आता है जब आप किसी पुल रिक्वेस्ट में आर्किटेक्चर पर बहस कर रहे हों।
ग्राफ इंजीनियरिंग निष्पादन संरचना का वर्णन करती है, जो इसे उन दो चीज़ों से अलग करती है जो इसकी शब्दावली उधार लेती हैं।
नॉलेज ग्राफ और GraphRAG डेटा का वर्णन करते हैं।
वे दस्तावेज़ों को एंटिटी और रिलेशनशिप में बदलते हैं ताकि रिट्रीवल सिस्टम तथ्यों के बीच कनेक्शन पर चल सके—और इनके टूलिंग, स्टोरेज, और मूल्यांकन मीट्रिक्स सब अलग होते हैं।
उस पक्ष के लिए, हमारा नॉलेज ग्राफ का उपयोग करके RAG एप्लिकेशन बनाने वाला ट्यूटोरियल सही शुरुआती बिंदु है, और हमारा ग्राफ थ्योरी का परिचय दोनों के नीचे बैठने वाले गणित को कवर करता है।
दूसरी बात जो यह नहीं है: कोई नई क्षमता।
LangGraph, Google का Agent Development Kit (ADK), और Microsoft AutoGen—इन सबने लेबल वायरल होने से पहले ही मल्टी-एजेंट ऑर्केस्ट्रेशन शिप कर दी थी, तो अगर आपने StateGraph लिखा है, आप पहले से यही कर रहे थे।
कई पाठक पाएंगे कि वे एक साल से "मेरी LangGraph पाइपलाइन" नाम के तहत ग्राफ इंजीनियरिंग कर रहे हैं।
AI इंजीनियरिंग की हर परत मॉडल से एक कदम बाहर की किसी चीज़ पर नियंत्रण लेती है।
इस तालिका को पढ़ने का उपयोगी तरीका दाहिना कॉलम है, जो बताता है कि आप अगर कोई पायदान छोड़ देते हैं और फिर भी उसके ऊपर बिल्ड करने की कोशिश करते हैं, तो असल में टूटता क्या है।
| परत | आप क्या नियंत्रित करते हैं | क्या टूटेगा अगर इसे छोड़ दें |
|---|---|---|
| प्रॉम्प्ट | अनुरोध की भाषा | मॉडल वह सवाल जवाब देगा जो आपने पूछा ही नहीं |
| कॉन्टेक्स्ट | कौन-से इनपुट मॉडल तक पहुँचते हैं | यह गलत सामग्री पर अच्छी तरह तर्क करेगा |
| हार्नेस | टूल्स, मेमोरी, फाइल और API एक्सेस | यह चैट विंडो के बाहर किसी चीज़ को छू ही नहीं पाएगा |
| लूप | दोहराओ-जब-तक-खत्म न हो चक्र | यह जल्दी रुक जाएगा, या कभी रुकेगा ही नहीं |
| ग्राफ | अगला कौन-सा वर्कर चलेगा, और किस पर | एक एजेंट 4 एजेंट बनने की कोशिश करता है और 3 को भूल जाता है |
कोई पायदान छोड़ना ग्राफ प्रोजेक्ट्स के फेल होने का सबसे आम तरीका है, और विफलता शायद ही स्पष्ट होती है।
तीन अविश्वसनीय नोड्स को एक साथ वायर करना किसी विश्वसनीय सिस्टम का औसत नहीं बनता।
वे ऐसा सिस्टम बनाते हैं जो और अधिक जगहों पर फेल होता है, हर फेल्यर पर ज़्यादा महँगा पड़ता है, और डायग्नोज़ करने में लंबा लगता है क्योंकि अब खराब आउटपुट उस नोड से 2 हैंडऑफ दूर बैठा है जिसने उसे पैदा किया।
कोई भी एजेंट ग्राफ—चाहे उसमें 3 नोड हों या 30—नोड्स, एजेज़, और साझा स्टेट में टूटता है।
एक बार जब आप किसी कोडबेस में इन 3 हिस्सों को नाम दे सकते हैं, तो अधिकांश ऑर्केस्ट्रेशन फ्रेमवर्क बिना डॉक्यूमेंटेशन के भी पढ़े जा सकते हैं।
एक नोड एक नाम और एक सिंगल ज़िम्मेदारी वाला काम की इकाई है।
यह किसी विशेष प्रॉम्प्ट और अपने टूल्स के साथ एक LLM कॉल हो सकता है, या एक साधारण Python फ़ंक्शन जो डेटाबेस क्वेरी करता है, स्कीमा वैलिडेट करता है, या फाइल लिखता है।
मॉडल कॉल्स उन चरणों के लिए बचाकर रखें जिन्हें सेमान्टिक जजमेंट चाहिए।
अगर किसी नियम का उत्तर पहले से तय है, तो उसे Python में रखें—जहाँ वह माइक्रोसेकंड में चलता है, कुछ नहीं खर्चता, और हर बार एक जैसा परिणाम देता है।
यह है मेरा टेस्ट किसी चीज़ को बाँटना चाहिए या नहीं: बिना संयोजन शब्द के एक वाक्य में नोड का वर्णन करके देखें।
एक नोड जो "सोर्सेस खींचता है और तय करता है कि क्या हमारे पास पर्याप्त हैं"—वह पहले ही फेल है, क्योंकि आप रिट्रीवल वाले आधे हिस्से को जजमेंट वाले हिस्से को छेड़े बिना स्वैप नहीं कर सकते।
एक एज तय करता है कि मौजूदा नोड खत्म होने के बाद क्या चलेगा।
चार आकृतियाँ लगभग सब कुछ कवर कर देती हैं जो आप बनाएँगे:
एजेज़ ही वह जगह हैं जहाँ आपकी स्टॉपिंग लॉजिक होनी चाहिए। रिट्राई कैप, क्वालिटी गेट्स, और एस्केलेशन नियम सभी रूटिंग निर्णय हैं, और इन्हें एज फ़ंक्शनों में रखने का मतलब है कि आप कंट्रोल फ्लो को एक ही जगह ऑडिट कर सकते हैं—न कि नोड बॉडीज़ में ढूँढते फिरें।
शेयर्ड स्टेट वह सिंगल ऑब्जेक्ट है जिसे हर नोड रन के दौरान पढ़ता और लिखता है।
इसके बिना, आपके पास कई एजेंट आस-पास का काम कर रहे हैं और एक-दूसरे को कुछ नहीं दे रहे—तो लेखक नहीं देख पाएगा कि रिसर्चर ने क्या पाया, और रिव्यूअर दोनों में से किसी को नहीं।
LangGraph में, स्टेट आमतौर पर TypedDict होता है।
हमारे स्टेट में टॉपिक, रिसर्चर के नोट्स, मौजूदा ड्राफ्ट, रिव्यूअर का फैसला और फीडबैक, और एक रिवीज़न काउंटर जमा होता है। हर नोड केवल वही फ़ील्ड लौटाता है जिसे उसने बदला, और फ्रेमवर्क उन रिटर्न्स को रनिंग ऑब्जेक्ट में मर्ज कर देता है।
राइट ओनरशिप वह जगह है जहाँ ग्राफ सबसे पहले सड़ते हैं।
कोडिंग से पहले तय करें कि कौन-सा नोड किस फ़ील्ड को लिख सकता है, क्योंकि ऐसा स्टेट ऑब्जेक्ट जिसे 3 अलग-अलग नोड्स ओवरराइट कर सकते हैं—वह एक डिबगिंग सेशन है जिसे आपने अपने लिए पहले ही शेड्यूल कर दिया है।
लूप इंजीनियरिंग उस चक्र को डिज़ाइन करती है जिसे एक सिंगल एजेंट खत्म होने तक दोहराता है, और ग्राफ इंजीनियरिंग उन कई चक्रों के बीच समन्वय को डिज़ाइन करती है।
यह लेख का सबसे निर्णायक निर्णय है, इसलिए ट्यूटोरियल से पहले आता है।
डिफ़ॉल्ट जवाब है—लूप।
एक सिंगल, स्पष्ट-परिभाषित एजेंट कठोर वेरिफायर के साथ—उसी काम के किसी भी ग्राफ की तुलना में—जल्दी बनता है, सस्ता चलता है, और डिबग करना बहुत आसान होता है।
यह सिर्फ मेरी पसंद नहीं है।
UC Berkeley की एक टीम (प्रथम लेखक Mert Cemri) इस अवलोकन से शुरू करती है कि मल्टी-एजेंट सेटअप्स के सिंगल-एजेंट पर लाभ अक्सर मामूली होते हैं, फिर 7 मल्टी-एजेंट फ्रेमवर्क्स की 1,600+ एग्ज़ीक्यूशन ट्रेसेज़ को एनोटेट करके पता लगाती है कि क्यों (arXiv:2503.13657, v3)।
उनकी टैक्सोनॉमी, जिनमें से 150 ट्रेस की क्लोज़ रीडिंग से बनी, 14 अलग-अलग फेल्यर मोड्स के नाम देती है।
ये 14 मोड 3 कैटेगरी में बंटते हैं: सिस्टम डिज़ाइन इश्यूज़, इंटर-एजेंट मिसअलाइन्मेंट, और टास्क वेरिफिकेशन।
उस तीसरे को तब तक पकड़ कर रखें जब तक हम रिव्यूअर नोड तक नहीं पहुँचते।
इन्हें ट्रिगर मानें, चेकलिस्ट नहीं।
दाएँ कॉलम में एक साफ-सुथरा हाँ काफी है, और पाँच धुंधले हाँ नहीं।
| आपके टास्क के बारे में सवाल | लूप संभाल लेगा | आपको ग्राफ चाहिए |
|---|---|---|
| क्या आप काम को एक निर्देश में लिख सकते हैं? | हाँ, और कोई व्यक्ति इसे शुरू से अंत तक मान सकता है | यह दो अलग भूमिकाओं के बीच हैंडऑफ जैसा पढ़ता है |
| क्या हर स्टेप को एक ही मॉडल चाहिए? | सारे समय एक मॉडल और एक टूलसेट | इकट्ठा करना सस्ता-तेज़ चाहता है, जज करना तेज़-धार |
| क्या कोई स्टेप एक-दूसरे पर निर्भर नहीं? | हर स्टेप को पिछले स्टेप का आउटपुट चाहिए | कई लुकअप जिन्हें सब एक साथ चलाया जा सकता है |
| आउटपुट पर्याप्त अच्छा है या नहीं—कौन तय करता है? | एजेंट अपना काम खुद दोबारा पढ़ता है | जिसने उसे लिखा नहीं है, उसे साइन-ऑफ करना है |
| किसी स्टेप के फेल होने पर क्या होना चाहिए? | उसे दोहराएँ और आगे बढ़ें | विफलता को सीमित रखें ताकि बाकी रन बचा रहे |
| क्या किसी को लिए गए रास्ते का ऑडिट करना है? | ट्रेस आपके और आपकी टीम के लिए है | बाहर का कोई देखना चाहता है कि कौन-सा स्टेप क्यों चला |
जो ओवर-इंजीनियर किया हुआ वर्ज़न मुझे सबसे ज़्यादा दिखता है, वह एजेंट्स के बारे में है ही नहीं। किसी को 800 होटल पतों की सूची साफ करनी और जियोकोड करनी है, और वह 5-नोड ग्राफ के रूप में आता है: लोडर, नॉर्मलाइज़र, जियोकोडर, वेलिडेटर, और राइटर नोड—शेयर्ड स्टेट के साथ।
इनमें से हर स्टेप डिटरमिनिस्टिक है, तो असल में जो बना है वह एक 40-लाइन Python स्क्रिप्ट है जो एक फ्रेमवर्क पहन कर आई है—और अब यह प्रति पंक्ति पैसा खाती है और उन तरीकों से फेल होती है जिनमें pandas कभी नहीं होता।
सही साइज़ वाला वर्ज़न वही है जो हम बनाने वाले हैं।
एक छोटा रिसर्च्ड ब्रीफ़ बनाना ऐसे काम में बँटता है जिसमें एक सिंगल लूप जूझता है: कच्चा मटेरियल इकट्ठा करना, उसे गद्य में बदलना, और फिर उसी गद्य का बाहर से जजमेंट।
तीसरा स्टेप ग्राफ के अस्तित्व का कारण है, क्योंकि एजेंट अपना ही ड्राफ्ट रिव्यू कर रहा है—तो वह रिव्यू ही नहीं है।
तीन चीज़ें एक नोड को जायज़ ठहराती हैं।
अगर हर जोड़े गए नोड के लिए आप इनमें से किसी एक पर उंगली नहीं रख सकते, तो नोड हटा दें और उसका काम पड़ोसी में मिला दें।
पहला—असली विशेषज्ञता।
हमारा रिसर्चर सस्ता, तेज़ मॉडल और—प्रोडक्शन में—सर्च टूल्स चाहता है। राइटर इनमें से कुछ नहीं चाहता और मज़बूत मॉडल से फ़ायदा उठाता है, तो यह बँटवारा डायग्राम सजाने के बजाय वास्तविक काम कर रहा है।
दूसरा—वह पैरेललिज़्म जो सच में महसूस होगा।
फैन-आउट तब चुकता देता है जब शाखाएँ स्वतंत्र हों और वॉल-क्लॉक बचत किसी के लिए मायने रखती हो—और जब ऐसा नहीं होता, तो यह अनावश्यक जटिलता का खर्चा है।
तीसरा—और इसे मैं सबसे कड़ी तरह से बचाऊँगा—स्वतंत्र वेरिफिकेशन।
अपना होमवर्क एजेंट खुद ग्रेड करेगा तो नरमी से करेगा, इसलिए ड्राफ्ट पर केवल रीड-ओनली पहुँच रखने वाला अलग रिव्यूअर नोड अक्सर किसी भी ग्राफ का सबसे मूल्यवान नोड होता है।
इन पैटर्न्स को अलग-अलग लाइब्रेरीज़ कैसे व्यक्त करती हैं, इसका फ्रेमवर्क-स्तरीय व्यू के लिए हमारा CrewAI बनाम LangGraph बनाम AutoGen तुलना लेख ट्रेडऑफ़्स स्पष्ट करता है।
हम एक LangGraph मल्टी-एजेंट पाइपलाइन बना रहे हैं जिसमें एक रिसर्चर, एक राइटर, और एक रिव्यूअर है—जो एक छोटा रिसर्च्ड ब्रीफ़ बनाता है और असफल ड्राफ्ट्स को संशोधन के लिए वापस भेजता है।
LangGraph स्टेटफुल एजेंट्स के लिए लो-लेवल ऑर्केस्ट्रेशन फ्रेमवर्क है, और इसका StateGraph पिछले सेक्शन के नोड्स, एजेज़ और स्टेट पर लगभग एक-से-एक मैप होता है।
नीचे की हर चीज़ सितंबर 2026 में langgraph 1.2.11 और langchain-anthropic 1.7.1 पर जाँची गई।
अगर यह लाइब्रेरी आपके लिए नई है, तो हमारा LangGraph ट्यूटोरियल बुनियादी बातें कवर करता है। यह सेक्शन तेज़ी से चलता है, और हमारा LangChain बनाम LangGraph बनाम LangSmith बनाम LangFlow गाइड इस फैमिली के हर हिस्से का काम समझाता है।
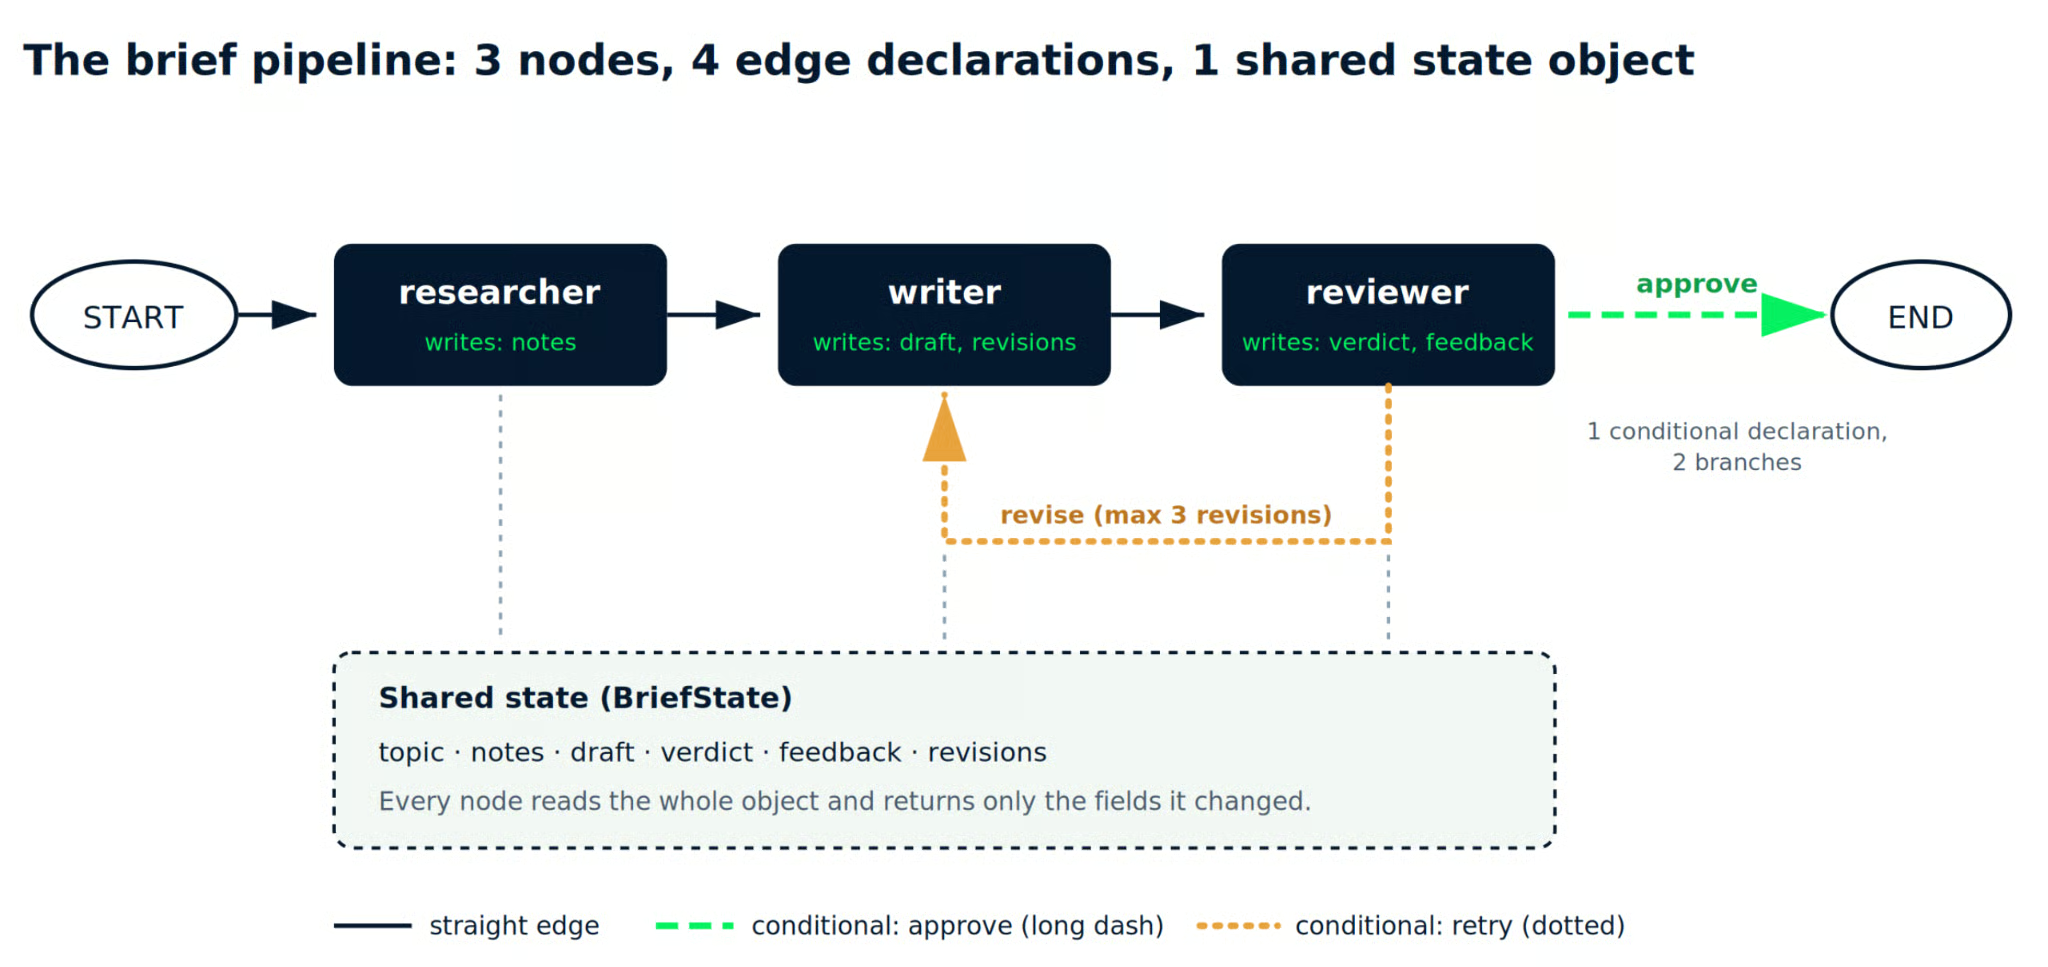
लेखक द्वारा इमेज। वह पाइपलाइन जिसे हम बनाने वाले हैं। ठोस रेखाएँ 3 सीधे एज हैं; टूटी और बिंदीदार रेखाएँ एक ही कंडीशनल एज की 2 शाखाएँ हैं।
पैकेज इंस्टॉल करें, साथ में python-dotenv ताकि आपकी कुंजी सोर्स से बाहर रहे:
pip install langgraph langchain-anthropic python-dotenvअपने स्क्रिप्ट के पास एक .env फाइल बनाएँ:
ANTHROPIC_API_KEY=sk-ant-your-key-hereअब इम्पोर्ट्स और स्टेट स्कीमा। TypedDict पहले लिखना 2 मिनट के काबिल है, क्योंकि यही वह कॉन्ट्रैक्ट है जिस पर हर नोड सहमत होता है:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
दो मॉडल, एक नहीं। यह निर्णय तालिका वाला "हर स्टेप के लिए अलग मॉडल" ट्रिगर है—रिसर्च हाई-वॉल्यूम और लो-जजमेंट काम है जिसे महँगे मॉडल की ज़रूरत नहीं।
MAX_REVISIONS यहाँ चुपचाप लेकिन अहम काम कर रहा है।
कैप के बिना, एक सख्त रिव्यूअर और जिद्दी राइटर ड्राफ्ट को आगे-पीछे पास करते रहेंगे—जब तक आपका इनवॉइस रोचक न हो जाए।
हर नोड एक जैसा कॉन्ट्रैक्ट फॉलो करता है। यह मौजूदा स्टेट लेता है, अपना एक काम करता है, और केवल वे फ़ील्ड लौटाता है जिन्हें उसने बदला।
रिसर्चर कच्चा मटेरियल इकट्ठा करता है और उसे notes में लिखता है:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
इस नोड का प्रोडक्शन वर्ज़न मॉडल की अपनी जानकारी पर निर्भर रहने के बजाय किसी सर्च टूल को कॉल करेगा।
मैंने इसे एक ही .invoke() कॉल रखा ताकि ग्राफ स्ट्रक्चर दिखता रहे—तो जो नोट्स यह बनाता है, उन्हें अनवेरिफाइड समझें।
राइटर वे नोट्स पढ़ता है और एक ड्राफ्ट बनाता है। यह रिव्यूअर फीडबैक की भी जाँच करता है—जिससे रिट्राई एज को एक्शन मिलता है:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
रिव्यूअर ड्राफ्ट को स्कोर करता है।
उसने राइटर की रीजनिंग नहीं देखी और न ही टेक्स्ट का कोई हिस्सा लिखा—तो वह नतीजे पर बेबाक हो सकता है।
यह Berkeley टैक्सोनॉमी की तीसरी फेल्यर कैटेगरी है, जिसे एक अलग नोड दिया गया है।
टास्क वेरिफिकेशन तब टूटता है जब कुछ भी स्वतंत्र रूप से आउटपुट की जाँच नहीं करता—तो फिक्स है ऐसा वर्कर जो अपना होमवर्क खुद मार्क नहीं कर सकता:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
ध्यान दें, तीनों नोड्स पर .content नहीं बल्कि .text।
दोनों एक साधारण रिप्लाई के लिए स्ट्रिंग लौटाते हैं, लेकिन .text तब भी सही काम करता है जब रिस्पॉन्स कई कंटेंट ब्लॉक्स में आए—जो बाद में उलझाऊ AttributeError: 'list' object has no attribute 'strip' से बचाता है।
पहली लाइन से वर्डिक्ट पार्स करना पठनीय रखता है—और नाज़ुक है।
बिना निगरानी चलने वाली किसी चीज़ के लिए, उस स्ट्रिंग चेक की जगह LangChain का structured output इस्तेमाल करें—ताकि वर्डिक्ट एक टाइप्ड फ़ील्ड के रूप में आए, न कि ऐसे प्रीफ़िक्स के रूप में जिस पर आप उम्मीद लगाए बैठे हों।
रूटिंग फ़ंक्शन ही कंडीशनल एज है। यह रिव्यूअर के बाद स्टेट पढ़ता है और लौटाता है कि आगे क्या होना चाहिए:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
उस फ़ंक्शन को चुप रखें। उसके अंदर print() पिछला स्ट्रीम लूप अभी भी पिछला चंक प्रिंट करते हुए stdout पर उतरता है—तो कैप नोटिस एक स्टेप पहले दिख जाता है और ट्रेस उलटी लगती है।
रिवीज़न कैप नोड के अंदर नहीं बल्कि यहाँ रहता है—क्योंकि रुकना कंट्रोल-फ्लो का फैसला है और कंट्रोल-फ्लो एज पर होना चाहिए।
अब ग्राफ असेंबल करें। नोड्स, फिर एजेज़, फिर कम्पाइल:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
.add_conditional_edges() का तीसरा आर्ग्युमेंट पाथ मैप है।
यह हर डेस्टिनेशन लिस्ट करता है जिसे रूटिंग फ़ंक्शन लौटा सकता है—और LangGraph इसका इस्तेमाल किसी नोड के चलने से पहले ही शाखा ड्रॉ करने में करता है।
कम्पाइल्ड ग्राफ को एक इनिशियल स्टेट के साथ इनवोक करें। केवल topic और revisions को मान चाहिए—बाकी फ़ील्ड्स एक्सेक्यूशन के साथ भरते चलते हैं:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
यह आपको केवल फाइनल स्टेट देता है—और कुछ नहीं। रन बिगड़ जाए तो ज्यादा मदद नहीं।
.invoke() की जगह .stream() का इस्तेमाल करें, stream_mode="updates" के साथ—ताकि हर नोड बताए कि उसने क्या लिखा। हर कॉल अलग रन है, अपने मॉडल कॉल्स के साथ—तो दोनों न चलाएँ; इनमें से एक चुनें:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
ऐसे रन में जहाँ रिव्यूअर पहला ड्राफ्ट रिजेक्ट करता है, यह आउटपुट देता है:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
दो चीज़ें वहाँ दिखती हैं जो फाइनल स्टेट छिपा देता है।
रिसर्चर एक बार चला और उसके नोट्स दोनों राइटिंग पास के दौरान टिके रहे—तो रिट्राई फिर से रिसर्च नहीं करता। हर नोड ने केवल अपने फ़ील्ड्स छुए—जिससे पहले वाला राइट-ओनरशिप नियम ऐसी चीज़ बन जाता है जिसे आप वेरिफाई कर सकते हैं।
यहाँ रहते हुए कॉल्स गिनें।
वह रिजेक्टेड पाथ 5 मॉडल कॉल्स की कीमत लेता है—उसी टास्क के सिंगल-लूप वर्ज़न के लगभग 1 कॉल की तुलना में। और अतिरिक्त 4 ने आपको कुछ दिलाया या नहीं—यह जानने का एकमात्र तरीका वर्डिक्ट्स को लॉग करना और पढ़ना है।
जो आपने बनाया, उसका आकार देखने के लिए अतिरिक्त टूलिंग की ज़रूरत नहीं:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Mermaid आउटपुट कंडीशनल ब्रांच को reviewer से __end__ और writer दोनों की ओर जाती टूटी रेखाओं के रूप में रेंडर करता है।
यह आपके रिट्राई एज के अस्तित्व की पुष्टि करता है—मॉडल कॉल्स पर कुछ खर्च करने से पहले। ASCII व्यू केवल स्टार्ट से एंड तक की सीधी राह ड्रॉ करता है—तो लूप देखना हो तो Mermaid आउटपुट इस्तेमाल करें।
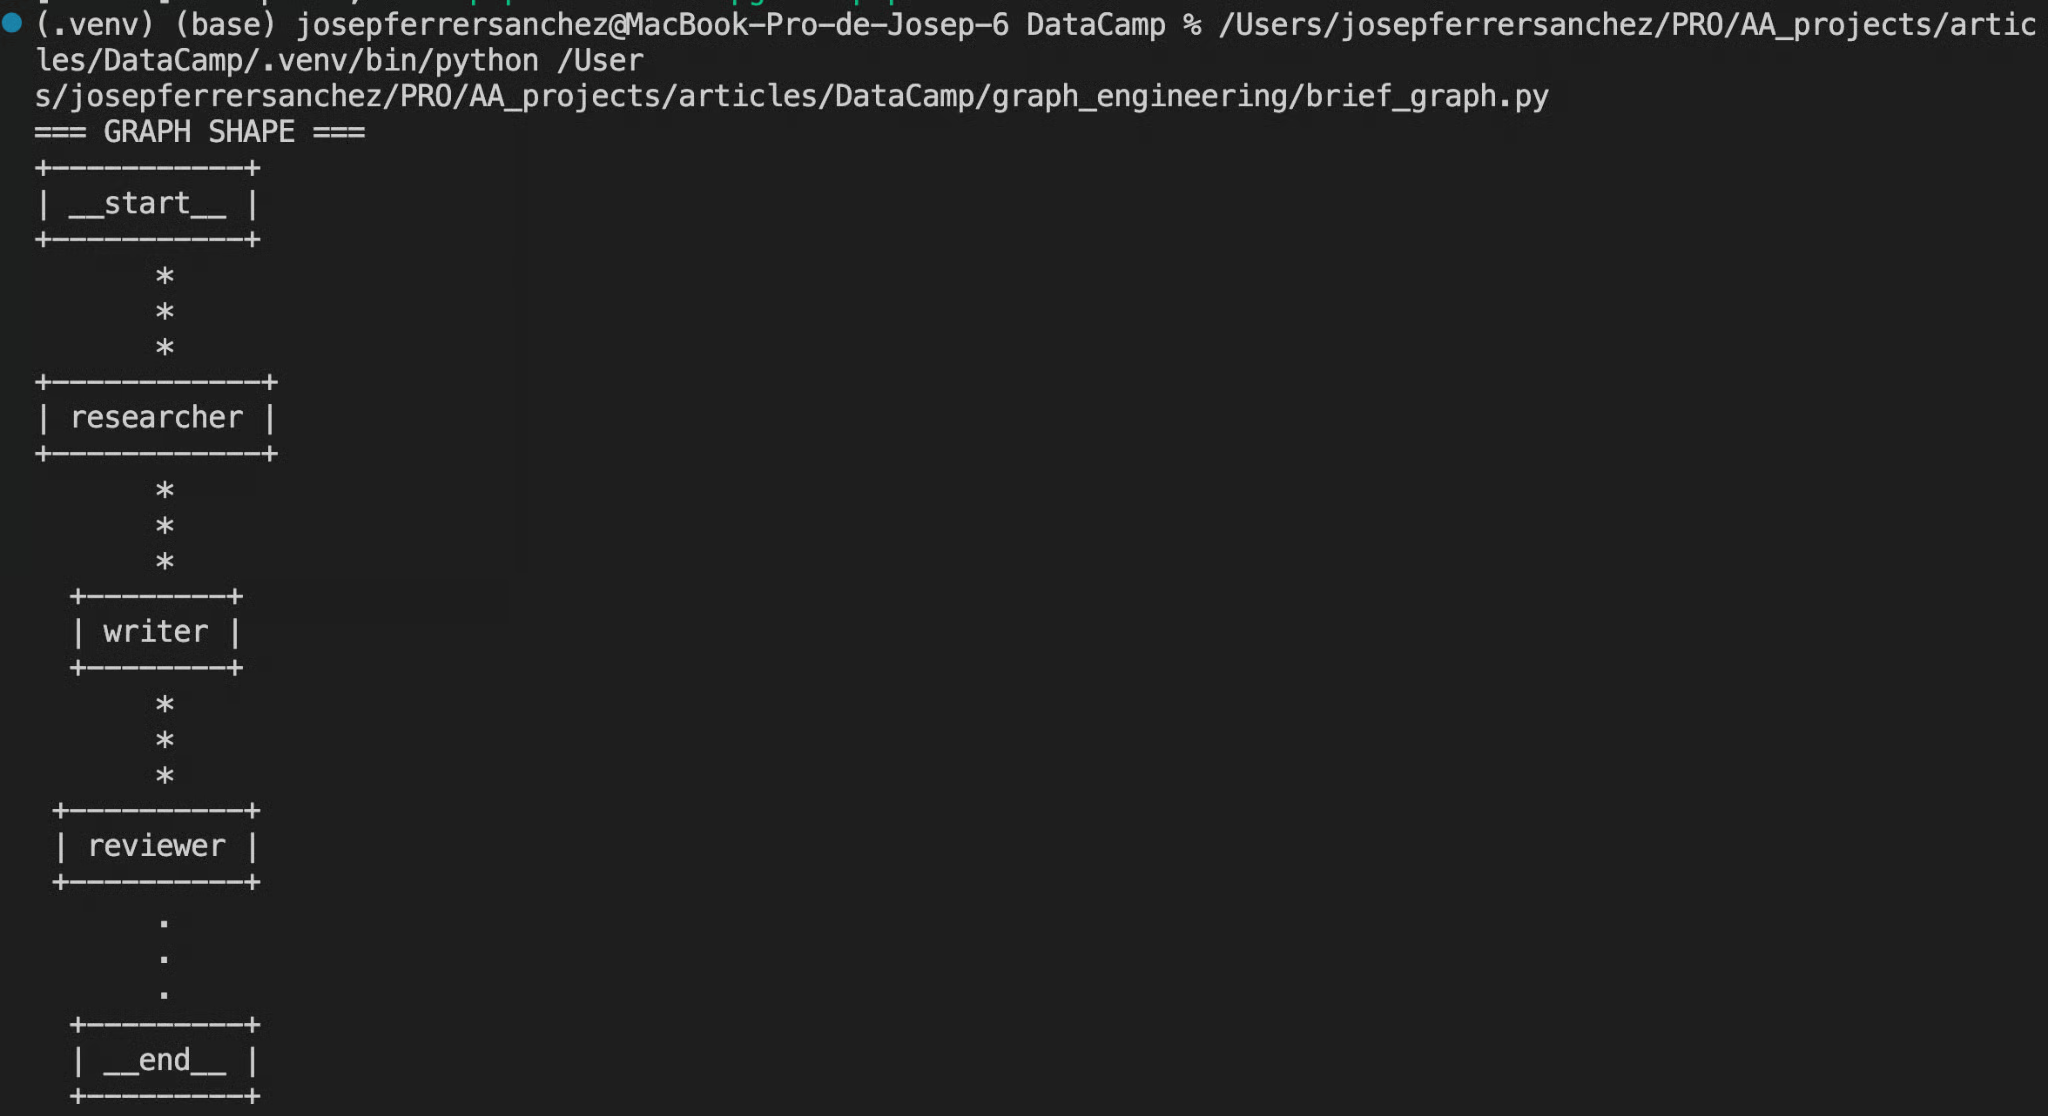
लेखक द्वारा स्क्रीनशॉट। टर्मिनल में .draw_ascii() का आउटपुट दिखता है—__start__, researcher, writer, reviewer, और __end__ वर्टिकली स्टैक्ड और कनेक्टेड।
हर नोड पर स्टेट इंस्पेक्शन के साथ स्टेप-थ्रू डिबगिंग के लिए, LangGraph Studio लोकल सर्वर से जुड़ता है। इसके लिए अलग पैकेज और एक कॉन्फ़िग फाइल चाहिए—तो pip install "langgraph-cli[inmem]" चलाएँ, एक langgraph.json जोड़ें जो आपके कम्पाइल्ड graph ऑब्जेक्ट की ओर पॉइंट करता हो, फिर langgraph dev चलाएँ और प्रिंट हुआ Studio URL खोलें।
हमारा LangGraph Studio गाइड इंटरफ़ेस समझाता है (यह 2024 का है—तो इसकी सेटअप स्टेप्स को ऊपर दिए कमांड्स से मिलाएँ), और हमारा LangGraph एजेंट्स ट्यूटोरियल हमारे रिसर्चर जैसे नोड में असली टूल्स जोड़ना कवर करता है।
एक स्कोपिंग नोट।
यह पाइपलाइन क्रमिक है, तो यह फैन-आउट—वह पैटर्न जिसमें रिसर्चर कई सोर्सेस को एक साथ क्वेरी करता—और एक जॉइन नोड—जो नतीजों को मर्ज करता—डेमो नहीं करती।
वह स्वाभाविक अगला विस्तार है—और यहीं लागत सबसे तेज़ी से बढ़ती है।
एजेंटिक AI ग्राफ इंजीनियरिंग में फेल्यर मोड इतने बार दोहराते हैं कि उन्हें नाम दिया जा सके। ये तीन मैं कुछ भी शिप करने से पहले जाँचता हूँ।
हर नोड अपने आप में एक लूप है—एक प्रॉम्प्ट, टूल्स, और डिफिनिशन ऑफ़ डन के साथ।
तीन हिलते-डुलते नोड्स को वायर करना आपको एक हिलता-डुलता सिस्टम देता है—तीन गुना सरफेस एरिया और उससे भी खराब डिबगिंग कहानी के साथ।
पहले एक नोड को अकेले ठीक चलाएँ।
जो रिसर्चर डायरेक्ट कॉल पर धुंधले नोट्स लौटाता है—वह ग्राफ के भीतर भी धुंधले नोट्स लौटाएगा—और डाउनस्ट्रीम राइटर उन्हें आत्मविश्वास से आधार बना लेगा।
जब लॉजिक एज पर होना चाहिए, तो उसे नोड में रखने के लालच का विरोध करें।
स्टॉपिंग कंडीशंस, ब्रांच निर्णय, और रिट्राई कैप—ये सभी रूटिंग हैं—और रूटिंग एज फ़ंक्शन में होनी चाहिए, जहाँ आप सब कुछ एक साथ पढ़ सकते हैं।
पहले वाला बिना-संयोजन टेस्ट लागू करें।
जो नोड सोर्सेस खोजता है और तय करता है कि क्या वे पर्याप्त हैं—वह दो नोड्स हैं जो एक फ़ंक्शन सिग्नेचर साझा कर रहे हैं।
फैन-आउट और रिट्राई लूप्स टोकन उपयोग को ऐसे गुना करते हैं जिसे डायग्राम पूरी तरह छुपा देता है।
एक 5-वे फैन-आउट जो 3-रिट्राई कैप वाले जॉइन नोड में फीड करता है—यह 5 कॉल्स नहीं है, और रिट्राई कहाँ बैठा है उस पर निर्भर करते हुए—यह 15 या उससे ज़्यादा हो सकता है—जॉइन से पहले भी।
कैप स्पष्ट रूप से सेट करें—जैसा हमने MAX_REVISIONS के साथ किया। फिर प्रति-नोड टोकन काउंट्स लॉग करें और एक हफ्ते बाद पढ़ें—क्योंकि जो नोड आपको सस्ता लगता था, वही अक्सर सबसे ज़्यादा चल रहा होता है।
AutoGen अब भी ग्राफ ऑर्केस्ट्रेशन के लिए रिकमेंड हो जाता है—और उसका एक्सपेरिमेंटल GraphFlow असली प्रायर आर्ट था—लेकिन रिपोज़िटरी सितंबर 2026 से मेंटेनेंस मोड में है, बिना नई फीचर्स के।
Microsoft नए यूज़र्स को Microsoft Agent Framework की ओर निर्देशित करता है—जिसमें अपने ग्राफ-आधारित वर्कफ़्लोज़ हैं—एक प्रकाशित माइग्रेशन गाइड के साथ।
आज के हिसाब से, LangGraph, Google का ADK, या Microsoft Agent Framework सुरक्षित विकल्प हैं—और हमारा Building AI Agents with Google ADK कोर्स ADK को गहराई से कवर करता है।
ग्राफ इंजीनियरिंग लूप इंजीनियरिंग के ऊपर की कोऑर्डिनेशन लेयर है।
नोड्स काम करते हैं, एज तय करते हैं कि आगे क्या चलेगा, और एक साझा ऑब्जेक्ट उनके बीच जानकारी लेकर चलता है।
जुलाई 2026 की टाइमलाइन के शोर को हटा दें—और यही पूरा मॉडल है।
हमारी पाइपलाइन जानबूझकर छोटी रखी: 3 नोड्स, 4 एज घोषणाएँ (जिनमें से 1 कंडीशनल है—तो 2 ब्रांच ड्रॉ होती हैं), और एक रिवीज़न कैप ताकि रिट्राई हमारे हाथ से न निकल जाए।
इतनी संरचना काफी थी—ड्राफ्ट को किसी ऐसे द्वारा रिव्यू कराने के लिए जिसने उसे लिखा नहीं था—और यही एक गुण है जो लूप पेश नहीं कर सकता था।
ग्राफ तब चुनें जब काम ऐसे चरणों में बँटता है जिन्हें अलग विशेषज्ञ चाहिए—और एक भी नोड पहले नहीं। संदेहवादी ठीक थे कि मैकेनिक्स दशकों पुराने हैं और इस टर्म के इर्द-गिर्द लिखावट का अधिकांश हिस्सा शोर है।
वे उस हिस्से के बारे में भी सही थे जो मंगलवार दोपहर मायने रखता है।
लूप-आकार की समस्या से जुड़ा एक कमजोर वेरिफायर बेहतर नहीं हो जाता क्योंकि आपने उसके इर्द-गिर्द और बॉक्स खींच दिए।
इन पैटर्न्स को आगे ले जाने के लिए हमारा Multi-Agent Systems with LangGraph कोर्स सुपरवाइज़र और नेटवर्क डिज़ाइन्स कवर करता है—जहाँ यह ट्यूटोरियल नहीं जाता।
शब्द के डेटा पक्ष के लिए, Graph RAG with LangChain and Neo4j अच्छा अगला कदम है। ऑर्केस्ट्रेशन पक्ष पर रहने के लिए, Text-to-Query Agents with MongoDB and LangGraph एक लाइव डेटाबेस के खिलाफ LangGraph पाइपलाइन बनाता है, और LLM Agents Explained इनके नीचे की आर्किटेक्चर भरता है।
पूरा स्क्रिप्ट मेरे GitHub रेपो में है—ग्राफ रेंडरिंग हेल्पर और हर रन की लागत पर एक छोटा नोट सहित।
Top DataCamp Courses
course
course
course