
Curso
Sistemas Multiagentes com LangGraph
2 h 45 min
8.6K
Dê uma tarefa para um agente e ele se sai bem. Dê três e repare no que acontece na segunda passagem: ele esquece o que encontrou no primeiro passo, avalia o próprio rascunho com generosidade e declara sucesso enquanto a saída ainda está inacabada.
A discussão sobre esse padrão pegou fogo em meados de julho de 2026, quando o termo "graph engineering" estourou no X (ex-Twitter) e a timeline se dividiu entre quem decretou a morte do agent loop e quem chamou o termo de recheio para fazenda de conteúdo.
Minha visão: a etiqueta graph engineering é opcional; a mudança por trás dela, não. Vou tentar justificar isso antes de escrevermos qualquer linha de código.
A maior parte do que você vai construir neste mês ainda deve ser um único loop, e a forma mais rápida de perder uma semana é desenhar um diagrama com 6 caixas para um trabalho que pedia 1.
Um grafo de agentes tem 3 partes:
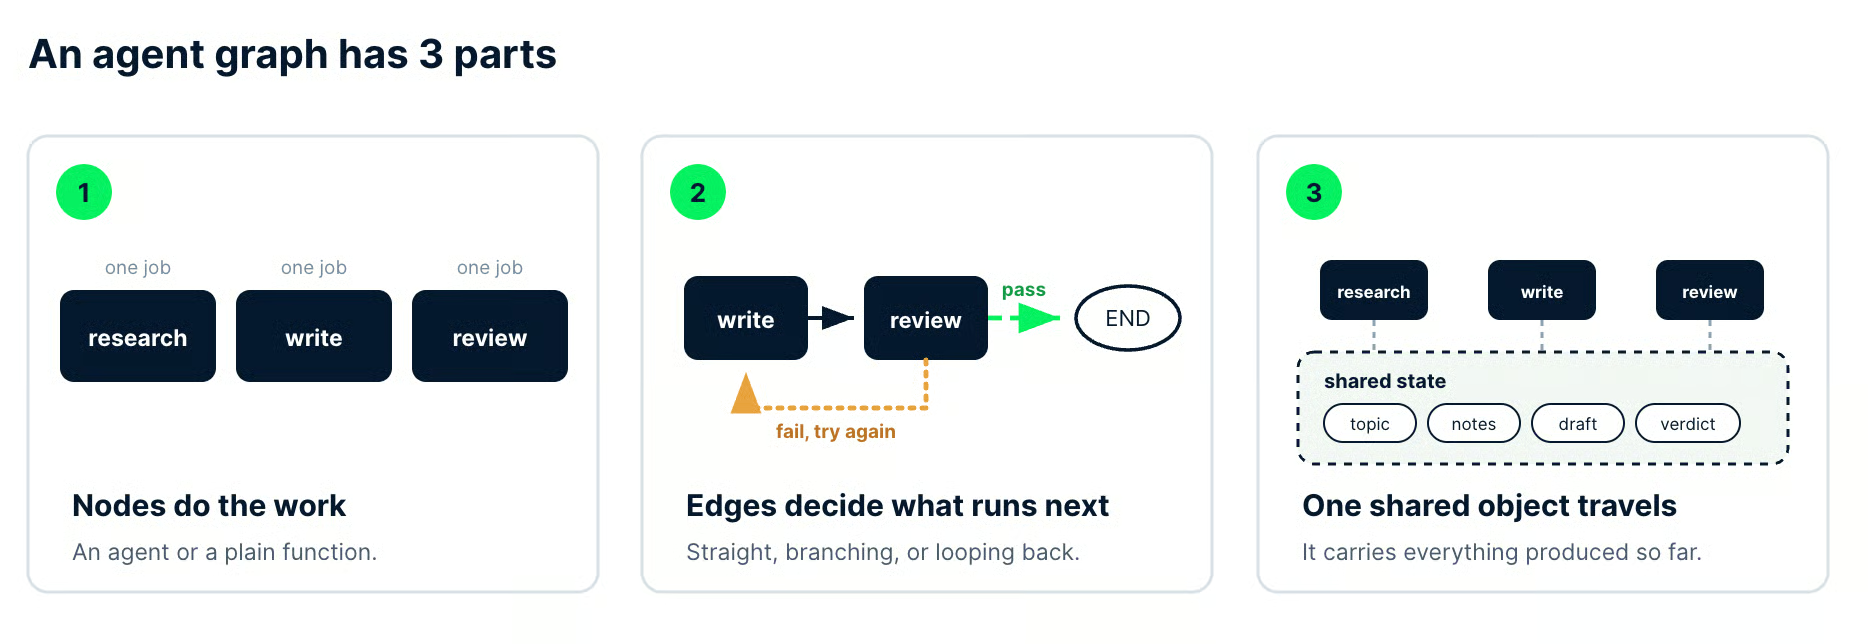
Imagem do autor. As 3 partes mostradas no pipeline que construiremos adiante: 3 nós nomeados, uma aresta de aprovação e uma aresta de nova tentativa, e um objeto de estado reunindo topic, notes, draft e verdict.
Declarar as 3 partes logo de início, em vez de deixar um único agente improvisar seu próprio caminho, é o que o termo graph engineering descreve.
Este tutorial constrói um pipeline funcional de pesquisador, redator e revisor em Python com LangGraph, incluindo uma aresta condicional que devolve rascunhos reprovados para revisão.
Você vai precisar de Python, pip e alguma familiaridade com modelos de linguagem (LLMs) ou agentes de IA. Se agentes são novidade, nosso curso Introduction to AI Agents cobre os conceitos assumidos aqui, e nosso tutorial de agentes LangGraph cobre a parte prática.
Graph engineering é a prática de tornar explícito, em código, o fluxo de controle de um sistema de agentes, em vez de deixá-lo a critério do modelo.
Você declara quais trabalhadores especializados existem, quais transições entre eles são permitidas e quais informações viajam nessas transições.
O agente continua raciocinando livremente, mas raciocina dentro de um nó, não ao longo do trabalho inteiro.
Essa última frase é toda a distinção.
No loop, você define uma meta e um nível de qualidade, e o agente escolhe o próprio caminho para alcançá-los. No grafo, você fixa o caminho e os checkpoints, então a autonomia do modelo fica limitada por uma estrutura que você lê num diff.
O rótulo apareceu alto no X em julho de 2026, mas não começou ali. Itamar Friedman, da CodiumAI (hoje Qodo), descreveu a mudança "de prompt engineering para flow (/graph) engineering" lá em fevereiro de 2024, e o paper AlphaCodium da equipe colocou números nisso.
A acurácia pass@5 do GPT-4 no conjunto de validação do CodeContests foi de 19% com um único prompt bem projetado para 44% com um fluxo em múltiplas etapas. São 5 tentativas por problema em ambos os cenários, não tiro único.
O que aconteceu em julho de 2026 foi amplificação.
Em 18 de julho, Peter Steinberger perguntou no X: "Ainda estamos falando de loops ou já mudamos para grafos?", uma semana depois de Mike Masson publicar a escada com prompt, context, harness, loop, graph. A pergunta teve 3,1 milhões de visualizações, e a expressão que ela espalhou já estava em uso.
A reação veio rápido. Harrison Chase, cofundador da LangChain e parte do time por trás do LangGraph, perguntou se aquilo tudo não era "basicamente só o langgraph?"
Dale Everett empurrou do outro lado, argumentando que um loop sempre foi um grafo de um nó, então a empolgação de julho estava redescobrindo terreno antigo. A retrospectiva da própria LangChain, 3 Years of Graph Engineering with LangGraph, segue linha parecida, enquadrando grafos de agentes como um padrão que eles vêm construindo há 3 anos.
Então eu arquivo o termo como um atalho útil.
Ele nos deu um nome compartilhado para questões de design que ficavam enterradas em documentação de frameworks, e um nome se paga quando você está debatendo arquitetura num pull request.
Graph engineering descreve a estrutura de execução, o que o separa de duas coisas que emprestam seu vocabulário.
Knowledge graphs e GraphRAG descrevem dados.
Eles transformam documentos em entidades e relacionamentos para que um sistema de busca percorra conexões entre fatos; as ferramentas, o armazenamento e as métricas de avaliação são todos diferentes.
Para esse lado da palavra, nosso tutorial sobre usar um knowledge graph para implementar um aplicativo de RAG é o ponto de partida certo, com nossa introdução à teoria dos grafos cobrindo a matemática por trás de ambos.
A segunda coisa que ele não é: uma capacidade nova.
LangGraph, o Agent Development Kit (ADK) do Google e o Microsoft AutoGen já entregavam orquestração multiagente antes de o rótulo viralizar, então, se você já escreveu um StateGraph, já fazia isso.
Muita gente vai perceber que vem praticando graph engineering há um ano sob o nome "meu pipeline LangGraph".
Cada camada da engenharia de IA assume o controle de algo um passo além do modelo.
O jeito útil de ler a tabela é a coluna da direita, que mostra o que de fato dá errado quando você pula um degrau e tenta construir em cima assim mesmo.
| Camada | O que você controla | O que quebra se pular |
|---|---|---|
| Prompt | A formulação do pedido | O modelo responde a uma pergunta que você não fez |
| Contexto | Quais inputs chegam ao modelo | Ele raciocina bem em cima do material errado |
| Harness | Ferramentas, memória, acesso a arquivos e APIs | Ele não toca em nada fora da janela do chat |
| Loop | O ciclo repetir-até-acabar | Ele para cedo demais ou nunca para |
| Grafo | Qual trabalhador roda em seguida e sobre o quê | Um agente tenta ser 4 e esquece 3 deles |
Pular um degrau é a forma mais comum de um projeto com grafo falhar — e a falha raramente é óbvia.
Três nós pouco confiáveis conectados não viram um sistema confiável por média.
Eles viram um sistema que falha em mais lugares, custa mais por falha e leva mais tempo para diagnosticar porque a saída ruim agora está a 2 repasses do nó que a causou.
Qualquer grafo de agentes, tenha ele 3 nós ou 30, se decompõe em nós, arestas e estado compartilhado.
Quando você consegue nomear essas 3 partes num codebase, a maioria dos frameworks de orquestração fica legível sem a documentação.
Um nó é uma unidade de trabalho com nome e responsabilidade única.
Pode ser uma chamada de LLM com prompt especializado e ferramentas próprias, ou pode ser uma função Python comum que consulta um banco, valida um schema ou escreve um arquivo.
Reserve as chamadas ao modelo para etapas que exigem julgamento semântico.
Se uma regra tem resposta conhecida, coloque em Python — roda em microssegundos, não custa nada e retorna o mesmo resultado duas vezes.
Meu teste para decidir se algo deve ser quebrado em nós: tente descrever o nó em uma frase, sem conjunção.
Um nó que "busca as fontes e decide se temos o suficiente" já falhou no teste, porque você não consegue trocar a metade de busca sem mexer na metade de julgamento.
Uma aresta determina o que roda depois que o nó atual termina.
Quatro formatos cobrem quase tudo que você vai construir:
As arestas também são onde a lógica de parada deve morar. Limites de nova tentativa, gates de qualidade e regras de escalonamento são decisões de roteamento, e mantê-las nas funções de aresta permite auditar o fluxo de controle num único lugar, sem caçar lógica dentro dos nós.
Estado compartilhado é o objeto único que todo nó lê e escreve conforme a execução avança.
Sem ele, você tem vários agentes trabalhando lado a lado e não passando nada entre si, então o redator não vê o que o pesquisador achou, e o revisor não vê nenhum dos dois.
No LangGraph, o estado costuma ser um TypedDict.
O nosso acumula o tópico, as notas do pesquisador, o rascunho atual, o veredito e o feedback do revisor e um contador de revisões. Cada nó retorna apenas os campos que mudou, e o framework mescla esses retornos no objeto em execução.
Propriedade de escrita é onde os grafos se deterioram primeiro.
Decida antes de codar qual nó pode escrever cada campo, porque um estado que 3 nós diferentes podem sobrescrever é uma sessão de debugging que você já agendou para si mesmo.
Loop engineering projeta o ciclo que um agente único repete até terminar; graph engineering projeta a coordenação entre vários desses ciclos.
Esta é a decisão mais importante do artigo, então vem antes do tutorial.
A resposta padrão é: o loop.
Um agente único, bem delimitado e com um verificador rígido, é mais rápido de construir, mais barato de rodar e muito mais simples de depurar do que qualquer grafo fazendo o mesmo trabalho.
Não é só preferência minha.
Uma equipe da UC Berkeley (primeiro autor Mert Cemri) parte da observação de que os ganhos multiagente sobre setups de agente único costumam ser mínimos e anota 1.600+ execuções de 7 frameworks multiagente para investigar o porquê (arXiv:2503.13657, v3).
A taxonomia deles, construída a partir da leitura atenta de 150 dessas execuções, nomeia 14 modos de falha distintos.
Esses 14 modos se agrupam em 3 categorias: problemas de design do sistema, desalinhamento entre agentes e verificação da tarefa.
Guarde a terceira até chegarmos ao nó revisor.
Trate estes pontos como gatilhos, não como checklist.
Um “sim” claro na coluna da direita basta; cinco “talvez” não bastam.
| Pergunta sobre sua tarefa | Um loop dá conta | Você quer um grafo |
|---|---|---|
| Dá para escrever o trabalho como uma instrução única? | Sim, e uma pessoa conseguiria seguir até o fim | Parece um repasse entre 2 papéis diferentes |
| Todo passo quer o mesmo modelo? | Um modelo e um conjunto de ferramentas do início ao fim | Coleta quer barato e rápido; julgamento quer precisão |
| Algum passo não depende do outro? | Cada passo precisa da saída do anterior | Várias consultas que poderiam rodar em paralelo |
| Quem decide que a saída está boa o bastante? | O próprio agente relê o que escreveu | Algo que não escreveu precisa aprovar |
| O que deve acontecer quando um passo falha? | Tentar de novo e seguir | Conter a falha para salvar o restante da execução |
| Alguém precisa auditar o caminho tomado? | O trace é para você e seu time | Alguém de fora precisa ver o que rodou e por quê |
A versão superengenheirada que mais encontro nem é sobre agentes. Alguém precisa limpar e geocodificar uma lista de 800 endereços de hotéis, e ela chega como um grafo de 5 nós: loader, normalizer, geocoder, validator e writer, com estado compartilhado passando entre eles.
Todos esses passos são determinísticos, então o que foi construído ali é um script de Python de 40 linhas vestindo um framework — que agora cobra por linha e falha de formas que o pandas nunca falharia.
A versão no tamanho certo é a que vamos construir agora.
Produzir um brief curto e pesquisado se divide em trabalhos com os quais um único loop sofre: coletar material bruto, transformá-lo em texto e depois julgar esse texto de fora.
O terceiro passo é o motivo de o grafo existir, porque agente revisando o próprio rascunho não está revisando.
Três coisas justificam um nó.
Se você não consegue apontar uma delas para cada nó que adicionou, apague o nó e incorpore o trabalho dele ao vizinho.
Primeiro, especialização de verdade.
Nosso pesquisador quer um modelo barato e rápido e, em produção, ferramentas de busca. O redator não quer nenhuma dessas e se beneficia de um modelo mais forte — a divisão faz trabalho de verdade, não só enfeita o diagrama.
Segundo, paralelismo que você vai notar.
Fan-out compensa quando as ramificações são independentes e a economia de tempo no relógio importa para alguém; e adiciona complexidade quando nada disso é verdade.
Terceiro — e este é o ponto que eu mais defendo — verificação independente.
Agente que corrige o próprio dever de casa é generoso, então um nó revisor separado, com acesso somente leitura ao rascunho, costuma ser o nó mais valioso de qualquer grafo.
Para uma visão de framework sobre como bibliotecas diferentes expressam esses padrões, nossa comparação CrewAI vs LangGraph vs AutoGen expõe os trade-offs.
Vamos construir um pipeline multiagente no LangGraph com pesquisador, redator e revisor que produz um brief curto e pesquisado e devolve rascunhos reprovados para revisão.
LangGraph é um framework de orquestração de baixo nível para agentes com estado, e seu StateGraph mapeia quase um-para-um para os nós, arestas e estado da seção anterior.
Tudo abaixo foi verificado com langgraph 1.2.11 e langchain-anthropic 1.7.1 em setembro de 2026.
Se a biblioteca é nova para você, nosso tutorial de LangGraph cobre os fundamentos. Esta seção é rápida, e nosso guia LangChain vs LangGraph vs LangSmith vs LangFlow esclarece o papel de cada peça da família.
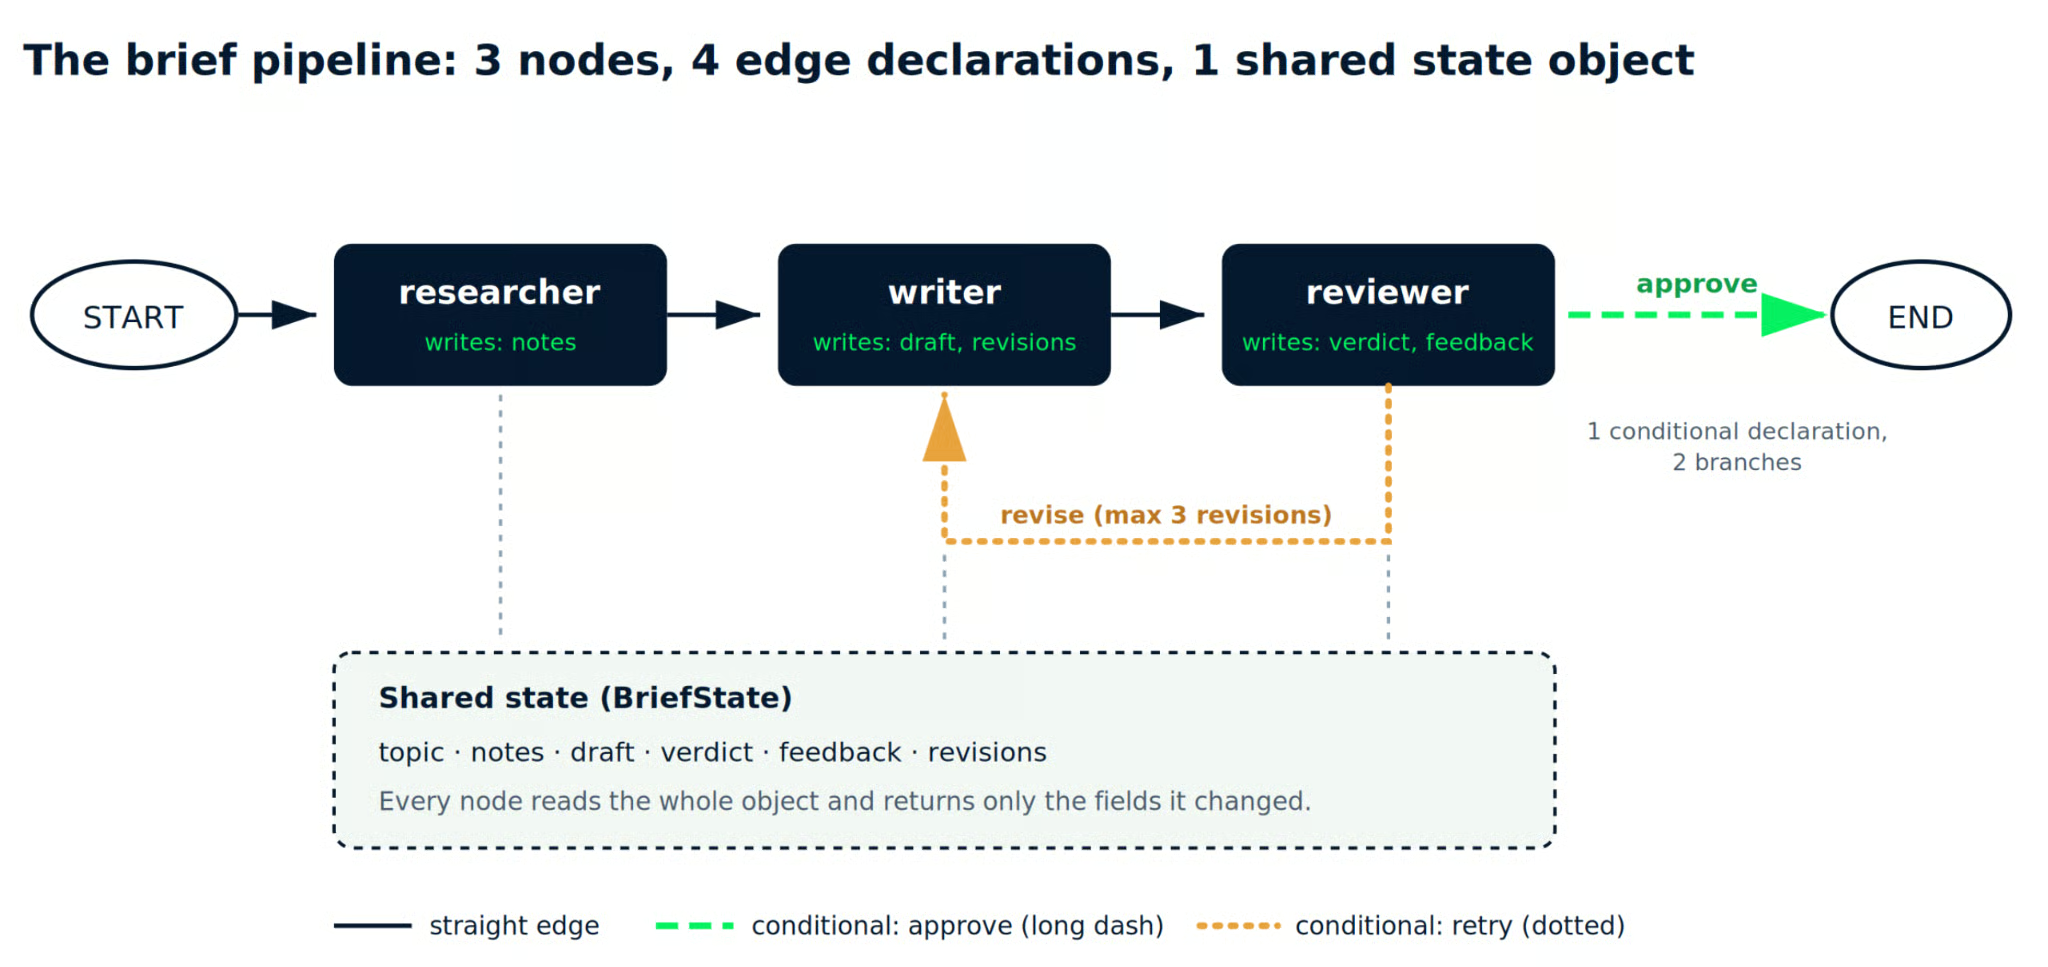
Imagem do autor. O pipeline que vamos construir. Linhas sólidas são as 3 arestas retas; as tracejadas e pontilhadas são os 2 ramos de uma única aresta condicional.
Instale os pacotes, além de python-dotenv para manter sua chave fora do código-fonte:
pip install langgraph langchain-anthropic python-dotenvCrie um arquivo .env ao lado do seu script:
ANTHROPIC_API_KEY=sk-ant-your-key-hereAgora os imports e o schema do estado. Vale a pena escrever o TypedDict primeiro: é o contrato que todo nó concorda em seguir:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# Um modelo barato para coleta, um mais forte para escrever e revisar.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Dois modelos, não um. Este é o gatilho "modelo diferente por etapa" da tabela de decisão aparecendo no código real: pesquisa é trabalho de alto volume e baixo julgamento que não precisa do modelo caro.
MAX_REVISIONS faz um trabalho silencioso, porém importante.
Sem limite, um revisor rígido e um redator teimoso podem ficar devolvendo o rascunho até a sua fatura ficar interessante.
Todo nó segue o mesmo contrato. Recebe o estado atual, faz seu único trabalho e retorna um dicionário com apenas os campos que mudou.
O pesquisador reúne material bruto e escreve em notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
Em produção, este nó chamaria uma ferramenta de busca em vez de depender do conhecimento do modelo.
Eu mantive como uma única chamada .invoke() para a estrutura do grafo seguir visível; então trate as notas produzidas como não verificadas.
O redator lê essas notas e produz um rascunho. Ele também verifica se há feedback do revisor, o que dá à aresta de retry algo sobre o que agir:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
O revisor pontua o rascunho.
Ele não viu o raciocínio do redator e não produziu nenhum trecho do texto, então pode ser direto sobre o resultado.
Esta é a terceira categoria de falhas da taxonomia de Berkeley, ganha um nó próprio.
A verificação da tarefa falha quando nada independente checa a saída — a correção é um trabalhador que não possa corrigir o próprio dever de casa:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Note o uso de .text e não .content nos três nós.
Ambos retornam string para respostas simples, mas .text também se comporta direito quando a resposta vem em múltiplos blocos de conteúdo, evitando um confuso AttributeError: 'list' object has no attribute 'strip' depois.
Analisar o veredito pela primeira linha mantém o código legível — e é frágil.
Para algo rodando sem supervisão, troque a checagem de string pela saída estruturada do LangChain, para o veredito voltar como um campo tipado em vez de um prefixo que você torce para o modelo respeitar.
A função de roteamento é a aresta condicional. Ela lê o estado depois que o revisor roda e retorna o nome do que deve acontecer a seguir:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions conta todo rascunho, inclusive o primeiro, então ">" permite
    # 1 rascunho original mais MAX_REVISIONS reescritas.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Mantenha essa função silenciosa. Um print() ali cai no stdout enquanto o loop de stream ainda imprime o chunk anterior, então o aviso do limite aparece um passo antes e o trace fica fora de ordem.
O limite de revisões vive aqui e não dentro de um nó porque parar é decisão de controle de fluxo, e controle de fluxo pertence às arestas.
Agora monte o grafo. Nós, depois arestas, depois compile:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
O terceiro argumento de .add_conditional_edges() é o mapa de caminhos.
Ele lista todo destino que a função de roteamento pode retornar, e o LangGraph usa isso para desenhar o desvio antes de qualquer nó rodar.
Chame o grafo compilado com um estado inicial. Só topic e revisions precisam de valores, porque os demais campos são preenchidos conforme a execução flui:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Isso te dá apenas o estado final. Não ajuda muito quando uma execução sai do trilho.
Troque .invoke() por .stream() com stream_mode="updates" para ver cada nó reportar o que escreveu. Cada chamada é uma execução separada, com novas chamadas ao modelo, então use uma ou outra, não as duas:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Numa execução em que o revisor reprova o primeiro rascunho, isso imprime o seguinte:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Duas coisas ficam visíveis que o estado final esconde.
O pesquisador rodou uma vez e suas notas persistiram pelos dois passes de escrita — retry não refaz pesquisa. Cada nó também tocou apenas seus próprios campos, transformando a regra de propriedade de escrita em algo verificável.
Conte as chamadas enquanto está aqui.
Esse caminho reprovado custa 5 chamadas de modelo contra algo perto de 1 num loop único para a mesma tarefa, e a única forma de saber se as 4 extras compraram algo é logar os vereditos e lê-los.
Você não precisa de ferramentas extras para ver a forma do que construiu:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
A saída Mermaid renderiza o desvio condicional como linhas tracejadas saindo de reviewer para __end__ e de volta para writer.
Isso confirma que sua aresta de retry existe antes de você gastar com chamadas de modelo. A visualização em ASCII só desenha o caminho reto de início ao fim; use o Mermaid quando quiser ver o loop.
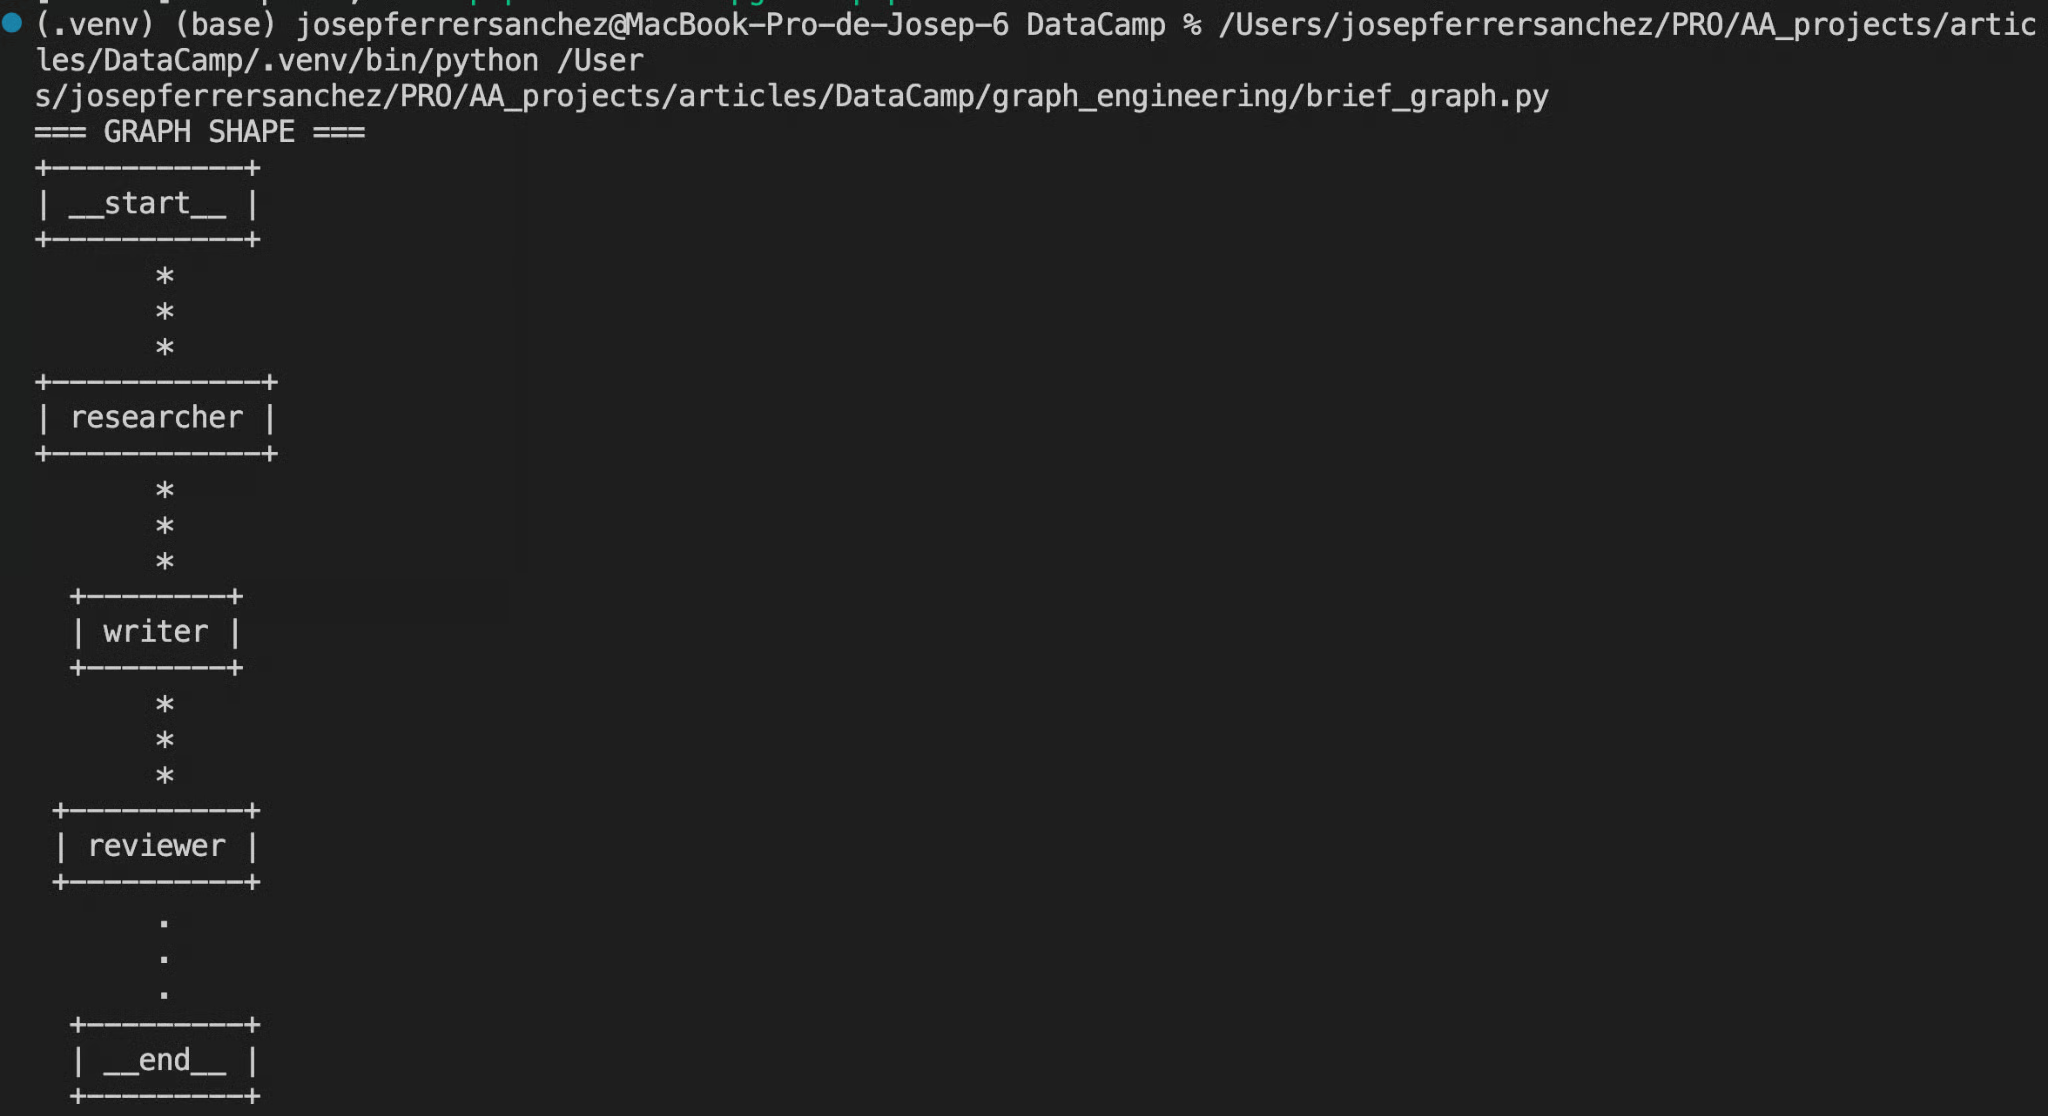
Captura de tela do autor. Terminal exibindo a saída de .draw_ascii(), com __start__, researcher, writer, reviewer e __end__ empilhados e conectados verticalmente.
Para depuração passo a passo com inspeção de estado em cada nó, o LangGraph Studio conecta a um servidor local. Ele precisa de um pacote e um arquivo de config: pip install "langgraph-cli[inmem]", adicione um langgraph.json apontando para o objeto graph compilado, depois rode langgraph dev e abra a URL do Studio que ele imprimir.
Nosso guia do LangGraph Studio percorre a interface (é de 2024, então confira os passos de setup com os comandos acima), e nosso tutorial de agentes LangGraph cobre adicionar ferramentas reais a um nó como o pesquisador.
Uma observação de escopo.
Este pipeline é sequencial, então não demonstra fan-out — o padrão em que o pesquisador consultaria várias fontes ao mesmo tempo e um nó de junção mesclaria os resultados.
Esse é o próximo passo natural — e também onde os custos multiplicam mais rápido.
Os modos de falha em grafos com agentes de IA se repetem o suficiente para serem nomeados. Estes são os três que eu confiro antes de enviar qualquer coisa.
Cada nó é um loop por si só, com prompt, ferramentas e definição de pronto.
Ligar 3 nós trêmulos dá um sistema trêmulo com tripla área de superfície e uma história de debugging bem pior.
Faça um nó funcionar sozinho primeiro.
Um pesquisador que retorna notas vagas quando chamado diretamente também retorna notas vagas dentro de um grafo — e o redator a jusante vai construir em cima delas com confiança.
Resista a colocar lógica num nó quando ela pertence a uma aresta.
Condições de parada, decisões de ramificação e limites de retry são roteamento — e roteamento pertence à função de aresta, onde você lê tudo de uma vez.
Aplique o teste da não-conjunção de antes.
Um nó que busca fontes e decide se são suficientes na verdade são 2 nós compartilhando uma assinatura.
Fan-out e loops de retry multiplicam tokens de formas que o diagrama esconde completamente.
Um fan-out de 5 ramificações alimentando um nó de junção com limite de 3 novas tentativas não são 5 chamadas — dependendo de onde está o retry, podem ser 15 ou mais antes de contar a junção.
Defina o limite explicitamente, como fizemos com MAX_REVISIONS. Depois logue contagens de tokens por nó e leia após uma semana — o nó que você assumiu ser barato costuma ser o que mais roda.
AutoGen ainda é recomendado para orquestração em grafo, e seu trabalho experimental GraphFlow foi antecedente real, mas o repositório está em modo de manutenção desde setembro de 2026, sem novos recursos.
A Microsoft direciona novos usuários para o Microsoft Agent Framework, que tem seus próprios fluxos baseados em grafo, com um guia de migração publicado.
Hoje, LangGraph, o ADK do Google ou o Microsoft Agent Framework são escolhas mais seguras, e nosso curso Building AI Agents with Google ADK cobre o ADK em profundidade.
Graph engineering é a camada de coordenação acima do loop engineering.
Os nós fazem o trabalho, as arestas decidem o que roda em seguida e um objeto compartilhado carrega as informações entre eles.
Tire o barulho da timeline de julho de 2026 e esse é o modelo inteiro.
Nosso pipeline ficou pequeno de propósito: 3 nós, 4 declarações de aresta (1 condicional, então desenha 2 ramos) e um limite de revisão para o retry não fugir do controle.
Isso já foi estrutura suficiente para ter um rascunho revisado por algo que não o escreveu — e essa propriedade única é o que um loop não oferece.
Recorra a um grafo quando o trabalho se divide em fases que pedem especialistas diferentes — e não um nó antes disso. Os céticos estavam certos de que a mecânica tem décadas e de que a maior parte do conteúdo sobre o termo é ruído.
Também estavam certos sobre o que importa na tarde de terça.
Um verificador fraco preso a um problema em forma de loop não melhora porque você desenhou mais caixas ao redor dele.
Para levar esses padrões adiante, nosso curso Multi-Agent Systems with LangGraph cobre os designs de supervisor e de rede que este tutorial não alcança.
Para o lado de dados da palavra, Graph RAG with LangChain and Neo4j é um bom próximo passo. Para seguir no lado da orquestração, Text-to-Query Agents with MongoDB and LangGraph constrói um pipeline LangGraph contra um banco vivo, e LLM Agents Explained preenche a arquitetura por trás de tudo.
O script completo está no meu repositório no GitHub, com o helper de renderização do grafo e uma nota curta sobre o custo de cada execução.
Top DataCamp Courses
Curso
Curso
Curso