
Kurs
Multi-Agent Systems mit LangGraph
2 Std. 45 Min.
8.6K
Gib einem Agenten eine Aufgabe, und er macht sie ordentlich. Gib ihm drei, und beobachte, was beim zweiten Handoff passiert: Er vergisst, was er in Schritt eins gefunden hat, bewertet den eigenen Entwurf zu wohlwollend und meldet Erfolg, während der Output halbfertig liegen bleibt.
Die Debatte um dieses Muster kochte Mitte Juli 2026 hoch, als „Graph Engineering“ auf X (ehemals Twitter) trendete und die Timeline sofort in zwei Lager zerfiel: hier das Ende der Agenten-Loop, dort die Abwertung des Begriffs als Content-Füllstoff.
Mein Fazit: Das Label Graph Engineering ist optional, die zugrunde liegende Eskalation nicht. Das versuche ich zu begründen, bevor wir eine Zeile Code schreiben.
Das meiste, was du diesen Monat baust, sollte weiterhin eine einzelne Loop sein. Der schnellste Weg, eine Woche zu verbrennen, ist ein Diagramm mit 6 Kästchen für einen Job, der 1 gebraucht hätte.
Ein Agenten-Graph hat 3 Bausteine:
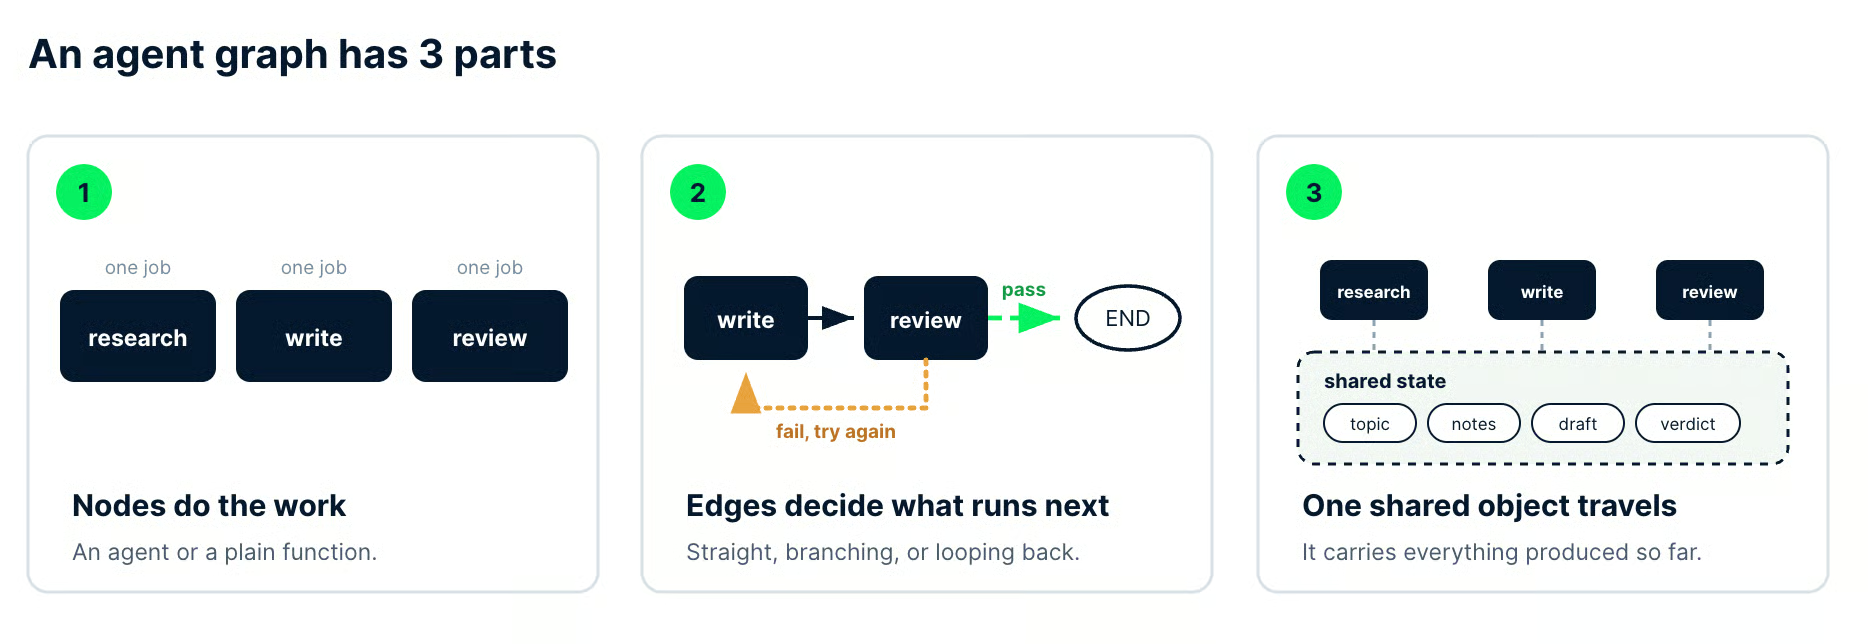
Bild: Autor. Die 3 Teile am Pipeline-Beispiel, das wir später bauen: 3 benannte Nodes, eine Pass-Kante und eine Retry-Kante sowie ein State-Objekt, das Topic, Notes, Draft und Verdict sammelt.
Alle 3 Teile vorab zu deklarieren, statt einen einzelnen Agenten seinen eigenen Pfad improvisieren zu lassen, ist das, was der Begriff Graph Engineering beschreibt.
Dieses Tutorial baut eine funktionierende Researcher-, Writer- und Reviewer-Pipeline in Python mit LangGraph, inklusive einer bedingten Kante, die fehlgeschlagene Entwürfe zur Überarbeitung zurückschickt.
Du brauchst Python, pip und etwas Vertrautheit mit großen Sprachmodellen (LLMs) oder KI-Agenten. Falls Agenten neu für dich sind, deckt unser Kurs Introduction to AI Agents die Konzepte ab, auf die sich dieser Artikel stützt, und unser LangGraph-Agents-Tutorial führt dich durch die Praxis.
Graph Engineering ist die Praxis, den Kontrollfluss eines Agentensystems im Code explizit zu machen, statt ihn dem Urteil des Modells zu überlassen.
Du deklarierst, welche spezialisierten Worker es gibt, welche Übergänge zwischen ihnen erlaubt sind und welche Informationen entlang dieser Übergänge fließen.
Der Agent denkt weiterhin frei, aber er denkt innerhalb eines Nodes statt über den gesamten Job hinweg.
Dieser letzte Satz ist die ganze Unterscheidung.
In einer Loop setzt du Ziel und Qualitätsmaß, und der Agent sucht sich den Weg dorthin selbst. In einem Graphen fixierst du den Weg und die Checkpoints, sodass die Autonomie des Modells durch eine Struktur begrenzt ist, die du in einem Diff lesen kannst.
Der Begriff wurde im Juli 2026 auf X laut, aber er begann nicht dort. Itamar Friedman von CodiumAI (heute Qodo) beschrieb schon im Februar 2024 den Shift „from prompt engineering to flow (/graph) engineering“, und das AlphaCodium-Paper seines Teams lieferte Zahlen dazu.
Die pass@5-Genauigkeit von GPT-4 auf dem CodeContests-Validierungsset stieg von 19% mit einem guten Prompt auf 44% mit einem mehrstufigen Flow. Das sind in beiden Fällen 5 Versuche pro Problem, nicht Single-Shot.
Was im Juli 2026 passierte, war Verstärkung.
Am 18. Juli fragte Peter Steinberger auf X: „Are we still talking loops or did we shift to graphs yet?“, eine Woche nachdem Mike Masson die Leiter Prompt, Context, Harness, Loop, Graph postete. Die Frage bekam 3,1 Millionen Views, und der Begriff, den sie verbreitete, war längst im Umlauf.
Der Widerspruch kam prompt. Harrison Chase, ein LangChain-Mitgründer aus dem Team hinter LangGraph, fragte, ob das Ganze nicht „basically just langgraph?“ sei.
Dale Everett argumentierte von der anderen Seite, eine Loop sei immer ein Ein-Knoten-Graph, sodass die Juli-Euphorie Bekanntes wiederentdecke. LangChains eigenes Resümee, 3 Years of Graph Engineering with LangGraph, zeichnet eine ähnliche Linie und rahmt Agentengraphen als Muster, das seit 3 Jahren gebaut wird.
Ich verbuche den Begriff daher als nützliche Abkürzung.
Er gibt uns einen gemeinsamen Namen für Designfragen, die früher tief in Framework-Dokumentation vergraben waren, und ein Name lohnt sich, wenn du in einem Pull Request über Architektur streitest.
Graph Engineering beschreibt die Ausführungsstruktur und unterscheidet sich damit von zwei Dingen, die sich seiner Vokabel bedienen.
Knowledge Graphs und GraphRAG beschreiben Daten.
Sie verwandeln Dokumente in Entitäten und Beziehungen, damit ein Retrieval-System die Verknüpfungen zwischen Fakten durchlaufen kann. Tooling, Speicherung und Evaluierung unterscheiden sich komplett.
Für diese Seite des Wortes ist unser Tutorial zu Knowledge-Graph-basiertem RAG der richtige Einstieg, zusammen mit unserer Einführung in die Graphentheorie, die die Mathematik darunter erklärt.
Zweitens ist es keine neue Fähigkeit.
LangGraph, Googles Agent Development Kit (ADK) und Microsoft AutoGen hatten Multi-Agenten-Orchestrierung lange vor dem Hype-Label im Programm. Wenn du also schon einmal einen StateGraph geschrieben hast, hast du das bereits gemacht.
Viele Leser werden feststellen, dass sie seit einem Jahr Graph Engineering betreiben – unter dem Namen „meine LangGraph-Pipeline“.
Jede Schicht des KI-Engineerings übernimmt die Kontrolle über etwas, das einen Schritt weiter außen vom Modell liegt.
Die rechte Spalte in dieser Tabelle ist die nützliche Lesart. Sie zeigt, was tatsächlich schiefgeht, wenn du eine Sprosse auslässt und trotzdem darauf aufbauen willst.
| Ebene | Worüber du Kontrolle hast | Was bricht, wenn du sie überspringst |
|---|---|---|
| Prompt | Die Wortwahl der Anfrage | Das Modell beantwortet eine Frage, die du nicht gestellt hast |
| Kontext | Welche Inputs das Modell erreichen | Es argumentiert gut – über das falsche Material |
| Harness | Tools, Speicher, Datei- und API-Zugriff | Es kann nichts außerhalb des Chatfensters berühren |
| Loop | Der Wiederhole-bis-fertig-Zyklus | Es hört zu früh auf – oder nie |
| Graph | Welcher Worker als Nächstes läuft – und worauf | Ein Agent versucht, 4 zu sein, und vergisst 3 davon |
Eine Sprosse auszulassen ist der häufigste Grund, warum Graph-Projekte scheitern – und das Scheitern ist selten offensichtlich.
Drei unzuverlässige Nodes zu verdrahten ergibt kein zuverlässiges System im Mittel.
Es erzeugt ein System, das an mehr Stellen ausfällt, pro Ausfall mehr kostet und länger zu diagnostizieren ist, weil der schlechte Output jetzt 2 Handoffs vom verursachenden Node entfernt liegt.
Jeder Agenten-Graph, ob mit 3 Nodes oder 30, zerfällt in Nodes, Edges und Shared State.
Wenn du diese 3 Teile im Code benennen kannst, werden die meisten Orchestrierungsframeworks ohne Doku lesbar.
Ein Node ist eine Arbeitseinheit mit Namen und klarer Einzelverantwortung.
Er kann ein LLM-Call mit spezialisiertem Prompt und eigenen Tools sein – oder eine normale Python-Funktion, die eine Datenbank abfragt, ein Schema validiert oder eine Datei schreibt.
Reserviere Modellaufrufe für Schritte, die semantisches Urteil brauchen.
Wenn eine Regel eine bekannte Antwort hat, pack sie in Python: läuft in Mikrosekunden, kostet nichts und liefert zweimal dasselbe Ergebnis.
Hier ist mein Test, ob etwas aufgespalten werden sollte: Versuche, den Node in einem Satz ohne Konjunktion zu beschreiben.
Ein Node, der „die Quellen zieht und entscheidet, ob es genug sind“, fällt durch. Du kannst die Retrieval-Hälfte nicht austauschen, ohne die Bewertungs-Hälfte zu stören.
Eine Edge bestimmt, was nach Abschluss des aktuellen Nodes läuft.
Vier Formen decken fast alles ab, was du baust:
Edges sind auch der Ort für deine Stopplogik. Retry-Limits, Qualitätsgates und Eskalationsregeln sind Routing-Entscheidungen. Hältst du sie in den Edge-Funktionen, kannst du den Kontrollfluss an einer Stelle auditieren statt in Node-Bodies zu suchen.
Shared State ist das eine Objekt, aus dem jeder Node liest und in das er während des Laufs schreibt.
Ohne ihn arbeiten mehrere Agenten nebeneinander her und reichen sich nichts weiter. Der Writer sieht nicht, was der Researcher fand – und der Reviewer keines von beidem.
In LangGraph ist der State meist ein TypedDict.
Unserer sammelt Topic, die Notizen des Researchers, den aktuellen Draft, das Verdict und Feedback des Reviewers sowie einen Revisionszähler. Jeder Node gibt nur die Felder zurück, die er geändert hat, und das Framework mergen diese Returns in das laufende Objekt.
Write-Ownership ist die Stelle, an der Graphen zuerst erodieren.
Lege vor dem Coden fest, welcher Node welches Feld schreiben darf. Ein State-Objekt, das 3 verschiedene Nodes überschreiben können, ist eine Debugging-Session, die du dir schon terminiert hast.
Loop Engineering designt den Zyklus, den ein einzelner Agent so lange wiederholt, bis er fertig ist. Graph Engineering designt die Koordination zwischen mehreren dieser Zyklen.
Das ist die folgenreichste Entscheidung im Artikel, daher steht sie vor dem Tutorial.
Die Default-Antwort ist die Loop.
Ein einzelner, sauber abgegrenzter Agent mit einem strengen Verifier ist schneller gebaut, günstiger im Betrieb und viel einfacher zu debuggen als jeder Graph, der denselben Job erledigt.
Das ist nicht nur meine Präferenz.
Ein UC-Berkeley-Team (Erstautor Mert Cemri) beobachtet zunächst, dass Multi-Agenten-Setups oft nur minimale Vorteile gegenüber Single-Agenten bringen, und annotiert dann 1.600+ Execution-Traces aus 7 Multi-Agenten-Frameworks, um herauszufinden, warum (arXiv:2503.13657, v3).
Ihre Taxonomie, aus dem Close Reading von 150 dieser Traces gebaut, benennt 14 unterschiedliche Fehlermodi.
Diese 14 Modi fallen in 3 Kategorien: Systemdesign-Probleme, Inter-Agenten-Fehlabstimmung und Task-Verifikation.
Halte die dritte im Kopf, bis wir beim Reviewer-Node sind.
Behandle diese Punkte als Trigger, nicht als Checkliste.
Ein klares Ja in der rechten Spalte reicht. Fünf vage sind es nicht.
| Frage zu deiner Aufgabe | Eine Loop reicht | Du willst einen Graph |
|---|---|---|
| Lässt sich der Job als eine Anweisung schreiben? | Ja, und eine Person könnte sie von Anfang bis Ende befolgen | Es liest sich wie eine Übergabe zwischen 2 verschiedenen Rollen |
| Brauchen alle Schritte dasselbe Modell? | Ein Modell und ein Toolset durchgehend | Gathering will billig und schnell, Beurteilen will scharf |
| Hängen einzelne Schritte nicht voneinander ab? | Jeder Schritt braucht den Output des vorherigen | Mehrere Lookups, die parallel laufen könnten |
| Wer entscheidet, ob der Output gut genug ist? | Der Agent liest seine eigene Arbeit gegen | Etwas, das es nicht geschrieben hat, muss abnicken |
| Was soll passieren, wenn ein Schritt scheitert? | Nochmals versuchen und weitermachen | Den Fehler einkapseln, damit der Rest überlebt |
| Muss jemand den eingeschlagenen Pfad auditieren? | Der Trace ist für dich und dein Team | Externe brauchen Sicht darauf, was lief – und warum |
Die Über-Engineered-Version, der ich am häufigsten begegne, hat nicht einmal mit Agenten zu tun. Jemand muss 800 Hoteladressen bereinigen und geokodieren, und das landet als 5-Node-Graph: Loader, Normalizer, Geocoder, Validator, Writer – mit Shared State dazwischen.
Jeder dieser Schritte ist deterministisch. Gebaut wurde also ein 40-Zeilen-Python-Skript im Framework-Kostüm – jetzt mit Kosten pro Zeile und Fehlermodi, die pandas nie hätte.
Die passende Größe ist das, was wir gleich bauen.
Ein kurzes Research-Brief zu erstellen, zerfällt in Arbeit, mit der eine einzelne Loop kämpft: Material sammeln, in Prosa überführen und diese Prosa anschließend von außen bewerten.
Der dritte Schritt ist der Grund für den Graphen, denn ein Agent, der seinen eigenen Entwurf reviewed, reviewed nicht.
Drei Dinge rechtfertigen einen Node.
Wenn du nicht für jeden hinzugefügten Node auf eines davon zeigen kannst, lösche den Node und falte seine Arbeit in einen Nachbarn.
Echte Spezialisierung kommt zuerst.
Unser Researcher will ein billiges, schnelles Modell und in Produktion Such-Tools. Der Writer will beides nicht und profitiert von einem stärkeren Modell. Die Trennung leistet also Arbeit – sie dekoriert kein Diagramm.
Zweitens: Parallelisierung, die man wirklich merkt.
Fan-out lohnt sich, wenn Zweige unabhängig sind und die eingesparte Echtzeit jemandem etwas bringt – und kostet dich Komplexität, wenn beides nicht zutrifft.
Drittens – und das verteidige ich am härtesten – unabhängige Verifikation.
Ein Agent, der seine Hausaufgaben selbst benotet, benotet freundlich. Ein separater Reviewer-Node mit Read-only-Zugriff auf den Draft ist deshalb meist der wertvollste Node in jedem Graphen.
Für die Framework-Perspektive auf diese Muster vergleicht unser Artikel CrewAI vs LangGraph vs AutoGen die Trade-offs.
Wir bauen eine LangGraph-Multi-Agent-Pipeline mit Researcher, Writer und Reviewer, die ein kurzes Research-Brief produziert und fehlgeschlagene Entwürfe zur Überarbeitung zurückschickt.
LangGraph ist ein Low-Level-Orchestrierungsframework für zustandsbehaftete Agenten. Sein StateGraph mappt fast eins zu eins auf Nodes, Edges und State aus dem vorherigen Abschnitt.
Alles unten ist gegen langgraph 1.2.11 und langchain-anthropic 1.7.1 im September 2026 geprüft.
Wenn die Library neu für dich ist, deckt unser LangGraph-Tutorial die Grundlagen ab. Dieser Abschnitt zieht an, und unser Guide LangChain vs LangGraph vs LangSmith vs LangFlow sortiert, welches Teil der Familie was tut.
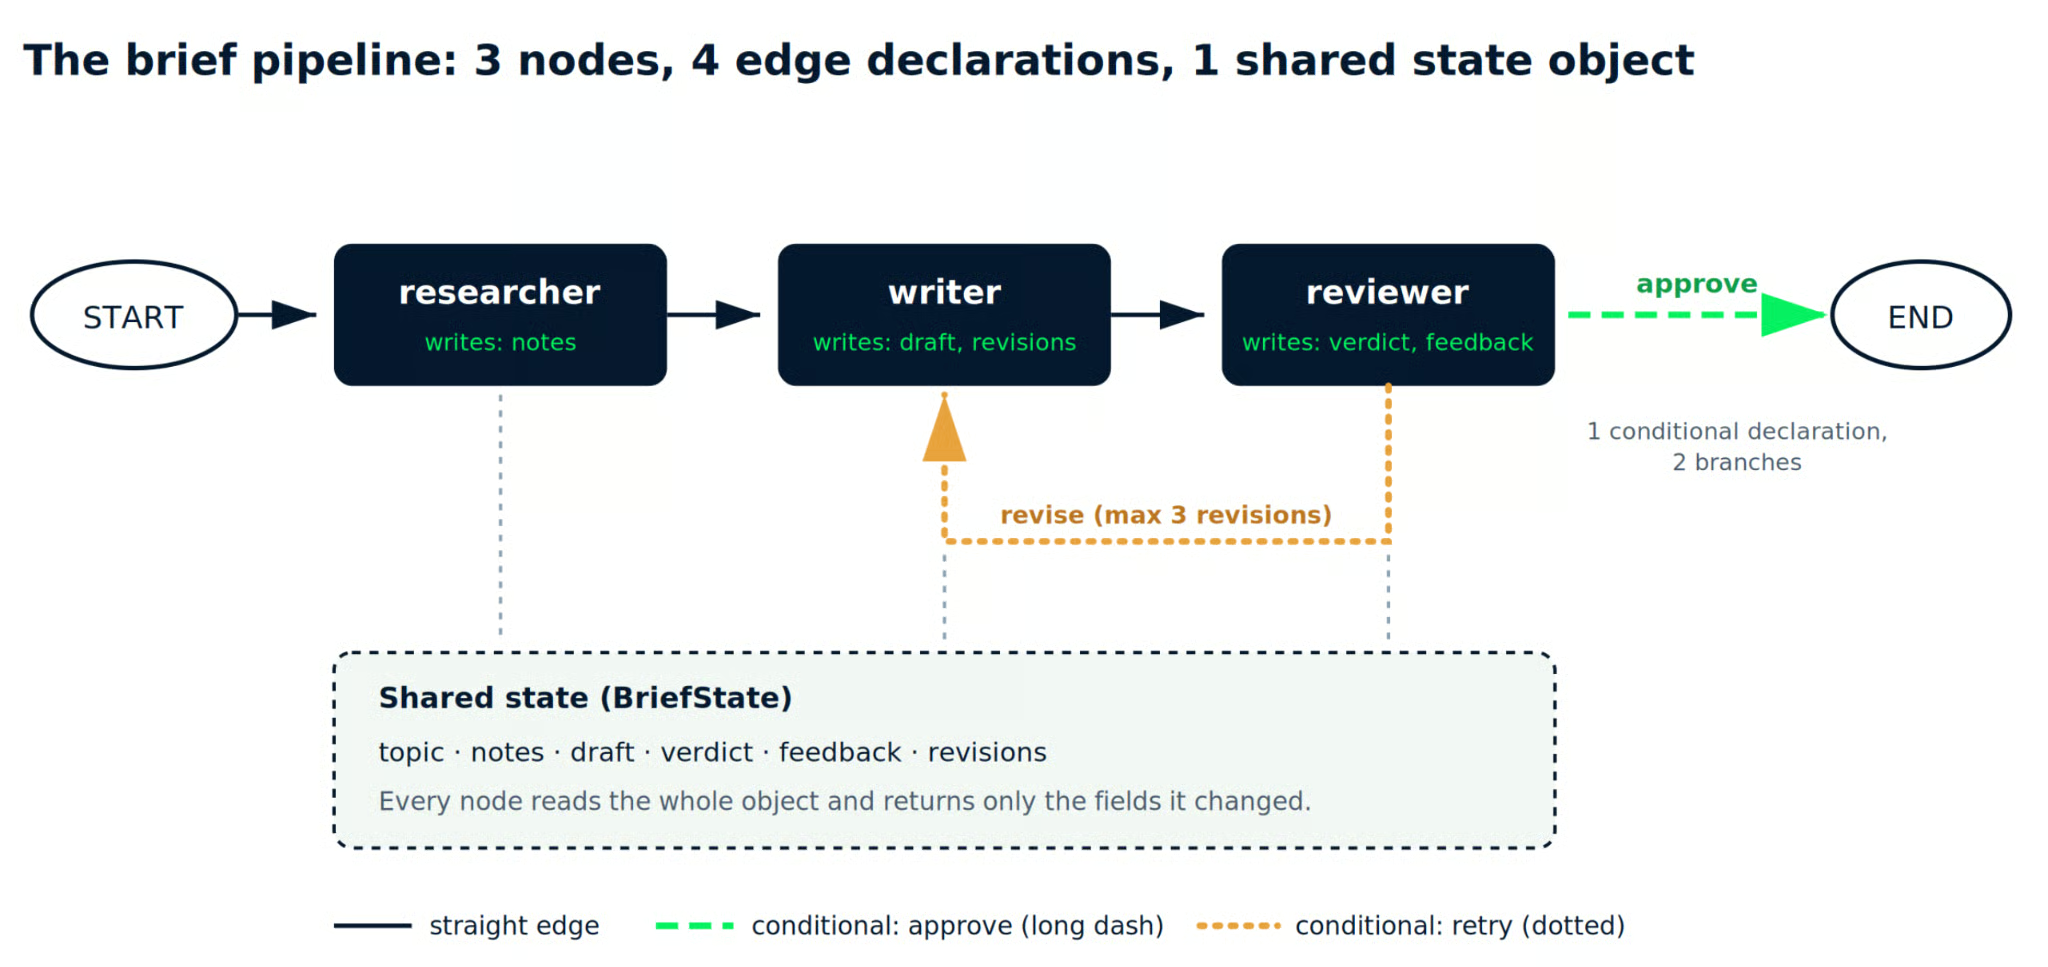
Bild: Autor. Die Pipeline, die wir gleich bauen. Durchgezogene Linien sind die 3 geraden Kanten; die gestrichelten und gepunkteten Linien sind die 2 Zweige einer einzigen bedingten Kante.
Installiere die Pakete plus python-dotenv, damit dein Key nicht im Source landet:
pip install langgraph langchain-anthropic python-dotenvLege eine .env-Datei neben deinem Skript an:
ANTHROPIC_API_KEY=sk-ant-your-key-hereJetzt die Imports und das State-Schema. Das TypedDict zuerst zu schreiben, lohnt die 2 Minuten – es ist der Vertrag, auf den sich jeder Node einigt:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# Ein günstiges Modell fürs Sammeln, ein stärkeres fürs Schreiben und Bewerten.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Zwei Modelle, nicht eins. Das ist der „anderes Modell pro Schritt“-Trigger aus der Entscheidungstabelle – in echtem Code. Research ist hochvolumig und braucht wenig Urteilstärke. Dafür muss es nicht das teure Modell sein.
MAX_REVISIONS leistet hier stille, aber wichtige Arbeit.
Ohne Limit schieben ein strenger Reviewer und ein sturer Writer einen Draft endlos hin und her – bis die Rechnung spannend wird.
Jeder Node folgt demselben Vertrag. Er erhält den aktuellen State, macht seinen einen Job und gibt ein Dictionary mit nur den Feldern zurück, die er geändert hat.
Der Researcher sammelt Rohmaterial und schreibt es in notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
In Produktion würde dieser Node ein Such-Tool aufrufen statt nur das Modellwissen zu nutzen.
Ich habe es bei einem .invoke()-Call belassen, damit die Graph-Struktur sichtbar bleibt. Behandle die Notizen daher als unverifiziert.
Der Writer liest diese Notizen und produziert einen Draft. Er prüft auch Reviewer-Feedback – das gibt der Retry-Kante etwas, worauf sie reagieren kann:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Der Reviewer bewertet den Draft.
Er sah das Denken des Writers nicht und hat keinen Text erzeugt, kann also schonungslos urteilen.
Das ist die dritte Fehlerkategorie der Berkeley-Taxonomie – als eigener Node.
Task-Verifikation bricht, wenn nichts Unabhängiges den Output prüft. Die Abhilfe ist ein Worker, der seine eigenen Hausaufgaben nicht benoten kann:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Beachte .text statt .content in allen drei Nodes.
Beide liefern bei einer einfachen Antwort einen String, aber .text verhält sich auch korrekt, wenn eine Antwort in mehreren Content-Blöcken kommt. Das erspart dir später ein verwirrendes AttributeError: 'list' object has no attribute 'strip'.
Das Verdict von der ersten Zeile zu parsen, hält den Code lesbar – und ist fragil.
Für alles, was unbeaufsichtigt läuft, ersetze diesen String-Check durch LangChains Structured Output, sodass das Verdict als typisiertes Feld zurückkommt – nicht als Präfix, von dem du hoffst, dass das Modell es respektiert.
Die Routing-Funktion ist die bedingte Kante. Sie liest den State nach dem Reviewer und gibt den Namen dessen zurück, was als Nächstes passieren soll:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions zählt jeden Draft inklusive des ersten, daher erlaubt ">"
    # 1 Original plus MAX_REVISIONS Überarbeitungen.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Halte diese Funktion stumm. Ein print() darin landet auf stdout, während die Stream-Loop noch den vorherigen Chunk druckt. So erscheint der Cap-Hinweis zu früh und der Trace wirkt außer der Reihe.
Das Revisionslimit lebt hier – nicht in einem Node –, weil Stoppen eine Control-Flow-Entscheidung ist, und Control Flow gehört auf die Edges.
Jetzt den Graph zusammenbauen. Nodes, dann Edges, dann kompilieren:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Das dritte Argument von .add_conditional_edges() ist die Pfad-Map.
Sie listet jedes mögliche Ziel, das die Routing-Funktion zurückgeben könnte. LangGraph nutzt sie, um die Verzweigung zu zeichnen, bevor ein Node gelaufen ist.
Rufe den kompilierten Graphen mit einem Initial-State auf. Nur topic und revisions brauchen Werte, die anderen Felder werden im Lauf ausgefüllt:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Das liefert dir nur den Final-State. Hilft wenig, wenn ein Lauf schiefgeht.
Tausche .invoke() gegen .stream() mit stream_mode="updates", um zu sehen, welcher Node was geschrieben hat. Jeder Call ist ein separater Run mit eigenen Modellaufrufen – nutze also entweder das eine oder das andere, statt beides zu fahren:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Bei einem Lauf, in dem der Reviewer den ersten Draft ablehnt, druckt das Folgendes:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Zwei Dinge werden hier sichtbar, die der Final-State verbirgt.
Der Researcher lief einmal, und seine Notizen blieben über beide Schreibdurchläufe bestehen – ein Retry forscht nicht neu. Außerdem fasste jeder Node nur seine eigenen Felder an. Die Write-Ownership-Regel von vorhin wird so überprüfbar.
Zähle die Calls, solange du hier bist.
Dieser abgelehnte Pfad kostet 5 Modellaufrufe gegenüber grob 1 in einer Single-Loop-Version derselben Aufgabe. Ob die zusätzlichen 4 dir etwas gebracht haben, erfährst du nur, wenn du die Verdicts loggst und liest.
Du brauchst kein Extra-Tool, um die Form dessen zu sehen, was du gebaut hast:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Die Mermaid-Ausgabe rendert den bedingten Zweig als gestrichelte Linien vom reviewer sowohl zu __end__ als auch zurück zu writer.
Das bestätigt, dass deine Retry-Kante existiert, bevor du Geld für Modellaufrufe ausgibst. Die ASCII-Ansicht zeichnet nur den geraden Pfad von Start bis Ende. Willst du die Schleife sehen, nimm Mermaid.
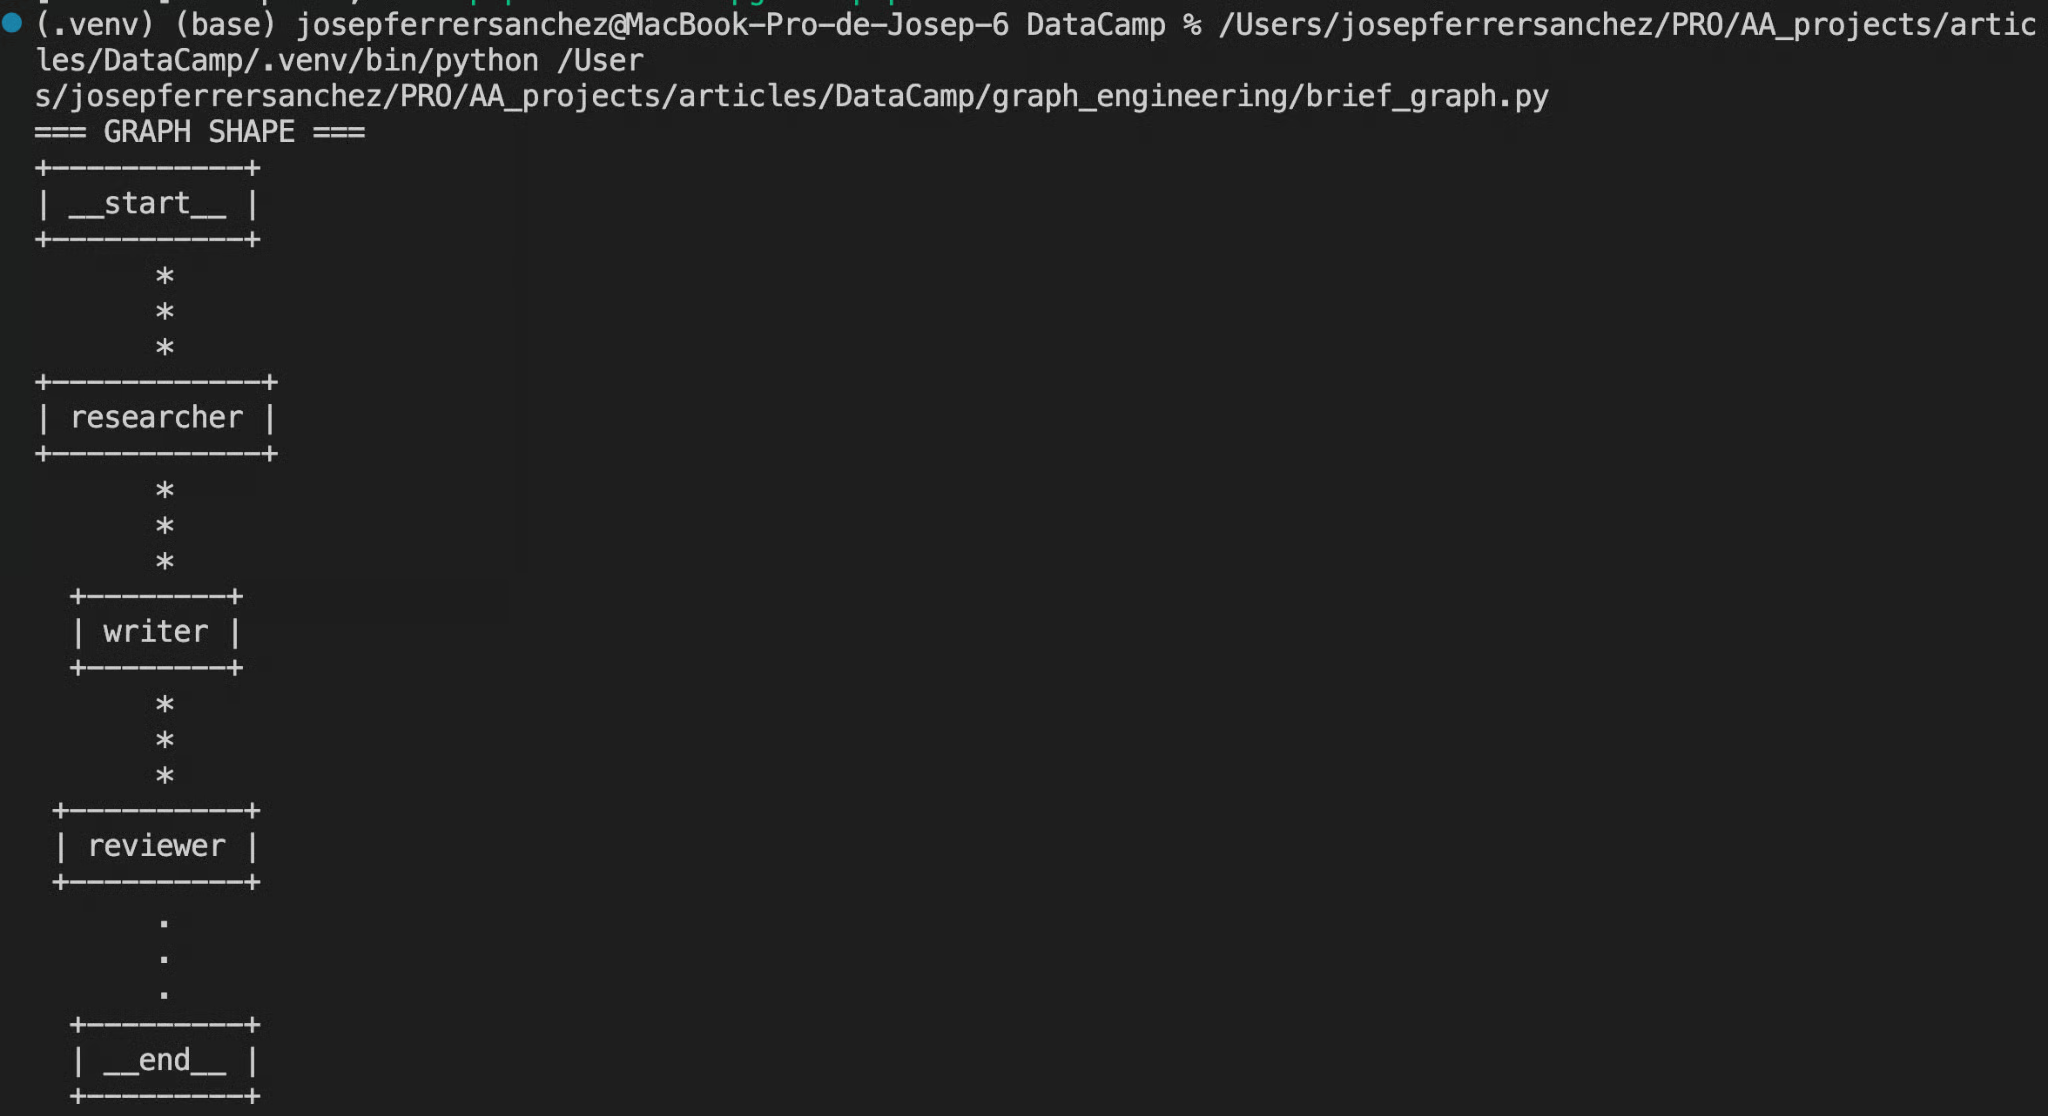
Screenshot: Autor. Terminal mit .draw_ascii()-Ausgabe: __start__, researcher, writer, reviewer und __end__ vertikal gestapelt und verbunden.
Für Step-Through-Debugging mit State-Inspection pro Node verbindet sich LangGraph Studio mit einem lokalen Server. Das braucht ein eigenes Paket und eine Config: pip install "langgraph-cli[inmem]", eine langgraph.json, die auf dein kompiliertes graph-Objekt zeigt, dann langgraph dev ausführen und die ausgegebene Studio-URL öffnen.
Unser LangGraph-Studio-Guide führt durch das Interface (er stammt aus 2024, gleiche also die Setup-Schritte mit den obigen Kommandos ab), und unser LangGraph-Agents-Tutorial zeigt, wie du echten Tools zu einem Node wie unserem Researcher hinzufügst.
Ein Scope-Hinweis.
Diese Pipeline ist sequentiell und demonstriert daher kein Fan-out – also das Muster, bei dem der Researcher mehrere Quellen gleichzeitig abfragt und ein Join-Node die Ergebnisse zusammenführt.
Das ist die natürliche nächste Erweiterung – und auch der Ort, an dem die Kosten am schnellsten explodieren.
Die Fehlermuster im agentischen KI-Graph Engineering wiederholen sich oft genug, um sie zu benennen. Das sind die drei Checks vor dem Shipping.
Jeder Node ist für sich eine Loop – mit Prompt, Tools und Definition of Done.
Drei wackelige Nodes zu verdrahten ergibt ein wackeliges System mit dreifacher Angriffsfläche und einer viel schlechteren Debugging-Story.
Bring zuerst einen Node allein zum Laufen.
Ein Researcher, der dir allein vage Notizen liefert, liefert sie im Graphen auch – und der Writer downstream baut sie selbstbewusst ein.
Widerstehe dem Drang, Logik in einen Node zu packen, wenn sie auf eine Edge gehört.
Stop-Bedingungen, Branch-Entscheidungen und Retry-Limits sind Routing – und Routing gehört in die Edge-Funktion, wo du alles auf einmal lesen kannst.
Wende den „ohne Konjunktion“-Test von oben an.
Ein Node, der Quellen sucht und entscheidet, ob es genug sind, sind zwei Nodes mit einer gemeinsamen Signatur.
Fan-out und Retry-Schleifen multiplizieren den Tokenverbrauch – ein Diagramm verschleiert das komplett.
Ein 5-Wege-Fan-out in einen Join-Node mit einem 3-Retry-Limit sind nicht 5 Calls. Je nach Platz des Retries können es 15 oder mehr werden – den Join noch nicht mitgerechnet.
Setze das Limit explizit, wie wir es mit MAX_REVISIONS getan haben. Logge dann pro Node die Tokenzahlen und lies sie nach einer Woche. Der Node, von dem du dachtest, er sei billig, ist meist der, der am häufigsten läuft.
AutoGen wird für Graph-Orchestrierung noch empfohlen, und das experimentelle GraphFlow war echtes Vorläuferwerk. Das Repository ist aber seit September 2026 im Maintenance-Modus, ohne neue Features.
Microsoft verweist neue Nutzer auf das Microsoft Agent Framework mit eigenen Graph-basierten Workflows – samt Migrationsleitfaden.
Stand heute sind LangGraph, Googles ADK oder Microsoft Agent Framework die sichereren Wahlen. Unser Kurs Building AI Agents with Google ADK behandelt ADK im Detail.
Graph Engineering ist die Koordinationsschicht über dem Loop Engineering.
Nodes erledigen die Arbeit, Edges entscheiden, was als Nächstes läuft, und ein gemeinsames Objekt trägt die Informationen zwischen ihnen.
Nimm den Timeline-Lärm vom Juli 2026 weg – das ist das ganze Modell.
Unsere Pipeline blieb absichtlich klein: 3 Nodes, 4 Edge-Deklarationen (1 davon bedingt, also mit 2 Zweigen) und ein Revisionslimit, damit der Retry nicht mit uns durchgeht.
Das reichte, um einen Draft von etwas reviewen zu lassen, das ihn nicht geschrieben hat. Genau diese Eigenschaft konnte die Loop nicht bieten.
Greife zum Graphen, wenn sich die Arbeit in Phasen mit unterschiedlichen Spezialisten aufteilt – und keinen Node früher. Die Skeptiker hatten recht: Die Mechanik ist Jahrzehnte alt, und das meiste Geschreibe dazu ist Rauschen.
Sie hatten auch in dem Punkt recht, der an einem Dienstagnachmittag zählt.
Ein schwacher Verifier an einem Loop-förmigen Problem wird nicht besser, weil du mehr Kästchen drum herum malst.
Wenn du tiefer einsteigen willst, deckt unser Kurs Multi-Agent Systems with LangGraph die Supervisor- und Netzwerk-Designs ab, an denen dieses Tutorial Halt macht.
Für die Datenseite des Wortes ist Graph RAG with LangChain and Neo4j ein guter nächster Schritt. Für Orchestrierung bleib bei Text-to-Query Agents with MongoDB and LangGraph – dort baust du eine LangGraph-Pipeline gegen eine Live-Datenbank, und LLM Agents Explained füllt die Architektur darunter aus.
Das komplette Skript liegt in meinem GitHub-Repo – inklusive Render-Helfer für den Graphen und einer kurzen Notiz zu den Kosten pro Run.
Top DataCamp Courses
Kurs
Kurs
Kurs