Program
Dasar-Dasar Bisnis Kecerdasan Buatan
12 jam
Pernah bertanya-tanya bagaimana asisten digital seperti Alexa atau Google Assistant bisa memberikan jawaban yang begitu akurat?
Keajaiban di baliknya disebut Retrieval-Augmented Generation (RAG), yang menggabungkan pengambilan informasi dengan teknik generasi bahasa. Salah satu komponen kunci dalam proses ini adalah knowledge graph, yang membantu asisten tersebut mengakses kumpulan informasi terstruktur yang sangat besar untuk meningkatkan kualitas respons.
Dalam tutorial ini, kita akan mengeksplorasi knowledge graph dan cara menggunakannya untuk membangun aplikasi RAG agar menghasilkan jawaban yang lebih akurat dan relevan.
Kita akan mulai dengan mengulas dasar-dasar knowledge graph dan perannya dalam RAG. Kita akan membandingkannya dengan basis data vektor serta mempelajari kapan sebaiknya menggunakan salah satunya. Lalu, kita akan praktik langsung membuat knowledge graph dari data teks, menyimpannya ke dalam basis data, dan menggunakannya untuk menemukan info relevan bagi kueri pengguna. Kita juga akan melihat bagaimana memperluas pendekatan ini untuk menangani berbagai jenis data dan format file, bukan hanya teks biasa.
Jika Anda ingin mempelajari lebih lanjut tentang RAG, lihat artikel ini tentang retrieval augmented generation.
Knowledge graph merepresentasikan informasi dalam format yang terstruktur dan saling terhubung. Struktur ini terdiri dari entitas (node) dan relasi (edge) antar entitas. Entitas dapat mewakili objek dunia nyata, konsep, atau gagasan, sedangkan relasi menggambarkan bagaimana entitas-entitas tersebut saling terhubung.
Intuisi di balik knowledge graph adalah meniru cara manusia memahami dan menalar dunia. Kita tidak menyimpan informasi dalam silo yang terpisah; kita justru menghubungkan berbagai potongan informasi, membentuk jejaring pengetahuan yang kaya dan saling terhubung.
Knowledge graph membantu kita melihat bagaimana entitas saling terhubung dengan menampilkan relasi antar entitas secara jelas. Menelusuri koneksi-koneksi ini memungkinkan kita menemukan informasi baru dan menarik kesimpulan yang sulit didapat dari potongan informasi yang terpisah.
Mari lihat sebuah contoh.
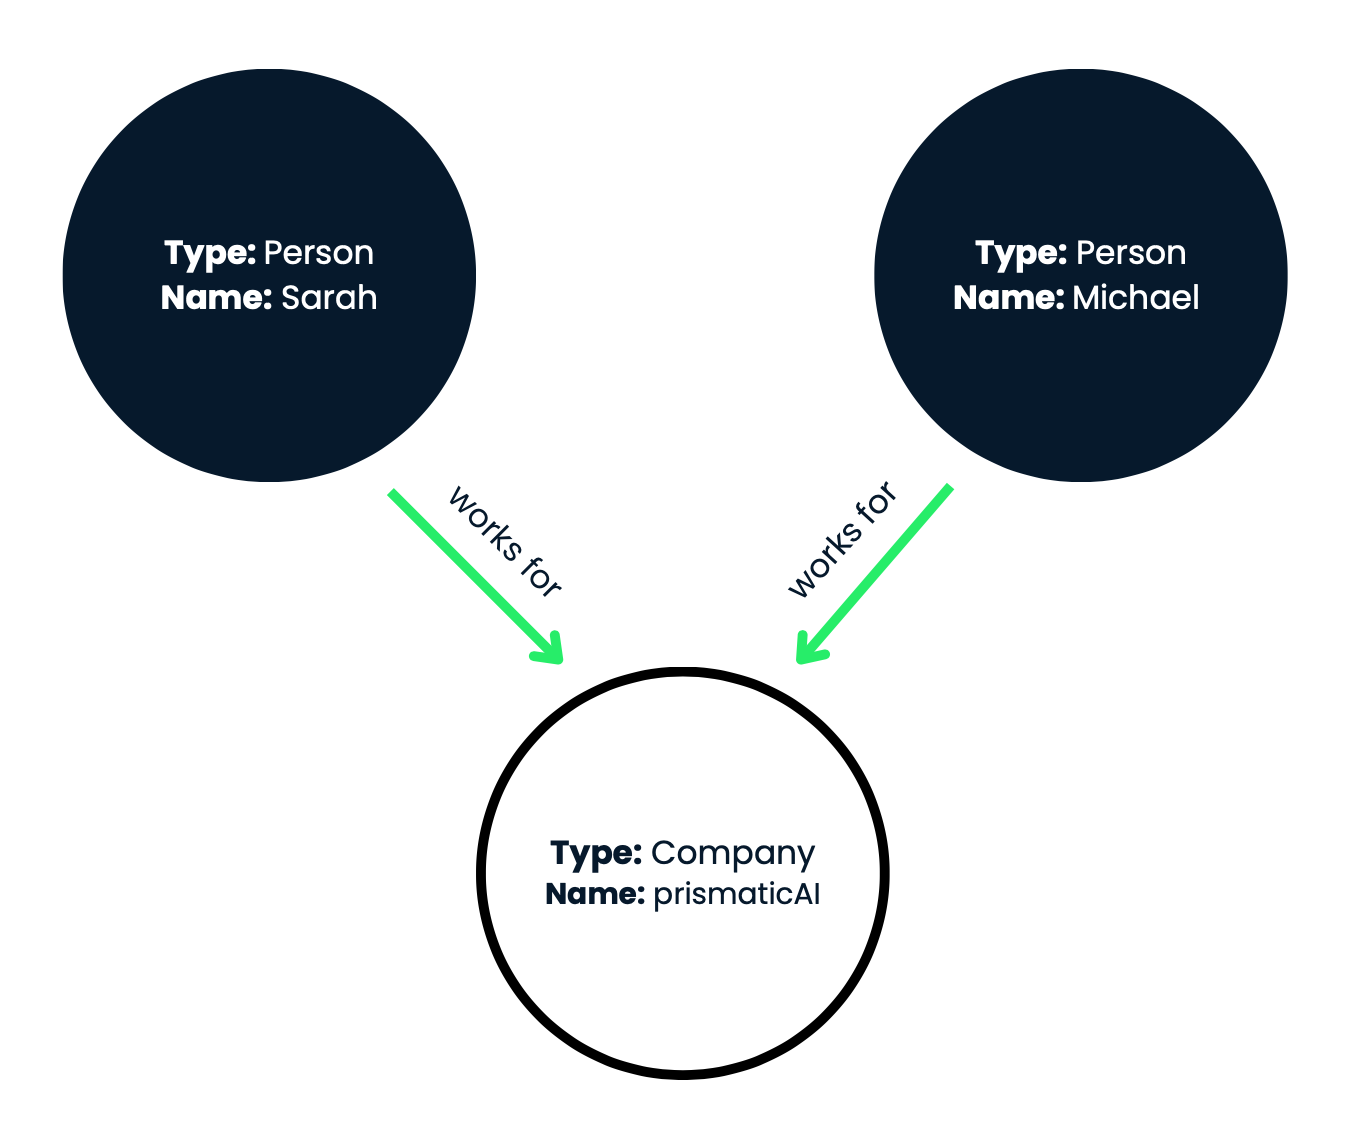
Gambar 1: Dalam representasi visual ini, node ditampilkan sebagai lingkaran, dan relasi direpresentasikan sebagai panah berlabel yang menghubungkan node-node tersebut.
Knowledge graph ini secara efektif menangkap relasi ketenagakerjaan antara individu bernama Sarah dan Michael dengan perusahaan prismaticAI. Dalam contoh kita, terdapat tiga node:
Singkatnya, kita memiliki dua node person (Sarah dan Michael) dan satu node company (prismaticAI). Sekarang, mari lihat relasi (edge) antar node ini:
Salah satu aspek kuat dari knowledge graph adalah kemampuannya untuk melakukan kueri dan menelusuri relasi antar entitas guna mengekstrak informasi relevan atau menyimpulkan pengetahuan baru. Mari kita eksplorasi bagaimana melakukan hal ini dengan knowledge graph contoh kita.
Pertama, kita perlu menentukan informasi apa yang ingin diambil dari knowledge graph. Misalnya:
Kueri 1: Di mana Sarah bekerja?
Untuk menjawab kueri ini, kita perlu menemukan titik awal yang tepat pada knowledge graph. Dalam hal ini, kita mulai dari node yang merepresentasikan Sarah.
Dari titik awal (node Sarah), kita mengikuti edge relasi "works for" yang keluar. Edge ini menghubungkan node Sarah ke node yang merepresentasikan prismaticAI. Dengan menelusuri relasi "works for", kita dapat menyimpulkan bahwa Sarah bekerja di prismaticAI.
Jawaban 1: Sarah bekerja di prismaticAI.
Mari coba kueri lain:
Kueri 2: Siapa yang bekerja di prismaticAI?
Kali ini, kita ingin mulai dari node yang merepresentasikan prismaticAI.
Dari node prismaticAI, kita menelusuri edge relasi "works for" secara mundur. Ini akan membawa kita ke node-node yang merepresentasikan orang-orang yang bekerja di prismaticAI. Dengan menelusuri relasi "works for" secara terbalik, kita dapat mengidentifikasi bahwa Sarah dan Michael sama-sama bekerja di prismaticAI.
Jawaban 2: Sarah dan Michael bekerja di prismaticAI.
Satu contoh lagi!
Kueri 3: Apakah Michael bekerja di perusahaan yang sama dengan Sarah?
Kita bisa mulai dari node Sarah atau node Michael. Mari mulai dari node Sarah.
Kita mengikuti relasi "works for" hingga mencapai node prismaticAI.
Lalu, kita periksa apakah Michael juga memiliki relasi "works for" yang mengarah ke node prismaticAI yang sama. Karena Sarah dan Michael sama-sama memiliki relasi "works for" dengan node prismaticAI, kita dapat menyimpulkan bahwa mereka bekerja di perusahaan yang sama.
Jawaban 3: Ya, Michael bekerja di perusahaan yang sama dengan Sarah (prismaticAI).
Menelusuri relasi dalam knowledge graph memungkinkan kita mengekstrak informasi spesifik dan memahami koneksi antar entitas. Knowledge graph dapat menjadi jauh lebih kompleks, dengan banyak node dan relasi, sehingga memungkinkan representasi pengetahuan dunia nyata yang rumit dalam cara yang terstruktur dan saling terhubung.
Aplikasi RAG menggabungkan pengambilan informasi dan generasi bahasa alami untuk memberikan respons yang relevan dan koheren terhadap kueri atau prompt pengguna. Knowledge graph menawarkan sejumlah keunggulan yang membuatnya sangat cocok untuk aplikasi ini. Mari bahas manfaat utamanya:
Seperti yang kita pelajari di bagian sebelumnya, knowledge graph merepresentasikan informasi secara terstruktur, dengan entitas (node) dan relasinya (edge). Representasi terstruktur ini memudahkan pengambilan informasi yang relevan untuk kueri atau tugas tertentu dibandingkan data teks tak terstruktur.
Dalam knowledge graph contoh kita, kita dapat dengan mudah mengambil informasi tentang siapa yang bekerja di prismaticAI dengan mengikuti relasi "works for".
Knowledge graph menangkap relasi antar entitas, sehingga memungkinkan pemahaman yang lebih mendalam terhadap konteks tempat informasi disajikan. Pemahaman kontekstual ini sangat penting untuk menghasilkan respons yang koheren dan relevan dalam aplikasi RAG.
Kembali ke contoh kita, memahami relasi "works for" antara Sarah, Michael, dan prismaticAI akan memungkinkan aplikasi RAG memberikan respons yang lebih relevan secara konteks tentang pekerjaan mereka.
Menelusuri relasi dalam knowledge graph memungkinkan aplikasi RAG melakukan inferensi dan menurunkan pengetahuan baru yang mungkin tidak dinyatakan secara eksplisit. Kemampuan penalaran inferensial ini meningkatkan kualitas dan kelengkapan respons yang dihasilkan.
Dengan menelusuri relasi, aplikasi RAG dapat menyimpulkan bahwa Sarah dan Michael bekerja di perusahaan yang sama, meskipun informasi ini tidak dinyatakan secara langsung.
Knowledge graph dapat mengintegrasikan informasi dari berbagai sumber, memungkinkan aplikasi RAG memanfaatkan basis pengetahuan yang beragam dan saling melengkapi. Integrasi pengetahuan ini dapat menghasilkan respons yang lebih komprehensif dan menyeluruh.
Kita bisa menambahkan informasi tentang perusahaan, karyawan, dan peran mereka dari berbagai sumber ke contoh knowledge graph kita, sehingga memberikan gambaran yang lebih lengkap untuk menghasilkan respons.
Knowledge graph menyediakan representasi pengetahuan yang transparan saat digunakan untuk menghasilkan respons. Transparansi ini kunci untuk menjelaskan proses penalaran di balik keluaran yang dihasilkan, yang penting dalam banyak aplikasi, seperti sistem tanya jawab.
Penjelasan untuk jawaban 3 pada contoh kita bisa seperti ini: Ya, Michael bekerja di perusahaan yang sama dengan Sarah. Saya sampai pada kesimpulan ini dengan mengidentifikasi bahwa Sarah bekerja di prismaticAI lalu memverifikasi bahwa Michael juga memiliki relasi 'works for' dengan prismaticAI. Karena keduanya memiliki relasi ini dengan entitas perusahaan yang sama, saya dapat menyimpulkan bahwa mereka bekerja di perusahaan yang sama.
Transparansi dalam proses penalaran ini memungkinkan pengguna dan pengembang memahami bagaimana aplikasi RAG sampai pada responsnya alih-alih menganggapnya sebagai kotak hitam. Ini juga meningkatkan kepercayaan terhadap sistem, karena proses pengambilan keputusan dijabarkan dengan jelas dan dapat diverifikasi terhadap knowledge graph.
Selain itu, jika ada inkonsistensi atau informasi yang hilang dalam knowledge graph, penjelasan dapat membantu mengidentifikasi dan mengatasi masalah tersebut, sehingga meningkatkan akurasi dan kelengkapan respons.
Dengan menggunakan knowledge graph, aplikasi RAG dapat menghasilkan respons yang lebih akurat, jelas, dan mudah dipahami. Ini membuatnya bermanfaat untuk berbagai tugas dalam pemrosesan bahasa alami.
Saat membangun aplikasi RAG, Anda mungkin menemukan dua pendekatan berbeda: knowledge graph dan basis data vektor. Keduanya digunakan untuk merepresentasikan dan mengambil informasi, tetapi berbeda dalam struktur data yang mendasarinya dan cara menangani informasi.
Mari kita bahas perbedaan utama antara dua pendekatan ini:
|
Fitur |
Knowledge Graph |
Basis Data Vektor |
|
Representasi Data |
Entitas (node) dan relasi (edge) antar entitas, membentuk struktur graf. |
Vektor berdimensi tinggi, masing-masing merepresentasikan sepotong informasi (mis. dokumen, kalimat). |
|
Mekanisme Pengambilan |
Menelusuri struktur graf dan mengikuti relasi antar entitas. Memungkinkan inferensi dan penurunan pengetahuan baru. |
Kemiripan vektor berdasarkan metrik kemiripan (mis. cosine similarity). Mengembalikan vektor yang paling mirip beserta informasi terkait. |
|
Keterinterpretasian |
Representasi pengetahuan yang dapat diinterpretasikan manusia. Struktur graf dan relasi berlabel memperjelas koneksi antar entitas. |
Kurang dapat diinterpretasikan manusia karena representasi numerik berdimensi tinggi. Sulit untuk langsung memahami relasi atau alasan di balik informasi yang diambil. |
|
Integrasi Pengetahuan |
Mempermudah integrasi dengan merepresentasikan entitas dan relasi dalam struktur graf terpadu. Integrasi mulus jika entitas dan relasi dipetakan dengan benar. |
Lebih menantang. Membutuhkan teknik seperti penyelarasan ruang vektor atau metode ansambel untuk menggabungkan informasi. Memastikan kompatibilitas vektor bisa tidak sepele. |
|
Penalaran Inferensial |
Memungkinkan penalaran inferensial dengan menelusuri struktur graf dan memanfaatkan relasi antar entitas. Mengungkap koneksi implisit dan menurunkan wawasan baru. |
Lebih terbatas. Bertumpu pada kemiripan vektor dan bisa melewatkan relasi atau inferensi implisit. Dapat mengidentifikasi informasi serupa tetapi tidak relasi kompleks seperti pada knowledge graph. |
Baik knowledge graph maupun basis data vektor memiliki keunggulan dan kasus penggunaannya masing-masing, dan pilihan di antara keduanya bergantung pada kebutuhan spesifik aplikasi Anda. Knowledge graph unggul dalam merepresentasikan dan melakukan penalaran atas pengetahuan terstruktur, sementara basis data vektor cocok untuk tugas yang sangat bergantung pada kemiripan semantik dan pengambilan informasi berbasis representasi vektor.
Anda dapat mempelajari lebih lanjut tentang basis data vektor dalam pengantar basis data vektor untuk machine learning ini. Selain itu, lihat lima basis data vektor terpopuler.
Pada bagian ini, kita akan mengeksplorasi cara menerapkan knowledge graph untuk meningkatkan proses generasi bahasa dalam aplikasi RAG.
Kita akan membahas langkah-langkah utama berikut:
Di akhir bagian ini, Anda akan memiliki pemahaman yang kuat tentang penerapan knowledge graph dalam aplikasi RAG, sehingga Anda dapat membangun sistem generasi bahasa yang lebih cerdas dan peka konteks.
Sebelum mulai, pastikan Anda telah memasang hal-hal berikut:
pip install langchain)pip install llama-index)Langkah pertama adalah memuat dan memraproses data teks yang akan kita gunakan untuk mengekstrak knowledge graph. Pada contoh ini, kita akan menggunakan cuplikan teks yang menggambarkan perusahaan teknologi bernama prismaticAI, para karyawannya, dan peran mereka.
from langchain.document_loaders import TextLoader
from langchain.text_splitter import CharacterTextSplitter

# Load text data
text = """Sarah is an employee at prismaticAI, a leading technology company based in Westside Valley. She has been working there for the past three years as a software engineer.
Michael is also an employee at prismaticAI, where he works as a data scientist. He joined the company two years ago after completing his graduate studies.
prismaticAI is a well-known technology company that specializes in developing cutting-edge software solutions and artificial intelligence applications. The company has a diverse workforce of talented individuals from various backgrounds.
Both Sarah and Michael are highly skilled professionals who contribute significantly to prismaticAI's success. They work closely with their respective teams to develop innovative products and services that meet the evolving needs of the company's clients."""

loader = TextLoader(text)
documents = loader.load()
text_splitter = CharacterTextSplitter(chunk_size=200, chunk_overlap=20)
texts = text_splitter.split_documents(documents)
Kita mulai dengan mengimpor kelas yang diperlukan dari LangChain: TextLoader dan CharacterTextSplitter. TextLoader memuat data teks, sedangkan CharacterTextSplitter membagi teks menjadi potongan-potongan lebih kecil untuk pemrosesan yang lebih efisien.
Selanjutnya, kita mendefinisikan data teks sebagai variabel string multi-baris text.
Kita kemudian menggunakan TextLoader untuk memuat data teks langsung dari variabel teks. Metode loader.load() mengembalikan daftar objek Document, masing-masing berisi potongan teks.
Untuk membagi teks menjadi potongan yang lebih kecil dan mudah dikelola, kita membuat instance CharacterTextSplitter dengan chunk_size 200 karakter dan chunk_overlap 20 karakter. Parameter chunk_overlap memastikan adanya tumpang tindih antar potongan yang berdekatan, yang dapat membantu mempertahankan konteks selama proses ekstraksi pengetahuan.
Terakhir, kita menggunakan metode split_documents dari CharacterTextSplitter untuk membagi objek Document menjadi potongan yang lebih kecil, yang disimpan dalam variabel texts sebagai daftar objek Document.
Praproses data teks seperti ini memungkinkan kita menyiapkannya untuk langkah berikutnya, yakni menginisialisasi model bahasa dan menggunakannya untuk mengekstrak knowledge graph dari potongan teks.
Setelah memuat dan memraproses data teks, langkah selanjutnya adalah menginisialisasi model bahasa dan menggunakannya untuk mengekstrak knowledge graph dari potongan teks. Dalam contoh ini, kita akan menggunakan model bahasa OpenAI yang disediakan oleh LangChain.
from langchain.llms import OpenAI
from langchain.transformers import LLMGraphTransformer
import getpass
import os

# Load environment variable for OpenAI API key
os.environ["OPENAI_API_KEY"] = getpass.getpass()

# Initialize LLM
llm = OpenAI(temperature=0)

# Extract Knowledge Graph
llm_transformer = LLMGraphTransformer(llm=llm)
graph_documents = llm_transformer.convert_to_graph_documents(texts)
Pertama, kita mengimpor kelas yang diperlukan dari LangChain: OpenAI dan LLMGraphTransformer. OpenAI adalah pembungkus untuk model bahasa OpenAI yang akan kita gunakan untuk mengekstrak knowledge graph. LLMGraphTransformer adalah kelas utilitas yang membantu mengonversi data teks menjadi representasi knowledge graph.
Selanjutnya, kita memuat kunci API OpenAI dari variabel lingkungan. Ini adalah praktik keamanan yang baik untuk menghindari penulisan kredensial sensitif langsung di kode.
Kemudian, kita menginisialisasi instance model bahasa OpenAI dengan nilai temperature 0. Parameter temperature mengontrol tingkat keacakan keluaran model; nilai yang lebih rendah menghasilkan respons yang lebih deterministik.
Setelah menginisialisasi model bahasa, kita membuat instance LLMGraphTransformer dan meneruskan objek llm yang telah diinisialisasi. Kelas LLMGraphTransformer mengonversi potongan teks (texts) menjadi representasi knowledge graph.
Terakhir, kita memanggil metode convert_to_graph_documents dari LLMGraphTransformer, dengan meneruskan daftar texts. Metode ini menggunakan model bahasa untuk menganalisis potongan teks dan mengekstrak entitas, relasi, serta informasi terstruktur relevan lainnya, lalu merepresentasikannya sebagai knowledge graph. Knowledge graph yang dihasilkan disimpan dalam variabel graph_documents.
Kita telah berhasil menginisialisasi model bahasa dan menggunakannya untuk mengekstrak knowledge graph dari data teks. Pada langkah berikutnya, kita akan menyimpan knowledge graph ke basis data untuk persistensi dan kueri.
Setelah mengekstrak knowledge graph dari data teks, penting untuk menyimpannya dalam format yang persisten dan dapat dikueri. Dalam tutorial ini, kita akan menggunakan Neo4j untuk menyimpan knowledge graph.
from langchain.graph_stores import Neo4jGraphStore

# Store Knowledge Graph in Neo4j
graph_store = Neo4jGraphStore(url="neo4j://your_neo4j_url", username="your_username", password="your_password")
graph_store.write_graph(graph_documents)
Pertama, kita mengimpor kelas Neo4jGraphStore dari LangChain. Kelas ini menyediakan antarmuka yang mudah untuk berinteraksi dengan basis data Neo4j dan menyimpan knowledge graph.
Selanjutnya, kita membuat instance Neo4jGraphStore dengan memberikan detail koneksi yang diperlukan: URL basis data Neo4j, nama pengguna, dan kata sandi. Pastikan untuk mengganti "your_neo4j_url", "your_username", dan "your_password" dengan nilai yang sesuai untuk instance Neo4j Anda.
Terakhir, kita memanggil metode write_graph dari instance graph_store, dengan meneruskan daftar graph_documents yang diperoleh dari langkah sebelumnya. Metode ini melakukan serialisasi knowledge graph dan menuliskannya ke basis data Neo4j.
Menyimpan knowledge graph dalam basis data Neo4j memungkinkan kita memastikan bahwa graf tersebut persisten dan mudah dikueri serta diambil saat dibutuhkan. Struktur graf Neo4j memungkinkan representasi dan penelusuran yang efisien atas relasi dan entitas kompleks yang ada dalam knowledge graph.
Pada langkah berikutnya, kita akan menyiapkan komponen untuk mengambil pengetahuan dari graf dan menghasilkan respons menggunakan konteks yang diambil.
Perlu dicatat bahwa meskipun tutorial ini menggunakan Neo4j sebagai basis data graf, LangChain juga mendukung basis data graf lainnya, seperti Amazon Neptune dan basis data kompatibel TinkerPop seperti Gremlin Server. Anda dapat menukar Neo4jGraphStore dengan implementasi penyimpanan graf yang sesuai untuk basis data pilihan Anda.
Sekarang setelah kita menyimpan knowledge graph ke dalam basis data, kita dapat menyiapkan komponen untuk mengambil pengetahuan relevan dari graf berdasarkan kueri pengguna dan menghasilkan respons menggunakan konteks yang diambil. Ini adalah fungsi inti dari aplikasi RAG.
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.retrievers import KnowledgeGraphRAGRetriever
from llama_index.core.response_synthesis import ResponseSynthesizer

# Retrieve Knowledge for RAG
graph_rag_retriever = KnowledgeGraphRAGRetriever(storage_context=graph_store.storage_context, verbose=True)
query_engine = RetrieverQueryEngine.from_args(graph_rag_retriever)
Pertama, kita mengimpor kelas yang diperlukan dari LlamaIndex: RetrieverQueryEngine, KnowledgeGraphRAGRetriever, dan ResponseSynthesizer.
RetrieverQueryEngine adalah mesin kueri yang menggunakan retriever untuk mengambil konteks yang relevan dari sumber data (dalam kasus kita, knowledge graph) lalu menyintesis respons menggunakan konteks tersebut.
KnowledgeGraphRAGRetriever adalah retriever khusus yang dapat mengambil informasi relevan dari knowledge graph yang disimpan di basis data.
ResponseSynthesizer bertanggung jawab menghasilkan respons akhir dengan menggabungkan konteks yang diambil dengan model bahasa.
Selanjutnya, kita membuat instance KnowledgeGraphRAGRetriever dengan meneruskan storage_context dari instance graph_store kita. storage_context ini berisi informasi yang diperlukan untuk terhubung dan melakukan kueri ke basis data Neo4j tempat kita menyimpan knowledge graph. Kita juga menetapkan verbose=True untuk mengaktifkan pencatatan detail selama proses pengambilan.
Lalu, kita menginisialisasi RetrieverQueryEngine menggunakan metode from_args dan meneruskan instance graph_rag_retriever kita. Mesin kueri ini akan menangani seluruh proses pengambilan konteks relevan dari knowledge graph dan menghasilkan respons berdasarkan konteks tersebut.
Dengan komponen-komponen ini siap, kita sekarang dapat melakukan kueri pada knowledge graph dan menghasilkan respons menggunakan konteks yang diambil. Pada langkah berikutnya, kita akan melihat cara melakukannya dalam praktik.
Terakhir, kita dapat melakukan kueri pada knowledge graph dan menghasilkan respons menggunakan konteks yang diambil.
def query_and_synthesize(query):
    retrieved_context = query_engine.query(query)
    response = response_synthesizer.synthesize(query, retrieved_context)
    print(f"Query: {query}")
    print(f"Answer: {response}\n")

# Initialize the ResponseSynthesizer instance
response_synthesizer = ResponseSynthesizer(llm)

# Query 1
query_and_synthesize("Where does Sarah work?")

# Query 2
query_and_synthesize("Who works for prismaticAI?")

# Query 3
query_and_synthesize("Does Michael work for the same company as Sarah?")
Dalam contoh ini, kita mendefinisikan tiga kueri berbeda terkait karyawan dan perusahaan yang dijelaskan dalam data teks. Untuk setiap kueri, kita menggunakan query_engine untuk mengambil konteks yang relevan dari knowledge graph, membuat instance ResponseSynthesizer, dan memanggil metode synthesize dengan kueri dan konteks yang diambil.
ResponseSynthesizer menggunakan model bahasa dan konteks yang diambil untuk menghasilkan respons akhir terhadap kueri, lalu mencetaknya ke konsol, sesuai dengan jawaban pada bagian pertama artikel ini.
Meskipun tutorial ini mendemonstrasikan penggunaan knowledge graph untuk aplikasi RAG dengan teks yang relatif sederhana, skenario dunia nyata sering kali melibatkan set data yang lebih kompleks dan beragam. Selain itu, data masukan dapat hadir dalam berbagai format file di luar teks biasa. Pada bagian ini, kita akan mengeksplorasi bagaimana aplikasi RAG berbasis knowledge graph dapat diperluas untuk menangani skenario semacam itu.
Seiring meningkatnya ukuran dan kompleksitas data masukan, proses ekstraksi knowledge graph bisa menjadi lebih menantang. Berikut beberapa strategi untuk menangani set data yang besar dan beragam:
Dalam skenario dunia nyata, data dapat hadir dalam berbagai format file, seperti PDF, dokumen Word, spreadsheet, atau bahkan format data terstruktur seperti JSON atau XML. Untuk menangani berbagai jenis file ini, Anda dapat menggunakan strategi berikut:
Strategi-strategi ini akan membantu Anda memperluas aplikasi RAG berbasis knowledge graph untuk menangani set data yang lebih kompleks dan beragam, serta rentang jenis file yang lebih luas.
Perlu dicatat bahwa seiring meningkatnya kompleksitas data masukan, proses ekstraksi knowledge graph mungkin memerlukan penyesuaian dan penyetelan khusus domain agar hasilnya akurat dan andal.
Menyiapkan knowledge graph untuk aplikasi RAG di dunia nyata dapat menjadi tugas yang kompleks dengan sejumlah tantangan. Mari kita eksplorasi beberapa di antaranya:
Membangun knowledge graph berkualitas tinggi adalah proses yang kompleks dan memakan waktu, memerlukan keahlian domain dan upaya yang signifikan. Mengekstrak entitas, relasi, dan fakta dari berbagai sumber data serta mengintegrasikannya ke dalam knowledge graph yang koheren bisa menantang, terutama untuk set data yang besar dan beragam. Ini melibatkan pemahaman domain, mengidentifikasi informasi yang relevan, dan menyusunnya dengan cara yang akurat menangkap relasi dan semantik.
Aplikasi RAG sering kali perlu mengintegrasikan data dari berbagai sumber heterogen, masing-masing dengan struktur, format, dan semantiknya sendiri. Memastikan konsistensi data, menyelesaikan konflik, serta memetakan entitas dan relasi di berbagai sumber data bukanlah hal sepele. Diperlukan pembersihan, transformasi, dan pemetaan data yang cermat agar knowledge graph secara akurat merepresentasikan informasi dari berbagai sumber.
Knowledge graph bukanlah sesuatu yang statis. Graf perlu terus diperbarui dan dipelihara ketika informasi baru tersedia atau informasi yang ada berubah. Menjaga knowledge graph tetap mutakhir dan konsisten dengan sumber data yang terus berkembang bisa menjadi proses yang memakan sumber daya. Ini melibatkan pemantauan perubahan pada sumber data, mengidentifikasi pembaruan yang relevan, dan menyebarkan pembaruan tersebut ke knowledge graph sambil menjaga integritas dan konsistensinya.
Seiring bertambahnya ukuran dan kompleksitas knowledge graph, memastikan penyimpanan, pengambilan, dan kueri data graf yang efisien menjadi semakin menantang. Masalah skalabilitas dan kinerja dapat muncul, khususnya untuk aplikasi RAG berskala besar dengan volume kueri tinggi. Mengoptimalkan teknik penyimpanan knowledge graph, pengindeksan, dan pemrosesan kueri menjadi krusial untuk mempertahankan tingkat kinerja yang dapat diterima.
Walaupun knowledge graph unggul dalam merepresentasikan relasi kompleks dan memungkinkan penalaran multi-lompatan, merumuskan dan mengeksekusi kueri kompleks yang memanfaatkan kemampuan ini bisa sulit. Mengembangkan algoritma pemrosesan kueri dan penalaran yang efisien adalah area riset yang aktif. Memahami bahasa kueri dan kemampuan penalaran sistem knowledge graph penting untuk memanfaatkan seluruh potensinya secara efektif.
Masih kurang standar yang banyak diadopsi untuk merepresentasikan dan melakukan kueri pada knowledge graph, yang dapat menimbulkan masalah interoperabilitas dan ketergantungan pada vendor tertentu. Sistem knowledge graph yang berbeda mungkin menggunakan model data, bahasa kueri, dan API yang berbeda, sehingga menyulitkan untuk berpindah antar sistem atau berintegrasi dengan sistem lain. Mengadopsi atau mengembangkan standar dapat memfasilitasi interoperabilitas dan mengurangi ketergantungan pada vendor.
Meskipun knowledge graph dapat menyediakan penalaran yang dapat dijelaskan dan transparan, memastikan proses penalaran mudah diinterpretasikan dan dipahami oleh pengguna akhir bisa menjadi tantangan, terutama untuk kueri atau jalur penalaran yang kompleks. Mengembangkan antarmuka dan penjelasan yang ramah pengguna serta secara jelas mengomunikasikan proses penalaran beserta asumsi yang mendasarinya penting untuk kepercayaan dan adopsi pengguna.
Bergantung pada domain dan aplikasinya, mungkin ada tantangan tambahan yang spesifik untuk domain tersebut, seperti menangani terminologi, ontologi, atau format data khusus domain. Misalnya, pada domain medis, menangani terminologi medis yang kompleks, sistem pengodean, dan masalah privasi dapat menambah lapisan kompleksitas tambahan pada penyiapan dan penggunaan knowledge graph.
Terlepas dari tantangan-tantangan tersebut, knowledge graph menawarkan keunggulan signifikan untuk aplikasi RAG, khususnya dalam merepresentasikan pengetahuan terstruktur, memungkinkan penalaran yang kompleks, dan memberikan hasil yang dapat dijelaskan serta transparan. Mengatasi tantangan ini melalui desain knowledge graph yang cermat, strategi integrasi data, dan teknik pemrosesan kueri yang efisien sangat penting untuk berhasil menerapkan aplikasi RAG berbasis knowledge graph.
Dalam tutorial ini, kita mengeksplorasi kekuatan knowledge graph untuk menghasilkan respons yang lebih akurat, informatif, dan relevan secara kontekstual. Kita mulai dengan memahami konsep dasar di balik knowledge graph dan perannya dalam aplikasi RAG. Lalu, kita menelusuri contoh praktik langsung, mengekstrak knowledge graph dari data teks, menyimpannya di basis data Neo4j, dan menggunakannya untuk mengambil konteks relevan bagi kueri pengguna. Terakhir, kita mendemonstrasikan cara menggunakan konteks yang diambil untuk menghasilkan respons dengan memanfaatkan pengetahuan terstruktur dalam graf.
Jika Anda ingin mempelajari lebih lanjut tentang AI dan LLM, lihat jalur keterampilan enam kursus tentang AI Fundamentals ini.
Semoga Anda menemukan tutorial ini bermanfaat dan menyenangkan, sampai jumpa di pembahasan berikutnya.
Selamat ngoding!
Pelajari lebih lanjut tentang AI dan LLM!
Program
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



