Courses
使用 LangGraph 构建多智能体系统
2小时45分钟
8.6K
给一个智能体一项任务,它能完成得不错。给它三项任务,看看第二次交接会发生什么:它会忘记第一步找到的内容,它会慷慨地给自己的草稿打高分,它会宣布成功,而输出仍未完成地摆在那里。
关于这种模式的争论在 2026 年 7 月中旬爆发开来,当“图工程”登上 X(原 Twitter)后,时间线立刻分成两派:一边宣布智能体循环已死,另一边称这个词是内容农场的填充物。
我的看法是,“图工程”这个标签可有可无,但背后的升级不可避免。写代码前我会先试着为此辩护。
本月您要构建的大多数东西仍应是单循环;而最容易浪费一周时间的方式,就是为只需要 1 个盒子的工作画出 6 个盒子的图。
一个智能体图有 3 个部分:
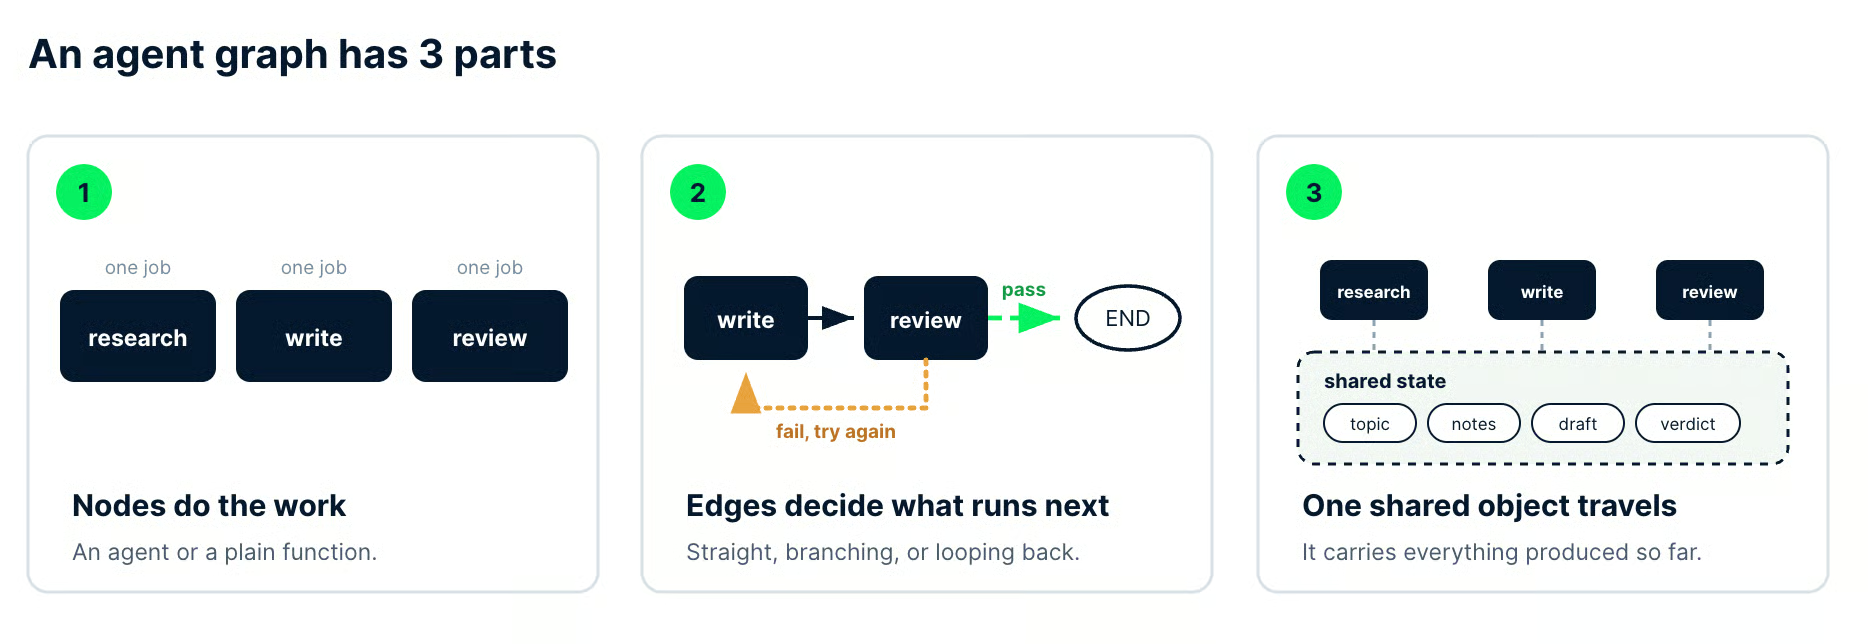
作者制图。稍后我们构建的流水线中展示的 3 个部分:3 个命名节点、一条通过边和一条重试边,以及一个汇集 topic、notes、draft、verdict 的状态对象。
把这三者全部预先声明,而不是让单个智能体自行即兴规划路径,这就是“图工程”所描述的内容。
本教程将使用 Python 与 LangGraph 构建可运行的研究员、写作者、审稿人流水线,并包含一个将失败草稿退回修订的条件边。
您需要 Python、pip,以及对大型语言模型(LLM)或 AI 智能体有一定了解。如果您对智能体还不熟悉,我们的AI 智能体入门课程涵盖本文假定的概念,我们的LangGraph 智能体教程涵盖上手实操。
图工程是在代码中将智能体系统的控制流显式化,而不是把它交给模型自行判断。
您会声明有哪些专业分工者、它们之间允许哪些转移,以及哪些信息会沿着这些转移流动。
智能体依然可以自由推理,但它只在单个节点内推理,而不是贯穿整项工作。
上一句话就是全部区别。
在循环中,您设定目标与质量标准,由智能体自选路径来达成。在图中,您固定路径与检查点,使模型的自主性受限于一个可以在 diff 中读出的结构。
这个标签在 2026 年 7 月于 X 上声量大,但并非始于此。CodiumAI(现 Qodo)的 Itamar Friedman 早在 2024 年 2 月就描述了从“提示工程到流程(/图)工程”的转变,他的团队在AlphaCodium 论文中给出了数据。
在 CodeContests 验证集上,GPT-4 的 pass@5 准确率从使用一个精心设计的提示时的 19%,提升到使用多阶段流程时的 44%。两种设置下每题都是 5 次尝试,并非单次。
2026 年 7 月发生的是“放大”。
7 月 18 日,Peter Steinberger 在X 上发问:“我们还在谈循环,还是已经转向图了?”,这距离 Mike Masson 发布“梯子:提示、上下文、机架、循环、图”的帖子仅一周。该问题获得了 310 万浏览,而它传播的短语当时已在使用中。
反对声很快到来。LangGraph 背后的团队、LangChain 联合创始人 Harrison Chase 质疑这是否“基本上就是 langgraph?”
Dale Everett 则从另一侧发力,认为循环始终是一种单节点图,7 月的热闹是在重发现旧事物。LangChain 自己的回顾文章《与 LangGraph 共度的 3 年图工程》也持类似观点,将智能体图定位为其 3 年来一直在构建的模式。
所以我把这个术语归档为有用的速记。
它给了我们一个共同的名字,来指代那些过去埋在框架文档里的设计问题;当您在拉取请求里争论架构时,有名字就值回票价。
图工程描述的是执行结构,这使它区别于两个借用了其词汇的概念。
知识图与 GraphRAG 描述的是数据。
它们将文档转为实体与关系,便于检索系统遍历事实之间的连接,其工具、存储与评估指标都不同。
关于这个方向,我们的用知识图实现 RAG 应用教程是正确的起点,我们的图论入门覆盖二者之下的数学。
第二个“它不是什么”是:它不是一种新能力。
LangGraph、Google 的 Agent Development Kit(ADK)与 Microsoft AutoGen 都在该标签走红前就已经提供了多智能体编排,所以如果您写过 StateGraph,您早就在这么做了。
许多读者会发现,他们已经用“我的 LangGraph 流水线”这个名字做了一年的图工程。
AI 工程的每一层,都会把控制从模型再向外扩展一步。
阅读下表最实用的方式是看右侧列,它告诉您跳过某一阶、仍试图往上搭建时,究竟会坏在什么地方。
| 层级 | 您能控制什么 | 跳过会坏在哪里 |
|---|---|---|
| 提示 | 请求的措辞 | 模型回答了您未曾提出的问题 |
| 上下文 | 哪些输入能到达模型 | 它会在错误材料上进行良好推理 |
| 机架 | 工具、记忆、文件与 API 访问 | 它无法触及聊天窗口之外的任何东西 |
| 循环 | 重复直到完成的周期 | 它过早停止,或永不停止 |
| 图 | 下一个运行的分工者是谁、运行在什么上 | 一个智能体试图充当 4 个智能体并忘了其中 3 个 |
跳过某一阶是图项目失败的最常见方式,而且失败很少显而易见。
三个不可靠的节点串在一起并不会平均成一个可靠系统。
它会产出一个在更多地方失败、每次失败成本更高、诊断更久的系统,因为现在坏输出距离导致它的节点已经有两次交接之远。
任何智能体图,无论有 3 个节点还是 30 个,都可以分解为节点、边与共享状态。
一旦您能在代码库中说出这三者的名字,大多数编排框架即使不看文档也能看懂。
一个节点是一项具有名称与单一职责的工作单元。
它可以是一个带有专用提示与自有工具的 LLM 调用,也可以是一个普通的 Python 函数,用于查询数据库、校验模式或写入文件。
把模型调用留给需要语义判断的步骤。
如果某条规则有确定答案,就放进 Python 中去,它以微秒级运行、零成本、且两次返回相同结果。
以下是我用于判断是否要拆分的测试:尝试用不含并列连词的一句话描述该节点。
一个节点“拉取来源并决定我们是否足够”已然没通过,因为您无法在不干扰判断部分的情况下替换检索部分。
一条边决定当前节点结束后,接下来运行什么。
四种形态几乎覆盖您将要构建的一切:
边也是您放置停止逻辑的地方。重试上限、质量闸口与升级规则都属于路由决策,把它们放在边函数中意味着您可以在一处审计控制流,而无需在节点体内来回搜寻。
共享状态是一个在运行过程中每个节点都会读取与写入的单个对象。
没有它,您就会有多个智能体在做相邻工作却彼此不传递任何东西,于是写作者看不到研究员找到的内容,审稿人也看不到二者。
在 LangGraph 中,状态通常是一个 TypedDict。
我们的状态累积主题、研究员的笔记、当前草稿、审稿人的判定与反馈,以及修订计数。每个节点仅返回自己修改过的字段,框架会把这些返回合并进运行中的对象。
写入所有权是图最先腐化的地方。
在编码前先决定每个字段由哪个节点负责写入,因为一个可被 3 个不同节点覆盖写入的状态对象,就是您已经给自己排好的一场调试会。
循环工程设计的是单个智能体重复直到完成的周期,图工程设计的是这些周期之间的协调。
这是本文中影响最大的一项决策,所以它在教程之前出现。
默认答案是循环。
一个范围明确、配有严格验证器的单智能体,比任何做同样工作的图都更快构建、更便宜运行、且更易调试。
这不只是我的偏好。
加州大学伯克利分校的一支团队(第一作者 Mert Cemri)从一个观察出发:多智能体相对于单智能体的收益往往很小,随后对来自 7 个多智能体框架的 1600+ 条执行轨迹进行标注,以找出原因(arXiv:2503.13657,v3)。
他们以对其中 150 条轨迹的细读为基础建立了一个分类法,点名 14 种不同的失败模式。
这 14 种模式分成 3 类:系统设计问题、智能体间不一致、以及任务验证。
把第三类记在心里,等我们讲到审稿人节点。
把这些当作触发条件,而不是清单。
右侧列一个清晰的“是”就足够,五个模糊的“不确定”并不算数。
| 关于您任务的问题 | 循环可以处理 | 您需要图 |
|---|---|---|
| 能否用一条指令写出整项工作? | 可以,而且一个人可以从头到尾照做 | 读起来像两个不同角色之间的交接 |
| 每一步都想要同一个模型吗? | 全程一个模型与一套工具 | 收集想要便宜快速,判断想要锋利 |
| 是否有步骤彼此不相依? | 每一步都需要上一步的输出 | 有若干可并发运行的查询 |
| 谁来决定输出是否足够好? | 智能体自审自己的工作 | 必须由未参与撰写的东西签字通过 |
| 当某一步失败时该怎么办? | 重试它然后继续 | 把失败圈定在局部,让其余流程幸存 |
| 是否有人必须审计所走路径? | 追踪仅供您与队友查看 | 外部人员需要看到跑了哪一步,以及原因 |
我最常见到的过度工程甚至与智能体无关。有人需要清洗并地理编码一份包含 800 家酒店地址的名单,它被做成了一个 5 节点图:加载器、归一化、地理编码、验证、写入,且有共享状态贯穿其间。
这些步骤全是确定性的,所以他们实际构建的是一段 40 行的 Python 脚本披着一个框架的外衣,它现在变成按行计费,并以 pandas 从不会的方式出错。
恰到好处的版本就是我们即将构建的那个。
产出一份简短的研究简报会拆成单循环难以胜任的工作:收集原始材料、把它写成文字、然后从外部评判这段文字。
第三步是图存在的理由,因为让一个智能体审自己的草稿不叫审稿。
三件事可以为一个节点正名。
如果您无法为每个新增节点指出其中之一,就删除该节点,把它的工作并回邻居。
首先是真正的专业分工。
我们的研究员需要便宜、快速的模型,以及在生产环境中的搜索工具。写作者不需要这些,反而受益于更强的模型,因此这种拆分确实在“干活”,而非只是装点图表。
其次,是您确实能感受到的并行性。
当分支彼此独立且墙钟时间的节省对某人有意义时,扇出才值得;若两者都不满足,它只会让复杂度平白增加。
第三,也是我最坚定捍卫的一点,独立验证。
让智能体给自己的作业打分会打得很宽厚,因此一个对草稿只有只读访问权的独立审稿节点,通常是任何图中最有价值的节点。
若想在框架层面了解不同库如何表达这些模式,我们对CrewAI、LangGraph 与 AutoGen 的比较梳理了权衡取舍。
我们将构建一个包含研究员、写作者与审稿人的 LangGraph 多智能体流水线,产出一份简短的研究简报,并将未通过的草稿退回修订。
LangGraph 是一个用于有状态智能体的低层编排框架,它的 StateGraph 与上一节的节点、边与状态几乎一一对应。
以下内容已在 2026 年 9 月对 langgraph 1.2.11 与 langchain-anthropic 1.7.1 进行验证。
如果您对该库还不熟悉,我们的LangGraph 教程涵盖基础知识。本节推进较快,我们的LangChain vs LangGraph vs LangSmith vs LangFlow指南可帮助您厘清这个家族各自负责什么。
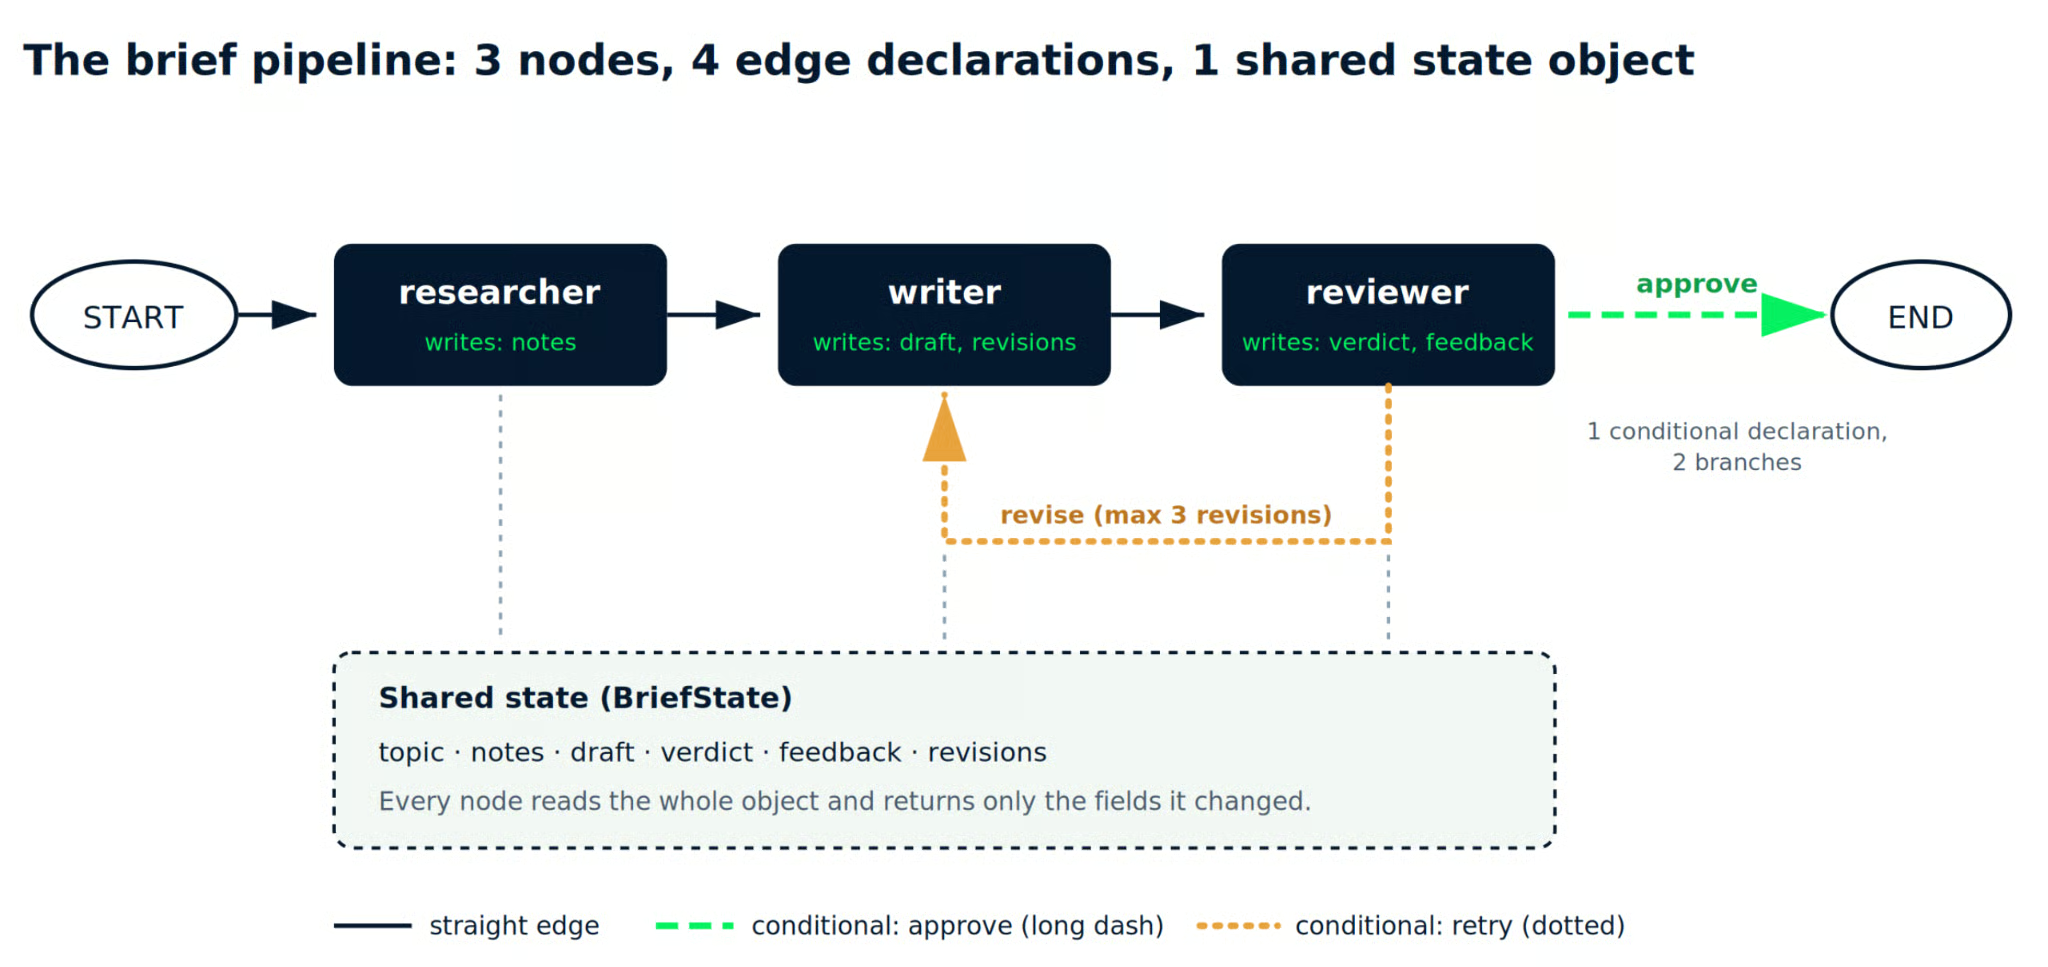
作者制图。我们即将构建的流水线。实线是 3 条直连边;虚线与点线是单个条件边的两条分支。
安装这些包,另加 python-dotenv,让您的密钥不出现在源码中:
pip install langgraph langchain-anthropic python-dotenv在脚本旁创建一个 .env 文件:
ANTHROPIC_API_KEY=sk-ant-your-key-here接下来是导入与状态模式。先写 TypedDict 值得花这 2 分钟,因为它是每个节点都要遵守的契约:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
两个模型,而非一个。这是决策表里“每步使用不同模型”的触发条件在真实代码中的体现,因为研究是高量低判断的工作,不需要昂贵模型。
MAX_REVISIONS 在这里发挥着不张扬却重要的作用。
没有上限,一个严格的审稿人与一个固执的写作者会把草稿来回传递,直到您的账单变得“有趣”。
每个节点都遵循相同的契约。它接收当前状态,完成自己的唯一职责,并返回一个仅包含其修改字段的字典。
研究员收集原始材料并写入 notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
生产版本会调用搜索工具,而不是依赖模型自身的知识。
我把它保持为一次 .invoke() 调用,以便图结构保持清晰,所以把它产出的笔记视为未验证的材料。
写作者读取这些笔记并产出草稿。它也会检查审稿反馈,为重试边提供可作用的依据:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
审稿人对草稿打分。
它没有看到写作者的推理,也没有产出任何文本,所以它可以对结果直言不讳。
这正是伯克利分类法中的第三类失败,单独给了一个节点。
当没有独立检查输出的环节时,任务验证就会失灵,因此修复方式是一个无法给自己作业打分的工人:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
注意三个节点都用的是 .text 而非 .content。
两者在简单回复时都会返回字符串,但当响应以多个内容块到达时,.text 也能正确处理,这能避免之后让人困惑的 AttributeError: 'list' object has no attribute 'strip'。
从第一行解析判定让代码保持可读,但也脆弱。
任何无人值守运行的场景,都应把这个字符串检查换成 LangChain 的结构化输出,让判定作为一个类型化字段返回,而不是一个您指望模型会遵守的前缀。
路由函数就是条件边。它读取审稿人运行后的状态,并返回接下来应发生之事的名称:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
让这个函数保持沉默。在其中放一个 print() 会在流式循环仍在打印上一个分块时把输出写到 stdout,于是上限提示会提前一拍出现,使追踪看起来乱序。
修订上限放在这里而不是节点内,因为停止是一个控制流决策,而控制流属于边。
现在组装图。先节点,再边,最后编译:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
.add_conditional_edges() 的第三个参数是路径映射。
它列出路由函数可能返回的每个目的地,LangGraph 用它来在任何节点运行前就绘出分支。
用初始状态调用已编译的图。只有 topic 与 revisions 需要赋值,因为其余字段会在执行流转中被填充:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
这会给您最终状态,而别无他物。运行偏离正轨时帮助不大。
把 .invoke() 换成 .stream() 并设 stream_mode="updates",即可观看每个节点报告它写入了什么。每次调用都是一次独立运行并伴随各自的模型调用,所以二者择一,而不是都跑:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
在审稿人否决初稿的一次运行中,会打印如下内容:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
有两点是最终状态所隐藏、而这里可见的。
研究员只运行了一次,它的笔记贯穿两次写作都保留下来,因此重试不会重新研究。每个节点也只触碰了自己的字段,把先前的写入所有权规则变成了可以核验的事实。
在这里顺便数数调用次数。
这条被否决的路径需要 5 次模型调用,而做相同任务的单循环版本大致只需 1 次;多出来的 4 次是否带来价值,唯有记录判定并读它们才能知道。
无需额外工具即可看到您构建之物的形状:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Mermaid 输出会把条件分支渲染为从 reviewer 分别指向 __end__ 与回到 writer 的虚线。
这能在您为模型调用花钱之前确认重试边确实存在。ASCII 视图只会画出从开始到结束的直线路径,想看循环时请用 Mermaid 输出。
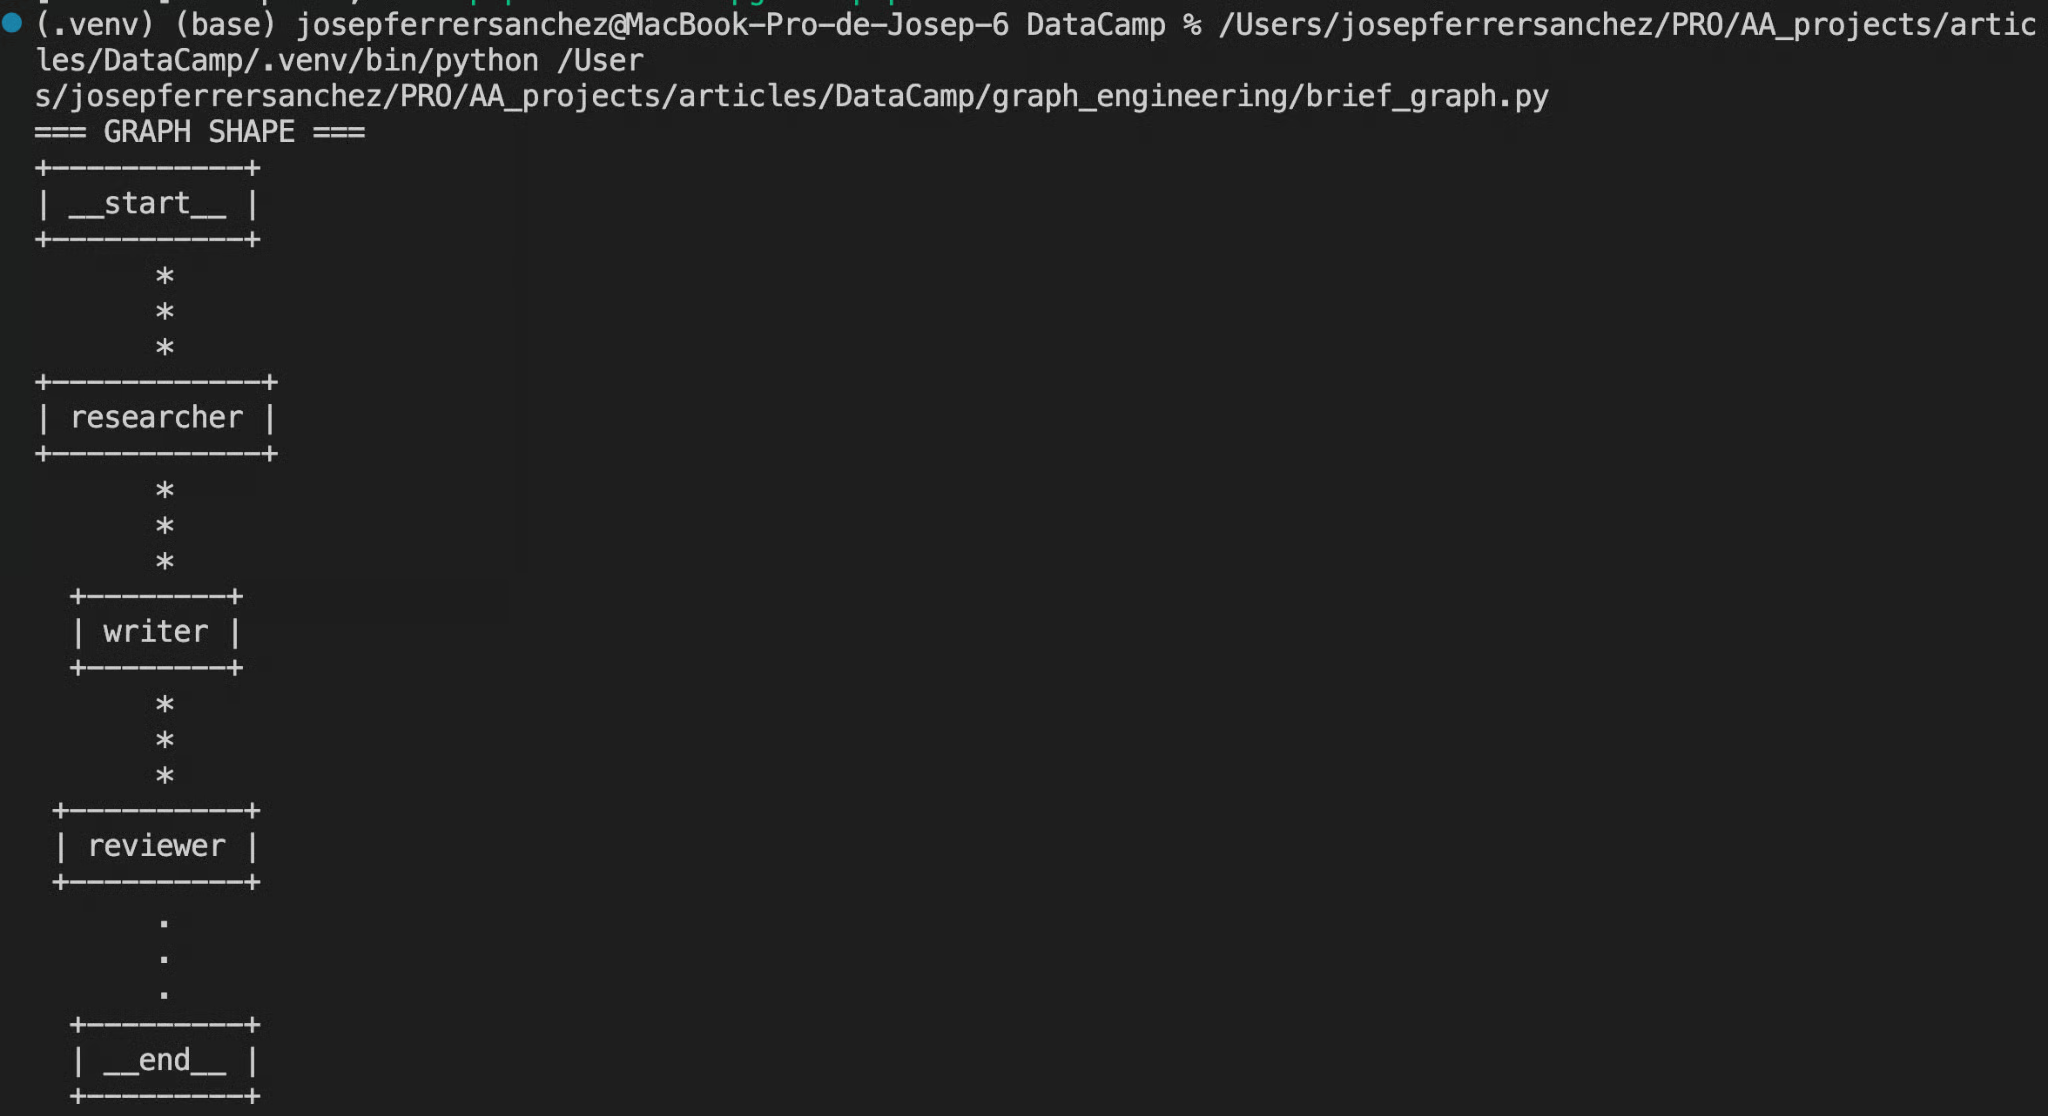
作者截图。终端展示 .draw_ascii() 输出,__start__、researcher、writer、reviewer、__end__ 自上而下相连。
若需逐步调试并在每个节点检查状态,LangGraph Studio 可连接本地服务器。这需要单独的包与配置文件,所以先 pip install "langgraph-cli[inmem]",添加一个指向已编译 graph 对象的 langgraph.json,然后运行 langgraph dev 并打开其打印的 Studio URL。
我们的LangGraph Studio 指南讲解界面(它写于 2024 年,安装步骤请与上述命令比对),我们的LangGraph 智能体教程涵盖为类似研究员的节点添加真实工具。
有个范围限定说明。
本流水线是顺序式的,因此未演示扇出——即研究员同时查询多个来源、并由一个汇合节点合并结果的模式。
那是自然而然的下一步扩展,也是成本增长最快的地方。
在智能体 AI 的图工程中,失败模式常见到足以命名。以下三点是我在上线前必查的。
每个节点本身都是一个循环,带有提示、工具与完成定义。
把 3 个摇摇欲坠的节点串在一起,只会得到一个表面积变成三倍、调试体验更糟的摇摆系统。
先让一个节点单独工作起来。
一个直接调用时返回空泛笔记的研究员,在图内也会返回空泛笔记,而下游写作者会自信地在此之上构建。
当逻辑属于边时,克制把它塞进节点的冲动。
停止条件、分支决策、重试上限都是路由,而路由应放在边函数中,这样您可以一次性读全。
应用先前的“无并列连词”测试。
一个既搜索来源又决定是否足够的节点,其实是共用一个函数签名的两个节点。
扇出与重试循环会以图表完全隐藏的方式成倍放大 Token 使用量。
一个 5 路扇出、接入一个带 3 次重试上限的汇合节点,并不是 5 次调用;取决于重试放在哪里,可能在计入汇合前就已达到 15 次甚至更多。
像我们用 MAX_REVISIONS 那样明确设置上限。然后记录每个节点的 Token 用量并在一周后查看,因为您原以为便宜的节点通常是运行最频繁的那个。
AutoGen 仍会被推荐用于图式编排,它的实验性 GraphFlow 工作确实是先驱,但仓库在 2026 年 9 月起进入维护模式,不再新增功能。
Microsoft 引导新用户转向Microsoft Agent Framework,它也有自己的基于图的工作流,并提供了迁移指南。
从今天开始,LangGraph、Google 的 ADK 或 Microsoft Agent Framework 是更稳妥的选择,我们的用 Google ADK 构建 AI 智能体课程对 ADK 有深入介绍。
图工程是位于循环工程之上的协调层。
节点负责干活,边决定下步运行,共享对象在它们之间承载信息。
剥离 2026 年 7 月时间线的噪音,模型就是这些。
我们的流水线有意保持小巧:3 个节点、4 条边声明(其中 1 条为条件边,所以画出 2 个分支),并设置修订上限,以免重试失控。
这点结构足以让一个未参与撰写的实体对草稿进行审阅,而这正是循环无法提供的单一特性。
当工作拆分为需要不同专长的阶段时再去用图,且不要早一个节点。怀疑者关于“机制早已陈旧、围绕该术语的写作大多是噪音”的观点是对的。
他们也说对了另一个对周二下午很重要的点。
把一个薄弱的验证器附在一个本就适合循环的问题上,并不会因为您画了更多盒子而改进。
若想把这些模式走得更远,我们的LangGraph 多智能体系统课程涵盖本教程未涉及的监督者与网络型设计。
若转向数据侧,用 LangChain 与 Neo4j 实现 Graph RAG是不错的下一步。若继续停留在编排侧,基于 MongoDB 与 LangGraph 的文本转查询智能体在实时数据库上构建 LangGraph 流水线,LLM 智能体详解补齐其底层架构。
完整脚本见我的 GitHub 仓库,其中包含图渲染辅助与每次运行成本的简短说明。
DataCamp 精品课程
Courses
Courses
Courses