
Cursus
Multi-agent systemen met LangGraph
2 Hr 45 Min
8.6K
Geef een agent één taak en het gaat prima. Geef er drie en kijk wat er rond de tweede overdracht gebeurt: hij vergeet wat hij in stap één vond, beoordeelt zijn eigen concept royaal en roept succes uit terwijl de output onafgemaakt blijft liggen.
Die discussie liep halverwege juli 2026 hoog op, toen "graph engineering" X (voorheen Twitter) bereikte en de tijdlijn zich meteen splitste tussen mensen die de dood van de agent-loop aankondigden en mensen die de term wegzetten als contentfarm-vulling.
Mijn mening: het label graph engineering is optioneel, de onderliggende verschuiving niet. Dat probeer ik te onderbouwen voordat we ook maar één regel code schrijven.
Het meeste wat je deze maand bouwt, hoort nog steeds één enkele loop te zijn, en de snelste manier om een week te verspillen is een schema tekenen met 6 blokken voor een klus die er 1 nodig had.
Een agentgrafiek heeft 3 onderdelen:
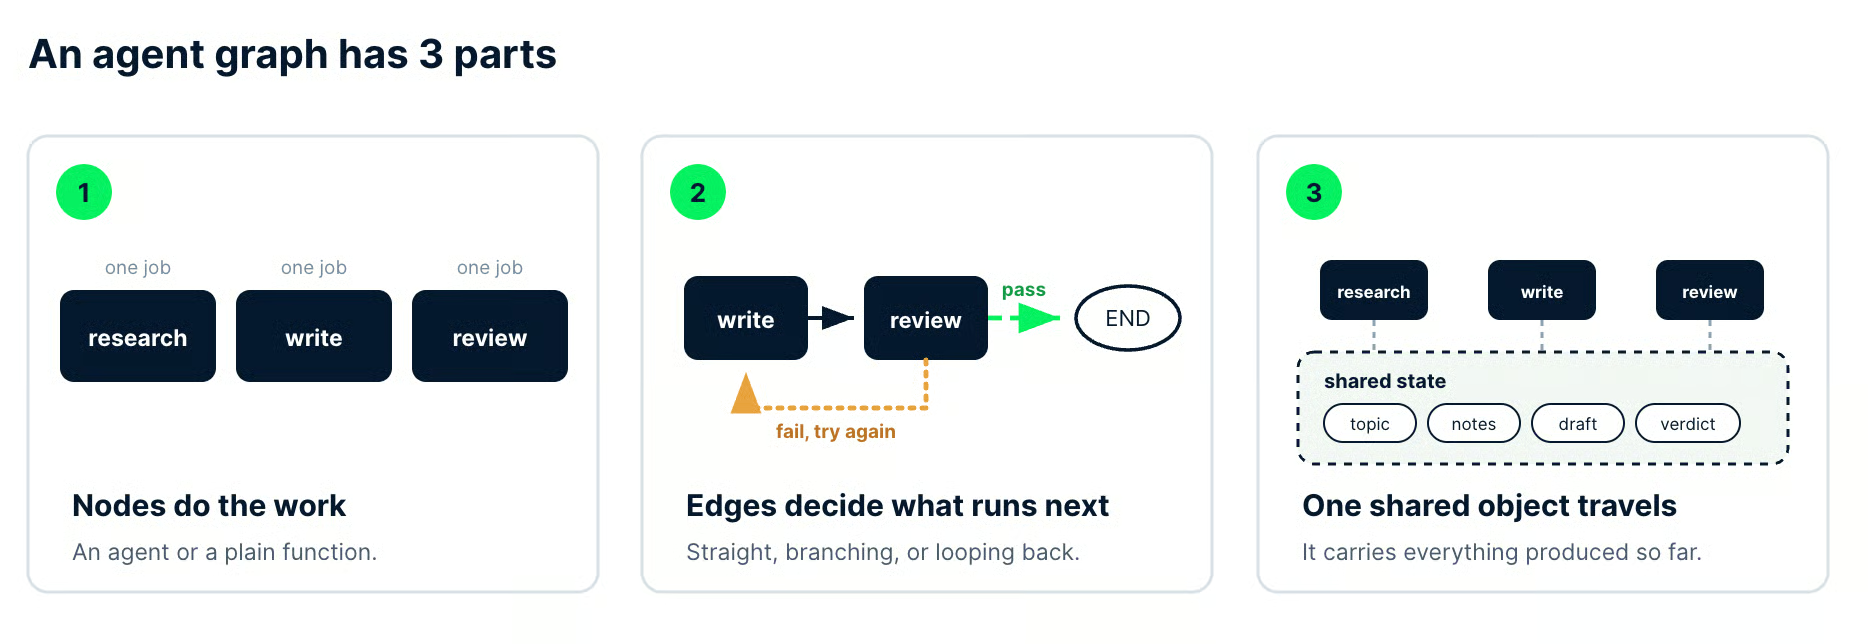
Afbeelding door de auteur. De 3 onderdelen op de pijplijn die we later bouwen: 3 benoemde nodes, een pass-edge en een retry-edge, en één state-object dat topic, notes, draft en verdict verzamelt.
Alle 3 vooraf declareren, in plaats van één agent zijn eigen pad te laten improviseren, is waar de term graph engineering voor staat.
Deze tutorial bouwt een werkende pijplijn met onderzoeker, schrijver en beoordelaar in Python met LangGraph, inclusief een conditionele edge die afgekeurde concepten terugstuurt voor revisie.
Je hebt Python, pip en enige bekendheid met large language models (LLM's) of AI-agents nodig. Als agents nieuw voor je zijn, behandelt onze cursus Introduction to AI Agents de concepten die dit artikel veronderstelt, en onze LangGraph-agents-tutorial de praktijk.
Graph engineering is de praktijk om de control flow van een agentsysteem expliciet in code vast te leggen in plaats van die aan het oordeel van het model over te laten.
Je declareert welke gespecialiseerde workers er zijn, welke overgangen daartussen zijn toegestaan en welke informatie over die overgangen wordt doorgegeven.
De agent redeneert nog steeds vrij, maar wel binnen één node in plaats van over de hele klus heen.
Die laatste zin is het hele onderscheid.
In een loop stel je een doel en een kwaliteitsdrempel, en kiest de agent zijn eigen route om die te halen. In een grafiek leg je de route en de checkpoints vast, zodat de autonomie van het model wordt ingekaderd door een structuur die je in een diff kunt lezen.
Het label werd luid op X in juli 2026, maar begon niet daar. Itamar Friedman van CodiumAI (nu Qodo) beschreef al in februari 2024 een verschuiving "van prompt engineering naar flow (/graph) engineering", en het AlphaCodium-paper van zijn team zette er cijfers op.
De pass@5-accuratesse van GPT-4 op de CodeContests-validatieset ging van 19% met één goed ontworpen prompt naar 44% met een multi-stage flow. Dat zijn in beide gevallen 5 pogingen per probleem, niet single-shot.
Wat er in juli 2026 gebeurde, was versterking.
Op 18 juli vroeg Peter Steinberger op X: "Hebben we het nog over loops of zijn we al naar graphs verschoven?", 1 week nadat Mike Masson de ladder postte: prompt, context, harness, loop, graph. De vraag trok 3,1 miljoen views, en de uitdrukking die hij verspreidde was al in gebruik.
De tegenreactie kwam snel. Harrison Chase, LangChain-medeoprichter van het team achter LangGraph, vroeg of het hele ding "in feite gewoon langgraph" was.
Dale Everett duwde vanaf de andere kant en stelde dat een loop altijd al een one-node graph was, dus dat de opwinding in juli oud terrein herontdekte. LangChains eigen terugblik, 3 Years of Graph Engineering with LangGraph, zit op dezelfde lijn en framed agentgraphs als een patroon waar het al 3 jaar aan bouwt.
Dus ik zet de term weg als nuttige shorthand.
Wat het ons gaf, is een gedeelde naam voor ontwerpvragen die vroeger weggestopt zaten in frameworkdocumentatie, en een naam bewijst zijn nut als je in een pull request over architectuur discussieert.
Graph engineering beschrijft de uitvoeringsstructuur, en staat daarmee los van twee dingen die zijn vocabulaire lenen.
Knowledge graphs en GraphRAG beschrijven data.
Ze zetten documenten om in entiteiten en relaties zodat een retrievalsysteem de verbindingen tussen feiten kan volgen, en tooling, opslag en evaluatiemetrics verschillen allemaal.
Voor die kant van het woord is onze tutorial over een knowledge graph gebruiken om een RAG-applicatie te bouwen het juiste startpunt, met onze introductie in grafentheorie voor de wiskunde die onder beide ligt.
Het tweede wat het niet is: een nieuwe capability.
LangGraph, Google's Agent Development Kit (ADK) en Microsoft AutoGen leverden al multi-agentorkestratie voordat het label viraal ging, dus als je een StateGraph hebt geschreven, deed je dit al.
Veel lezers zullen merken dat ze al een jaar aan graph engineering doen onder de naam "mijn LangGraph-pijplijn".
Elke laag van AI-engineering neemt de controle over iets één stap verder weg van het model.
De nuttige manier om deze tabel te lezen is de kolom rechts, die vertelt wat er misgaat als je een trede overslaat en er toch op probeert voort te bouwen.
| Laag | Wat je beheerst | Wat er breekt als je het overslaat |
|---|---|---|
| Prompt | De bewoording van het verzoek | Het model beantwoordt een vraag die je niet stelde |
| Context | Welke inputs het model bereiken | Het redeneert goed over het verkeerde materiaal |
| Harness | Tools, geheugen, bestands- en API-toegang | Het kan niets aanraken buiten het chatvenster |
| Loop | De herhaal-tot-klaar-cyclus | Het stopt te vroeg, of het stopt nooit |
| Graph | Welke worker hierna draait, en waarop | Eén agent probeert 4 agents te zijn en vergeet er 3 |
Een trede overslaan is de meest voorkomende manier waarop graphprojecten falen, en die fout is zelden duidelijk.
Drie onbetrouwbare nodes aan elkaar knopen middelt niet uit tot een betrouwbaar systeem.
Ze leveren een systeem dat op meer plekken faalt, per fout meer kost en langer duurt om te diagnosticeren, omdat de slechte output nu 2 overdrachten verwijderd is van de node die het veroorzaakte.
Elke agentgrafiek, of die nu 3 nodes heeft of 30, valt uiteen in nodes, edges en gedeelde state.
Als je die 3 onderdelen in een codebase kunt benoemen, worden de meeste orkestratiekaders leesbaar zonder hun documentatie.
Een node is één werkeenheid met een naam en één verantwoordelijkheid.
Het kan een LLM-call zijn met een gespecialiseerde prompt en eigen tools, of een gewone Python-functie die een database bevraagt, een schema valideert of een bestand schrijft.
Bewaar de model-calls voor stappen die semantisch oordeel nodig hebben.
Als een regel een bekend antwoord heeft, zet het in Python, waar het in microseconden draait, niets kost en twee keer hetzelfde resultaat geeft.
Dit is de test die ik gebruik om te bepalen of iets gesplitst moet worden: probeer de node in één zin zonder voegwoord te beschrijven.
Een node die "de bronnen ophaalt en beslist of we er genoeg hebben" is al gezakt, want je kunt de retrievalhelft niet vervangen zonder de oordeelhelft te verstoren.
Een edge bepaalt wat er draait nadat de huidige node klaar is.
Vier vormen dekken bijna alles wat je bouwt:
Edges zijn ook waar je stoplogica hoort. Retry-limieten, kwaliteitspoorten en escalatieregels zijn allemaal routeringsbeslissingen, en ze in de edgefuncties houden betekent dat je de control flow op één plek kunt auditen in plaats van te moeten zoeken in node-bodies.
Gedeelde state is het ene object waaruit elke node leest en waarin elke node schrijft terwijl de run vordert.
Zonder dat heb je meerdere agents die naast elkaar werken en elkaar niets doorgeven, dus de schrijver ziet niet wat de onderzoeker vond en de reviewer ziet geen van beide.
In LangGraph is de state meestal een TypedDict.
De onze stapelt het topic, de notities van de onderzoeker, de huidige draft, het oordeel en de feedback van de reviewer en een revisieteller. Elke node retourneert alleen de velden die hij wijzigde, en het framework voegt die terug samen in het lopende object.
Schrijf-eigenaarschap is waar grafieken het eerst vervallen.
Bepaal vóór je codeert welke node welk veld mag schrijven, want een state-object dat 3 verschillende nodes kunnen overschrijven, is een debugsessie die je al voor jezelf hebt ingepland.
Loop engineering ontwerpt de cyclus die één agent herhaalt tot hij klaar is, en graph engineering ontwerpt de coördinatie tussen meerdere van die cycli.
Dit is de meest doorslaggevende keuze in het artikel, dus die komt vóór de tutorial.
Het standaardantwoord is de loop.
Één goed afgebakende agent met een strikte verifier is sneller te bouwen, goedkoper te draaien en veel eenvoudiger te debuggen dan welke grafiek dan ook die hetzelfde werk doet.
Dat is niet alleen mijn voorkeur.
Een team van UC Berkeley (eerste auteur Mert Cemri) vertrekt vanuit de observatie dat multi-agentwinsten ten opzichte van single-agentopstellingen vaak minimaal zijn, en annoteert vervolgens 1.600+ execution traces uit 7 multi-agentframeworks om te achterhalen waarom (arXiv:2503.13657, v3).
Hun taxonomie, gebouwd op een close reading van 150 van die traces, benoemt 14 verschillende faalmodi.
Die 14 modi vallen uiteen in 3 categorieën: systeemontwerp, misalignment tussen agents en taakverificatie.
Bewaar die derde tot we bij de reviewernode zijn.
Zie dit als triggers, geen checklist.
Eén duidelijke ja in de rechterkolom is genoeg, en 5 vage niet.
| Vraag over je taak | Een loop kan het aan | Je wilt een grafiek |
|---|---|---|
| Kun je de klus als één instructie opschrijven? | Ja, en een mens kan die van begin tot eind volgen | Het leest als een overdracht tussen 2 verschillende rollen |
| Wil elke stap hetzelfde model? | Eén model en één set tools overal | Verzamelen wil goedkoop en snel, beoordelen wil scherp |
| Zijn er stappen die niet van elkaar afhangen? | Elke stap heeft de output van de vorige nodig | Meerdere lookups die allemaal tegelijk kunnen draaien |
| Wie beslist dat de output goed genoeg is? | De agent leest zijn eigen werk na | Iets dat het niet schreef, moet tekenen |
| Wat moet er gebeuren als een stap faalt? | Opnieuw proberen en verdergaan | De fout isoleren zodat de rest van de run overleeft |
| Moet iemand het gevolgde pad kunnen auditen? | De trace is voor jou en je teamgenoten | Iemand van buiten moet zien welke stap draaide, en waarom |
De meest overge-engineerde versie die ik tegenkom, gaat niet eens over agents. Iemand moet een lijst van 800 hoteladressen schonen en geocoderen, en die komt binnen als een 5-nodegrafiek: een loadernode, een normalizer, een geocoder, een validator en een writer, met gedeelde state ertussen.
Al die stappen zijn deterministisch, dus wat ze eigenlijk bouwden is een Python-script van 40 regels in een frameworkjasje, en het kost nu geld per rij en faalt op manieren die pandas nooit zou doen.
De juiste maat is de versie die we nu gaan bouwen.
Een korte researched brief produceren valt uiteen in werk waar één enkele loop mee worstelt: ruwe input verzamelen, die in proza gieten en dat proza van buitenaf beoordelen.
Die derde stap is de reden dat de grafiek bestaat, want een agent die zijn eigen concept beoordeelt, beoordeelt niet.
Drie dingen rechtvaardigen een node.
Als je niet naar één ervan kunt wijzen voor elke node die je toevoegde, verwijder de node en vouw het werk in een buurman.
Echte specialisatie komt eerst.
Onze onderzoeker wil een goedkoop, snel model en, in productie, search-tools. De schrijver wil geen van beide en profiteert van een sterker model, dus de splitsing doet werk in plaats van een diagram te versieren.
Ten tweede, parallelisme dat je echt gaat merken.
Fan-out loont als takken onafhankelijk zijn en de wall-clockwinst voor iemand uitmaakt, en kost je extra complexiteit als geen van beide waar is.
Ten derde, en dit is degene die ik het hardst zou verdedigen, onafhankelijke verificatie.
Een agent die zijn eigen huiswerk nakijkt, is mild, dus een aparte reviewernode met alleen-lezen toegang tot de draft is meestal de waardevolste node in elke grafiek.
Voor een frameworkbrede kijk op hoe verschillende bibliotheken deze patronen uitdrukken, zet onze vergelijking CrewAI vs LangGraph vs AutoGen de trade-offs uiteen.
We bouwen een LangGraph-multi-agentpijplijn met een onderzoeker, een schrijver en een beoordelaar die een korte researched brief oplevert en afgekeurde concepten terugstuurt voor revisie.
LangGraph is een low-level orkestratiekader voor stateful agents, en zijn StateGraph komt bijna één-op-één overeen met de nodes, edges en state uit de vorige sectie.
Alles hieronder is gecontroleerd tegen langgraph 1.2.11 en langchain-anthropic 1.7.1 in september 2026.
Als de bibliotheek nieuw voor je is, behandelt onze LangGraph-tutorial de basis. Deze sectie gaat snel, en onze gids LangChain vs LangGraph vs LangSmith vs LangFlow zet uiteen welk onderdeel in die familie wat doet.
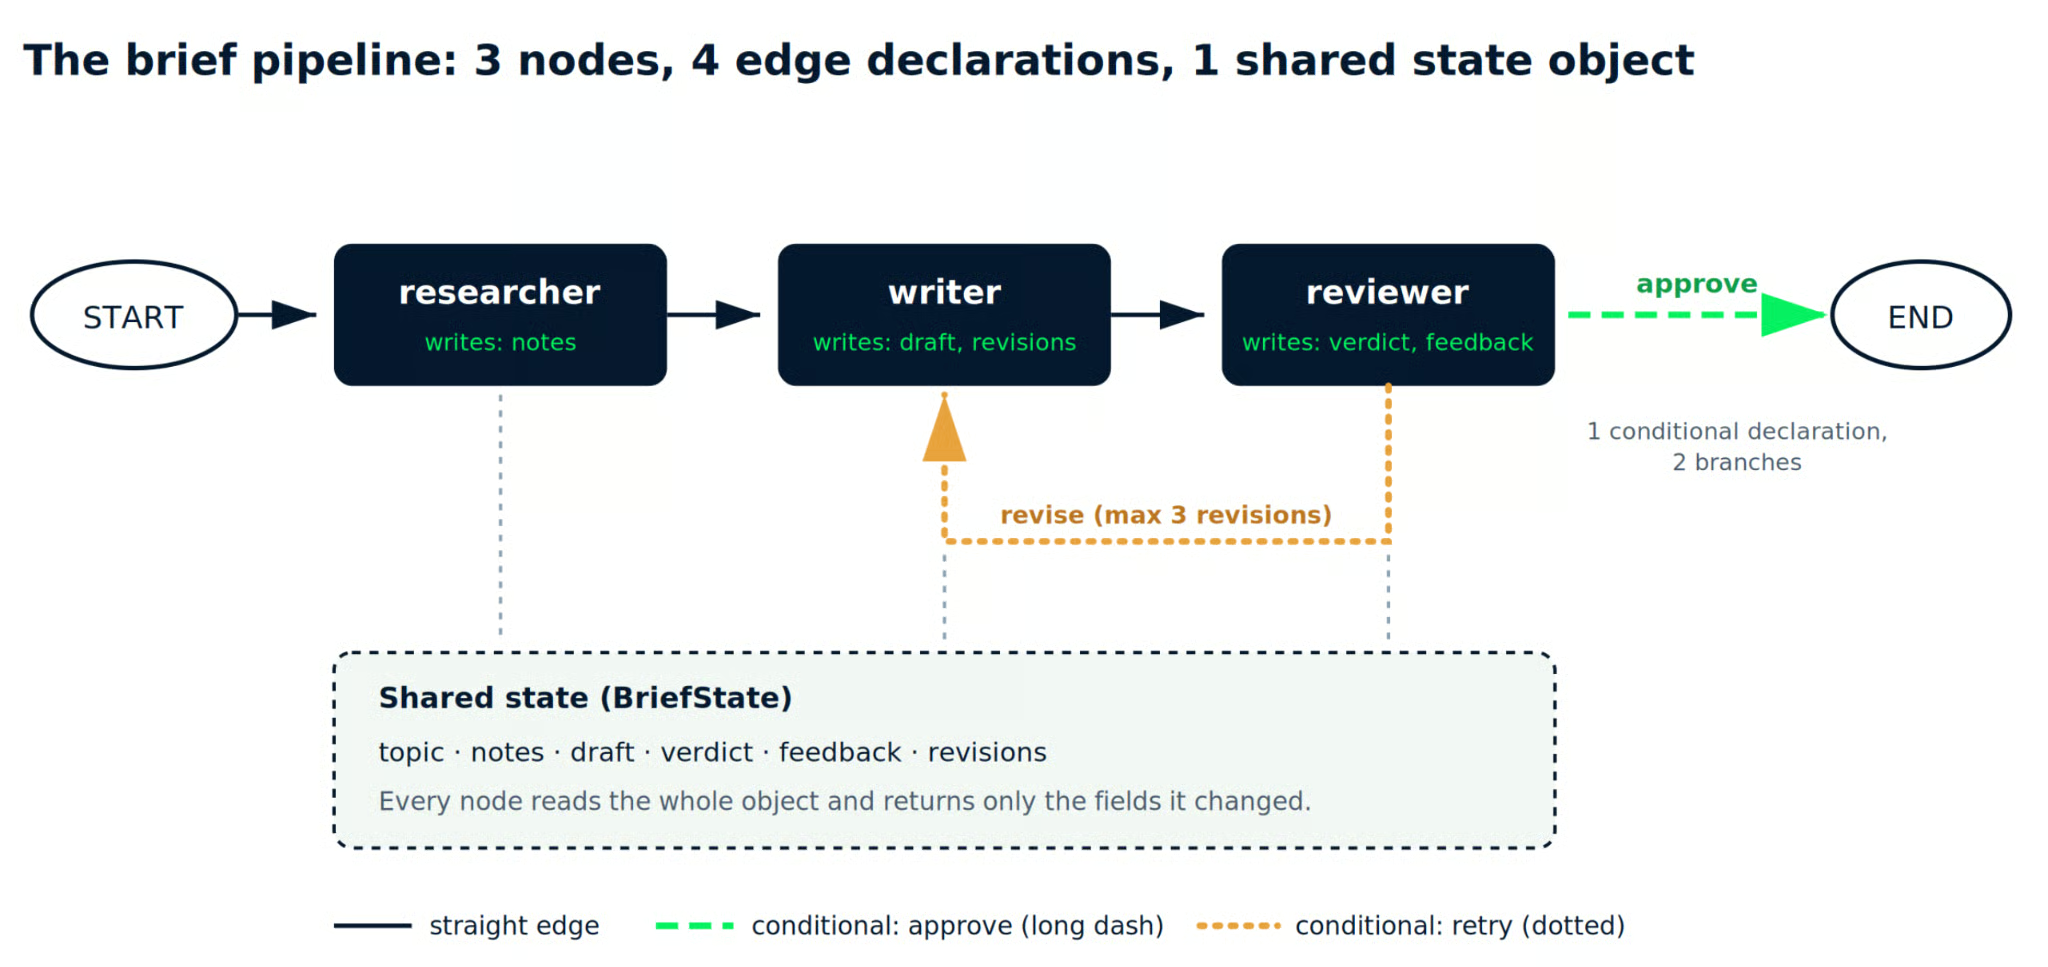
Afbeelding door de auteur. De pijplijn die we zo gaan bouwen. Doorgetrokken lijnen zijn de 3 rechte edges; de gestreepte en gestippelde lijnen zijn de 2 takken van één conditionele edge.
Installeer de packages, plus python-dotenv zodat je key uit de bron blijft:
pip install langgraph langchain-anthropic python-dotenvMaak een .env-bestand naast je script:
ANTHROPIC_API_KEY=sk-ant-your-key-hereNu de imports en het stateschema. De TypedDict eerst schrijven is die 2 minuten waard, want het is het contract waar elke node mee instemt:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Twee modellen, niet één. Dat is de trigger "ander model per stap" uit de beslijstabel, nu in echte code, omdat research hoogvolume en lage-oordeel is en geen duur model nodig heeft.
MAX_REVISIONS doet hier stil maar belangrijk werk.
Zonder limiet sturen een strikte reviewer en een koppige schrijver een concept heen en weer tot je factuur interessant wordt.
Elke node volgt hetzelfde contract. Hij ontvangt de huidige state, doet zijn ene taak en retourneert een dictionary met alleen de velden die hij wijzigde.
De onderzoeker verzamelt ruwe input en schrijft die naar notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
Een productieversie van deze node zou een search-tool aanroepen in plaats van te vertrouwen op de eigen kennis van het model.
Ik hield het bij één .invoke()-call zodat de grafiekstructuur zichtbaar blijft; behandel de notities die hij produceert dus als ongeverifieerd.
De schrijver leest die notities en produceert een concept. Hij kijkt ook of er reviewerfeedback is, wat de retry-edge iets geeft om op te reageren:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
De reviewer beoordeelt het concept.
Hij zag het redeneren van de schrijver niet en produceerde geen van de tekst, dus hij kan bot zijn over het resultaat.
Dit is de derde faalcategorie uit de Berkeley-taxonomie, als eigen node gegeven.
Taakverificatie gaat mis als niets onafhankelijk de output checkt, dus de fix is een worker die zijn eigen huiswerk niet kan nakijken:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Let op .text in plaats van .content op alle drie de nodes.
Beide geven een string terug voor een simpel antwoord, maar .text doet ook het juiste wanneer een response binnenkomt als meerdere contentblokken, wat je later een verwarrende AttributeError: 'list' object has no attribute 'strip' bespaart.
Het oordeel van de eerste regel parsen houdt dit leesbaar, en het is fragiel.
Voor iets dat onbemand draait, ruil je die stringcheck in voor LangChains structured output, zodat het oordeel terugkomt als een getypt veld in plaats van een prefix waarvan je hoopte dat het model die zou respecteren.
De routeringsfunctie is de conditionele edge. Hij leest de state nadat de reviewer draaide en retourneert de naam van wat er hierna moet gebeuren:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Hou die functie stil. Een print() erin belandt op stdout terwijl de streamloop nog de vorige chunk print, dus de limietmelding verschijnt een stap te vroeg en de trace lijkt uit volgorde.
De revisielimiet hoort hier en niet in een node, omdat stoppen een control-flowbeslissing is en control flow op de edges hoort.
Nu de grafiek samenstellen. Nodes, dan edges, dan compileren:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Dat derde argument aan .add_conditional_edges() is de padmap.
Die somt elke bestemming op die de routeringsfunctie kan retourneren, en LangGraph gebruikt die om de aftakking te tekenen voordat er ook maar één node heeft gedraaid.
Roep de gecompileerde grafiek aan met een initiële state. Alleen topic en revisions hebben waarden nodig, want de andere velden worden ingevuld terwijl de uitvoering doorstroomt:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Dat geeft je de eindstate en verder niets. Niet erg behulpzaam als een run de verkeerde kant op gaat.
Vervang .invoke() door .stream() met stream_mode="updates" om elke node te zien rapporteren wat hij schreef. Elke call is een aparte run met eigen model-calls, dus gebruik de één of de ander en draai ze niet allebei:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Bij een run waar de reviewer het eerste concept afwijst, print dat het volgende:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Twee dingen zijn daar zichtbaar die de eindstate verbergt.
De onderzoeker draaide één keer, en zijn notities bleven behouden door beide schrijfrondes heen, dus een retry doet geen her-research. Ook raakte elke node alleen zijn eigen velden, waardoor de schrijf-eigenaarschapsregel van eerder iets wordt dat je kunt verifiëren.
Tel hier meteen de calls.
Dat afgewezen pad kost 5 model-calls tegenover grofweg 1 voor een single-loopversie van dezelfde taak, en de enige manier om te weten of die extra 4 je iets opleverden, is de oordelen loggen en lezen.
Je hebt geen extra tooling nodig om de vorm te zien van wat je bouwde:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
De Mermaid-output tekent de conditionele aftakking als gestreepte lijnen van reviewer naar zowel __end__ als terug naar writer.
Dat bevestigt dat je retry-edge bestaat voordat je iets aan model-calls uitgeeft. De ASCII-weergave tekent alleen het rechte pad van start naar eind, dus gebruik de Mermaid-output als je de loop wilt zien.
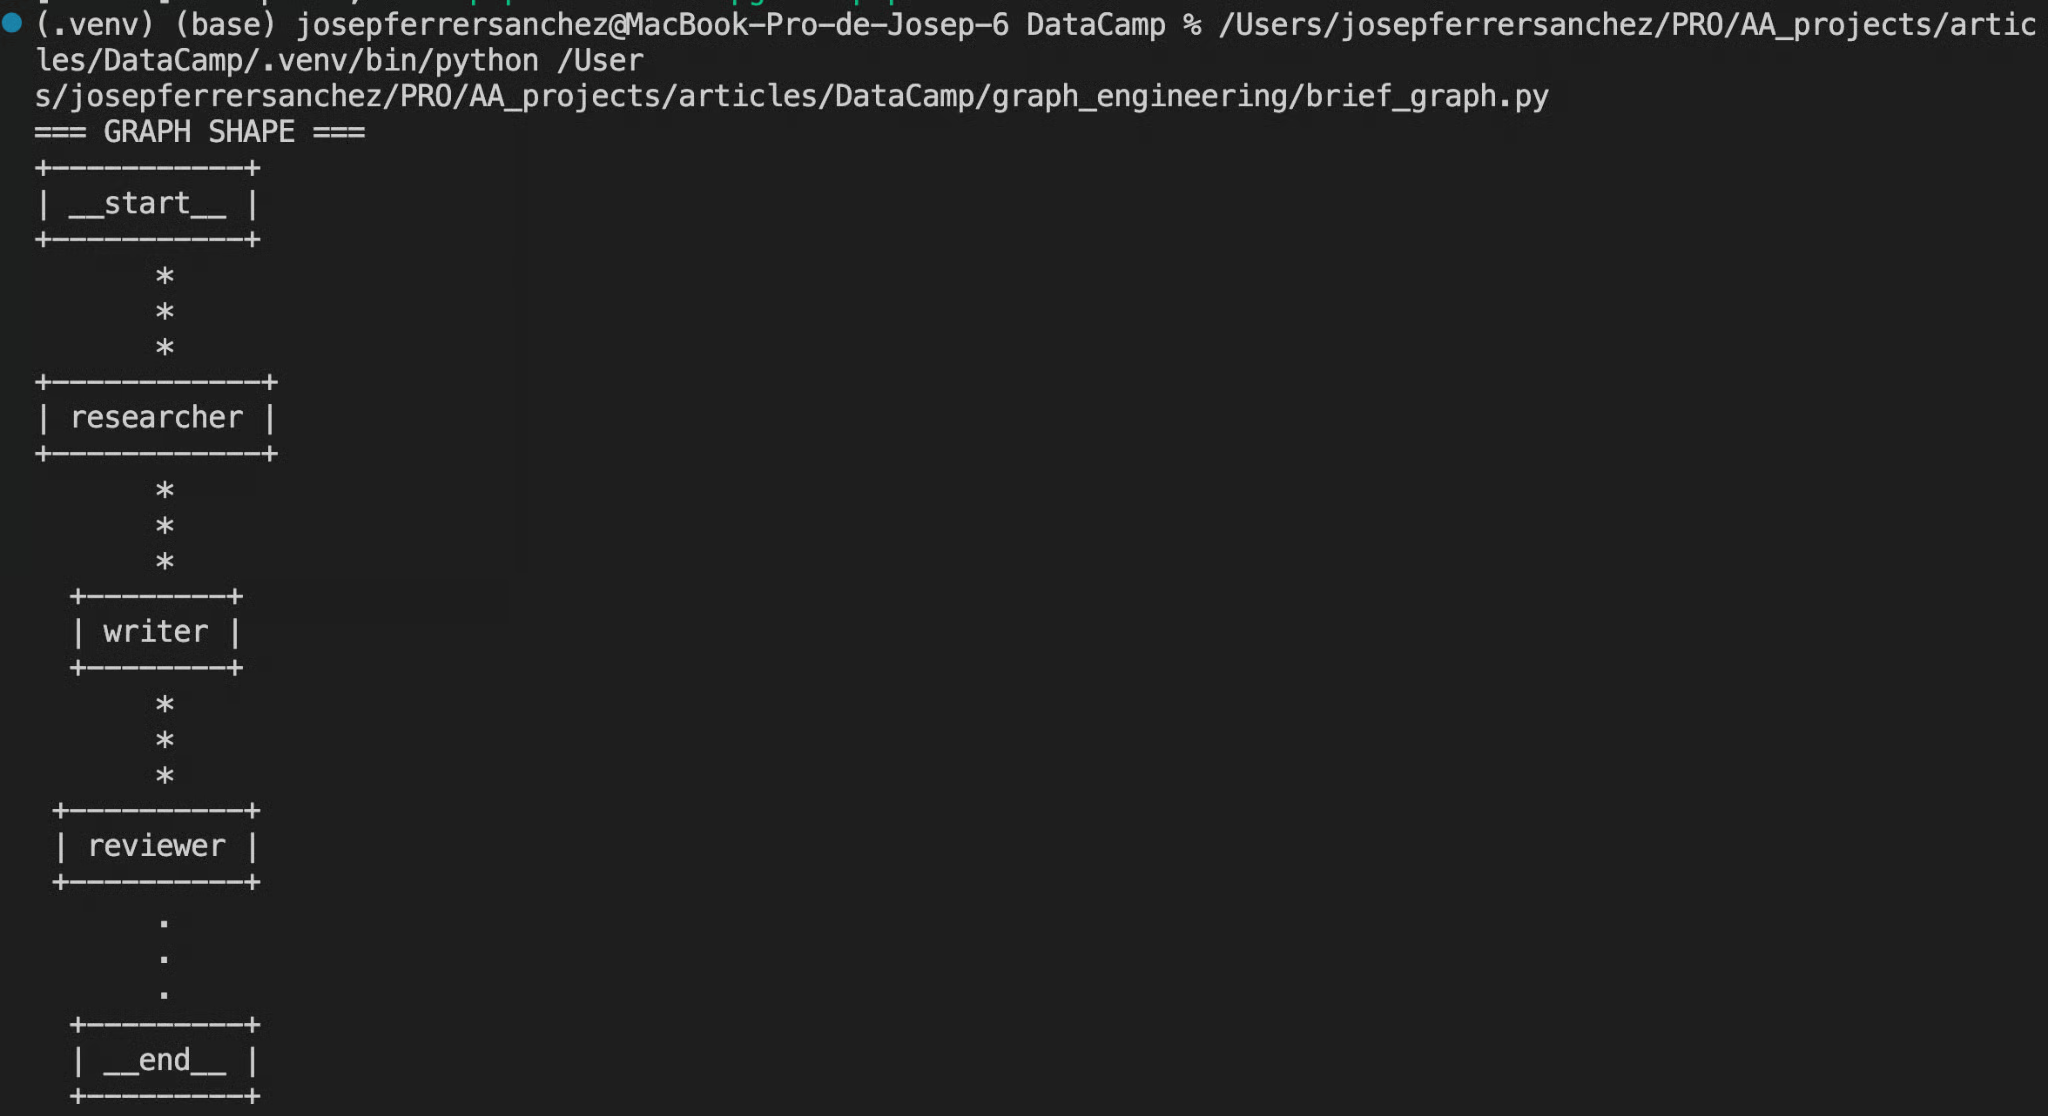
Screenshot door de auteur. Terminal met de output van .draw_ascii(), met __start__, researcher, writer, reviewer en __end__ verticaal gestapeld en verbonden.
Voor stap-voor-stap debuggen met state-inspectie bij elke node, koppelt LangGraph Studio aan een lokale server. Dat vereist een eigen package en een configbestand, dus pip install "langgraph-cli[inmem]", voeg een langgraph.json toe die wijst naar je gecompileerde graph-object, draai vervolgens langgraph dev en open de Studio-URL die wordt geprint.
Onze LangGraph Studio-gids loopt door de interface (hij dateert uit 2024, dus check de setupstappen tegen de commando's hierboven), en onze LangGraph-agents-tutorial behandelt het toevoegen van echte tools aan een node zoals onze onderzoeker.
Eén scoping-opmerking.
Deze pijplijn is sequentieel, dus hij demonstreert nooit fan-out: het patroon waarbij de onderzoeker meerdere bronnen tegelijk zou bevragen en een join-node de resultaten zou samenvoegen.
Dat is de natuurlijke volgende uitbreiding, en ook waar kosten het snelst vermenigvuldigen.
De faalmodi in agentische AI-graph engineering komen vaak genoeg terug om te benoemen. Dit zijn de drie die ik check voordat ik iets ship.
Elke node is op zichzelf een loop, met een prompt, tools en een definitie van klaar.
Drie wankele nodes aan elkaar knopen geeft je een wankel systeem met driedubbel oppervlak en een veel slechter debugverhaal.
Krijg één node eerst alleen werkend.
Een onderzoeker die vage notities teruggeeft als je hem direct aanroept, geeft ook vage notities terug binnen een grafiek, en de schrijver stroomafwaarts bouwt er vol vertrouwen op voort.
Weersta de neiging logica in een node te stoppen als die op een edge thuishoort.
Stopvoorwaarden, takbeslissingen en retry-limieten zijn routering, en routering hoort in de edgefunctie, waar je alles in één keer kunt lezen.
Pas de geen-voegwoordtest van eerder toe.
Een node die bronnen zoekt en beslist of het er genoeg zijn, is 2 nodes die een functiehandtekening delen.
Fan-out en retry-loops vermenigvuldigen het tokenverbruik op manieren die een diagram volledig verbergt.
Een 5-weg fan-out naar een join-node met een retry-limiet van 3 is niet 5 calls, en afhankelijk van waar de retry zit, kan het 15 of meer zijn voordat je de join meetelt.
Zet de limiet expliciet, zoals we met MAX_REVISIONS deden. Log daarna per-node tokenaantallen en lees ze na een week, want de node waarvan je aannam dat die goedkoop was, is meestal degene die het vaakst draait.
AutoGen wordt nog steeds aangeraden voor graph-orkestratie, en het experimentele GraphFlow-werk was echte voorloper, maar de repository staat sinds september 2026 in onderhoudsmodus, zonder nieuwe features.
Microsoft verwijst nieuwe gebruikers naar het Microsoft Agent Framework, dat eigen grafiekgebaseerde workflows heeft, via een gepubliceerde migratiegids.
Vanaf vandaag zijn LangGraph, Google's ADK of Microsoft Agent Framework de veiligere keuzes, en onze cursus Building AI Agents with Google ADK behandelt ADK grondig.
Graph engineering is de coördinatielaag boven loop engineering.
Nodes doen het werk, edges bepalen wat hierna draait, en één gedeeld object draagt informatie tussen hen.
Streep de ruis van juli 2026 weg en dat is het hele model.
Onze pijplijn bleef expres klein: 3 nodes, 4 edgedeclaraties (waarvan 1 conditioneel, dus die tekent 2 takken), en een revisielimiet zodat de retry niet met ons op de loop gaat.
Dat was genoeg structuur om een concept te laten reviewen door iets dat het niet schreef, en precies die eigenschap is wat een loop niet kon bieden.
Grijp naar een grafiek wanneer het werk uiteenvalt in fasen die verschillende specialisten nodig hebben, en niet één node eerder. De sceptici hadden gelijk dat de mechaniek decennia oud is en dat het meeste geschrevene rond de term ruis is.
Ze hadden ook gelijk over het deel dat ertoe doet op een dinsdagmiddag.
Een zwakke verifier gekoppeld aan een loop-vormig probleem wordt niet beter omdat je er meer hokjes omheen tekent.
Om deze patronen verder te brengen, behandelt onze cursus Multi-Agent Systems with LangGraph de supervisor- en netwerkontwerpen waar deze tutorial net niet aan toekomt.
Voor de datakant van het woord is Graph RAG with LangChain and Neo4j een goede volgende stap. Wil je op de orkestratiekant blijven, dan bouwt Text-to-Query Agents with MongoDB and LangGraph een LangGraph-pijplijn tegen een live database, en LLM Agents Explained vult de architectuur eronder in.
Het complete script staat in mijn GitHub-repo, met de helper voor het renderen van de grafiek en een korte notitie over wat elke run kost.
Topcursussen op DataCamp
Cursus
Cursus
Cursus