course
Wieloagentowe systemy z LangGraph
2 godz. 45 min
8.6K
Daj agentowi jedno zadanie – poradzi sobie. Daj mu trzy – i zobacz, co się dzieje przy drugim przekazaniu: zapomina, co znalazł w kroku pierwszym, hojnie ocenia własny szkic i ogłasza sukces, gdy wynik leży niedokończony.
Spór o ten wzorzec wybuchł w połowie lipca 2026 r., gdy „inżynieria grafów” trafiła na X (dawniej Twitter) i linia czasu natychmiast podzieliła się między osoby ogłaszające śmierć pętli agenta a tych, którzy nazywali ten termin zapychaczem z farm treści.
Moim zdaniem etykieta inżynierii grafów jest opcjonalna, ale stojąca za nią eskalacja – nie. Spróbuję to uzasadnić, zanim napiszemy jakikolwiek kod.
Większość rzeczy, które zbudujesz w tym miesiącu, nadal powinna być pojedynczą pętlą, a najszybszy sposób na zmarnowanie tygodnia to narysować diagram z 6 pudełkami do pracy, która potrzebowała 1.
Graf agentów ma 3 części:
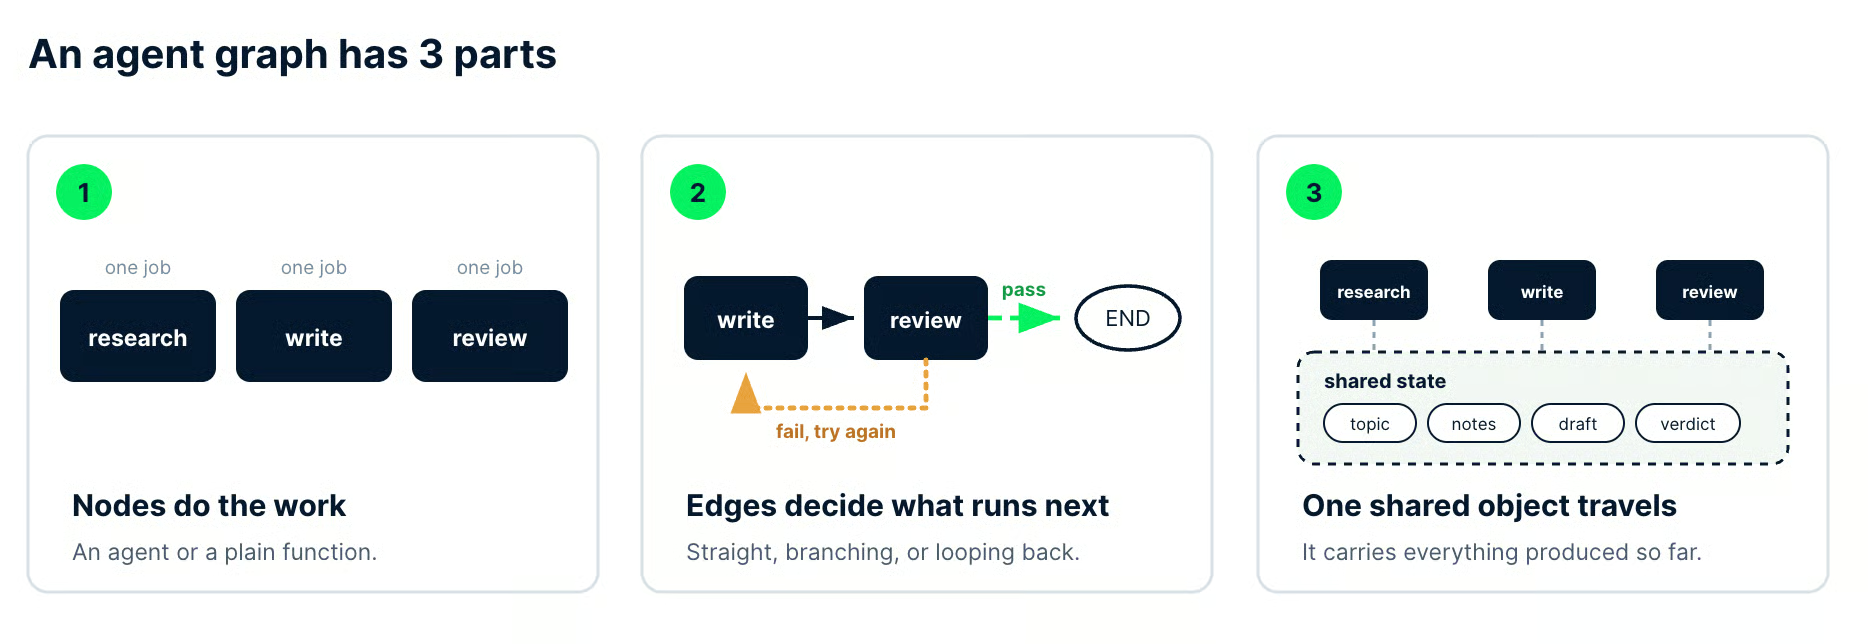
Grafika autora. 3 części pokazane na potoku, który zbudujemy później: 3 nazwane węzły, krawędź „pass” i krawędź ponowienia oraz jeden obiekt stanu zbierający topic, notes, draft i verdict.
Zadeklarowanie całej trójki z góry – zamiast pozwalać pojedynczemu agentowi improwizować własną ścieżkę – to właśnie opisuje termin inżynieria grafów.
Ten tutorial buduje działający potok badacza, autora i recenzenta w Pythonie z LangGraph, w tym warunkową krawędź odsyłającą nieudane szkice do poprawy.
Potrzebujesz Pythona, pipa i pewnego obycia z dużymi modelami językowymi (LLM) lub agentami AI. Jeśli agenci to nowość, nasz kurs Wprowadzenie do agentów AI omawia koncepcje zakładane w tym artykule, a nasz tutorial o agentach LangGraph pokazuje praktykę.
Inżynieria grafów to praktyka zapisywania przepływu sterowania systemu agentów w kodzie wprost, zamiast zostawiać go osądowi modelu.
Deklarujesz, jacy wyspecjalizowani pracownicy istnieją, jakie przejścia między nimi są dozwolone oraz jakie informacje przez nie przepływają.
Agent nadal swobodnie rozumuje, ale robi to wewnątrz jednego węzła, a nie w poprzek całej pracy.
To ostatnie zdanie to cała różnica.
W pętli ustawiasz cel i poprzeczkę jakości, a agent wybiera własną trasę, by je spełnić. W grafie ustalasz trasę i punkty kontrolne, więc autonomia modelu jest ograniczona przez strukturę, którą możesz odczytać w diffie.
Etykieta zrobiła się głośna na X w lipcu 2026 r., ale nie zaczęła się tam. Itamar Friedman z CodiumAI (obecnie Qodo) opisał przesunięcie „z inżynierii promptów do inżynierii przepływów (/grafów)” już w lutym 2024 r., a zespół w pracy AlphaCodium podał na to liczby.
Dokładność GPT‑4 pass@5 na zbiorze walidacyjnym CodeContests wzrosła z 19% przy jednym dobrze zaprojektowanym promcie do 44% przy wieloetapowym przepływie. W obu warunkach to 5 prób na zadanie, nie pojedyncze strzały.
To, co wydarzyło się w lipcu 2026 r., to amplifikacja.
18 lipca Peter Steinberger zapytał na X: „Czy wciąż mówimy o pętlach, czy już przeszliśmy do grafów?”, tydzień po tym, jak Mike Masson wrzucił drabinę: prompt, kontekst, harness, pętla, graf. Pytanie zebrało 3,1 mln wyświetleń, a rozprzestrzenione wyrażenie już było w użyciu.
Szybko pojawiła się kontrargumentacja. Harrison Chase, współzałożyciel LangChain z zespołu stojącego za LangGraph, spytał, czy to wszystko to „w zasadzie po prostu langgraph?”
Dale Everett naciskał z drugiej strony, argumentując, że pętla to zawsze graf z jednym węzłem, więc lipcowe podniecenie odkrywało stary grunt. Retrospektywa LangChain, 3 lata inżynierii grafów z LangGraph, przedstawia podobną tezę, ujmując grafy agentów jako wzorzec, który buduje od 3 lat.
Ja wpisuję ten termin pod „użyteczny skrót myślowy”.
Dał nam wspólną nazwę dla pytań projektowych, które wcześniej tkwiły zakopane w dokumentacji frameworków – a nazwa przydaje się, gdy dyskutujesz o architekturze w pull requeście.
Inżynieria grafów opisuje strukturę wykonania, co odróżnia ją od dwóch rzeczy, które pożyczają jej słownictwo.
Grafy wiedzy i GraphRAG opisują dane.
Zamieniają dokumenty w encje i relacje, by system wyszukiwania mógł przechodzić po połączeniach między faktami, a narzędzia, składowanie i metryki ewaluacji są inne.
Po tę stronę słowa właściwym punktem startowym jest nasz tutorial o wykorzystaniu grafu wiedzy do implementacji aplikacji RAG, a nasze wprowadzenie do teorii grafów omawia matematykę wspólną dla obu.
Drugą rzeczą, którą to nie jest, jest nowa zdolność.
LangGraph, Agent Development Kit (ADK) Google'a i Microsoft AutoGen dostarczyły orkiestrację multi‑agentową zanim etykieta stała się viralem, więc jeśli napisałeś StateGraph, już to robiłeś.
Wielu czytelników odkryje, że od roku uprawia inżynierię grafów pod nazwą „mój potok LangGraph”.
Każda warstwa inżynierii AI przejmuje kontrolę nad czymś o krok dalej od modelu.
Użyteczny sposób czytania tej tabeli to prawa kolumna – mówi, co faktycznie się psuje, gdy przeskakujesz szczebel i próbujesz mimo to na nim budować.
| Warstwa | Co kontrolujesz | Co się psuje, jeśli to pominiesz |
|---|---|---|
| Prompt | Sformułowanie prośby | Model odpowiada na pytanie, którego nie zadałeś |
| Kontekst | Które wejścia trafiają do modelu | Dobrze rozumuje na złym materiale |
| Harness | Narzędzia, pamięć, dostęp do plików i API | Nie może dotknąć niczego poza oknem czatu |
| Pętla | Cykl powtarzaj‑aż‑zrobisz | Kończy za wcześnie albo nie kończy wcale |
| Graf | Który pracownik rusza dalej i nad czym | Jeden agent próbuje być 4 agentami i zapomina 3 z nich |
Pomijanie szczebla to najczęstszy sposób, w jaki projekty grafów zawodzą – i rzadko w oczywisty sposób.
Trzy zawodne węzły połączone razem nie uśredniają się do niezawodnego systemu.
Produkują system, który psuje się w większej liczbie miejsc, kosztuje więcej za awarię i dłużej się diagnozuje, bo zły wynik jest teraz o 2 przekazania dalej od węzła, który go spowodował.
Każdy graf agentów – czy ma 3 węzły, czy 30 – rozkłada się na węzły, krawędzie i współdzielony stan.
Gdy potrafisz nazwać te 3 części w bazie kodu, większość frameworków orkiestracyjnych staje się czytelna bez ich dokumentacji.
Węzeł to jedna jednostka pracy z nazwą i pojedynczą odpowiedzialnością.
Może to być wywołanie LLM ze specjalistycznym promptem i własnymi narzędziami, albo zwykła funkcja Pythona, która odpytuje bazę, waliduje schemat lub zapisuje plik.
Zarezerwuj wywołania modelu dla kroków wymagających osądu semantycznego.
Jeśli reguła ma znaną odpowiedź, umieść ją w Pythonie – zadziała w mikrosekundach, nic nie kosztuje i zwraca ten sam wynik dwa razy.
Oto test, którego używam, czy coś rozdzielać: spróbuj opisać węzeł jednym zdaniem bez spójników.
Węzeł, który „ściąga źródła i decyduje, czy mamy ich dość”, już oblał test, bo nie możesz wymienić części wyszukującej bez naruszania części oceniającej.
Krawędź określa, co uruchamia się po zakończeniu bieżącego węzła.
Cztery kształty pokrywają prawie wszystko, co zbudujesz:
Krawędzie to także miejsce na logikę zatrzymywania. Limity prób, bramki jakości i reguły eskalacji to decyzje trasowania – trzymając je w funkcjach krawędzi możesz audytować przepływ sterowania w jednym miejscu, zamiast szukać ich w ciałach węzłów.
Współdzielony stan to pojedynczy obiekt, z którego każdy węzeł czyta i do którego pisze w trakcie uruchomienia.
Bez niego masz kilku agentów wykonujących sąsiednią pracę i nieprzekazujących sobie nic – więc autor nie widzi, co znalazł badacz, a recenzent nie widzi żadnego z nich.
W LangGraph stan to zwykle TypedDict.
Nasz zbiera temat, notatki badacza, bieżący szkic, werdykt i feedback recenzenta oraz licznik poprawek. Każdy węzeł zwraca tylko pola, które zmienił, a framework scala te zwroty w obiekt bieżącego stanu.
Własność zapisu to miejsce, gdzie grafy psują się jako pierwsze.
Zdecyduj przed kodowaniem, który węzeł może pisać w każde pole, bo obiekt stanu, który 3 różne węzły mogą nadpisywać, to sesja debugowania, którą już sobie zaplanowałeś.
Inżynieria pętli projektuje cykl, który pojedynczy agent powtarza, aż skończy, a inżynieria grafów projektuje koordynację między kilkoma takimi cyklami.
To najważniejsza decyzja w artykule, więc pojawia się przed tutorialem.
Domyślna odpowiedź to pętla.
Pojedynczy dobrze zawężony agent z surowym weryfikatorem jest szybszy w budowie, tańszy w uruchomieniu i dużo łatwiejszy w debugowaniu niż jakikolwiek graf robiący to samo.
To nie tylko moja preferencja.
Zespół z UC Berkeley (pierwszy autor Mert Cemri) wychodzi od obserwacji, że zyski multi‑agentów nad układami jednoagentowymi są często minimalne, a potem adnotuje 1600+ śladów wykonania z 7 frameworków multi‑agentowych, by dowiedzieć się dlaczego (arXiv:2503.13657, v3).
Ich taksonomia, zbudowana z uważnej lektury 150 z tych śladów, nazywa 14 odrębnych trybów awarii.
Te 14 trybów grupuje się w 3 kategorie: problemy projektu systemu, niedopasowanie między agentami i weryfikację zadania.
Zachowaj tę trzecią do momentu, gdy dojdziemy do węzła recenzenta.
Traktuj to jako wyzwalacze, nie checklistę.
Jedno wyraźne „tak” w prawej kolumnie wystarczy, a 5 mętnych – nie.
| Pytanie o twoje zadanie | Pętla to ogarnie | Potrzebujesz grafu |
|---|---|---|
| Czy możesz opisać pracę jednym poleceniem? | Tak, i człowiek mógłby je wykonać od początku do końca | Brzmi jak przekazanie między 2 różnymi rolami |
| Czy każdy krok chce tego samego modelu? | Jeden model i jeden zestaw narzędzi przez całość | Zbieranie chce tanio i szybko, osąd chce ostro |
| Czy jakieś kroki od siebie nie zależą? | Każdy krok potrzebuje wyniku poprzedniego | Kilka lookupów, które mogłyby lecieć równolegle |
| Kto decyduje, że wynik jest wystarczająco dobry? | Agent czyta własną pracę jeszcze raz | Coś, co tego nie pisało, musi to zatwierdzić |
| Co powinno się stać, gdy krok zawiedzie? | Spróbuj ponownie i jedź dalej | Odizoluj awarię, żeby reszta przebiegu przetrwała |
| Czy ktoś musi audytować obraną ścieżkę? | Ślad jest dla ciebie i twojego zespołu | Ktoś z zewnątrz musi widzieć, który krok ruszył i dlaczego |
Najczęstsza nadinżynieria, na którą trafiam, nie dotyczy nawet agentów. Ktoś musi oczyścić i zgeokodować listę 800 adresów hoteli, i trafia to jako graf 5‑węzłowy: loader, normalizer, geocoder, validator i writer, z nawleczonym współdzielonym stanem.
Każdy z tych kroków jest deterministyczny, więc to, co faktycznie zbudowali, to 40‑linijkowy skrypt Pythona w przebraniu frameworka – teraz kosztuje za każdy wiersz i psuje się w sposoby, w jakie pandas nigdy by się nie popsuł.
Wersja dobrana do rozmiaru to ta, którą zaraz zbudujemy.
Wyprodukowanie krótkiego, zresearczowanego briefu rozdziela się na pracę, z którą pojedyncza pętla się szarpie: zebranie surowca, zamianę go w prozę i osądzenie tej prozy z zewnątrz.
Trzeci krok to powód istnienia grafu, bo agent recenzujący własny szkic to nie recenzja.
Trzy rzeczy uzasadniają węzeł.
Jeśli nie możesz wskazać jednej z nich dla każdego dodanego węzła, usuń węzeł i wchłoń jego pracę do sąsiada.
Najpierw realna specjalizacja.
Nasz badacz chce taniego, szybkiego modelu i – na produkcji – narzędzi wyszukiwania. Autor nie potrzebuje żadnego z nich i korzysta na mocniejszym modelu, więc podział robi robotę zamiast dekorować diagram.
Po drugie, równoległość, którą naprawdę odczujesz.
Fan‑out się opłaca, gdy gałęzie są niezależne, a oszczędność czasu ściennego ma dla kogoś znaczenie – i kosztuje cię złożoność, gdy żaden warunek nie zachodzi.
Po trzecie – i tego broniłbym najmocniej – niezależna weryfikacja.
Agent oceniający własną pracę ocenia łagodnie, więc osobny węzeł recenzenta z dostępem tylko do odczytu szkicu to zwykle najcenniejszy węzeł w każdym grafie.
Z perspektywy frameworków i tego, jak różne biblioteki wyrażają te wzorce, nasza porównywarka CrewAI vs LangGraph vs AutoGen rozkłada kompromisy.
Budujemy potok multi‑agentowy LangGraph z badaczem, autorem i recenzentem, który produkuje krótki, zresearczowany brief i odsyła nieudane szkice do poprawy.
LangGraph to niskopoziomowy framework orkiestracji dla stanowych agentów, a jego StateGraph niemal jeden do jednego mapuje się na węzły, krawędzie i stan z poprzedniej sekcji.
Wszystko poniżej sprawdzone na langgraph 1.2.11 i langchain-anthropic 1.7.1 we wrześniu 2026 r.
Jeśli biblioteka jest ci nowa, nasz tutorial LangGraph omawia podstawy. Ta sekcja idzie szybko, a nasz przewodnik LangChain vs LangGraph vs LangSmith vs LangFlow porządkuje role w tej rodzinie.
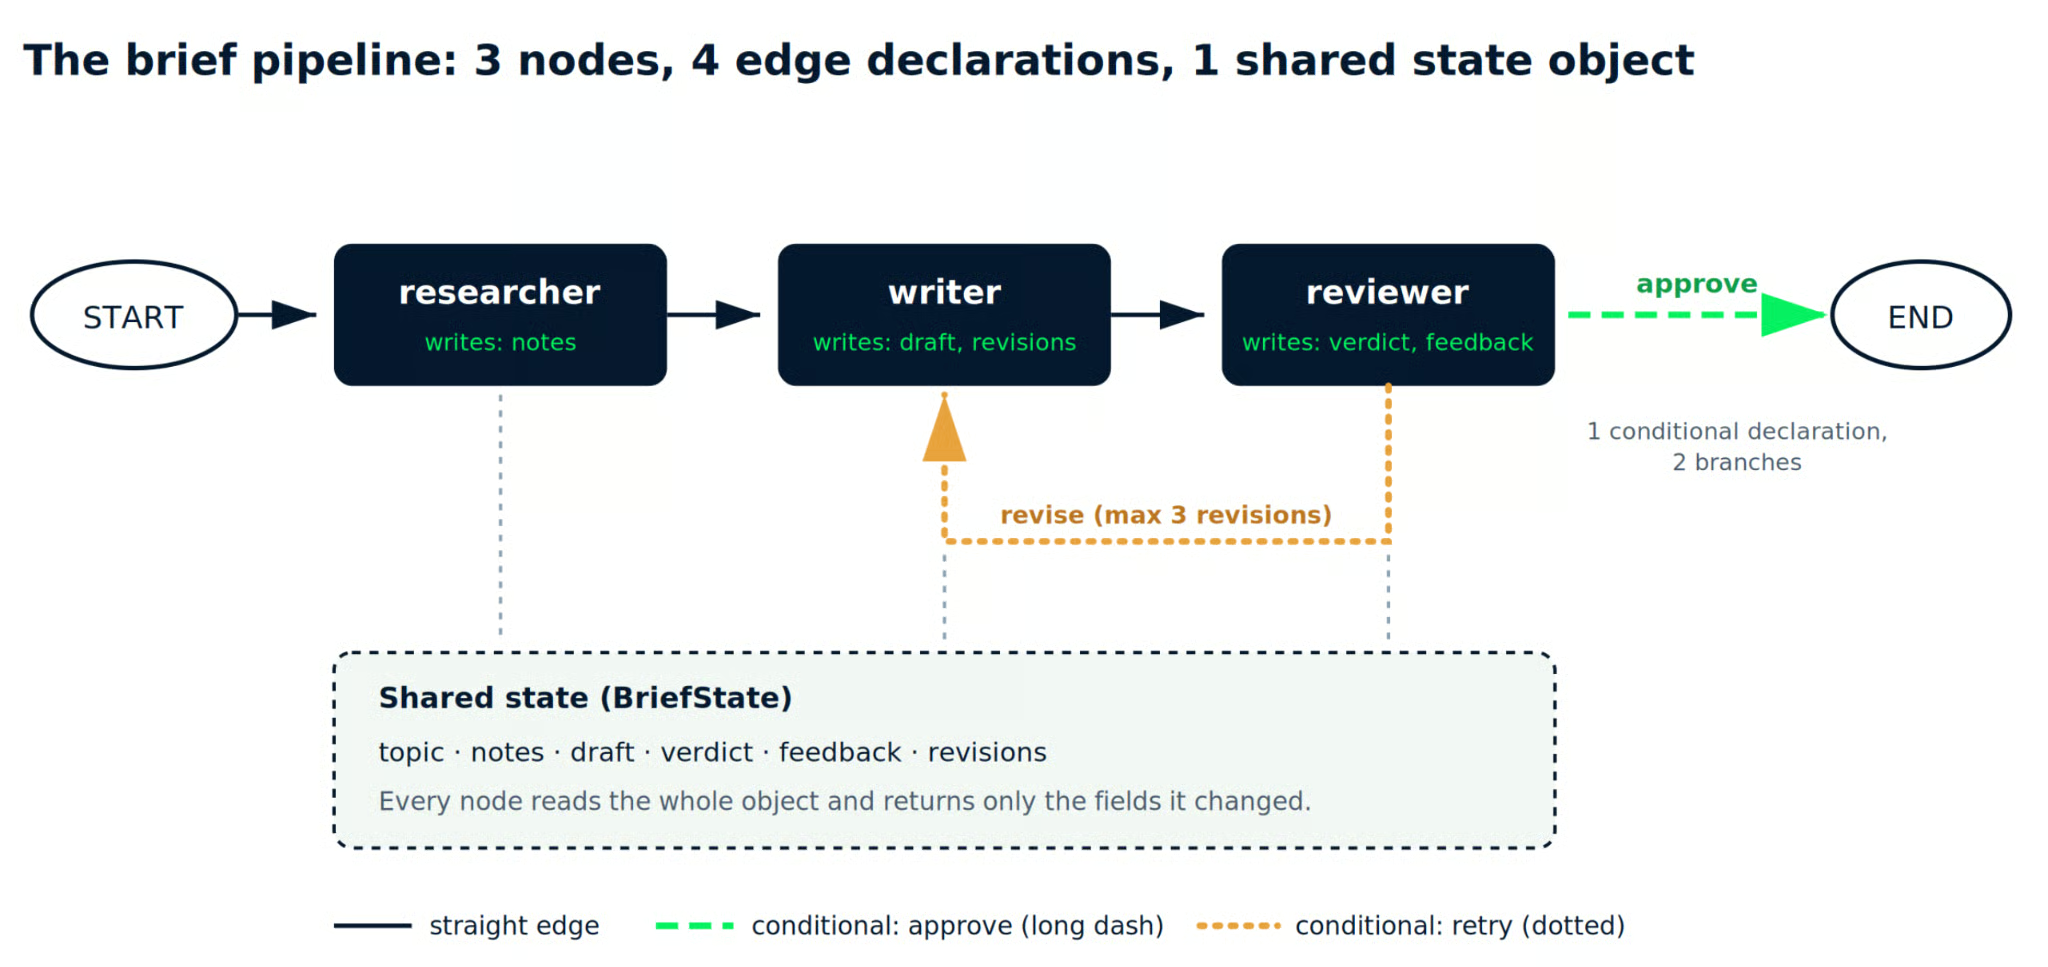
Grafika autora. Potok, który za chwilę zbudujemy. Ciągłe linie to 3 proste krawędzie; linie przerywana i kropkowana to 2 gałęzie jednej krawędzi warunkowej.
Zainstaluj pakiety oraz python-dotenv, by klucz nie trafił do źródeł:
pip install langgraph langchain-anthropic python-dotenvUtwórz plik .env obok skryptu:
ANTHROPIC_API_KEY=sk-ant-your-key-hereTeraz importy i schemat stanu. Warto zacząć od TypedDict – to umowa, na którą zgadza się każdy węzeł:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Dwa modele, nie jeden. To „inny model na krok” z tabeli decyzji w realnym kodzie, bo research to praca o dużej objętości i małej potrzebie osądu, która nie wymaga drogiego modelu.
MAX_REVISIONS robi tu cichą, ale ważną robotę.
Bez limitu surowy recenzent i uparty autor będą odsyłać szkic tam i z powrotem, aż faktura stanie się ciekawa.
Każdy węzeł ma ten sam kontrakt. Otrzymuje bieżący stan, robi swoje jedno zadanie i zwraca słownik zawierający tylko pola, które zmienił.
Badacz zbiera surowiec i zapisuje go do notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
Wersja produkcyjna tego węzła wywoływałaby narzędzie wyszukiwania zamiast polegać na wiedzy samego modelu.
Zostawiłem to jako pojedyncze wywołanie .invoke(), żeby struktura grafu była widoczna – traktuj więc powstające notatki jako niezweryfikowane.
Autor czyta te notatki i tworzy szkic. Sprawdza też feedback recenzenta, co daje krawędzi ponownej próby punkt zaczepienia:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Recenzent ocenia szkic.
Nigdy nie widział rozumowania autora i nie produkował tekstu, więc może być wobec wyniku bezpośredni.
To trzecia kategoria z berkeleyowskiej taksonomii, wydzielona do osobnego węzła.
Weryfikacja zadania się psuje, gdy nic niezależnego nie sprawdza wyniku, więc naprawą jest pracownik, który nie może sam sobie sprawdzić pracy domowej:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Zwróć uwagę na .text, a nie .content we wszystkich trzech węzłach.
Oba zwracają string dla prostej odpowiedzi, ale .text dobrze obsługuje też odpowiedzi jako wiele bloków treści, co oszczędza ci mylącego AttributeError: 'list' object has no attribute 'strip' później.
Parsowanie werdyktu z pierwszej linii zachowuje czytelność – i jest kruche.
Dla czegokolwiek działającego bez nadzoru zamień ten check stringa na strukturyzowany output LangChain, żeby werdykt wracał jako typowane pole zamiast prefiksu, którego – miałeś nadzieję – model dotrzyma.
Funkcja trasowania to krawędź warunkowa. Czyta stan po uruchomieniu recenzenta i zwraca nazwę tego, co ma się wydarzyć dalej:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Trzymaj tę funkcję w ciszy. print() w jej środku trafi na stdout, gdy pętla streamu wciąż drukuje poprzedni fragment, więc komunikat o limicie pokaże się o krok za wcześnie i ślad będzie wyglądał nie po kolei.
Limit poprawek żyje tutaj, a nie w węźle, bo zatrzymanie to decyzja o przepływie sterowania, a przepływ sterowania należy do krawędzi.
Teraz złóż graf. Węzły, potem krawędzie, potem kompilacja:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Trzeci argument .add_conditional_edges() to mapa ścieżek.
Wymienia wszystkie miejsca docelowe, które funkcja trasowania może zwrócić, a LangGraph używa jej do narysowania gałęzi zanim jakikolwiek węzeł ruszy.
Wywołaj skompilowany graf z początkowym stanem. Wartości wymagają tylko topic i revisions, bo pozostałe pola wypełnią się w trakcie wykonania:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
To daje ci stan końcowy i nic więcej. Niewiele pomaga, gdy przebieg idzie bokiem.
Zamień .invoke() na .stream() ze stream_mode="updates", by obserwować, jak każdy węzeł raportuje, co zapisał. Każde wywołanie to osobny przebieg z własnymi wywołaniami modelu – użyj jednego albo drugiego, zamiast uruchamiać oba:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Przy przebiegu, w którym recenzent odrzuca pierwszy szkic, wydrukuje to:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Widać tu dwie rzeczy, których nie pokazuje stan końcowy.
Badacz ruszył raz, a jego notatki przetrwały oba przejścia autora – retry nie robi ponownego researchu. Każdy węzeł dotknął też tylko własnych pól, zamieniając regułę własności zapisu w coś weryfikowalnego.
Policz przy okazji wywołania.
Ta ścieżka odrzucona kosztuje 5 wywołań modelu wobec mniej więcej 1 dla wersji jednopętlowej tego samego zadania – i jedyny sposób, by wiedzieć, czy te dodatkowe 4 coś kupiły, to logować werdykty i je czytać.
Nie potrzebujesz dodatkowych narzędzi, by zobaczyć kształt tego, co zbudowałeś:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Wyjście Mermaid renderuje gałąź warunkową jako przerywane linie biegnące z reviewer do __end__ i z powrotem do writer.
To potwierdza istnienie krawędzi retry, zanim wydasz cokolwiek na wywołania modeli. Widok ASCII rysuje tylko prostą ścieżkę od startu do końca, więc do oglądania pętli użyj Mermaid.
Zrzut ekranu autora. Terminal pokazujący wynik .draw_ascii() ze stosami __start__, researcher, writer, reviewer i __end__ połączonymi pionowo.
Do debugowania krok‑po‑kroku z podglądem stanu w każdym węźle LangGraph Studio łączy się z lokalnym serwerem. Potrzebuje osobnego pakietu i pliku konfig, więc pip install "langgraph-cli[inmem]", dodaj langgraph.json wskazujący na skompilowany obiekt graph, potem uruchom langgraph dev i otwórz adres Studio, który wypisze.
Nasz przewodnik po LangGraph Studio przeprowadza przez interfejs (pochodzi z 2024 r., więc porównaj kroki konfiguracji z komendami powyżej), a nasz tutorial o agentach LangGraph omawia dodawanie prawdziwych narzędzi do węzła takiego jak nasz badacz.
Jedna uwaga zakresowa.
Ten potok jest sekwencyjny, więc nie demonstruje fan‑outu – wzorca, w którym badacz odpytuje kilka źródeł naraz, a węzeł łączący scala wyniki.
To naturalne następne rozszerzenie – i też miejsce, gdzie koszty mnożą się najszybciej.
Tryby awarii w agentowej inżynierii AI powtarzają się na tyle często, że da się je nazwać. Oto trzy, które sprawdzam przed wysyłką czegokolwiek.
Każdy węzeł to w pewnym sensie własna pętla – z promptem, narzędziami i definicją „gotowe”.
Połączenie 3 chwiejnych węzłów daje chwiejny system z potrójną powierzchnią ataku i znacznie gorszą historią debugowania.
Najpierw uruchom samodzielnie jeden działający węzeł.
Badacz, który zwraca mgliste notatki w wywołaniu bezpośrednim, zwróci mgliste notatki również w grafie – a autor niżej pewnie je rozwinie.
Oprzyj się wkładaniu logiki do węzła, jeśli należy do krawędzi.
Warunki zatrzymania, decyzje o gałęziach i limity powtórek to trasowanie, a trasowanie należy do funkcji krawędzi, gdzie przeczytasz wszystko naraz.
Zastosuj test bez spójników z wcześniejszej części.
Węzeł, który szuka źródeł i decyduje, czy jest ich dość, to 2 węzły współdzielące sygnaturę funkcji.
Fan‑out i pętle retry mnożą użycie tokenów w sposób, którego diagram kompletnie nie ujawnia.
Fan‑out x5 zasilający węzeł łączący z limitem 3 powtórek to nie 5 wywołań – w zależności od miejsca retry może być 15 lub więcej, zanim policzysz join.
Ustaw limit wprost, jak zrobiliśmy z MAX_REVISIONS. Potem loguj liczniki tokenów per węzeł i przeczytaj je po tygodniu, bo węzeł, który wydawał ci się tani, zwykle uruchamia się najczęściej.
AutoGen wciąż bywa polecany do orkiestracji grafów i jego eksperymentalny GraphFlow był realnym dorobkiem, ale repozytorium jest w trybie maintenance od września 2026 r., bez nowych funkcji.
Microsoft kieruje nowych użytkowników do Microsoft Agent Framework, który ma własne przepływy oparte na grafach, wraz z opublikowanym przewodnikiem migracji.
Na dziś bezpieczniejszym wyborem są LangGraph, ADK Google'a lub Microsoft Agent Framework, a nasz kurs Budowa agentów AI z Google ADK omawia ADK dogłębnie.
Inżynieria grafów to warstwa koordynacji ponad inżynierią pętli.
Węzły wykonują pracę, krawędzie decydują, co uruchomić dalej, a jeden współdzielony obiekt przenosi informacje między nimi.
Odetnij szum z osi czasu lipca 2026 r. i to cały model.
Nasz potok celowo pozostał mały: 3 węzły, 4 deklaracje krawędzi (1 z nich warunkowa, więc rysuje 2 gałęzie) i limit poprawek, by retry nam nie odjechało.
To wystarczyło, by szkic oceniło coś, co go nie napisało – a tej jednej rzeczy pętla nie potrafiła zaoferować.
Sięgaj po graf, gdy praca dzieli się na fazy wymagające różnych specjalistów – i ani jednego węzła wcześniej. Sceptycy mieli rację, że mechanika ma dekady i że większość pisania wokół terminu to szum.
Mieli też rację w tym, co liczy się we wtorkowe popołudnie.
Słaby weryfikator podpięty do problemu w kształcie pętli nie stanie się lepszy dlatego, że narysujesz wokół niego więcej pudełek.
Żeby pójść dalej z tymi wzorcami, nasz kurs Multi‑agentowe systemy z LangGraph omawia projekty supervisor i sieci, na których ten tutorial się zatrzymuje.
Po stronie danych dobrym kolejnym krokiem jest Graph RAG z LangChain i Neo4j. Jeśli wolisz pozostać po stronie orkiestracji, Agenci text‑to‑query z MongoDB i LangGraph budują potok LangGraph przeciwko żywej bazie, a Wyjaśnienie agentów LLM uzupełnia architekturę pod spodem.
Pełny skrypt jest w moim repozytorium GitHub, wraz z helperem do renderowania grafu i krótką notatką o kosztach każdego przebiegu.
Top DataCamp Courses
course
course
course