course
Multi-Agent Systems with LangGraph
2 tim 45 min
8.6K
Ge en agent ett jobb och den sköter det bra. Ge den tre, och se vad som händer runt det andra överlämnandet: den glömmer vad den hittade i steg ett, den betygsätter sitt eget utkast generöst och den utropar framgång medan resultatet ligger där ofärdigt.
Diskussionen om det där mönstret exploderade i mitten av juli 2026, när ”grafteknik” nådde X (tidigare Twitter) och flödet omedelbart delade sig mellan dem som utropade agentloopens död och dem som kallade begreppet innehållskvarnsfyllnad.
Min ståndpunkt är att etiketten grafteknik är valfri men upptrappningen under ytan inte är det, vilket jag ska försöka motivera innan vi skriver någon kod.
Det mesta du bygger den här månaden bör fortfarande vara en enda loop, och det snabbaste sättet att slösa bort en vecka är att rita ett diagram med 6 rutor för ett jobb som behövde 1.
En agentgraf har tre delar:
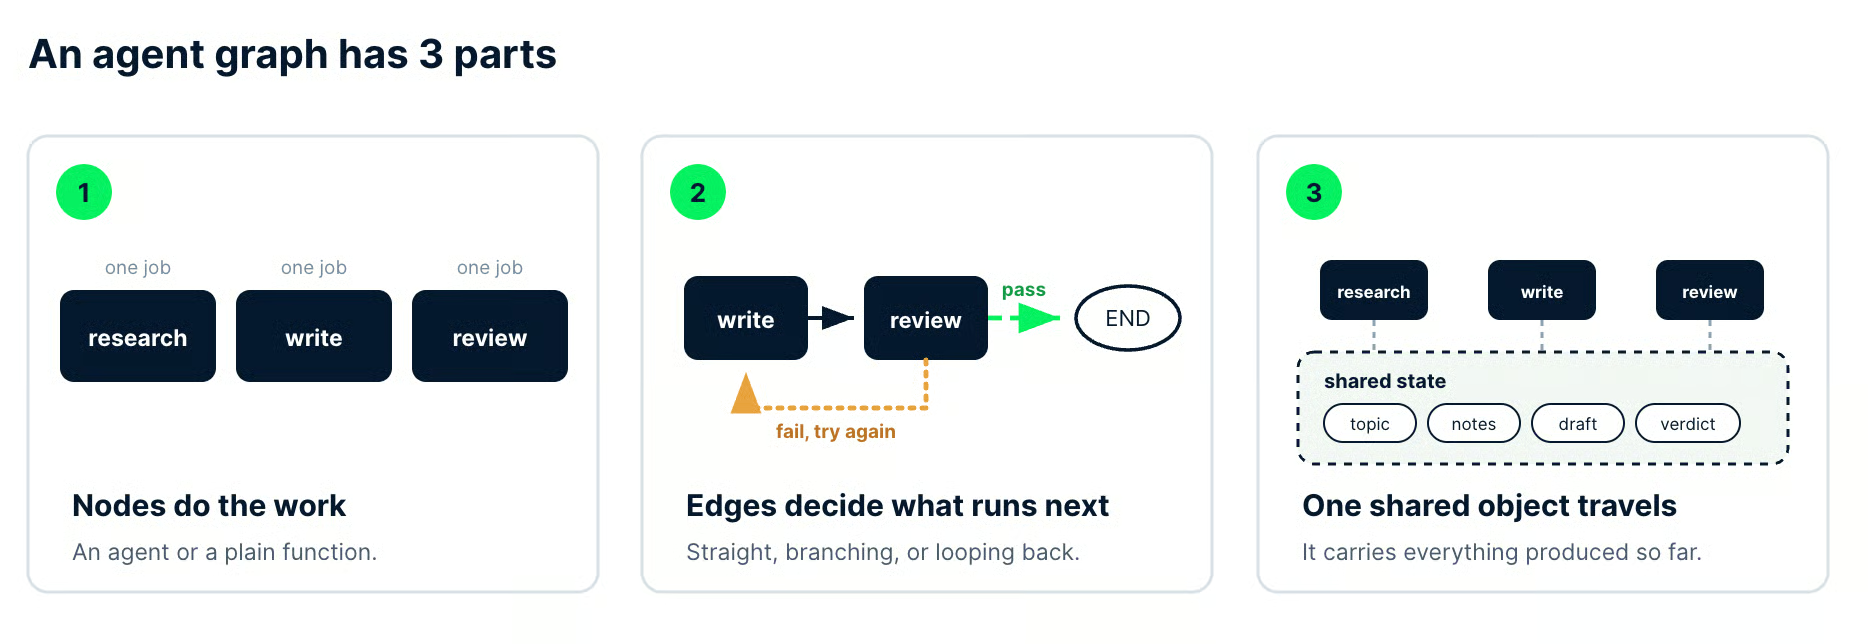
Bild av författaren. De 3 delarna visade på pipelinen vi bygger senare: 3 namngivna noder, en pass-kant och en omförsök-kant, samt ett state-objekt som samlar topic, notes, draft och verdict.
Att deklarera alla tre på förhand, i stället för att låta en enda agent improvisera sin egen väg, är det som avses med grafteknik.
Den här handledningen bygger en fungerande pipeline med forskare, skribent och granskare i Python med LangGraph, inklusive en villkorad kant som skickar tillbaka underkända utkast för revidering.
Du behöver Python, pip och viss vana vid stora språkmodeller (LLM:er) eller AI-agenter. Om agenter är nytt för dig täcker vår kurs Introduction to AI Agents de begrepp som den här artikeln förutsätter, och vår handledning om LangGraph-agenter tar den praktiska sidan.
Grafteknik är praktiken att göra ett agentsystems kontrollflöde explicit i kod i stället för att överlåta det åt modellens omdöme.
Du deklarerar vilka specialiserade arbetare som finns, vilka övergångar mellan dem som är tillåtna och vilken information som färdas längs de övergångarna.
Agenten resonerar fortfarande fritt, men den gör det inom en nod i stället för över hela jobbet.
Den sista meningen är hela skillnaden.
I en loop sätter du ett mål och en kvalitetsribba, och agenten väljer sin egen väg för att klara dem. I en graf låser du vägen och kontrollstationerna, så modellens autonomi begränsas av en struktur du kan läsa i en diff.
Etiketten blev högljudd på X i juli 2026, men den började inte där. Itamar Friedman på CodiumAI (numera Qodo) beskrev ett skifte ”från prompt engineering till flow (/graph) engineering” redan i februari 2024, och hans teams AlphaCodium-artikel satte siffror på det.
GPT-4:s pass@5-precision på CodeContests valideringsmängd gick från 19% med en väl utformad prompt till 44% med ett flerstegsflöde. Det är 5 försök per problem i båda förhållandena, inte single-shot.
Det som hände i juli 2026 var förstärkning.
Den 18 juli frågade Peter Steinberger på X, ”Pratar vi fortfarande loops eller har vi bytt till grafer än?”, en vecka efter att Mike Masson postat stegen prompt, context, harness, loop, graph. Frågan drog 3,1 miljoner visningar, och frasen den spred användes redan.
Motreaktionen kom snabbt. Harrison Chase, medgrundare av LangChain från teamet bakom LangGraph, frågade om allt i princip bara var ”basically just langgraph?”
Dale Everett tryckte från andra sidan och hävdade att en loop alltid varit en en-nods-graf, så julihypen återupptäckte gammal mark. LangChains egen återblick, 3 Years of Graph Engineering with LangGraph, tar en liknande linje och ramar in agentgrafer som ett mönster de har byggt i 3 år.
Så jag sorterar begreppet som användbar förkortning.
Det gav oss ett gemensamt namn för designfrågor som tidigare låg begravda i ramverksdokumentation, och ett namn tjänar sitt syfte när du argumenterar om arkitektur i en pull request.
Grafteknik beskriver körningsstrukturen, vilket skiljer den från två saker som lånar dess vokabulär.
Kunskapsgrafer och GraphRAG beskriver data.
De förvandlar dokument till entiteter och relationer så att ett söksystem kan vandra mellan faktasamband, och verktyg, lagring och utvärderingsmetrik skiljer sig åt.
För den sidan av ordet är vår handledning om att använda en kunskapsgraf för att implementera en RAG-applikation rätt startpunkt, och vår introduktion till grafteori täcker matematiken som ligger under båda.
Den andra saken det inte är, är en ny förmåga.
LangGraph, Googles Agent Development Kit (ADK) och Microsoft AutoGen släppte alla orkestrering av multiagenter innan etiketten blev viral, så om du har skrivit en StateGraph gjorde du redan detta.
Många läsare kommer att upptäcka att de har ägnat sig åt grafteknik i ett år under namnet ”min LangGraph-pipeline”.
Varje lager i AI-engineering tar kontroll över något ett steg längre ut från modellen.
Det användbara sättet att läsa den här tabellen är högerkolumnen, som berättar vad som faktiskt går fel när du hoppar över ett steg och försöker bygga ovanpå det ändå.
| Lager | Vad du kontrollerar | Vad som går sönder om du hoppar över det |
|---|---|---|
| Prompt | Formuleringen av begäran | Modellen svarar på en fråga du inte ställde |
| Kontext | Vilka indata som når modellen | Den resonerar väl över fel material |
| Harness | Verktyg, minne, fil- och API-åtkomst | Den kan inte röra något utanför chattfönstret |
| Loop | Upprepa-tills-klar-cykeln | Den stannar tidigt, eller så stannar den aldrig |
| Graf | Vilken arbetare som körs härnäst och på vad | En agent försöker vara 4 agenter och glömmer 3 av dem |
Att hoppa över en stegpinne är det vanligaste sättet som grafprojekt misslyckas på, och felet är sällan uppenbart.
Tre opålitliga noder ihopkopplade blir inte i snitt ett pålitligt system.
De ger ett system som fallerar på fler ställen, kostar mer per fel och tar längre tid att felsöka eftersom det dåliga resultatet nu är två överlämningar bort från noden som orsakade det.
Vilken agentgraf som helst, oavsett om den har 3 noder eller 30, bryts ned i noder, kanter och delat state.
När du kan namnge de tre delarna i en kodbas blir de flesta orkestreringsramverk läsbara utan deras dokumentation.
En nod är en enhet av arbete med ett namn och ett enda ansvar.
Det kan vara ett LLM-anrop med en specialiserad prompt och egna verktyg, eller en vanlig Python-funktion som frågar en databas, validerar ett schema eller skriver en fil.
Reservera modellanrop för steg som behöver semantiskt omdöme.
Om en regel har ett känt svar, lägg den i Python där den körs på mikrosekunder, kostar inget och ger samma resultat två gånger.
Här är testet jag använder för om något ska delas upp: försök beskriva noden i en mening utan bindeord.
En nod som ”hämtar källorna och avgör om vi har tillräckligt” har redan misslyckats med testet, eftersom du inte kan byta ut hämtningshalvan utan att störa omdömeshalvan.
En kant avgör vad som körs efter att den aktuella noden är klar.
Fyra former täcker nästan allt du kommer att bygga:
Kanter är också platsen där din stopp-logik hör hemma. Omförsöksgränser, kvalitetsgrindar och eskaleringsregler är alla routningsbeslut, och att hålla dem i kantfunktionerna innebär att du kan granska kontrollflödet på ett ställe i stället för att leta genom nodkroppar.
Delat state är det enda objekt som varje nod läser från och skriver till allteftersom körningen fortskrider.
Utan det har du flera agenter som gör angränsande arbete och passerar varandra utan något, så skribenten kan inte se vad forskaren hittade, och granskaren kan inte se någotdera.
I LangGraph är statet vanligtvis en TypedDict.
Vårt ackumulerar ämnet, forskarens anteckningar, aktuellt utkast, granskarens utslag och feedback samt en räknare för revideringar. Varje nod returnerar bara fälten den ändrade, och ramverket mergar de returerna in i det pågående objektet.
Skrivägande är där grafer först börjar förfalla.
Bestäm innan du kodar vilken nod som får skriva varje fält, för ett state-objekt som 3 olika noder kan skriva över är en felsökningssession du redan har bokat in.
Loop engineering utformar cykeln som en enskild agent upprepar tills den är klar, och grafteknik utformar koordineringen mellan flera av de cyklerna.
Detta är artikelns mest avgörande beslut, så det kommer före handledningen.
Standardsvaret är loopen.
En enda välavgränsad agent med en strikt verifierare är snabbare att bygga, billigare att köra och mycket enklare att felsöka än någon graf som gör samma jobb.
Det här är inte bara min preferens.
Ett team från UC Berkeley (försteförfattare Mert Cemri) utgår från observationen att vinster med multiagenter över en-agentupplägg ofta är minimala, och annoterar sedan 1 600+ körningsspår från 7 multiagentramverk för att ta reda på varför (arXiv:2503.13657, v3).
Deras taxonomi, byggd från närläsning av 150 av dessa spår, namnger 14 distinkta felmoder.
De 14 modena sorterar in i 3 kategorier: systemdesignfrågor, felinriktning mellan agenter och uppgiftsverifiering.
Spara den tredje tills vi når granskar-noden.
Behandla dessa som utlösare, inte en checklista.
Ett tydligt ja i högerkolumnen räcker, och 5 vaga gör det inte.
| Fråga om din uppgift | En loop hanterar det | Du vill ha en graf |
|---|---|---|
| Kan du skriva jobbet som en instruktion? | Ja, och en person kan följa den från start till mål | Det låter som ett överlämnande mellan 2 olika roller |
| Vill varje steg ha samma modell? | En modell och ett verktygsset rakt igenom | Insamling vill ha billigt och snabbt, bedömning vill ha skärpa |
| Är några steg oberoende av varandra? | Varje steg behöver föregående stegs output | Flera uppslag som alla skulle kunna köras samtidigt |
| Vem avgör att resultatet är tillräckligt bra? | Agenten läser om sitt eget arbete | Något som inte skrev det måste godkänna |
| Vad ska hända när ett steg misslyckas? | Försök igen och fortsätt | Isolera felet så att resten av körningen överlever |
| Måste någon granska den tagna vägen? | Spåret är för dig och dina kollegor | Någon utanför behöver se vilket steg som kördes, och varför |
Den överkonstruerade version jag oftast stöter på handlar inte ens om agenter. Någon behöver rensa och geokoda en lista med 800 hotelladresser, och den anländer som en 5-nods-graf: en inläsningsnod, en normaliseringsnod, en geokodare, en validerare och en skrivare, med delat state som trådar mellan dem.
Var och en av de stegen är deterministisk, så vad de faktiskt byggde är ett Python-skript på 40 rader ifört ett ramverk, och nu kostar det pengar per rad och fallerar på sätt som pandas aldrig skulle.
Rätt storlek är versionen vi strax ska bygga.
Att producera en kort researchad brief delar upp sig i arbete som en enda loop kämpar med: samla råmaterial, förvandla det till prosa och sedan bedöma den prosan utifrån.
Det tredje steget är skälet till att grafen finns, för en agent som granskar sitt eget utkast granskar inte.
Tre saker berättigar en nod.
Om du inte kan peka på en av dem för varje nod du lade till, ta bort noden och vik in dess arbete i en granne.
Äkta specialisering kommer först.
Vår forskare vill ha en billig, snabb modell och i produktion sökverktyg. Skribenten vill inte ha något av det och gynnas av en starkare modell, så delningen gör nytta i stället för att dekorera ett diagram.
För det andra, parallellism som du faktiskt märker.
Fläkt ut lönar sig när grenar är oberoende och väggklocksvinsten spelar roll för någon, och kostar dig extra komplexitet när ingetdera stämmer.
För det tredje, och detta skulle jag försvara hårdast, oberoende verifiering.
En agent som rättar sina egna läxor rättar snällt, så en separat granskar-nod med skrivskyddad åtkomst till utkastet är oftast den mest värdefulla noden i en graf.
För en ramverksnivåvy av hur olika bibliotek uttrycker dessa mönster, lägger vår jämförelse av CrewAI vs LangGraph vs AutoGen ut avvägningarna.
Vi bygger en multiagent-pipeline i LangGraph med en forskare, en skribent och en granskare som producerar en kort researchad brief och skickar tillbaka underkända utkast för revidering.
LangGraph är ett låg-nivå-orkestreringsramverk för tillståndsfulla agenter, och dess StateGraph mappar nästan en-till-en mot noder, kanter och state från föregående avsnitt.
Allt nedan kontrollerades mot langgraph 1.2.11 och langchain-anthropic 1.7.1 i september 2026.
Om biblioteket är nytt för dig täcker vår LangGraph-handledning grunderna. Det här avsnittet går snabbt, och vår guide till LangChain vs LangGraph vs LangSmith vs LangFlow reder ut vilken del av familjen som gör vad.
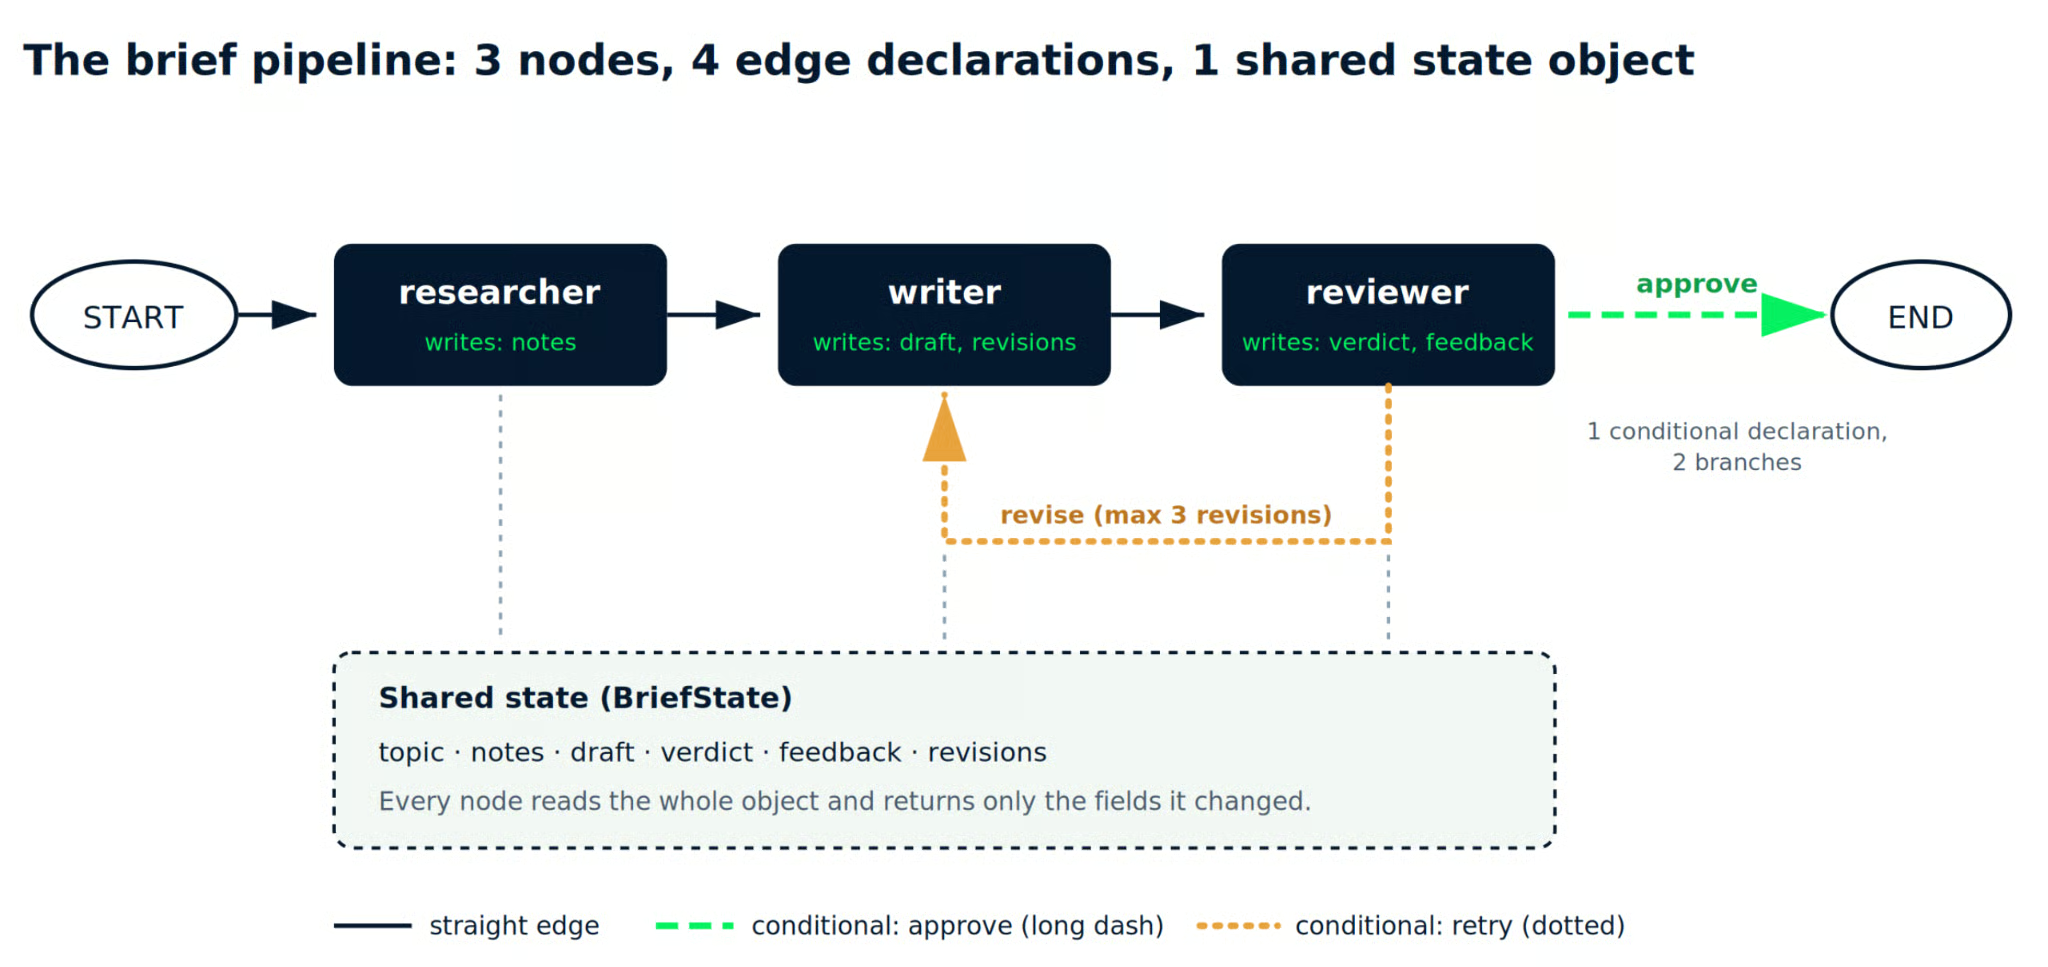
Bild av författaren. Pipelinen vi ska bygga. Heldragna linjer är de 3 raka kanterna; de streckade och prickade linjerna är de 2 grenarna av en och samma villkorade kant.
Installera paketen, plus python-dotenv så att din nyckel hålls utanför källkoden:
pip install langgraph langchain-anthropic python-dotenvSkapa en .env-fil bredvid ditt skript:
ANTHROPIC_API_KEY=sk-ant-your-key-hereNu importerna och state-schemat. Att skriva TypedDict först är värt de 2 minuterna, eftersom det är kontraktet som varje nod förbinder sig till:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Två modeller, inte en. Det är ”olika modell per steg”-triggaren från beslutsmatrisen som syns i verklig kod, eftersom research är högvolym- och lågbedömningsarbete som inte behöver den dyra modellen.
MAX_REVISIONS gör ett tyst men viktigt arbete här.
Utan ett tak kommer en strikt granskare och en envis skribent att skicka ett utkast fram och tillbaka tills din faktura blir intressant.
Varje nod följer samma kontrakt. Den tar emot aktuellt state, gör sitt enda jobb och returnerar en ordbok som bara innehåller de fält den ändrade.
Forskaren samlar råmaterial och skriver det till notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
En produktionsversion av den här noden skulle anropa ett sökverktyg i stället för att förlita sig på modellens egen kunskap.
Jag höll den som ett enda .invoke()-anrop så att grafstrukturen förblir synlig, så behandla anteckningarna den producerar som overifierade.
Skribenten läser de anteckningarna och producerar ett utkast. Den kollar också efter granskarfeedback, vilket ger omförsökskanten något att agera på:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Granskaren sätter betyg på utkastet.
Den såg aldrig skribentens resonemang och producerade ingen av texten, så den kan vara rakt på sak om resultatet.
Detta är Berkeleys taxonomis tredje felkategori, given en egen nod.
Uppgiftsverifiering faller sönder när inget oberoende kontrollerar output, så lösningen är en arbetare som inte kan rätta sina egna läxor:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Notera .text snarare än .content i alla tre noderna.
Båda returnerar en sträng för ett enkelt svar, men .text gör också rätt sak när ett svar kommer som flera innehållsblock, vilket sparar dig en förvirrande AttributeError: 'list' object has no attribute 'strip' senare.
Att parsa utslaget från första raden håller detta läsbart, och det är skört.
För allt som körs obevakat, byt ut den strängkontrollen mot LangChains strukturerade output så att utslaget kommer tillbaka som ett typat fält i stället för ett prefix du hoppades att modellen skulle respektera.
Routningsfunktionen är den villkorade kanten. Den läser state efter att granskaren körts och returnerar namnet på det som ska hända härnäst:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Håll den funktionen tyst. Ett print() inuti den hamnar på stdout medan strömningsloopen fortfarande skriver ut föregående chunk, så taknotisen dyker upp ett steg tidigt och spåret ser ur fas ut.
Revideringstaket bor här snarare än i en nod, eftersom stopp är ett kontrollflödesbeslut och kontrollflödet hör hemma på kanterna.
Montera nu grafen. Noder, sedan kanter, sedan kompilera:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Det tredje argumentet till .add_conditional_edges() är vägkartan.
Den listar varje destination som routningsfunktionen kan returnera, och LangGraph använder den för att rita grenen innan någon nod har körts.
Anropa den kompilerade grafen med ett initialt state. Endast topic och revisions behöver värden, eftersom de andra fälten fylls på allt eftersom exekveringen flyter igenom:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Det ger dig slutstatet och inget annat. Inte till mycket hjälp när en körning spårar ur.
Byt .invoke() mot .stream() med stream_mode="updates" för att se varje nod rapportera vad den skrev. Varje anrop är en separat körning med egna modellanrop, så använd det ena eller det andra i stället för att köra båda:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
Vid en körning där granskaren underkänner första utkastet skriver det ut följande:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Två saker syns där som slutstatet döljer.
Forskaren kördes en gång, och dess anteckningar bestod genom båda skrivpassen, så ett omförsök forskar inte om. Varje nod rörde också bara sina egna fält, vilket förvandlar skriväganderegeln från tidigare till något du kan verifiera.
Räkna anropen när du ändå är här.
Den underkända vägen kostar 5 modellanrop mot ungefär 1 för en enkelloopsversion av samma uppgift, och det enda sättet att veta om de extra 4 köpte dig något är att logga utslagen och läsa dem.
Du behöver inga extra verktyg för att se formen på det du byggt:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Mermaid-utdata renderar den villkorade grenen som streckade linjer från reviewer till både __end__ och tillbaka till writer.
Det bekräftar att din omförsökskant finns innan du spenderar något på modellanrop. ASCII-vyn ritar bara den raka vägen från start till slut, så använd Mermaid-utdata när du vill se loopen.
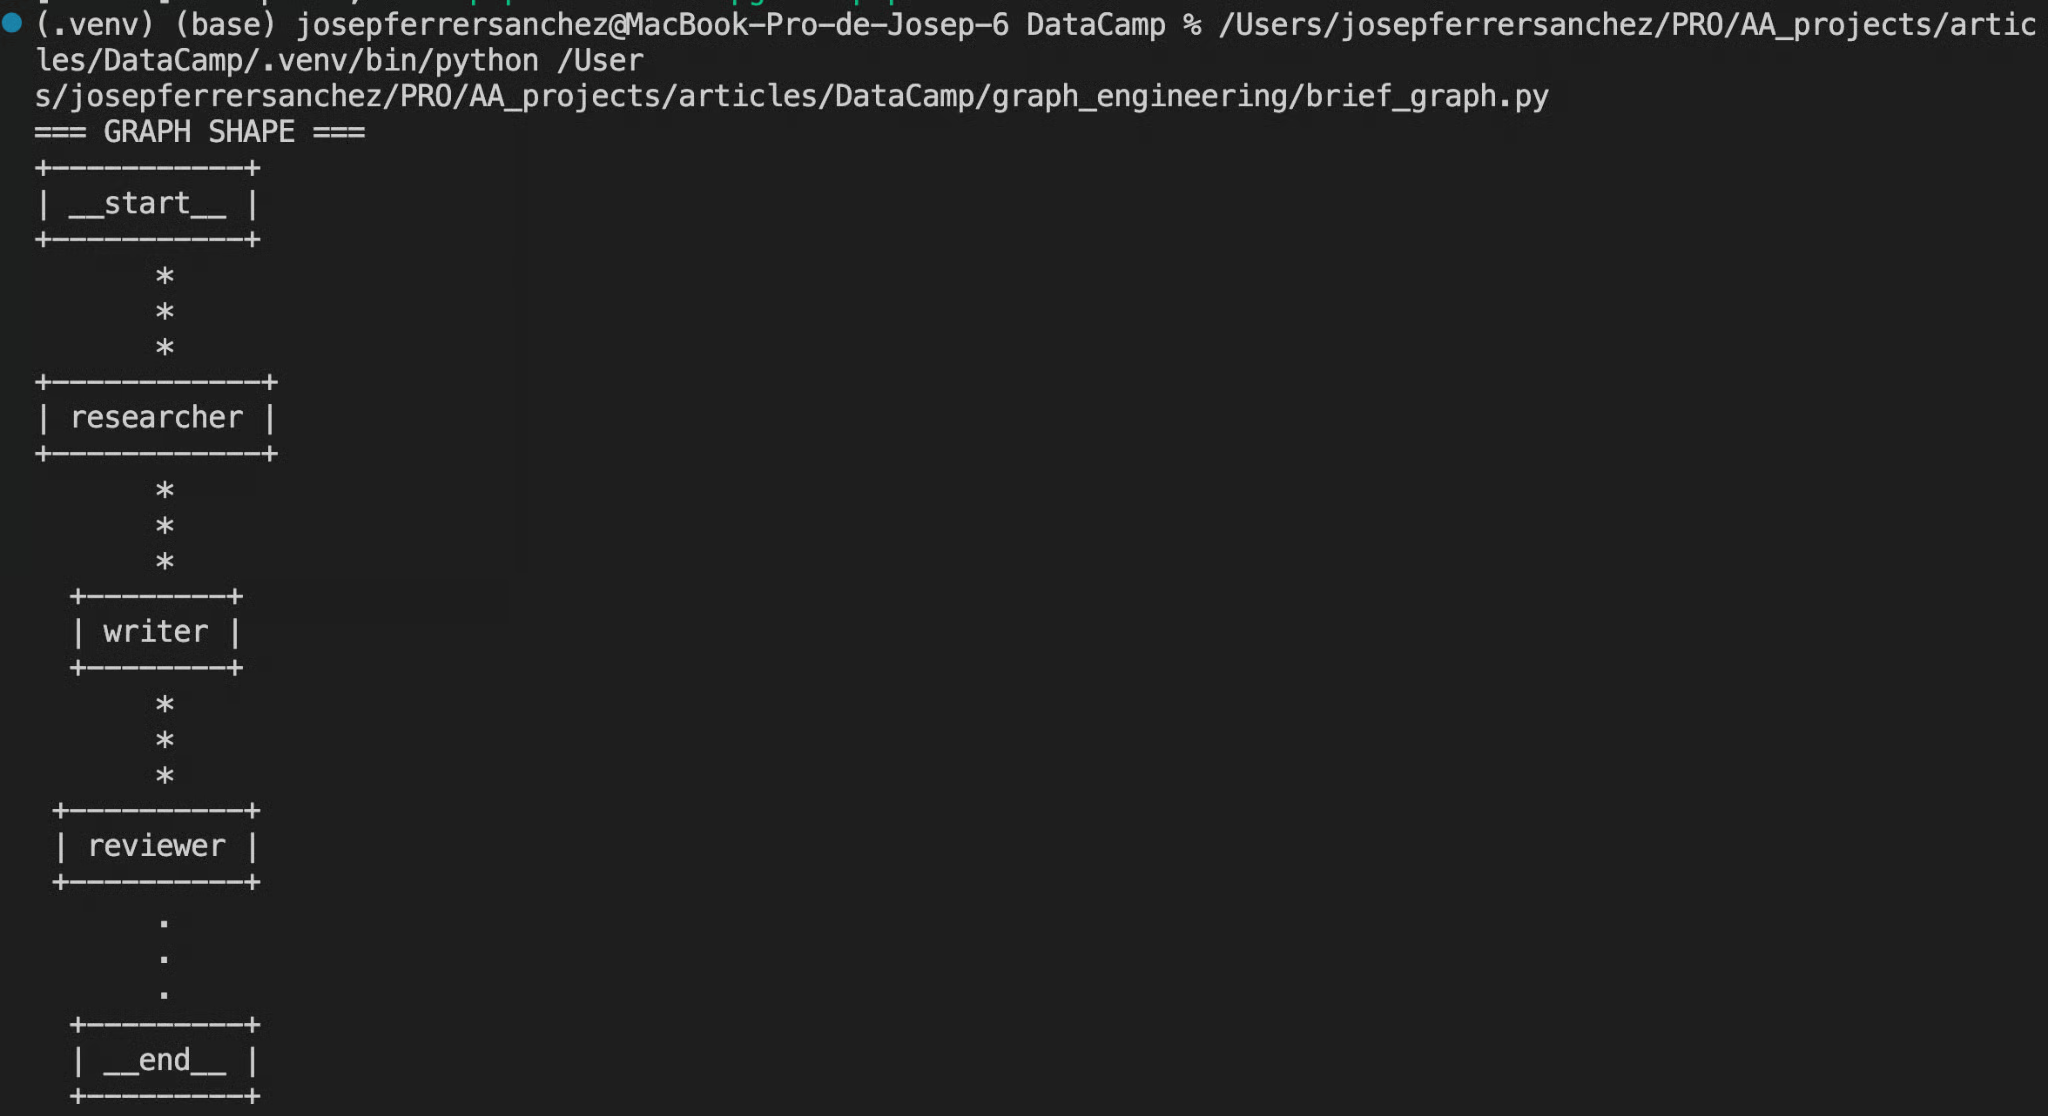
Skärmdump av författaren. Terminal som visar .draw_ascii()-utdata, med __start__, researcher, writer, reviewer och __end__ staplade vertikalt och sammankopplade.
För steg-för-steg-felsökning med state-inspektion i varje nod kopplar LangGraph Studio till en lokal server. Det kräver sitt eget paket och en konfigfil, så kör pip install "langgraph-cli[inmem]", lägg till en langgraph.json som pekar på ditt kompilerade graph-objekt, kör sedan langgraph dev och öppna Studio-URL:en den skriver ut.
Vår guide till LangGraph Studio går igenom gränssnittet (den är från 2024, så kontrollera dess uppsättningssteg mot kommandona ovan), och vår handledning om LangGraph-agenter täcker hur du lägger till riktiga verktyg i en nod som vår forskare.
En avgränsningsnot.
Den här pipelinen är sekventiell, så den demonstrerar aldrig fläkt ut, mönstret där forskaren skulle fråga flera källor samtidigt och en sammanfogningsnod skulle slå ihop resultaten.
Det är den naturliga nästa utökningen, och också där kostnaderna multipliceras snabbast.
Felmoder i agentisk AI-grafteknik upprepas tillräckligt ofta för att namnges. Detta är de tre jag kontrollerar innan jag skeppar något.
Varje nod är en loop i sig, med en prompt, verktyg och en definition av klart.
Att koppla ihop 3 skakiga noder ger dig ett skakigt system med tredubbel yta och en mycket sämre felsökningshistoria.
Få en nod att fungera ensam först.
En forskare som returnerar vaga anteckningar när du anropar den direkt returnerar vaga anteckningar i en graf också, och skribenten nedströms kommer att bygga vidare på dem med självförtroende.
Motstå att lägga logik i en nod när den hör hemma på en kant.
Stoppvillkor, grenbeslut och omförsökstak är routning, och routning hör hemma i kantfunktionen, där du kan läsa allt på en gång.
Tillämpa testet utan bindeord från tidigare.
En nod som söker källor och avgör om det finns tillräckligt av dem är två noder som delar funktionssignatur.
Fläkt ut och omförsöksloopar multiplicerar tokenanvändning på sätt som ett diagram helt döljer.
En femvägs fläkt ut som matar en sammanfogningsnod med ett omförsökstak på 3 är inte 5 anrop, och beroende på var omförsöket sitter kan det vara 15 eller fler innan du räknar sammanfogningen.
Sätt taket explicit, som vi gjorde med MAX_REVISIONS. Logga sedan tokenräkningar per nod och läs dem efter en vecka, för noden du antog var billig är oftast den som körs oftast.
AutoGen rekommenderas fortfarande för graforientering, och dess experimentella GraphFlow var verklig föregångare, men repo:t är i underhållsläge i september 2026, utan nya funktioner.
Microsoft hänvisar nya användare till Microsoft Agent Framework, som har egna grafliknande arbetsflöden, via en publicerad migreringsguide.
Från och med idag är LangGraph, Googles ADK eller Microsoft Agent Framework säkrare val, och vår kurs Building AI Agents with Google ADK täcker ADK på djupet.
Grafteknik är koordineringslagret ovanför loop engineering.
Noder gör jobbet, kanter avgör vad som körs härnäst, och ett gemensamt objekt bär information mellan dem.
Skala bort brus från juli 2026, och det är hela modellen.
Vår pipeline hölls liten med avsikt: 3 noder, 4 kantdeklarationer (1 av dem villkorad, så den ritar 2 grenar), och ett revideringstak så att omförsöket inte springer iväg.
Det var tillräcklig struktur för att få ett utkast granskat av något som inte skrev det, och den egenskapen är vad en loop inte kunde erbjuda.
Sträck dig efter en graf när arbetet delas upp i faser som behöver olika specialister, och inte en nod tidigare. Skeptikerna hade rätt i att mekaniken är decennier gammal och att det mesta som skrivs kring begreppet är brus.
De hade också rätt om delen som spelar roll en tisdag eftermiddag.
En svag verifierare kopplad till ett loopformat problem blir inte bättre för att du ritade fler rutor runt det.
För att ta dessa mönster vidare täcker vår kurs Multi-Agent Systems with LangGraph supervisor- och nätverksdesignerna som den här handledningen stannar före.
För datasidan av ordet är Graph RAG with LangChain and Neo4j ett bra nästa steg. För att stanna på orkestreringssidan bygger Text-to-Query Agents with MongoDB and LangGraph en LangGraph-pipeline mot en live-databas, och LLM Agents Explained fyller i arkitekturen under alltihop.
Det kompletta skriptet finns i mitt GitHub-repo, med hjälpare för grafrendering och en kort not om vad varje körning kostar.
Toppkurser på DataCamp
course
course
course