
Curso
Sistemas multiagente con LangGraph
2 h 45 min
8.6K
Si le das a un agente una sola tarea, se defiende bien. Si le das tres, fíjate en lo que pasa en la segunda entrega: olvida lo que encontró en el primer paso, puntúa con generosidad su propio borrador y proclama el éxito mientras el resultado sigue sin terminar.
El debate sobre ese patrón estalló a mediados de julio de 2026, cuando la "ingeniería de grafos" llegó a X (antes Twitter) y la cronología se partió entre quienes anunciaban la muerte del bucle de agentes y quienes tachaban el término de relleno de granja de contenidos.
Mi postura es que la etiqueta ingeniería de grafos es opcional, pero la escalada subyacente no lo es. Intentaré justificarlo antes de escribir una sola línea de código.
La mayoría de lo que construyas este mes debería seguir siendo un único bucle, y la forma más rápida de perder una semana es dibujar un diagrama con 6 cajas para un trabajo que necesitaba 1.
Un grafo de agentes tiene 3 partes:
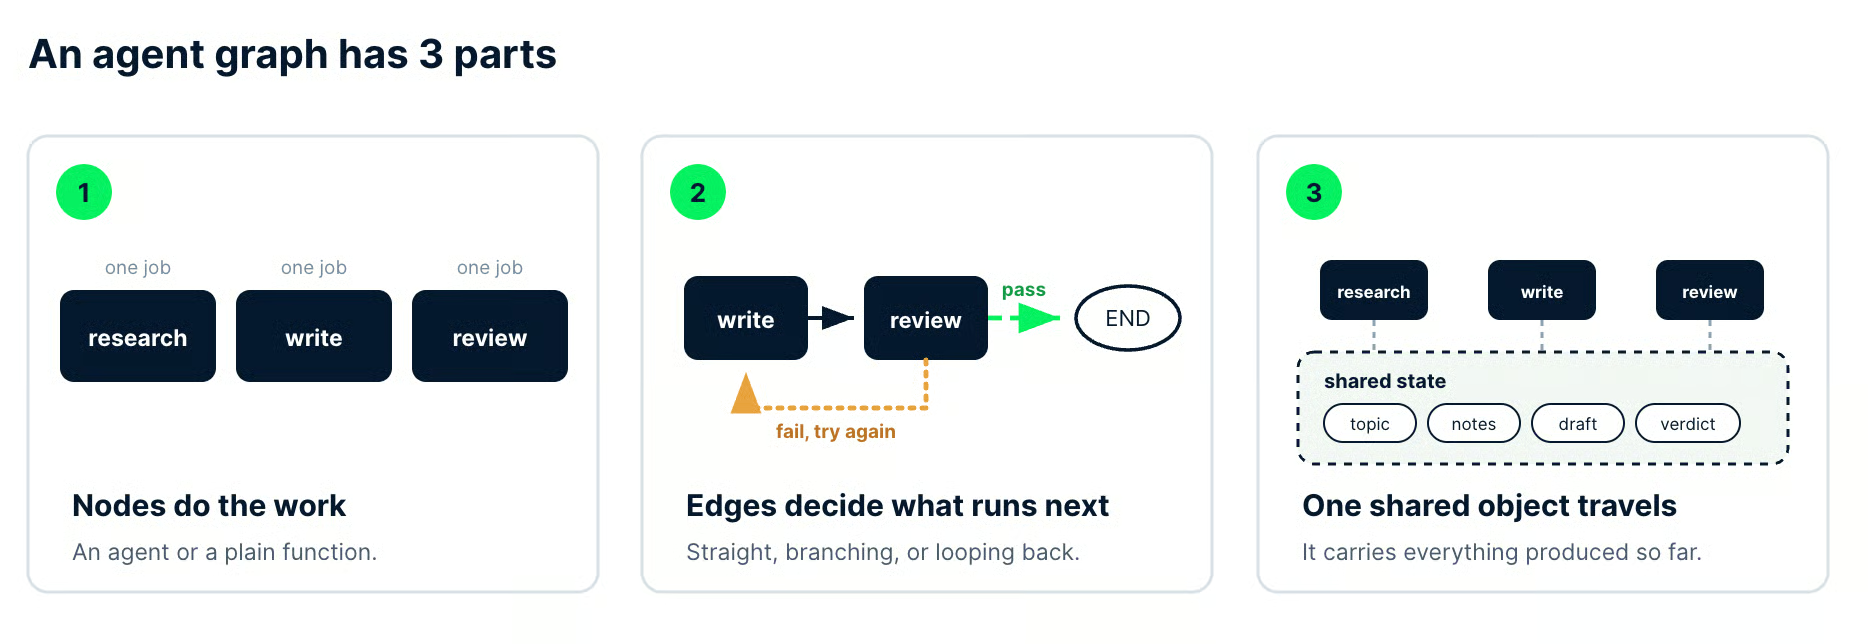
Imagen del autor. Las 3 partes aplicadas a la canalización que construiremos después: 3 nodos con nombre, un borde de aprobación y otro de reintento, y un objeto de estado que recoge el tema, las notas, el borrador y el veredicto.
Declarar las 3 desde el principio, en lugar de dejar que un único agente improvise su propio camino, es lo que describe el término ingeniería de grafos.
Este tutorial construye una canalización funcional de investigador, redactor y revisor en Python con LangGraph, incluyendo un borde condicional que devuelve los borradores fallidos para su revisión.
Necesitas Python, pip y cierta familiaridad con grandes modelos de lenguaje (LLMs) o agentes de IA. Si los agentes te suenan a nuevo, nuestro curso Introduction to AI Agents cubre los conceptos que este artículo da por supuestos, y nuestro tutorial de agentes LangGraph cubre la parte práctica.
La ingeniería de grafos es la práctica de hacer explícito en el código el flujo de control de un sistema de agentes en lugar de dejarlo al criterio del modelo.
Defines qué trabajadores especializados existen, qué transiciones entre ellos están permitidas y qué información circula por esas transiciones.
El agente sigue razonando con libertad, pero lo hace dentro de un nodo en lugar de a lo largo de todo el trabajo.
Esa última frase es toda la distinción.
En un bucle, fijas una meta y un nivel de calidad, y el agente elige su propia ruta para alcanzarlos. En un grafo, fijas la ruta y los puntos de control, así que la autonomía del modelo queda acotada por una estructura que puedes leer en un diff.
La etiqueta hizo ruido en X en julio de 2026, pero no empezó ahí. Itamar Friedman, de CodiumAI (ahora Qodo), describió un giro "de la prompt engineering a la flow (/graph) engineering" en febrero de 2024, y su equipo lo cuantificó en el paper AlphaCodium.
La precisión pass@5 de GPT-4 en el conjunto de validación CodeContests pasó del 19% con un único prompt bien diseñado al 44% con un flujo multiestadio. En ambos casos hubo 5 intentos por problema, no un único disparo.
Lo que pasó en julio de 2026 fue amplificación.
El 18 de julio, Peter Steinberger preguntó en X: "¿Seguimos hablando de bucles o ya hemos pasado a grafos?", una semana después de que Mike Masson publicara la escalera: prompt, contexto, arnés, bucle, grafo. La pregunta acumuló 3,1 millones de visualizaciones, y la expresión que difundió ya estaba en uso.
El rechazo llegó rápido. Harrison Chase, cofundador de LangChain y parte del equipo detrás de LangGraph, preguntó si todo aquello no era "básicamente solo langgraph".
Dale Everett empujó desde el otro lado argumentando que un bucle siempre fue un grafo de un solo nodo, así que la emoción de julio redescubría terreno conocido. La propia retrospectiva de LangChain, 3 Years of Graph Engineering with LangGraph, va en la misma línea, presentando los grafos de agentes como un patrón que llevan 3 años construyendo.
Así que archivo el término como un atajo útil.
Nos dio un nombre compartido para cuestiones de diseño que antes quedaban enterradas en la documentación de los frameworks, y un nombre se justifica cuando estás discutiendo arquitectura en un pull request.
La ingeniería de grafos describe la estructura de ejecución, lo que la separa de dos cosas que toman prestado su vocabulario.
Los knowledge graphs y GraphRAG describen datos.
Convierten documentos en entidades y relaciones para que un sistema de recuperación recorra las conexiones entre hechos, y tanto las herramientas como el almacenamiento y las métricas de evaluación son distintos.
Para ese significado de la palabra, nuestro tutorial sobre usar un knowledge graph para implementar una aplicación RAG es el punto de partida, junto con nuestra introducción a la teoría de grafos, que cubre las matemáticas que subyacen en ambos.
La segunda cosa que no es: una capacidad nueva.
LangGraph, el Agent Development Kit (ADK) de Google y Microsoft AutoGen ya ofrecían orquestación multiagente antes de que la etiqueta se hiciera viral; si has escrito un StateGraph, ya estabas haciendo esto.
Muchos lectores descubrirán que llevan un año haciendo ingeniería de grafos bajo el nombre de "mi pipeline de LangGraph".
Capa a capa, la ingeniería de IA toma control de algo un paso más allá del modelo.
La forma útil de leer esta tabla es la columna de la derecha, que te dice qué se rompe cuando te saltas un peldaño e intentas construir encima igualmente.
| Capa | Qué controlas | Qué se rompe si la omites |
|---|---|---|
| Prompt | El enunciado de la petición | El modelo responde a una pregunta que no hiciste |
| Contexto | Qué entradas llegan al modelo | Razona bien sobre material equivocado |
| Arnés | Herramientas, memoria, acceso a archivos y APIs | No puede tocar nada fuera de la ventana de chat |
| Bucle | El ciclo de repetir hasta terminar | Se para antes de tiempo o no se para nunca |
| Grafo | Qué trabajador va después, y con qué | Un agente intenta ser 4 y se olvida de 3 |
Saltar un peldaño es la forma más común de que fallen los proyectos con grafos, y el fallo rara vez es evidente.
Tres nodos poco fiables cableados entre sí no se convierten por promedio en un sistema fiable.
Producen un sistema que falla en más sitios, cuesta más por cada fallo y tarda más en diagnosticarse porque la salida defectuosa ahora está a 2 entregas del nodo que la causó.
Cualquier grafo de agentes, tenga 3 nodos o 30, se descompone en nodos, bordes y estado compartido.
Cuando sabes nombrar esas 3 partes en una base de código, la mayoría de frameworks de orquestación se vuelven legibles sin su documentación.
Un nodo es una unidad de trabajo con nombre y una sola responsabilidad.
Puede ser una llamada a un LLM con un prompt especializado y sus propias herramientas, o una función normal de Python que consulte una base de datos, valide un esquema o escriba un archivo.
Reserva las llamadas al modelo para pasos que necesiten juicio semántico.
Si una regla tiene respuesta conocida, ponla en Python, donde se ejecuta en microsegundos, no cuesta nada y devuelve el mismo resultado dos veces.
Esta es la prueba que uso para decidir si conviene dividir algo: intenta describir el nodo en una sola frase y sin conjunciones.
Un nodo que "recoge las fuentes y decide si tenemos suficientes" ya ha fallado la prueba, porque no puedes cambiar la parte de recuperación sin tocar la parte de juicio.
Un borde determina qué se ejecuta cuando el nodo actual termina.
Cuatro formas cubren casi todo lo que construirás:
Los bordes también son donde debe vivir tu lógica de parada. Límites de reintento, umbrales de calidad y reglas de escalado son decisiones de enrutado; mantenerlas en las funciones de borde te permite auditar el flujo de control en un solo sitio, en lugar de buscarlas dentro de los cuerpos de los nodos.
El estado compartido es el único objeto que todos los nodos leen y escriben a medida que avanza la ejecución.
Sin él, tienes varios agentes haciendo trabajos adyacentes que no se pasan nada: el redactor no ve lo que encontró el investigador, y el revisor tampoco.
En LangGraph, el estado suele ser un TypedDict.
El nuestro acumula el tema, las notas del investigador, el borrador actual, el veredicto y feedback del revisor, y un contador de revisiones. Cada nodo devuelve solo los campos que cambió, y el framework fusiona esas devoluciones en el objeto en curso.
La propiedad de escritura es donde los grafos se degradan primero.
Decide antes de programar qué nodo puede escribir cada campo, porque un objeto de estado que 3 nodos distintos pueden sobrescribir es una sesión de depuración que ya te has agendado.
La ingeniería de bucles diseña el ciclo que repite un solo agente hasta terminar, y la de grafos diseña la coordinación entre varios de esos ciclos.
Esta es la decisión más importante del artículo, así que va antes del tutorial.
La respuesta por defecto es el bucle.
Un solo agente bien acotado con un verificador estricto se construye más rápido, cuesta menos ejecutar y es mucho más fácil de depurar que cualquier grafo haciendo el mismo trabajo.
No es solo una preferencia mía.
Un equipo de UC Berkeley (primer autor Mert Cemri) parte de la observación de que las ganancias multiagente frente a configuraciones monoagente suelen ser mínimas, y anota más de 1.600 trazas de ejecución de 7 frameworks multiagente para averiguar por qué (arXiv:2503.13657, v3).
Su taxonomía, construida leyendo de cerca 150 de esas trazas, nombra 14 modos de fallo distintos.
Esos 14 modos se agrupan en 3 categorías: problemas de diseño del sistema, desalineación entre agentes y verificación de tareas.
Guárdate esa tercera hasta llegar al nodo revisor.
Tómalas como señales, no como checklist.
Un sí claro en la columna de la derecha basta; cinco vagos no.
| Pregunta sobre tu tarea | Lo maneja un bucle | Te conviene un grafo |
|---|---|---|
| ¿Puedes escribir el trabajo como una sola instrucción? | Sí, y una persona podría seguirla de principio a fin | Suena a entrega entre 2 funciones distintas |
| ¿Todos los pasos quieren el mismo modelo? | Un modelo y un set de herramientas en todo el proceso | Recopilar quiere barato y rápido; juzgar, precisión |
| ¿Algún paso no depende de otro? | Cada paso necesita la salida del anterior | Varias consultas que podrían correr a la vez |
| ¿Quién decide que la salida es suficiente? | El agente se relee a sí mismo | Alguien que no lo escribió debe dar el visto bueno |
| ¿Qué debe pasar si un paso falla? | Reinténtalo y sigue | Contén el fallo para que el resto sobreviva |
| ¿Alguien tiene que auditar el camino seguido? | La traza es para ti y tu equipo | Alguien externo debe ver qué se ejecutó y por qué |
La versión sobreingenierizada que más me encuentro ni siquiera va de agentes. Alguien necesita limpiar y geocodificar una lista de 800 direcciones de hoteles, y llega como un grafo de 5 nodos: cargador, normalizador, geocodificador, validador y escritor, con estado compartido pasando entre ellos.
Todos esos pasos son deterministas, así que lo que en realidad construyeron es un script de Python de 40 líneas disfrazado de framework, que ahora cuesta dinero por fila y falla de formas en que pandas nunca lo haría.
La versión de tamaño adecuado es la que vamos a construir.
Producir un breve con investigación se divide en trabajos con los que un único bucle se atraganta: recopilar materia prima, convertirla en prosa y luego juzgar esa prosa desde fuera.
El tercer paso es la razón de existir del grafo, porque un agente revisando su propio borrador no está revisando.
Tres cosas justifican un nodo.
Si no puedes señalar una de ellas para cada nodo que añadiste, bórralo e integra su trabajo en un vecino.
Primero, especialización real.
Nuestro investigador quiere un modelo barato y rápido y, en producción, herramientas de búsqueda. El redactor no quiere ninguna de esas y se beneficia de un modelo más potente, así que la división aporta valor en lugar de decorar un diagrama.
Segundo, paralelismo que de verdad notes.
El fan-out compensa cuando las ramas son independientes y el ahorro en tiempo de pared le importa a alguien, y te añade complejidad cuando no se cumplen ambas.
Tercero, y este lo defendería con más ahínco, verificación independiente.
Un agente corrigiendo sus deberes es indulgente, así que un nodo revisor separado con acceso de solo lectura al borrador suele ser el nodo más valioso de cualquier grafo.
Para una visión a nivel framework de cómo diferentes librerías expresan estos patrones, nuestra comparativa CrewAI vs LangGraph vs AutoGen expone los trade-offs.
Vamos a construir una canalización multiagente en LangGraph con un investigador, un redactor y un revisor que produzca un breve con investigación y devuelva los borradores fallidos para su revisión.
LangGraph es un framework de orquestación de bajo nivel para agentes con estado, y su StateGraph se mapea casi uno a uno con los nodos, bordes y estado de la sección anterior.
Todo lo de abajo se comprobó con langgraph 1.2.11 y langchain-anthropic 1.7.1 en septiembre de 2026.
Si la librería te es nueva, nuestro tutorial de LangGraph cubre los fundamentos. Esta sección va rápido, y nuestra guía LangChain vs LangGraph vs LangSmith vs LangFlow aclara qué hace cada pieza de esa familia.
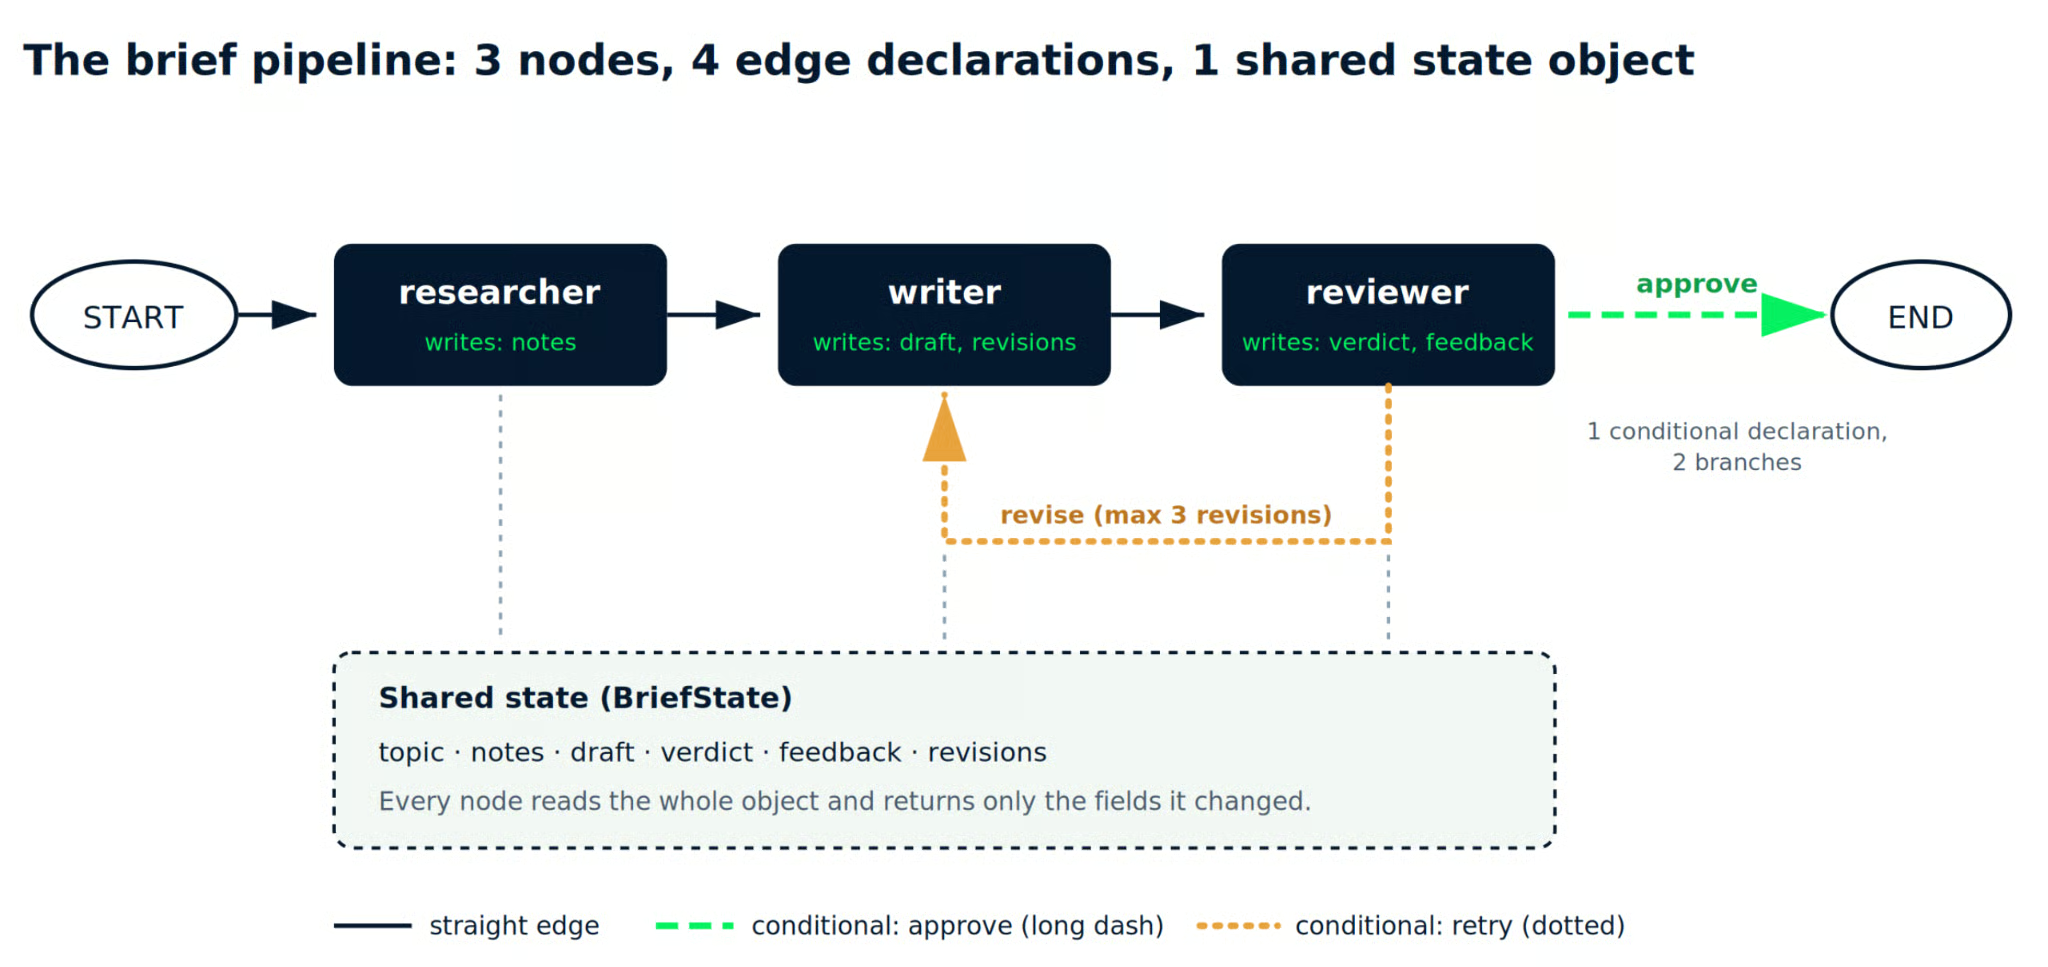
Imagen del autor. La canalización que vamos a construir. Las líneas sólidas son los 3 bordes rectos; las discontinua y de puntos son las 2 ramas de un único borde condicional.
Instala los paquetes, más python-dotenv para que tu clave no acabe en el código fuente:
pip install langgraph langchain-anthropic python-dotenvCrea un archivo .env junto a tu script:
ANTHROPIC_API_KEY=sk-ant-your-key-hereAhora los imports y el esquema del estado. Escribir primero el TypedDict compensa los 2 minutos: es el contrato que todos los nodos aceptan.
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# Un modelo barato para recopilar; uno más fuerte para redactar y revisar.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Dos modelos, no uno. Esa es la señal de "modelo diferente por paso" de la tabla de decisión aterrizando en código real: investigar es trabajo de alto volumen y bajo juicio que no necesita el modelo caro.
MAX_REVISIONS aquí hace un trabajo silencioso pero importante.
Sin tope, un revisor estricto y un redactor tozudo se pasarán un borrador de un lado a otro hasta que tu factura sea llamativa.
Todos los nodos siguen el mismo contrato. Reciben el estado actual, hacen su tarea y devuelven un diccionario con solo los campos que cambiaron.
El investigador recopila materia prima y la escribe en notes:
def researcher(state: BriefState) -> dict:
    """Recopila materia prima y la escribe como notas en el estado compartido."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
Una versión en producción de este nodo llamaría a una herramienta de búsqueda en lugar de depender del conocimiento del modelo.
Lo mantuve como una sola llamada a .invoke() para que la estructura del grafo se vea clara; trata las notas que produce como no verificadas.
El redactor lee esas notas y produce un borrador. También comprueba si hay feedback del revisor, lo que da algo a lo que agarrarse al borde de reintento:
def writer(state: BriefState) -> dict:
    """Convierte notas en un borrador aplicando el feedback del revisor en un reintento."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
El revisor puntúa el borrador.
No vio el razonamiento del redactor ni produjo el texto, así que puede ser tajante con el resultado.
Esta es la tercera categoría de la taxonomía de Berkeley, con un nodo propio.
La verificación de tareas se rompe cuando nada independiente comprueba la salida; la solución es un trabajador que no pueda corregir sus propios deberes:
def reviewer(state: BriefState) -> dict:
    """Puntúa el borrador. Este nodo nunca escribe, así que puede ser honesto."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Fíjate en .text y no en .content en los tres nodos.
Ambos devuelven un string para una respuesta simple, pero .text también hace lo correcto cuando la respuesta llega en varios bloques de contenido, lo que te ahorra un desconcertante AttributeError: 'list' object has no attribute 'strip' más adelante.
Parsear el veredicto de la primera línea mantiene esto legible, y es frágil.
Para algo desatendido, cambia esa comprobación de string por la salida estructurada de LangChain para que el veredicto vuelva como un campo tipado y no como un prefijo que confías en que el modelo respete.
La función de enrutado es el borde condicional. Lee el estado tras ejecutar el revisor y devuelve el nombre de lo que debe pasar a continuación:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """El borde condicional: envíalo o devuélvelo al redactor."""
    if state["verdict"] == "approve":
        return END
    # revisions cuenta todos los borradores, incluido el primero, así que ">" permite
    # 1 borrador original más MAX_REVISIONS reescrituras.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Mantén esa función silenciosa. Un print() dentro aterriza en stdout mientras el bucle de streaming aún imprime el chunk anterior, así que el aviso del tope aparece un paso antes y la traza parece desordenada.
El tope de revisiones vive aquí y no dentro de un nodo, porque detenerse es una decisión de control de flujo y el control de flujo pertenece a los bordes.
Ahora monta el grafo. Nodos, luego bordes y compila:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Ese tercer argumento de .add_conditional_edges() es el mapa de rutas.
Enumera todos los destinos que la función de enrutado puede devolver, y LangGraph lo usa para dibujar la rama antes de que se ejecute ningún nodo.
Invoca el grafo compilado con un estado inicial. Solo topic y revisions necesitan valores; el resto se va rellenando a medida que fluye la ejecución:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Eso te da el estado final y nada más. Poca ayuda cuando una ejecución se tuerce.
Cambia .invoke() por .stream() con stream_mode="updates" para ver cómo cada nodo informa de lo que escribió. Cada llamada es una ejecución separada con sus propias llamadas al modelo, así que usa una u otra en lugar de ejecutar ambas:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
En una ejecución donde el revisor rechaza el primer borrador, imprimirá lo siguiente:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Ahí hay dos cosas que el estado final oculta.
El investigador se ejecutó una vez y sus notas persistieron en ambas pasadas de redacción, así que un reintento no vuelve a investigar. Cada nodo tocó solo sus propios campos, convirtiendo en verificable la regla de propiedad de escritura de antes.
Ya que estás, cuenta las llamadas.
Esa ruta rechazada cuesta 5 llamadas a modelos frente a aproximadamente 1 en una versión de bucle único para la misma tarea, y la única manera de saber si las 4 extra te aportaron algo es registrar los veredictos y leerlos.
No necesitas herramientas extra para ver la forma de lo que has construido:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
La salida Mermaid representa la rama condicional con líneas discontinuas desde reviewer tanto a __end__ como de vuelta a writer.
Eso confirma que tu borde de reintento existe antes de gastar nada en llamadas a modelos. La vista ASCII solo dibuja el camino recto de inicio a fin, así que usa la salida Mermaid cuando quieras ver el bucle.
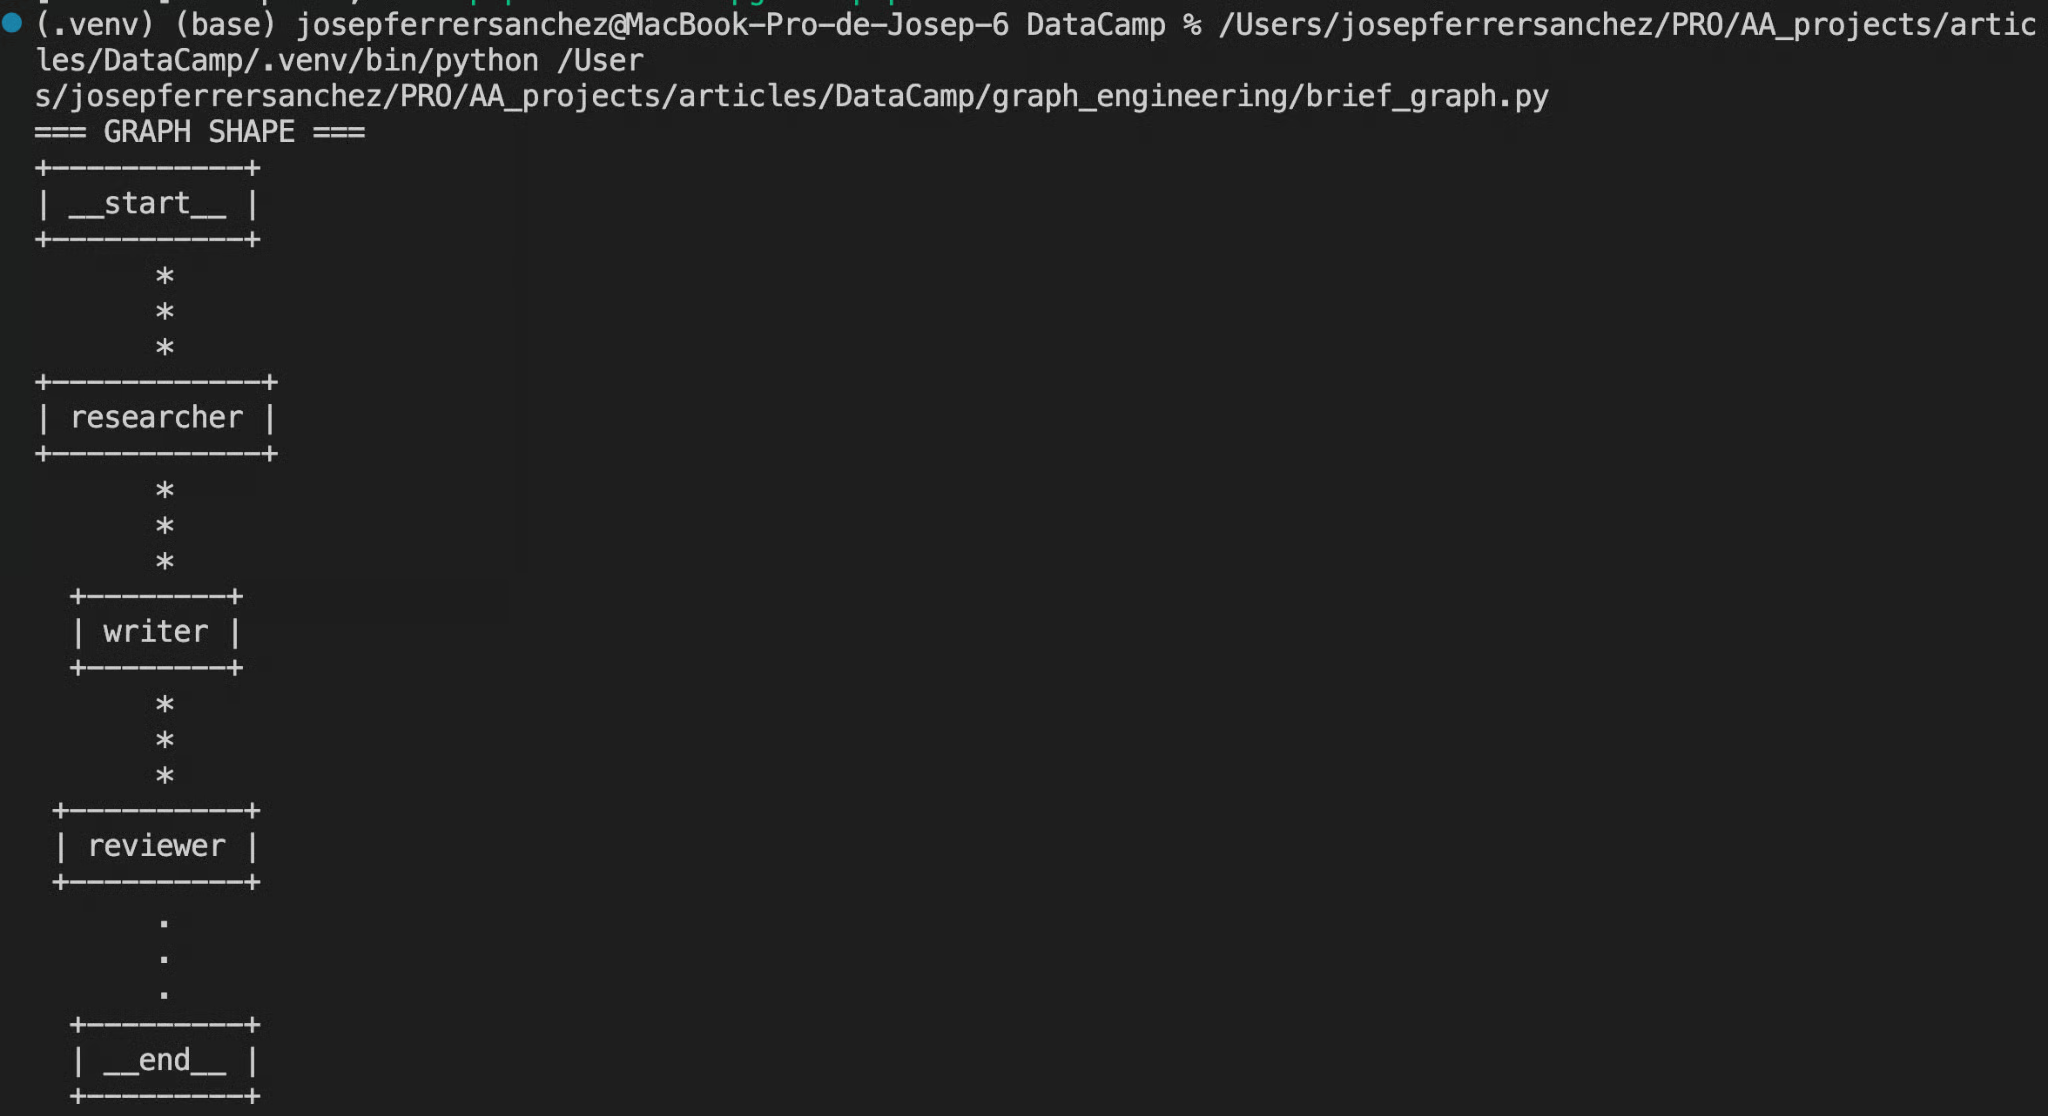
Captura del autor. Terminal mostrando la salida de .draw_ascii(), con __start__, researcher, writer, reviewer y __end__ apilados verticalmente y conectados.
Para depurar paso a paso inspeccionando el estado en cada nodo, LangGraph Studio se conecta a un servidor local. Necesita su propio paquete y un archivo de configuración, así que ejecuta pip install "langgraph-cli[inmem]", añade un langgraph.json apuntando a tu objeto graph compilado, luego ejecuta langgraph dev y abre la URL de Studio que imprime.
Nuestra guía de LangGraph Studio recorre la interfaz (data de 2024, compárala con los comandos anteriores), y nuestro tutorial de agentes LangGraph cubre cómo añadir herramientas reales a un nodo como nuestro investigador.
Una nota de alcance.
Esta canalización es secuencial, así que no demuestra fan-out, el patrón donde el investigador consultaría varias fuentes a la vez y un nodo de unión mezclaría los resultados.
Es la extensión natural siguiente y también donde los costes se multiplican más rápido.
Los modos de fallo en grafos con agentes se repiten lo suficiente como para ponerles nombre. Estos son los tres que reviso antes de enviar nada.
Cada nodo es un bucle en sí mismo, con un prompt, herramientas y una definición de terminado.
Conectar 3 nodos inestables te da un sistema inestable con el triple de superficie y una historia de depuración mucho peor.
Haz que funcione un nodo solo primero.
Un investigador que devuelve notas vagas cuando lo llamas directamente también las devolverá dentro de un grafo, y el redactor río abajo construirá con confianza sobre ellas.
Resiste meter lógica en un nodo cuando pertenece a un borde.
Condiciones de parada, decisiones de rama y topes de reintento son enrutado, y el enrutado pertenece a la función de borde, donde puedes leerlo todo de un vistazo.
Aplica la prueba sin conjunciones de antes.
Un nodo que busca fuentes y decide si hay suficientes son 2 nodos compartiendo firma.
El fan-out y los bucles de reintento multiplican el consumo de tokens de formas que un diagrama oculta por completo.
Un fan-out de 5 ramas hacia un nodo de unión con un tope de 3 reintentos no son 5 llamadas; según dónde esté el reintento, pueden ser 15 o más antes de contar la unión.
Fija el tope explícitamente, como hicimos con MAX_REVISIONS. Luego registra el consumo de tokens por nodo y léelo tras una semana, porque el nodo que asumías barato suele ser el que más se ejecuta.
AutoGen se sigue recomendando para orquestación en grafo y su trabajo experimental GraphFlow fue antecedente real, pero el repositorio está en modo mantenimiento desde septiembre de 2026, sin nuevas funciones.
Microsoft dirige a los nuevos usuarios al Microsoft Agent Framework, que tiene sus propios flujos basados en grafos, con una guía de migración publicada.
Hoy por hoy, LangGraph, el ADK de Google o Microsoft Agent Framework son opciones más seguras, y nuestro curso Building AI Agents with Google ADK cubre ADK a fondo.
La ingeniería de grafos es la capa de coordinación por encima de la ingeniería de bucles.
Los nodos hacen el trabajo, los bordes deciden qué se ejecuta después y un objeto compartido lleva la información entre ellos.
Si quitas el ruido de julio de 2026, ese es todo el modelo.
Nuestra canalización se mantuvo pequeña a propósito: 3 nodos, 4 declaraciones de bordes (1 condicional, así que dibuja 2 ramas) y un tope de revisiones para que el reintento no se nos vaya de las manos.
Fue suficiente estructura para lograr que algo que no lo escribió revisara el borrador, y esa propiedad es justo lo que un bucle no podía ofrecer.
Recurre a un grafo cuando el trabajo se divide en fases que necesitan especialistas distintos, y no un nodo antes. Los escépticos tenían razón en que la mecánica tiene décadas y que gran parte de lo escrito en torno al término es ruido.
También tenían razón en lo que importa un martes por la tarde.
Un verificador débil pegado a un problema con forma de bucle no mejora porque dibujes más cajas alrededor.
Para profundizar en estos patrones, nuestro curso Multi-Agent Systems with LangGraph cubre los diseños de supervisor y de red a los que este tutorial no llega.
Para el lado de datos del término, Graph RAG with LangChain and Neo4j es un buen siguiente paso. Si quieres seguir en la parte de orquestación, Text-to-Query Agents with MongoDB and LangGraph construye una canalización de LangGraph contra una base de datos en vivo, y LLM Agents Explained completa la arquitectura que hay debajo de todo esto.
El script completo está en mi repositorio de GitHub, con el ayudante para renderizar el grafo y una breve nota sobre el coste de cada ejecución.
Top DataCamp Courses
Curso
Curso
Curso