Course
Мультиагентные системы с LangGraph
2 ч 45 мин
8.6K
Дайте агенту одно задание — и он справится. Дайте три — и посмотрите, что произойдёт на втором переходе: он забудет, что нашёл на первом шаге, великодушно оценит собственный черновик и объявит об успехе, пока результат остаётся незаконченным.
Спор вокруг этого паттерна вспыхнул в середине июля 2026 года, когда «графовая инженерия» вышла в X (ранее Twitter), и лента тут же раскололась между теми, кто провозгласил смерть агентного цикла, и теми, кто назвал термин наполнителем для контент-ферм.
Моя позиция: ярлык «графовая инженерия» — опционален, а вот лежащая под ним эскалация — нет. Постараюсь это обосновать до того, как мы напишем первый кусок кода.
Большинство задач в этом месяце по-прежнему стоит решать одним циклом, а самый быстрый способ потратить неделю впустую — это нарисовать диаграмму с 6 блоками для работы, которой хватало одного.
У графа агентов есть 3 части:
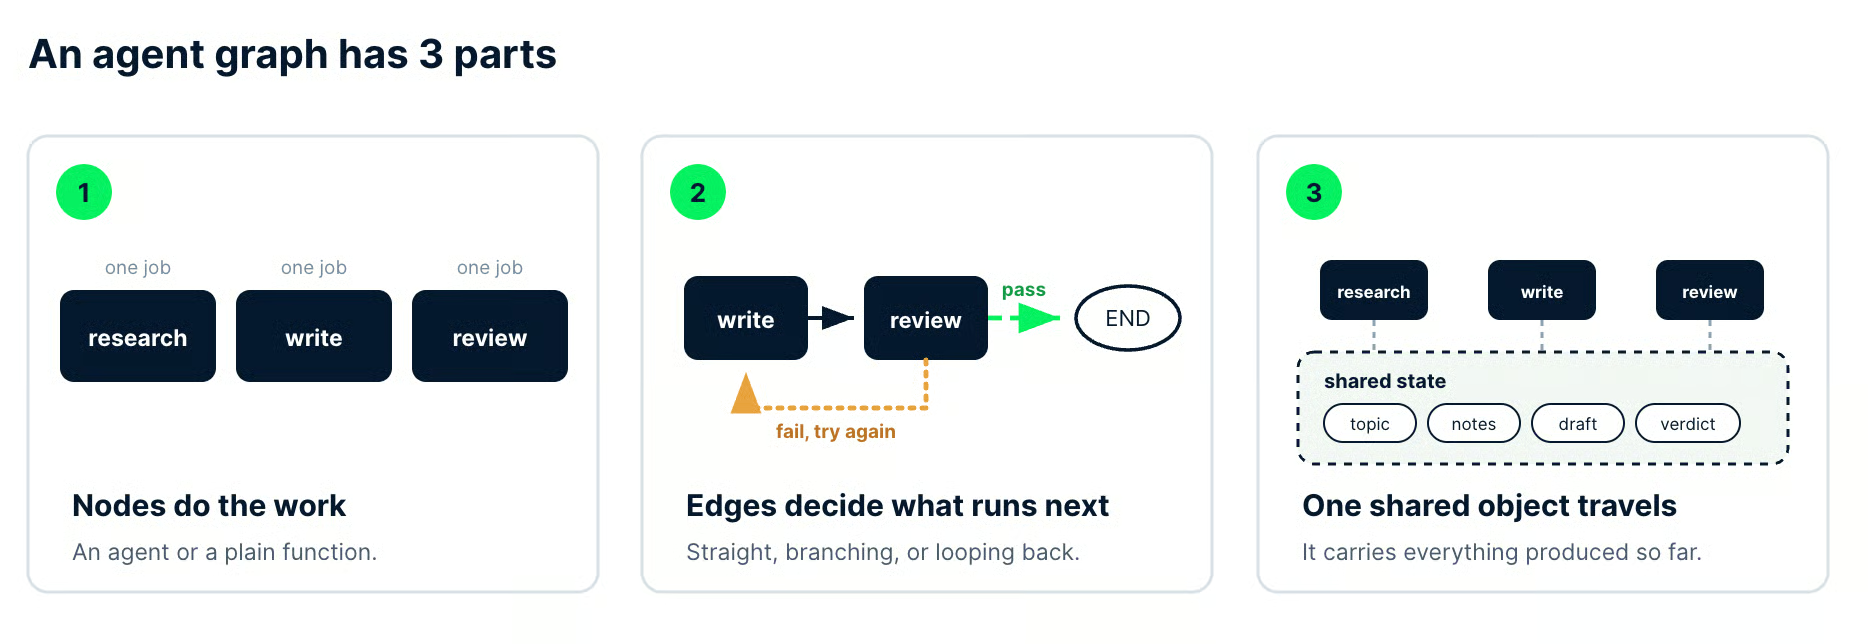
Изображение автора. Те же 3 части на конвейере, который мы соберём ниже: 3 именованных узла, ребро «pass» и ребро повторной попытки, а также один объект состояния, собирающий topic, notes, draft и verdict.
Объявить все 3 заранее, вместо того чтобы позволять одному агенту импровизировать маршрут, — это и описывает термин «графовая инженерия».
В этом руководстве мы соберём рабочий конвейер «исследователь — автор — редактор» на Python с LangGraph, включая условное ребро, которое возвращает неудачные черновики на доработку.
Вам понадобятся Python, pip и базовое знакомство с большими языковыми моделями (LLM) или AI-агентами. Если агенты в новинку, наш курс Введение в AI-агентов закрывает теорию, на которую опирается статья, а наш практический туториал по агентам LangGraph — практику.
Графовая инженерия — это практика делать управляющий поток агентной системы явным в коде, а не оставлять его на усмотрение модели.
Вы объявляете, какие специализированные исполнители существуют, какие переходы между ними допустимы и какая информация передаётся по этим переходам.
Агент по‑прежнему свободно рассуждает, но делает это внутри одного узла, а не через всю задачу.
Это и есть вся разница.
В цикле вы задаёте цель и планку качества, а агент сам выбирает маршрут, чтобы их преодолеть. В графе вы фиксируете маршрут и контрольные точки, так что автономия модели ограничена структурой, которую видно даже в diff.
Шум вокруг ярлыка поднялся в X в июле 2026, но началось не там. Итамар Фридман из CodiumAI (ныне Qodo) ещё в феврале 2024 описал сдвиг «от prompt engineering к flow (/graph) engineering», а их статья AlphaCodium дала цифры.
Точность GPT-4 pass@5 на валид. наборе CodeContests выросла с 19% при одном хорошо спроектированном промпте до 44% при многостадийном потоке. Это 5 попыток на задачу в обоих условиях, не одиночный запуск.
В июле 2026 произошла просто амплификация.
18 июля Питер Штайнбергер спросил в X: «Мы всё ещё говорим о циклах или уже перешли к графам?», через неделю после поста Майка Массона с лестницей prompt, context, harness, loop, graph. Вопрос собрал 3,1 млн просмотров, а выражение, которое он разнёс, уже было в ходу.
Возражения последовали быстро. Харрисон Чейз, сооснователь LangChain и участник команды LangGraph, спросил, не является ли всё это «по сути просто langgraph?»
Дэйл Эверетт надавил с другой стороны, утверждая, что цикл всегда был графом из одного узла, так что июльский ажиотаж переоткрыл старое. Ретроспектива самой LangChain — 3 года графовой инженерии с LangGraph — подхватывает ту же линию, описывая графы агентов как паттерн, который они строят уже 3 года.
Так что я отношу термин к полезным сокращениям.
Он дал общее имя для проектных вопросов, которые раньше прятались по документации фреймворков, а имя окупается, когда вы спорите об архитектуре в pull request.
Графовая инженерия описывает структуру исполнения, что отличает её от двух вещей, заимствующих её словарь.
Онтологические графы знаний и GraphRAG описывают данные.
Они превращают документы в сущности и связи, чтобы система извлечения могла проходить по соединениям между фактами, — инструменты, хранение и метрики оценки там совсем другие.
Для этой стороны вопроса наш туториал по использованию графа знаний в RAG-приложении — правильная отправная точка, а введение в теорию графов закрывает математику, лежащую под обоими направлениями.
Вторая вещь, чем это не является, — новая возможность.
LangGraph, Agent Development Kit (ADK) от Google и Microsoft AutoGen выпустили мультиагентную оркестрацию ещё до того, как ярлык стал вирусным, так что если вы писали StateGraph, вы уже это делали.
Многие читатели обнаружат, что занимались графовой инженерией год — под названием «мой конвейер LangGraph».
Каждый слой AI-инженерии берёт под контроль что‑то на шаг дальше от модели.
Полезнее всего читать правый столбец таблицы — он показывает, что именно ломается, если пропустить ступень и строить поверх неё.
| Слой | Что вы контролируете | Что сломается, если пропустить |
|---|---|---|
| Промпт | Формулировку запроса | Модель ответит на вопрос, который вы не задавали |
| Контекст | Какие входы доходят до модели | Она хорошо рассуждает по неверному материалу |
| Обвязка | Инструменты, память, доступ к файлам и API | Она не может тронуть ничего за пределами окна чата |
| Цикл | Повторяй-до-готово | Она останавливается рано или не останавливается вовсе |
| Граф | Кто пойдёт следующим и над чем | Один агент пытается быть 4 и забывает троих |
Пропуск ступени — самый частый способ провалить графовый проект, и провал редко очевиден.
Три ненадёжных узла, соединённых вместе, не усредняются в надёжную систему.
Получается система, которая падает в большем числе мест, стоит дороже за падение и дольше диагностируется, потому что плохой вывод теперь на 2 передачи дальше от узла, который его вызвал.
Любой граф агентов, хоть с 3 узлами, хоть с 30, раскладывается на узлы, рёбра и общее состояние.
Как только вы научились называть эти 3 части в кодовой базе, большинство оркестрационных фреймворков становятся читаемыми и без документации.
Узел — это единица работы с именем и одной ответственностью.
Это может быть вызов LLM со специализированным промптом и своими инструментами или обычная функция Python, которая делает запрос к базе, валидирует схему или пишет файл.
Оставляйте вызовы модели для шагов, где нужен семантический суд.
Если по правилу есть однозначный ответ, вынесите его в Python — там это выполняется за микросекунды, ничего не стоит и дважды вернёт один и тот же результат.
Вот тест, которым я пользуюсь, чтобы понять, надо ли делить: попробуйте описать узел одним предложением без союза.
Узел, который «тянет источники и решает, достаточно ли их», уже провалил тест, потому что вы не можете заменить часть извлечения, не тронув часть суждения.
Ребро определяет, что запустится после завершения текущего узла.
Четыре формы покрывают почти всё, что вы будете строить:
На рёбрах также должен жить и ваш стоп-логика. Лимиты ретраев, пороги качества и правила эскалации — это решения маршрутизации, и, удерживая их в функциях рёбер, вы можете аудировать управляющий поток в одном месте, а не искать его по телам узлов.
Общее состояние — это единый объект, из которого каждый узел читает и в который пишет по мере выполнения.
Без него у вас несколько агентов делают соседнюю работу и ничего друг другу не передают, так что автор не видит, что нашёл исследователь, а редактор — ни того ни другого.
В LangGraph состояние обычно — это TypedDict.
Наш аккумулирует тему, заметки исследователя, текущий черновик, вердикт и фидбек редактора, а также счётчик правок. Каждый узел возвращает только поля, которые он изменил, а фреймворк сливает эти возвращаемые данные в объект, живущий на протяжении запуска.
Право записи — первое место, где графы расползаются.
Решите до кода, какой узел имеет право писать каждое поле, потому что объект состояния, который могут перезаписывать 3 разных узла, — это дебаг-сессия, которую вы себе уже назначили.
Инжиниринг цикла проектирует цикл, который повторяет одиночный агент до завершения, а граф — координацию между несколькими такими циклами.
Это самое важное решение в статье, поэтому оно идёт до практики.
Ответ по умолчанию — цикл.
Один хорошо очерченный агент со строгим проверяющим быстрее в разработке, дешевле в запуске и значительно проще в отладке, чем любой граф для той же задачи.
И это не только моя предпочтение.
Команда UC Berkeley (первый автор Мерт Чемри) отмечает, что выигрыш мультиагентных настроек над одноагентными часто минимален, а затем аннотирует 1600+ трассировок исполнения из 7 мультиагентных фреймворков, чтобы понять почему (arXiv:2503.13657, v3).
Их таксономия, собранная из внимательного чтения 150 таких трасс, называет 14 различных режимов отказа.
Эти 14 режимов укладываются в 3 категории: проблемы системного дизайна, межагентное рассогласование и верификация задачи.
Запомните третью до узла редактора.
Воспринимайте это как триггеры, а не чек-лист.
Одного чёткого «да» в правой колонке достаточно, и 5 размытых — нет.
| Вопрос о задаче | Хватит цикла | Нужен граф |
|---|---|---|
| Можно ли описать работу одной инструкцией? | Да, и человек сможет ей следовать от начала до конца | Похоже на передачу между 2 разными ролями |
| Каждому шагу нужна одна и та же модель? | Одна модель и один набор инструментов на всём пути | Сбор хочет дёшево и быстро, оценка — остро |
| Есть шаги, не зависящие друг от друга? | Каждому шагу нужен вывод предыдущего | Несколько запросов, которые могут идти параллельно |
| Кто решает, что результат достаточно хорош? | Агент перечитывает свою работу | Кто‑то, кто это не писал, должен поставить подпись |
| Что должно происходить при сбое шага? | Повторить и продолжить | Локализовать сбой, чтобы остальной прогон выжил |
| Нужно ли кому‑то аудировать пройденный путь? | Трейс — для вас и коллег | Кто‑то извне должен видеть, какой шаг выполнился и почему |
Самый частый пример «сверхинжиниринга», с которым я сталкиваюсь, вообще не про агентов. Нужно почистить и геокодировать список из 800 адресов отелей, и он приезжает как граф из 5 узлов: загрузчик, нормализатор, геокодер, валидатор и писатель, с общим состоянием между ними.
Каждый из этих шагов детерминирован, так что фактически построили 40-строчный Python‑скрипт в обёртке фреймворка, и теперь это стоит денег за строку и падает в местах, где pandas не стал бы.
Правильный по размеру вариант — тот, который мы сейчас соберём.
Подготовка короткой исследованной записки распадается на работу, с которой один цикл справляется с трудом: сбор сырья, превращение его в текст и внешняя оценка этого текста.
Третий шаг — причина, по которой существует граф: агент, проверяющий свой черновик, — это не проверка.
Три вещи оправдывают узел.
Если вы не можете указать на одну из них для каждого добавленного узла — удалите узел и встройте его работу в соседний.
Настоящая специализация — во главе.
Наш исследователь хочет дешёвую быструю модель и, в продакшне, инструменты поиска. Автору это не нужно, но он выигрывает от более сильной модели — значит, разделение делает работу, а не украшает диаграмму.
Второе — параллелизм, который вы действительно заметите.
Fan-out окупается, когда ветви независимы и экономия по реальному времени важна для кого‑то, и добавляет сложности, когда ни то ни другое не верно.
Третье, и это я бы защищал особенно, — независимая проверка.
Агент, оценивающий свою домашнюю работу, ставит мягкие оценки, поэтому отдельный узел-редактор с доступом только на чтение к черновику обычно — самый ценный узел в любом графе.
Фреймворково, как разные библиотеки выражают эти паттерны, разбираем в сравнении CrewAI vs LangGraph vs AutoGen.
Мы строим мультиагентный конвейер LangGraph с исследователем, автором и редактором, который готовит короткую исследованную записку и возвращает неудачные черновики на доработку.
LangGraph — это низкоуровневый оркестрационный фреймворк для «состояниесодержащих» агентов, и его StateGraph почти один к одному соответствует узлам, рёбрам и состоянию из предыдущего раздела.
Всё ниже проверено на langgraph 1.2.11 и langchain-anthropic 1.7.1 в сентябре 2026.
Если библиотека для вас новая, наш туториал по LangGraph покрывает базу. Здесь темп высокий, а наш гид LangChain vs LangGraph vs LangSmith vs LangFlow поясняет, какая часть семейства за что отвечает.
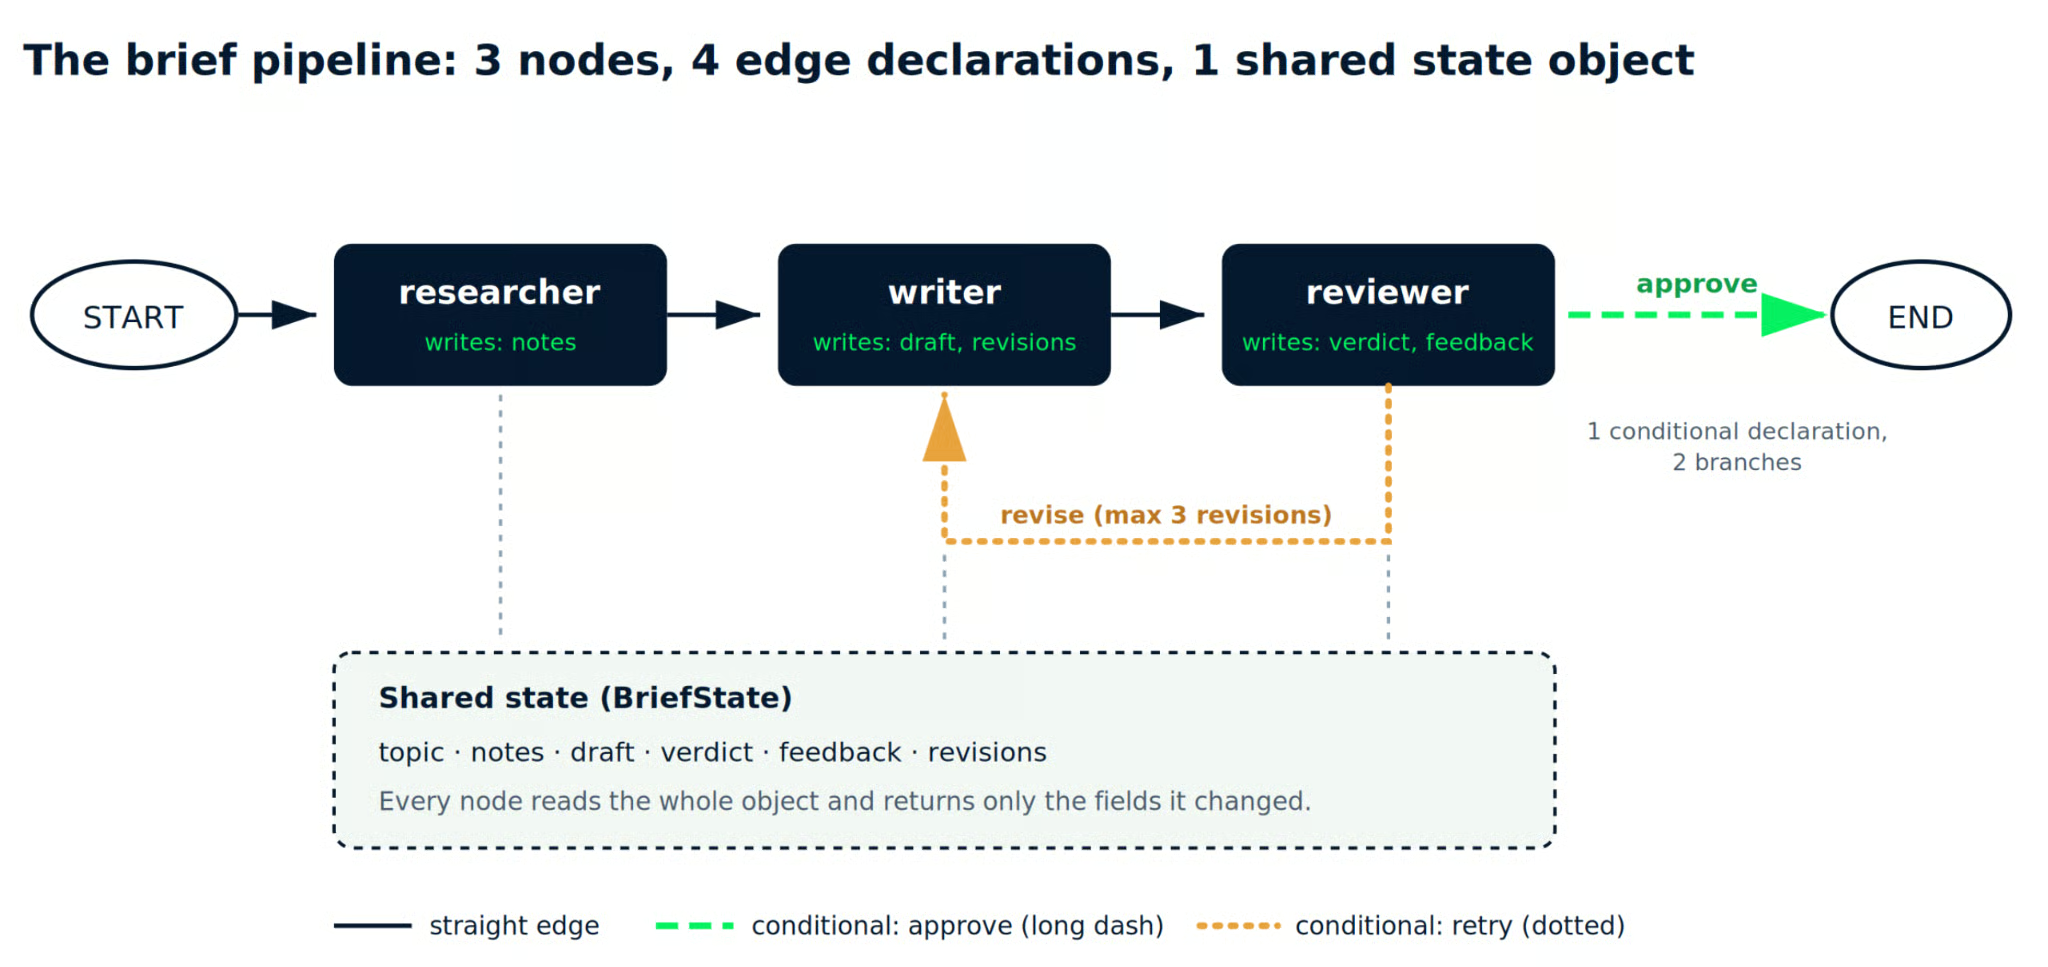
Изображение автора. Конвейер, который мы сейчас соберём. Сплошные линии — 3 прямых ребра; штриховая и пунктирная — две ветви одного условного ребра.
Установите пакеты, плюс python-dotenv, чтобы ключ не попал в исходники:
pip install langgraph langchain-anthropic python-dotenvСоздайте рядом со скриптом файл .env:
ANTHROPIC_API_KEY=sk-ant-your-key-hereТеперь импорты и схема состояния. Написать TypedDict сначала стоит тех 2 минут: это контракт, с которым согласен каждый узел:
from typing import Literal, TypedDict

from dotenv import load_dotenv
from langchain_anthropic import ChatAnthropic
from langgraph.graph import END, START, StateGraph

load_dotenv()

MAX_REVISIONS = 3

# A cheap model for gathering, a stronger one for writing and reviewing.
fast_llm = ChatAnthropic(model="claude-haiku-4-5-20251001", max_tokens=2000)
main_llm = ChatAnthropic(model="claude-sonnet-5", max_tokens=2000)


class BriefState(TypedDict):
    topic: str
    notes: str
    draft: str
    verdict: str
    feedback: str
    revisions: int
Две модели, а не одна. Это тот самый триггер «разные модели по шагам» из таблицы решений, в реальном коде: ресёрч — это объёмная и низкосудебная работа, которой не нужна дорогая модель.
MAX_REVISIONS здесь делает тихую, но важную работу.
Без лимита строгий редактор и упрямый автор будут гонять черновик туда‑сюда, пока счёт не станет занятным.
Каждый узел следует одному контракту. Он получает текущее состояние, делает свою работу и возвращает словарь только с изменёнными полями.
Исследователь собирает сырьё и записывает его в notes:
def researcher(state: BriefState) -> dict:
    """Gather raw material and write it into shared state as notes."""
    prompt = (
        f"Topic: {state['topic']}\n\n"
        "List 6 to 8 concrete facts, numbers, or named examples a writer "
        "could use. Bullet points only. No introduction, no conclusion."
    )
    response = fast_llm.invoke(prompt)
    return {"notes": response.text}
В продакшне этот узел вызывал бы инструмент поиска, а не полагался на собственные знания модели.
Здесь оставим один вызов .invoke(), чтобы структура графа оставалась видимой, так что относитесь к заметкам как к непроверенным.
Автор читает заметки и делает черновик. Он также проверяет фидбек редактора — это даёт условному ребру материал для повторного прогона:
def writer(state: BriefState) -> dict:
    """Turn notes into a draft, applying reviewer feedback on a retry."""
    feedback = state.get("feedback", "")
    revision_note = (
        f"\n\nThe reviewer rejected your last draft. Fix this: {feedback}"
        if feedback
        else ""
    )
    prompt = (
        f"Write a 200-word brief on: {state['topic']}\n\n"
        f"Use only these notes:\n{state['notes']}{revision_note}"
    )
    response = main_llm.invoke(prompt)
    return {
        "draft": response.text,
        "revisions": state.get("revisions", 0) + 1,
    }
Редактор оценивает черновик.
Он не видел рассуждений автора и не писал текст, так что может быть прямолинейным в оценке результата.
Это как раз третья категория отказов из берклиевской таксономии, вынесенная в отдельный узел.
Верификация задачи ломается, когда ничего независимого не проверяет вывод, так что фиксом служит работник, который не может проверять собственную работу:
def reviewer(state: BriefState) -> dict:
    """Score the draft. This node never writes, so it can be honest."""
    prompt = (
        "You are a skeptical editor. Reject the draft if it makes a claim "
        "the notes do not support, or if it runs past 250 words.\n\n"
        f"NOTES:\n{state['notes']}\n\nDRAFT:\n{state['draft']}\n\n"
        "Reply with APPROVE or REVISE on the first line. "
        "If REVISE, add one line explaining the single biggest problem."
    )
    response = main_llm.invoke(prompt)
    text = response.text.strip()
    verdict = "approve" if text.upper().startswith("APPROVE") else "revise"
    return {"verdict": verdict, "feedback": text}
Обратите внимание на .text, а не .content во всех трёх узлах.
Оба возвращают строку для простого ответа, но .text также правильно работает, когда ответ приходит несколькими блоками контента, что избавляет от запутывающей ошибки AttributeError: 'list' object has no attribute 'strip' позже.
Парсинг вердикта с первой строки держит код читаемым — и он хрупкий.
Для автономного запуска замените эту строковую проверку на структурированный вывод LangChain, чтобы вердикт приходил типизированным полем, а не префиксом, соблюдения которого вы надеялись от модели.
Маршрутизирующая функция — это условное ребро. Она читает состояние после работы редактора и возвращает имя того, что должно случиться дальше:
def route_after_review(state: BriefState) -> Literal["writer", "__end__"]:
    """The conditional edge: ship it, or send it back to the writer."""
    if state["verdict"] == "approve":
        return END
    # revisions counts every draft, including the first, so ">" allows
    # 1 original draft plus MAX_REVISIONS rewrites.
    if state["revisions"] > MAX_REVISIONS:
        return END
    return "writer"
Держите эту функцию без вывода. print() внутри неё попадёт в stdout, пока stream‑цикл ещё печатает предыдущий чанк, так что уведомление о лимите появится на шаг раньше, и трейс окажется не по порядку.
Лимит на правки живёт здесь, а не внутри узла, потому что остановка — это решение управляющего потока, а поток живёт на рёбрах.
Теперь собираем граф. Узлы, затем рёбра, затем компиляция:
builder = StateGraph(BriefState)

builder.add_node("researcher", researcher)
builder.add_node("writer", writer)
builder.add_node("reviewer", reviewer)

builder.add_edge(START, "researcher")
builder.add_edge("researcher", "writer")
builder.add_edge("writer", "reviewer")
builder.add_conditional_edges(
    "reviewer",
    route_after_review,
    {"writer": "writer", END: END},
)

graph = builder.compile()
Третий аргумент в .add_conditional_edges() — это карта путей.
Она перечисляет все назначения, которые может вернуть маршрутизатор, и LangGraph рисует ветку ещё до запуска любого узла.
Вызовите скомпилированный граф с начальными значениями состояния. Нужны только topic и revisions, остальные поля заполнятся по мере выполнения:
result = graph.invoke(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0}
)

if result["verdict"] != "approve":
    print(f"Hit the {MAX_REVISIONS}-revision cap. Shipped as is.")

print(f"Revisions: {result['revisions']}")
print(f"Verdict: {result['verdict']}")
print(result["draft"])
Это даёт только финальное состояние и ничего между. Слабо помогает, если прогон пошёл набок.
Замените .invoke() на .stream() с stream_mode="updates", чтобы видеть, как каждый узел сообщает, что он записал. Каждый вызов — отдельный прогон со своими вызовами модели, так что используйте что‑то одно, а не оба подряд:
for step in graph.stream(
    {"topic": "Why Postgres beat MongoDB for most startups", "revisions": 0},
    stream_mode="updates",
):
    for node, update in step.items():
        print(f"[{node}] wrote: {list(update.keys())}")
В прогоне, где редактор отклоняет первый черновик, это напечатает следующее:
[researcher] wrote: ['notes']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
[writer] wrote: ['draft', 'revisions']
[reviewer] wrote: ['verdict', 'feedback']
Здесь видны две вещи, которых не видно в финальном состоянии.
Исследователь отработал один раз, и его заметки сохранились через обе авторские прогоны — повтор не запрашивает ресёрч заново. Каждый узел трогал только свои поля — правило права записи из предыдущего раздела превращается в то, что можно проверить.
Пока вы здесь, посчитайте вызовы.
Отклонённый путь стоит 5 вызовов модели против примерно 1 у одноцикловой версии той же задачи, и единственный способ понять, купили ли лишние 4 что‑то полезное, — логировать вердикты и читать их.
Дополнительные инструменты не нужны, чтобы увидеть форму построенного:
print(graph.get_graph().draw_ascii())      # needs: pip install grandalf
print(graph.get_graph().draw_mermaid())    # paste into any Mermaid renderer
Вывод Mermaid отрисует условную ветку штриховыми линиями от reviewer к __end__ и обратно к writer.
Так вы подтвердите наличие ребра-повтора до расходов на вызовы модели. ASCII‑вид рисует только прямой путь от старта к финишу, так что, чтобы увидеть цикл, используйте Mermaid.
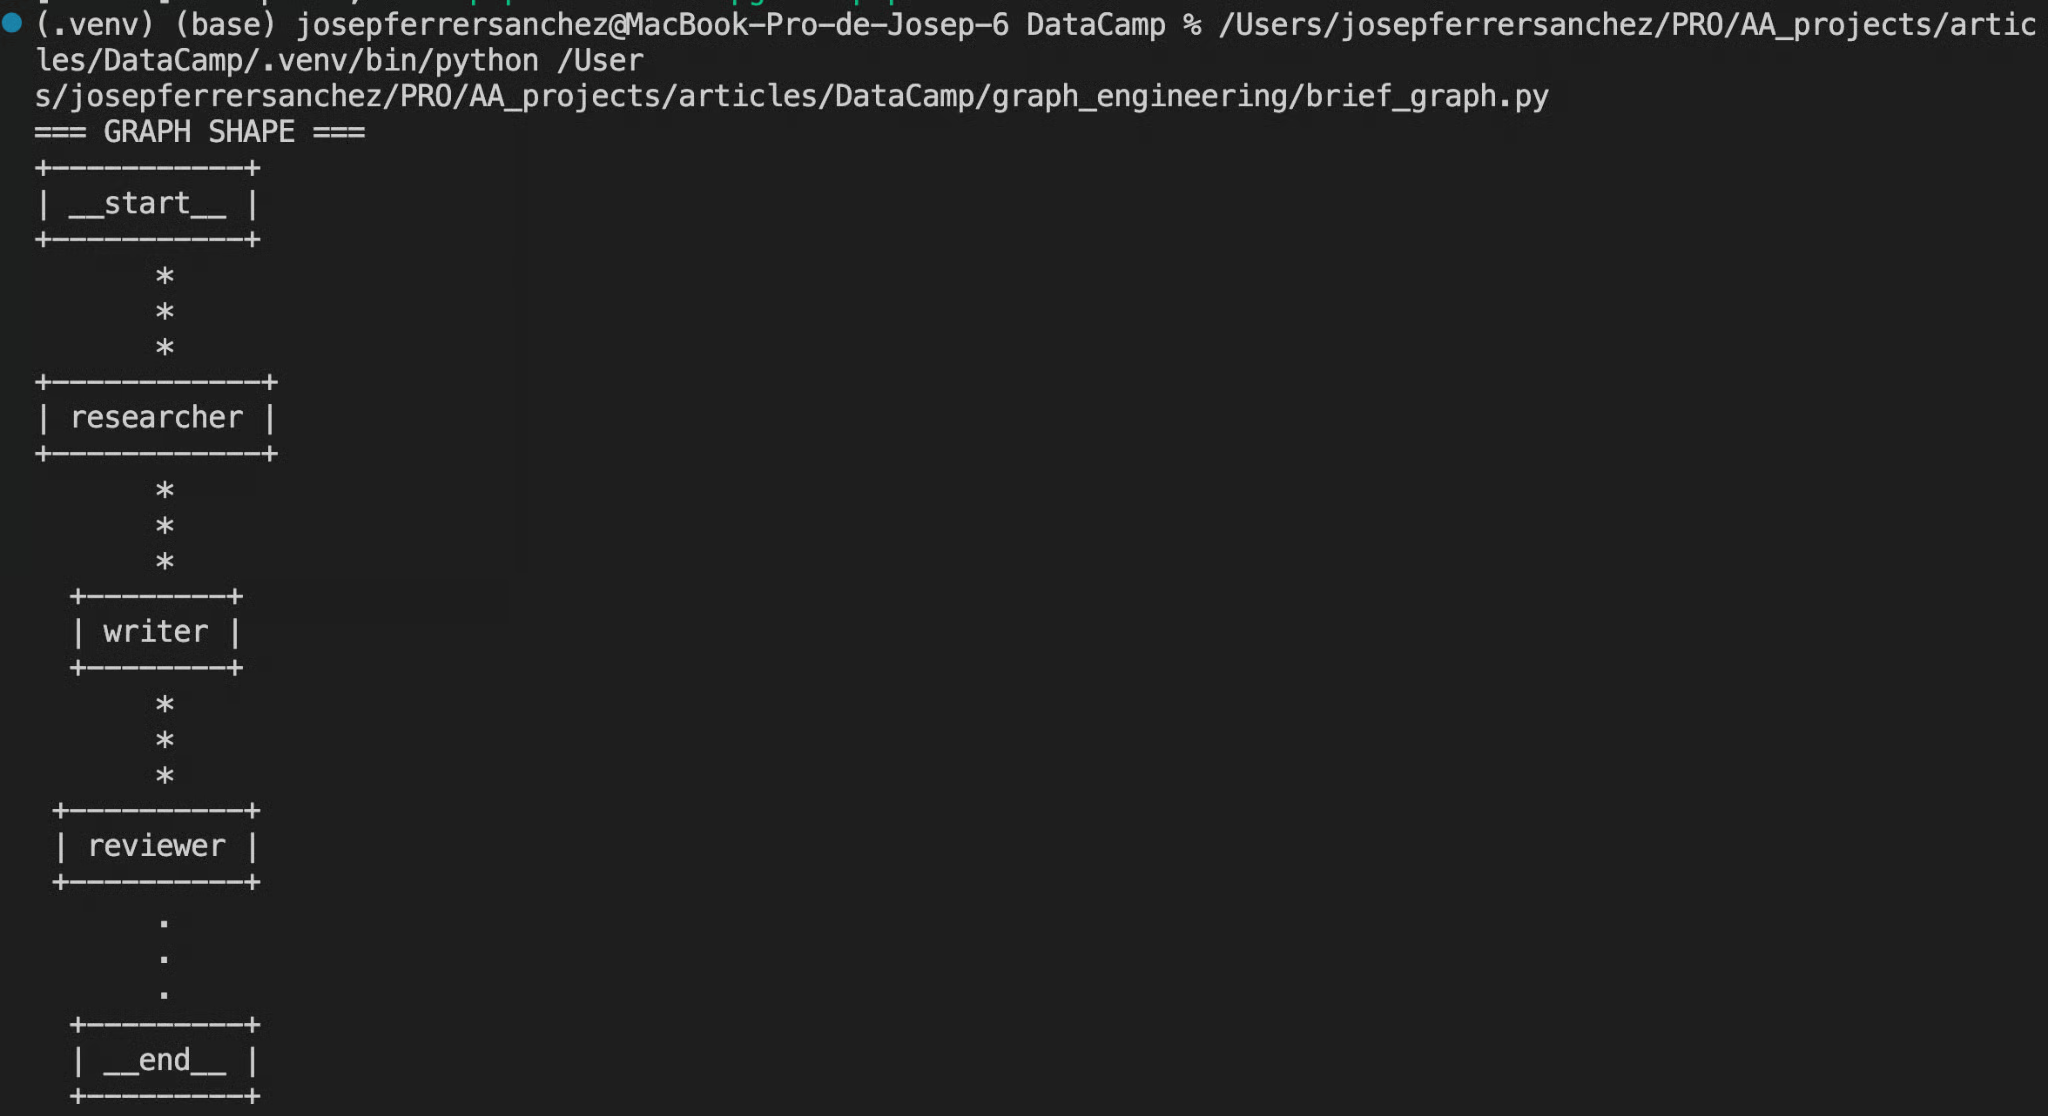
Скриншот автора. Терминал с выводом .draw_ascii(): __start__, researcher, writer, reviewer и __end__ вертикально и соединены.
Для пошаговой отладки с инспекцией состояния на каждом узле LangGraph Studio подключается к локальному серверу. Понадобится отдельный пакет и конфиг: pip install "langgraph-cli[inmem]", добавьте langgraph.json, указывающий на ваш скомпилированный объект graph, затем запустите langgraph dev и откройте выведенный URL Studio.
Наш гайд по LangGraph Studio проводит по интерфейсу (он с 2024 года, так что сверьте шаги настройки с командами выше), а туториал по агентам LangGraph покрывает добавление реальных инструментов в узел наподобие нашего исследователя.
Ограничение по охвату.
Этот конвейер последовательный, так что он не демонстрирует fan-out — паттерн, где исследователь спрашивает сразу несколько источников, а узел-сведение объединяет результаты.
Это естественное следующее расширение — и место, где быстрее всего растут расходы.
Режимы отказов в графовой инженерии агентного ИИ повторяются достаточно часто, чтобы их назвать. Вот три пункта, которые я проверяю перед релизом.
Каждый узел — это по сути цикл с промптом, инструментами и определением готовности.
Соединить 3 шатких узла — значит получить шаткую систему с тройной площадью атаки и куда худшей историей отладки.
Сначала доведите один узел до ума в одиночку.
Исследователь, который возвращает расплывчатые заметки в прямом вызове, вернёт расплывчатые заметки и внутри графа — а автор вниз по потоку уверенно на них опрётся.
Сопротивляйтесь добавлению логики в узел, если ей место на ребре.
Условия остановки, решения о ветвлении и лимиты повторов — это маршрутизация, а маршрутизация принадлежит функции ребра, где всё видно сразу.
Применяйте тест «без союза» из выше.
Узел, который ищет источники и решает, достаточно ли их, — это 2 узла, разделяющих сигнатуру.
Fan-out и циклы повторов умножают токены так, как диаграмма полностью скрывает.
Пятикратный fan-out, ведущий в узел-сведение с лимитом в 3 повтора, — это не 5 вызовов; в зависимости от места ретрая, это может быть 15 и больше до учёта сведения.
Поставьте лимит явно, как мы сделали с MAX_REVISIONS. Затем логируйте помодульные токены и перечитайте через неделю — обычно чаще всего бегает узел, который вы считали дешёвым.
AutoGen до сих пор рекомендуют для оркестрации графов, и его экспериментальный GraphFlow был настоящим приоритетом, но репозиторий с сентября 2026 в режиме поддержки, без новых фич.
Microsoft направляет новых пользователей в Microsoft Agent Framework с графовыми воркфлоу, через опубликованный гайд миграции.
На сегодня более безопасный выбор — LangGraph, ADK от Google или Microsoft Agent Framework, а наш курс Построение AI-агентов с Google ADK подробно покрывает ADK.
Графовая инженерия — это слой координации над инженерией цикла.
Узлы делают работу, рёбра решают, что пойдёт дальше, а один общий объект переносит информацию между ними.
Если отбросить шум июльской ленты 2026, это вся модель.
Наш конвейер намеренно остался небольшим: 3 узла, 4 объявления рёбер (1 из них условное, так что рисует 2 ветви) и лимит правок, чтобы ретрай не убежал от нас.
Этой структуры хватило, чтобы черновик проверил кто‑то, кто его не писал, — и именно это свойство цикл дать не мог.
Тянитесь к графу, когда работа распадается на фазы, требующие разных специалистов, и ни одним узлом раньше. Скептики были правы: механика десятилетиями как известна, а большая часть текстов вокруг термина — шум.
Они были правы и в том, что важно во вторник днём.
Слабый проверяющий, приделанный к задаче, имеющей форму цикла, не станет лучше от того, что вы нарисуете вокруг больше коробок.
Чтобы продвинуться дальше, наш курс Мультиагентные системы с LangGraph покрывает дизайны супервизора и сети, на которых это руководство останавливается.
Для «данных» в этом слове курс Graph RAG с LangChain и Neo4j — хороший следующий шаг. Чтобы остаться на стороне оркестрации, курс Агенты Text-to-Query с MongoDB и LangGraph строит конвейер LangGraph поверх живой базы, а LLM-агенты: объяснение заполняет архитектуру под всем этим.
Полный скрипт — в моём репозитории на GitHub, вместе с помощником для рендеринга графа и короткой заметкой о стоимости каждого прогона.
Лучшие курсы DataCamp
Course
Course
Course