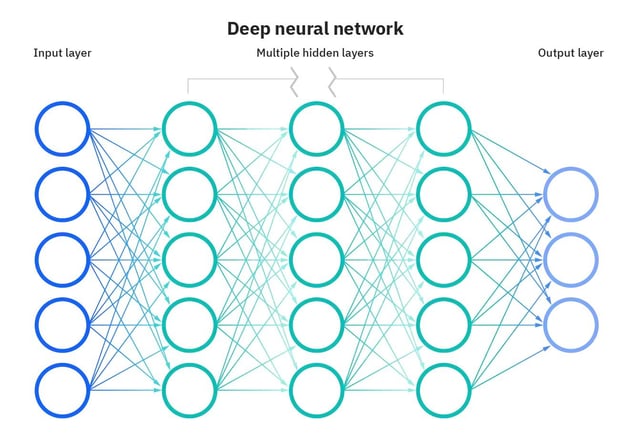
Biểu diễn mạng nơ-ron. Nguồn ảnh
Hàm kích hoạt là gì?
Hàm kích hoạt là một khối xây dựng không thể thiếu của mạng nơ-ron, cho phép chúng học được các mẫu phức tạp trong dữ liệu. Chúng biến đổi tín hiệu đầu vào của một nút trong mạng nơ-ron thành tín hiệu đầu ra để truyền sang tầng kế tiếp. Không có hàm kích hoạt, mạng nơ-ron sẽ chỉ mô hình hóa được các mối quan hệ tuyến tính giữa đầu vào và đầu ra.
Hàm kích hoạt đưa vào tính phi tuyến, cho phép mạng nơ-ron học được các ánh xạ rất phức tạp giữa đầu vào và đầu ra.
Việc chọn đúng hàm kích hoạt có ý nghĩa quyết định đối với việc huấn luyện các mạng nơ-ron có khả năng khái quát tốt và đưa ra dự đoán chính xác. Trong bài viết này, chúng tôi sẽ điểm qua những hàm kích hoạt phổ biến nhất, vai trò của chúng và cách chọn hàm kích hoạt phù hợp cho các trường hợp sử dụng khác nhau.
Dù bạn mới bắt đầu với học sâu hay là người đã có kinh nghiệm, nắm vững hàm kích hoạt sẽ giúp bạn hình thành trực giác và nâng cao hiệu quả áp dụng mạng nơ-ron.
Vì sao hàm kích hoạt lại thiết yếu?
Nếu không có hàm kích hoạt, mạng nơ-ron chỉ gồm các phép toán tuyến tính như nhân ma trận. Tất cả các tầng sẽ thực hiện biến đổi tuyến tính của đầu vào và không đưa vào bất kỳ tính phi tuyến nào.
Hầu hết dữ liệu đời thực là phi tuyến. Ví dụ, mối quan hệ giữa giá nhà và diện tích, giữa thu nhập và hành vi mua sắm, v.v., đều phi tuyến. Nếu mạng nơ-ron không có hàm kích hoạt, chúng sẽ không học được các mẫu phi tuyến phức tạp tồn tại trong dữ liệu đời thực.
Hàm kích hoạt cho phép mạng nơ-ron học các mối quan hệ phi tuyến này bằng cách đưa vào hành vi phi tuyến thông qua chính các hàm kích hoạt. Điều này làm tăng đáng kể sự linh hoạt và sức mạnh của mạng nơ-ron trong việc mô hình hóa dữ liệu phức tạp và tinh tế.
Các loại hàm kích hoạt
Mạng nơ-ron sử dụng nhiều loại hàm kích hoạt để đưa vào tính phi tuyến và học các mẫu phức tạp. Mỗi hàm có những đặc tính riêng và phù hợp với một số trường hợp sử dụng nhất định.
Ví dụ, hàm sigmoid lý tưởng cho bài toán phân loại nhị phân, softmax hữu ích cho dự đoán đa lớp, còn ReLU giúp khắc phục vấn đề tiêu biến đạo hàm.
Sử dụng đúng hàm kích hoạt cho nhiệm vụ sẽ giúp huấn luyện nhanh hơn và đạt hiệu năng tốt hơn.
Hãy cùng xem một số hàm kích hoạt phổ biến:
Kích hoạt tuyến tính
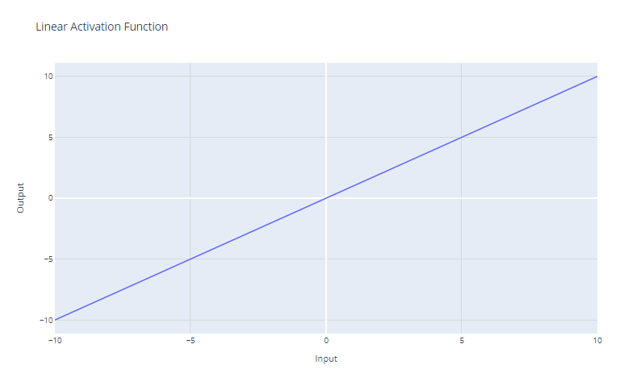
Hàm kích hoạt tuyến tính. Ảnh: Tác giả
Hàm kích hoạt tuyến tính là hàm đơn giản nhất, được định nghĩa như sau:
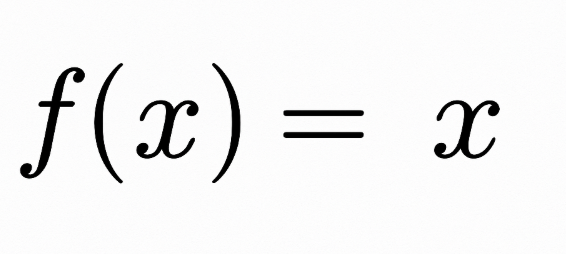
Nó đơn giản trả về đầu vào x làm đầu ra. Về đồ thị, nó là một đường thẳng có độ dốc bằng 1.
Trường hợp sử dụng chính của hàm tuyến tính là ở tầng đầu ra của mạng nơ-ron dùng cho hồi quy. Với các bài toán hồi quy cần dự đoán giá trị số, dùng hàm tuyến tính ở tầng đầu ra đảm bảo mạng nơ-ron xuất ra một giá trị số. Hàm tuyến tính không nén hay biến đổi đầu ra, nên trả lại chính giá trị dự đoán.
Tuy nhiên, hàm tuyến tính hiếm khi được dùng ở các tầng ẩn của mạng nơ-ron vì nó không mang lại tính phi tuyến. Mục đích của các tầng ẩn là học các tổ hợp phi tuyến của đặc trưng đầu vào. Dùng tuyến tính xuyên suốt sẽ giới hạn mô hình chỉ học các biến đổi tuyến tính của đầu vào.
Kích hoạt sigmoid
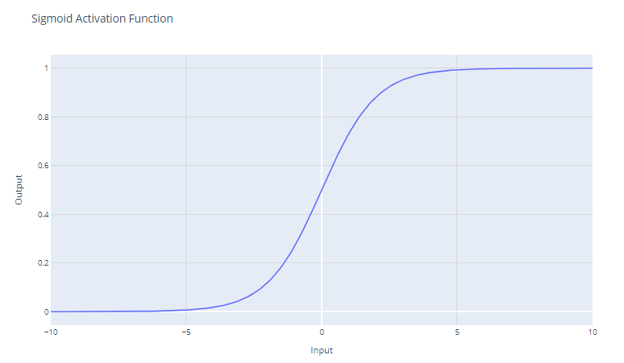
Hàm kích hoạt sigmoid. Ảnh: Tác giả
Hàm kích hoạt sigmoid, thường ký hiệu là σ(x), là một hàm trơn, khả vi liên tục, có ý nghĩa lịch sử trong sự phát triển của mạng nơ-ron. Hàm sigmoid có dạng toán học:
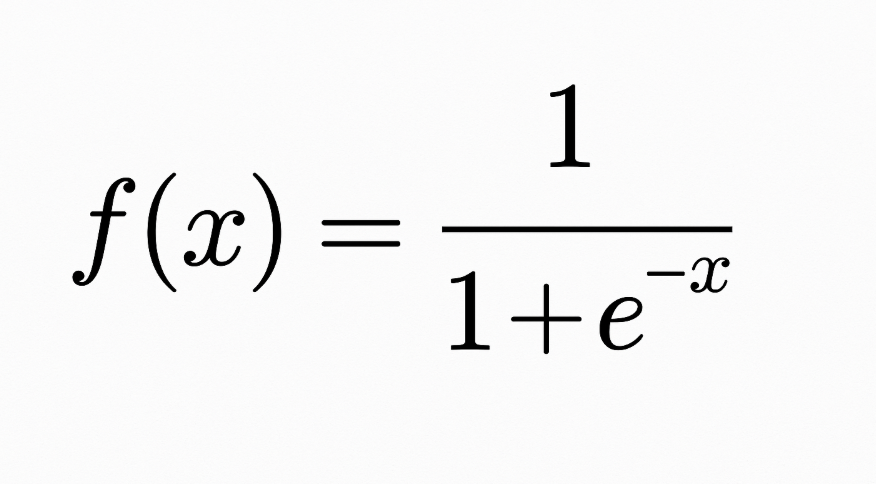
Nó nhận đầu vào là số thực và nén về khoảng từ 0 đến 1. Đường cong sigmoid có dạng chữ "S", tiệm cận 0 khi giá trị âm lớn và tiệm cận 1 khi giá trị dương lớn. Đầu ra dễ được diễn giải như xác suất, nên rất tự nhiên cho các bài toán phân loại nhị phân.
Các nút sigmoid từng phổ biến trong những mạng nơ-ron đầu tiên vì độ dốc là mạnh nhất khi đầu ra của nút gần 0,5, cho phép huấn luyện lan truyền ngược hiệu quả. Tuy vậy, sigmoid gặp vấn đề "tiêu biến đạo hàm" gây cản trở việc học ở các mạng sâu.
Khi đầu vào trở nên dương hoặc âm rất lớn, hàm bão hòa tại 0 hoặc 1 với độ dốc cực nhỏ. Ở những vùng này, đạo hàm gần bằng 0, dẫn đến các thay đổi rất nhỏ ở trọng số trong quá trình lan truyền ngược, đặc biệt với các nơ-ron ở tầng đầu của mạng sâu, khiến việc học cực chậm hoặc dừng hẳn. Đây là vấn đề tiêu biến đạo hàm trong mạng nơ-ron.
Trường hợp sử dụng chính của sigmoid là làm hàm kích hoạt cho tầng đầu ra của mô hình phân loại nhị phân. Nó nén đầu ra về giá trị xác suất từ 0 đến 1, có thể hiểu là xác suất đầu vào thuộc về một lớp cụ thể.
Kích hoạt tanh (hyperbolic tangent)
Hàm kích hoạt tanh. Ảnh: Tác giả
Hàm kích hoạt tanh (hyperbolic tangent) được định nghĩa như sau:
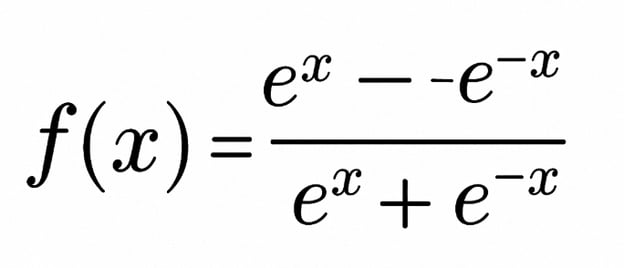
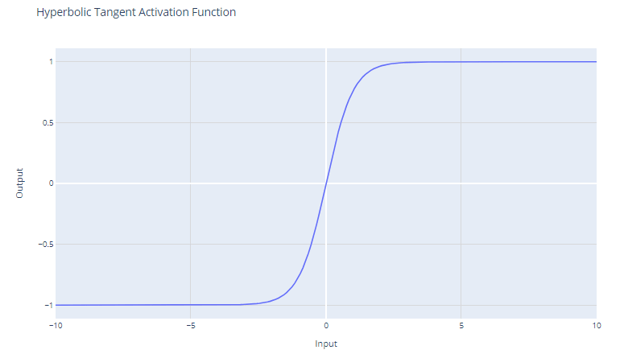
Hàm tanh cho đầu ra trong khoảng từ -1 đến +1. Điều này có nghĩa là nó xử lý giá trị âm hiệu quả hơn sigmoid, vốn có miền giá trị từ 0 đến 1.
Khác với sigmoid, tanh là hàm lấy 0 làm tâm, tức đầu ra đối xứng quanh gốc toạ độ. Đây thường được xem là một lợi thế vì có thể giúp thuật toán học hội tụ nhanh hơn.
Do đầu ra của tanh nằm giữa -1 và +1, nó có đạo hàm mạnh hơn sigmoid. Đạo hàm mạnh hơn thường dẫn đến học và hội tụ nhanh hơn trong huấn luyện vì thường chống chịu tốt hơn trước vấn đề tiêu biến đạo hàm so với đạo hàm của sigmoid.
Dù có những ưu điểm này, tanh vẫn gặp vấn đề tiêu biến đạo hàm. Trong lan truyền ngược, đạo hàm của tanh có thể rất nhỏ (gần 0). Vấn đề này đặc biệt nghiêm trọng với mạng sâu nhiều tầng; đạo hàm của hàm mất mát có thể trở nên quá nhỏ để tạo ra thay đổi đáng kể ở trọng số khi lan truyền ngược về các tầng đầu. Điều này có thể làm chậm đáng kể quá trình huấn luyện và dẫn đến đặc tính hội tụ kém.
Hàm tanh thường được dùng ở các tầng ẩn của mạng nơ-ron. Nhờ đặc tính lấy 0 làm tâm, khi dữ liệu cũng được chuẩn hóa về trung bình 0, nó có thể giúp quá trình huấn luyện hiệu quả hơn.
Nếu phải chọn giữa sigmoid và tanh mà không có lý do cụ thể để thiên về một bên, tanh thường là lựa chọn tốt hơn vì các lý do nêu trên. Tuy nhiên, quyết định cũng có thể bị chi phối bởi trường hợp sử dụng cụ thể và hành vi của mạng trong các thử nghiệm huấn luyện ban đầu.
Bạn có thể xây dựng một Mạng Nơ-ron Đơn giản từ đầu bằng PyTorch theo hướng dẫn của Kurtis Pykes hoặc, nếu bạn là người dùng nâng cao, khóa học Deep Learning với PyTorch dành cho bạn.
Kích hoạt ReLU (rectified linear unit)
Hàm kích hoạt Rectified Linear Unit (ReLU). Ảnh: Tác giả
Hàm kích hoạt Rectified Linear Unit (ReLU) có dạng:
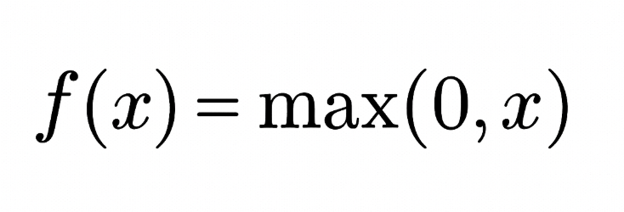
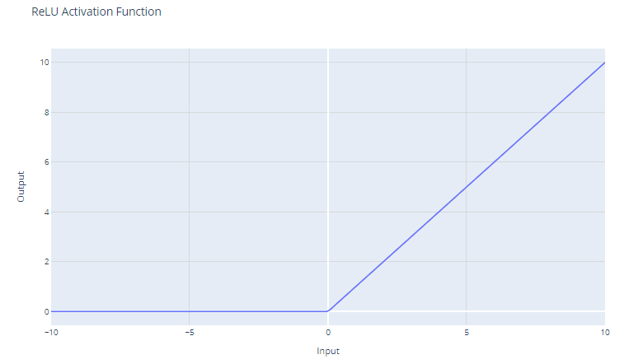
Nó đặt ngưỡng đầu vào tại 0, trả về 0 cho giá trị âm và trả về chính đầu vào cho giá trị dương.
Với đầu vào lớn hơn 0, ReLU hoạt động như một hàm tuyến tính với đạo hàm bằng 1. Điều này có nghĩa là nó không làm thay đổi thang độ của các đầu vào dương và cho phép đạo hàm truyền qua không đổi trong lan truyền ngược. Thuộc tính này rất quan trọng trong việc giảm thiểu vấn đề tiêu biến đạo hàm.
Mặc dù ReLU là tuyến tính trên một nửa không gian đầu vào của nó, về mặt kỹ thuật đây vẫn là một hàm phi tuyến vì có điểm không khả vi tại x=0, nơi nó chuyển đột ngột sang x. Tính phi tuyến này cho phép mạng nơ-ron học các mẫu phức tạp.
Vì ReLU cho đầu ra bằng 0 với mọi đầu vào âm, nó tự nhiên dẫn đến kích hoạt thưa; tại mỗi thời điểm, chỉ một tập con nơ-ron được kích hoạt, nhờ đó tính toán hiệu quả hơn.
Hàm ReLU rẻ về tính toán vì chỉ liên quan đến việc ngưỡng hóa tại 0. Điều này cho phép mạng mở rộng ra nhiều tầng mà không làm tăng đáng kể gánh nặng tính toán, so với các hàm phức tạp hơn như tanh hay sigmoid.
Kích hoạt softmax
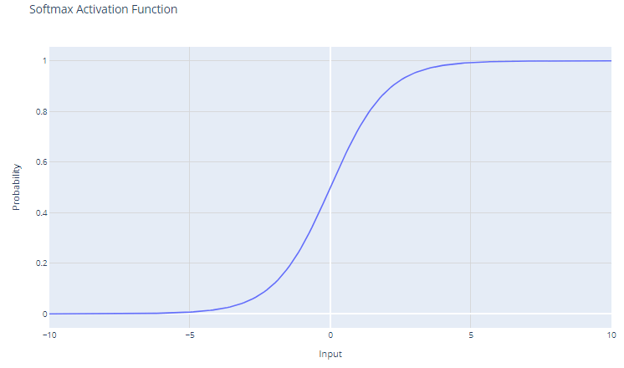
Hàm kích hoạt softmax. Ảnh: Tác giả
Hàm kích hoạt softmax, còn gọi là hàm mũ chuẩn hóa, đặc biệt hữu ích trong các bài toán phân loại đa lớp. Hàm này hoạt động trên một vector, thường gọi là logits, biểu diễn các dự đoán hoặc điểm số thô cho mỗi lớp do các tầng trước của mạng nơ-ron tính ra.
Với vector đầu vào x có các phần tử x1, x2, ..., xC, hàm softmax được định nghĩa như sau:
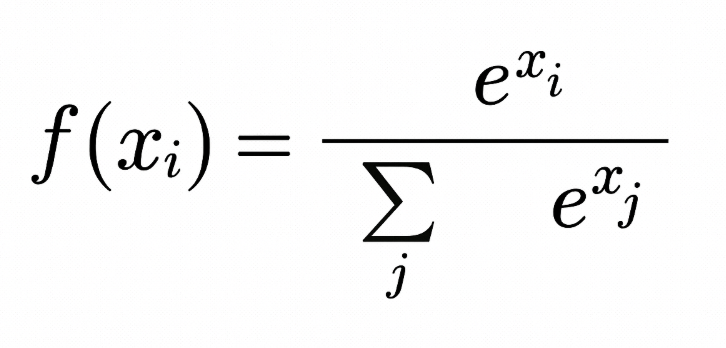
Đầu ra của hàm softmax là một phân phối xác suất có tổng bằng một. Mỗi phần tử của đầu ra biểu diễn xác suất đầu vào thuộc về một lớp cụ thể.
Việc dùng hàm mũ đảm bảo mọi giá trị đầu ra không âm. Điều này rất quan trọng vì xác suất không thể âm.
Softmax khuếch đại sự khác biệt trong vector đầu vào. Ngay cả những khác biệt nhỏ ở giá trị đầu vào cũng có thể dẫn đến khác biệt lớn ở xác suất đầu ra, với giá trị đầu vào lớn nhất có xu hướng chi phối phân phối xác suất thu được.
Softmax thường được dùng ở tầng đầu ra của mạng nơ-ron khi nhiệm vụ là phân loại đầu vào vào một trong nhiều (hơn hai) hạng mục có thể có (phân loại đa lớp).
Các xác suất do softmax tạo ra có thể được diễn giải như điểm tin cậy cho mỗi lớp, cung cấp góc nhìn về mức độ chắc chắn của mô hình đối với dự đoán của nó.
Do softmax khuếch đại khác biệt, nó có thể nhạy với ngoại lai hoặc giá trị cực đoan. Ví dụ, nếu vector đầu vào có một giá trị rất lớn, softmax có thể "ép" xác suất của các lớp khác xuống thấp, khiến mô hình trở nên quá tự tin.
Chọn hàm kích hoạt phù hợp
Việc lựa chọn hàm kích hoạt phụ thuộc vào loại bài toán bạn muốn giải quyết. Dưới đây là một số hướng dẫn:
Đối với phân loại nhị phân
Dùng hàm sigmoid ở tầng đầu ra. Nó sẽ nén đầu ra vào khoảng 0 đến 1, biểu diễn xác suất cho hai lớp.
Đối với phân loại đa lớp
Dùng hàm softmax ở tầng đầu ra. Nó sẽ xuất ra phân phối xác suất trên tất cả các lớp.
Nếu chưa chắc chắn
Dùng hàm ReLU ở các tầng ẩn. ReLU là hàm kích hoạt mặc định phổ biến nhất và thường là lựa chọn tốt.
Kết luận
Chúng ta đã khám phá vai trò then chốt của các hàm kích hoạt trong quá trình huấn luyện mạng nơ-ron. Chúng ta đã thấy rằng chúng không chỉ là phần bổ trợ tùy chọn mà là những thành phần thiết yếu giúp mạng nơ-ron nắm bắt và mô hình hóa sự phức tạp vốn có trong dữ liệu đời thực. Từ ReLU đơn giản nhưng hiệu quả đến cách diễn giải xác suất do softmax mang lại, mỗi hàm kích hoạt đều có vị trí và mục đích riêng trong các tầng khác nhau của mạng và trên nhiều miền bài toán.
Khi mạng nơ-ron tiếp tục phát triển, việc khám phá các hàm kích hoạt chắc chắn sẽ mở rộng, có thể bao gồm các dạng mới giải quyết những thách thức cụ thể của các kiến trúc đang nổi lên. Tuy nhiên, các nguyên tắc và hàm đã thảo luận trong bài viết này nhiều khả năng vẫn là cốt lõi của thiết kế mạng nơ-ron trong tương lai gần.
Việc lựa chọn cẩn trọng các hàm kích hoạt là một sự cân bằng — pha trộn giữa hiểu biết khoa học và trực giác tinh tế — có thể ảnh hưởng đáng kể đến hiệu năng của mạng nơ-ron.
Bạn quan tâm đến học sâu với framework Keras? Hãy xem khóa học Giới thiệu về Học sâu với Keras của chúng tôi.


Biểu diễn mạng nơ-ron. Nguồn ảnh
Hàm kích hoạt là gì?
Hàm kích hoạt là một khối xây dựng không thể thiếu của mạng nơ-ron, cho phép chúng học được các mẫu phức tạp trong dữ liệu. Chúng biến đổi tín hiệu đầu vào của một nút trong mạng nơ-ron thành tín hiệu đầu ra để truyền sang tầng kế tiếp. Không có hàm kích hoạt, mạng nơ-ron sẽ chỉ mô hình hóa được các mối quan hệ tuyến tính giữa đầu vào và đầu ra.
Hàm kích hoạt đưa vào tính phi tuyến, cho phép mạng nơ-ron học được các ánh xạ rất phức tạp giữa đầu vào và đầu ra.
Việc chọn đúng hàm kích hoạt có ý nghĩa quyết định đối với việc huấn luyện các mạng nơ-ron có khả năng khái quát tốt và đưa ra dự đoán chính xác. Trong bài viết này, chúng tôi sẽ điểm qua những hàm kích hoạt phổ biến nhất, vai trò của chúng và cách chọn hàm kích hoạt phù hợp cho các trường hợp sử dụng khác nhau.
Dù bạn mới bắt đầu với học sâu hay là người đã có kinh nghiệm, nắm vững hàm kích hoạt sẽ giúp bạn hình thành trực giác và nâng cao hiệu quả áp dụng mạng nơ-ron.
Vì sao hàm kích hoạt lại thiết yếu?
Nếu không có hàm kích hoạt, mạng nơ-ron chỉ gồm các phép toán tuyến tính như nhân ma trận. Tất cả các tầng sẽ thực hiện biến đổi tuyến tính của đầu vào và không đưa vào bất kỳ tính phi tuyến nào.
Hầu hết dữ liệu đời thực là phi tuyến. Ví dụ, mối quan hệ giữa giá nhà và diện tích, giữa thu nhập và hành vi mua sắm, v.v., đều phi tuyến. Nếu mạng nơ-ron không có hàm kích hoạt, chúng sẽ không học được các mẫu phi tuyến phức tạp tồn tại trong dữ liệu đời thực.
Hàm kích hoạt cho phép mạng nơ-ron học các mối quan hệ phi tuyến này bằng cách đưa vào hành vi phi tuyến thông qua chính các hàm kích hoạt. Điều này làm tăng đáng kể sự linh hoạt và sức mạnh của mạng nơ-ron trong việc mô hình hóa dữ liệu phức tạp và tinh tế.
Các loại hàm kích hoạt
Mạng nơ-ron sử dụng nhiều loại hàm kích hoạt để đưa vào tính phi tuyến và học các mẫu phức tạp. Mỗi hàm có những đặc tính riêng và phù hợp với một số trường hợp sử dụng nhất định.
Ví dụ, hàm sigmoid lý tưởng cho bài toán phân loại nhị phân, softmax hữu ích cho dự đoán đa lớp, còn ReLU giúp khắc phục vấn đề tiêu biến đạo hàm.
Sử dụng đúng hàm kích hoạt cho nhiệm vụ sẽ giúp huấn luyện nhanh hơn và đạt hiệu năng tốt hơn.
Hãy cùng xem một số hàm kích hoạt phổ biến:
Kích hoạt tuyến tính
Hàm kích hoạt tuyến tính. Ảnh: Tác giả
Hàm kích hoạt tuyến tính là hàm đơn giản nhất, được định nghĩa như sau:
Nó đơn giản trả về đầu vào x làm đầu ra. Về đồ thị, nó là một đường thẳng có độ dốc bằng 1.
Trường hợp sử dụng chính của hàm tuyến tính là ở tầng đầu ra của mạng nơ-ron dùng cho hồi quy. Với các bài toán hồi quy cần dự đoán giá trị số, dùng hàm tuyến tính ở tầng đầu ra đảm bảo mạng nơ-ron xuất ra một giá trị số. Hàm tuyến tính không nén hay biến đổi đầu ra, nên trả lại chính giá trị dự đoán.
Tuy nhiên, hàm tuyến tính hiếm khi được dùng ở các tầng ẩn của mạng nơ-ron vì nó không mang lại tính phi tuyến. Mục đích của các tầng ẩn là học các tổ hợp phi tuyến của đặc trưng đầu vào. Dùng tuyến tính xuyên suốt sẽ giới hạn mô hình chỉ học các biến đổi tuyến tính của đầu vào.
Kích hoạt sigmoid
Hàm kích hoạt sigmoid. Ảnh: Tác giả
Hàm kích hoạt sigmoid, thường ký hiệu là σ(x), là một hàm trơn, khả vi liên tục, có ý nghĩa lịch sử trong sự phát triển của mạng nơ-ron. Hàm sigmoid có dạng toán học:
Nó nhận đầu vào là số thực và nén về khoảng từ 0 đến 1. Đường cong sigmoid có dạng chữ "S", tiệm cận 0 khi giá trị âm lớn và tiệm cận 1 khi giá trị dương lớn. Đầu ra dễ được diễn giải như xác suất, nên rất tự nhiên cho các bài toán phân loại nhị phân.
Các nút sigmoid từng phổ biến trong những mạng nơ-ron đầu tiên vì độ dốc là mạnh nhất khi đầu ra của nút gần 0,5, cho phép huấn luyện lan truyền ngược hiệu quả. Tuy vậy, sigmoid gặp vấn đề "tiêu biến đạo hàm" gây cản trở việc học ở các mạng sâu.
Khi đầu vào trở nên dương hoặc âm rất lớn, hàm bão hòa tại 0 hoặc 1 với độ dốc cực nhỏ. Ở những vùng này, đạo hàm gần bằng 0, dẫn đến các thay đổi rất nhỏ ở trọng số trong quá trình lan truyền ngược, đặc biệt với các nơ-ron ở tầng đầu của mạng sâu, khiến việc học cực chậm hoặc dừng hẳn. Đây là vấn đề tiêu biến đạo hàm trong mạng nơ-ron.
Trường hợp sử dụng chính của sigmoid là làm hàm kích hoạt cho tầng đầu ra của mô hình phân loại nhị phân. Nó nén đầu ra về giá trị xác suất từ 0 đến 1, có thể hiểu là xác suất đầu vào thuộc về một lớp cụ thể.
Kích hoạt tanh (hyperbolic tangent)
Hàm kích hoạt tanh. Ảnh: Tác giả
Hàm kích hoạt tanh (hyperbolic tangent) được định nghĩa như sau:
Hàm tanh cho đầu ra trong khoảng từ -1 đến +1. Điều này có nghĩa là nó xử lý giá trị âm hiệu quả hơn sigmoid, vốn có miền giá trị từ 0 đến 1.
Khác với sigmoid, tanh là hàm lấy 0 làm tâm, tức đầu ra đối xứng quanh gốc toạ độ. Đây thường được xem là một lợi thế vì có thể giúp thuật toán học hội tụ nhanh hơn.
Do đầu ra của tanh nằm giữa -1 và +1, nó có đạo hàm mạnh hơn sigmoid. Đạo hàm mạnh hơn thường dẫn đến học và hội tụ nhanh hơn trong huấn luyện vì thường chống chịu tốt hơn trước vấn đề tiêu biến đạo hàm so với đạo hàm của sigmoid.
Dù có những ưu điểm này, tanh vẫn gặp vấn đề tiêu biến đạo hàm. Trong lan truyền ngược, đạo hàm của tanh có thể rất nhỏ (gần 0). Vấn đề này đặc biệt nghiêm trọng với mạng sâu nhiều tầng; đạo hàm của hàm mất mát có thể trở nên quá nhỏ để tạo ra thay đổi đáng kể ở trọng số khi lan truyền ngược về các tầng đầu. Điều này có thể làm chậm đáng kể quá trình huấn luyện và dẫn đến đặc tính hội tụ kém.
Hàm tanh thường được dùng ở các tầng ẩn của mạng nơ-ron. Nhờ đặc tính lấy 0 làm tâm, khi dữ liệu cũng được chuẩn hóa về trung bình 0, nó có thể giúp quá trình huấn luyện hiệu quả hơn.
Nếu phải chọn giữa sigmoid và tanh mà không có lý do cụ thể để thiên về một bên, tanh thường là lựa chọn tốt hơn vì các lý do nêu trên. Tuy nhiên, quyết định cũng có thể bị chi phối bởi trường hợp sử dụng cụ thể và hành vi của mạng trong các thử nghiệm huấn luyện ban đầu.
Bạn có thể xây dựng một Mạng Nơ-ron Đơn giản từ đầu bằng PyTorch theo hướng dẫn của Kurtis Pykes hoặc, nếu bạn là người dùng nâng cao, khóa học Deep Learning với PyTorch dành cho bạn.
Kích hoạt ReLU (rectified linear unit)
Hàm kích hoạt Rectified Linear Unit (ReLU). Ảnh: Tác giả
Hàm kích hoạt Rectified Linear Unit (ReLU) có dạng:
Nó đặt ngưỡng đầu vào tại 0, trả về 0 cho giá trị âm và trả về chính đầu vào cho giá trị dương.
Với đầu vào lớn hơn 0, ReLU hoạt động như một hàm tuyến tính với đạo hàm bằng 1. Điều này có nghĩa là nó không làm thay đổi thang độ của các đầu vào dương và cho phép đạo hàm truyền qua không đổi trong lan truyền ngược. Thuộc tính này rất quan trọng trong việc giảm thiểu vấn đề tiêu biến đạo hàm.
Mặc dù ReLU là tuyến tính trên một nửa không gian đầu vào của nó, về mặt kỹ thuật đây vẫn là một hàm phi tuyến vì có điểm không khả vi tại x=0, nơi nó chuyển đột ngột sang x. Tính phi tuyến này cho phép mạng nơ-ron học các mẫu phức tạp.
Vì ReLU cho đầu ra bằng 0 với mọi đầu vào âm, nó tự nhiên dẫn đến kích hoạt thưa; tại mỗi thời điểm, chỉ một tập con nơ-ron được kích hoạt, nhờ đó tính toán hiệu quả hơn.
Hàm ReLU rẻ về tính toán vì chỉ liên quan đến việc ngưỡng hóa tại 0. Điều này cho phép mạng mở rộng ra nhiều tầng mà không làm tăng đáng kể gánh nặng tính toán, so với các hàm phức tạp hơn như tanh hay sigmoid.
Kích hoạt softmax
Hàm kích hoạt softmax. Ảnh: Tác giả
Hàm kích hoạt softmax, còn gọi là hàm mũ chuẩn hóa, đặc biệt hữu ích trong các bài toán phân loại đa lớp. Hàm này hoạt động trên một vector, thường gọi là logits, biểu diễn các dự đoán hoặc điểm số thô cho mỗi lớp do các tầng trước của mạng nơ-ron tính ra.
Với vector đầu vào x có các phần tử x1, x2, ..., xC, hàm softmax được định nghĩa như sau:
Đầu ra của hàm softmax là một phân phối xác suất có tổng bằng một. Mỗi phần tử của đầu ra biểu diễn xác suất đầu vào thuộc về một lớp cụ thể.
Việc dùng hàm mũ đảm bảo mọi giá trị đầu ra không âm. Điều này rất quan trọng vì xác suất không thể âm.
Softmax khuếch đại sự khác biệt trong vector đầu vào. Ngay cả những khác biệt nhỏ ở giá trị đầu vào cũng có thể dẫn đến khác biệt lớn ở xác suất đầu ra, với giá trị đầu vào lớn nhất có xu hướng chi phối phân phối xác suất thu được.
Softmax thường được dùng ở tầng đầu ra của mạng nơ-ron khi nhiệm vụ là phân loại đầu vào vào một trong nhiều (hơn hai) hạng mục có thể có (phân loại đa lớp).
Các xác suất do softmax tạo ra có thể được diễn giải như điểm tin cậy cho mỗi lớp, cung cấp góc nhìn về mức độ chắc chắn của mô hình đối với dự đoán của nó.
Do softmax khuếch đại khác biệt, nó có thể nhạy với ngoại lai hoặc giá trị cực đoan. Ví dụ, nếu vector đầu vào có một giá trị rất lớn, softmax có thể "ép" xác suất của các lớp khác xuống thấp, khiến mô hình trở nên quá tự tin.
Chọn hàm kích hoạt phù hợp
Việc lựa chọn hàm kích hoạt phụ thuộc vào loại bài toán bạn muốn giải quyết. Dưới đây là một số hướng dẫn:
Đối với phân loại nhị phân
Dùng hàm sigmoid ở tầng đầu ra. Nó sẽ nén đầu ra vào khoảng 0 đến 1, biểu diễn xác suất cho hai lớp.
Đối với phân loại đa lớp
Dùng hàm softmax ở tầng đầu ra. Nó sẽ xuất ra phân phối xác suất trên tất cả các lớp.
Nếu chưa chắc chắn
Dùng hàm ReLU ở các tầng ẩn. ReLU là hàm kích hoạt mặc định phổ biến nhất và thường là lựa chọn tốt.
Kết luận
Chúng ta đã khám phá vai trò then chốt của các hàm kích hoạt trong quá trình huấn luyện mạng nơ-ron. Chúng ta đã thấy rằng chúng không chỉ là phần bổ trợ tùy chọn mà là những thành phần thiết yếu giúp mạng nơ-ron nắm bắt và mô hình hóa sự phức tạp vốn có trong dữ liệu đời thực. Từ ReLU đơn giản nhưng hiệu quả đến cách diễn giải xác suất do softmax mang lại, mỗi hàm kích hoạt đều có vị trí và mục đích riêng trong các tầng khác nhau của mạng và trên nhiều miền bài toán.
Khi mạng nơ-ron tiếp tục phát triển, việc khám phá các hàm kích hoạt chắc chắn sẽ mở rộng, có thể bao gồm các dạng mới giải quyết những thách thức cụ thể của các kiến trúc đang nổi lên. Tuy nhiên, các nguyên tắc và hàm đã thảo luận trong bài viết này nhiều khả năng vẫn là cốt lõi của thiết kế mạng nơ-ron trong tương lai gần.
Việc lựa chọn cẩn trọng các hàm kích hoạt là một sự cân bằng — pha trộn giữa hiểu biết khoa học và trực giác tinh tế — có thể ảnh hưởng đáng kể đến hiệu năng của mạng nơ-ron.
Bạn quan tâm đến học sâu với framework Keras? Hãy xem khóa học Giới thiệu về Học sâu với Keras của chúng tôi.