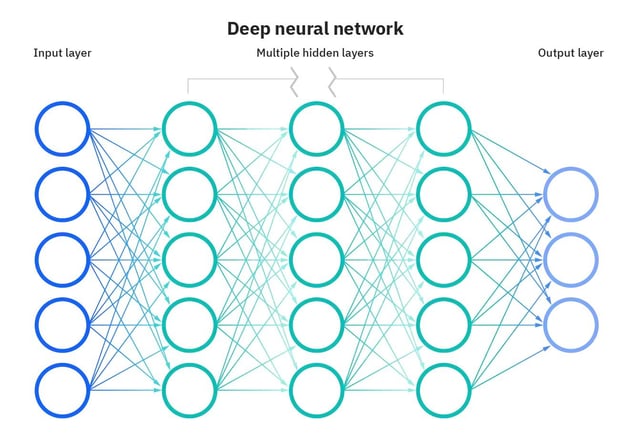
Rappresentazione di una rete neurale. Fonte immagine
Cosa sono le funzioni di attivazione?
Le funzioni di attivazione sono un elemento fondamentale delle reti neurali che permette loro di imparare schemi complessi nei dati. Trasformano il segnale in ingresso di un nodo in una rete neurale in un segnale in uscita che viene poi passato allo strato successivo. Senza funzioni di attivazione, le reti neurali sarebbero limitate a modellare solo relazioni lineari tra input e output.
Le funzioni di attivazione introducono non linearità, consentendo alle reti neurali di apprendere mappature molto complesse tra ingressi e uscite.
Scegliere la funzione di attivazione giusta è cruciale per addestrare reti neurali che generalizzano bene e forniscono previsioni accurate. In questo post, forniremo una panoramica delle funzioni di attivazione più comuni, dei loro ruoli e di come selezionare funzioni adatte ai diversi casi d'uso.
Che tu stia muovendo i primi passi nel deep learning o sia già un professionista esperto, comprendere a fondo le funzioni di attivazione rafforzerà la tua intuizione e migliorerà l'applicazione delle reti neurali.
Perché le funzioni di attivazione sono essenziali?
Senza funzioni di attivazione, le reti neurali sarebbero composte solo da operazioni lineari come la moltiplicazione di matrici. Tutti gli strati eseguirebbero trasformazioni lineari dell'input, senza introdurre non linearità.
La maggior parte dei dati del mondo reale è non lineare. Ad esempio, le relazioni tra prezzo e dimensione di una casa, reddito e acquisti, ecc., sono non lineari. Se le reti neurali non avessero funzioni di attivazione, non riuscirebbero a imparare i complessi schemi non lineari presenti nei dati reali.
Le funzioni di attivazione consentono alle reti neurali di apprendere queste relazioni non lineari introducendo comportamenti non lineari. Questo aumenta notevolmente la flessibilità e la capacità delle reti neurali di modellare dati complessi e ricchi di sfumature.
Tipi di funzioni di attivazione
Le reti neurali sfruttano vari tipi di funzioni di attivazione per introdurre non linearità e consentire l'apprendimento di schemi complessi. Ogni funzione di attivazione ha proprietà uniche ed è adatta a determinati casi d'uso.
Per esempio, la funzione sigmoid è ideale per problemi di classificazione binaria, la softmax è utile per previsioni multi-classe e la ReLU aiuta a superare il problema del gradiente che svanisce.
Usare la funzione di attivazione giusta per il compito porta a un addestramento più rapido e a prestazioni migliori.
Vediamo alcune delle funzioni di attivazione più comuni:
Attivazione lineare
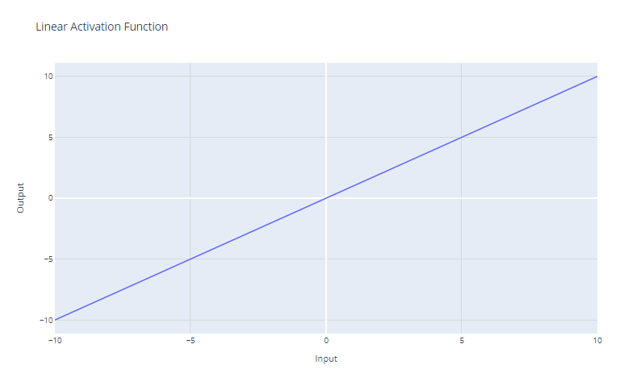
Funzione di attivazione lineare. Immagine dell'autore
La funzione di attivazione lineare è la più semplice, definita come:
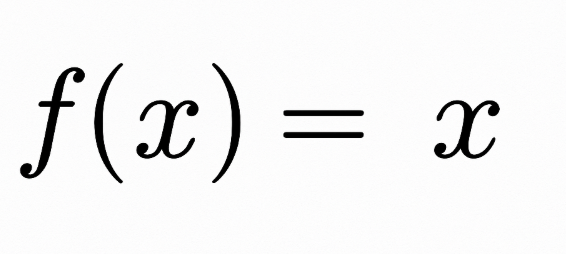
Restituisce semplicemente l'input x come output. Graficamente, appare come una linea retta con pendenza 1.
Il principale caso d'uso della funzione lineare è nello strato di output di una rete neurale utilizzata per la regressione. Per problemi di regressione in cui vogliamo prevedere un valore numerico, usare una funzione lineare nello strato di output garantisce che la rete neurale produca un valore numerico. La funzione lineare non comprime né trasforma l'output, quindi viene restituito il valore effettivamente previsto.
Tuttavia, la funzione lineare è raramente usata negli strati nascosti delle reti neurali, perché non fornisce alcuna non linearità. Il punto degli strati nascosti è imparare combinazioni non lineari delle caratteristiche in input. Usare un'attivazione lineare ovunque limiterebbe il modello a imparare solo trasformazioni lineari dell'input.
Attivazione sigmoid
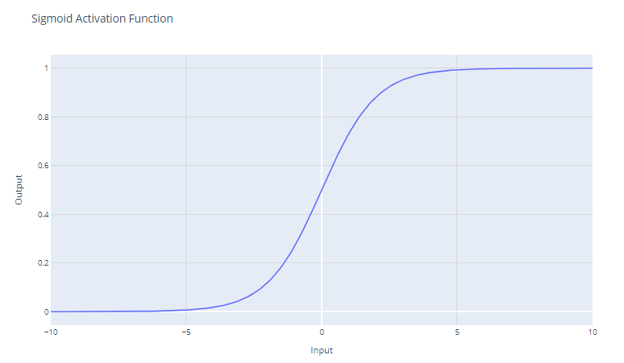
Funzione di attivazione sigmoid. Immagine dell'autore
La funzione di attivazione sigmoid, spesso rappresentata come σ(x), è una funzione liscia e continuamente differenziabile storicamente importante nello sviluppo delle reti neurali. La funzione sigmoid ha la forma matematica:
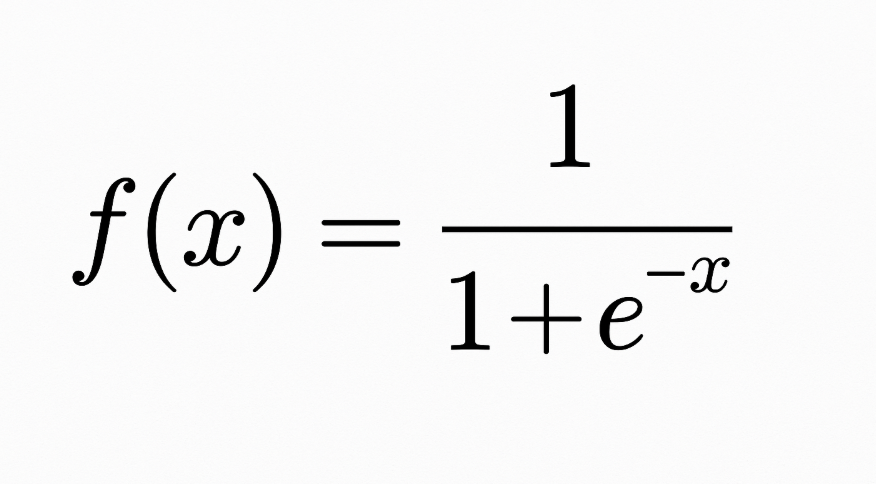
Accetta un input reale e lo comprime in un valore tra 0 e 1. La sigmoid ha una curva a "S" che tende asintoticamente a 0 per numeri negativi grandi e a 1 per numeri positivi grandi. Gli output possono essere facilmente interpretati come probabilità, il che la rende naturale per la classificazione binaria.
Le unità sigmoid erano popolari nelle prime reti neurali poiché il gradiente è massimo quando l'output dell'unità è vicino a 0,5, consentendo un addestramento efficiente con backpropagation. Tuttavia, le unità sigmoid soffrono del problema del "gradiente che svanisce", che ostacola l'apprendimento nelle reti neurali profonde.
Quando i valori di input diventano molto positivi o negativi, la funzione satura a 0 o 1, con una pendenza estremamente piatta. In queste regioni, il gradiente è molto vicino a zero. Ciò si traduce in cambiamenti minimi dei pesi durante la backpropagation, in particolare per i neuroni negli strati iniziali delle reti profonde, rendendo l'apprendimento dolorosamente lento o addirittura bloccandolo. Questo è noto come problema del gradiente che svanisce nelle reti neurali.
Il principale caso d'uso della sigmoid è come attivazione per lo strato di output dei modelli di classificazione binaria. Comprimi l'output in un valore di probabilità tra 0 e 1, interpretabile come la probabilità che l'input appartenga a una determinata classe.
Attivazione tanh (tangente iperbolica)
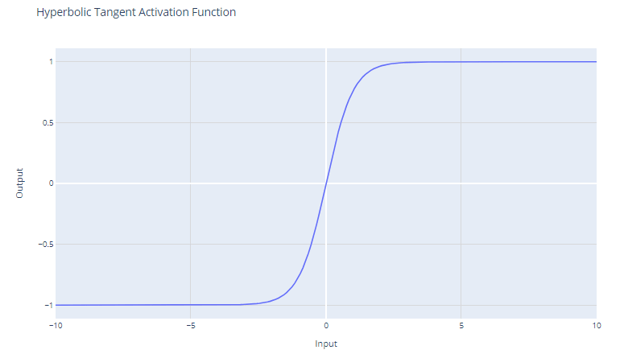
Funzione di attivazione tanh. Immagine dell'autore
La funzione di attivazione tanh (tangente iperbolica) è definita come:
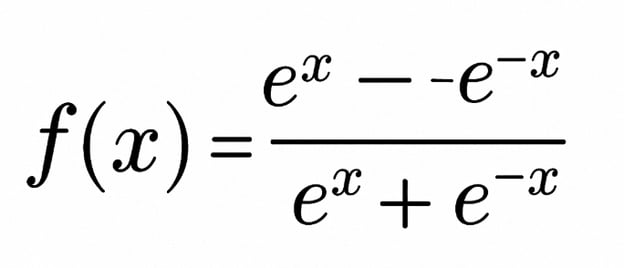
La tanh restituisce valori nell'intervallo da -1 a +1. Ciò significa che gestisce i valori negativi in modo più efficace della sigmoid, che ha intervallo 0–1.
A differenza della sigmoid, la tanh è centrata sullo zero, cioè il suo output è simmetrico rispetto all'origine del sistema di coordinate. Questo è spesso considerato un vantaggio perché può aiutare l'algoritmo di apprendimento a convergere più rapidamente.
Poiché l'output della tanh varia tra -1 e +1, ha gradienti più forti rispetto alla sigmoid. Gradienti più forti spesso portano a un apprendimento e a una convergenza più rapidi durante l'addestramento, perché tendono a essere più resilienti al problema del gradiente che svanisce rispetto ai gradienti della sigmoid.
Nonostante questi vantaggi, anche la tanh soffre del problema del gradiente che svanisce. Durante la backpropagation, i gradienti della tanh possono diventare molto piccoli (vicini a zero). Questo problema è particolarmente rilevante per reti profonde con molti strati; i gradienti della funzione di perdita possono diventare troppo piccoli per apportare cambiamenti significativi ai pesi durante l'addestramento man mano che si propagano agli strati iniziali. Ciò può rallentare drasticamente il processo di addestramento e portare a scarse proprietà di convergenza.
La tanh è spesso utilizzata negli strati nascosti di una rete neurale. Grazie alla sua natura centrata sullo zero, quando i dati sono anche normalizzati con media zero, può risultare in un addestramento più efficiente.
Se devi scegliere tra sigmoid e tanh senza un motivo specifico per preferirne una, spesso la tanh è la scelta migliore per i motivi sopra citati. Tuttavia, la decisione può dipendere anche dallo specifico caso d'uso e dal comportamento della rete nei primi esperimenti di addestramento.
Puoi costruire una semplice rete neurale da zero con PyTorch seguendo il nostro tutorial di Kurtis Pykes oppure, se sei un utente avanzato, il nostro corso Deep Learning con PyTorch fa per te.
Attivazione ReLU (rectified linear unit)
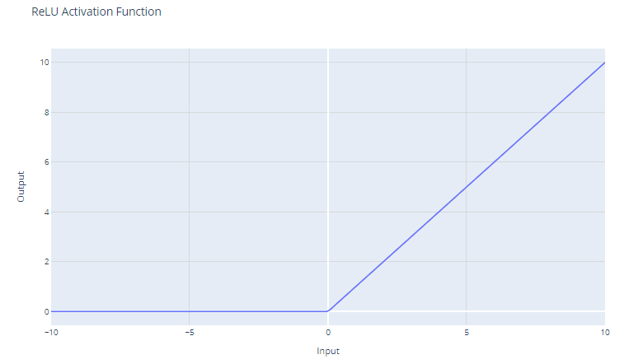
Funzione di attivazione Rectified Linear Unit (ReLU). Immagine dell'autore
La funzione di attivazione Rectified Linear Unit (ReLU) ha la forma:
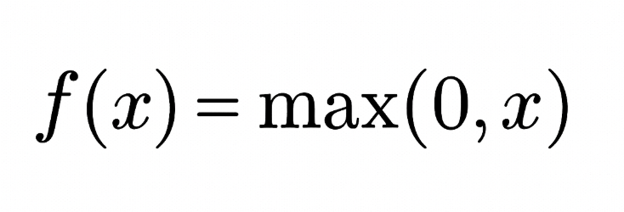
Applica una soglia a zero: restituisce 0 per i valori negativi e l'input stesso per i valori positivi.
Per input maggiori di 0, la ReLU si comporta come una funzione lineare con gradiente 1. Ciò significa che non altera la scala degli input positivi e lascia passare il gradiente invariato durante la backpropagation. Questa proprietà è fondamentale per mitigare il problema del gradiente che svanisce.
Anche se la ReLU è lineare per metà del suo spazio di input, tecnicamente è una funzione non lineare perché ha un punto non differenziabile in x=0, dove passa bruscamente a x. Questa non linearità consente alle reti neurali di apprendere schemi complessi.
Poiché la ReLU restituisce zero per tutti gli input negativi, porta naturalmente ad attivazioni sparse; in ogni momento, solo un sottoinsieme di neuroni è attivo, con un'elaborazione più efficiente.
La funzione ReLU è computazionalmente economica perché prevede una semplice soglia a zero. Questo consente di scalare le reti a molti strati senza un aumento significativo del carico computazionale, rispetto a funzioni più complesse come tanh o sigmoid.
Attivazione softmax
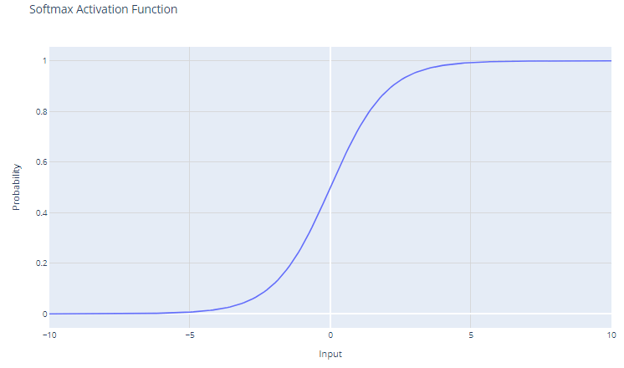
Funzione di attivazione softmax. Immagine dell'autore
La funzione di attivazione softmax, nota anche come funzione esponenziale normalizzata, è particolarmente utile nel contesto di problemi di classificazione multi-classe. Questa funzione opera su un vettore, spesso chiamato logits, che rappresenta le previsioni o i punteggi grezzi per ciascuna classe calcolati dagli strati precedenti di una rete neurale.
Per un vettore di input x con elementi x1, x2, ..., xC, la funzione softmax è definita come:
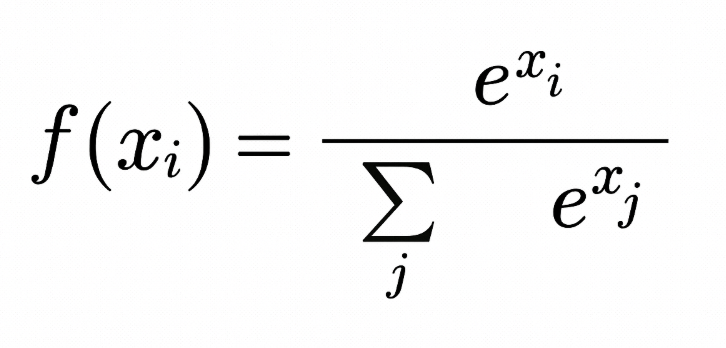
L'output della softmax è una distribuzione di probabilità che somma a uno. Ogni elemento dell'output rappresenta la probabilità che l'input appartenga a una particolare classe.
L'uso della funzione esponenziale garantisce che tutti i valori di output siano non negativi. Questo è cruciale perché le probabilità non possono essere negative.
La softmax amplifica le differenze nel vettore di input. Anche piccole differenze nei valori in ingresso possono portare a differenze sostanziali nelle probabilità in uscita, con i valori di input più alti che tendono a dominare nella distribuzione risultante.
La softmax è in genere utilizzata nello strato di output di una rete neurale quando il compito prevede di classificare un input in una tra più (oltre due) categorie possibili (classificazione multi-classe).
Le probabilità prodotte dalla softmax possono essere interpretate come punteggi di confidenza per ciascuna classe, fornendo un'idea della certezza del modello sulle sue previsioni.
Poiché la softmax amplifica le differenze, può essere sensibile agli outlier o a valori estremi. Ad esempio, se il vettore di input ha un valore molto grande, la softmax può "schiacciare" le probabilità delle altre classi, portando a un modello eccessivamente sicuro di sé.
Scegliere la funzione di attivazione giusta
La scelta della funzione di attivazione dipende dal tipo di problema che stai cercando di risolvere. Ecco alcune linee guida:
Per la classificazione binaria
Usa la funzione di attivazione sigmoid nello strato di output. Comprimerà gli output tra 0 e 1, rappresentando le probabilità per le due classi.
Per la classificazione multi-classe
Usa la funzione di attivazione softmax nello strato di output. Restituirà distribuzioni di probabilità su tutte le classi.
Se non sei sicuro
Usa la funzione di attivazione ReLU negli strati nascosti. ReLU è l'attivazione predefinita più comune e di solito una buona scelta.
Conclusione
Abbiamo esplorato il ruolo cruciale che le funzioni di attivazione svolgono nell'addestramento delle reti neurali. Abbiamo visto come non siano semplici optional, ma elementi essenziali che permettono alle reti neurali di cogliere e modellare la complessità insita nei dati del mondo reale. Dalla semplice ma efficace ReLU alle interpretazioni probabilistiche fornite dalla softmax, ogni funzione di attivazione ha il suo posto e la sua finalità nei diversi strati di una rete e nei vari domini di problema.
Con l'evoluzione continua delle reti neurali, l'esplorazione delle funzioni di attivazione si amplierà certamente, includendo forse nuove forme che affrontano sfide specifiche di architetture emergenti. Tuttavia, i principi e le funzioni discussi in questo blog probabilmente resteranno al centro della progettazione di reti neurali per il prossimo futuro.
La scelta attenta delle funzioni di attivazione è un equilibrio sottile—un mix di comprensione scientifica e intuizione—che può influenzare in modo significativo le prestazioni delle reti neurali.
Ti interessa imparare il deep learning con il framework Keras? Dai un'occhiata al nostro corso Introduzione al Deep Learning con Keras.







Rappresentazione di una rete neurale. Fonte immagine
Cosa sono le funzioni di attivazione?
Le funzioni di attivazione sono un elemento fondamentale delle reti neurali che permette loro di imparare schemi complessi nei dati. Trasformano il segnale in ingresso di un nodo in una rete neurale in un segnale in uscita che viene poi passato allo strato successivo. Senza funzioni di attivazione, le reti neurali sarebbero limitate a modellare solo relazioni lineari tra input e output.
Le funzioni di attivazione introducono non linearità, consentendo alle reti neurali di apprendere mappature molto complesse tra ingressi e uscite.
Scegliere la funzione di attivazione giusta è cruciale per addestrare reti neurali che generalizzano bene e forniscono previsioni accurate. In questo post, forniremo una panoramica delle funzioni di attivazione più comuni, dei loro ruoli e di come selezionare funzioni adatte ai diversi casi d'uso.
Che tu stia muovendo i primi passi nel deep learning o sia già un professionista esperto, comprendere a fondo le funzioni di attivazione rafforzerà la tua intuizione e migliorerà l'applicazione delle reti neurali.
Perché le funzioni di attivazione sono essenziali?
Senza funzioni di attivazione, le reti neurali sarebbero composte solo da operazioni lineari come la moltiplicazione di matrici. Tutti gli strati eseguirebbero trasformazioni lineari dell'input, senza introdurre non linearità.
La maggior parte dei dati del mondo reale è non lineare. Ad esempio, le relazioni tra prezzo e dimensione di una casa, reddito e acquisti, ecc., sono non lineari. Se le reti neurali non avessero funzioni di attivazione, non riuscirebbero a imparare i complessi schemi non lineari presenti nei dati reali.
Le funzioni di attivazione consentono alle reti neurali di apprendere queste relazioni non lineari introducendo comportamenti non lineari. Questo aumenta notevolmente la flessibilità e la capacità delle reti neurali di modellare dati complessi e ricchi di sfumature.
Tipi di funzioni di attivazione
Le reti neurali sfruttano vari tipi di funzioni di attivazione per introdurre non linearità e consentire l'apprendimento di schemi complessi. Ogni funzione di attivazione ha proprietà uniche ed è adatta a determinati casi d'uso.
Per esempio, la funzione sigmoid è ideale per problemi di classificazione binaria, la softmax è utile per previsioni multi-classe e la ReLU aiuta a superare il problema del gradiente che svanisce.
Usare la funzione di attivazione giusta per il compito porta a un addestramento più rapido e a prestazioni migliori.
Vediamo alcune delle funzioni di attivazione più comuni:
Attivazione lineare
Funzione di attivazione lineare. Immagine dell'autore
La funzione di attivazione lineare è la più semplice, definita come:
Restituisce semplicemente l'input x come output. Graficamente, appare come una linea retta con pendenza 1.
Il principale caso d'uso della funzione lineare è nello strato di output di una rete neurale utilizzata per la regressione. Per problemi di regressione in cui vogliamo prevedere un valore numerico, usare una funzione lineare nello strato di output garantisce che la rete neurale produca un valore numerico. La funzione lineare non comprime né trasforma l'output, quindi viene restituito il valore effettivamente previsto.
Tuttavia, la funzione lineare è raramente usata negli strati nascosti delle reti neurali, perché non fornisce alcuna non linearità. Il punto degli strati nascosti è imparare combinazioni non lineari delle caratteristiche in input. Usare un'attivazione lineare ovunque limiterebbe il modello a imparare solo trasformazioni lineari dell'input.
Attivazione sigmoid
Funzione di attivazione sigmoid. Immagine dell'autore
La funzione di attivazione sigmoid, spesso rappresentata come σ(x), è una funzione liscia e continuamente differenziabile storicamente importante nello sviluppo delle reti neurali. La funzione sigmoid ha la forma matematica:
Accetta un input reale e lo comprime in un valore tra 0 e 1. La sigmoid ha una curva a "S" che tende asintoticamente a 0 per numeri negativi grandi e a 1 per numeri positivi grandi. Gli output possono essere facilmente interpretati come probabilità, il che la rende naturale per la classificazione binaria.
Le unità sigmoid erano popolari nelle prime reti neurali poiché il gradiente è massimo quando l'output dell'unità è vicino a 0,5, consentendo un addestramento efficiente con backpropagation. Tuttavia, le unità sigmoid soffrono del problema del "gradiente che svanisce", che ostacola l'apprendimento nelle reti neurali profonde.
Quando i valori di input diventano molto positivi o negativi, la funzione satura a 0 o 1, con una pendenza estremamente piatta. In queste regioni, il gradiente è molto vicino a zero. Ciò si traduce in cambiamenti minimi dei pesi durante la backpropagation, in particolare per i neuroni negli strati iniziali delle reti profonde, rendendo l'apprendimento dolorosamente lento o addirittura bloccandolo. Questo è noto come problema del gradiente che svanisce nelle reti neurali.
Il principale caso d'uso della sigmoid è come attivazione per lo strato di output dei modelli di classificazione binaria. Comprimi l'output in un valore di probabilità tra 0 e 1, interpretabile come la probabilità che l'input appartenga a una determinata classe.
Attivazione tanh (tangente iperbolica)
Funzione di attivazione tanh. Immagine dell'autore
La funzione di attivazione tanh (tangente iperbolica) è definita come:
La tanh restituisce valori nell'intervallo da -1 a +1. Ciò significa che gestisce i valori negativi in modo più efficace della sigmoid, che ha intervallo 0–1.
A differenza della sigmoid, la tanh è centrata sullo zero, cioè il suo output è simmetrico rispetto all'origine del sistema di coordinate. Questo è spesso considerato un vantaggio perché può aiutare l'algoritmo di apprendimento a convergere più rapidamente.
Poiché l'output della tanh varia tra -1 e +1, ha gradienti più forti rispetto alla sigmoid. Gradienti più forti spesso portano a un apprendimento e a una convergenza più rapidi durante l'addestramento, perché tendono a essere più resilienti al problema del gradiente che svanisce rispetto ai gradienti della sigmoid.
Nonostante questi vantaggi, anche la tanh soffre del problema del gradiente che svanisce. Durante la backpropagation, i gradienti della tanh possono diventare molto piccoli (vicini a zero). Questo problema è particolarmente rilevante per reti profonde con molti strati; i gradienti della funzione di perdita possono diventare troppo piccoli per apportare cambiamenti significativi ai pesi durante l'addestramento man mano che si propagano agli strati iniziali. Ciò può rallentare drasticamente il processo di addestramento e portare a scarse proprietà di convergenza.
La tanh è spesso utilizzata negli strati nascosti di una rete neurale. Grazie alla sua natura centrata sullo zero, quando i dati sono anche normalizzati con media zero, può risultare in un addestramento più efficiente.
Se devi scegliere tra sigmoid e tanh senza un motivo specifico per preferirne una, spesso la tanh è la scelta migliore per i motivi sopra citati. Tuttavia, la decisione può dipendere anche dallo specifico caso d'uso e dal comportamento della rete nei primi esperimenti di addestramento.
Puoi costruire una semplice rete neurale da zero con PyTorch seguendo il nostro tutorial di Kurtis Pykes oppure, se sei un utente avanzato, il nostro corso Deep Learning con PyTorch fa per te.
Attivazione ReLU (rectified linear unit)
Funzione di attivazione Rectified Linear Unit (ReLU). Immagine dell'autore
La funzione di attivazione Rectified Linear Unit (ReLU) ha la forma:
Applica una soglia a zero: restituisce 0 per i valori negativi e l'input stesso per i valori positivi.
Per input maggiori di 0, la ReLU si comporta come una funzione lineare con gradiente 1. Ciò significa che non altera la scala degli input positivi e lascia passare il gradiente invariato durante la backpropagation. Questa proprietà è fondamentale per mitigare il problema del gradiente che svanisce.
Anche se la ReLU è lineare per metà del suo spazio di input, tecnicamente è una funzione non lineare perché ha un punto non differenziabile in x=0, dove passa bruscamente a x. Questa non linearità consente alle reti neurali di apprendere schemi complessi.
Poiché la ReLU restituisce zero per tutti gli input negativi, porta naturalmente ad attivazioni sparse; in ogni momento, solo un sottoinsieme di neuroni è attivo, con un'elaborazione più efficiente.
La funzione ReLU è computazionalmente economica perché prevede una semplice soglia a zero. Questo consente di scalare le reti a molti strati senza un aumento significativo del carico computazionale, rispetto a funzioni più complesse come tanh o sigmoid.
Attivazione softmax
Funzione di attivazione softmax. Immagine dell'autore
La funzione di attivazione softmax, nota anche come funzione esponenziale normalizzata, è particolarmente utile nel contesto di problemi di classificazione multi-classe. Questa funzione opera su un vettore, spesso chiamato logits, che rappresenta le previsioni o i punteggi grezzi per ciascuna classe calcolati dagli strati precedenti di una rete neurale.
Per un vettore di input x con elementi x1, x2, ..., xC, la funzione softmax è definita come:
L'output della softmax è una distribuzione di probabilità che somma a uno. Ogni elemento dell'output rappresenta la probabilità che l'input appartenga a una particolare classe.
L'uso della funzione esponenziale garantisce che tutti i valori di output siano non negativi. Questo è cruciale perché le probabilità non possono essere negative.
La softmax amplifica le differenze nel vettore di input. Anche piccole differenze nei valori in ingresso possono portare a differenze sostanziali nelle probabilità in uscita, con i valori di input più alti che tendono a dominare nella distribuzione risultante.
La softmax è in genere utilizzata nello strato di output di una rete neurale quando il compito prevede di classificare un input in una tra più (oltre due) categorie possibili (classificazione multi-classe).
Le probabilità prodotte dalla softmax possono essere interpretate come punteggi di confidenza per ciascuna classe, fornendo un'idea della certezza del modello sulle sue previsioni.
Poiché la softmax amplifica le differenze, può essere sensibile agli outlier o a valori estremi. Ad esempio, se il vettore di input ha un valore molto grande, la softmax può "schiacciare" le probabilità delle altre classi, portando a un modello eccessivamente sicuro di sé.
Scegliere la funzione di attivazione giusta
La scelta della funzione di attivazione dipende dal tipo di problema che stai cercando di risolvere. Ecco alcune linee guida:
Per la classificazione binaria
Usa la funzione di attivazione sigmoid nello strato di output. Comprimerà gli output tra 0 e 1, rappresentando le probabilità per le due classi.
Per la classificazione multi-classe
Usa la funzione di attivazione softmax nello strato di output. Restituirà distribuzioni di probabilità su tutte le classi.
Se non sei sicuro
Usa la funzione di attivazione ReLU negli strati nascosti. ReLU è l'attivazione predefinita più comune e di solito una buona scelta.
Conclusione
Abbiamo esplorato il ruolo cruciale che le funzioni di attivazione svolgono nell'addestramento delle reti neurali. Abbiamo visto come non siano semplici optional, ma elementi essenziali che permettono alle reti neurali di cogliere e modellare la complessità insita nei dati del mondo reale. Dalla semplice ma efficace ReLU alle interpretazioni probabilistiche fornite dalla softmax, ogni funzione di attivazione ha il suo posto e la sua finalità nei diversi strati di una rete e nei vari domini di problema.
Con l'evoluzione continua delle reti neurali, l'esplorazione delle funzioni di attivazione si amplierà certamente, includendo forse nuove forme che affrontano sfide specifiche di architetture emergenti. Tuttavia, i principi e le funzioni discussi in questo blog probabilmente resteranno al centro della progettazione di reti neurali per il prossimo futuro.
La scelta attenta delle funzioni di attivazione è un equilibrio sottile—un mix di comprensione scientifica e intuizione—che può influenzare in modo significativo le prestazioni delle reti neurali.
Ti interessa imparare il deep learning con il framework Keras? Dai un'occhiata al nostro corso Introduzione al Deep Learning con Keras.