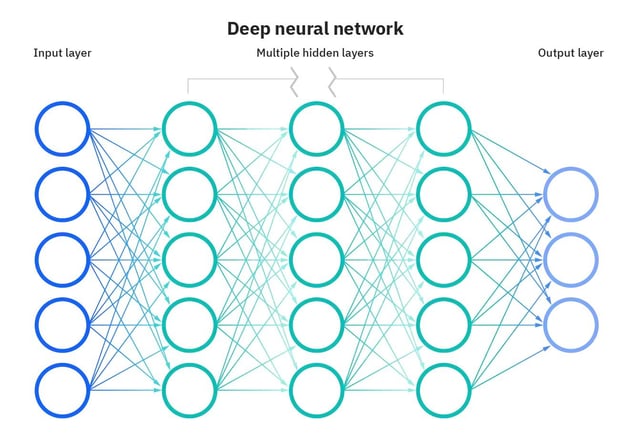
Weergave van een neuraal netwerk. Beeldbron
Wat zijn activatiefuncties?
Activatiefuncties zijn een essentieel bouwblok van neurale netwerken waarmee ze complexe patronen in data kunnen leren. Ze transformeren het ingangssignaal van een knoop in een neuraal netwerk naar een uitgangssignaal dat vervolgens naar de volgende laag wordt doorgegeven. Zonder activatiefuncties zouden neurale netwerken beperkt zijn tot het modelleren van alleen lineaire relaties tussen input en output.
Activatiefuncties introduceren niet-lineariteit, waardoor neurale netwerken zeer complexe verbanden tussen input en output kunnen leren.
De juiste activatiefunctie kiezen is cruciaal voor het trainen van neurale netwerken die goed generaliseren en nauwkeurige voorspellingen leveren. In deze post geven we een overzicht van de meest voorkomende activatiefuncties, hun rol en hoe je geschikte activatiefuncties selecteert voor verschillende use-cases.
Of je nu net begint met deep learning of al een doorgewinterde practitioner bent, een diepgaand begrip van activatiefuncties scherpt je intuïtie en verbetert je toepassing van neurale netwerken.
Waarom zijn activatiefuncties essentieel?
Zonder activatiefuncties zouden neurale netwerken alleen bestaan uit lineaire bewerkingen zoals matrixvermenigvuldiging. Alle lagen zouden lineaire transformaties op de input uitvoeren en er zouden geen niet-lineariteiten worden geïntroduceerd.
De meeste data in de echte wereld is niet-lineair. Zo zijn relaties tussen huizenprijzen en grootte, inkomen en aankopen, enz. niet-lineair. Als neurale netwerken geen activatiefuncties hadden, zouden ze de complexe niet-lineaire patronen die in real-world data voorkomen niet kunnen leren.
Activatiefuncties stellen neurale netwerken in staat deze niet-lineaire relaties te leren door niet-lineair gedrag te introduceren. Dit vergroot de flexibiliteit en kracht van neurale netwerken om complexe en genuanceerde data te modelleren aanzienlijk.
Typen activatiefuncties
Neurale netwerken gebruiken verschillende soorten activatiefuncties om niet-lineariteit te introduceren en complexe patronen te leren. Elke activatiefunctie heeft zijn eigen eigenschappen en is geschikt voor bepaalde use-cases.
Zo is de sigmoidfunctie ideaal voor binaire classificatieproblemen, is softmax nuttig voor multi-class voorspellingen en helpt ReLU het probleem van verdwijnende gradiënten te overwinnen.
De juiste activatiefunctie voor de taak gebruiken leidt tot snellere training en betere prestaties.
Laten we enkele veelgebruikte activatiefuncties bekijken:
Lineaire activatie
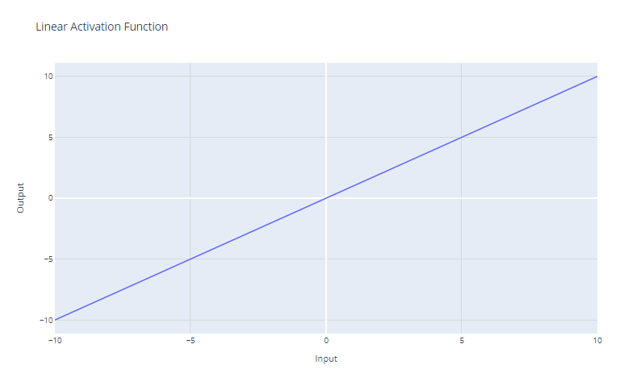
Lineaire activatiefunctie. Afbeelding door de auteur
De lineaire activatiefunctie is de eenvoudigste activatiefunctie, gedefinieerd als:
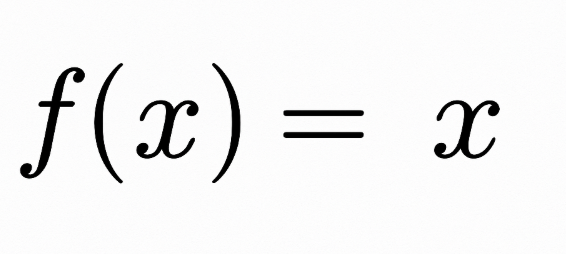
Hij geeft simpelweg de input x terug als output. Grafisch ziet het eruit als een rechte lijn met een helling van 1.
De belangrijkste use-case van de lineaire activatiefunctie is in de outputlaag van een neuraal netwerk dat voor regressie wordt gebruikt. Voor regressieproblemen waarbij we een numerieke waarde willen voorspellen, zorgt een lineaire activatiefunctie in de outputlaag ervoor dat het neuraal netwerk een numerieke waarde uitgeeft. De lineaire activatiefunctie perst of transformeert de output niet, dus de daadwerkelijk voorspelde waarde wordt teruggegeven.
De lineaire activatiefunctie wordt echter zelden gebruikt in verborgen lagen van neurale netwerken. Dit komt omdat hij geen niet-lineariteit toevoegt. Het hele doel van verborgen lagen is om niet-lineaire combinaties van de inputkenmerken te leren. Overal een lineaire activatie gebruiken zou het model beperken tot het leren van louter lineaire transformaties van de input.
Sigmoidactivatie
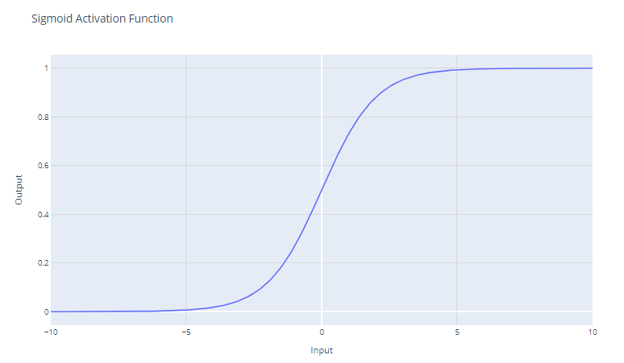
Sigmoidactivatiefunctie. Afbeelding door de auteur
De sigmoidactivatiefunctie, vaak weergegeven als σ(x), is een gladde, continu differentieerbare functie die historisch belangrijk is in de ontwikkeling van neurale netwerken. De sigmoid-activatiefunctie heeft de wiskundige vorm:
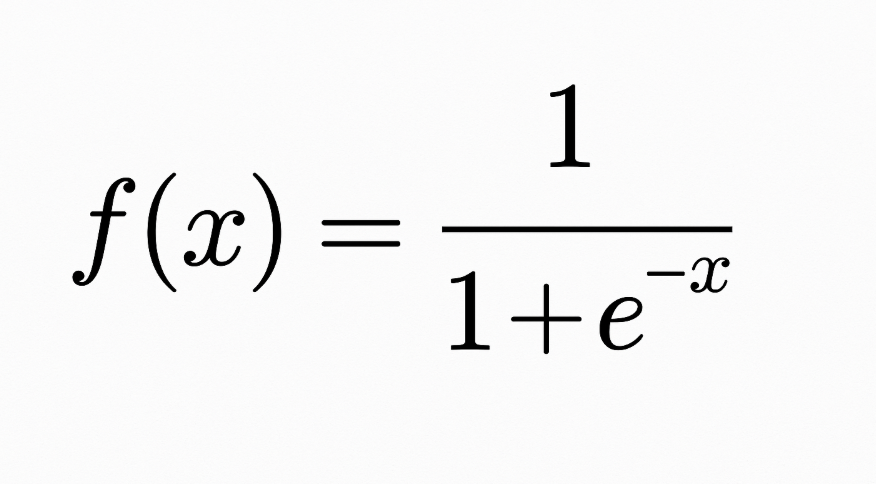
Ze neemt een reële input en perst die naar een waarde tussen 0 en 1. De sigmoidfunctie heeft een S-vormige curve die asymptotisch naar 0 gaat voor grote negatieve getallen en naar 1 voor grote positieve getallen. De outputs zijn eenvoudig te interpreteren als kansen, wat haar natuurlijk maakt voor binaire classificatieproblemen.
Sigmoïde eenheden waren populair in vroege neurale netwerken omdat de gradiënt het sterkst is wanneer de output van de eenheid rond 0,5 ligt, wat efficiënte backpropagatie mogelijk maakt. Sigmoïde eenheden hebben echter last van het probleem van de "verdwijnende gradiënt", wat het leren in diepe neurale netwerken belemmert.
Naarmate de inputwaarden sterk positief of negatief worden, verzadigt de functie op 0 of 1, met een extreem vlakke helling. In deze gebieden is de gradiënt vrijwel nul. Dit resulteert in zeer kleine wijzigingen in de gewichten tijdens backpropagatie, met name voor neuronen in de eerdere lagen van diepe netwerken, waardoor het leren pijnlijk traag wordt of zelfs stopt. Dit staat bekend als het probleem van de verdwijnende gradiënt in neurale netwerken.
De belangrijkste use-case van de sigmoidfunctie is als activatie voor de outputlaag van binaire classificatiemodellen. Ze perst de output naar een kanswaarde tussen 0 en 1, die kan worden geïnterpreteerd als de kans dat de input tot een bepaalde klasse behoort.
Tanh (hyperbolische tangens) activatie
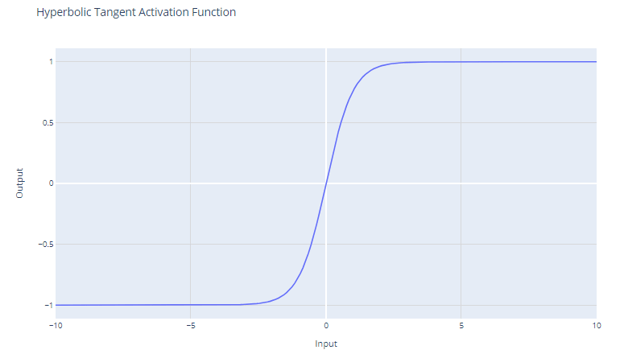
Tanh-activatiefunctie. Afbeelding door de auteur
De tanh (hyperbolische tangens) activatiefunctie is gedefinieerd als:
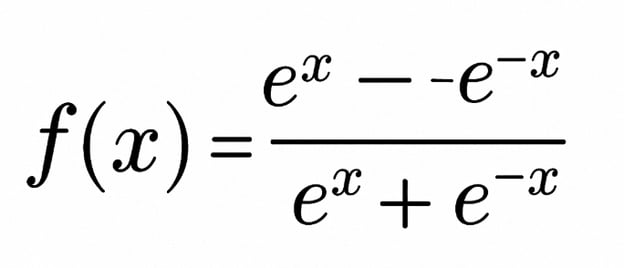
De tanh-functie geeft waarden in het bereik van -1 tot +1. Dit betekent dat ze negatieve waarden effectiever kan verwerken dan de sigmoidfunctie, die een bereik van 0 tot 1 heeft.
In tegenstelling tot de sigmoidfunctie is tanh nulgecentreerd, wat betekent dat de output symmetrisch is rond de oorsprong van het assenstelsel. Dit wordt vaak als een voordeel gezien omdat het het leeralgoritme kan helpen sneller te convergeren.
Omdat de output van tanh tussen -1 en +1 ligt, heeft ze sterkere gradiënten dan de sigmoidfunctie. Sterkere gradiënten leiden vaak tot sneller leren en snellere convergentie tijdens training, omdat ze doorgaans beter bestand zijn tegen het probleem van verdwijnende gradiënten vergeleken met de gradiënten van de sigmoidfunctie.
Ondanks deze voordelen heeft de tanh-functie nog steeds last van het probleem van de verdwijnende gradiënt. Tijdens backpropagatie kunnen de gradiënten van de tanh-functie erg klein worden (dicht bij nul). Dit is vooral problematisch voor diepe netwerken met veel lagen; de gradiënten van de verliesfunctie kunnen te klein worden om tijdens training significante wijzigingen in de gewichten aan te brengen wanneer ze terug naar de eerste lagen propageren. Dit kan het trainingsproces drastisch vertragen en tot slechte convergentie-eigenschappen leiden.
De tanh-functie wordt vaak gebruikt in de verborgen lagen van een neuraal netwerk. Vanwege haar nulgecentreerde karakter kan training efficiënter verlopen wanneer de data ook is genormaliseerd met gemiddelde nul.
Als je moet kiezen tussen sigmoid en tanh en je hebt geen specifieke reden om de een boven de ander te verkiezen, is tanh vaak de betere keuze om de hierboven genoemde redenen. De beslissing kan echter ook worden beïnvloed door de specifieke use-case en het gedrag van het netwerk tijdens de eerste trainingsexperimenten.
Je kunt een eenvoudig neuraal netwerk from scratch bouwen met PyTorch door onze tutorial van Kurtis Pykes te volgen, of, als je een gevorderde gebruiker bent, is onze Deep Learning met PyTorch-cursus iets voor jou. .
ReLU (rectified linear unit) activatie
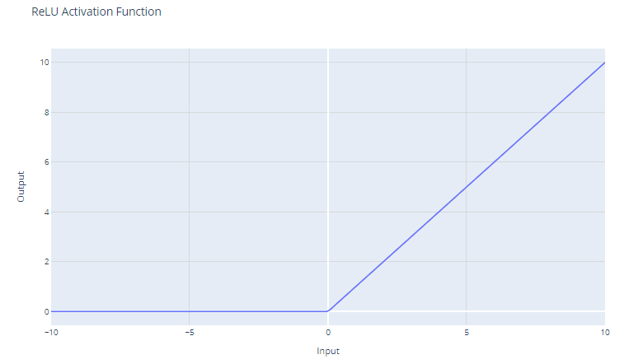
Rectified Linear Unit (ReLU) activatiefunctie. Afbeelding door de auteur
De Rectified Linear Unit (ReLU) activatiefunctie heeft de vorm:
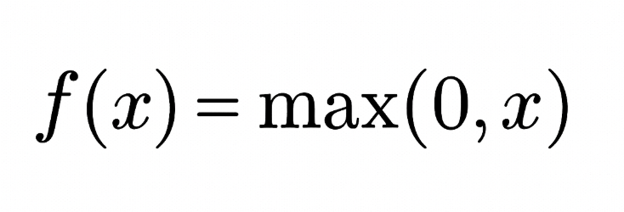
Ze drempelt de input op nul, geeft 0 terug voor negatieve waarden en de input zelf voor positieve waarden.
Voor inputs groter dan 0 gedraagt ReLU zich als een lineaire functie met een gradiënt van 1. Dit betekent dat ze de schaal van positieve inputs niet verandert en de gradiënt tijdens backpropagatie ongehinderd doorlaat. Deze eigenschap is cruciaal om het probleem van verdwijnende gradiënten te beperken.
Hoewel ReLU lineair is voor de helft van haar inputruimte, is ze technisch gezien een niet-lineaire functie omdat ze een niet-differentieerbaar punt heeft bij x=0, waar ze abrupt verandert van x. Deze niet-lineariteit stelt neurale netwerken in staat complexe patronen te leren.
Omdat ReLU voor alle negatieve inputs nul teruggeeft, leidt ze van nature tot schaarse activaties; op elk moment wordt slechts een subset van neuronen geactiveerd, wat tot efficiëntere berekening leidt.
De ReLU-functie is computationeel goedkoop omdat ze neerkomt op eenvoudig drempelen op nul. Hierdoor kunnen netwerken opschalen naar veel lagen zonder een significante toename van de rekenlast, vergeleken met complexere functies zoals tanh of sigmoid.
Softmaxactivatie
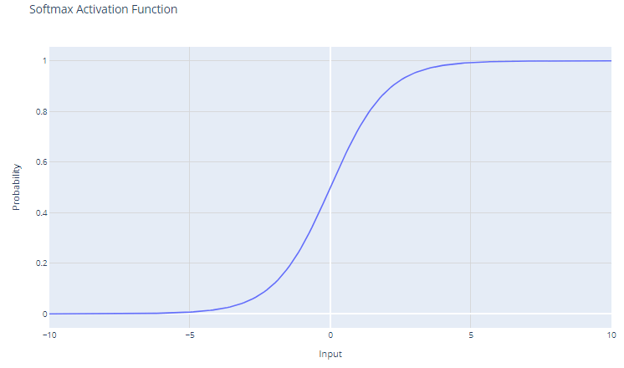
Softmax-activatiefunctie. Afbeelding door de auteur
De softmaxactivatiefunctie, ook wel de genormaliseerde exponentiële functie genoemd, is vooral nuttig in de context van multi-class classificatieproblemen. Deze functie werkt op een vector, vaak logits genoemd, die de ruwe voorspellingen of scores voor elke klasse weergeeft, berekend door de vorige lagen van een neuraal netwerk.
Voor invoervector x met elementen x1, x2, ..., xC is de softmax-functie gedefinieerd als:
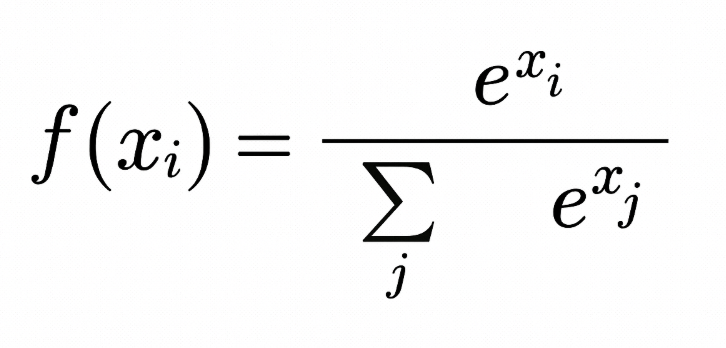
De output van de softmaxfunctie is een kansverdeling die optelt tot één. Elk element van de output vertegenwoordigt de kans dat de input tot een bepaalde klasse behoort.
Het gebruik van de exponentiële functie zorgt ervoor dat alle outputwaarden niet-negatief zijn. Dit is cruciaal omdat kansen niet negatief kunnen zijn.
Softmax versterkt verschillen in de invoervector. Zelfs kleine verschillen in de inputwaarden kunnen leiden tot aanzienlijke verschillen in de outputkansen, waarbij de hoogste inputwaarde(n) de resulterende kansverdeling vaak domineren.
Softmax wordt meestal gebruikt in de outputlaag van een neuraal netwerk wanneer de taak inhoudt dat een input in een van meerdere (meer dan twee) mogelijke categorieën wordt geclassificeerd (multi-class classificatie).
De door de softmaxfunctie geproduceerde kansen kunnen worden geïnterpreteerd als betrouwbaarheidscores voor elke klasse, wat inzicht geeft in de zekerheid van het model over zijn voorspellingen.
Omdat softmax verschillen versterkt, kan ze gevoelig zijn voor uitschieters of extreme waarden. Als de invoervector bijvoorbeeld een zeer grote waarde heeft, kan softmax de kansen van andere klassen "platdrukken", wat leidt tot een overzelfverzekerd model.
De juiste activatiefunctie kiezen
De keuze van de activatiefunctie hangt af van het type probleem dat je probeert op te lossen. Hier zijn enkele richtlijnen:
Voor binaire classificatie
Gebruik de sigmoidactivatiefunctie in de outputlaag. Die perst outputs tussen 0 en 1, wat kansen voor de twee klassen weergeeft.
Voor multi-class classificatie
Gebruik de softmaxactivatiefunctie in de outputlaag. Die geeft kansverdelingen over alle klassen.
Als je twijfelt
Gebruik de ReLU-activatiefunctie in de verborgen lagen. ReLU is de meest gebruikelijke standaardactivatie en doorgaans een goede keuze.
Conclusie
We hebben de cruciale rol verkend die activatiefuncties spelen bij het trainen van neurale netwerken. We hebben gezien dat het niet slechts optionele extra’s zijn, maar essentiële elementen die neurale netwerken in staat stellen de complexiteit in real-world data vast te leggen en te modelleren. Van de eenvoudige maar effectieve ReLU tot de probabilistische interpretaties van de softmaxfunctie: elke activatiefunctie heeft zijn plek en doel binnen verschillende lagen van een netwerk en in uiteenlopende probleemdomeinen.
Naarmate neurale netwerken zich blijven ontwikkelen, zal het onderzoek naar activatiefuncties ongetwijfeld uitbreiden, mogelijk met nieuwe vormen die specifieke uitdagingen van opkomende architecturen aanpakken. Toch zullen de principes en functies die in deze blog zijn besproken naar verwachting de kern van neuraledesign blijven in de nabije toekomst.
De zorgvuldige selectie van activatiefuncties is een evenwichtsoefening—een mix van wetenschappelijk begrip en gevoel voor nuance—die de prestaties van neurale netwerken aanzienlijk kan beïnvloeden.
Wil je deep learning leren met het Keras-framework? Bekijk dan onze cursus Introduction to Deep Learning with Keras.




Weergave van een neuraal netwerk. Beeldbron
Wat zijn activatiefuncties?
Activatiefuncties zijn een essentieel bouwblok van neurale netwerken waarmee ze complexe patronen in data kunnen leren. Ze transformeren het ingangssignaal van een knoop in een neuraal netwerk naar een uitgangssignaal dat vervolgens naar de volgende laag wordt doorgegeven. Zonder activatiefuncties zouden neurale netwerken beperkt zijn tot het modelleren van alleen lineaire relaties tussen input en output.
Activatiefuncties introduceren niet-lineariteit, waardoor neurale netwerken zeer complexe verbanden tussen input en output kunnen leren.
De juiste activatiefunctie kiezen is cruciaal voor het trainen van neurale netwerken die goed generaliseren en nauwkeurige voorspellingen leveren. In deze post geven we een overzicht van de meest voorkomende activatiefuncties, hun rol en hoe je geschikte activatiefuncties selecteert voor verschillende use-cases.
Of je nu net begint met deep learning of al een doorgewinterde practitioner bent, een diepgaand begrip van activatiefuncties scherpt je intuïtie en verbetert je toepassing van neurale netwerken.
Waarom zijn activatiefuncties essentieel?
Zonder activatiefuncties zouden neurale netwerken alleen bestaan uit lineaire bewerkingen zoals matrixvermenigvuldiging. Alle lagen zouden lineaire transformaties op de input uitvoeren en er zouden geen niet-lineariteiten worden geïntroduceerd.
De meeste data in de echte wereld is niet-lineair. Zo zijn relaties tussen huizenprijzen en grootte, inkomen en aankopen, enz. niet-lineair. Als neurale netwerken geen activatiefuncties hadden, zouden ze de complexe niet-lineaire patronen die in real-world data voorkomen niet kunnen leren.
Activatiefuncties stellen neurale netwerken in staat deze niet-lineaire relaties te leren door niet-lineair gedrag te introduceren. Dit vergroot de flexibiliteit en kracht van neurale netwerken om complexe en genuanceerde data te modelleren aanzienlijk.
Typen activatiefuncties
Neurale netwerken gebruiken verschillende soorten activatiefuncties om niet-lineariteit te introduceren en complexe patronen te leren. Elke activatiefunctie heeft zijn eigen eigenschappen en is geschikt voor bepaalde use-cases.
Zo is de sigmoidfunctie ideaal voor binaire classificatieproblemen, is softmax nuttig voor multi-class voorspellingen en helpt ReLU het probleem van verdwijnende gradiënten te overwinnen.
De juiste activatiefunctie voor de taak gebruiken leidt tot snellere training en betere prestaties.
Laten we enkele veelgebruikte activatiefuncties bekijken:
Lineaire activatie
Lineaire activatiefunctie. Afbeelding door de auteur
De lineaire activatiefunctie is de eenvoudigste activatiefunctie, gedefinieerd als:
Hij geeft simpelweg de input x terug als output. Grafisch ziet het eruit als een rechte lijn met een helling van 1.
De belangrijkste use-case van de lineaire activatiefunctie is in de outputlaag van een neuraal netwerk dat voor regressie wordt gebruikt. Voor regressieproblemen waarbij we een numerieke waarde willen voorspellen, zorgt een lineaire activatiefunctie in de outputlaag ervoor dat het neuraal netwerk een numerieke waarde uitgeeft. De lineaire activatiefunctie perst of transformeert de output niet, dus de daadwerkelijk voorspelde waarde wordt teruggegeven.
De lineaire activatiefunctie wordt echter zelden gebruikt in verborgen lagen van neurale netwerken. Dit komt omdat hij geen niet-lineariteit toevoegt. Het hele doel van verborgen lagen is om niet-lineaire combinaties van de inputkenmerken te leren. Overal een lineaire activatie gebruiken zou het model beperken tot het leren van louter lineaire transformaties van de input.
Sigmoidactivatie
Sigmoidactivatiefunctie. Afbeelding door de auteur
De sigmoidactivatiefunctie, vaak weergegeven als σ(x), is een gladde, continu differentieerbare functie die historisch belangrijk is in de ontwikkeling van neurale netwerken. De sigmoid-activatiefunctie heeft de wiskundige vorm:
Ze neemt een reële input en perst die naar een waarde tussen 0 en 1. De sigmoidfunctie heeft een S-vormige curve die asymptotisch naar 0 gaat voor grote negatieve getallen en naar 1 voor grote positieve getallen. De outputs zijn eenvoudig te interpreteren als kansen, wat haar natuurlijk maakt voor binaire classificatieproblemen.
Sigmoïde eenheden waren populair in vroege neurale netwerken omdat de gradiënt het sterkst is wanneer de output van de eenheid rond 0,5 ligt, wat efficiënte backpropagatie mogelijk maakt. Sigmoïde eenheden hebben echter last van het probleem van de "verdwijnende gradiënt", wat het leren in diepe neurale netwerken belemmert.
Naarmate de inputwaarden sterk positief of negatief worden, verzadigt de functie op 0 of 1, met een extreem vlakke helling. In deze gebieden is de gradiënt vrijwel nul. Dit resulteert in zeer kleine wijzigingen in de gewichten tijdens backpropagatie, met name voor neuronen in de eerdere lagen van diepe netwerken, waardoor het leren pijnlijk traag wordt of zelfs stopt. Dit staat bekend als het probleem van de verdwijnende gradiënt in neurale netwerken.
De belangrijkste use-case van de sigmoidfunctie is als activatie voor de outputlaag van binaire classificatiemodellen. Ze perst de output naar een kanswaarde tussen 0 en 1, die kan worden geïnterpreteerd als de kans dat de input tot een bepaalde klasse behoort.
Tanh (hyperbolische tangens) activatie
Tanh-activatiefunctie. Afbeelding door de auteur
De tanh (hyperbolische tangens) activatiefunctie is gedefinieerd als:
De tanh-functie geeft waarden in het bereik van -1 tot +1. Dit betekent dat ze negatieve waarden effectiever kan verwerken dan de sigmoidfunctie, die een bereik van 0 tot 1 heeft.
In tegenstelling tot de sigmoidfunctie is tanh nulgecentreerd, wat betekent dat de output symmetrisch is rond de oorsprong van het assenstelsel. Dit wordt vaak als een voordeel gezien omdat het het leeralgoritme kan helpen sneller te convergeren.
Omdat de output van tanh tussen -1 en +1 ligt, heeft ze sterkere gradiënten dan de sigmoidfunctie. Sterkere gradiënten leiden vaak tot sneller leren en snellere convergentie tijdens training, omdat ze doorgaans beter bestand zijn tegen het probleem van verdwijnende gradiënten vergeleken met de gradiënten van de sigmoidfunctie.
Ondanks deze voordelen heeft de tanh-functie nog steeds last van het probleem van de verdwijnende gradiënt. Tijdens backpropagatie kunnen de gradiënten van de tanh-functie erg klein worden (dicht bij nul). Dit is vooral problematisch voor diepe netwerken met veel lagen; de gradiënten van de verliesfunctie kunnen te klein worden om tijdens training significante wijzigingen in de gewichten aan te brengen wanneer ze terug naar de eerste lagen propageren. Dit kan het trainingsproces drastisch vertragen en tot slechte convergentie-eigenschappen leiden.
De tanh-functie wordt vaak gebruikt in de verborgen lagen van een neuraal netwerk. Vanwege haar nulgecentreerde karakter kan training efficiënter verlopen wanneer de data ook is genormaliseerd met gemiddelde nul.
Als je moet kiezen tussen sigmoid en tanh en je hebt geen specifieke reden om de een boven de ander te verkiezen, is tanh vaak de betere keuze om de hierboven genoemde redenen. De beslissing kan echter ook worden beïnvloed door de specifieke use-case en het gedrag van het netwerk tijdens de eerste trainingsexperimenten.
Je kunt een eenvoudig neuraal netwerk from scratch bouwen met PyTorch door onze tutorial van Kurtis Pykes te volgen, of, als je een gevorderde gebruiker bent, is onze Deep Learning met PyTorch-cursus iets voor jou. .
ReLU (rectified linear unit) activatie
Rectified Linear Unit (ReLU) activatiefunctie. Afbeelding door de auteur
De Rectified Linear Unit (ReLU) activatiefunctie heeft de vorm:
Ze drempelt de input op nul, geeft 0 terug voor negatieve waarden en de input zelf voor positieve waarden.
Voor inputs groter dan 0 gedraagt ReLU zich als een lineaire functie met een gradiënt van 1. Dit betekent dat ze de schaal van positieve inputs niet verandert en de gradiënt tijdens backpropagatie ongehinderd doorlaat. Deze eigenschap is cruciaal om het probleem van verdwijnende gradiënten te beperken.
Hoewel ReLU lineair is voor de helft van haar inputruimte, is ze technisch gezien een niet-lineaire functie omdat ze een niet-differentieerbaar punt heeft bij x=0, waar ze abrupt verandert van x. Deze niet-lineariteit stelt neurale netwerken in staat complexe patronen te leren.
Omdat ReLU voor alle negatieve inputs nul teruggeeft, leidt ze van nature tot schaarse activaties; op elk moment wordt slechts een subset van neuronen geactiveerd, wat tot efficiëntere berekening leidt.
De ReLU-functie is computationeel goedkoop omdat ze neerkomt op eenvoudig drempelen op nul. Hierdoor kunnen netwerken opschalen naar veel lagen zonder een significante toename van de rekenlast, vergeleken met complexere functies zoals tanh of sigmoid.
Softmaxactivatie
Softmax-activatiefunctie. Afbeelding door de auteur
De softmaxactivatiefunctie, ook wel de genormaliseerde exponentiële functie genoemd, is vooral nuttig in de context van multi-class classificatieproblemen. Deze functie werkt op een vector, vaak logits genoemd, die de ruwe voorspellingen of scores voor elke klasse weergeeft, berekend door de vorige lagen van een neuraal netwerk.
Voor invoervector x met elementen x1, x2, ..., xC is de softmax-functie gedefinieerd als:
De output van de softmaxfunctie is een kansverdeling die optelt tot één. Elk element van de output vertegenwoordigt de kans dat de input tot een bepaalde klasse behoort.
Het gebruik van de exponentiële functie zorgt ervoor dat alle outputwaarden niet-negatief zijn. Dit is cruciaal omdat kansen niet negatief kunnen zijn.
Softmax versterkt verschillen in de invoervector. Zelfs kleine verschillen in de inputwaarden kunnen leiden tot aanzienlijke verschillen in de outputkansen, waarbij de hoogste inputwaarde(n) de resulterende kansverdeling vaak domineren.
Softmax wordt meestal gebruikt in de outputlaag van een neuraal netwerk wanneer de taak inhoudt dat een input in een van meerdere (meer dan twee) mogelijke categorieën wordt geclassificeerd (multi-class classificatie).
De door de softmaxfunctie geproduceerde kansen kunnen worden geïnterpreteerd als betrouwbaarheidscores voor elke klasse, wat inzicht geeft in de zekerheid van het model over zijn voorspellingen.
Omdat softmax verschillen versterkt, kan ze gevoelig zijn voor uitschieters of extreme waarden. Als de invoervector bijvoorbeeld een zeer grote waarde heeft, kan softmax de kansen van andere klassen "platdrukken", wat leidt tot een overzelfverzekerd model.
De juiste activatiefunctie kiezen
De keuze van de activatiefunctie hangt af van het type probleem dat je probeert op te lossen. Hier zijn enkele richtlijnen:
Voor binaire classificatie
Gebruik de sigmoidactivatiefunctie in de outputlaag. Die perst outputs tussen 0 en 1, wat kansen voor de twee klassen weergeeft.
Voor multi-class classificatie
Gebruik de softmaxactivatiefunctie in de outputlaag. Die geeft kansverdelingen over alle klassen.
Als je twijfelt
Gebruik de ReLU-activatiefunctie in de verborgen lagen. ReLU is de meest gebruikelijke standaardactivatie en doorgaans een goede keuze.
Conclusie
We hebben de cruciale rol verkend die activatiefuncties spelen bij het trainen van neurale netwerken. We hebben gezien dat het niet slechts optionele extra’s zijn, maar essentiële elementen die neurale netwerken in staat stellen de complexiteit in real-world data vast te leggen en te modelleren. Van de eenvoudige maar effectieve ReLU tot de probabilistische interpretaties van de softmaxfunctie: elke activatiefunctie heeft zijn plek en doel binnen verschillende lagen van een netwerk en in uiteenlopende probleemdomeinen.
Naarmate neurale netwerken zich blijven ontwikkelen, zal het onderzoek naar activatiefuncties ongetwijfeld uitbreiden, mogelijk met nieuwe vormen die specifieke uitdagingen van opkomende architecturen aanpakken. Toch zullen de principes en functies die in deze blog zijn besproken naar verwachting de kern van neuraledesign blijven in de nabije toekomst.
De zorgvuldige selectie van activatiefuncties is een evenwichtsoefening—een mix van wetenschappelijk begrip en gevoel voor nuance—die de prestaties van neurale netwerken aanzienlijk kan beïnvloeden.
Wil je deep learning leren met het Keras-framework? Bekijk dan onze cursus Introduction to Deep Learning with Keras.