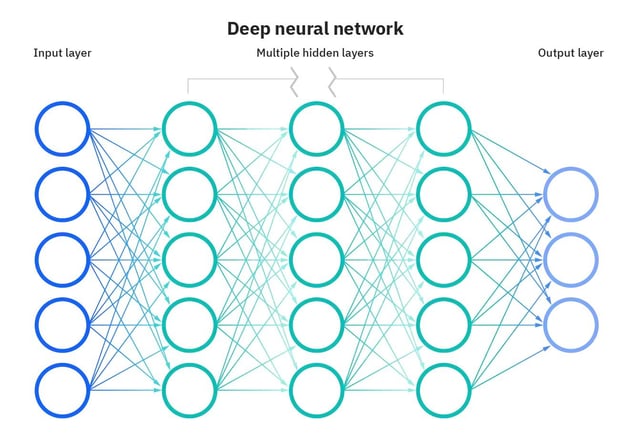
न्यूरल नेटवर्क का निरूपण। छवि स्रोत
एक्टिवेशन फंक्शंस क्या होते हैं?
एक्टिवेशन फंक्शंस न्यूरल नेटवर्क्स के मूल निर्माण खंड हैं जो उन्हें डेटा में जटिल पैटर्न सीखने में सक्षम बनाते हैं। वे न्यूरल नेटवर्क के एक नोड के इनपुट सिग्नल को आउटपुट सिग्नल में बदलते हैं, जिसे अगली लेयर में पास किया जाता है। एक्टिवेशन फंक्शंस के बिना, न्यूरल नेटवर्क्स केवल इनपुट और आउटपुट के बीच रैखिक (linear) संबंधों का ही मॉडल बना पाते।
एक्टिवेशन फंक्शंस गैर-रैखिकता (non-linearity) लाते हैं, जिससे न्यूरल नेटवर्क्स इनपुट और आउटपुट के बीच अत्यंत जटिल मैपिंग सीख पाते हैं।
उचित एक्टिवेशन फंक्शन चुनना ऐसे न्यूरल नेटवर्क्स को प्रशिक्षित करने के लिए महत्वपूर्ण है जो अच्छे से जनरलाइज़ करें और सटीक पूर्वानुमान दें। इस पोस्ट में, हम सबसे आम एक्टिवेशन फंक्शंस, उनकी भूमिकाओं और विभिन्न उपयोग-परिदृश्यों के लिए उपयुक्त एक्टिवेशन फंक्शंस कैसे चुनें, का एक अवलोकन देंगे।
चाहे आप डीप लर्निंग में अभी शुरुआत कर रहे हों या अनुभवी प्रैक्टिशनर हों, एक्टिवेशन फंक्शंस की गहरी समझ आपकी अंतर्दृष्टि को मजबूत करेगी और न्यूरल नेटवर्क्स के उपयोग में सुधार लाएगी।
एक्टिवेशन फंक्शंस आवश्यक क्यों हैं?
एक्टिवेशन फंक्शंस के बिना, न्यूरल नेटवर्क्स केवल मैट्रिक्स गुणा जैसी रैखिक क्रियाओं तक सीमित रहेंगे। सभी लेयर्स इनपुट के रैखिक परिवर्तन ही करेंगी और कोई गैर-रैखिकता शामिल नहीं होगी।
अधिकांश वास्तविक दुनिया का डेटा गैर-रैखिक होता है। उदाहरण के लिए, मकान की कीमत और आकार, आय और खरीदारी आदि के संबंध गैर-रैखिक हैं। यदि न्यूरल नेटवर्क्स में एक्टिवेशन फंक्शंस न हों, तो वे वास्तविक डेटा में मौजूद इन जटिल गैर-रैखिक पैटर्नों को सीखने में असफल रहेंगे।
एक्टिवेशन फंक्शंस इन गैर-रैखिक संबंधों को सीखने में सक्षम बनाते हैं क्योंकि वे गैर-रैखिक व्यवहार जोड़ते हैं। इससे जटिल और सूक्ष्म डेटा का मॉडल बनाने में न्यूरल नेटवर्क्स की लचीलापन और क्षमता काफी बढ़ जाती है।
एक्टिवेशन फंक्शंस के प्रकार
न्यूरल नेटवर्क्स विभिन्न प्रकार के एक्टिवेशन फंक्शंस का उपयोग गैर-रैखिकता लाने और जटिल पैटर्न सीखने के लिए करते हैं। प्रत्येक एक्टिवेशन फंक्शन के अपने गुण होते हैं और वे कुछ विशिष्ट उपयोग-परिदृश्यों के लिए उपयुक्त होते हैं।
उदाहरण के लिए, sigmoid फ़ंक्शन द्विआधारी वर्गीकरण समस्याओं के लिए आदर्श है, softmax बहु-वर्ग भविष्यवाणी में उपयोगी है, और ReLU vanishing gradient समस्या को कम करने में मदद करता है।
कार्य के लिए सही एक्टिवेशन फंक्शन का उपयोग करने से प्रशिक्षण तेज होता है और प्रदर्शन बेहतर होता है।
आइए कुछ सामान्य एक्टिवेशन फंक्शंस पर नज़र डालें:
Linear activation
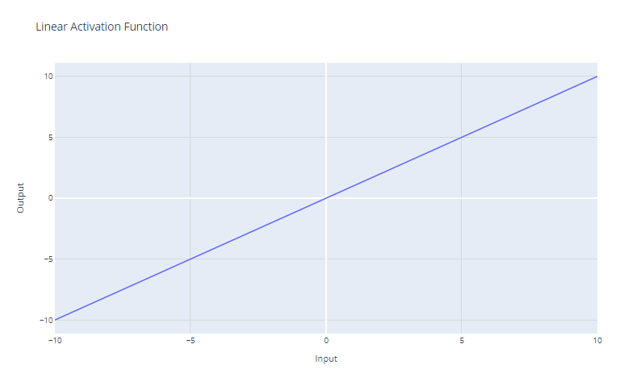
लिनीयर एक्टिवेशन फंक्शन। छवि: लेखक
लिनीयर एक्टिवेशन फंक्शन सबसे सरल है, जिसे इस प्रकार परिभाषित किया जाता है:
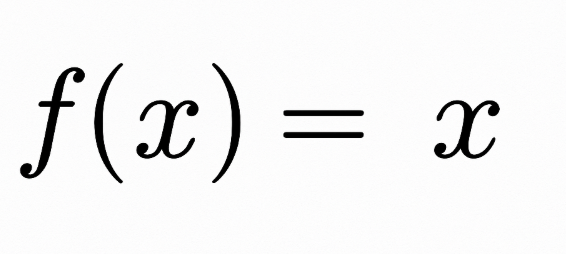
यह बस इनपुट x को ही आउटपुट में लौटाता है। ग्राफिक रूप से यह ढाल 1 वाली सीधी रेखा जैसा दिखता है।
लिनीयर एक्टिवेशन फंक्शन का मुख्य उपयोग प्रतिगमन (regression) के लिए प्रयुक्त न्यूरल नेटवर्क के आउटपुट लेयर में होता है। जहाँ हमें संख्यात्मक मान का पूर्वानुमान करना होता है, वहाँ आउटपुट लेयर में लिनीयर एक्टिवेशन सुनिश्चित करता है कि नेटवर्क संख्यात्मक मान ही निकाले। यह आउटपुट को दबाता या रूपांतरित नहीं करता, इसलिए वास्तविक पूर्वानुमानित मान ही लौटता है।
हालाँकि, छिपी हुई लेयर्स में लिनीयर एक्टिवेशन कम ही उपयोग होता है क्योंकि यह कोई गैर-रैखिकता नहीं देता। हिडन लेयर्स का उद्देश्य इनपुट फ़ीचर्स के गैर-रैखिक संयोजन सीखना होता है। हर जगह लिनीयर एक्टिवेशन प्रयोग करने से मॉडल सिर्फ इनपुट के रैखिक रूपांतरण तक सीमित रह जाएगा।
Sigmoid activation
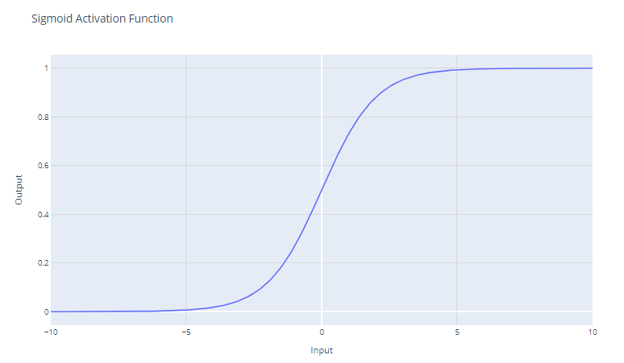
Sigmoid एक्टिवेशन फंक्शन। छवि: लेखक
Sigmoid एक्टिवेशन फंक्शन, जिसे अक्सर σ(x) से दर्शाया जाता है, एक स्मूद और सतत अवकलनीय फ़ंक्शन है, जो न्यूरल नेटवर्क्स के विकास में ऐतिहासिक रूप से महत्वपूर्ण रहा है। Sigmoid एक्टिवेशन फंक्शन का गणितीय रूप है:
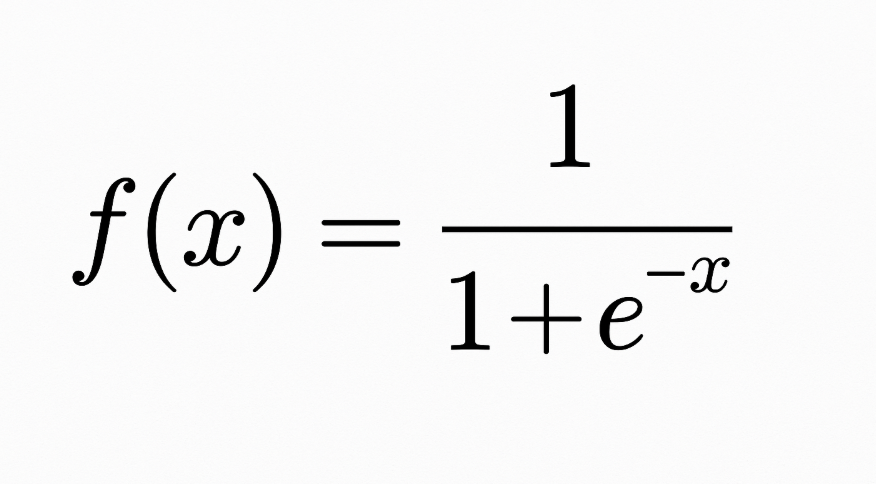
यह वास्तविक मान वाले इनपुट को 0 और 1 के बीच के मान में समेट देता है। Sigmoid कर्व "S" आकार का होता है, जो बड़े ऋणात्मक संख्याओं के लिए 0 और बड़े धनात्मक संख्याओं के लिए 1 के आसिम्प्टोट तक पहुँचता है। आउटपुट को आसानी से प्रायिकता के रूप में व्याख्यायित किया जा सकता है, जो इसे द्विआधारी वर्गीकरण के लिए स्वाभाविक विकल्प बनाता है।
प्रारंभिक न्यूरल नेटवर्क्स में sigmoid यूनिट्स लोकप्रिय थे क्योंकि जब यूनिट का आउटपुट 0.5 के पास होता है तो ग्रेडिएंट सबसे प्रबल होता है, जिससे बैकप्रोपेगेशन कुशल रहता है। हालांकि, sigmoid यूनिट्स "vanishing gradient" समस्या से ग्रस्त होते हैं, जो गहरे नेटवर्क्स में सीखने में बाधा डालती है।
जब इनपुट मान बहुत अधिक धनात्मक या ऋणात्मक हो जाते हैं, तो फ़ंक्शन 0 या 1 पर संतृप्त हो जाता है और ढाल अत्यंत सपाट हो जाती है। इन क्षेत्रों में ग्रेडिएंट लगभग शून्य के पास होता है। इससे बैकप्रोपेगेशन के दौरान वेट्स में बहुत छोटे परिवर्तन होते हैं, खासकर शुरुआती लेयर्स के न्यूरॉन्स के लिए, जिससे सीखना बेहद धीमा हो सकता है या रुक भी सकता है। इसे ही न्यूरल नेटवर्क्स में vanishing gradient समस्या कहा जाता है।
Sigmoid का मुख्य उपयोग द्विआधारी वर्गीकरण मॉडलों के आउटपुट लेयर में एक्टिवेशन के रूप में होता है। यह आउटपुट को 0 और 1 के बीच की प्रायिकता में समेट देता है, जिसे किसी विशेष वर्ग से इनपुट के संबंधित होने की प्रायिकता के रूप में समझा जा सकता है।
Tanh (hyperbolic tangent) activation
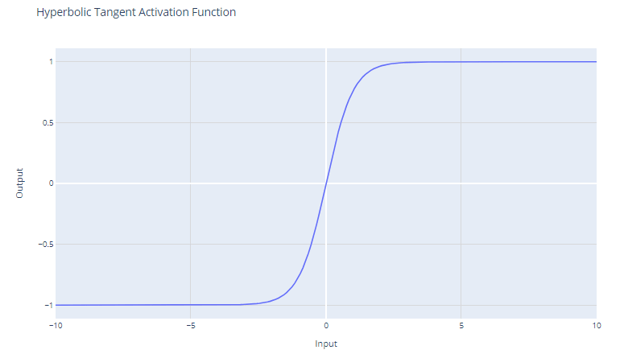
Tanh एक्टिवेशन फंक्शन। छवि: लेखक
Tanh (hyperbolic tangent) एक्टिवेशन फंक्शन इस प्रकार परिभाषित है:
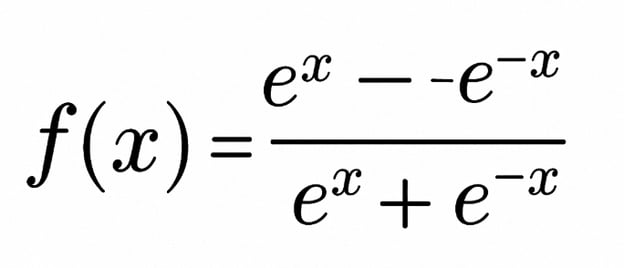
Tanh फ़ंक्शन -1 से +1 की सीमा में मान देता है। इसका अर्थ है कि यह ऋणात्मक मानों को sigmoid की तुलना में, जिसका दायरा 0 से 1 है, अधिक प्रभावी ढंग से संभाल पाता है।
Sigmoid के विपरीत, tanh शून्य-केंद्रित है, यानी इसका आउटपुट निर्देशांक तंत्र के उद्गम के सापेक्ष सममित होता है। इसे अक्सर लाभ माना जाता है क्योंकि यह लर्निंग एल्गोरिद्म को तेजी से अभिसरण करने में मदद कर सकता है।
चूँकि tanh का आउटपुट -1 से +1 के बीच होता है, इसके ग्रेडिएंट sigmoid की तुलना में अधिक प्रबल होते हैं। प्रबल ग्रेडिएंट अक्सर प्रशिक्षण के दौरान तेज़ सीखने और अभिसरण का कारण बनते हैं, क्योंकि वे sigmoid के ग्रेडिएंट की तुलना में vanishing gradient समस्या के प्रति अधिक सहनशील होते हैं।
इन फायदों के बावजूद, tanh भी vanishing gradient समस्या से अछूता नहीं है। बैकप्रोपेगेशन के दौरान tanh के ग्रेडिएंट बहुत छोटे (शून्य के पास) हो सकते हैं। यह विशेष रूप से कई लेयर्स वाले गहरे नेटवर्क्स में समस्या पैदा करता है; जैसे-जैसे ग्रेडिएंट शुरुआती लेयर्स तक लौटते हैं, वे इतने छोटे हो सकते हैं कि वेट्स में सार्थक परिवर्तन न कर पाएं। इससे प्रशिक्षण काफी धीमा हो सकता है और अभिसरण खराब हो सकता है।
Tanh फ़ंक्शन का उपयोग अक्सर न्यूरल नेटवर्क की हिडन लेयर्स में किया जाता है। इसके शून्य-केंद्रित स्वभाव के कारण, जब डेटा को भी शून्य-माध्य पर सामान्यीकृत किया जाता है, तो यह अधिक कुशल प्रशिक्षण का कारण बन सकता है।
यदि sigmoid और tanh में से किसी एक को चुनना हो और किसी विशेष कारण से कोई प्राथमिकता न हो, तो अक्सर ऊपर बताए कारणों से tanh बेहतर विकल्प होता है। हालांकि, निर्णय विशिष्ट उपयोग-परिदृश्य और प्रारंभिक प्रशिक्षण प्रयोगों के दौरान नेटवर्क के व्यवहार से भी प्रभावित हो सकता है।
आप PyTorch का उपयोग करके शून्य से एक सरल न्यूरल नेटवर्क बनाएँ — Kurtis Pykes के हमारे ट्यूटोरियल का अनुसरण करते हुए, या यदि आप उन्नत उपयोगकर्ता हैं, तो हमारा Deep Learning with PyTorch कोर्स आपके लिए है। .
ReLU (rectified linear unit) activation
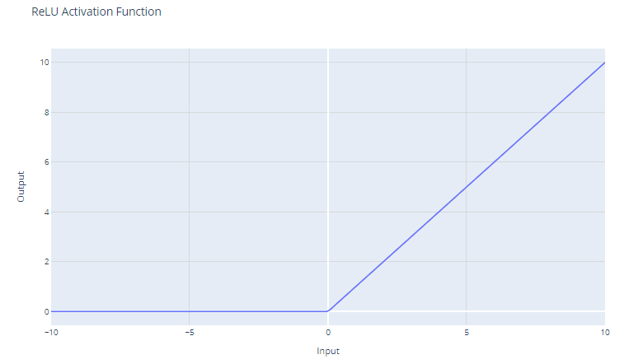
Rectified Linear Unit (ReLU) एक्टिवेशन फंक्शन। छवि: लेखक
Rectified Linear Unit (ReLU) एक्टिवेशन फंक्शन का रूप इस प्रकार है:
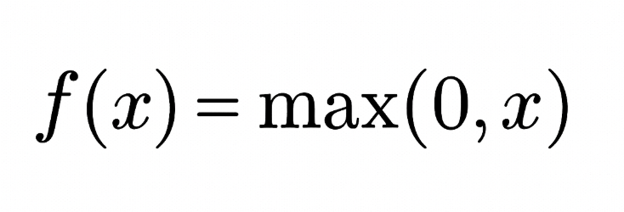
यह इनपुट को शून्य पर थ्रेशहोल्ड करता है, ऋणात्मक मानों के लिए 0 लौटाता है और धनात्मक मानों के लिए इनपुट को ही लौटाता है।
0 से बड़े इनपुट के लिए, ReLU ढाल 1 के साथ एक लिनीयर फ़ंक्शन की तरह कार्य करता है। यानी यह धनात्मक इनपुट के पैमाने को नहीं बदलता और बैकप्रोपेगेशन के दौरान ग्रेडिएंट को बिना परिवर्तन के गुजरने देता है। यह गुण vanishing gradient समस्या को कम करने में महत्वपूर्ण है।
हालाँकि ReLU अपने इनपुट स्पेस के आधे भाग में लिनीयर है, फिर भी तकनीकी रूप से यह गैर-रैखिक फ़ंक्शन है क्योंकि x=0 पर यह अवकलनीय नहीं होता, जहाँ यह अचानक x पर बदल जाता है। यही गैर-रैखिकता न्यूरल नेटवर्क्स को जटिल पैटर्न सीखने देती है।
क्योंकि ReLU सभी ऋणात्मक इनपुट के लिए शून्य आउटपुट देता है, यह स्वाभाविक रूप से विरल (sparse) एक्टिवेशन की ओर ले जाता है; किसी भी समय केवल कुछ न्यूरॉन्स ही सक्रिय होते हैं, जिससे गणना अधिक कुशल होती है।
ReLU फ़ंक्शन संगणनात्मक रूप से सस्ता है क्योंकि इसमें शून्य पर सरल थ्रेशहोल्डिंग होती है। यह नेटवर्क्स को कई लेयर्स तक स्केल करने देता है बिना संगणनात्मक बोझ में उल्लेखनीय वृद्धि के, tanh या sigmoid जैसे अधिक जटिल फ़ंक्शंस की तुलना में।
Softmax activation
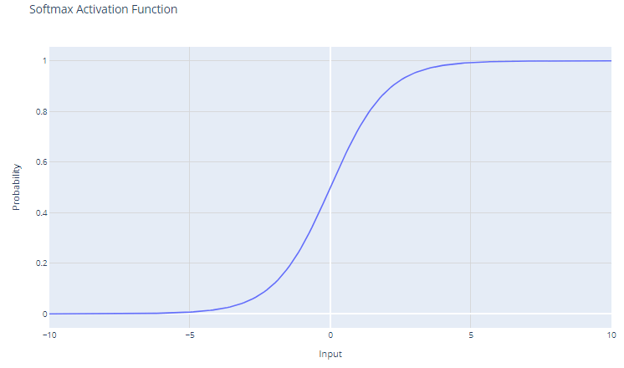
Softmax एक्टिवेशन फंक्शन। छवि: लेखक
Softmax एक्टिवेशन फंक्शन, जिसे normalized exponential function भी कहा जाता है, विशेष रूप से बहु-वर्ग वर्गीकरण समस्याओं के संदर्भ में उपयोगी है। यह फ़ंक्शन एक वेक्टर पर कार्य करता है, जिसे अक्सर logits कहा जाता है, जो न्यूरल नेटवर्क की पिछली लेयर्स द्वारा प्रत्येक वर्ग के लिए निकाले गए कच्चे प्रेडिक्शन या स्कोर का प्रतिनिधित्व करता है।
इनपुट वेक्टर x, जिसके अवयव x1, x2, ..., xC हैं, के लिए softmax फ़ंक्शन इस प्रकार परिभाषित है:
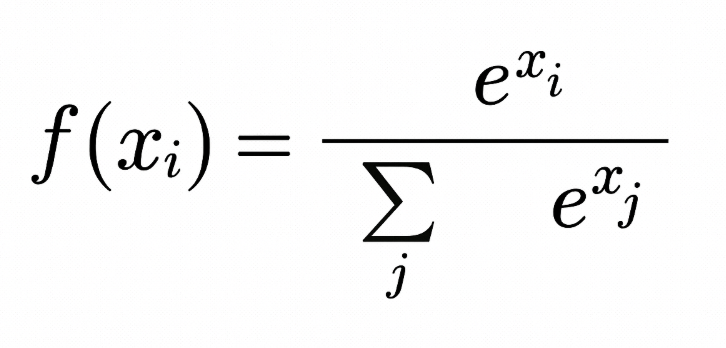
Softmax का आउटपुट एक प्रायिकता वितरण होता है जो जोड़कर एक बनता है। आउटपुट का प्रत्येक अवयव यह दर्शाता है कि इनपुट के किसी विशेष वर्ग से संबंधित होने की प्रायिकता कितनी है।
घातांक (exponential) फ़ंक्शन के उपयोग से यह सुनिश्चित होता है कि सभी आउटपुट मान गैर-ऋणात्मक हों। यह महत्वपूर्ण है क्योंकि प्रायिकताएँ ऋणात्मक नहीं हो सकतीं।
Softmax इनपुट वेक्टर में अंतर को बढ़ा-चढ़ाकर दिखाता है। इनपुट मानों में छोटे-से अंतर भी आउटपुट प्रायिकताओं में बड़े अंतर पैदा कर सकते हैं, जहाँ सबसे बड़ा इनपुट मान परिणामी वितरण में हावी रहने की प्रवृत्ति रखता है।
Softmax का उपयोग आमतौर पर आउटपुट लेयर में तब किया जाता है जब कार्य कई (दो से अधिक) श्रेणियों में से किसी एक में इनपुट को वर्गीकृत करना होता है (multi-class classification)।
Softmax द्वारा उत्पन्न प्रायिकताओं को प्रत्येक वर्ग के लिए confidence स्कोर के रूप में समझा जा सकता है, जो मॉडल की अपनी भविष्यवाणियों के प्रति निश्चितता का संकेत देता है।
क्योंकि softmax अंतर को बढ़ाता है, यह अपवाद मानों या चरम मानों के प्रति संवेदनशील हो सकता है। उदाहरण के लिए, यदि इनपुट वेक्टर में कोई बहुत बड़ा मान है, तो softmax अन्य वर्गों की प्रायिकताओं को "दबा" सकता है, जिससे मॉडल अतिआत्मविश्वासी हो सकता है।
उचित एक्टिवेशन फंक्शन का चयन
आप किस प्रकार की समस्या हल कर रहे हैं, इस पर एक्टिवेशन फंक्शन का चयन निर्भर करता है। यहाँ कुछ दिशानिर्देश हैं:
द्विआधारी वर्गीकरण के लिए
आउटपुट लेयर में sigmoid एक्टिवेशन का उपयोग करें। यह आउटपुट को 0 और 1 के बीच समेटकर दो वर्गों के लिए प्रायिकता दर्शाता है।
बहु-वर्ग वर्गीकरण के लिए
आउटपुट लेयर में softmax एक्टिवेशन का उपयोग करें। यह सभी वर्गों पर प्रायिकता वितरण देता है।
यदि अनिश्चित हों
हिडन लेयर्स में ReLU एक्टिवेशन का उपयोग करें। ReLU सबसे आम डिफ़ॉल्ट एक्टिवेशन फंक्शन है और प्रायः अच्छा विकल्प सिद्ध होता है।
निष्कर्ष
हमने प्रशिक्षण में एक्टिवेशन फंक्शंस की केंद्रीय भूमिका को समझा। देखा कि वे महज़ वैकल्पिक नहीं बल्कि आवश्यक घटक हैं जो न्यूरल नेटवर्क्स को वास्तविक दुनिया के डेटा में निहित जटिलता को पकड़ने और मॉडल करने में सक्षम बनाते हैं। सरल किंतु प्रभावी ReLU से लेकर softmax द्वारा दी जाने वाली संभाव्य व्याख्याओं तक, प्रत्येक एक्टिवेशन फंक्शन का नेटवर्क की विभिन्न लेयर्स और समस्या-क्षेत्रों में अपना स्थान और उद्देश्य है।
जैसे-जैसे न्यूरल नेटवर्क्स विकसित होंगे, एक्टिवेशन फंक्शंस की खोज भी अवश्य विस्तृत होगी, संभव है कि उभरती आर्किटेक्चर्स की विशिष्ट चुनौतियों को संबोधित करने वाले नए रूप सामने आएँ। फिर भी, इस ब्लॉग में चर्चा किए गए सिद्धांत और फंक्शंस निकट भविष्य में न्यूरल नेटवर्क डिज़ाइन के केंद्र में बने रहने की संभावना रखते हैं।
एक्टिवेशन फंक्शंस का सावधानीपूर्वक चयन एक संतुलनकारी कार्य है—वैज्ञानिक समझ और कलात्मक अंतर्ज्ञान का मिश्रण—जो न्यूरल नेटवर्क्स के प्रदर्शन को उल्लेखनीय रूप से प्रभावित कर सकता है।
Keras फ़्रेमवर्क के साथ डीप लर्निंग सीखने में रुचि है? हमारा Introduction to Deep Learning with Keras कोर्स देखें।


न्यूरल नेटवर्क का निरूपण। छवि स्रोत
एक्टिवेशन फंक्शंस क्या होते हैं?
एक्टिवेशन फंक्शंस न्यूरल नेटवर्क्स के मूल निर्माण खंड हैं जो उन्हें डेटा में जटिल पैटर्न सीखने में सक्षम बनाते हैं। वे न्यूरल नेटवर्क के एक नोड के इनपुट सिग्नल को आउटपुट सिग्नल में बदलते हैं, जिसे अगली लेयर में पास किया जाता है। एक्टिवेशन फंक्शंस के बिना, न्यूरल नेटवर्क्स केवल इनपुट और आउटपुट के बीच रैखिक (linear) संबंधों का ही मॉडल बना पाते।
एक्टिवेशन फंक्शंस गैर-रैखिकता (non-linearity) लाते हैं, जिससे न्यूरल नेटवर्क्स इनपुट और आउटपुट के बीच अत्यंत जटिल मैपिंग सीख पाते हैं।
उचित एक्टिवेशन फंक्शन चुनना ऐसे न्यूरल नेटवर्क्स को प्रशिक्षित करने के लिए महत्वपूर्ण है जो अच्छे से जनरलाइज़ करें और सटीक पूर्वानुमान दें। इस पोस्ट में, हम सबसे आम एक्टिवेशन फंक्शंस, उनकी भूमिकाओं और विभिन्न उपयोग-परिदृश्यों के लिए उपयुक्त एक्टिवेशन फंक्शंस कैसे चुनें, का एक अवलोकन देंगे।
चाहे आप डीप लर्निंग में अभी शुरुआत कर रहे हों या अनुभवी प्रैक्टिशनर हों, एक्टिवेशन फंक्शंस की गहरी समझ आपकी अंतर्दृष्टि को मजबूत करेगी और न्यूरल नेटवर्क्स के उपयोग में सुधार लाएगी।
एक्टिवेशन फंक्शंस आवश्यक क्यों हैं?
एक्टिवेशन फंक्शंस के बिना, न्यूरल नेटवर्क्स केवल मैट्रिक्स गुणा जैसी रैखिक क्रियाओं तक सीमित रहेंगे। सभी लेयर्स इनपुट के रैखिक परिवर्तन ही करेंगी और कोई गैर-रैखिकता शामिल नहीं होगी।
अधिकांश वास्तविक दुनिया का डेटा गैर-रैखिक होता है। उदाहरण के लिए, मकान की कीमत और आकार, आय और खरीदारी आदि के संबंध गैर-रैखिक हैं। यदि न्यूरल नेटवर्क्स में एक्टिवेशन फंक्शंस न हों, तो वे वास्तविक डेटा में मौजूद इन जटिल गैर-रैखिक पैटर्नों को सीखने में असफल रहेंगे।
एक्टिवेशन फंक्शंस इन गैर-रैखिक संबंधों को सीखने में सक्षम बनाते हैं क्योंकि वे गैर-रैखिक व्यवहार जोड़ते हैं। इससे जटिल और सूक्ष्म डेटा का मॉडल बनाने में न्यूरल नेटवर्क्स की लचीलापन और क्षमता काफी बढ़ जाती है।
एक्टिवेशन फंक्शंस के प्रकार
न्यूरल नेटवर्क्स विभिन्न प्रकार के एक्टिवेशन फंक्शंस का उपयोग गैर-रैखिकता लाने और जटिल पैटर्न सीखने के लिए करते हैं। प्रत्येक एक्टिवेशन फंक्शन के अपने गुण होते हैं और वे कुछ विशिष्ट उपयोग-परिदृश्यों के लिए उपयुक्त होते हैं।
उदाहरण के लिए, sigmoid फ़ंक्शन द्विआधारी वर्गीकरण समस्याओं के लिए आदर्श है, softmax बहु-वर्ग भविष्यवाणी में उपयोगी है, और ReLU vanishing gradient समस्या को कम करने में मदद करता है।
कार्य के लिए सही एक्टिवेशन फंक्शन का उपयोग करने से प्रशिक्षण तेज होता है और प्रदर्शन बेहतर होता है।
आइए कुछ सामान्य एक्टिवेशन फंक्शंस पर नज़र डालें:
Linear activation
लिनीयर एक्टिवेशन फंक्शन। छवि: लेखक
लिनीयर एक्टिवेशन फंक्शन सबसे सरल है, जिसे इस प्रकार परिभाषित किया जाता है:
यह बस इनपुट x को ही आउटपुट में लौटाता है। ग्राफिक रूप से यह ढाल 1 वाली सीधी रेखा जैसा दिखता है।
लिनीयर एक्टिवेशन फंक्शन का मुख्य उपयोग प्रतिगमन (regression) के लिए प्रयुक्त न्यूरल नेटवर्क के आउटपुट लेयर में होता है। जहाँ हमें संख्यात्मक मान का पूर्वानुमान करना होता है, वहाँ आउटपुट लेयर में लिनीयर एक्टिवेशन सुनिश्चित करता है कि नेटवर्क संख्यात्मक मान ही निकाले। यह आउटपुट को दबाता या रूपांतरित नहीं करता, इसलिए वास्तविक पूर्वानुमानित मान ही लौटता है।
हालाँकि, छिपी हुई लेयर्स में लिनीयर एक्टिवेशन कम ही उपयोग होता है क्योंकि यह कोई गैर-रैखिकता नहीं देता। हिडन लेयर्स का उद्देश्य इनपुट फ़ीचर्स के गैर-रैखिक संयोजन सीखना होता है। हर जगह लिनीयर एक्टिवेशन प्रयोग करने से मॉडल सिर्फ इनपुट के रैखिक रूपांतरण तक सीमित रह जाएगा।
Sigmoid activation
Sigmoid एक्टिवेशन फंक्शन। छवि: लेखक
Sigmoid एक्टिवेशन फंक्शन, जिसे अक्सर σ(x) से दर्शाया जाता है, एक स्मूद और सतत अवकलनीय फ़ंक्शन है, जो न्यूरल नेटवर्क्स के विकास में ऐतिहासिक रूप से महत्वपूर्ण रहा है। Sigmoid एक्टिवेशन फंक्शन का गणितीय रूप है:
यह वास्तविक मान वाले इनपुट को 0 और 1 के बीच के मान में समेट देता है। Sigmoid कर्व "S" आकार का होता है, जो बड़े ऋणात्मक संख्याओं के लिए 0 और बड़े धनात्मक संख्याओं के लिए 1 के आसिम्प्टोट तक पहुँचता है। आउटपुट को आसानी से प्रायिकता के रूप में व्याख्यायित किया जा सकता है, जो इसे द्विआधारी वर्गीकरण के लिए स्वाभाविक विकल्प बनाता है।
प्रारंभिक न्यूरल नेटवर्क्स में sigmoid यूनिट्स लोकप्रिय थे क्योंकि जब यूनिट का आउटपुट 0.5 के पास होता है तो ग्रेडिएंट सबसे प्रबल होता है, जिससे बैकप्रोपेगेशन कुशल रहता है। हालांकि, sigmoid यूनिट्स "vanishing gradient" समस्या से ग्रस्त होते हैं, जो गहरे नेटवर्क्स में सीखने में बाधा डालती है।
जब इनपुट मान बहुत अधिक धनात्मक या ऋणात्मक हो जाते हैं, तो फ़ंक्शन 0 या 1 पर संतृप्त हो जाता है और ढाल अत्यंत सपाट हो जाती है। इन क्षेत्रों में ग्रेडिएंट लगभग शून्य के पास होता है। इससे बैकप्रोपेगेशन के दौरान वेट्स में बहुत छोटे परिवर्तन होते हैं, खासकर शुरुआती लेयर्स के न्यूरॉन्स के लिए, जिससे सीखना बेहद धीमा हो सकता है या रुक भी सकता है। इसे ही न्यूरल नेटवर्क्स में vanishing gradient समस्या कहा जाता है।
Sigmoid का मुख्य उपयोग द्विआधारी वर्गीकरण मॉडलों के आउटपुट लेयर में एक्टिवेशन के रूप में होता है। यह आउटपुट को 0 और 1 के बीच की प्रायिकता में समेट देता है, जिसे किसी विशेष वर्ग से इनपुट के संबंधित होने की प्रायिकता के रूप में समझा जा सकता है।
Tanh (hyperbolic tangent) activation
Tanh एक्टिवेशन फंक्शन। छवि: लेखक
Tanh (hyperbolic tangent) एक्टिवेशन फंक्शन इस प्रकार परिभाषित है:
Tanh फ़ंक्शन -1 से +1 की सीमा में मान देता है। इसका अर्थ है कि यह ऋणात्मक मानों को sigmoid की तुलना में, जिसका दायरा 0 से 1 है, अधिक प्रभावी ढंग से संभाल पाता है।
Sigmoid के विपरीत, tanh शून्य-केंद्रित है, यानी इसका आउटपुट निर्देशांक तंत्र के उद्गम के सापेक्ष सममित होता है। इसे अक्सर लाभ माना जाता है क्योंकि यह लर्निंग एल्गोरिद्म को तेजी से अभिसरण करने में मदद कर सकता है।
चूँकि tanh का आउटपुट -1 से +1 के बीच होता है, इसके ग्रेडिएंट sigmoid की तुलना में अधिक प्रबल होते हैं। प्रबल ग्रेडिएंट अक्सर प्रशिक्षण के दौरान तेज़ सीखने और अभिसरण का कारण बनते हैं, क्योंकि वे sigmoid के ग्रेडिएंट की तुलना में vanishing gradient समस्या के प्रति अधिक सहनशील होते हैं।
इन फायदों के बावजूद, tanh भी vanishing gradient समस्या से अछूता नहीं है। बैकप्रोपेगेशन के दौरान tanh के ग्रेडिएंट बहुत छोटे (शून्य के पास) हो सकते हैं। यह विशेष रूप से कई लेयर्स वाले गहरे नेटवर्क्स में समस्या पैदा करता है; जैसे-जैसे ग्रेडिएंट शुरुआती लेयर्स तक लौटते हैं, वे इतने छोटे हो सकते हैं कि वेट्स में सार्थक परिवर्तन न कर पाएं। इससे प्रशिक्षण काफी धीमा हो सकता है और अभिसरण खराब हो सकता है।
Tanh फ़ंक्शन का उपयोग अक्सर न्यूरल नेटवर्क की हिडन लेयर्स में किया जाता है। इसके शून्य-केंद्रित स्वभाव के कारण, जब डेटा को भी शून्य-माध्य पर सामान्यीकृत किया जाता है, तो यह अधिक कुशल प्रशिक्षण का कारण बन सकता है।
यदि sigmoid और tanh में से किसी एक को चुनना हो और किसी विशेष कारण से कोई प्राथमिकता न हो, तो अक्सर ऊपर बताए कारणों से tanh बेहतर विकल्प होता है। हालांकि, निर्णय विशिष्ट उपयोग-परिदृश्य और प्रारंभिक प्रशिक्षण प्रयोगों के दौरान नेटवर्क के व्यवहार से भी प्रभावित हो सकता है।
आप PyTorch का उपयोग करके शून्य से एक सरल न्यूरल नेटवर्क बनाएँ — Kurtis Pykes के हमारे ट्यूटोरियल का अनुसरण करते हुए, या यदि आप उन्नत उपयोगकर्ता हैं, तो हमारा Deep Learning with PyTorch कोर्स आपके लिए है। .
ReLU (rectified linear unit) activation
Rectified Linear Unit (ReLU) एक्टिवेशन फंक्शन। छवि: लेखक
Rectified Linear Unit (ReLU) एक्टिवेशन फंक्शन का रूप इस प्रकार है:
यह इनपुट को शून्य पर थ्रेशहोल्ड करता है, ऋणात्मक मानों के लिए 0 लौटाता है और धनात्मक मानों के लिए इनपुट को ही लौटाता है।
0 से बड़े इनपुट के लिए, ReLU ढाल 1 के साथ एक लिनीयर फ़ंक्शन की तरह कार्य करता है। यानी यह धनात्मक इनपुट के पैमाने को नहीं बदलता और बैकप्रोपेगेशन के दौरान ग्रेडिएंट को बिना परिवर्तन के गुजरने देता है। यह गुण vanishing gradient समस्या को कम करने में महत्वपूर्ण है।
हालाँकि ReLU अपने इनपुट स्पेस के आधे भाग में लिनीयर है, फिर भी तकनीकी रूप से यह गैर-रैखिक फ़ंक्शन है क्योंकि x=0 पर यह अवकलनीय नहीं होता, जहाँ यह अचानक x पर बदल जाता है। यही गैर-रैखिकता न्यूरल नेटवर्क्स को जटिल पैटर्न सीखने देती है।
क्योंकि ReLU सभी ऋणात्मक इनपुट के लिए शून्य आउटपुट देता है, यह स्वाभाविक रूप से विरल (sparse) एक्टिवेशन की ओर ले जाता है; किसी भी समय केवल कुछ न्यूरॉन्स ही सक्रिय होते हैं, जिससे गणना अधिक कुशल होती है।
ReLU फ़ंक्शन संगणनात्मक रूप से सस्ता है क्योंकि इसमें शून्य पर सरल थ्रेशहोल्डिंग होती है। यह नेटवर्क्स को कई लेयर्स तक स्केल करने देता है बिना संगणनात्मक बोझ में उल्लेखनीय वृद्धि के, tanh या sigmoid जैसे अधिक जटिल फ़ंक्शंस की तुलना में।
Softmax activation
Softmax एक्टिवेशन फंक्शन। छवि: लेखक
Softmax एक्टिवेशन फंक्शन, जिसे normalized exponential function भी कहा जाता है, विशेष रूप से बहु-वर्ग वर्गीकरण समस्याओं के संदर्भ में उपयोगी है। यह फ़ंक्शन एक वेक्टर पर कार्य करता है, जिसे अक्सर logits कहा जाता है, जो न्यूरल नेटवर्क की पिछली लेयर्स द्वारा प्रत्येक वर्ग के लिए निकाले गए कच्चे प्रेडिक्शन या स्कोर का प्रतिनिधित्व करता है।
इनपुट वेक्टर x, जिसके अवयव x1, x2, ..., xC हैं, के लिए softmax फ़ंक्शन इस प्रकार परिभाषित है:
Softmax का आउटपुट एक प्रायिकता वितरण होता है जो जोड़कर एक बनता है। आउटपुट का प्रत्येक अवयव यह दर्शाता है कि इनपुट के किसी विशेष वर्ग से संबंधित होने की प्रायिकता कितनी है।
घातांक (exponential) फ़ंक्शन के उपयोग से यह सुनिश्चित होता है कि सभी आउटपुट मान गैर-ऋणात्मक हों। यह महत्वपूर्ण है क्योंकि प्रायिकताएँ ऋणात्मक नहीं हो सकतीं।
Softmax इनपुट वेक्टर में अंतर को बढ़ा-चढ़ाकर दिखाता है। इनपुट मानों में छोटे-से अंतर भी आउटपुट प्रायिकताओं में बड़े अंतर पैदा कर सकते हैं, जहाँ सबसे बड़ा इनपुट मान परिणामी वितरण में हावी रहने की प्रवृत्ति रखता है।
Softmax का उपयोग आमतौर पर आउटपुट लेयर में तब किया जाता है जब कार्य कई (दो से अधिक) श्रेणियों में से किसी एक में इनपुट को वर्गीकृत करना होता है (multi-class classification)।
Softmax द्वारा उत्पन्न प्रायिकताओं को प्रत्येक वर्ग के लिए confidence स्कोर के रूप में समझा जा सकता है, जो मॉडल की अपनी भविष्यवाणियों के प्रति निश्चितता का संकेत देता है।
क्योंकि softmax अंतर को बढ़ाता है, यह अपवाद मानों या चरम मानों के प्रति संवेदनशील हो सकता है। उदाहरण के लिए, यदि इनपुट वेक्टर में कोई बहुत बड़ा मान है, तो softmax अन्य वर्गों की प्रायिकताओं को "दबा" सकता है, जिससे मॉडल अतिआत्मविश्वासी हो सकता है।
उचित एक्टिवेशन फंक्शन का चयन
आप किस प्रकार की समस्या हल कर रहे हैं, इस पर एक्टिवेशन फंक्शन का चयन निर्भर करता है। यहाँ कुछ दिशानिर्देश हैं:
द्विआधारी वर्गीकरण के लिए
आउटपुट लेयर में sigmoid एक्टिवेशन का उपयोग करें। यह आउटपुट को 0 और 1 के बीच समेटकर दो वर्गों के लिए प्रायिकता दर्शाता है।
बहु-वर्ग वर्गीकरण के लिए
आउटपुट लेयर में softmax एक्टिवेशन का उपयोग करें। यह सभी वर्गों पर प्रायिकता वितरण देता है।
यदि अनिश्चित हों
हिडन लेयर्स में ReLU एक्टिवेशन का उपयोग करें। ReLU सबसे आम डिफ़ॉल्ट एक्टिवेशन फंक्शन है और प्रायः अच्छा विकल्प सिद्ध होता है।
निष्कर्ष
हमने प्रशिक्षण में एक्टिवेशन फंक्शंस की केंद्रीय भूमिका को समझा। देखा कि वे महज़ वैकल्पिक नहीं बल्कि आवश्यक घटक हैं जो न्यूरल नेटवर्क्स को वास्तविक दुनिया के डेटा में निहित जटिलता को पकड़ने और मॉडल करने में सक्षम बनाते हैं। सरल किंतु प्रभावी ReLU से लेकर softmax द्वारा दी जाने वाली संभाव्य व्याख्याओं तक, प्रत्येक एक्टिवेशन फंक्शन का नेटवर्क की विभिन्न लेयर्स और समस्या-क्षेत्रों में अपना स्थान और उद्देश्य है।
जैसे-जैसे न्यूरल नेटवर्क्स विकसित होंगे, एक्टिवेशन फंक्शंस की खोज भी अवश्य विस्तृत होगी, संभव है कि उभरती आर्किटेक्चर्स की विशिष्ट चुनौतियों को संबोधित करने वाले नए रूप सामने आएँ। फिर भी, इस ब्लॉग में चर्चा किए गए सिद्धांत और फंक्शंस निकट भविष्य में न्यूरल नेटवर्क डिज़ाइन के केंद्र में बने रहने की संभावना रखते हैं।
एक्टिवेशन फंक्शंस का सावधानीपूर्वक चयन एक संतुलनकारी कार्य है—वैज्ञानिक समझ और कलात्मक अंतर्ज्ञान का मिश्रण—जो न्यूरल नेटवर्क्स के प्रदर्शन को उल्लेखनीय रूप से प्रभावित कर सकता है।
Keras फ़्रेमवर्क के साथ डीप लर्निंग सीखने में रुचि है? हमारा Introduction to Deep Learning with Keras कोर्स देखें।