
Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Ich habe es schon angedeutet: Die Erwartungen müssen zum Modell passen. Bei Jev gilt das besonders – vor allem wegen seiner Modellklasse, den sogenannten System-One-Modellen.
Ein System-One-Modell gibt typisierte Entscheidungen statt Text zurück. Du schickst einen Zustandsblock plus einen Satz Fragen, jeweils mit einem von dir definierten Antwortraum. Das Modell liefert pro Frage eine Antwort mit Wahrscheinlichkeiten. Es wird nichts Token für Token erzeugt – es gibt also keinen String zu parsen und kein kaputtes JSON zu reparieren. TypeSafe hat den Begriff in Anlehnung an Daniel Kahnemans berühmte Unterscheidung geprägt:
Weil der Antwortraum ein Schema ist, das dein Code vorgibt, kann ein System-One-Modell per Design niemals eine Kategorie zurückgeben, die du nicht definiert hast. Es kann also nie „off-schema“ sein. Falsch liegen kann es trotzdem – dazu gleich mehr.
TypeSafe ist am 15. September 2026 aus dem Stealth gekommen und hat Jev im Early Access vorgestellt: 70 bis 500 ms Antwortzeit, 0,042 $ pro Million Input-Tokens, Output kostenlos. Auf seinem eigenen Vier-Workflow-Benchmark landet Jev bei rund 68% Genauigkeit – etwa Mittelfeld-LLM-Niveau zum Bruchteil der Kosten.
Für mehr Details zu Features und Benchmarks lies am besten unseren Jev-Guide.
Schreib die gültigen Antworten auf, bevor du den Call machst. Wenn du sie aufzählen kannst, hast du ein Jev-förmiges Problem:
Greif zu einem LLM, wenn der Output Prosa oder Code ist, der Antwortraum offen ist oder die Aufgabe mehrere, verkettete Schlussfolgerungsschritte braucht. Für alles Zahlentechnische ist Jev außerdem das falsche Tool – warum, kommt später.
Bevor du Code schreibst, leg dir ein TypeSafe-Konto an und öffne den Playground. Dort kannst du Text als State einfügen, Fragen hinzufügen und die vollständigen Antwortobjekte sehen – ohne Installation. So verstehst du am schnellsten, was jeder Fragetyp zurückliefert (und ob deine Frage unglücklich formuliert ist).
Ich nutze ein Support-Ticket als State für alle drei Beispiele:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Jeder Fragetyp nimmt instructions entgegen – also die in Klartext formulierte Frage. Was sich unterscheidet, ist criteria sowie das, was zurückkommt.
Eine Choice wählt eine Option aus einer von dir definierten Menge.
Du übergibst criteria als Dictionary, das jede Option einer Beschreibung zuordnet – von 1 bis 255 Einträgen. Die Antwort enthält:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Um den Code-Output zu sehen, den du auch per API erhältst, klicke oben rechts auf </> und dann auf Run, um Jev antworten zu lassen.
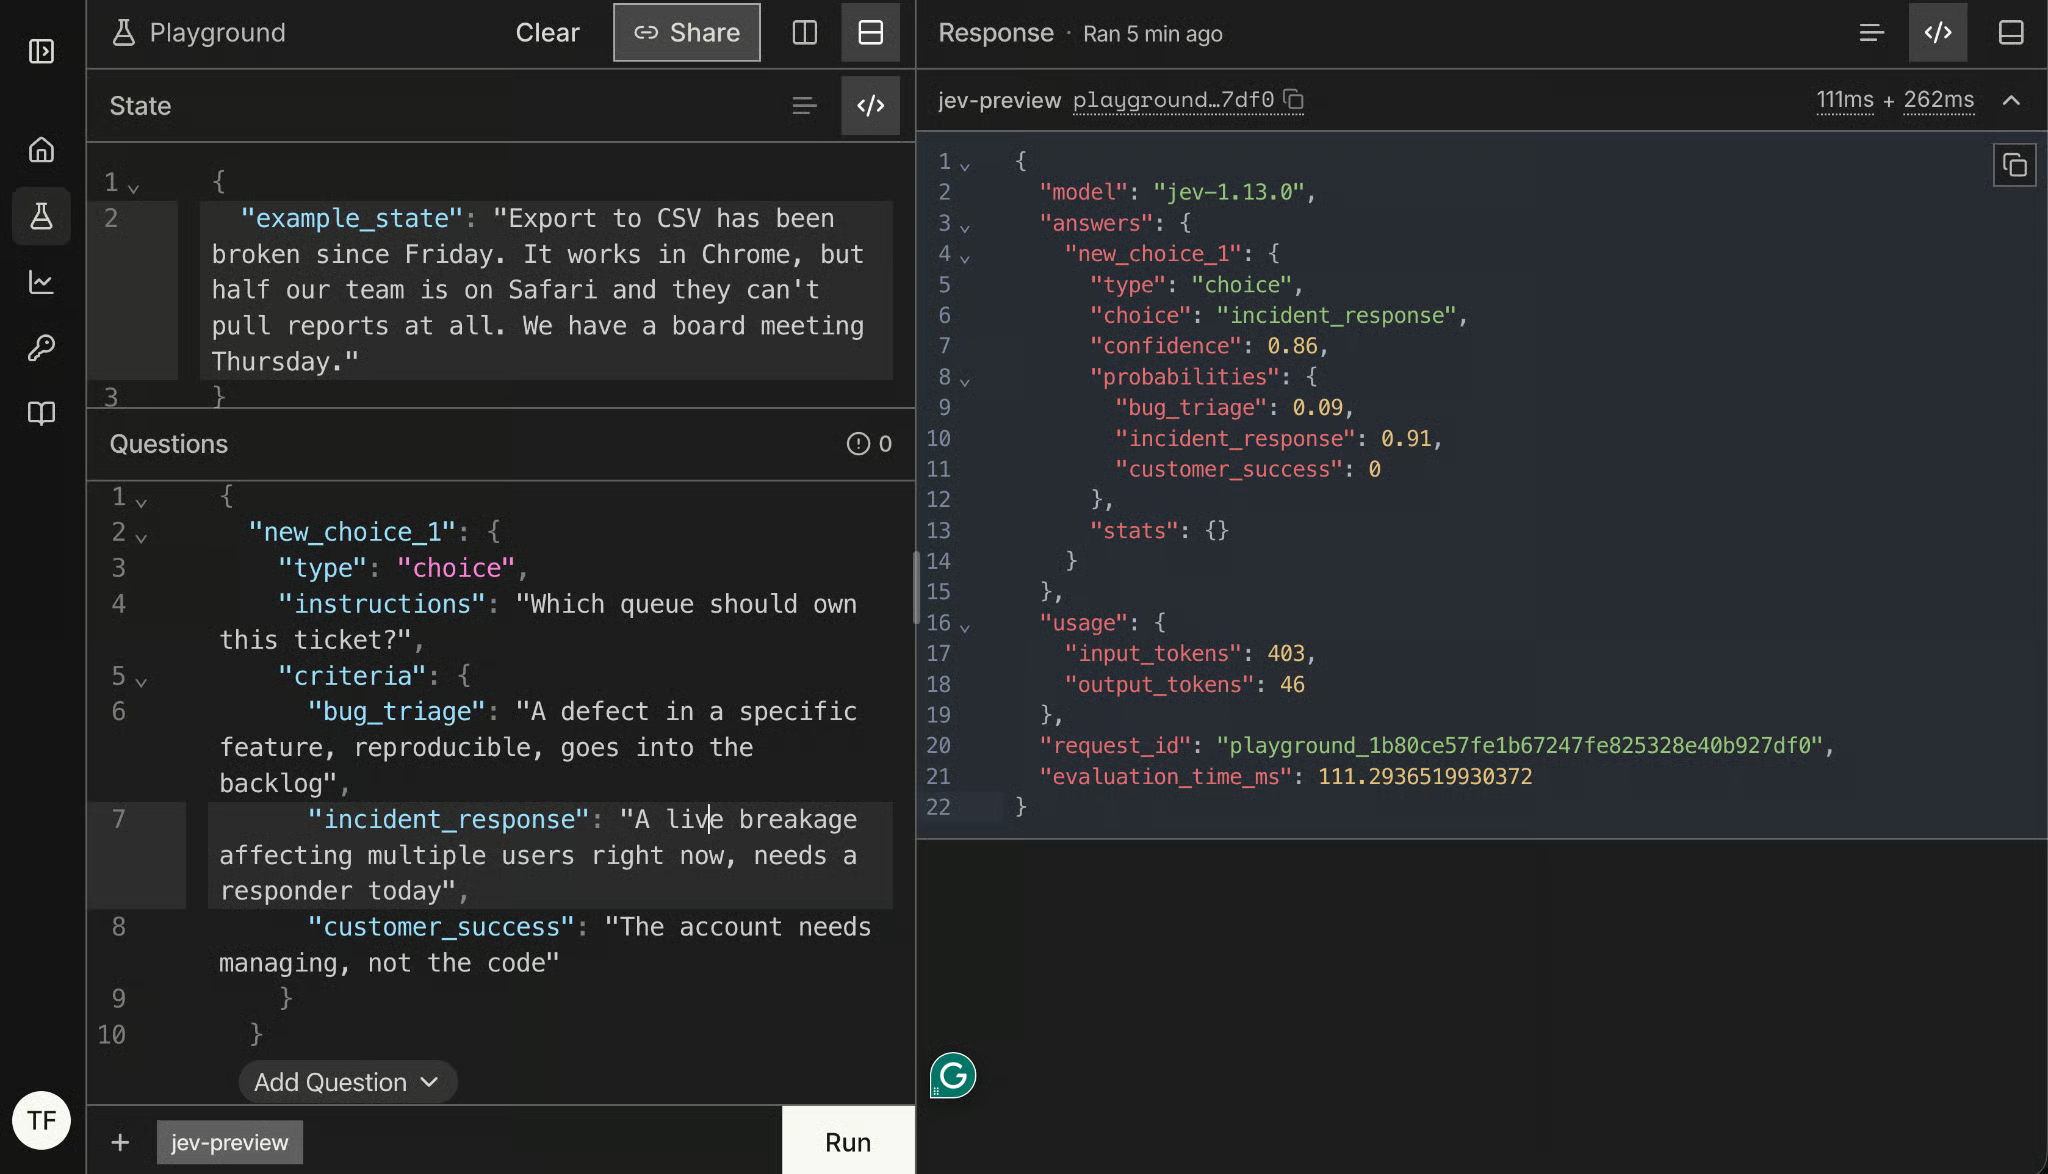
In diesem Fall ist incident_response die choice mit 91% Wahrscheinlichkeit. Jevs confidence für die Wahl liegt bei 86%.
Die vollständige Verteilung ist der Teil, auf den es ankommt.
choice sagt dir nur, welche Option gewonnen hat.
probabilities sagt dir, mit welchem Abstand.
Das sind unterschiedliche Informationen, wenn du ein Ticket automatisch routen willst. Ein 0,41/0,38/0,21-Split und das 0,91/0,09/0,00, das wir erhalten haben, können beide dieselbe choice liefern.
Ein Score bewertet den State entlang geordneter Stufen. Du übergibst criteria als Array aus 2 bis 10 Stufenbeschreibungen, niedrigste zuerst. Die Antwort enthält einen Score, eine legend, die jede Position deiner Beschreibung zuordnet, eine Wahrscheinlichkeit pro Stufe und Confidence.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}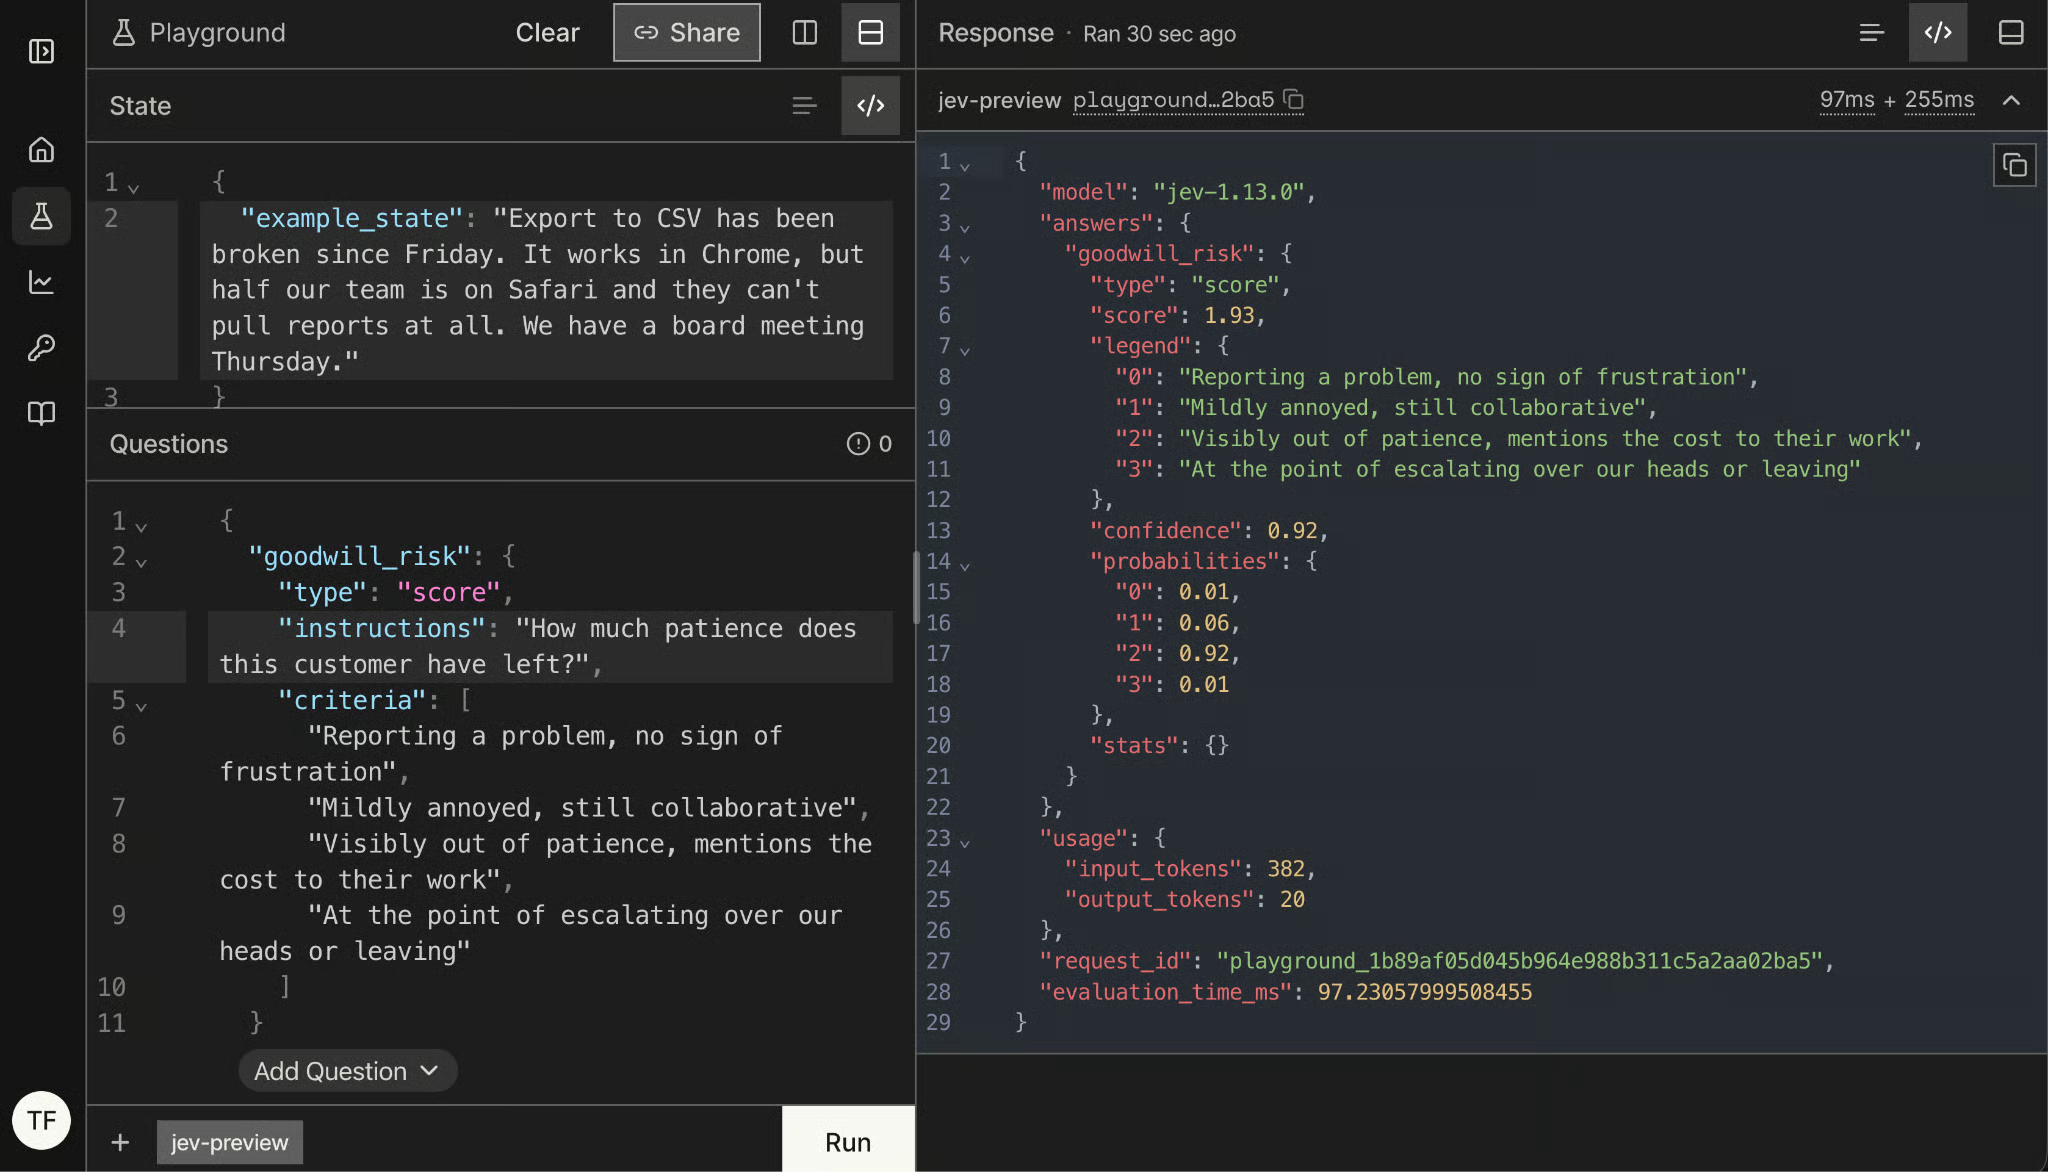
Der Score kann zwischen deinen Stufen landen – genau dafür gibt es die legend. Ein score von 1,93 bedeutet hier, dass das Modell zwischen „leicht genervt“ und „sichtbar ungeduldig“ schwankt, mit klarer Tendenz zum Letzteren – eine faire Lesart für ein höfliches Ticket, das dennoch eine Deadline nennt.
Auch hier gilt: Lies die Verteilung der probabilities statt nur die Zahl. Konzentration auf eine Stufe heißt klare Entscheidung, verschmiert über drei heißt Durchschnitt statt Urteil.
Ein Noul ist der Typ für binäre Fragen; der Name stammt von TypeSafe. criteria ist optional, aber du kannst beschreiben, was true und false bedeuten – sinnvoll, wenn „Ja“ doppeldeutig sein könnte.
Formuliere die Frage so, dass ein hoher Wert „Ja“ bedeutet. TypeSafes Doku ist da sehr deutlich, und ein Noul, bei dem true „Nein“ meint, performt messbar schlechter.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}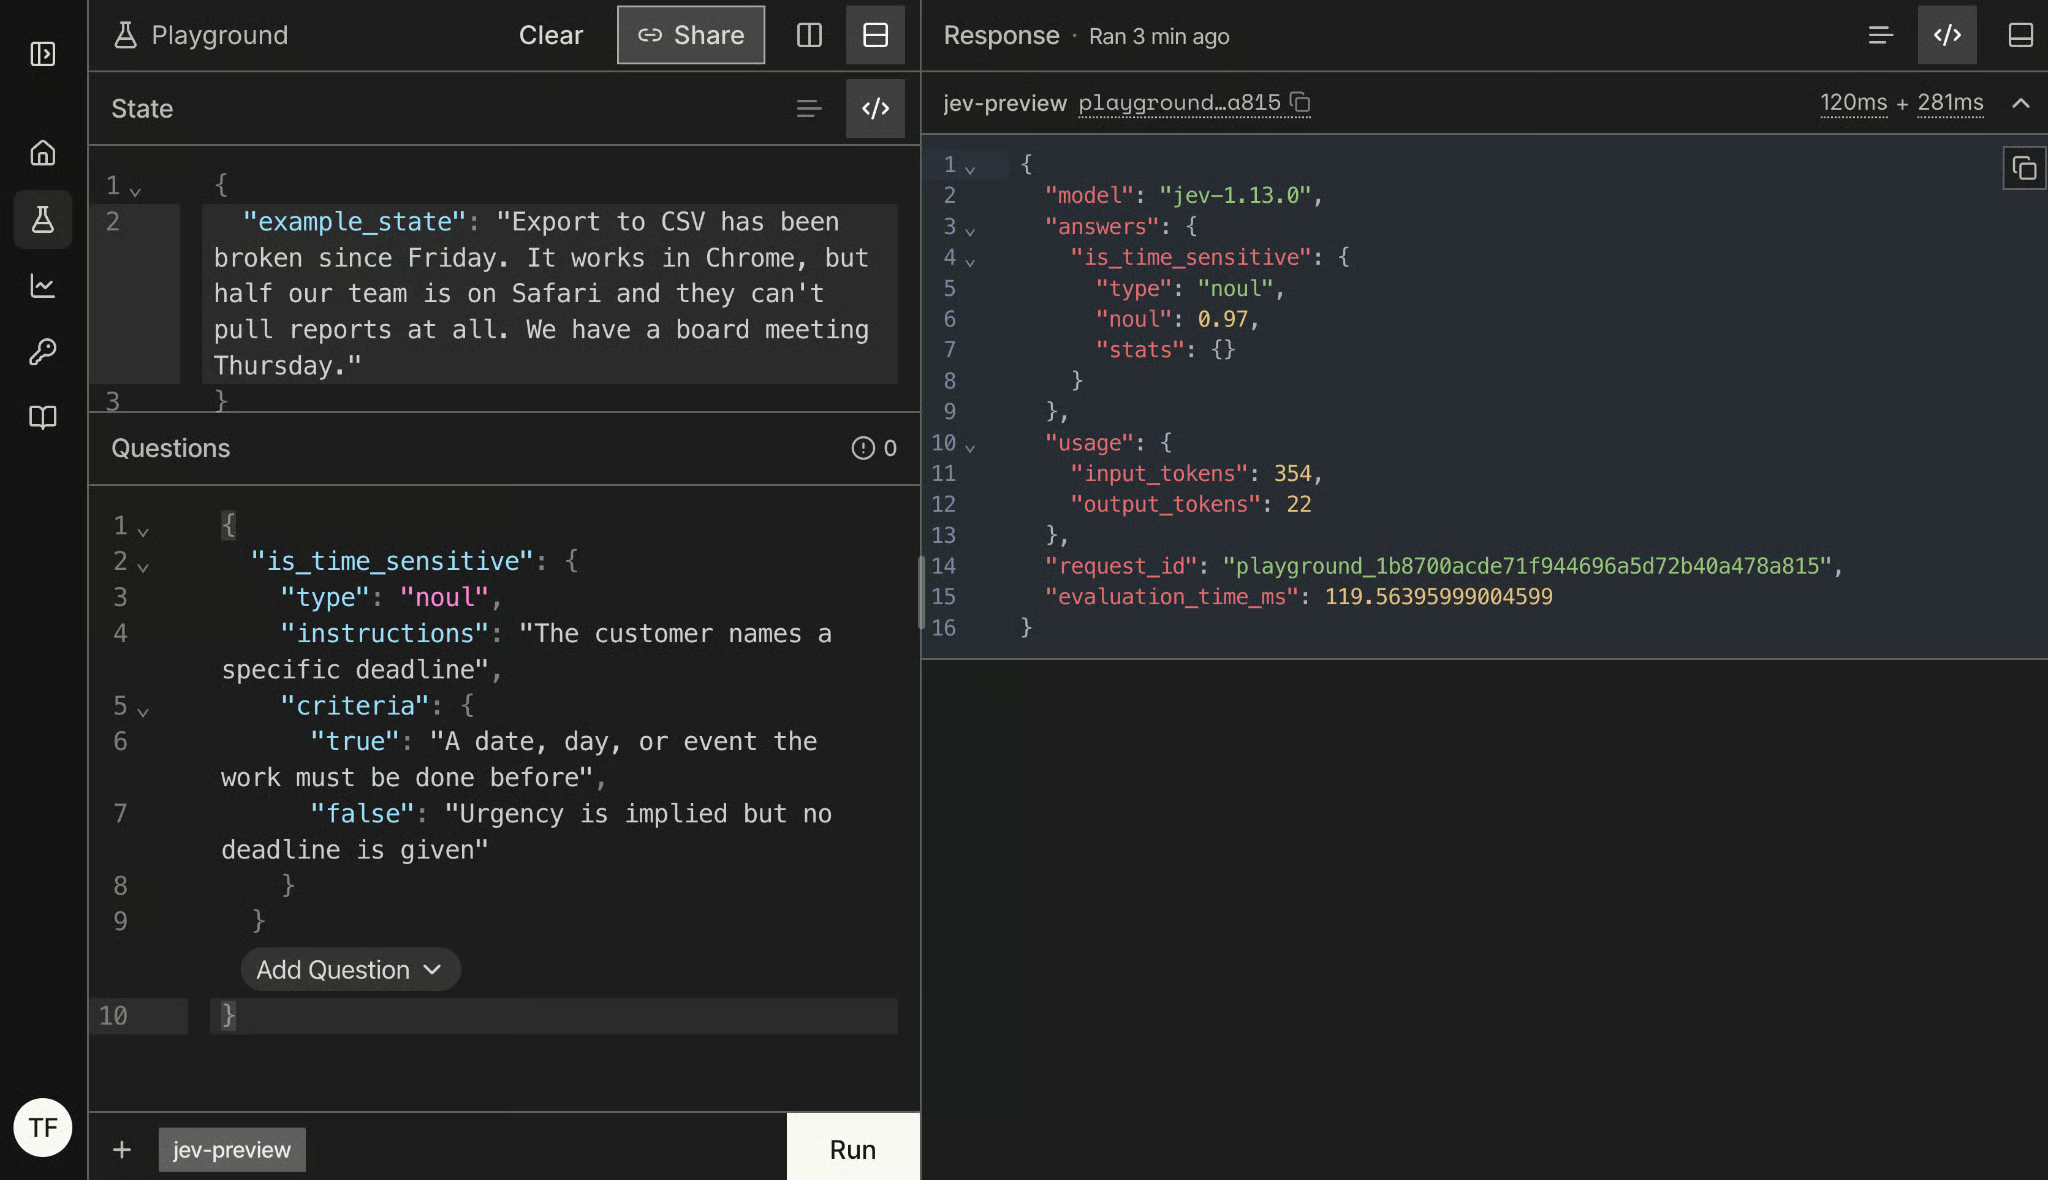
Da im State eine Vorstandssitzung am Donnerstag erwähnt wird, war der hohe noul-Wert von 0,97 zu erwarten.
Choice und Score liefern Confidence zusätzlich zu ihren Wahrscheinlichkeiten. Ein Noul nicht – das sorgt oft für Verwirrung, deshalb hier genau:
Confidence und Wahrscheinlichkeit sind getrennte Achsen. Bei Choice sagen die Wahrscheinlichkeiten, wie das Modell seine Überzeugung über die Optionen verteilt, und Confidence sagt, wie fest es zu der Antwort steht – darum kann eine Choice eine Top-Option von 0,85 mit einer Confidence von 0,78 haben. Ein Noul hat nur zwei Ausgänge, daher trägt die einzelne Wahrscheinlichkeit beides bereits: 0,97 ist ein klares Ja, 0,03 ein klares Nein, 0,52 heißt: keine Ahnung.
Die Entfernung von 0,5 ist also dein Signal für Entschiedenheit – kein separates Feld. Und du kannst keinen Schwellenwert von einem Noul auf eine Choice übertragen. Darauf komme ich in der Jaggedness-Sektion zurück – es ist tückischer, als es klingt.
Zum Mitmachen brauchst du nur Python 3.10+ und einen TypeSafe-Early-Access-Key.
Installiere das SDK:
pip install typesafe-sdkOder mit uv:
uv add typesafe-sdkErstelle dann im TypeSafe-Console einen Key und exportiere ihn. Der Client liest TYPESAFE_API_KEY aus der Umgebung – du gibst ihn also nie im Code weiter:
export TYPESAFE_API_KEY="your-key"Die folgenden Imports geben dir alles wie im Playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul und Score sind dieselben Fragetypen, durch die du gerade geklickt hast – als Python-Objekte.
TypeSafeClient ist der synchrone Client; es gibt auch einen AsyncTypeSafeClient mit derselben Schnittstelle, falls du Jev aus einem async-Dienst aufrufst. Beide funktionieren als Context Manager – das würde ich für alles jenseits eines Skripts nutzen:
with TypeSafeClient() as client:
...Standardmäßig ruft der Client jev-latest auf, das sich bewegt, sobald TypeSafe eine neue Version shippt – das nutzen wir im Tutorial. Für alles, wofür du bereits einen Schwellenwert kalibriert hast, pinne die Version:
client = TypeSafeClient(model="jev-1.13.0")Die Antwort teilt dir in jedem Fall mit, welches Modell tatsächlich geantwortet hat – und weiter unten erkläre ich, warum du das loggen solltest.
Für einen API-Call an Jev definierst du ein response-Objekt mit TypeSafeClient und der Funktion system_one(). Sie nimmt deinen Fragenkontext als state und die questions im selben Format wie im Playground.
Wir können einen Call erstellen, der alle drei Playground-Fragen beantwortet, da sie denselben state teilen:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Antworten kommen unter denselben Namen zurück, die du für jede Frage gewählt hast – das macht die Arbeit damit angenehm:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Schlägt dein erster Call mit einem TypeError zu output_buffer_limit fehl, ist das ein Versionskonflikt im Kompressions-Backend des SDKs – nicht dein Code. Das SDK bringt einen eigenen HTTP-Client httpx2 mit, der über zstandard und brotli dekomprimiert; eine ältere Kopie von einem der beiden kennt das übergebene Argument nicht. pip install -U typesafe-sdk httpx2 zstandard brotli hat es bei mir behoben.
Zwei Dinge sind eine Pause wert.
Erstens hat response.model jev-1.13.0 zurückgegeben – nicht jev-latest. Du hast den beweglichen Alias angefragt und Jev hat dir gesagt, welche Version tatsächlich geantwortet hat. Das Loggen dieses Feldes kostet also so wenig, dass es sich lohnt.
Zweitens sind die Antwortobjekte pro Fragetyp typisiert. .choice, .score und .noul sind echte Attribute, die dein Editor kennt. In diesem Code gibt es keinen JSON-String, nichts zu parsen und keinen Sonderfall für „malformed“. Wenn du lieber gruppierst, bietet das SDK auch response.choices, response.scores und response.nouls, gleich benannt.
Sieh dir auch response.usage an:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Output-Tokens sind einstellig und gratis. Du zahlst für State und Fragen – die Kosten steuerst du also komplett über die Menge an Kontext. Das ist wichtiger, als es aussieht, und kommt in der Jaggedness-Sektion wieder: Ein aufgeblähter State kostet dich gleichzeitig Geld und Genauigkeit.
Das ist ein Paradebeispiel für Jev. Ein Support-Ticket kommt an, und etwas muss entscheiden, in welche Queue es geht, ob ein Mensch zuerst draufschauen sollte und wie schnell. Jede dieser Entscheidungen hat einen Antwortraum, den du vorab aufschreiben kannst.
Die Designregel vorweg: Jev entscheidet, was ist – dein Code entscheidet, was passiert. Jev routet nie selbst. Es liefert Zahlen, und das Routing lebt in einer simplen Funktion, die du lesen, testen und ändern kannst, ohne das Modell anzufassen.
Fragen innerhalb einer Anfrage werden parallel ausgewertet. Eine sechste Frage kostet dich die Tokens, aus denen sie besteht, und kaum zusätzliche Latenz. Das ändert, wie du fragst: Mit einem LLM würdest du Batchen, um Roundtrips zu sparen. Hier fragst du alles, was du zu einem Kontext wissen könntest – auch Fragen, deren Antworten du wahrscheinlich ignorierst.
Erweitern wir unsere bisherigen Fragen um drei weitere Nouls, die für die Behandlung des Tickets wichtig sind:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Sechs Fragen – ein Call, eine Rechnung. is_automated ist die spekulative: In echten Tickets meist false, aber die eine True spart jemandem das Öffnen einer Mailer-Daemon-Bounce.
Zwei Gewohnheiten würde ich mir hier aneignen.
Halte den Fragensatz als Modulkonstante statt ihn inline zu bauen – du versionierst ihn zusammen mit deinen Schwellenwerten.
Benne Fragen nach dem, was sie messen, nicht nach der Aktion. is_time_sensitive überlebt eine Policy-Änderung, route_to_incident nicht.
Formuliere Fragen positiv: Wir hätten is_automated auch needs_no_reply nennen können. Laut TypeSafe performen positiv formulierte Fragen aber besser.
Jetzt kommt der Teil, den Jev nicht übernimmt. Jede Antwort hat entweder einen Confidence-Wert oder eine Wahrscheinlichkeit. Diese zweite Zahl ermöglicht drei Pfade statt zwei:
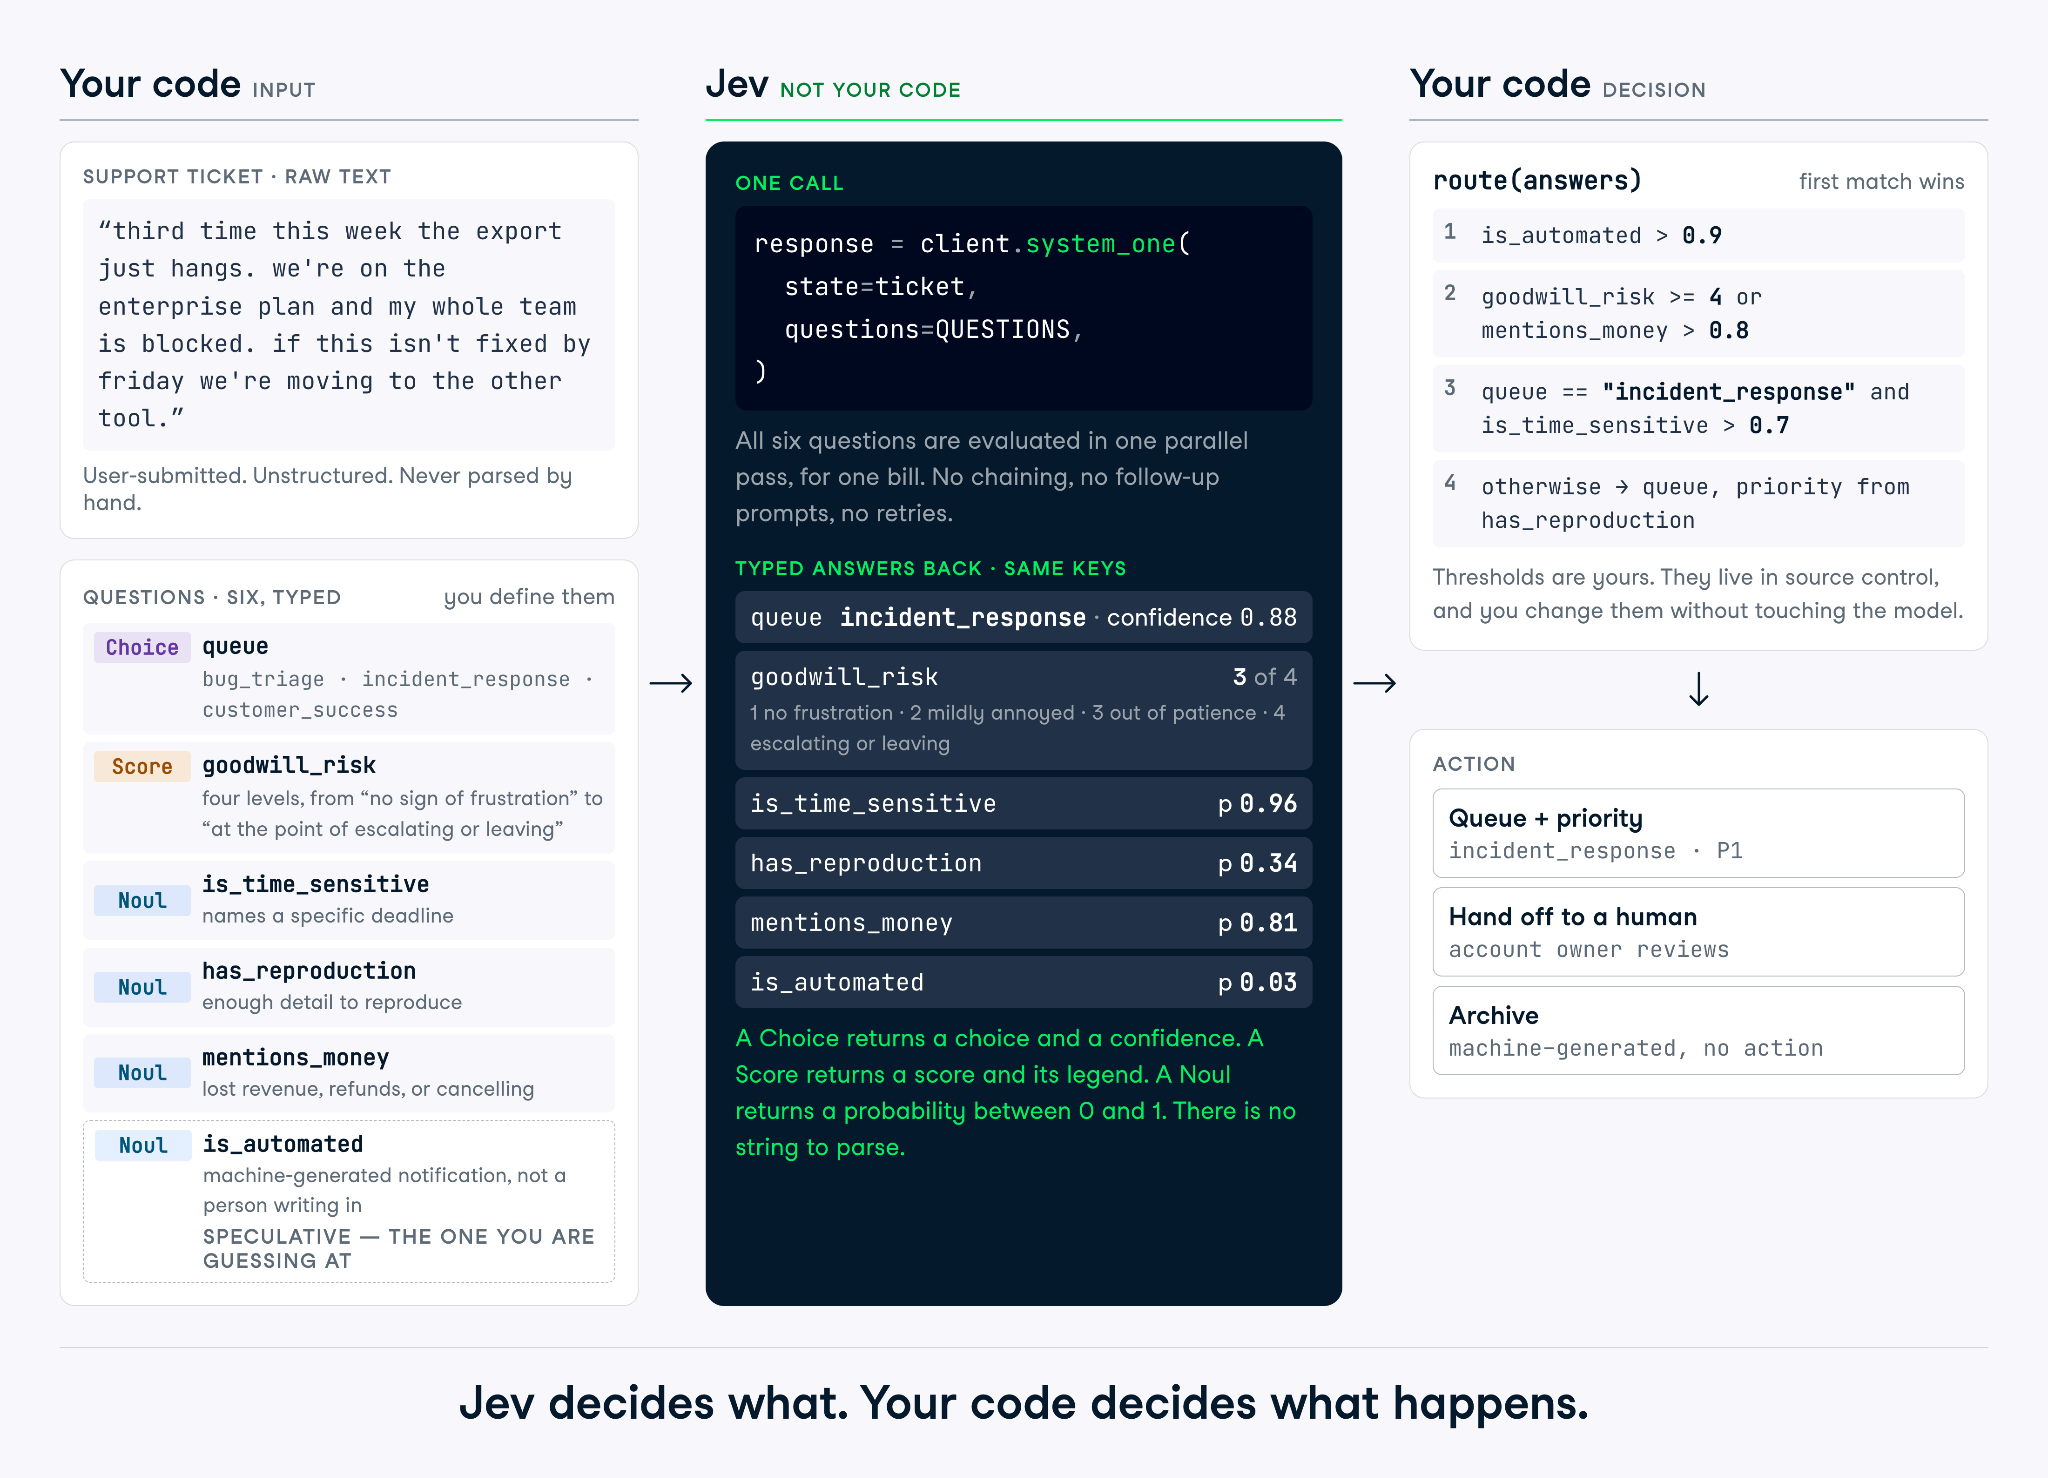
Übersetzen wir das in ein paar Routingregeln:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Lies, was diese Funktion tut. Das Modell hat sechs Urteile geliefert, und die Policy entscheidet, dass eines davon – mentions_money kombiniert mit Frust – die von Jev gewählte Queue überstimmt. Diese Priorisierung ist eine Business-Entscheidung, gehört in Code und kann am Freitagnachmittag geändert werden – ohne das Modell neu zu testen.
has_reproduction wird nie genutzt. Absicht. So sieht das Fan-out in der Praxis aus: Du fragst mehr, als die aktuelle Policy konsumiert, loggst alles – und wenn jemand wissen will, ob bug_triage-Tickets ohne Repro-Schritte länger offen sind, hast du schon sechs Wochen Daten.
Die Schwellenwerte oben sind Beispiele. Die richtigen findest du per Kalibrierung – dazu am Ende mehr.
Den kompletten Code findest du im begleitenden GitHub-Repo. In meinem Lauf mit unserem Szenario wurde das Ticket für heute an Incident Response geroutet.
python routing.py('incident_response', 'today')TypeSafe veröffentlicht pro Modellversion eine Jaggedness-Seite mit bekannten Fehlermodi. Ich wünschte, mehr Labs täten das. Lies sie, bevor du baust, und nochmal beim Upgrade – die Liste ist versioniert und die Kanten wandern.
Die fünf größten Zeitfresser für mich:
Du kannst keinen Schwellenwert zwischen Fragetypen übertragen. TypeSafes eigenes Beispiel fragt „Fordert der Kunde eine Rückerstattung?“ auf demselben Ticket auf beide Arten: Das Noul ergibt 0,22; die Ja/Nein-Choice ergibt 0,01 für Ja – mit 0,97 Confidence. Gleiche Frage, zwei Zahlen, zwei Größenordnungen auseinander.
Negationen spielen auch nicht mit. Ein Noul und sein Gegenteil kamen mit 0,72 und 0,47 zurück – Summe 1,19.
Grund: Die Typen fragen Unterschiedliches. Eine Choice ist relativ und entscheidet, welche Option gewinnt; jedes Noul ist absolut und kann bei allen Optionen niedrig sein. Tune Schwellenwerte pro Frage – in genau der Form, in der du sie ausrollst – und geh nie davon aus, dass P(yes) und 1 - P(no) dasselbe wären.
Score-Stufen sind geordnet, nicht skaliert. Ein 1,6 sagt nur: zwischen zweiter und dritter Stufe, Tendenz zur dritten.
Was du nicht tun kannst: eine reale Größe interpolieren. Wenn deine Stufen „unter einer Stunde“, „ein paar Stunden“ und „ein Tag“ sind, bedeutet 1,5 keine fünf Stunden. Nutze den Score, um einen Schwellenwert zu prüfen, und behalte jede echte Zahl im Code.
Jev behandelt den State als Daten, ist aber nicht dagegen gehärtet, dass der State selbst ihn steuert. Eingeschmuggelte Instruktionen, irreführendes Framing oder Text, der für seine eigene Klassifikation argumentiert, können die Antwort verschieben – TypeSafe will hier nachbessern. Wenn dir diese Angriffsfläche neu ist, behandeln wir den allgemeinen Fall in unserem Prompt-Injection-Guide.
Am kritischsten ist das bei nutzergeneriertem State – beim Ticket-Router also immer. Formuliere Kriterien so präzise, dass die Selbstaussagen des Tickets nicht entscheiden, und teste mit feindlichen Inputs, bevor du irgendetwas automatisch routest.
Zählen ist unzuverlässig und wird schlechter, je größer die Menge – das Modell erkennt die Form einer Antwort statt zu zählen. Daten werden als Text gelesen – Ordnung, Abstände, Zeitfenster gehen schief. Numerische Codierungen performen schlechter als ihre semantischen Entsprechungen – frag nach „rot“ statt #FF0000.
Die Lösung ist in allen drei Fällen dieselbe: Arbeit aufteilen.
Wenn du zählen musst, iteriere im Code und frage ein Noul pro Item ab:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Drei kleinere Punkte mit derselben Ursache. Jev beantwortet die Frage, die du geschrieben hast, nicht die, die du meintest. Bezugswörter und Verneinungen werden wörtlich gelesen. Doppelte Verneinungen und Fragen nach einer Eigenschaft einer Eigenschaft kosten Genauigkeit. Ein großer State mit irrelevanten Details kostet Genauigkeit und Geld – irrelevantes Material lenkt ab.
Der Hinweis auf den ersten Punkt: Wenn du bei einer falschen Antwort ins Erklären gerätst, „was du eigentlich meintest“, gehört genau diese Erklärung in die Instructions.
Basierend auf unseren Erkenntnissen hier ein paar Best Practices, um Jev optimal zu nutzen.
Formuliere die Bedingung statt der Absicht. Wenn du beim Review falscher Antworten erklärst, „was gemeint war“, gehört diese Erklärung in die Instructions. Konkret:
jev-latest bewegt sich. Pinne die Version, sobald ein Schwellenwert vom Modellverhalten abhängt:
client = TypeSafeClient(model="jev-1.13.0")Logge response.model zusammen mit den vollständigen Antworten bei jedem Call – nicht nur den Wert, auf dessen Basis du gehandelt hast. Wenn ein Schwellenwert „spinnt“, ist dieses Log deine einzige Chance, einen Modellwechsel von Ticket-Drift zu unterscheiden.
Schwellenwerte sind kein Dogma, sondern das Ergebnis von Experimenten.
Jev ist ein schmales Werkzeug – und das ist Absicht. Es beantwortet Fragen, deren Antworten du aufzählen kannst, so günstig, dass du nicht mehr knausern musst, und überlässt die Entscheidung deinem Code.
Was ich kritisch sehe, ist das Framing „kann nicht halluzinieren“. Im engen Sinn stimmt es: Das Modell kann nicht off-schema antworten. Aber ob die Antwort richtig ist, sagt das nicht. Eine Choice liefert immer eine gültige Queue. Sie kann trotzdem bei 0,9 Confidence falsch sein – und typisierter Output macht diesen Fehler leiser.
Teste es für deine Arbeit: Such eine Entscheidung, die dein Code mit einer brüchigen Regel oder einem langsamen LLM-Call trifft, und versuche, die gültigen Antworten aufzuschreiben. Wenn das geht, ist es Jev-förmig. Wenn nicht, hilft keine Fragenakrobatik.
Wenn du mit dem Bau von Systemen auf KI-Basis loslegen willst, empfehle ich dir unseren Associate AI Engineer for Developers Lernpfad. Du lernst, mit der OpenAI API, MCP, LangChain und mehr zu arbeiten.
Lerne AI Engineering mit DataCamp!
Lernpfad
Kurs
Kurs
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Moez Ali
6 Min.
Tutorial
DataCamp Team
4 Min.
Tutorial
Sejal Jaiswal
9 Min.


