Track
Inżynier AI Associate dla programistów
26 godz.
Już wspomniałem, że oczekiwania muszą pasować do modelu. W przypadku Jev jest to szczególnie ważne i w dużej mierze wynika z klasy modelu, określanej jako System One.
Model System One zwraca typowane decyzje zamiast tekstu. Wysyłasz blok stanu plus zestaw pytań, każde z przestrzenią odpowiedzi, którą definiujesz, a model zwraca po jednej odpowiedzi na pytanie z dołączonymi prawdopodobieństwami. Nic nie jest produkowane token po tokenie, więc nie ma ciągów do parsowania ani uszkodzonego JSON-a do naprawy. TypeSafe ukuł ten termin, nawiązując do słynnego podziału Daniela Kahnemana:
Ponieważ przestrzeń odpowiedzi jest schematem zadeklarowanym w twoim kodzie, modele System One z założenia nigdy nie zwrócą kategorii, której nie zdefiniowałeś. To znaczy, że nie wyjdą poza schemat. Mogą jednak się mylić, i do kilku podchwytliwych przypadków wrócimy później.
TypeSafe wyszedł z cienia 15 września 2026 r. z Jev w early access, podając 70–500 ms na odpowiedź i $0.042 za milion tokenów wejściowych, bez opłat za wyjście. Na własnym benchmarku czterech workflowów Jev osiąga ok. 68% trafności — mniej więcej środek stawki LLM przy ułamku kosztu.
Po więcej informacji o funkcjach i wydajności w benchmarkach polecam nasz przewodnik po Jev.
Zapisz poprawne odpowiedzi, zanim wykonasz wywołanie. Jeśli potrafisz je wyliczyć, masz problem w kształcie Jev:
Sięgnij po LLM, gdy wyjściem ma być proza lub kod, gdy przestrzeń odpowiedzi jest otwarta lub gdy zadanie wymaga kilku skoków rozumowania połączonych w łańcuch. Jev to też złe narzędzie do wszystkiego, co liczbowe — do tego wrócę później.
Zanim napiszesz jakikolwiek kod, załóż konto w TypeSafe i otwórz Playground. Tutaj możesz wkleić tekst jako stan, dodać pytania i zobaczyć pełne obiekty odpowiedzi bez instalowania czegokolwiek. To najszybszy sposób, żeby zrozumieć, co zwraca każdy typ pytania (i dowiedzieć się, czy twoje pytanie jest źle sformułowane).
Użyję jednego zgłoszenia wsparcia jako stanu dla wszystkich trzech przykładów:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Każdy typ pytania przyjmuje instructions — sformułowane zwykłym językiem pytanie, na które chcesz odpowiedzi. To, co się między nimi zmienia, to criteria i to, co wraca.
Choice wybiera jedną opcję z zestawu, który definiujesz.
Przekazujesz criteria jako słownik mapujący każdą opcję na opis — od 1 do 255 — a odpowiedź wraca z:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Żeby zobaczyć wynik w formacie, jaki dostałbyś przez API, kliknij przycisk </> w prawym górnym rogu i wybierz Run, żeby Jev odpowiedział na pytanie.
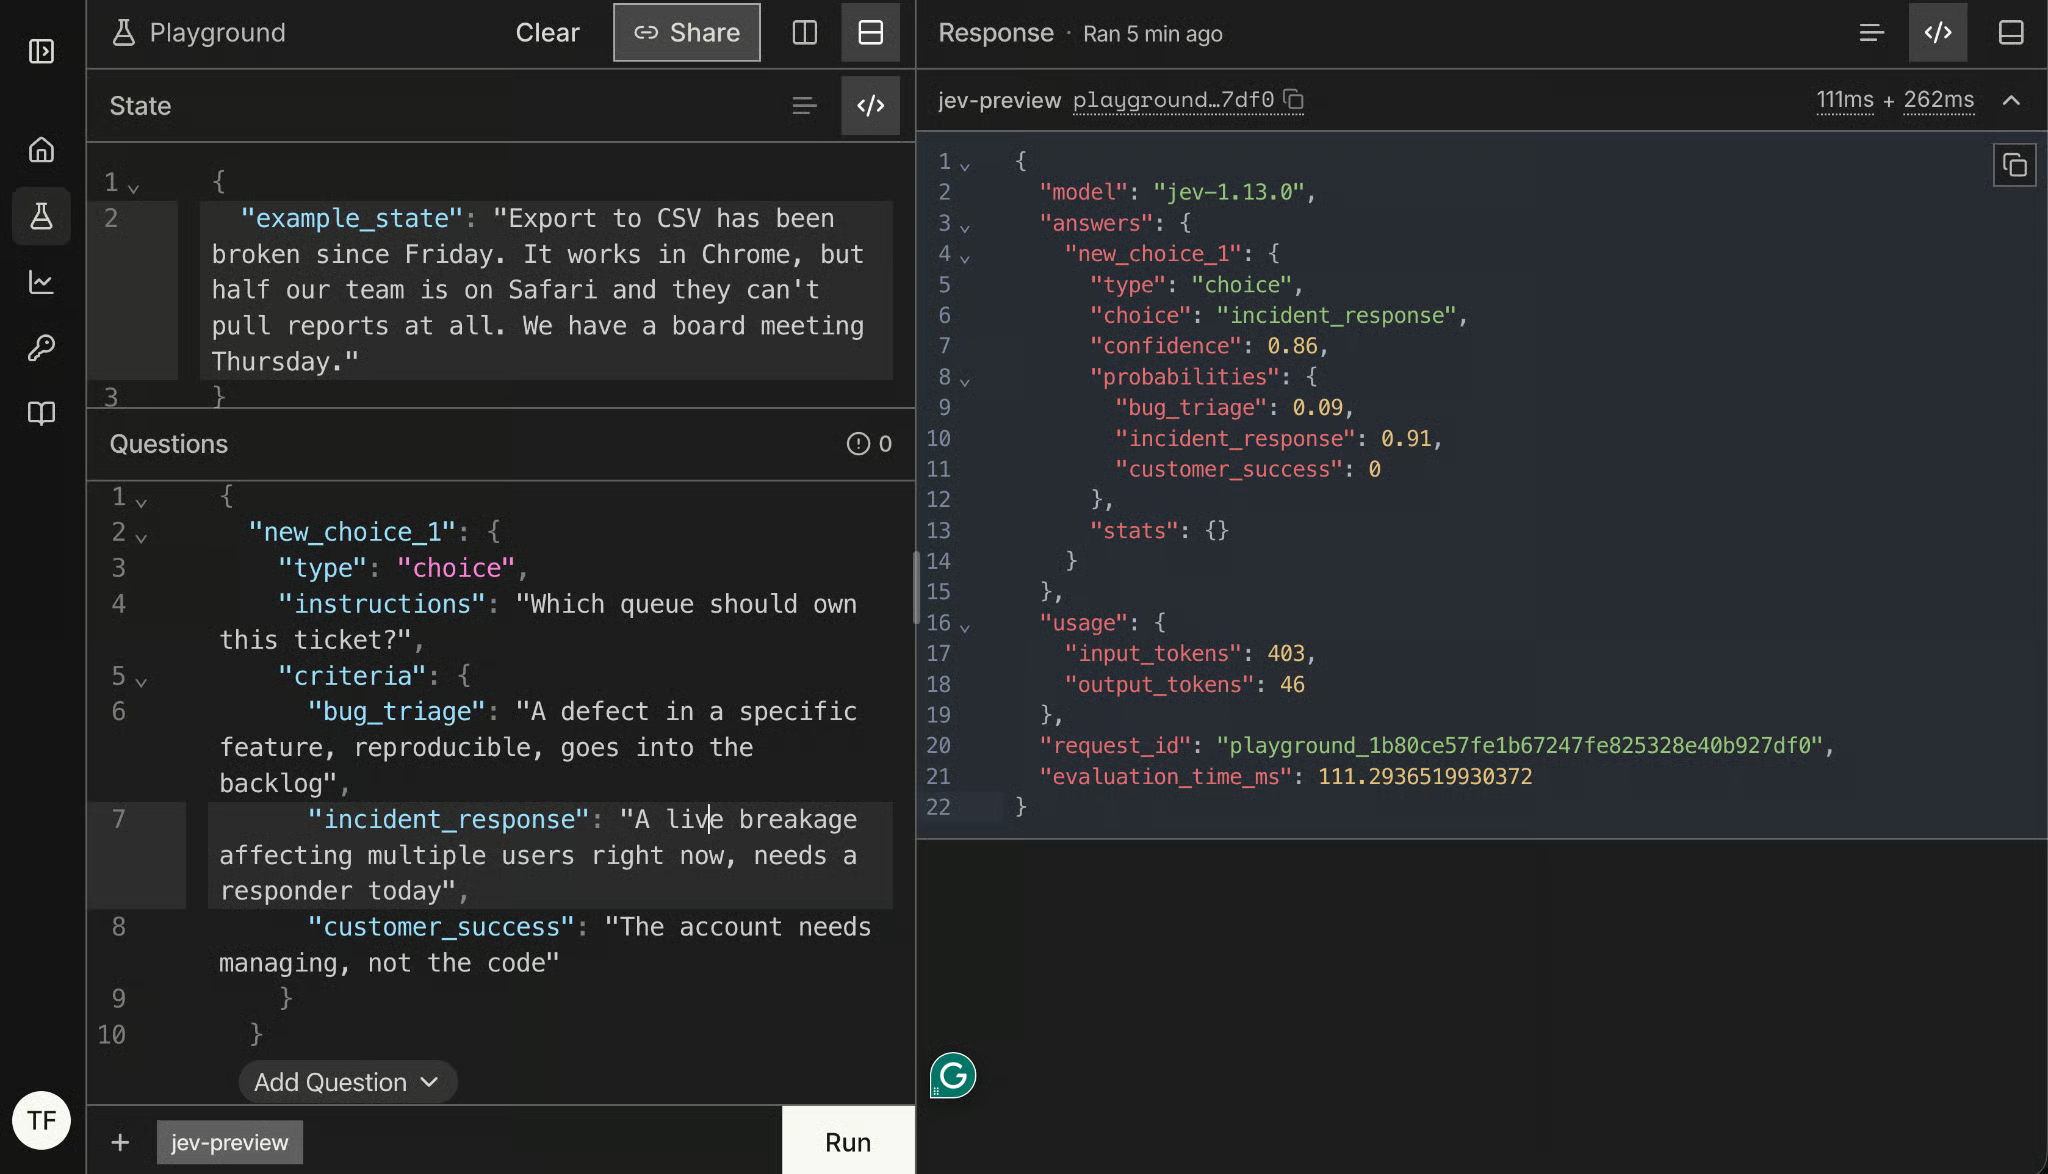
W tym przypadku incident_response to choice z prawdopodobieństwem 91%. confidence Jev dla wyboru to 86%.
Pełny rozkład to część warta twojej uwagi.
choice mówi tylko, która opcja wygrała.
probabilities mówi, o ile.
To różne informacje, gdy masz zamiar automatycznie zrutować zgłoszenie. Podział 0.41/0.38/0.21 i 0.91/0.09/0 mogą zwrócić to samo choice.
Score ocenia stan względem uporządkowanych poziomów. Przekazujesz criteria jako tablicę od 2 do 10 opisów poziomów, od najniższego, a odpowiedź zawiera score, legend mapującą pozycje na twoje opisy, prawdopodobieństwo na poziom i confidence.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}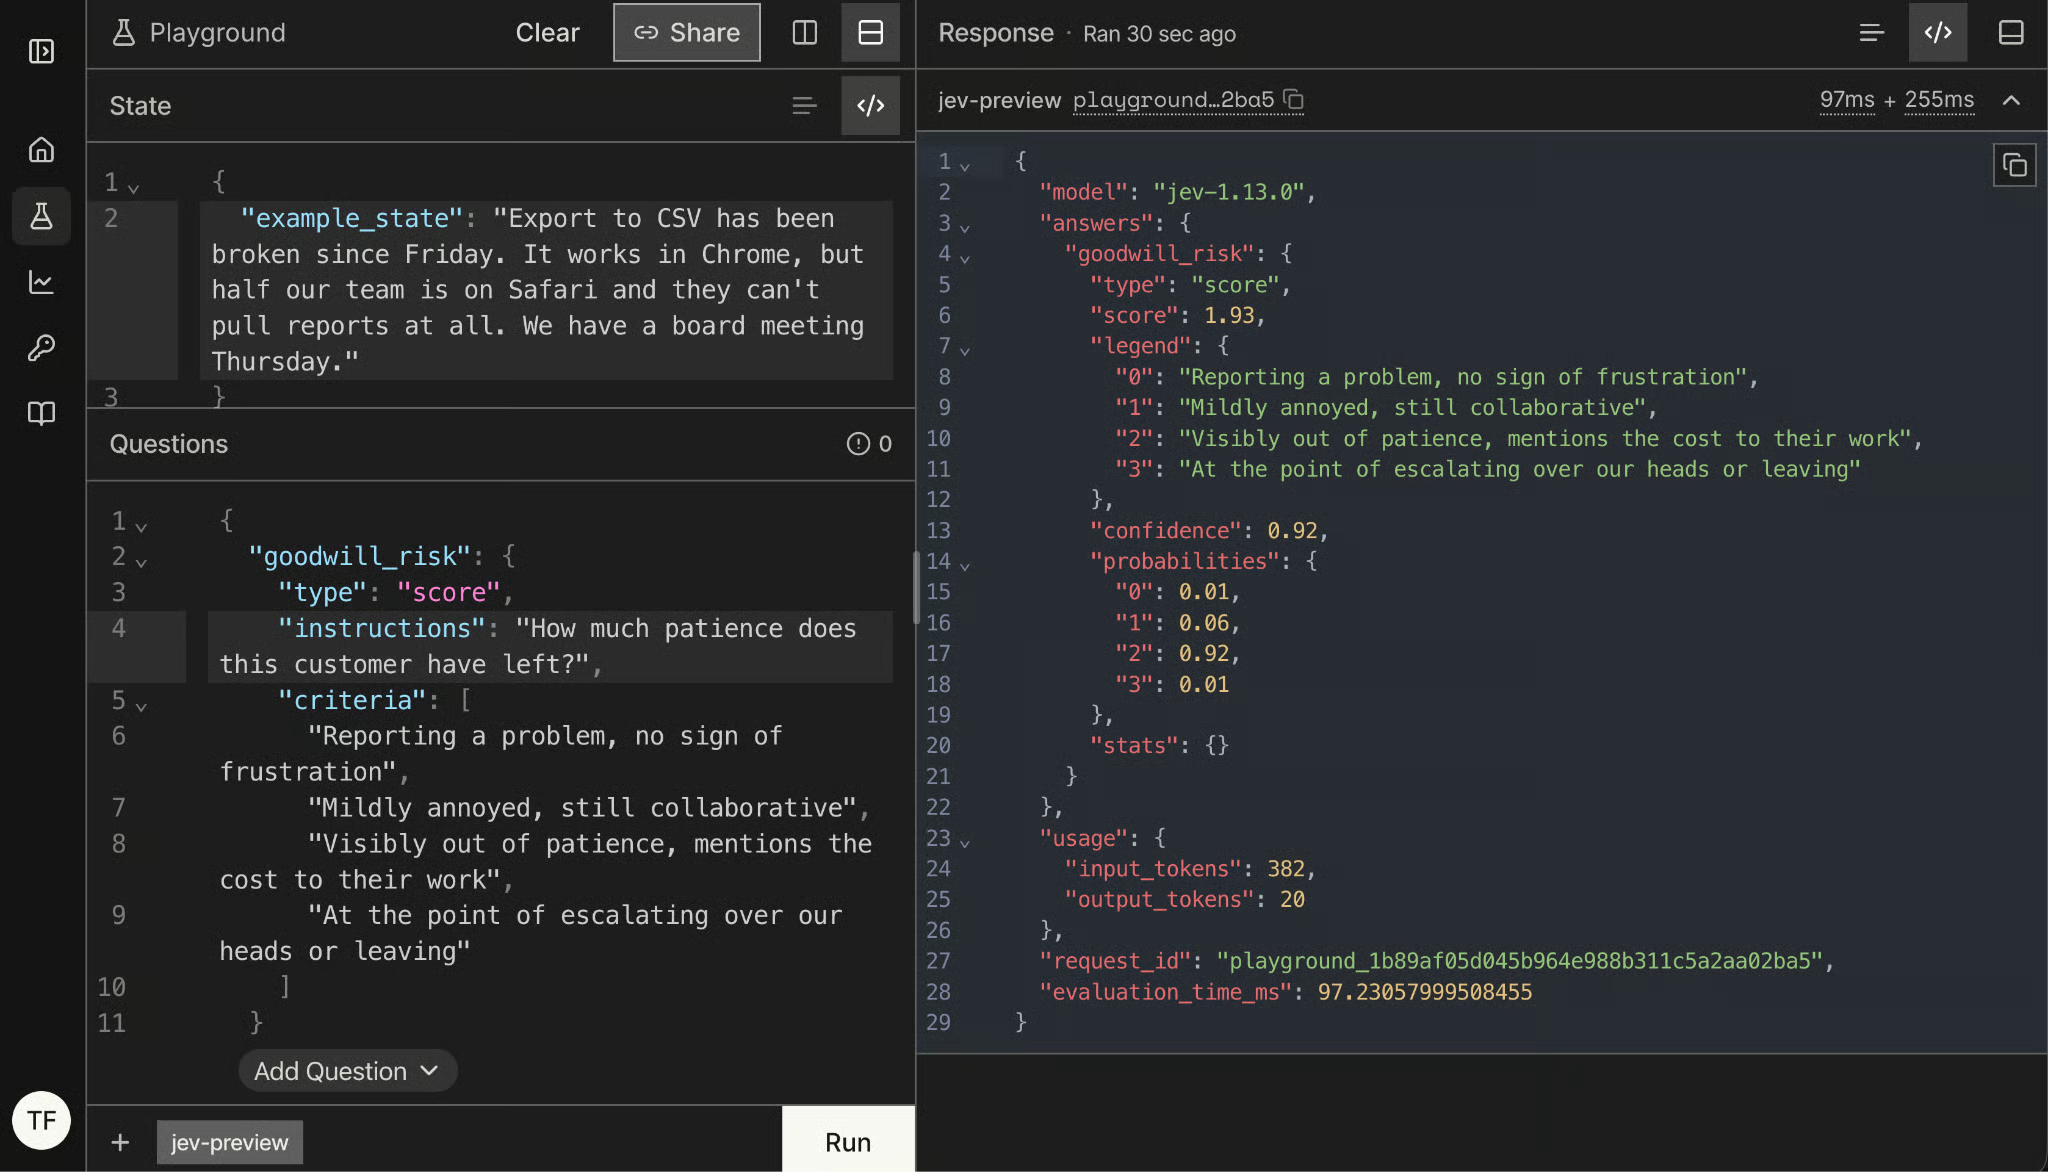
Wynik może wylądować między poziomami — i właśnie po to jest legend. score równe 1.93 oznacza, że model jest rozdarty między „lekko poirytowany” a „widocznie bez cierpliwości”, z mocnym przechyłem w tę drugą stronę — to rozsądna lektura zgłoszenia, które pozostaje uprzejme, ale podaje termin, którego nie dotrzyma.
Znów: czytaj rozkład probabilities, a nie samą liczbę. Skupienie na jednym poziomie oznacza zdecydowaną odpowiedź, rozsmarowanie na trzech — że dostałeś średnią zamiast osądu.
Noul to typ do pytań binarnych, a nazwę ukuł TypeSafe. criteria jest tu opcjonalne, choć możesz opisać, co znaczy true i false — warto to robić wszędzie tam, gdzie „tak” można odczytać dwojako.
Sformułuj pytanie tak, by wysoka wartość znaczyła „tak”. Dokumentacja TypeSafe mówi to wprost, a Noul, w którym true mapuje na „nie”, działa mierzalnie gorzej.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}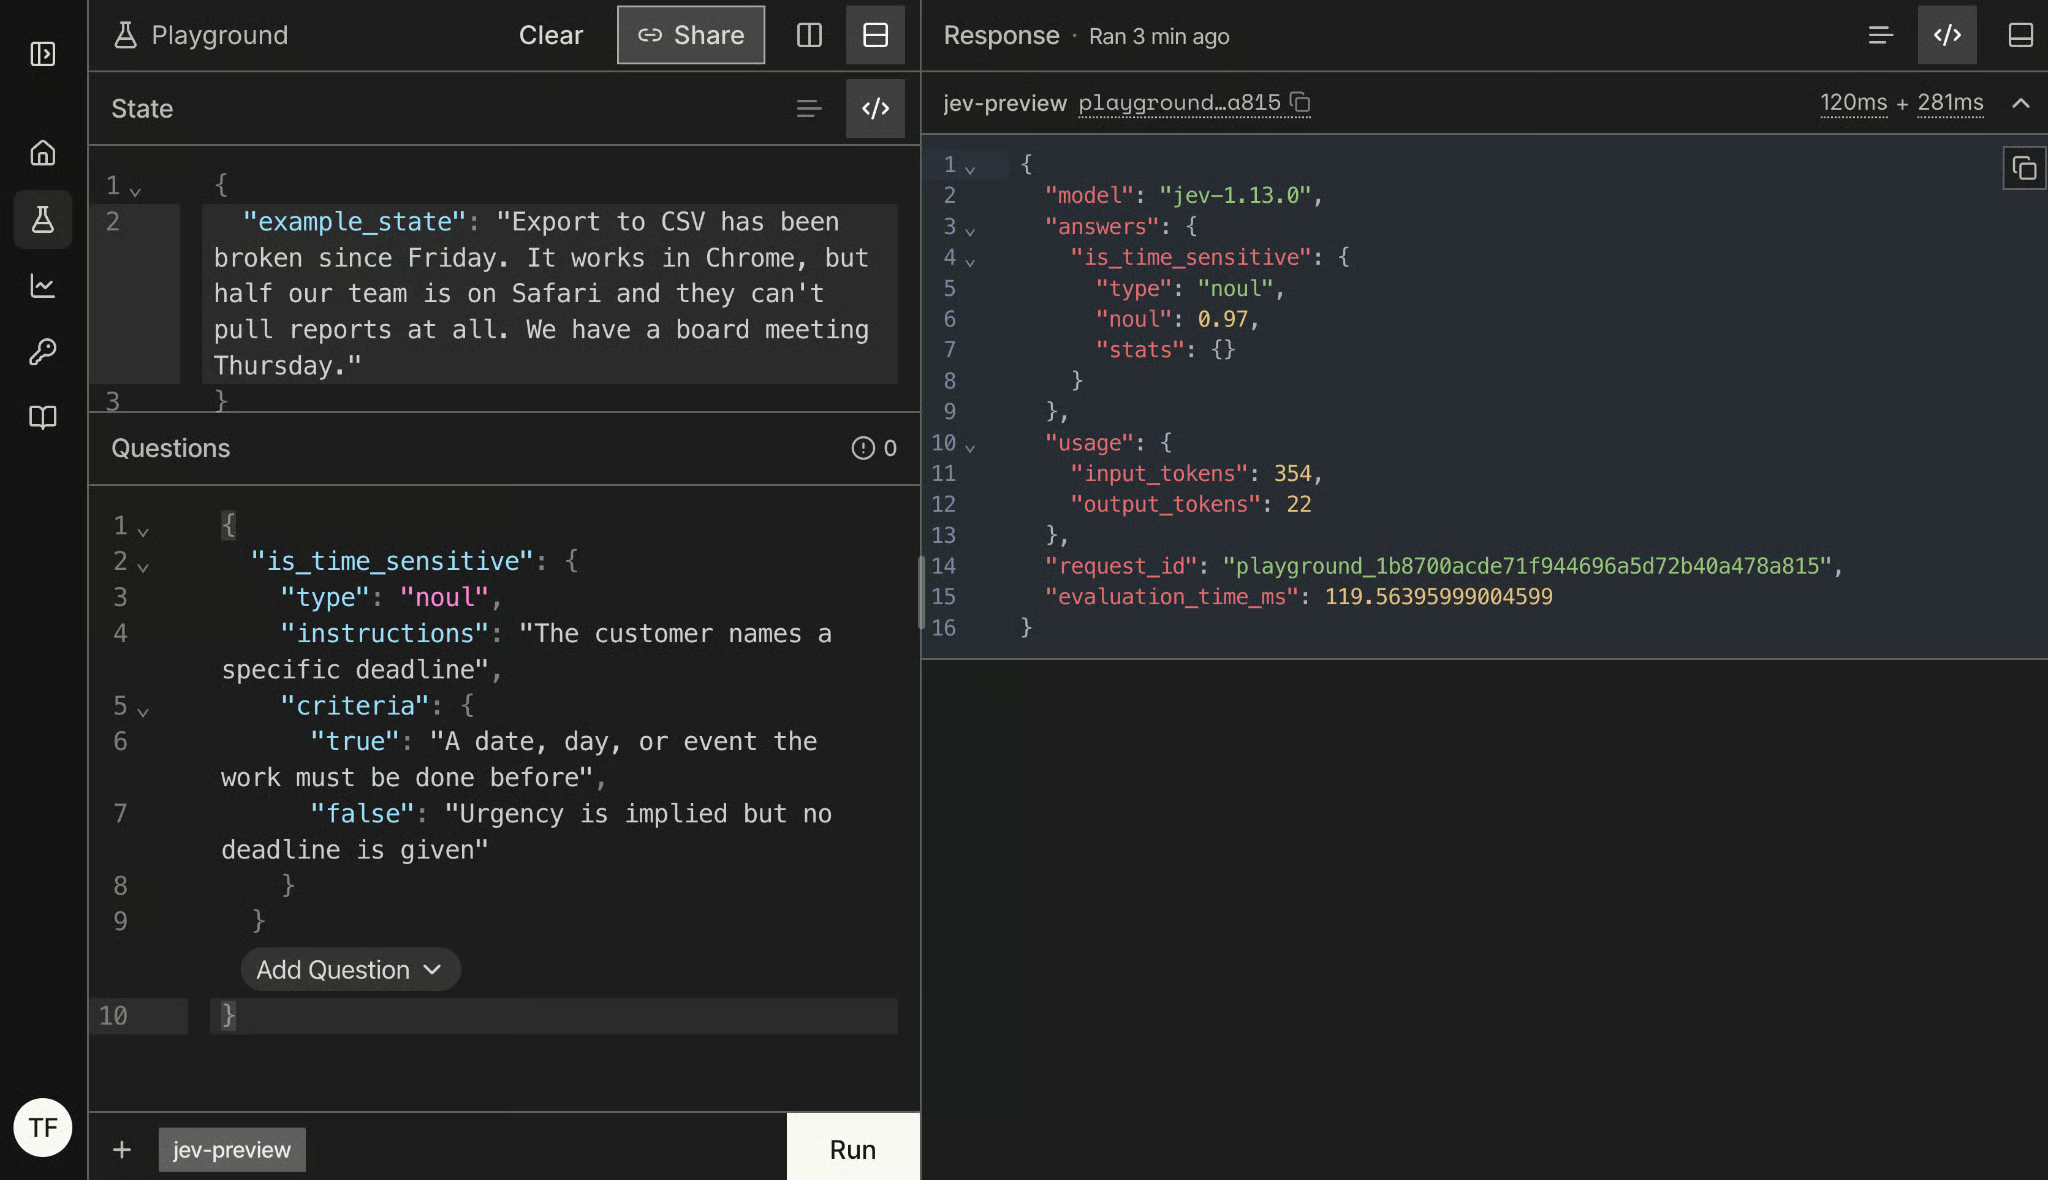
Ponieważ w stanie wspomniano o posiedzeniu zarządu w czwartek, wysoka wartość noul równa 0.97 była spodziewana.
Choice i Score zwracają confidence obok prawdopodobieństw. Noul nie — i to potrafi mylić, więc warto być precyzyjnym dlaczego.
Confidence i probability to osobne osie. Dla Choice probabilities mówi, jak model rozkłada przekonanie po twoich opcjach, a confidence — jak pewnie trzyma się tej odpowiedzi, i dlatego Choice może zwrócić topową opcję 0.85 z confidence 0.78. Noul ma tylko dwa wyniki, więc pojedyncze prawdopodobieństwo już niesie oba: 0.97 to twarde tak, 0.03 to twarde nie, a 0.52 to model mówiący, że nie ma pojęcia.
To znaczy, że odległość od 0.5 jest sygnałem zdecydowania, a nie osobnym polem. Oznacza to też, że nie przeniesiesz progu z Noul na Choice — do tego wrócę przy sekcji o „ząbkach”, bo gryzie mocniej, niż brzmi.
Żeby nadążać, potrzebujesz tylko Pythona 3.10+ i klucza TypeSafe do wczesnego dostępu.
Zainstaluj SDK:
pip install typesafe-sdkAlbo przez uv:
uv add typesafe-sdkNastępnie utwórz klucz w konsoli TypeSafe i wyeksportuj go. Klient czyta TYPESAFE_API_KEY ze środowiska, więc nigdy nie przekazujesz go w kodzie:
export TYPESAFE_API_KEY="your-key"Poniższe importy dają ci wszystko z playgroundu:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul i Score to te same typy pytań, które właśnie klikałeś, tyle że jako obiekty w Pythonie.
TypeSafeClient to klient synchroniczny, a jest też AsyncTypeSafeClient z tym samym interfejsem, jeśli wywołujesz Jev z usługi async. Oba działają jako menedżery kontekstu — i tak bym ich używał we wszystkim dłuższym niż skrypt:
with TypeSafeClient() as client:
...Pozostawiony w spokoju, klient wywołuje jev-latest, który przestawia się, gdy TypeSafe wydaje nową wersję — i to będziemy używać w całym tutorialu. Do wszystkiego, gdzie masz już dobrany próg, przypnij wersję:
client = TypeSafeClient(model="jev-1.13.0")Odpowiedź i tak mówi, który model faktycznie odpowiedział, i na końcu jest sekcja o tym, czemu warto to logować.
Żeby wykonać wywołanie API do Jev, musisz zdefiniować element response używając TypeSafeClient i funkcji system_one(), która przyjmuje kontekst pytań jako parametr state oraz same questions w tym samym formacie co w playgroundzie.
Możemy stworzyć jedno wywołanie, które odpowie na wszystkie 3 pytania z playgroundu, bo mają ten sam state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Odpowiedzi wracają pod tymi samymi nazwami, które wybrałeś dla każdego pytania — i to jest detal, który sprawia, że całość jest przyjemna w pracy:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Jeśli pierwsze wywołanie pada z TypeError o output_buffer_limit: to nie twój kod, tylko niedopasowanie wersji w backendzie kompresji SDK. SDK dostarcza własnego klienta HTTP, httpx2, który dekompresuje odpowiedzi przez zstandard i brotli, a starsza kopia któregoś z nich nie ma argumentu, z jakim jest wołana. pip install -U typesafe-sdk httpx2 zstandard brotli rozwiązało to u mnie.
Dwie rzeczy w tym outputcie warte są pauzy.
Po pierwsze, response.model zwróciło jev-1.13.0, nie jev-latest. Poprosiłeś o ruchomy alias, a Jev powiedział ci, która wersja faktycznie odpowiedziała — i to jedyny powód, dla którego logowanie tego pola jest na tyle tanie, że warto.
Po drugie, obiekty odpowiedzi są typowane per typ pytania, więc .choice, .score i .noul to prawdziwe atrybuty, a twój edytor o nich wie. W tym kodzie nie ma nigdzie ciągów JSON, nic do parsowania, żadnej gałęzi na przypadek uszkodzonej odpowiedzi. Jeśli wolisz grupowanie, SDK wystawia też response.choices, response.scores i response.nouls — pod tymi samymi kluczami.
Zerknij też na response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Tokeny wyjścia są jednocyfrowe i darmowe. Płacisz za stan i pytania, więc możesz w pełni kontrolować dźwignię kosztu, decydując, ile kontekstu wysyłasz. To ma większe znaczenie, niż wygląda, i wróci w sekcji o „ząbkach”: napompowany stan kosztuje cię jednocześnie pieniądze i trafność.
To jeden z przypadków użycia, do których Jev jest zbudowany. Przyjeżdża zgłoszenie wsparcia i coś musi zdecydować, do której kolejki trafi, czy najpierw powinien spojrzeć na nie człowiek i jak szybko. Każde z nich to osąd z przestrzenią odpowiedzi, którą możesz zapisać zanim zgłoszenie przyjdzie.
Zasada projektowa, którą warto wypowiedzieć na starcie: Jev decyduje, co jest, twój kod decyduje, co się dzieje. Jev nigdy nic nie rutuje. Zwraca liczby, a routing żyje w zwykłej funkcji, którą możesz czytać, testować i zmieniać bez dotykania modelu.
Pytania w jednym żądaniu są oceniane równolegle, więc szóste pytanie kosztuje cię tokeny, w jakich jest napisane, i niemal zerowy dodatkowy narzut na opóźnienie. To zmienia sposób zadawania pytań. Z LLM grupowałbyś ostrożnie, by oszczędzić round-trip, a tutaj pytasz o wszystko, co może się przydać w danym kontekście — łącznie z pytaniami, które prawdopodobnie zignorujesz.
Rozszerzmy poprzedni zestaw o trzy kolejne Noule, które dadzą nam ważne informacje o obsłudze zgłoszenia:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Sześć pytań, wszystkie w jednym wywołaniu i jednej fakturze. is_automated jest spekulatywne: w prawie każdym prawdziwym zgłoszeniu będzie fałszywe, a i tak warto pytać, bo ten jeden raz, kiedy będzie prawdziwe, oszczędza człowieka otwierającego bounce od mailer daemona.
Dwa nawyki, które bym tu wyrobił.
Trzymaj zestaw pytań jako stałą modułową, a nie buduj inline, bo to rzecz, którą będziesz wersjonować razem z progami.
Nazywaj pytania po tym, co mierzą, nie po tym, co zrobisz z odpowiedzią, bo is_time_sensitive przeżyje zmianę polityki, a route_to_incident nie.
Formułuj pytania pozytywnie: Moglibyśmy nazwać is_automated czymś w stylu needs_no_reply, ale według TypeSafe pytania sformułowane pozytywnie wypadają lepiej.
Teraz część, której Jev nie robi. Każda odpowiedź przychodzi z wartością confidence albo prawdopodobieństwem — i to drugi numer pozwala ci zbudować trzy ścieżki zamiast dwóch:
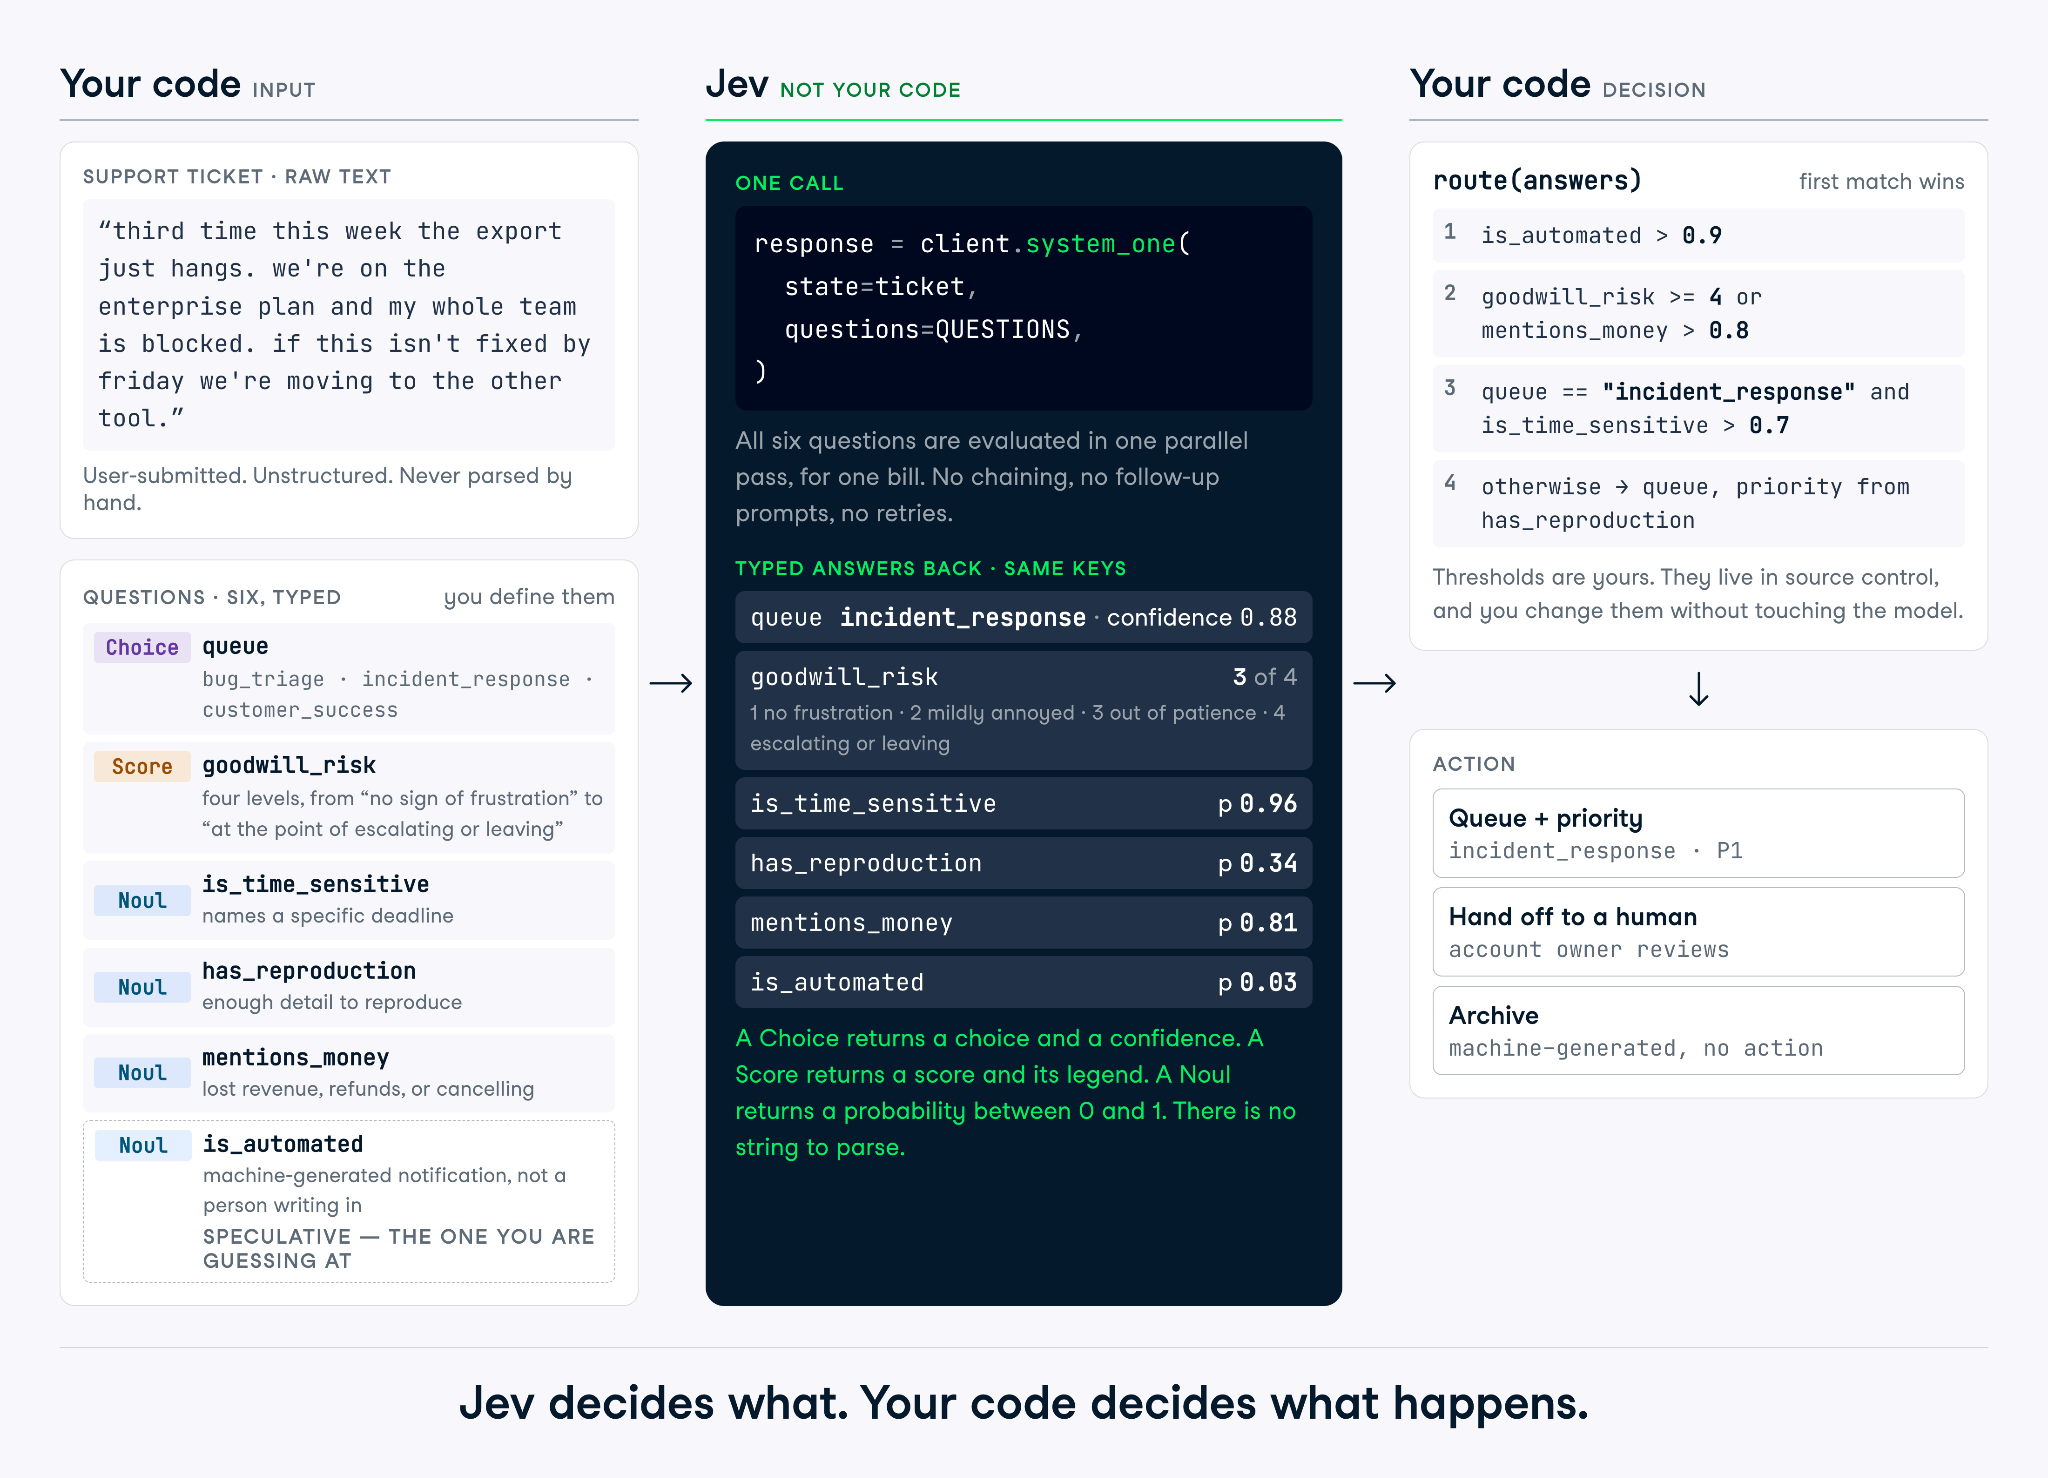
Przekujmy to w kilka zasad routingu zgłoszeń:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Przeczytaj, co robi ta funkcja. Model dostarczył sześć osądów, a polityka zdecydowała, że jeden z nich, mentions_money skrzyżowane ze sfrustrowanym klientem, ma pierwszeństwo przed kolejką wybraną przez Jev. Ten override to decyzja biznesowa, miejsce ma w kodzie i możesz go zmienić w piątek po południu bez retestowania modelu.
has_reproduction nigdy nie jest używane. Zostawiłem je celowo, bo tak wygląda w praktyce wzorzec fan-out: prosisz o więcej, niż obecna polityka konsumuje, logujesz wszystko, i kiedy ktoś zapyta, czy zgłoszenia bug_triage bez kroków repro zamykają się dłużej, masz już sześć tygodni odpowiedzi.
Powyższe progi to tylko przykłady. Dobranie właściwych to kwestia kalibracji — na końcu jest sekcja o ustawianiu ich na podstawie danych, a nie przeczucia.
Pełny skrypt znajdziesz w tym repozytorium GitHub. Gdy uruchomiłem skrypt Pythona z naszym scenariuszem, werdykt brzmiał: zrutować zgłoszenie do zespołu incident response na dziś.
python routing.py('incident_response', 'today')TypeSafe publikuje stronę ząbków dla każdej wersji modelu, z listą znanych trybów porażki. Chciałbym, żeby więcej labów tak robiło. Przeczytaj, zanim coś zbudujesz, i przeczytaj ponownie, gdy aktualizujesz — lista jest wersjonowana i krawędzie się przesuwają.
Oto pięć, które kosztowałyby mnie najwięcej czasu.
Nie przeniesiesz progu między typami pytań. Przykład TypeSafe pyta „Czy klient prosi o zwrot?” na tym samym zgłoszeniu na dwa sposoby: Noul zwraca 0.22, Choice tak/nie zwraca 0.01 dla „tak” z confidence 0.97. To samo pytanie, dwie liczby, dwa rzędy wielkości różnicy.
Negacje też nie współpracują. Noul i jego przeciwieństwo wróciły 0.72 i 0.47, co sumuje się do 1.19.
Powód jest taki, że te typy pytają o różne rzeczy. Choice jest relatywne i rozstrzyga, która opcja wygrywa, podczas gdy każdy Noul jest absolutny i może być nisko dla wszystkich. Strojąc progi, rób to per pytanie, w formie, w jakiej wysyłasz — i nigdy nie zakładaj, że P(yes) i 1 - P(no) to ta sama liczba.
Poziomy Score są uporządkowane, nie równomiernie rozstawione. 1.6 mówi, że model siedzi między twoim drugim i trzecim poziomem, z przechyłem ku trzeciemu — i to wszystko.
Czego nie możesz zrobić, to interpolować z tego realnej wielkości. Jeśli twoje poziomy to „poniżej godziny”, „kilka godzin” i „dzień”, 1.5 nie znaczy pięciu godzin. Używaj wyniku do testowania progu, a każdą faktyczną liczbę trzymaj w kodzie.
Jev traktuje stan jak dane, ale nie jest utwardzony przeciwko kodowi pisanemu w stanie, który próbuje nim sterować. Wstrzyknięta instrukcja, mylące ramowanie czy tekst argumentujący na rzecz własnej klasyfikacji mogą przesunąć odpowiedź — TypeSafe mówi, że planuje tu poprawę. Jeśli powierzchnia ataku jest ci nowa, omawiamy ogólny przypadek w naszym przewodniku po prompt injection.
To najbardziej boli tam, gdzie stan jest dostarczany przez użytkownika — a w routerze zgłoszeń zawsze tak jest. Pisz kryteria na tyle precyzyjne, by twierdzenia zgłoszenia o samym sobie nie decydowały o wyniku, i testuj na wrogich danych, zanim coś zautomatyzujesz.
Liczenie jest zawodne i pogarsza się wraz ze wzrostem liczby elementów, bo model rozpoznaje kształt odpowiedzi zamiast zliczać. Daty są czytane jak tekst, więc porządkowanie, odległość i okna czasowe zawodzą. Numeryczne kodowania wypadają gorzej niż ich semantyczne odpowiedniki — pytaj o „czerwony”, a nie #FF0000.
Naprawa jest ta sama w trzech przypadkach: rozdziel pracę.
Jeśli potrzebujesz licznika, iteruj w kodzie i pytaj jednym Noulem na element:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Trzy mniejsze, o wspólnej przyczynie. Jev odpowiada na pytanie, które napisałeś, nie to, które miałeś na myśli, więc słowa określające zakres i negacje czytane są dosłownie. Podwójne zaprzeczenia i pytania o własność własności kosztują trafność. A duży stan napompowany nieistotnymi detalami kosztuje i trafność, i pieniądze, bo niepowiązany materiał działa jak dystraktor.
Wskazówka do pierwszego: kiedy patrzysz na złą odpowiedź i łapiesz się na tłumaczeniu, co naprawdę miałeś na myśli — to tłumaczenie to brakująca połowa twojej instrukcji.
Na bazie tego, czego już się nauczyliśmy, oto kilka dobrych praktyk, by wycisnąć z Jev jak najwięcej.
Pisz warunek zamiast intencji. Jeśli przy przeglądzie złej odpowiedzi tłumaczysz, co miałeś na myśli, to wyjaśnienie należy do instrukcji. To znaczy:
jev-latest się zmienia. Przypnij wersję, gdy tylko próg zaczyna zależeć od zachowania modelu:
client = TypeSafeClient(model="jev-1.13.0")Loguj response.model razem z pełnymi odpowiedziami przy każdym wywołaniu, nie tylko wartość, na podstawie której działałeś. Gdy próg zacznie wariować, ten log to jedyny sposób, by odróżnić zmianę modelu od dryfu w twoich zgłoszeniach.
Wreszcie, progi nie są dane z góry — to wynik eksperymentów.
Jev to wąskie narzędzie — i o to w nim chodzi. Odpowiada na pytania, których odpowiedzi potrafisz wyliczyć, na tyle tanio, że przestajesz je racjonować, a decyzję oddaje twojemu kodowi.
Z czym bym polemizował, to narracja „nie może halucynować”. W wąskim sensie prawda, że model nie wyjdzie poza schemat, ale to nic nie mówi o poprawności odpowiedzi. Choice zawsze zwróci poprawną z definicji kolejkę. Nadal może to być zła kolejka przy confidence 0.9, a typowane wyjście sprawia, że taka porażka jest cichsza.
Żeby sprawdzić go w swojej pracy, znajdź jedną decyzję, którą twój kod podejmuje kruchą regułą albo wolnym wywołaniem LLM, i spróbuj zapisać poprawne odpowiedzi. Jeśli potrafisz — to problem w kształcie Jev. Jeśli nie — żadna inżynieria pytań tego nie zmieni.
Jeśli chcesz zacząć budować systemy wykorzystujące AI, bardzo polecam ścieżkę kariery Associate AI Engineer for Developers. Nauczysz się pracy z OpenAI API, MCP, LangChain i wieloma innymi.
Ucz się AI Engineering z DataCamp!
Track
course
course