track
Inginer AI asociat pentru dezvoltatori
26 oră
Am menționat deja că așteptările trebuie să se potrivească modelului. Asta e valabil mai ales în cazul lui Jev și are mai ales legătură cu clasa sa de model, denumită modele System One.
Un model System One întoarce decizii tipizate în loc de text. Trimiți un bloc de stare plus un set de întrebări, fiecare cu un spațiu de răspuns pe care îl definești, iar modelul întoarce câte un răspuns per întrebare, cu probabilități atașate. Nimic nu este produs token cu token, deci nu există string de parsat și nici JSON stricat de reparat. TypeSafe a inventat acest termen referindu-se la celebra împărțire a lui Daniel Kahneman:
Pentru că spațiul de răspuns este o schemă pe care o declară codul tău, modelele System One, prin design, nu pot întoarce niciodată o categorie pe care nu ai definit-o. Asta înseamnă că nu pot fi off-schema. Totuși, pot greși, și vom intra mai târziu în câteva cazuri dificile.
TypeSafe a ieșit din stealth pe 15 septembrie 2026, cu Jev în early access, raportând răspunsuri în 70 până la 500 ms și 0,042 $ per milion de tokeni de input, cu output gratuit. Pe propriul său benchmark cu patru fluxuri de lucru, Jev ajunge pe la 68% acuratețe, aproximativ la nivelul LLM-urilor mid-tier, la o fracțiune din cost.
Pentru mai multe informații despre funcționalități și performanța la benchmark, îți recomand să citești ghidul nostru Jev.
Notează răspunsurile valide înainte de a face apelul. Dacă le poți enumera, ai o problemă în formă de Jev:
Apelează la un LLM când outputul este proză sau cod, când spațiul de răspuns e deschis sau când taskul are nevoie de mai multe hop-uri de raționament înlănțuite. Jev este, de asemenea, instrumentul greșit pentru orice numeric, și voi reveni mai târziu la motivul pentru asta.
Înainte să scrii orice cod, creează-ți un cont TypeSafe și deschide Playground. Aici poți lipi text ca stare, adăuga întrebări și vedea obiectele de răspuns complete fără să instalezi nimic. Este cel mai rapid mod de a înțelege ce întoarce fiecare tip de întrebare (și de a afla dacă întrebarea ta e formulată prost).
Voi folosi un singur tichet de suport ca stare pentru toate cele trei exemple:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Fiecare tip de întrebare primește instructions, întrebarea în limbaj natural la care vrei răspuns. Ce se schimbă între ele este criteria și ce revine înapoi.
Un Choice alege o opțiune dintr-un set pe care îl definești.
Transmiți criteria ca un dicționar care map-ează fiecare opțiune la o descriere, de la 1 la 255 dintre ele, iar răspunsul revine cu:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Pentru a vedea outputul de cod pe care l-ai primi și prin API, dă clic pe butonul </> din dreapta sus și apasă Run ca să lași Jev să răspundă la întrebare.
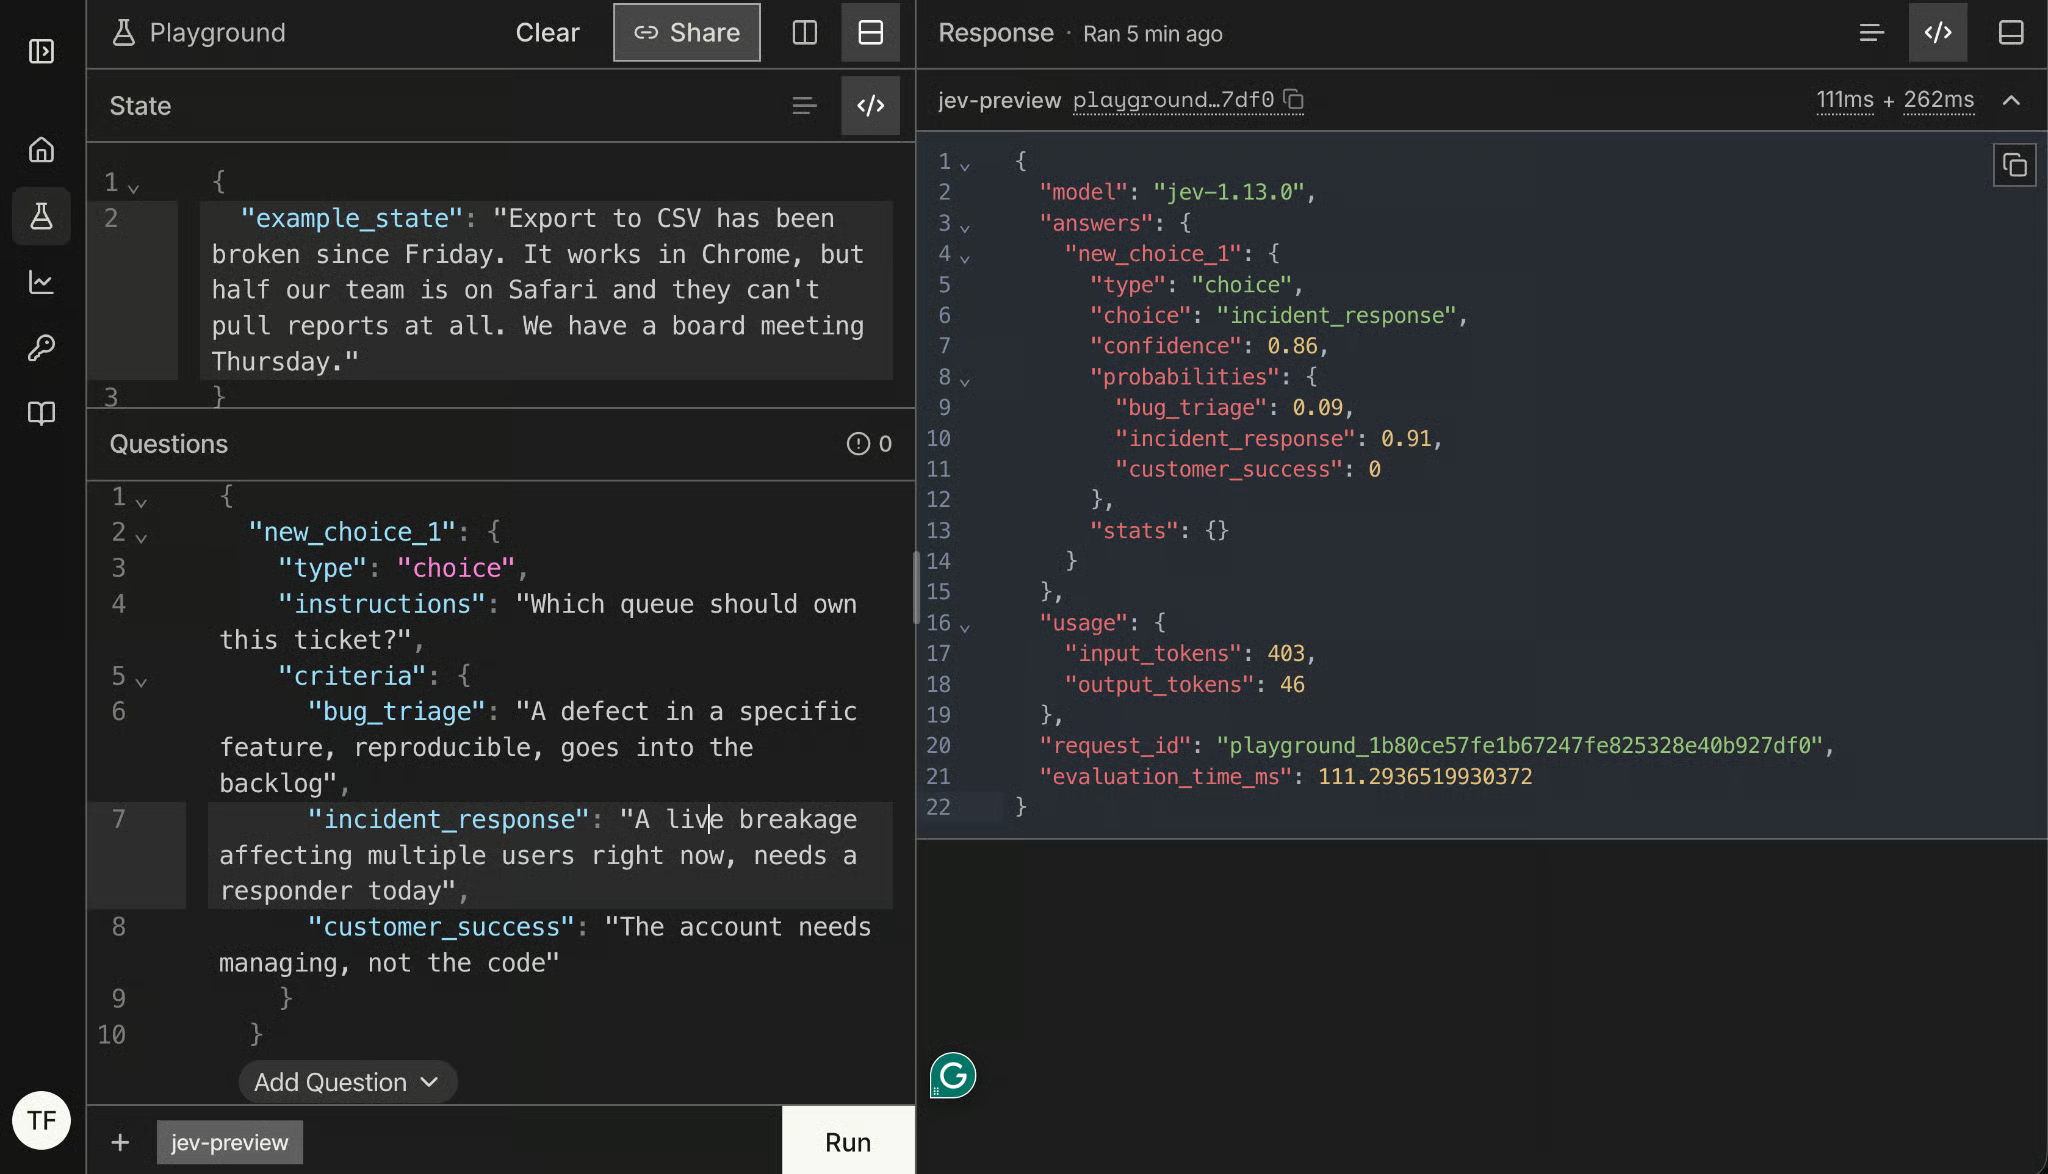
În acest caz, incident_response este choice cu o probabilitate de 91%. confidence al lui Jev pentru alegere este 86%.
Distribuția completă este partea care merită atenția ta.
choice îți spune doar care opțiune a câștigat.
probabilities îți spune cu cât.
Acestea sunt informații diferite când ești pe cale să rutezi un tichet automat. O împărțire 0,41/0,38/0,21 și 0,91/0,09/0 pe care am primit-o ar putea întoarce același choice.
Un Score evaluează starea față de nivele ordonate. Transmiți criteria ca un array de 2 până la 10 descrieri de nivel, de la cel mai mic la cel mai mare, iar răspunsul include un scor, un legend care mapează fiecare poziție la descrierea ta, o probabilitate per nivel și încredere.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}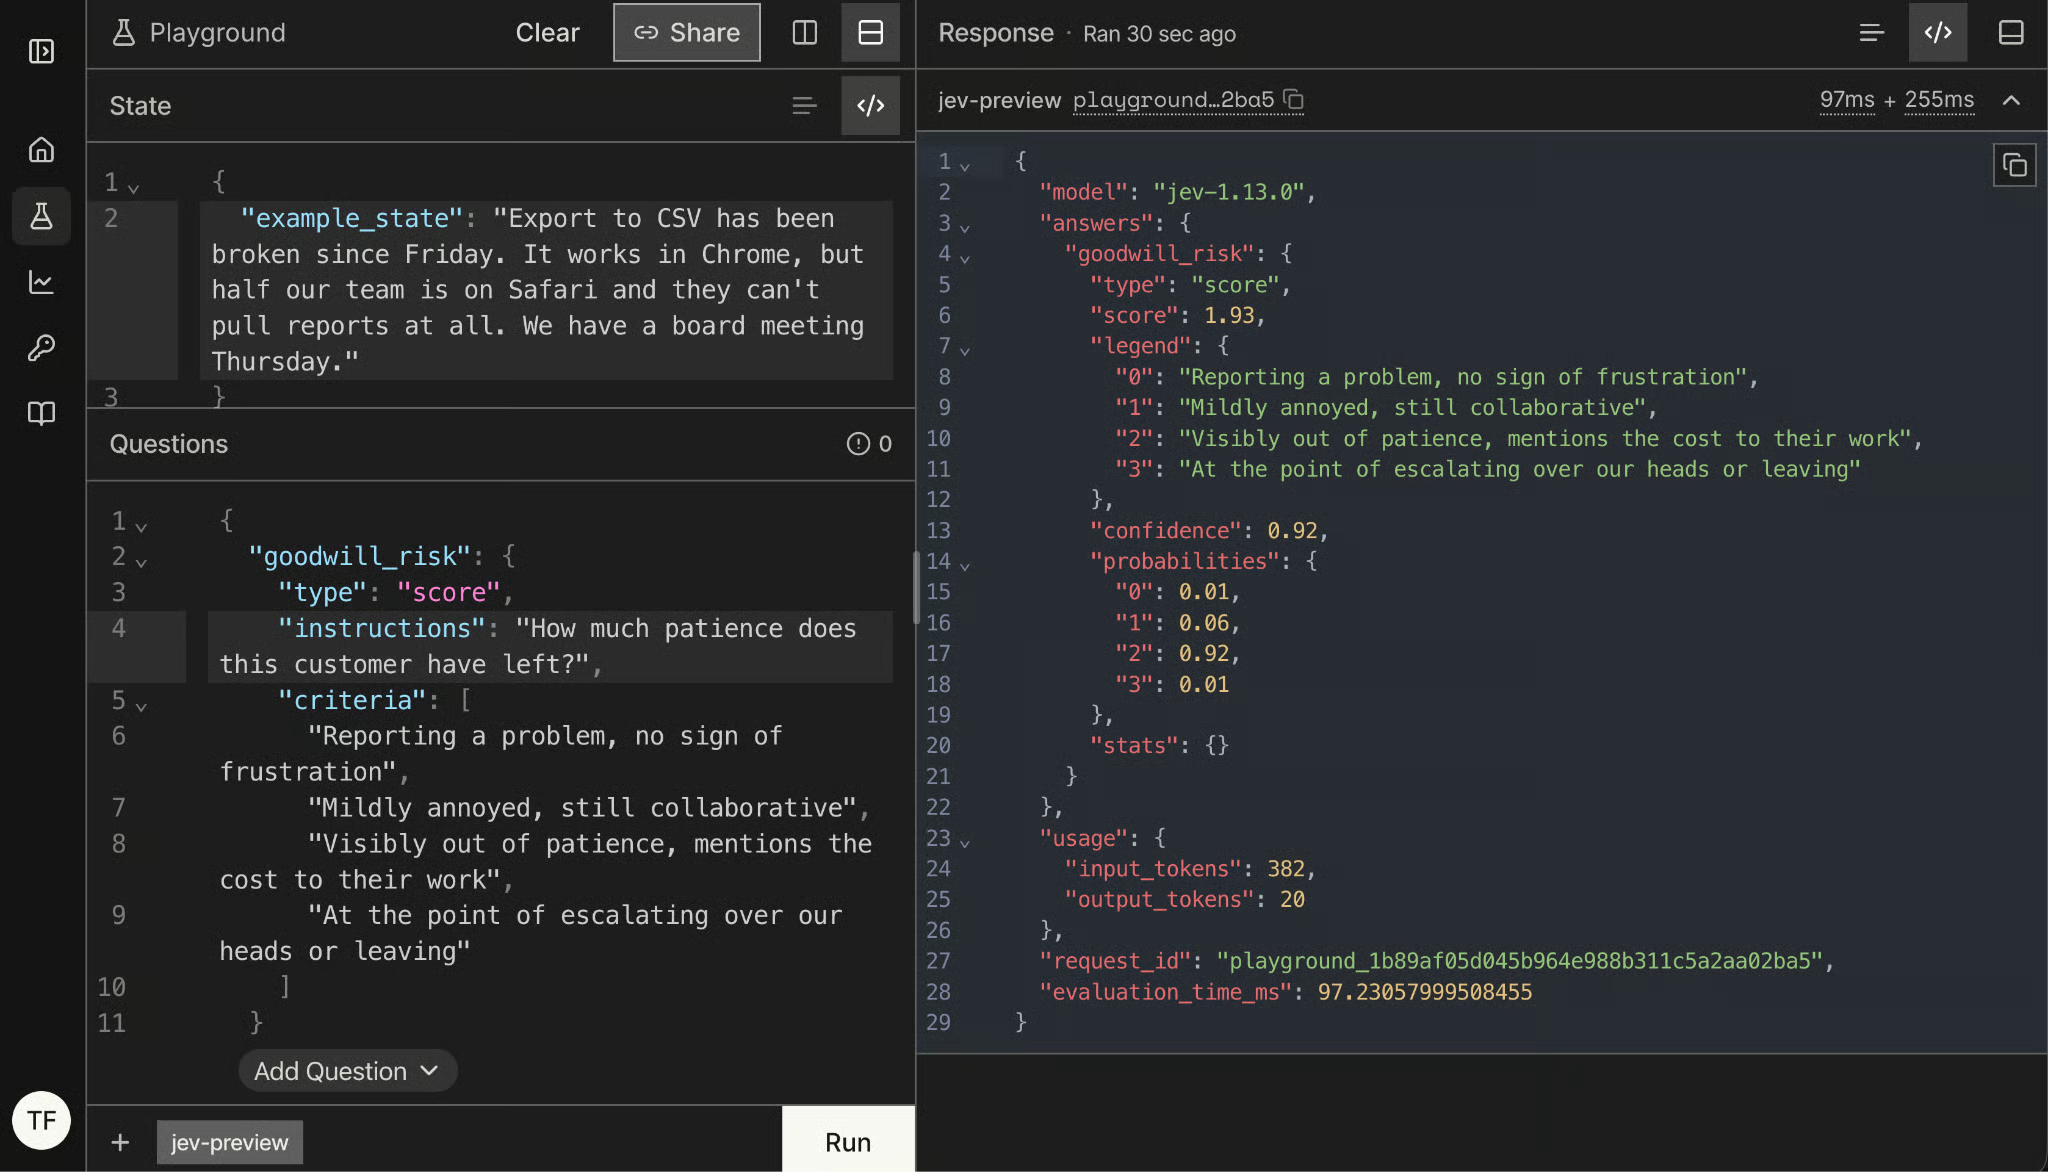
Scorul poate ajunge între nivelele tale, și acesta este chiar rostul legend. Un score de 1,93 aici înseamnă că modelul este împărțit între „ușor enervat” și „vizibil fără răbdare”, înclinând puternic spre a doua, ceea ce este o interpretare corectă a unui tichet care rămâne politicos în timp ce menționează un termen limită pe care îl va rata.
Din nou, citește distribuția probabilities mai degrabă decât doar numărul: probabilitate concentrată pe un nivel înseamnă un răspuns decis, probabilitate întinsă pe trei înseamnă că ai primit o medie în loc de o judecată.
Un Noul este tipul pentru întrebări binare, iar numele a fost inventat de TypeSafe. criteria este opțional aici, deși poți descrie ce înseamnă true și false, ceea ce merită făcut ori de câte ori „da” s-ar putea citi în două feluri.
Formulează întrebarea astfel încât o valoare mare să însemne da. Documentația TypeSafe e explicită în privința asta, iar un Noul al cărui true mapează către „nu” performează vizibil mai prost.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}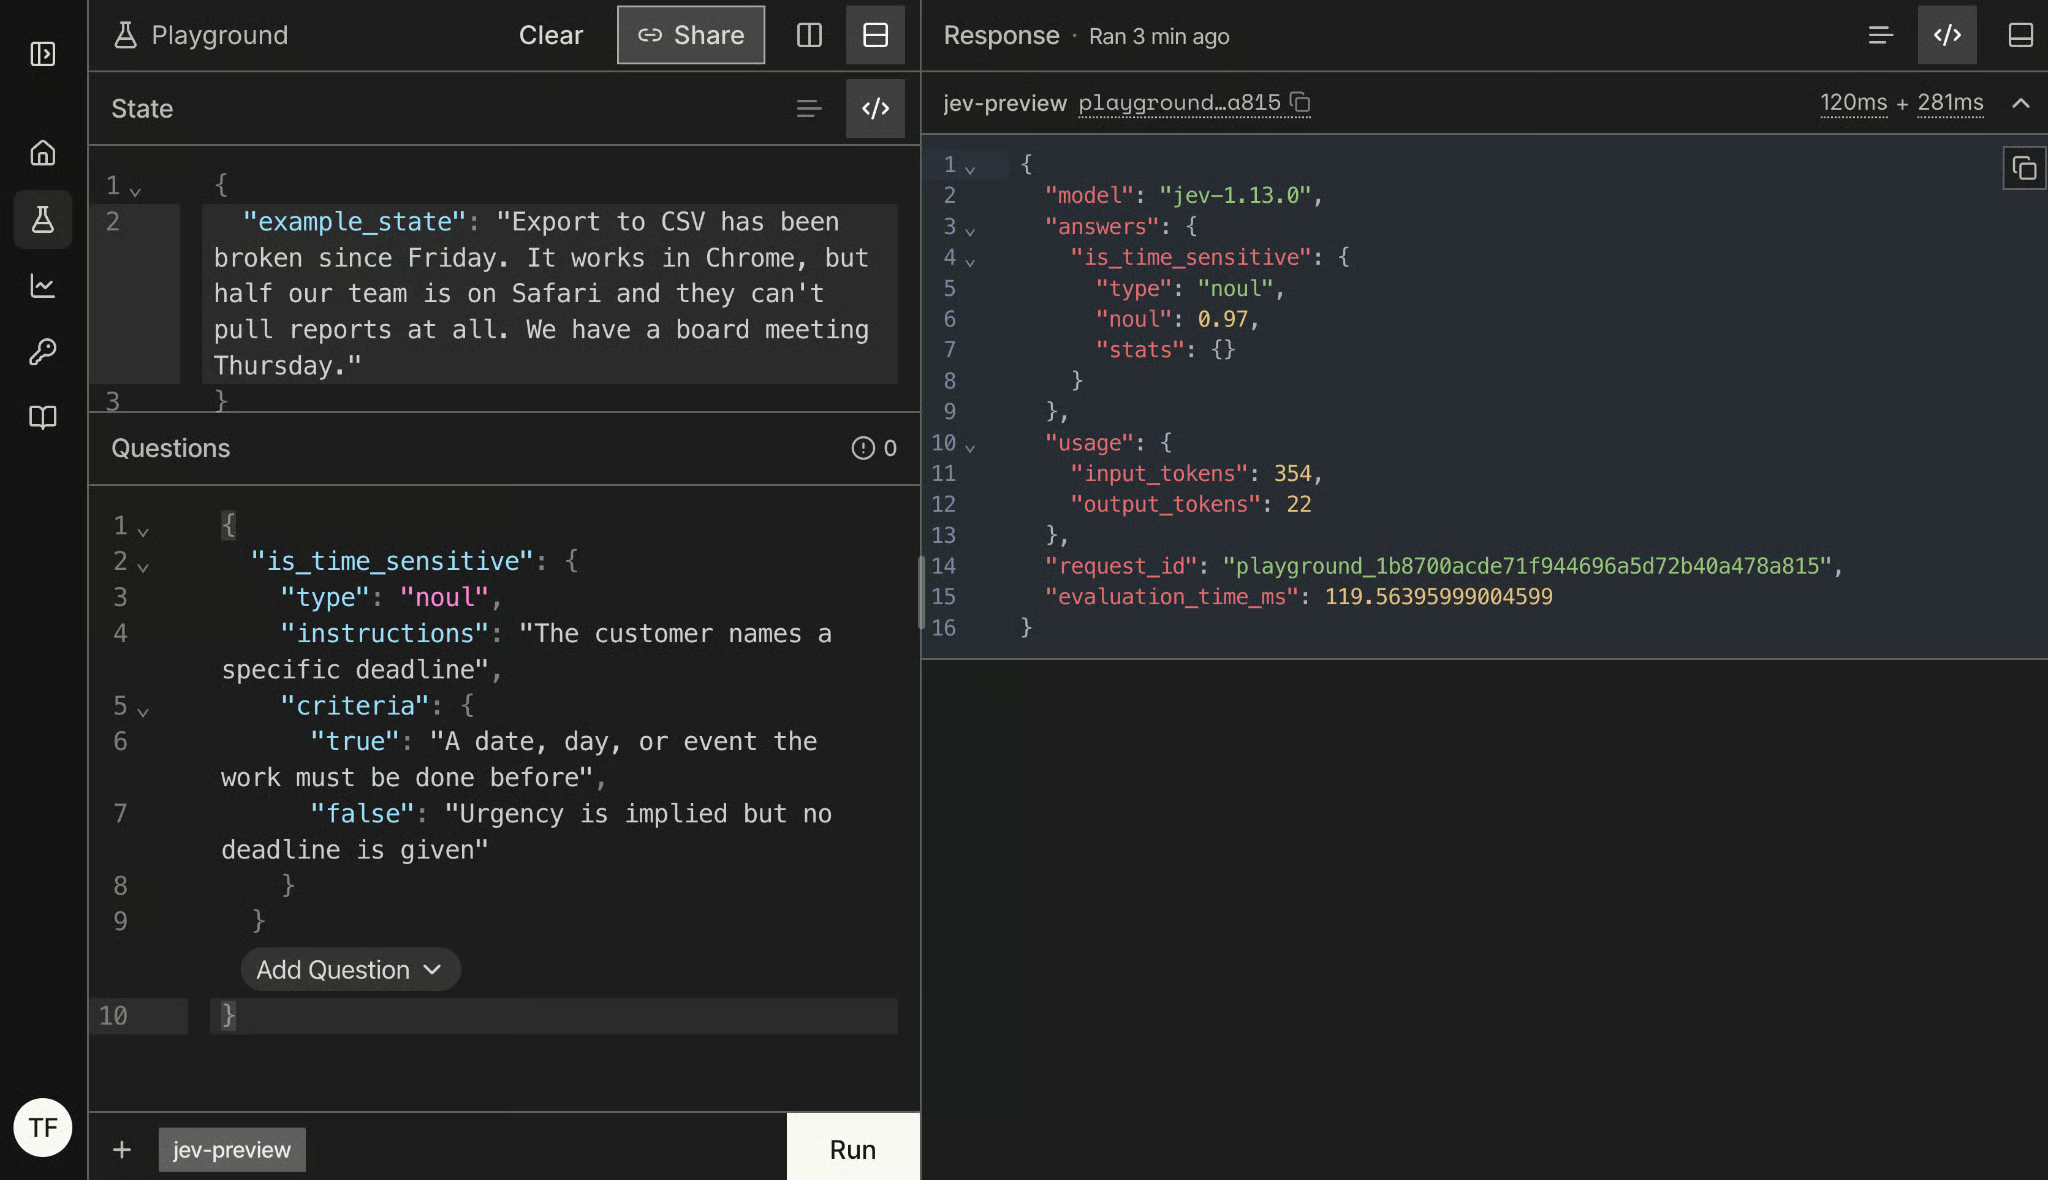
Deoarece în stare este menționată o ședință a consiliului joi, valoarea noul mare, de 0,97, era de așteptat.
Choice și Score întorc încredere alături de probabilități. Un Noul nu, iar asta îi încurcă pe oameni, deci merită să fim preciși de ce.
Încrederea și probabilitatea sunt axe separate. Pentru un Choice, probabilitățile spun cum își distribuie modelul convingerea între opțiunile tale, iar încrederea spune cât de ferm ține de acel răspuns, motiv pentru care un Choice poate întoarce o opțiune de top 0,85 cu o încredere de 0,78. Un Noul are doar două rezultate, deci probabilitatea unică deja poartă ambele: 0,97 e un da ferm, 0,03 e un nu ferm, iar 0,52 e modelul spunând că nu are idee.
Asta înseamnă că distanța față de 0,5 este semnalul tău de decizie, nu un câmp separat de citit. De asemenea, înseamnă că nu poți porta un prag de la un Noul la un Choice, și voi reveni la asta în secțiunea despre colțuri, pentru că doare mai tare decât sună.
Ca să urmărești, ai nevoie doar de Python 3.10+ și o cheie de early access de la TypeSafe.
Instalează SDK-ul:
pip install typesafe-sdkSau cu uv:
uv add typesafe-sdkApoi creează o cheie în consola TypeSafe și export-o. Clientul citește TYPESAFE_API_KEY din mediu, astfel încât să nu o treci niciodată în cod:
export TYPESAFE_API_KEY="your-key"Următoarele importuri îți oferă tot ce ai în playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul și Score sunt aceleași tipuri de întrebări prin care tocmai ai dat clic, ca obiecte Python.
TypeSafeClient este clientul sincron, iar există un AsyncTypeSafeClient cu aceeași interfață dacă apelezi Jev dintr-un serviciu async. Ambele funcționează ca manageri de context, ceea ce aș folosi în orice mai lung decât un script:
with TypeSafeClient() as client:
...Lăsat singur, clientul apelează jev-latest, care se mișcă ori de câte ori TypeSafe livrează o versiune nouă, ceea ce vom folosi pe tot parcursul tutorialului. Pentru orice unde ai calibrat deja un prag, fixează versiunea în schimb:
client = TypeSafeClient(model="jev-1.13.0")Răspunsul îți spune oricum ce model a răspuns efectiv și există o secțiune spre final despre de ce ar trebui să loghezi asta.
Pentru a face un apel API către Jev, trebuie să definești un element response folosind TypeSafeClient și funcția system_one(), care ia contextul întrebărilor tale ca parametru state și questions în același format ca în playground.
Putem crea un singur apel care răspunde la toate cele 3 întrebări din playground, deoarece împart aceeași state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Răspunsurile revin sub aceleași nume pe care le-ai ales pentru fiecare întrebare, detaliu care face întregul lucru plăcut de folosit:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Dacă primul tău apel eșuează cu un TypeError despre output_buffer_limit: e un mismatch de versiune în backend-ul de compresie al SDK-ului, nu în codul tău. SDK-ul livrează propriul client HTTP, httpx2, care decomprimă răspunsurile prin zstandard și brotli, iar o copie mai veche a uneia dintre ele nu are argumentul cu care e apelată. pip install -U typesafe-sdk httpx2 zstandard brotli a rezolvat la mine.
Două lucruri din acel output merită o pauză.
În primul rând, response.model a întors jev-1.13.0, nu jev-latest. Ai cerut aliasul în mișcare și Jev ți-a spus ce versiune a răspuns efectiv, ceea ce este singurul motiv pentru care logarea acelui câmp e suficient de ieftină ca să merite.
În al doilea rând, obiectele de răspuns sunt tipizate per tip de întrebare, așa că .choice, .score și .noul sunt atribute reale și editorul tău le cunoaște. Nu există niciun string JSON oriunde în acest cod, nimic de parsat și nicio ramură pentru apelul care s-a întors stricat. Dacă preferi gruparea, SDK-ul expune și response.choices, response.scores și response.nouls, indexate la fel.
Verifică și response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Tokenii de output au o singură cifră și sunt gratuiți. Plătești pentru stare și întrebări, așa că poți controla complet levierul de cost decizând cât context trimiți. Asta contează mai mult decât pare și revine în secțiunea despre colțuri: o stare umflată te costă bani și acuratețe în același timp.
Acesta este unul dintre cazurile de utilizare pentru care e construit Jev. Sosește un tichet de suport și ceva trebuie să decidă în ce coadă merge, dacă ar trebui să-l vadă mai întâi un om și cât de repede. Fiecare dintre acestea este o judecată cu un spațiu de răspuns pe care îl poți scrie înainte să sosească tichetul.
Regula de design care merită spusă din start: Jev decide ce este, codul tău decide ce se întâmplă. Jev nu rutează nimic. Întoarce numere, iar rutarea trăiește într-o funcție obișnuită pe care o poți citi, testa și schimba fără să atingi modelul.
Întrebările dintr-o singură cerere sunt evaluate în paralel, deci o a șasea întrebare te costă tokenii în care e scrisă și aproape deloc latență în plus. Asta îți schimbă felul în care întrebi. Cu un LLM, ai grupa cu grijă ca să economisești timp de round-trip, dar aici întrebi tot ce ți-ar putea trebui despre un anumit context, inclusiv întrebări pe care probabil le vei ignora.
Să extindem întrebările noastre anterioare cu încă trei Noul care ne oferă informații importante despre cum să tratăm tichetul:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Șase întrebări, toate răspunse într-un apel și o singură factură. is_automated este cea speculativă: e falsă pe aproape orice tichet real și merită s-o întrebi oricum, pentru că singura dată când e adevărată, salvează o persoană de la a deschide un mailer daemon bounce.
Două obiceiuri pe care le-aș adopta aici.
Păstrează setul de întrebări ca o constantă la nivel de modul, nu îl construi inline, pentru că este lucrul pe care îl vei versiona alături de pragurile tale.
Și denumește întrebările după ce măsoară, nu după ce vei face cu răspunsul, deoarece is_time_sensitive supraviețuiește unei schimbări de politică, iar route_to_incident nu.
Întrebări formulate pozitiv: Am fi putut numi is_automated și ceva de genul needs_no_reply, dar conform TypeSafe, performanța pentru întrebările formulate pozitiv este mai bună.
Acum partea pe care Jev nu o face. Fiecare răspuns sosește fie cu o valoare de încredere, fie cu o probabilitate, iar acel al doilea număr este ceea ce îți permite să construiești trei căi în loc de două:
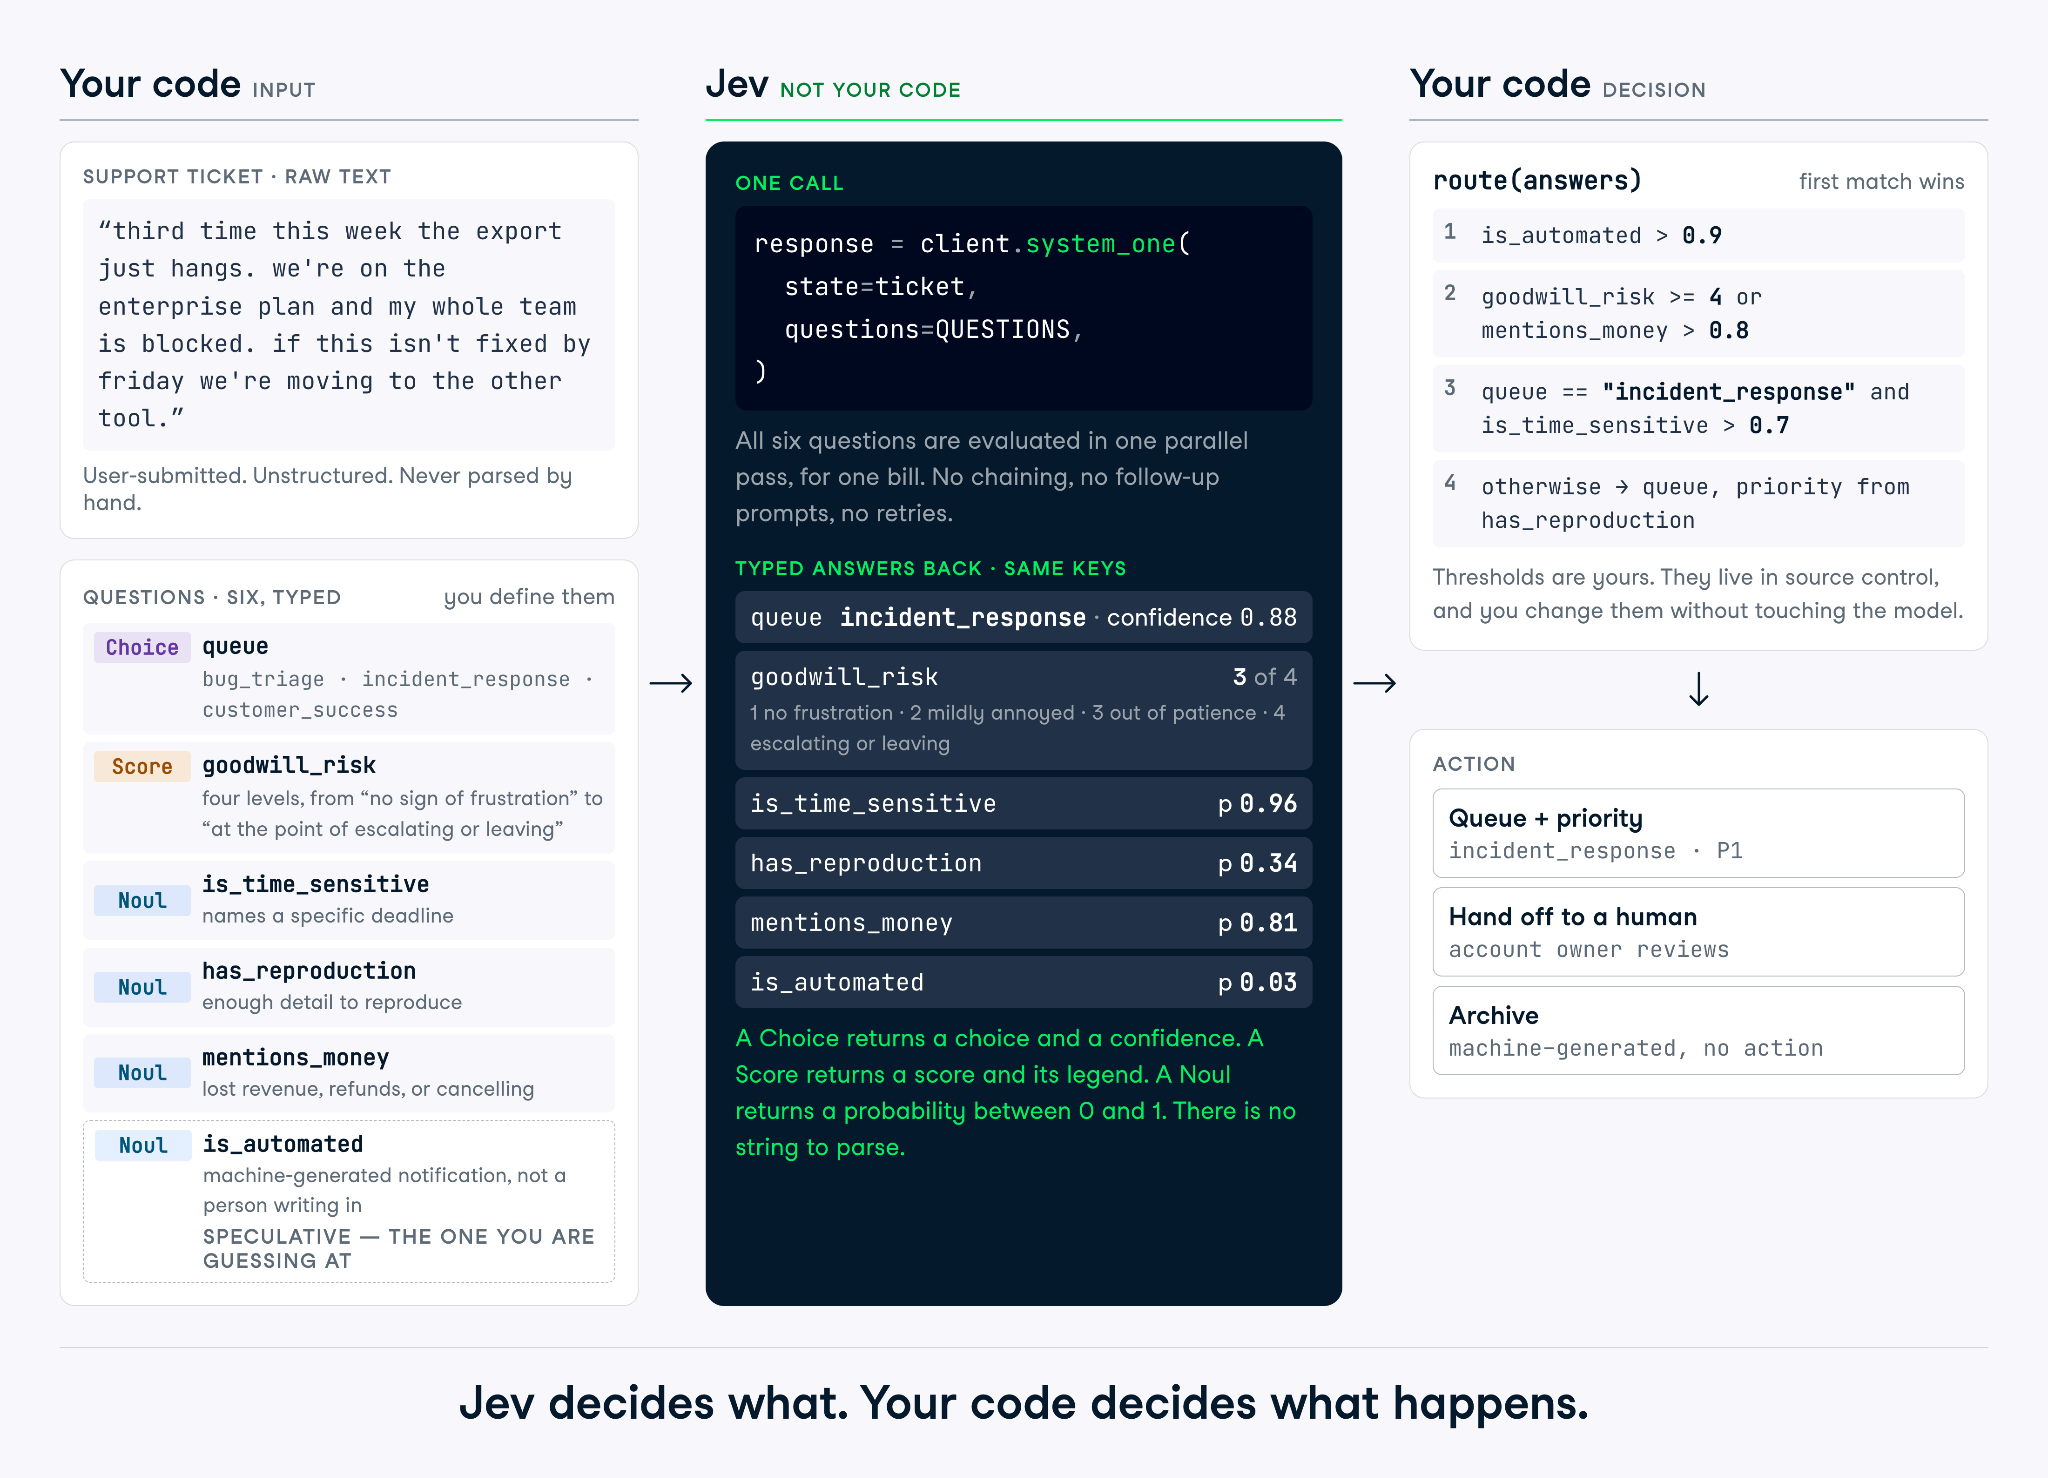
Să transformăm asta în câteva reguli pentru rutarea tichetelor:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Citește ce face acea funcție. Modelul a furnizat șase judecăți, iar politica a decis că una dintre ele, mentions_money intersectată cu un client frustrat, are prioritate față de coada pe care a ales-o Jev. Acea suprascriere este o decizie de business, aparține codului și o poți schimba într-o vineri după-amiază fără să retestezi un model.
has_reproduction nu este folosit niciodată. L-am lăsat intenționat, pentru că așa arată în practică modelul de fan-out: ceri mai mult decât consumă politica actuală, loghezi totul, iar când cineva întreabă dacă tichetele de bug_triage fără pași de reproducere durează mai mult până la închidere, ai deja șase săptămâni de răspuns.
Pragurile de mai sus sunt doar exemple. A le găsi pe cele potrivite ține de calibrare, iar la final este o secțiune despre cum să le setezi cu date, nu după vibe-uri.
Poți accesa scriptul complet din acest repo GitHub însoțitor. Când am rulat scriptul Python cu scenariul nostru, judecata a fost să ruteze tichetul la echipa de incident response astăzi.
python routing.py('incident_response', 'today')TypeSafe publică o pagină de „jaggedness” per versiune de model, listând modurile de eșec cunoscute. Mi-aș dori ca mai multe laboratoare să facă asta. Citește-o înainte să construiești orice și recitește-o când faci upgrade, pentru că lista e versiunea-tă și marginile se mișcă.
Iată cele cinci care mi-ar fi costat cel mai mult timp.
Nu poți porta un prag între tipuri de întrebări. Exemplul propriu al TypeSafe întreabă „Clientul cere o rambursare?” în ambele moduri pe același tichet: Noul întoarce 0,22, Choice-ul da/nu întoarce 0,01 pentru da, cu încredere 0,97. Aceeași întrebare, două numere, două ordine de mărime diferite.
Negațiile nu cooperează nici ele. Un Noul și opusul său s-au întors la 0,72 și 0,47, care însumează 1,19.
Motivul este că cele două tipuri întreabă lucruri diferite. Un Choice este relativ și stabilește care opțiune câștigă, pe când fiecare Noul este absolut și poate fi mic pentru toate. Calibrează praguri per întrebare, în forma în care o vei livra, și nu presupune niciodată că P(yes) și 1 - P(no) sunt același număr.
Nivelele unui Score sunt ordonate, nu spațiate egal. Un 1,6 îți spune că modelul stă între al doilea și al treilea nivel, înclinând spre al treilea, și atât.
Ce nu poți face este să interpolezi o cantitate reală din el. Dacă nivelele tale sunt „sub o oră”, „câteva ore” și „o zi”, un 1,5 nu înseamnă cinci ore. Folosește scorul pentru a testa un prag, apoi păstrează fiecare număr real în cod.
Jev tratează starea ca date, dar nu este întărit împotriva codului scris în stare pentru a-l devia. O instrucțiune injectată, un framing înșelător sau text care pledează pentru propria clasificare pot deplasa răspunsul, iar TypeSafe spune că se așteaptă să îmbunătățească aici. Dacă suprafața de atac îți este nouă, acoperim cazul general în ghidul nostru despre prompt injection.
Contează cel mai mult acolo unde starea este trimisă de utilizator, ceea ce, pentru un router de tichete, e întotdeauna. Scrie criterii suficient de precise încât afirmațiile tichetului despre sine să nu decidă rezultatul și testează cu inputuri ostile înainte să rutezi ceva automat.
Numărarea este nesigură și se înrăutățește pe măsură ce crește obiectul numărării, pentru că modelul recunoaște forma unui răspuns în loc să numere. Datele sunt citite ca text, deci ordonarea, distanța și ferestrele eșuează. Codificările numerice performează mai slab decât echivalentele lor semantice, așa că întreabă despre „roșu” mai degrabă decât #FF0000.
Remediul este același în toate trei cazurile: împarte munca.
Dacă ai nevoie de un count, iterează în cod și pune câte un Noul per element:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Trei aspecte mai mici care au aceeași cauză. Jev răspunde la întrebarea pe care ai scris-o, nu la cea pe care ai intenționat-o, deci cuvintele de scope și negațiile sunt citite ad litteram. Dublele negații și întrebările despre o proprietate a unei proprietăți costă acuratețe. Iar o stare mare, umflată cu detalii irelevante, costă atât acuratețe cât și bani, deoarece materialul fără legătură acționează ca un distractor.
Semnul pentru primul: când te uiți la un răspuns greșit și te surprinzi explicând ce ai vrut de fapt să spui, acea explicație este jumătatea lipsă din instrucțiunea ta.
Pe baza a ceea ce am învățat deja, iată câteva bune practici pentru a profita la maximum de Jev.
Scrie condiția, nu intenția. Dacă explici ce ai vrut să spui când revezi un răspuns greșit, acea explicație aparține instrucțiunilor. Ce înseamnă asta:
jev-latest se mișcă. Fixează versiunea odată ce un prag depinde de comportamentul modelului:
client = TypeSafeClient(model="jev-1.13.0")Loghează response.model alături de răspunsurile complete la fiecare apel, nu doar valoarea pe care ai acționat. Când un prag începe să se comporte ciudat, acel log este singura modalitate de a deosebi o schimbare de model de o derivă în tichetele tale.
În cele din urmă, pragurile nu sunt date din oficiu, ci rezultatul experimentării.
Jev este un instrument îngust, și asta este de fapt ideea. Răspunde la întrebări ale căror răspunsuri le poți enumera, suficient de ieftin încât să nu le mai raționalizezi, și pasează decizia înapoi codului tău.
Aș contrazice framingul „nu poate halucina”. E adevărat într-un sens îngust că modelul nu poate răspunde off-schema, dar asta nu spune nimic despre dacă răspunsul este corect. Un Choice întoarce mereu o coadă validă. Poate fi totuși coada greșită la 0,9 încredere, iar outputul tipizat face acel eșec mai tăcut.
Ca să-l testezi pentru munca ta. Îți sugerez să găsești o decizie pe care codul tău o ia cu o regulă fragilă sau cu un apel LLM lent și să încerci să scrii răspunsurile valide. Dacă poți, e în formă de Jev. Dacă nu poți, niciun fel de „engineering” al întrebării nu va schimba asta.
Dacă vrei să începi să construiești sisteme care folosesc AI, îți recomand cu căldură să te înscrii în Associate AI Engineer for Developers career track. Te învață cum să lucrezi cu OpenAI API, MCP, LangChain și multe altele.
Învață AI Engineering cu DataCamp!
track
course
course