
programa
Associate AI Engineer para desarrolladores
26 h
Ya lo mencioné: las expectativas deben encajar con el modelo. En Jev esto es especialmente cierto, y tiene mucho que ver con su clase de modelo, a la que se denomina modelos System One.
Un modelo System One devuelve decisiones tipadas en lugar de texto. Le envías un bloque de estado más un conjunto de preguntas, cada una con un espacio de respuestas que defines, y el modelo devuelve una respuesta por pregunta con probabilidades asociadas. No se produce nada token a token, así que no hay cadenas que parsear ni JSON malformado que reparar. TypeSafe acuñó este término en referencia a la famosa división de Daniel Kahneman:
Como el espacio de respuesta es un esquema que declara tu código, por diseño los modelos System One nunca pueden devolver una categoría que no hayas definido. Esto significa que nunca se salen del esquema. Dicho esto, pueden equivocarse, y veremos algunos casos delicados más adelante.
TypeSafe salió del modo stealth el 15 de septiembre de 2026 con Jev en early access, reportando respuestas de 70 a 500 ms y 0,042 $ por millón de tokens de entrada con la salida gratuita. En su propio benchmark de cuatro flujos, Jev ronda el 68% de acierto: territorio de LLM de gama media a una fracción del coste.
Para más información sobre funciones y rendimiento en benchmarks, te recomiendo leer nuestra guía de Jev.
Escribe las respuestas válidas antes de hacer la llamada. Si puedes enumerarlas, tienes un problema con forma de Jev:
Recurre a un LLM cuando la salida sea prosa o código, cuando el espacio de respuestas sea abierto o cuando la tarea requiera varios saltos de razonamiento encadenados. Jev también es la herramienta equivocada para cualquier cosa numérica, y luego volveré a por qué.
Antes de escribir una sola línea de código, crea una cuenta en TypeSafe y abre el Playground. Aquí puedes pegar texto como estado, añadir preguntas y ver los objetos de respuesta completos sin instalar nada. Es la forma más rápida de entender qué devuelve cada tipo de pregunta (y de descubrir si has redactado mal la pregunta).
Usaré un ticket de soporte como estado para los tres ejemplos:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Cada tipo de pregunta recibe instructions, la pregunta en lenguaje natural que quieres responder. Lo que cambia entre tipos es criteria y lo que vuelve.
Una Choice elige una opción de un conjunto que defines tú.
Pasas criteria como un diccionario que mapea cada opción a una descripción, de 1 a 255, y la respuesta vuelve con:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Para ver la salida de código que también recibirías vía API, haz clic en el botón </> arriba a la derecha y pulsa Run para que Jev responda.
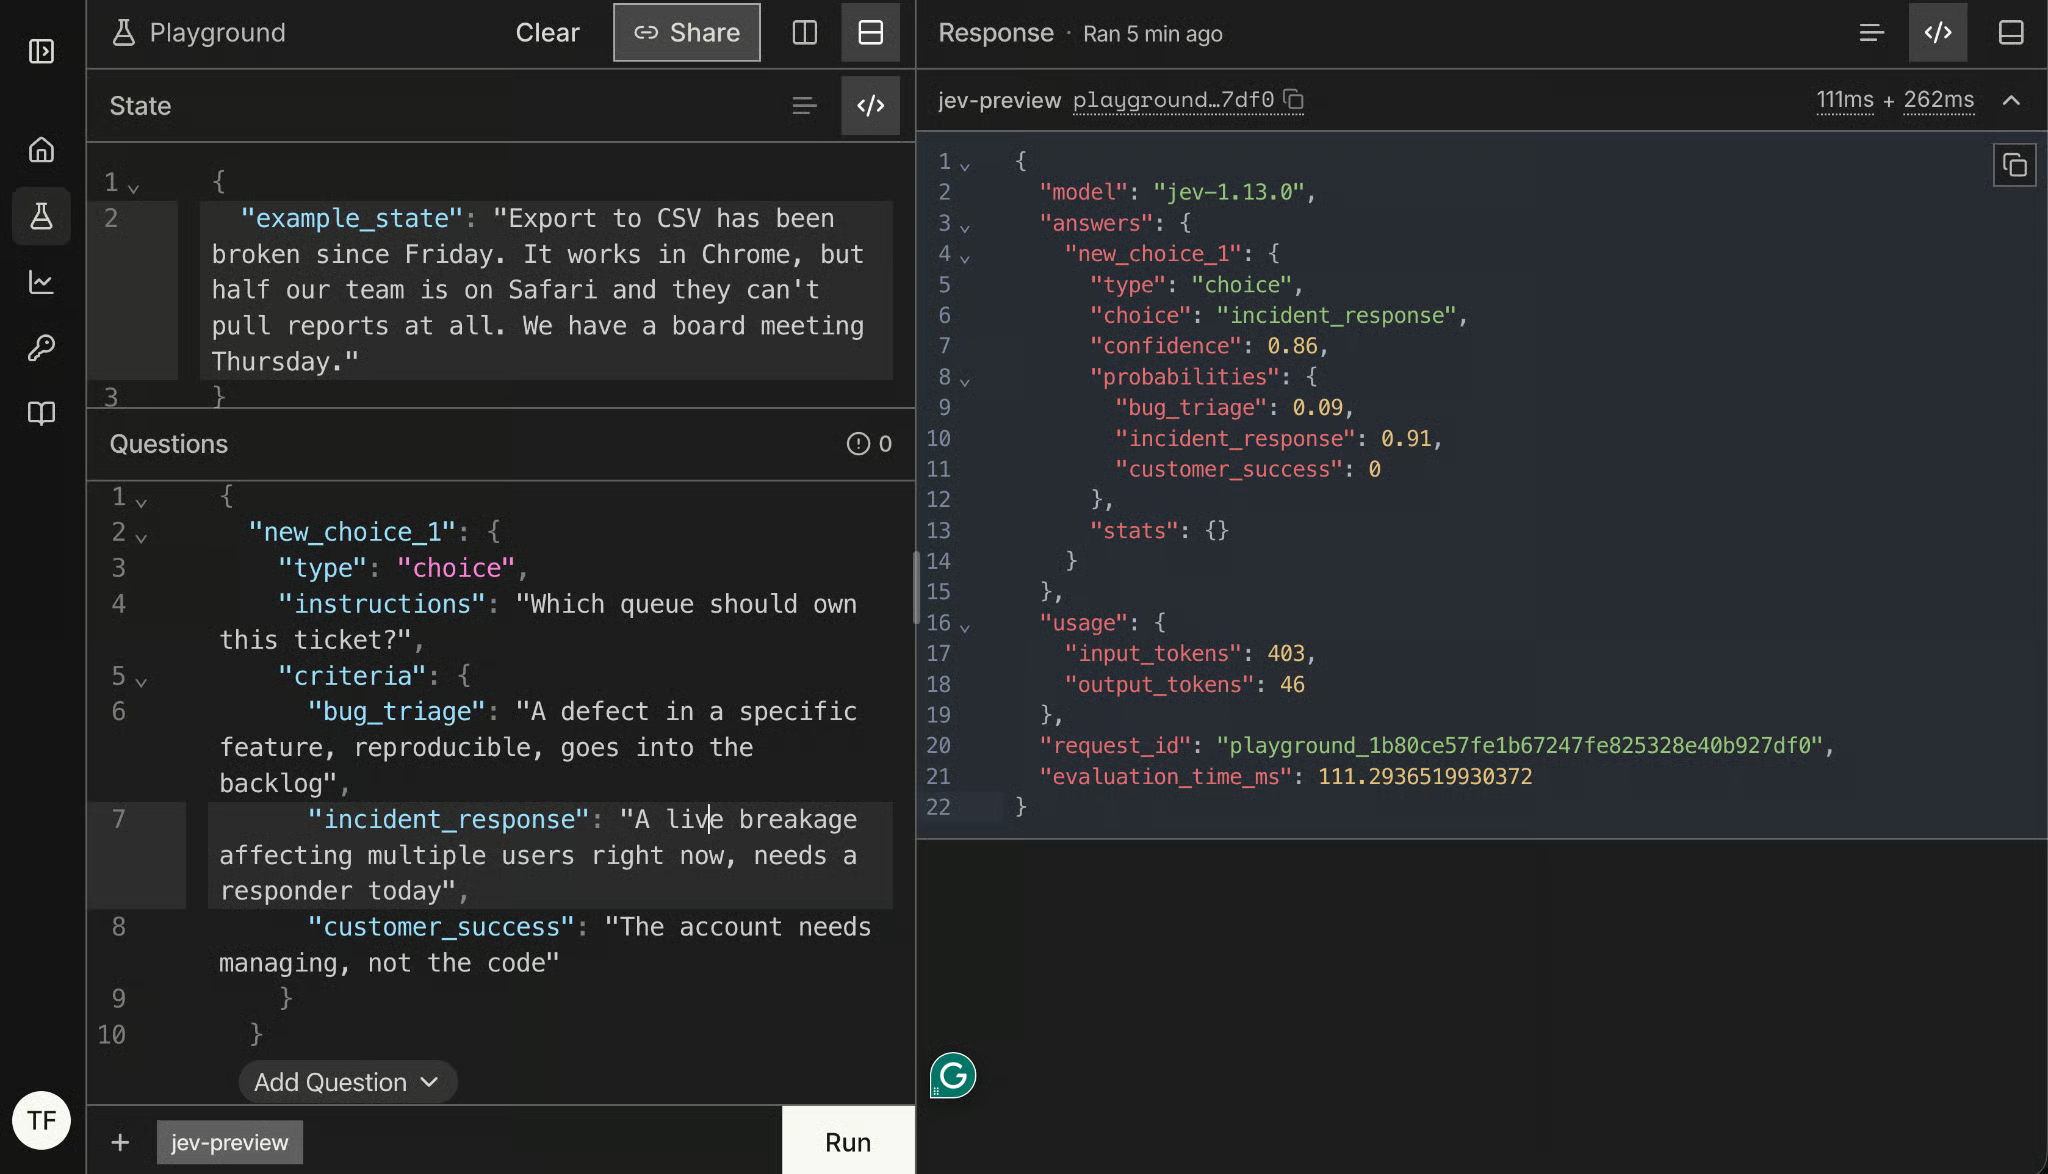
En este caso, incident_response es la choice con un 91% de probabilidad. La confidence de Jev para esa elección es del 86%.
La distribución completa es la parte a la que debes prestar atención.
choice solo te dice qué opción ganó.
probabilities te dice por cuánto.
Son piezas diferentes de información cuando estás a punto de enrutar un ticket automáticamente. Un reparto 0,41/0,38/0,21 y el 0,91/0,09/0 que recibimos pueden devolver la misma choice.
Score valora el estado frente a niveles ordenados. Pasas criteria como un array de 2 a 10 descripciones de nivel, de menor a mayor, y la respuesta incluye una puntuación, una legend que mapea cada posición a tu descripción, una probabilidad por nivel y la confianza.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}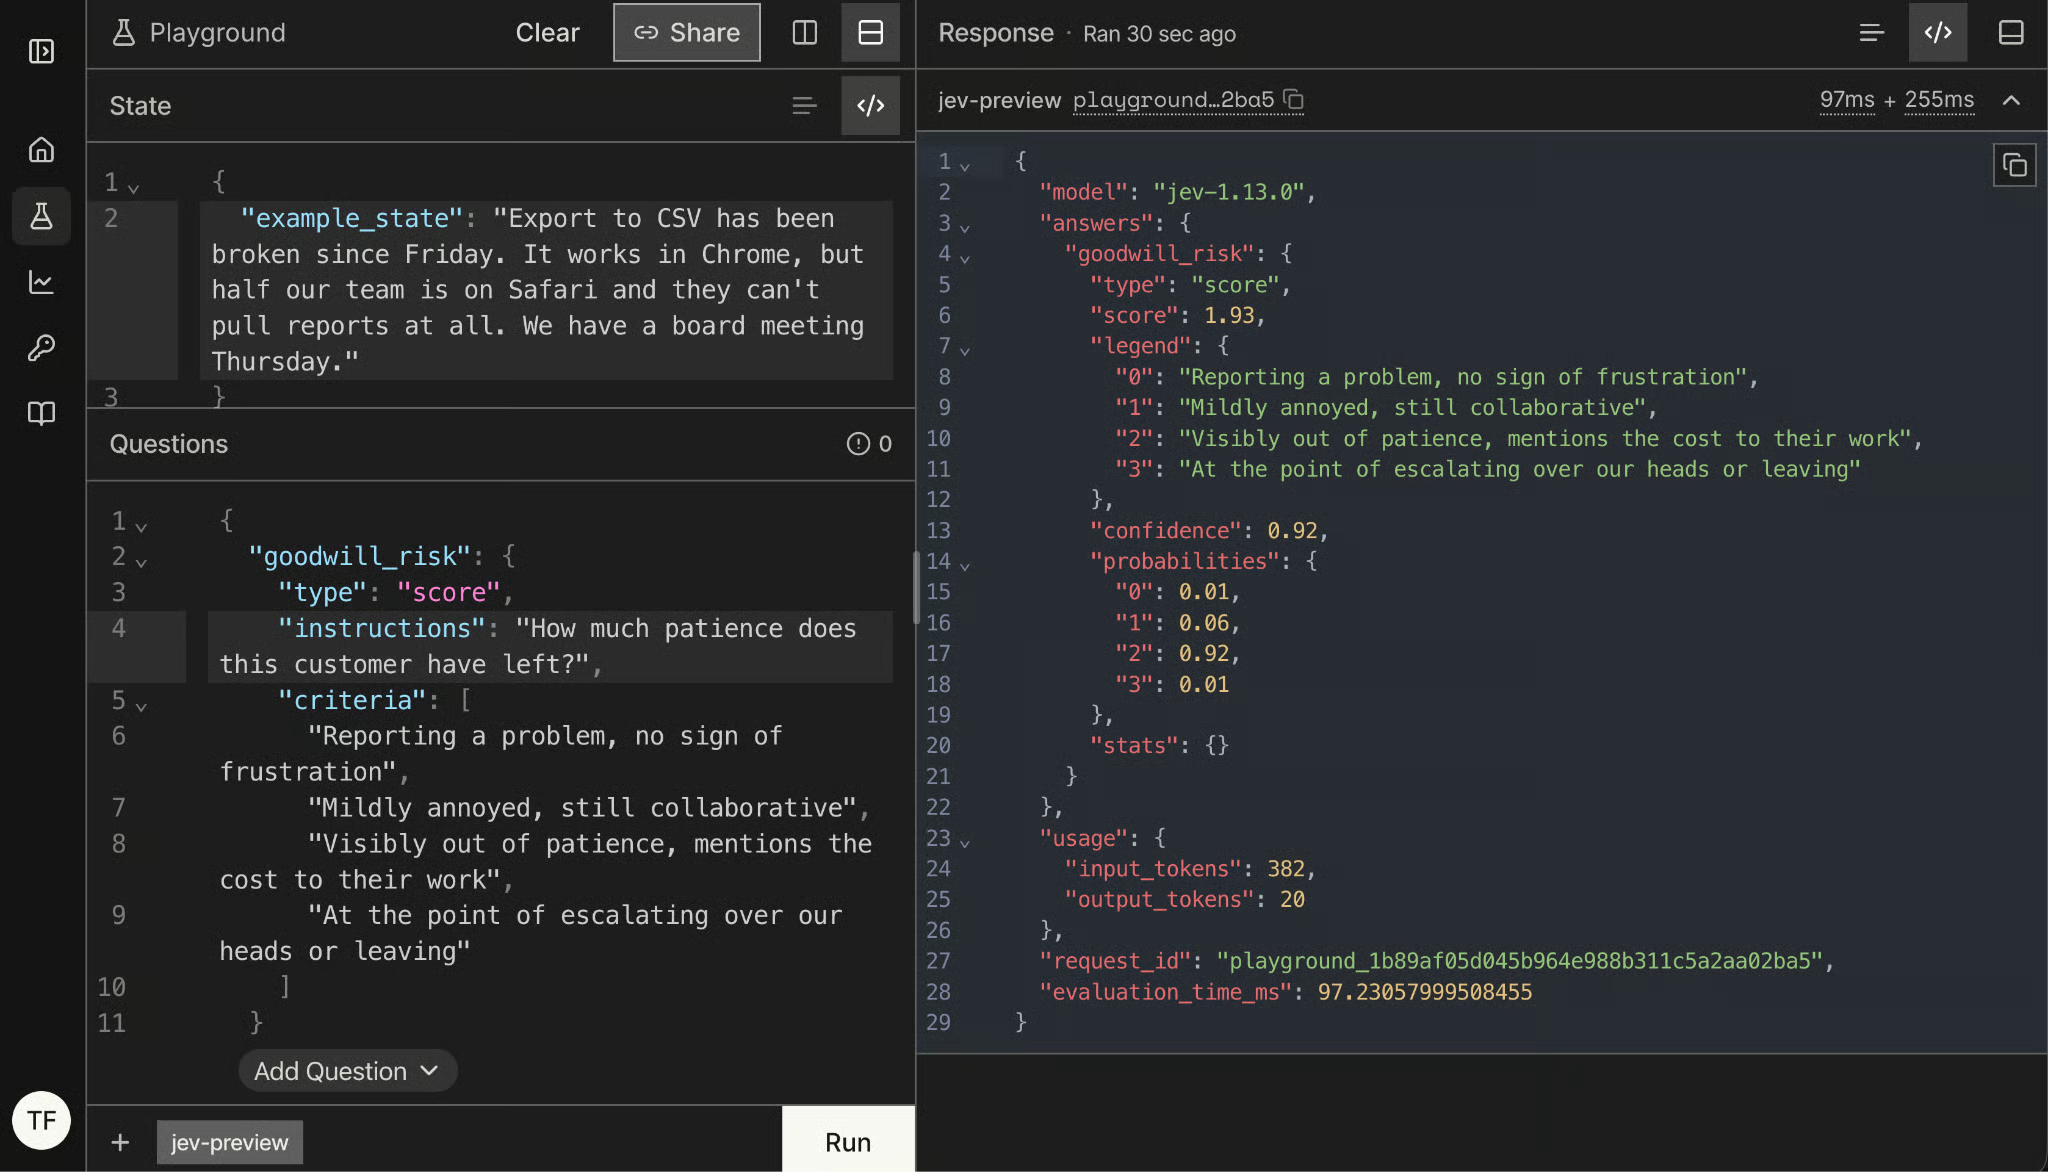
La puntuación puede caer entre tus niveles, y para eso está la legend. Un score de 1,93 aquí significa que el modelo está entre "algo molesto" y "sin paciencia", inclinándose claramente por lo segundo, que es una lectura razonable de un ticket que mantiene las formas pero menciona un plazo que va a incumplir.
De nuevo, mira la distribución de probabilities más que el número suelto: probabilidad concentrada en un nivel implica respuesta decidida; probabilidad repartida en tres implica que has recibido un promedio, no un juicio.
Noul es el tipo para preguntas binarias, y su nombre lo acuñó TypeSafe. Aquí criteria es opcional, aunque puedes describir qué significan true y false, lo cual conviene hacer siempre que "sí" pueda leerse de dos maneras.
Formula la pregunta de modo que un valor alto signifique sí. La documentación de TypeSafe es explícita al respecto, y un Noul cuyo true mapea a "no" rinde visiblemente peor.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}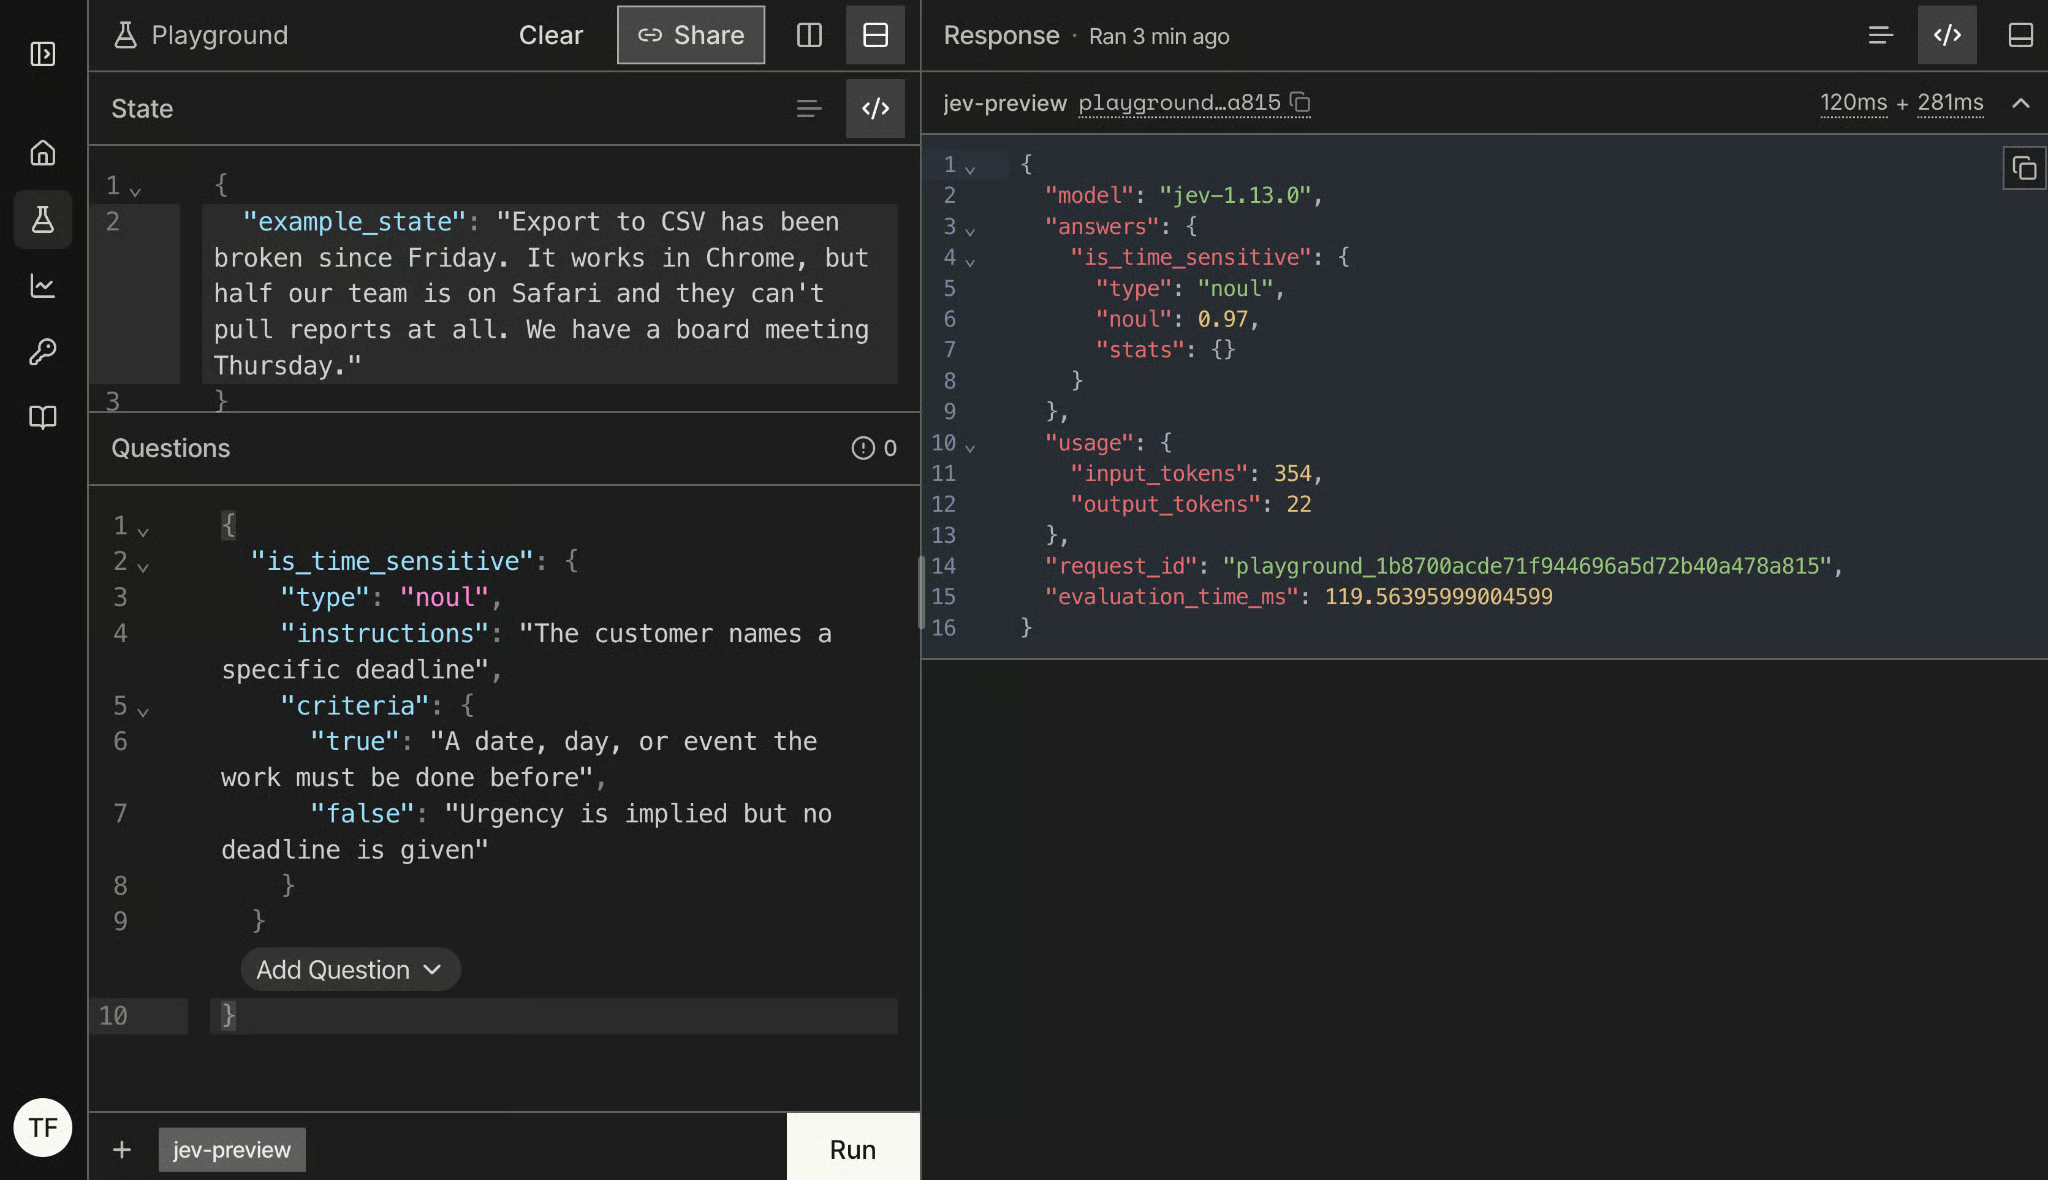
Como en el estado se menciona una reunión del consejo el jueves, era de esperar el noul alto de 0,97.
Choice y Score devuelven confianza junto a sus probabilidades. Noul no lo hace, y eso confunde, así que vale la pena ser precisos.
Confianza y probabilidad son ejes distintos. En Choice, probabilities dice cómo reparte el modelo su creencia entre tus opciones, y confidence dice cuán firme es esa respuesta, por eso una Choice puede devolver una opción superior de 0,85 con una confianza de 0,78. Un Noul solo tiene dos resultados, así que la probabilidad única ya lleva ambas cosas: 0,97 es un sí firme, 0,03 es un no firme, y 0,52 es el modelo diciéndote que no tiene ni idea.
Eso significa que la distancia a 0,5 es tu señal de determinación, no un campo aparte. También significa que no puedes trasladar un umbral de un Noul a una Choice, y volveré a esto en la sección de cantos vivos, porque muerde más de lo que parece.
Para seguir el tutorial, solo necesitas Python 3.10+ y una clave de acceso anticipado de TypeSafe.
Instala el SDK:
pip install typesafe-sdkO con uv:
uv add typesafe-sdkCrea una clave en la consola de TypeSafe y expórtala. El cliente lee TYPESAFE_API_KEY del entorno, así que nunca la pasas en el código:
export TYPESAFE_API_KEY="your-key"Las siguientes importaciones te dan todo lo que viste en el playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul y Score son los mismos tipos de preguntas por los que acabas de hacer clic, como objetos de Python.
TypeSafeClient es el cliente sincrónico, y hay un AsyncTypeSafeClient con la misma interfaz si llamas a Jev desde un servicio async. Ambos funcionan como context managers, que es lo que usaría en cualquier cosa más larga que un script:
with TypeSafeClient() as client:
...Si no indicas nada, el cliente llama a jev-latest, que avanza cada vez que TypeSafe publica una versión nueva, que es lo que usaremos durante el tutorial. Para cualquier cosa en la que ya hayas ajustado un umbral, fija la versión:
client = TypeSafeClient(model="jev-1.13.0")La respuesta te dice qué modelo respondió realmente en cualquier caso, y al final hay una sección sobre por qué deberías registrarlo en logs.
Para llamar a la API de Jev, defines un elemento response usando TypeSafeClient y la función system_one(), que toma el contexto de tus preguntas como parámetro state y las propias questions en el mismo formato que en el playground.
Podemos crear una única llamada que responda a nuestras 3 preguntas del playground, ya que comparten el mismo state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Las respuestas vuelven bajo los mismos nombres que elegiste para cada pregunta, el detalle que hace que trabajar con esto sea agradable:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Si tu primera llamada falla con un TypeError sobre output_buffer_limit: es un desajuste de versión en el backend de compresión del SDK, no tu código. El SDK incluye su propio cliente HTTP, httpx2, que descomprime respuestas mediante zstandard y brotli, y a una copia antigua de cualquiera de ellos le falta el argumento con el que se le llama. pip install -U typesafe-sdk httpx2 zstandard brotli me lo solucionó.
Hay dos cosas en esa salida en las que merece la pena detenerse.
Primero, response.model devolvió jev-1.13.0, no jev-latest. Pediste el alias móvil y Jev te dijo qué versión respondió realmente, que es la única razón por la que registrar ese campo es tan barato que compensa hacerlo.
Segundo, los objetos de respuesta están tipados por tipo de pregunta, así que .choice, .score y .noul son atributos reales y tu editor los conoce. No hay ninguna cadena JSON en este código, nada que parsear y ninguna rama para la llamada que vuelva malformada. Si prefieres agrupar, el SDK también expone response.choices, response.scores y response.nouls, con las mismas claves.
Consulta también response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Los tokens de salida son de un dígito y gratuitos. Pagas por el estado y las preguntas, así que puedes controlar completamente el coste decidiendo cuánta información de contexto envías. Eso importa más de lo que parece y vuelve a salir en la sección de cantos vivos: un estado inflado te cuesta dinero y precisión a la vez.
Este es uno de los casos de uso para los que Jev está hecho. Llega un ticket de soporte, y algo tiene que decidir a qué cola va, si una persona debe mirarlo antes y con qué rapidez. Cada una de esas es un juicio con un espacio de respuestas que puedes escribir antes de que llegue el ticket.
La regla de diseño que conviene dejar clara desde el principio: Jev decide qué es, tu código decide qué pasa. Jev nunca enruta nada. Devuelve números, y el enrutamiento vive en una función normal que puedes leer, probar y cambiar sin tocar el modelo.
Las preguntas en una misma petición se evalúan en paralelo, así que una sexta pregunta te cuesta los tokens en los que está escrita y casi no añade latencia. Eso cambia cómo preguntas. Con un LLM, agruparías cuidadosamente para ahorrar idas y vueltas, pero aquí preguntas todo lo que podrías querer sobre un cierto contexto, incluidas preguntas que probablemente ignores.
Ampliemos nuestras preguntas anteriores con tres Nouls más que nos dan información clave sobre cómo manejar el ticket:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Seis preguntas, todas respondidas en una llamada y una factura. is_automated es la especulativa: es falsa en casi cualquier ticket real, y aun así compensa preguntar porque la única vez que sea verdadera, ahorra que una persona abra un rebote de mailer daemon.
Dos hábitos que adoptaría aquí.
Mantén el conjunto de preguntas como una constante a nivel de módulo en lugar de construirlo inline, porque es lo que versionarás junto a tus umbrales.
Y nombra las preguntas por lo que miden, no por lo que harás con la respuesta, ya que is_time_sensitive sobrevive a un cambio de política y route_to_incident no.
Preguntas formuladas en positivo: podríamos haber llamado a is_automated algo como needs_no_reply, pero según TypeSafe, el rendimiento es mejor con formulaciones positivas.
Ahora la parte que Jev no hace. Cada respuesta llega con un valor de confianza o una probabilidad, y ese segundo número es el que te permite construir tres caminos en lugar de dos:
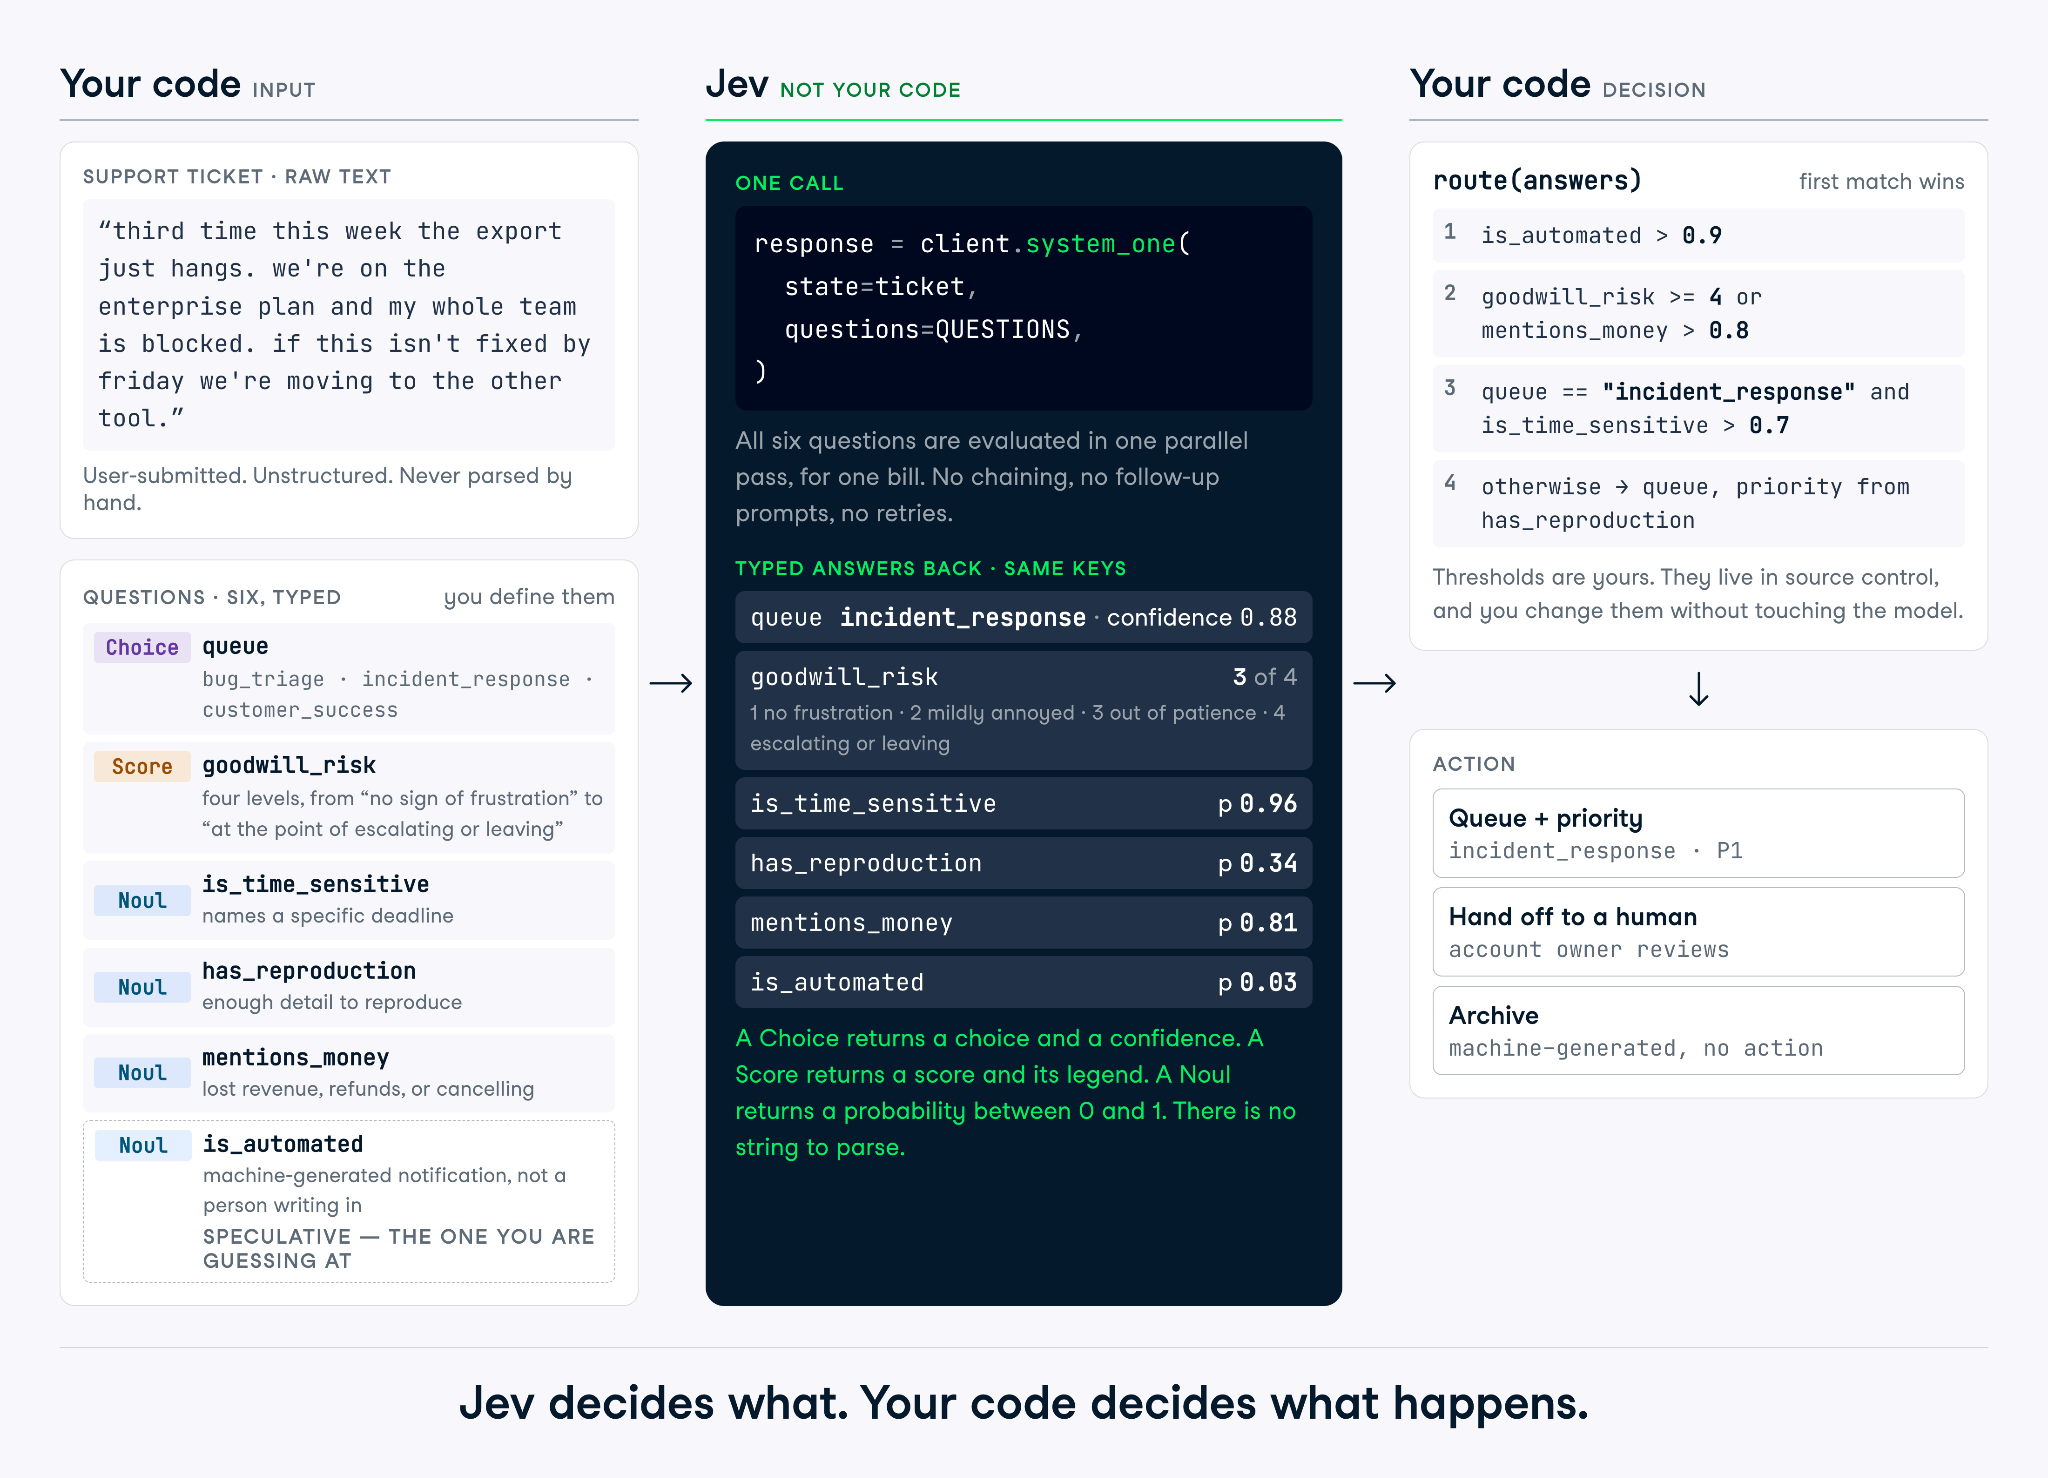
Convirtamos esto en un par de reglas para enrutar tickets:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Lee lo que hace esa función. El modelo aportó seis juicios, y la política decidió que uno de ellos, mentions_money cruzado con un cliente frustrado, tiene prioridad sobre la cola que eligió Jev. Esa anulación es una decisión de negocio, pertenece al código y puedes cambiarla un viernes por la tarde sin volver a probar un modelo.
has_reproduction no se usa nunca. Lo dejé a propósito, porque así es el patrón de abanico en la práctica: pides más de lo que la política actual consume, lo registras todo y, cuando alguien pregunte si los tickets de bug_triage sin pasos de reproducción tardan más en cerrarse, ya tendrás seis semanas de la respuesta.
Los umbrales de arriba son solo ejemplos. Encontrar los adecuados es cuestión de calibración, y al final hay una sección sobre cómo fijarlos con datos y no a ojo.
Puedes acceder al script completo en este repositorio de GitHub de apoyo. Cuando ejecuté el script de Python con nuestro escenario, el veredicto fue enrutar el ticket al equipo de incident response hoy.
python routing.py('incident_response', 'today')TypeSafe publica una página de cantos vivos por versión de modelo, listando los modos de fallo conocidos. Ojalá más laboratorios hicieran esto. Léela antes de construir nada y vuelve a leerla cuando actualices, porque la lista está versionada y los bordes se mueven.
Aquí van las cinco que más tiempo me habrían costado.
No puedes trasladar un umbral entre tipos de pregunta. El ejemplo de la propia TypeSafe pregunta "¿El cliente pide un reembolso?" de ambas formas sobre el mismo ticket: el Noul devuelve 0,22; la Choice de sí/no devuelve 0,01 para sí, con 0,97 de confianza. Misma pregunta, dos números, dos órdenes de magnitud distintos.
Las negaciones tampoco cooperan. Un Noul y su opuesto volvieron como 0,72 y 0,47, que suman 1,19.
La razón es que los dos tipos preguntan cosas distintas. Choice es relativa y decide qué opción gana, mientras que cada Noul es absoluto y puede ser bajo para todas. Ajusta umbrales por pregunta, en la forma en que la vas a desplegar, y no asumas nunca que P(yes) y 1 - P(no) sean el mismo número.
Los niveles de Score están ordenados, no espaciados. Un 1,6 te dice que el modelo está entre tu segundo y tercer nivel, inclinándose al tercero, y eso es todo lo que te dice.
Lo que no puedes hacer es interpolar una cantidad real a partir de ello. Si tus niveles son "menos de una hora", "unas horas" y "un día", un 1,5 no significa cinco horas. Usa el score para probar un umbral y guarda cada número real en código.
Jev trata el estado como datos, pero no está blindado contra instrucciones escritas en el propio estado para dirigirlo. Una instrucción inyectada, un encuadre engañoso o un texto que aboga por su propia clasificación pueden mover la respuesta, y TypeSafe dice que espera mejorar aquí. Si la superficie de ataque te pilla de nuevas, cubrimos el caso general en nuestra guía de prompt injection.
Importa sobre todo cuando el estado lo envía el usuario, que en un enrutador de tickets es siempre. Escribe criterios lo bastante precisos como para que las propias afirmaciones del ticket sobre sí mismo no decidan el resultado, y prueba con entradas hostiles antes de automatizar nada.
Contar es poco fiable y empeora a medida que crece lo que se cuenta, porque el modelo reconoce la forma de una respuesta en lugar de sumar. Las fechas se leen como texto, así que el orden, la distancia y las ventanas fallan. Las codificaciones numéricas rinden peor que sus equivalentes semánticos: pregunta por "rojo" en lugar de #FF0000.
La solución es la misma en los tres casos: divide el trabajo.
Si necesitas un recuento, itera en código y haz un Noul por elemento:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Tres cosas más pequeñas con una causa común. Jev responde a la pregunta que escribiste, no a la que querías escribir, así que los términos de alcance y las negaciones se leen al pie de la letra. Las dobles negaciones y las preguntas sobre la propiedad de una propiedad reducen precisión. Y un estado grande acolchado con detalles irrelevantes cuesta precisión y dinero, ya que el material no relacionado actúa como distracción.
La pista para la primera: cuando miras una respuesta equivocada y te sorprendes explicando lo que de verdad querías decir, esa explicación es la mitad que falta en tus instrucciones.
Con lo que ya hemos aprendido, aquí tienes algunas buenas prácticas para sacarle partido a Jev.
Escribe la condición en lugar de la intención. Si al revisar una respuesta incorrecta te ves explicando lo que querías decir, esa explicación pertenece a las instrucciones. En la práctica:
jev-latest se mueve. Fija la versión en cuanto un umbral dependa del comportamiento del modelo:
client = TypeSafeClient(model="jev-1.13.0")Registra response.model junto a las respuestas completas en cada llamada, no solo el valor que usaste para actuar. Cuando un umbral empiece a fallar, ese log es la única forma de diferenciar un cambio de modelo de una deriva en tus tickets.
Por último, los umbrales no vienen dados: son el resultado de la experimentación.
Jev es una herramienta acotada, y ese es precisamente el punto. Responde preguntas cuyas respuestas puedes enumerar, a un coste tan bajo que dejas de racionarlas, y devuelve la decisión a tu código.
Lo que matizaría es el encuadre de "no puede alucinar". Es cierto en el sentido estrecho de que el modelo no puede responder fuera del esquema, pero no dice nada sobre si la respuesta es correcta. Una Choice siempre devuelve una cola válida. Aun así puede ser la cola equivocada con 0,9 de confianza, y la salida tipada hace que ese fallo suene menos.
Para probarlo en tu trabajo, te sugiero encontrar una decisión que tu código tome con una regla frágil o una llamada lenta a un LLM, e intentar escribir las respuestas válidas. Si puedes, tiene forma de Jev. Si no, no hay ingeniería de preguntas que lo cambie.
Si quieres empezar a construir sistemas que usan IA, te recomiendo mucho inscribirte en nuestro itinerario profesional Associate AI Engineer for Developers. Te enseña a trabajar con la OpenAI API, MCP, LangChain y mucho más.
¡Aprende AI Engineering con DataCamp!
programa
Curso
Curso