tracks
개발자를 위한 AI 엔지니어 보조
26
이미 언급했듯, 기대치가 모델과 맞아야 합니다. Jev에서는 특히 그렇습니다. 이는 주로 System One 모델이라고 불리는 모델 계열과 관련이 있습니다.
System One 모델은 텍스트 대신 타입드 결정을 반환합니다. 상태 블록과 질문 집합(각 질문에는 여러분이 정의한 답변 공간을 포함)을 보내면, 모델은 각 질문에 대해 확률이 첨부된 답변 하나씩을 반환합니다. 토큰 단위로 생성되는 것이 아니므로, 파싱할 문자열도, 망가진 JSON을 복구할 일도 없습니다. TypeSafe는 이 용어를 Daniel Kahneman의 유명한 구분에 빗대어 썼습니다:
답변 공간은 코드가 선언한 스키마이므로, System One 모델은 설계상 정의하지 않은 카테고리를 절대 반환하지 않습니다. 즉, 스키마를 벗어나지 않습니다. 다만 여전히 틀릴 수는 있으며, 뒤에서 까다로운 사례를 몇 가지 살펴보겠습니다.
TypeSafe는 2026년 9월 15일 스텔스에서 나와 Jev의 얼리 액세스를 공개했고, 70~500ms 응답 시간과 백만 입력 토큰당 $0.042(출력은 무료)를 보고했습니다. 자체 4-워크플로 벤치마크에서 Jev는 약 68% 정확도로, 비용은 극히 낮으면서도 중급 LLM 수준에 근접합니다.
기능과 벤치마크 성능에 대한 자세한 정보는 Jev 가이드를 참고하세요.
호출 전에 유효한 답변을 적어보세요. 나열할 수 있다면, 이는 Jev가 딱 맞는 문제입니다:
LLM은 출력이 산문이나 코드일 때, 답변 공간이 열린 형태일 때, 또는 여러 단계의 추론을 연쇄해야 할 때 사용하세요. Jev는 숫자 관련 작업에도 부적합하며, 그 이유는 뒤에서 다시 설명합니다.
코드를 쓰기 전에 TypeSafe 계정을 만들고 Playground를 여세요. 여기에서 상태로 텍스트를 붙여넣고, 질문을 추가하며, 아무것도 설치하지 않고도 전체 답변 객체를 확인할 수 있습니다. 각 질문 유형이 무엇을 반환하는지(그리고 질문 표현이 나쁜지)를 가장 빠르게 이해하는 방법입니다.
세 예시 모두에서 하나의 지원 티켓을 상태로 사용하겠습니다:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
모든 질문 유형은 instructions, 즉 평이한 언어로 묻고자 하는 질문을 받습니다. 유형 간에 달라지는 것은 criteria와 반환 형태입니다.
Choice는 여러분이 정의한 집합에서 하나의 옵션을 고릅니다.
criteria는 각 옵션을 설명에 매핑한 딕셔너리 객체로 전달합니다. 옵션 수는 1~255개까지 가능하며, 답변에는 다음이 포함됩니다:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
API로도 받게 될 코드 출력을 확인하려면 오른쪽 상단의 </> 버튼을 클릭한 뒤 Run을 눌러 Jev가 질문에 답하도록 하세요.
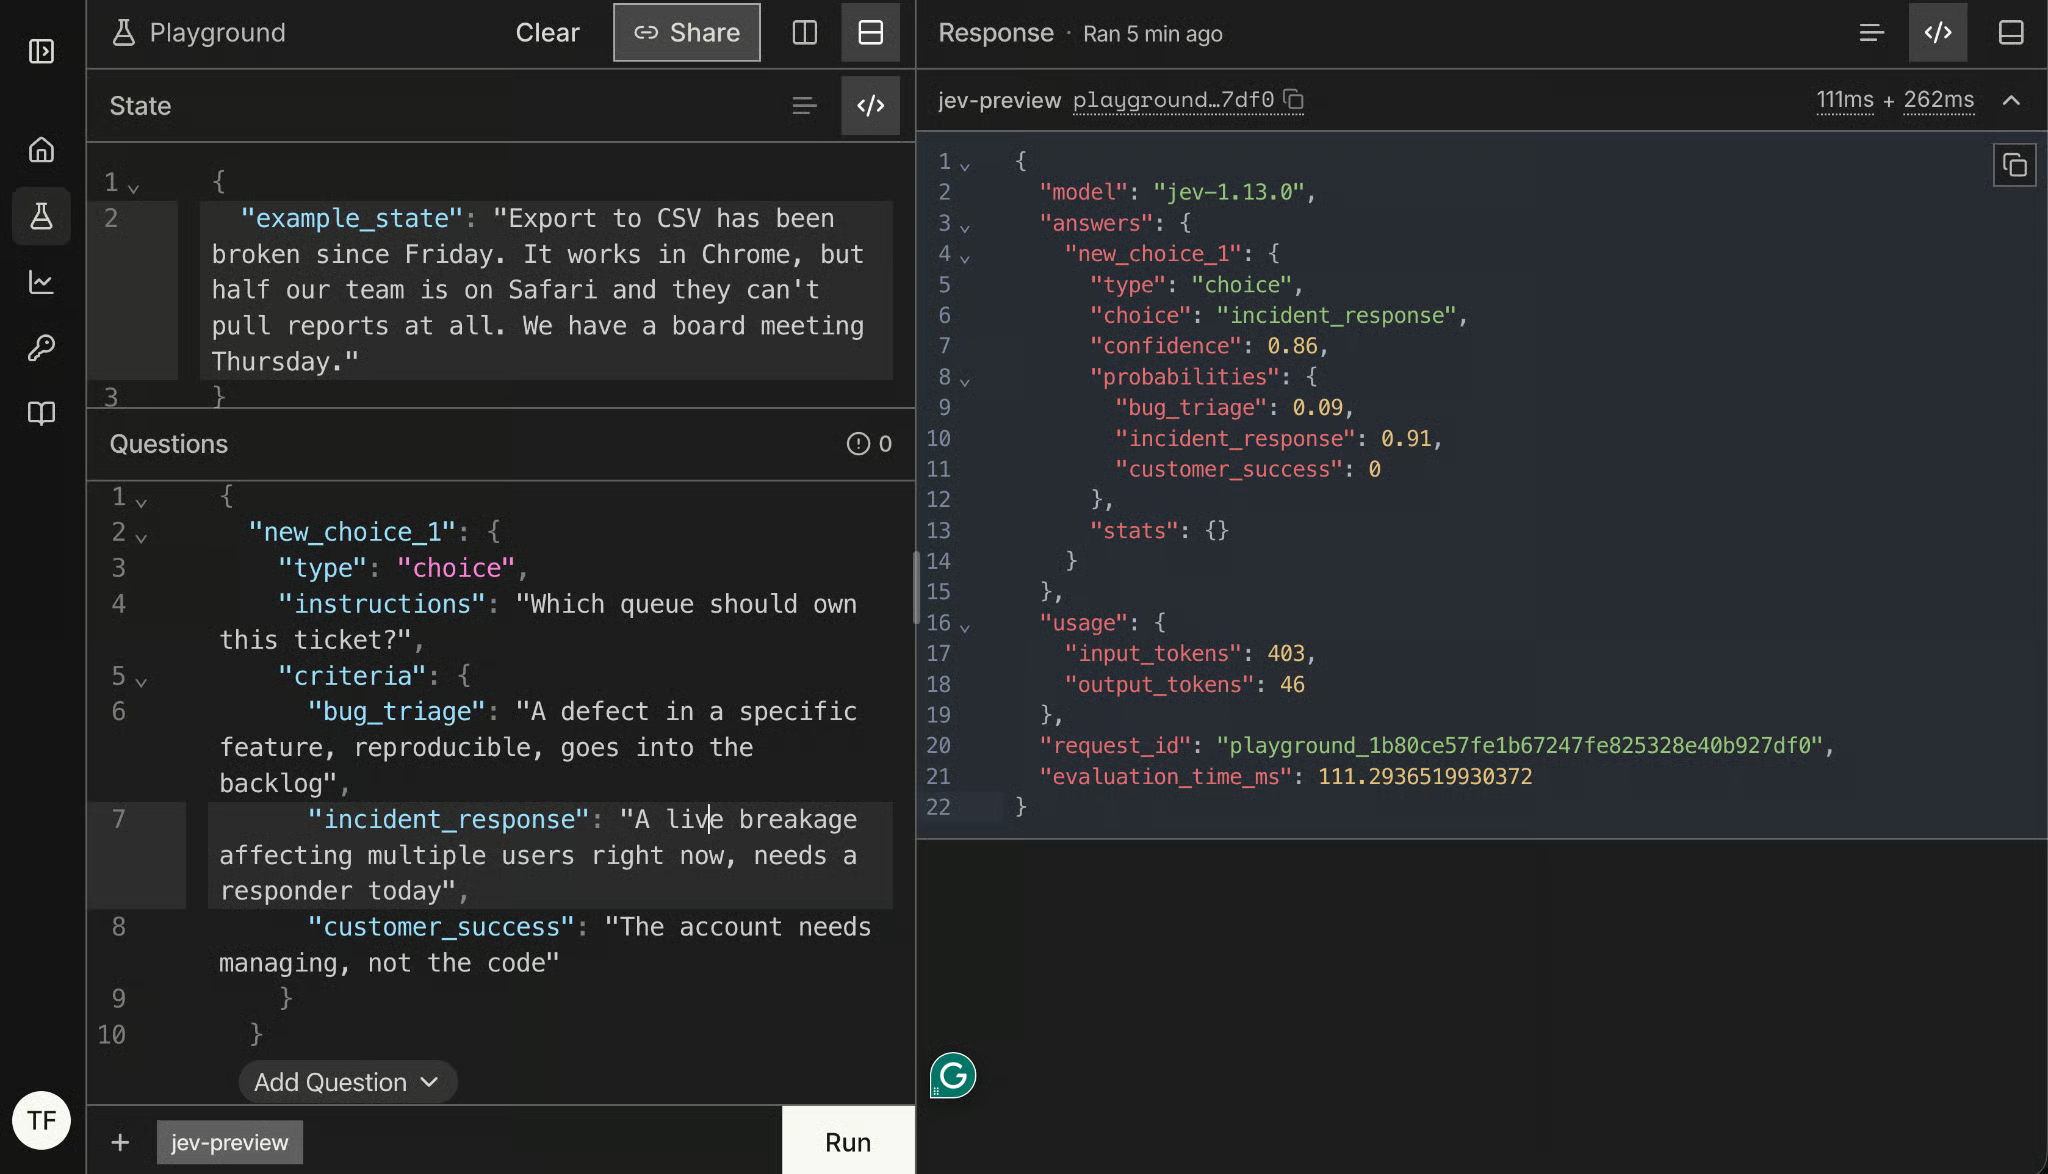
이 경우 incident_response가 91% 확률의 choice입니다. Jev의 해당 선택에 대한 confidence는 86%입니다.
전체 분포가 주목할 부분입니다.
choice는 어떤 옵션이 이겼는지만 알려줍니다.
probabilities는 얼마나 차이로 이겼는지 알려줍니다.
자동 라우팅 직전에 이 둘은 서로 다른 정보입니다. 0.41/0.38/0.21 분포와 우리가 받은 0.91/0.09/0 분포는 모두 동일한 choice를 반환할 수 있습니다.
Score는 상태를 순서가 있는 등급으로 평가합니다. criteria는 가장 낮은 수준부터 나열한 2~10개의 레벨 설명을 담은 배열로 전달하며, 답변에는 점수, 각 위치를 설명에 매핑한 legend, 레벨별 확률, 신뢰도가 포함됩니다.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}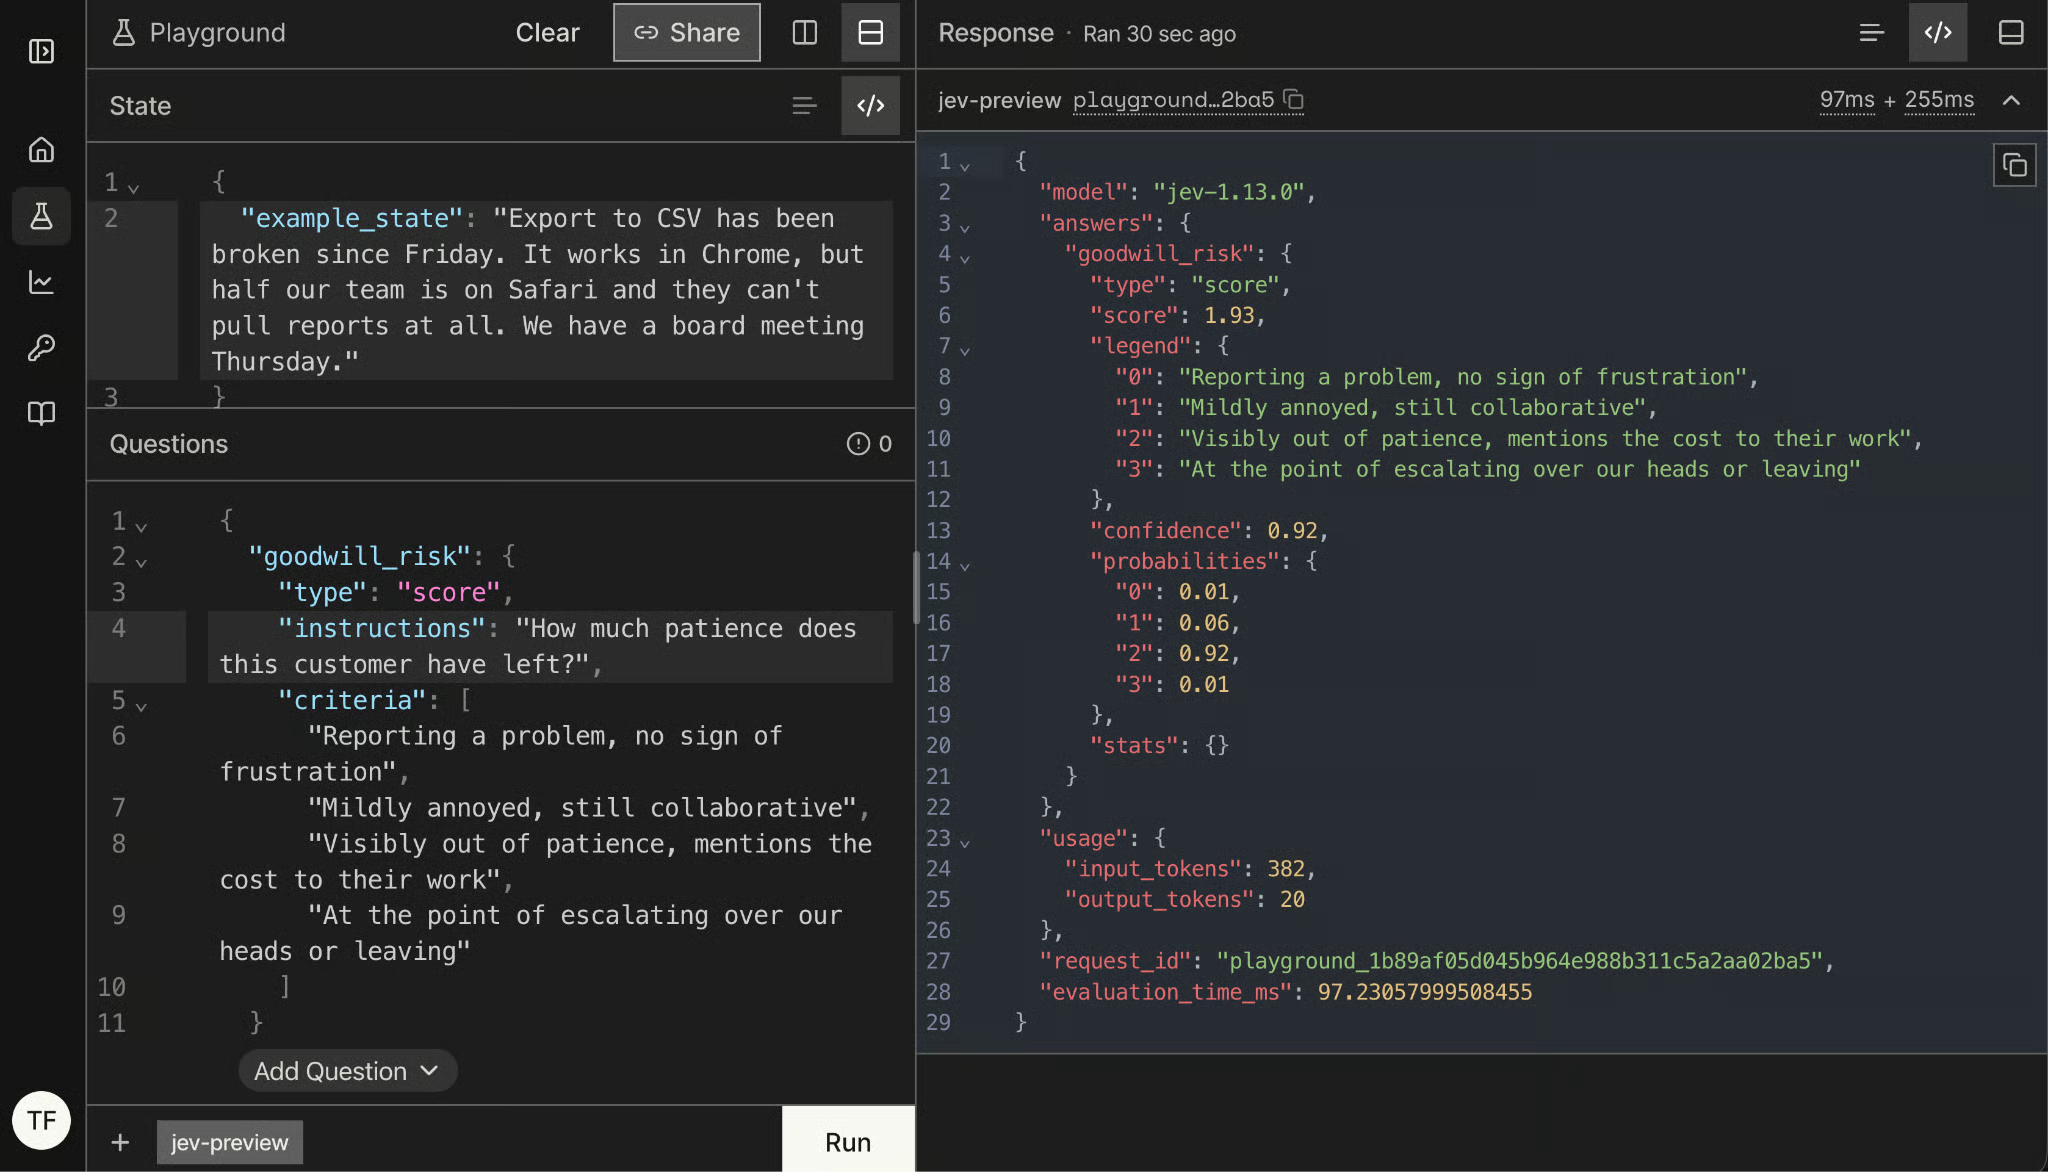
점수는 여러분의 레벨 사이에 위치할 수 있으며, 바로 그 때문에 legend가 중요합니다. 여기서 score 1.93은 모델이 "약간 짜증났음"과 "눈에 띄게 인내심이 바닥남" 사이에서, 후자 쪽으로 강하게 기운 상태를 의미합니다. 이는 예의를 지키면서도 놓칠 마감일을 언급하는 티켓에 대한 합리적 해석입니다.
또한 숫자만 보지 말고 probabilities 분포를 확인하세요. 하나의 레벨에 확률이 몰려 있다면 단호한 답변이고, 세 레벨에 넓게 퍼져 있다면 판단이 아닌 평균치를 얻은 것입니다.
Noul은 이진 질문 타입이며, 명칭은 TypeSafe가 만들었습니다. 여기서는 criteria가 선택 사항이지만, true와 false의 의미를 설명할 수 있으며, "예"가 두 가지로 읽힐 수 있을 때는 그렇게 하는 것이 좋습니다.
질문은 높은 값이 예(yes)를 의미하도록 표현하세요. TypeSafe 문서에 명시되어 있으며, true가 "아니오"에 매핑되는 Noul은 성능이 눈에 띄게 나빠집니다.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}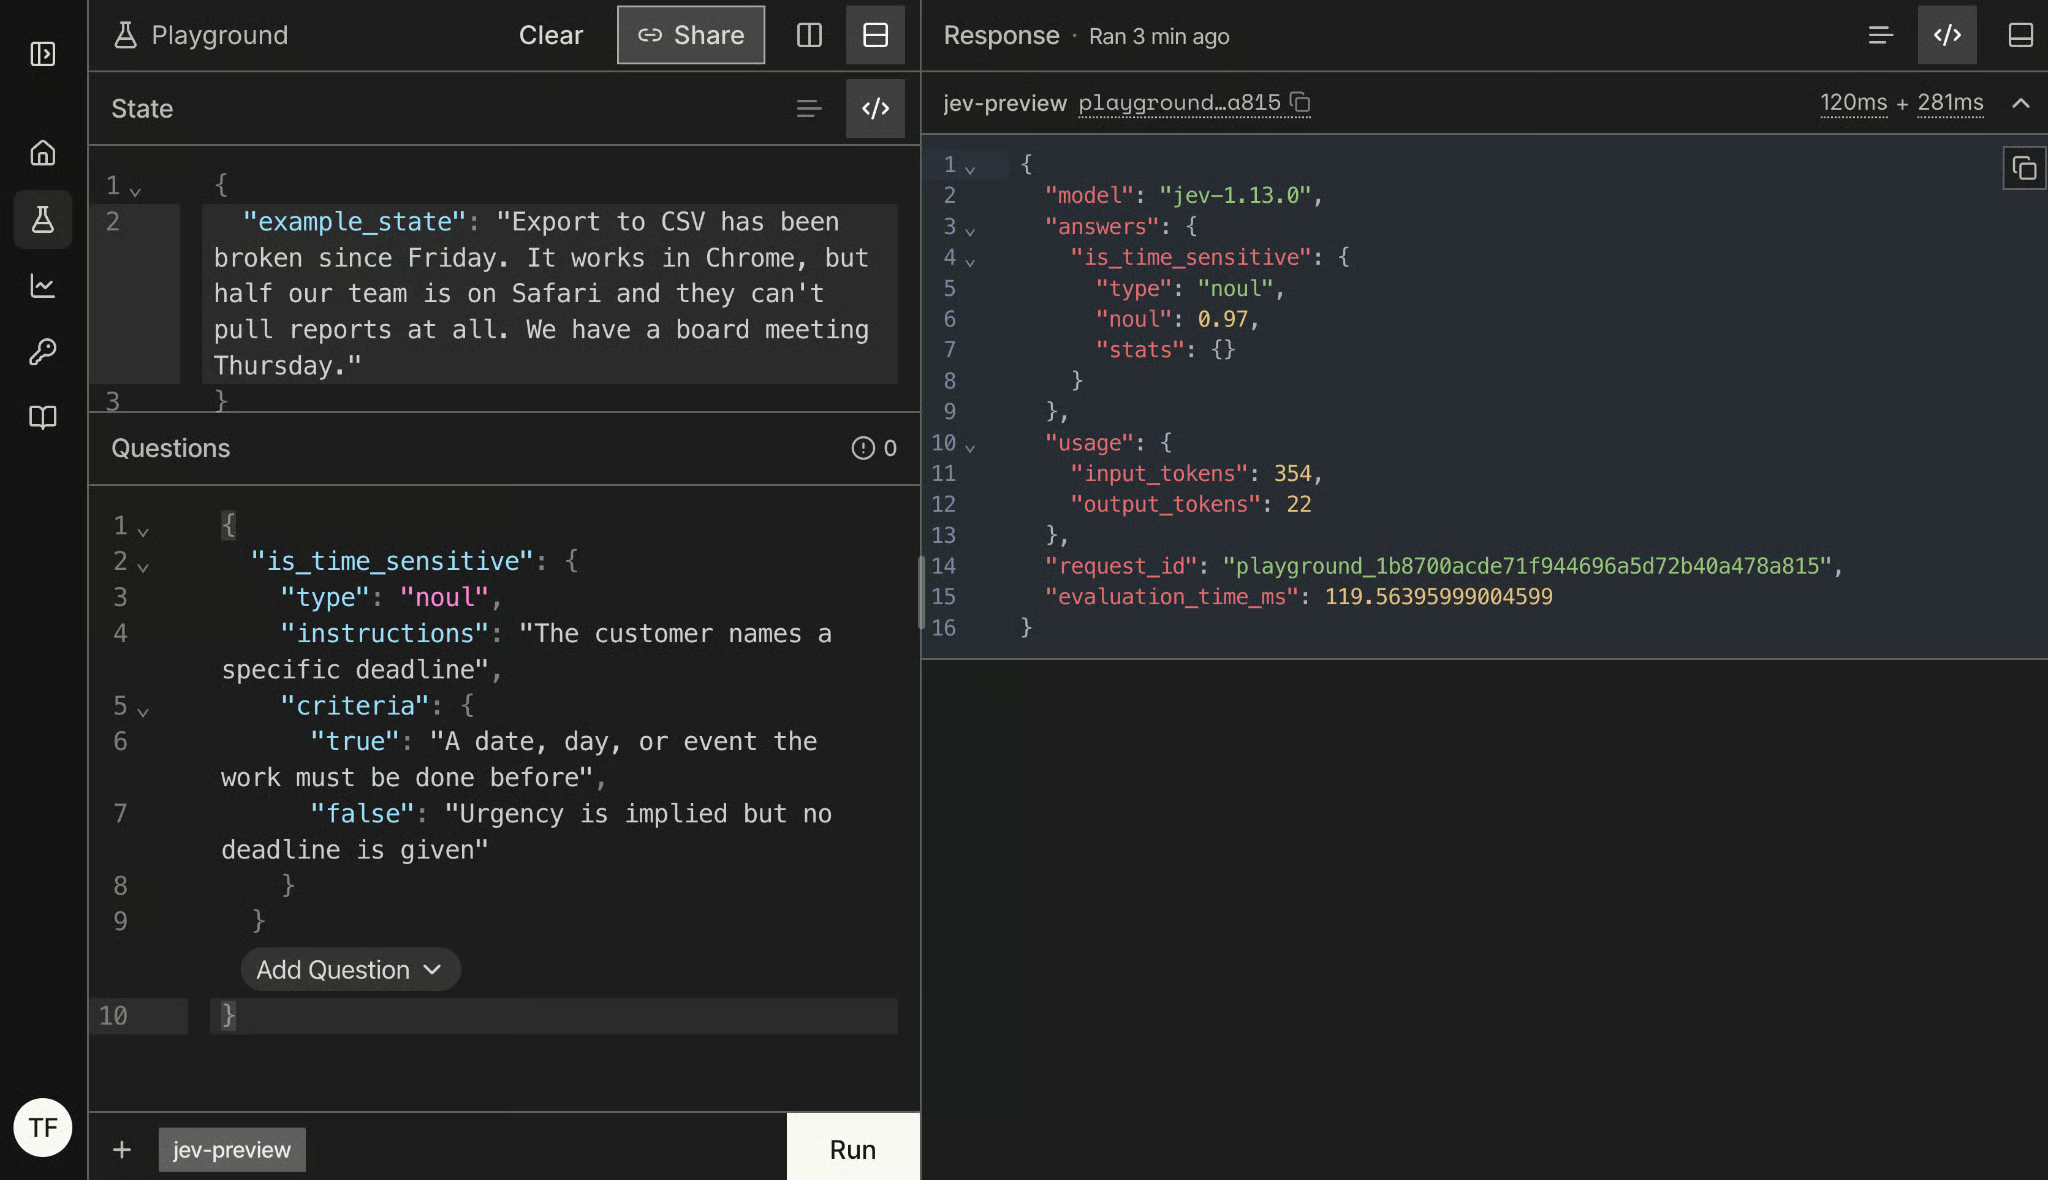
상태에 목요일 이사회 회의가 언급되어 있으므로, 0.97의 높은 noul 값은 예상된 결과입니다.
Choice와 Score는 확률과 함께 신뢰도를 반환합니다. Noul은 그렇지 않아서 헷갈리기 쉬운데, 그 이유를 정확히 짚고 넘어가는 것이 좋습니다.
신뢰도와 확률은 다른 축입니다. Choice에서 확률은 모델이 각 옵션에 대한 믿음을 어떻게 분배하는지 나타내고, 신뢰도는 그 답을 얼마나 굳게 믿는지 나타냅니다. 그래서 Choice는 상위 옵션이 0.85인데 신뢰도는 0.78일 수 있습니다. Noul은 결과가 두 개뿐이라 단일 확률이 이미 둘을 모두 담습니다. 0.97은 확고한 예, 0.03은 확고한 아니오, 0.52는 모델이 모르겠다는 뜻입니다.
즉, 0.5로부터의 거리야말로 결단 신호이며, 별도 필드를 읽을 필요가 없습니다. 또한 이는 Noul의 임계값을 Choice에 그대로 옮길 수 없다는 뜻이기도 하며, 이 비스듬한 모서리 내용에서 다시 다루겠습니다. 생각보다 훨씬 아픈 문제입니다.
따라 하시려면 Python 3.10+와 TypeSafe 얼리 액세스 키만 있으면 됩니다.
SDK를 설치하세요:
pip install typesafe-sdk또는 uv로:
uv add typesafe-sdk그런 다음 TypeSafe 콘솔에서 키를 만들고 내보내세요. 클라이언트는 환경 변수 TYPESAFE_API_KEY를 읽으므로, 코드에 직접 전달할 필요가 없습니다:
export TYPESAFE_API_KEY="your-key"다음 임포트로 플레이그라운드에서 보던 모든 것을 사용할 수 있습니다:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul, Score는 방금 클릭해본 동일한 질문 유형을 Python 객체로 제공합니다.
TypeSafeClient는 동기 클라이언트이며, async 서비스에서 Jev를 호출한다면 같은 인터페이스의 AsyncTypeSafeClient도 있습니다. 둘 다 컨텍스트 매니저로 동작하며, 스크립트를 넘어서는 코드에서는 이렇게 쓰는 것을 권합니다:
with TypeSafeClient() as client:
...아무 설정도 하지 않으면 클라이언트는 jev-latest를 호출합니다. 이는 TypeSafe가 새 버전을 배포할 때마다 이동하며, 이 튜토리얼 내내 이렇게 사용합니다. 이미 임계값을 조정해 둔 경우에는 버전을 고정하세요:
client = TypeSafeClient(model="jev-1.13.0")응답에는 어떤 모델이 실제로 답했는지 항상 포함되며, 이를 로깅해야 하는 이유는 끝부분에서 다시 설명합니다.
Jev로 API 호출을 하려면, TypeSafeClient와 system_one() 함수를 사용해 response 항목을 정의해야 합니다. 이 함수는 질문 컨텍스트를 state 매개변수로, 질문 자체는 플레이그라운드와 동일한 형식의 questions로 받습니다.
세 가지 플레이그라운드 질문은 모두 동일한 state를 공유하므로, 한 번의 호출로 함께 요청할 수 있습니다:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
답변은 각 질문에 대해 여러분이 지정한 동일한 이름 아래에 반환됩니다. 이 디테일 덕분에 작업이 무척 쾌적합니다:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97첫 호출이 output_buffer_limit 관련 TypeError로 실패한다면: 이는 SDK 압축 백엔드 버전 불일치이며, 코드 문제가 아닙니다. SDK는 자체 HTTP 클라이언트 httpx2를 포함하며, 응답을 zstandard와 brotli로 해제 압축합니다. 이 중 예전 버전이 호출 인자를 지원하지 않으면 문제가 납니다. pip install -U typesafe-sdk httpx2 zstandard brotli로 해결했습니다.
출력에서 주목할 점 두 가지가 있습니다.
첫째, response.model은 jev-latest가 아니라 jev-1.13.0을 반환했습니다. 이동하는 별칭을 요청했지만 Jev는 실제로 응답한 버전을 알려줍니다. 이 필드를 로깅해야 하는 이유가 충분히 저렴해지는 순간입니다.
둘째, 답변 객체는 질문 유형별로 타입이 지정되어 있으므로 .choice, .score, .noul은 실제 속성이며 에디터가 이를 인지합니다. 이 코드 전체 어디에도 JSON 문자열이 없고, 파싱할 것도, 잘못된 형식으로 돌아온 호출을 위한 분기도 없습니다. 그룹핑을 선호한다면, SDK는 같은 키로 response.choices, response.scores, response.nouls도 제공합니다.
response.usage도 확인하세요:
print(response.usage.input_tokens, response.usage.output_tokens)524
78출력 토큰은 한 자릿수이며 무료입니다. 비용은 상태와 질문에 대해 지불하므로, 어떤 컨텍스트를 얼마나 보낼지로 비용을 완전히 제어할 수 있습니다. 이는 보기보다 더 중요한데, 비스듬한 모서리 섹션에서도 다시 등장합니다. 부풀려진 상태는 비용과 정확도를 동시에 해칩니다.
이것이 바로 Jev가 설계된 사용 사례 중 하나입니다. 지원 티켓이 도착하면, 어느 대기열로 보낼지, 사람이 먼저 볼지, 속도는 어떠해야 하는지 누군가가 결정해야 합니다. 이 모든 것은 티켓 도착 전에 답변 공간을 적어둘 수 있는 판단입니다.
처음부터 명시할 설계 원칙: Jev는 무엇인지를 판단하고, 이후에 무엇을 할지는 코드가 결정합니다. Jev는 아무것도 라우팅하지 않습니다. 숫자를 반환하고, 라우팅은 모델을 건드리지 않고도 읽고, 테스트하고, 변경할 수 있는 평범한 함수에 담습니다.
한 요청 안의 질문들은 병렬로 평가되므로, 여섯 번째 질문은 그 질문 텍스트 토큰만큼의 비용과 거의 없는 추가 지연만 발생시킵니다. 이는 질문 방식을 바꿉니다. LLM에서는 왕복 시간을 아끼려 신중히 배치하겠지만, 여기서는 특정 컨텍스트에 대해 필요할 법한 것을 모두 묻습니다. 심지어 아마 무시할 질문도 포함합니다.
앞선 질문에 다음 세 가지 Noul을 추가해, 티켓 처리에 중요한 정보를 더 받아봅시다:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
여섯 개 질문, 한 번의 호출, 한 번의 청구. is_automated는 다소 투기적입니다. 실제 티켓에서는 거의 항상 false겠지만, 한 번이라도 true라면 메일러 데몬 바운스를 사람이 열어보는 일을 막아줍니다.
여기서 익힐 만한 습관 두 가지.
질문 집합은 인라인으로 만들지 말고 모듈 레벨 상수로 두세요. 임계값과 함께 버전 관리를 하게 될 것입니다.
그리고 질문 이름은 답으로 무엇을 할지가 아니라, 무엇을 측정하는지에 맞추세요. is_time_sensitive는 정책이 바뀌어도 유효하지만, route_to_incident는 그렇지 않습니다.
질문은 긍정형으로 표현하세요: is_automated를 needs_no_reply처럼 부정형으로 부를 수도 있었지만, TypeSafe에 따르면 긍정형으로 표현한 질문의 성능이 더 좋습니다.
이제 Jev가 하지 않는 부분입니다. 모든 답변은 신뢰도나 확률 중 하나를 동반하며, 이 두 번째 숫자가 두 갈래가 아닌 세 갈래 경로를 만들 수 있게 합니다:
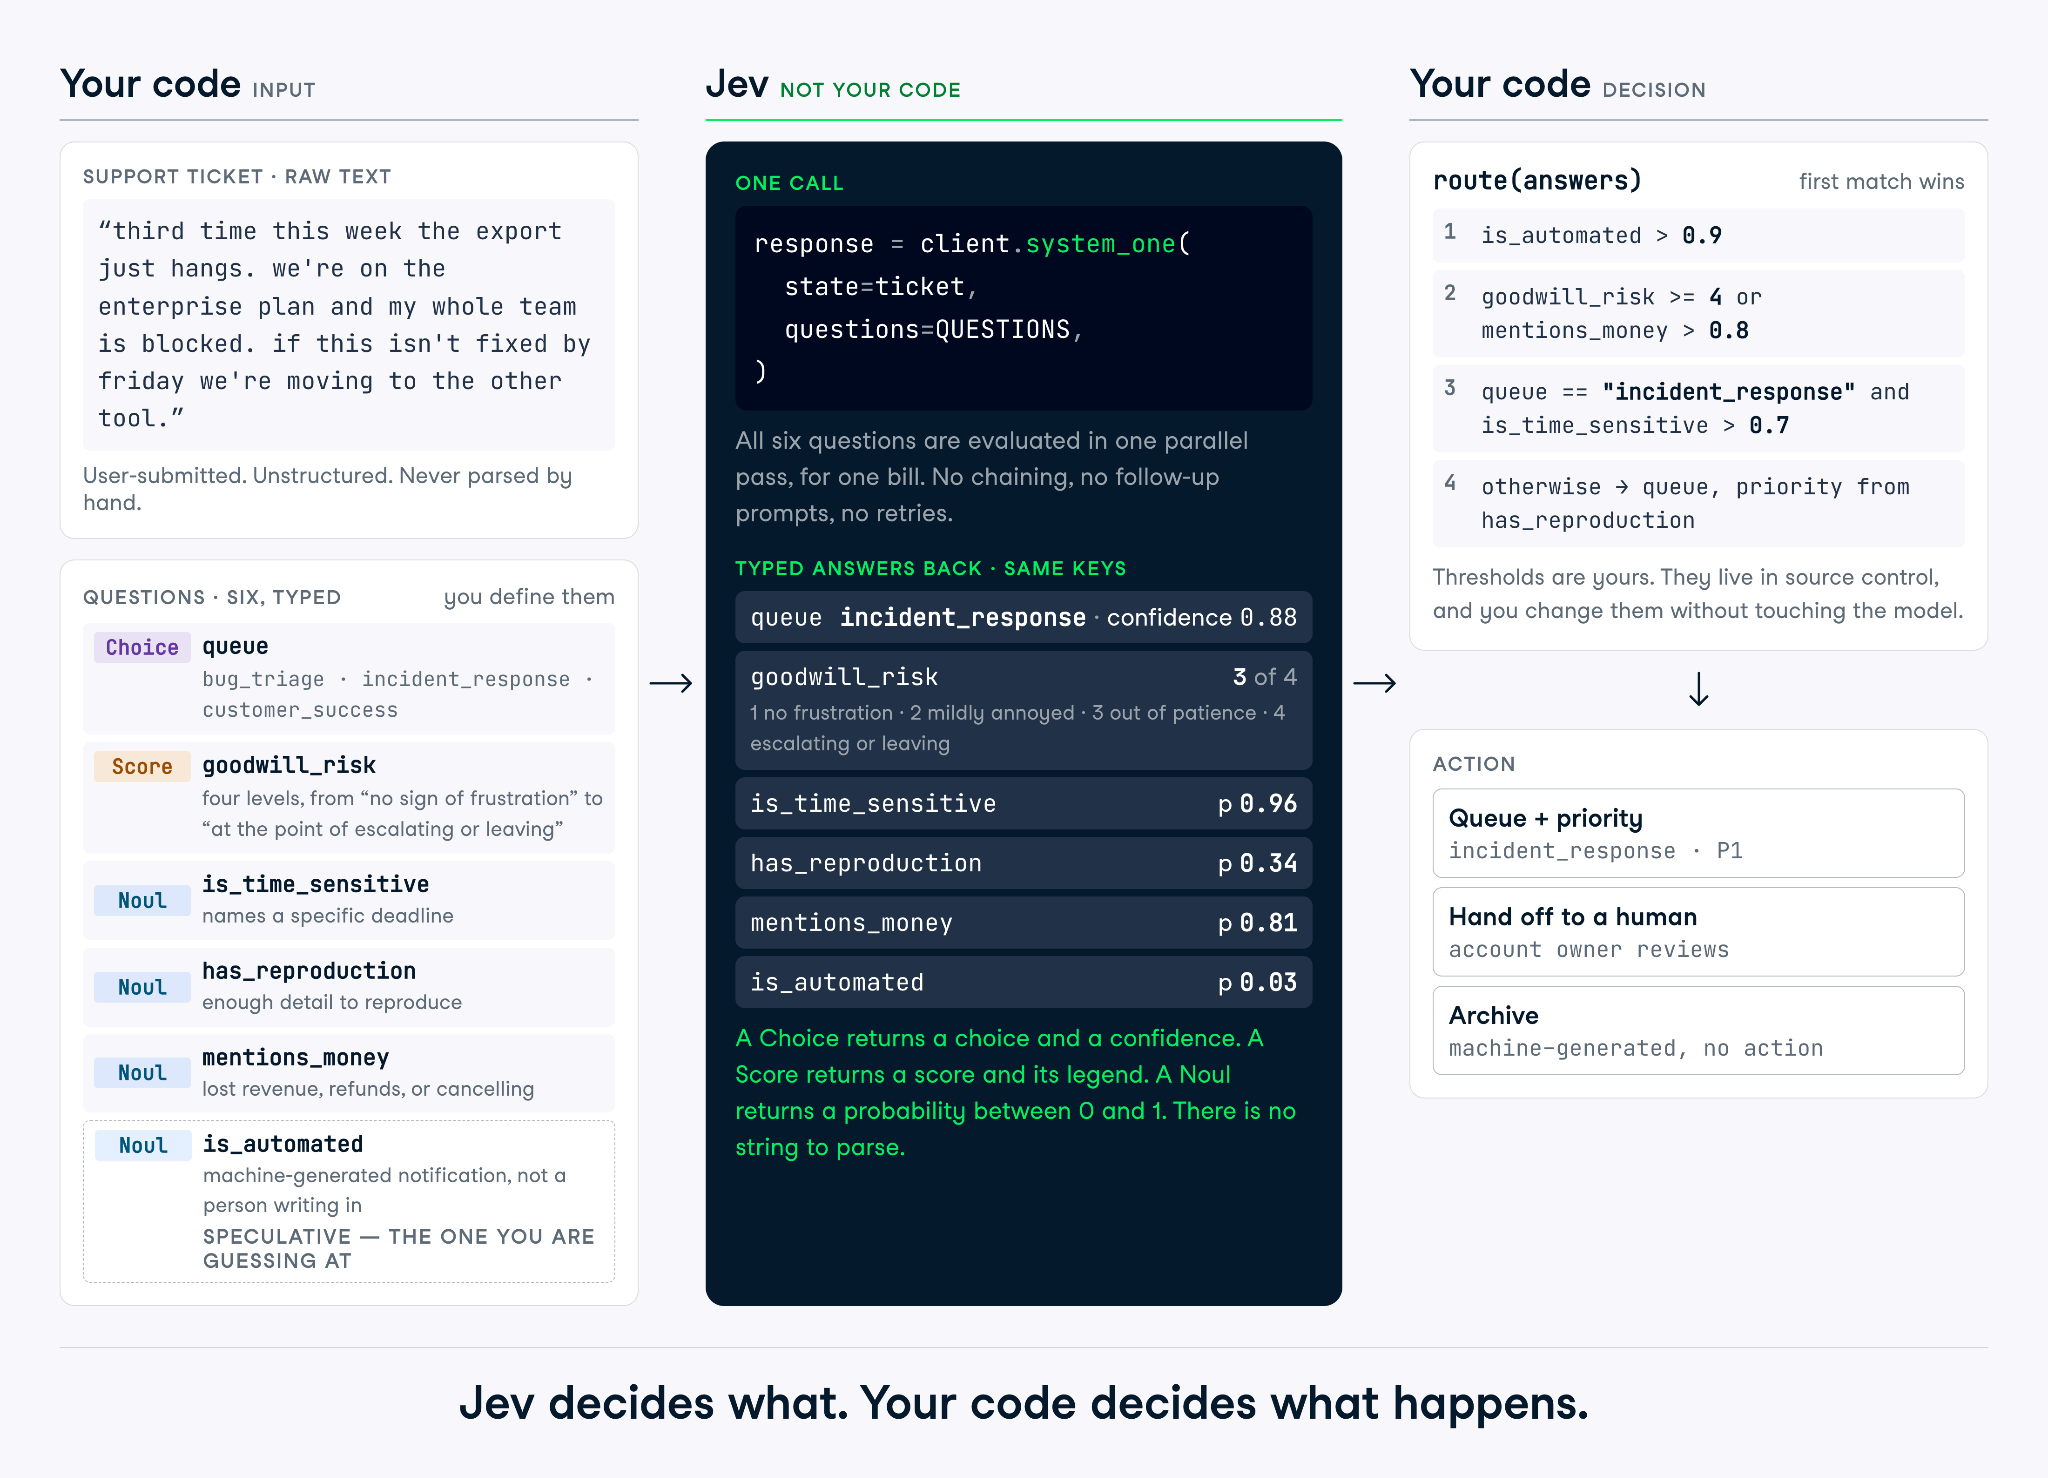
이를 티켓 라우팅 규칙 몇 가지로 바꿔봅시다:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
이 함수가 하는 일을 읽어보세요. 모델은 여섯 가지 판단을 제공했고, 정책은 그중 mentions_money와 불만 고객의 조합이 Jev가 고른 대기열보다 상위라고 결정했습니다. 이 오버라이드는 비즈니스 결정이며, 코드에 있어야 하고, 모델 재테스트 없이 금요일 오후에도 바꿀 수 있어야 합니다.
has_reproduction은 쓰이지 않습니다. 의도적으로 남겨두었습니다. 실제 팬아웃 패턴은 보통 이렇게 보입니다. 현재 정책이 소비하는 것보다 더 많이 물어보고, 전부 로깅하며, 누군가가 bug_triage 티켓 중 재현 단계가 없는 것이 해결에 더 오래 걸리는지 묻는다면, 이미 6주의 답을 갖고 있게 되는 식입니다.
위 임계값은 단지 예시입니다. 올바른 임계값을 찾는 일은 보정의 문제이며, 마지막에 데이터 기반으로 설정하는 방법을 다룹니다.
전체 스크립트는 보조 GitHub 저장소에서 확인할 수 있습니다. 제 시나리오에서 Python 스크립트를 실행했을 때의 판단은 티켓을 오늘 incident response 팀으로 라우팅하는 것이었습니다.
python routing.py('incident_response', 'today')TypeSafe는 모델 버전별로 실패 양상을 나열한 jaggedness 페이지를 공개합니다. 더 많은 연구소가 이렇게 하길 바랍니다. 무엇을 만들기 전에 읽고, 업그레이드할 때 다시 읽으세요. 목록은 버전별로 달라지며, 모서리도 이동합니다.
제가 가장 많은 시간을 잃었을 법한 다섯 가지를 소개합니다.
질문 유형 간에 임계값을 이식할 수 없습니다. TypeSafe의 자체 예시에서는 동일한 티켓에 대해 "고객이 환불을 요청하나요?"를 두 방식으로 묻습니다. Noul은 0.22를, 예/아니오 Choice는 예에 0.01(신뢰도 0.97)을 반환합니다. 같은 질문에 두 숫자, 두 자리수 차이입니다.
부정형도 협조적이지 않습니다. 어떤 Noul과 그 반대 질문이 0.72와 0.47로 돌아오는 경우가 있었는데, 합하면 1.19입니다.
이유는 두 유형이 서로 다른 것을 묻기 때문입니다. Choice는 상대적이며 어떤 옵션이 이기는지를 정하고, 각 Noul은 절대적이라 모두 낮을 수 있습니다. 배포 형태 그대로, 질문별로 임계값을 조정하세요. P(yes)와 1 - P(no)가 같은 숫자라고 절대 가정하지 마세요.
Score의 레벨은 순서만 있고 간격은 없습니다. 1.6은 모델이 두 번째와 세 번째 레벨 사이, 세 번째에 기운 상태라는 것만 알려줍니다.
즉, 실제 양을 보간해내려 해서는 안 됩니다. 예를 들어 레벨이 "1시간 미만", "몇 시간", "하루"라면, 1.5가 5시간을 뜻하지는 않습니다. 점수는 임계값을 테스트하는 데만 쓰고, 실제 수치는 코드에 남겨두세요.
Jev는 상태를 데이터로 취급하지만, 상태에 써넣은 지시나 오도하는 프레이밍, 특정 분류를 유도하는 텍스트에 대해 경화되어 있지 않습니다. 주입된 지시, 오도, 자기 자신에 대한 분류를 주장하는 텍스트는 답을 움직일 수 있으며, TypeSafe는 이 부분을 개선할 예정이라고 밝힙니다. 이 공격면이 낯설다면, 일반론은 우리의 프롬프트 인젝션 가이드에서 다룹니다.
이는 상태가 사용자 제출인 곳에서 가장 중요하며, 티켓 라우터라면 항상 그렇습니다. 티켓의 자기 주장만으로 결과가 좌우되지 않도록 criteria를 충분히 정밀하게 작성하고, 자동 라우팅 전에 적대적 입력으로 테스트하세요.
카운팅은 신뢰할 수 없으며, 개수가 커질수록 더 나빠집니다. 모델이 합계를 내기보다 답의 모양을 인식하기 때문입니다. 날짜는 텍스트로 읽히므로 정렬, 간격, 윈도우 계산이 모두 실패합니다. 숫자 인코딩은 의미 기반 표현보다 성능이 떨어지므로, #FF0000보다는 "빨강"처럼 물어보세요.
세 경우 모두 해결책은 같습니다: 작업을 분리하세요.
카운트가 필요하다면, 코드에서 반복하며 항목별로 Noul 하나씩 물어보세요:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)공통 원인을 공유하는 소소한 세 가지입니다. Jev는 여러분이 쓴 질문을 그대로 읽지, 의도한 질문을 읽지 않습니다. 범위 지정어와 부정은 액면 그대로 해석됩니다. 이중 부정이나 속성의 속성에 대한 질문은 정확도를 떨어뜨립니다. 무관한 디테일로 부풀린 큰 상태는 방해 요소로 작동해 정확도와 비용 모두를 악화시킵니다.
첫 번째의 징후는 이렇습니다. 잘못된 답을 보고 "내가 진짜로 말하고 싶었던 건…"이라고 설명하고 있다면, 그 설명이 곧 instructions에서 빠진 절반입니다.
지금까지 배운 내용을 바탕으로, Jev를 최대한 활용하기 위한 모범 사례를 정리합니다.
의도가 아니라 조건을 쓰세요. 오답을 리뷰하며 의도를 설명하게 된다면, 그 설명이 곧 instructions에 들어가야 할 내용입니다. 구체적으로는 다음과 같습니다:
jev-latest는 이동합니다. 임계값이 모델 동작에 의존하기 시작하면 버전을 고정하세요:
client = TypeSafeClient(model="jev-1.13.0")매 호출마다 response.model과 전체 답변을, 행동에 사용한 값만이 아니라 함께 로깅하세요. 임계값이 이상해지기 시작할 때, 그 로그만이 모델 변경과 티켓 분포 변화를 구분해줍니다.
마지막으로, 임계값은 주어지는 것이 아니라 실험의 결과입니다.
Jev는 좁은 도구이며, 그것이 바로 포인트입니다. 나열할 수 있는 답을 가진 질문에 답하고, 충분히 저렴해서 더 이상 질문을 아끼지 않게 해주며, 결정을 코드에 되돌려줍니다.
제가 반박하고 싶은 것은 "환각이 불가능하다"는 표현입니다. 엄밀히 말해 스키마 밖의 답은 낼 수 없다는 점은 사실이지만, 그 답이 맞는지에 대해선 아무 말도 하지 않습니다. Choice는 항상 유효한 대기열을 반환합니다. 여전히 0.9 신뢰도로 틀릴 수 있으며, 타입드 출력은 그 실패를 더 조용하게 만듭니다.
직접 업무에 시험해보세요. 취약한 규칙이나 느린 LLM 호출로 코드가 내리는 결정을 하나 골라, 유효한 답을 적어보세요. 적을 수 있다면 Jev가 맞습니다. 적을 수 없다면, 어떤 질문 엔지니어링으로도 바뀌지 않습니다.
AI를 활용한 시스템 구축을 시작하고 싶다면, Associate AI Engineer for Developers 커리어 트랙을 추천합니다. OpenAI API, MCP, LangChain 등 다양한 내용을 배울 수 있습니다.
DataCamp으로 AI 엔지니어링을 배우세요!
tracks
courses
courses