
Cursus
Associate AI Engineer pour développeurs
26 h
Je l’ai dit : vos attentes doivent correspondre au modèle. C’est particulièrement vrai pour Jev, et cela tient surtout à sa classe de modèles, dite System One.
Un modèle System One renvoie des décisions typées plutôt que du texte. Vous envoyez un bloc d’état et un ensemble de questions, chacune avec un espace de réponses que vous définissez ; le modèle renvoie une réponse par question avec des probabilités. Rien n’est produit token par token, donc pas de chaîne à parser ni de JSON mal formé à réparer. TypeSafe a forgé ce terme en référence à la célèbre distinction de Daniel Kahneman :
Puisque l’espace de réponses est un schéma déclaré par votre code, un modèle System One ne peut, par conception, jamais renvoyer une catégorie que vous n’avez pas définie. Il ne peut donc pas sortir du schéma. Cela dit, il peut toujours se tromper — nous verrons des cas pièges plus loin.
TypeSafe est sorti du mode furtif le 15 septembre 2026 avec Jev en accès anticipé, annonçant des réponses en 70 à 500 ms et un coût de 0,042 $ par million de tokens en entrée, la sortie étant gratuite. Sur son propre benchmark à quatre workflows, Jev atteint environ 68 % de précision, soit un niveau LLM intermédiaire pour une fraction du coût.
Pour en savoir plus sur les fonctionnalités et les performances, lisez notre guide Jev.
Listez les réponses valides avant l’appel. Si vous pouvez les énumérer, vous avez un problème « format Jev » :
Préférez un LLM quand la sortie est du propos ou du code, quand l’espace de réponse est ouvert, ou quand la tâche exige plusieurs chaînes de raisonnement. Jev est aussi le mauvais outil pour tout ce qui est numérique ; j’y reviens plus loin.
Avant d’écrire la moindre ligne, créez un compte TypeSafe et ouvrez le Playground. Ici, vous pouvez coller du texte comme état, ajouter des questions et voir les objets de réponse complets sans rien installer. C’est le moyen le plus rapide de comprendre ce que chaque type de question renvoie (et de vérifier si votre formulation est bancale).
J’utiliserai un ticket support comme état pour les trois exemples :
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Chaque type de question prend instructions, la question en langage naturel. Ce qui change entre eux, c’est criteria et la forme de la réponse.
Une Choice choisit une option dans un ensemble que vous définissez.
Vous passez criteria comme un dictionnaire associant chaque option à une description, de 1 à 255, et la réponse comprend :
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Pour voir la sortie code que vous recevriez via l’API, cliquez sur le bouton </> en haut à droite, puis sur Run pour laisser Jev répondre.
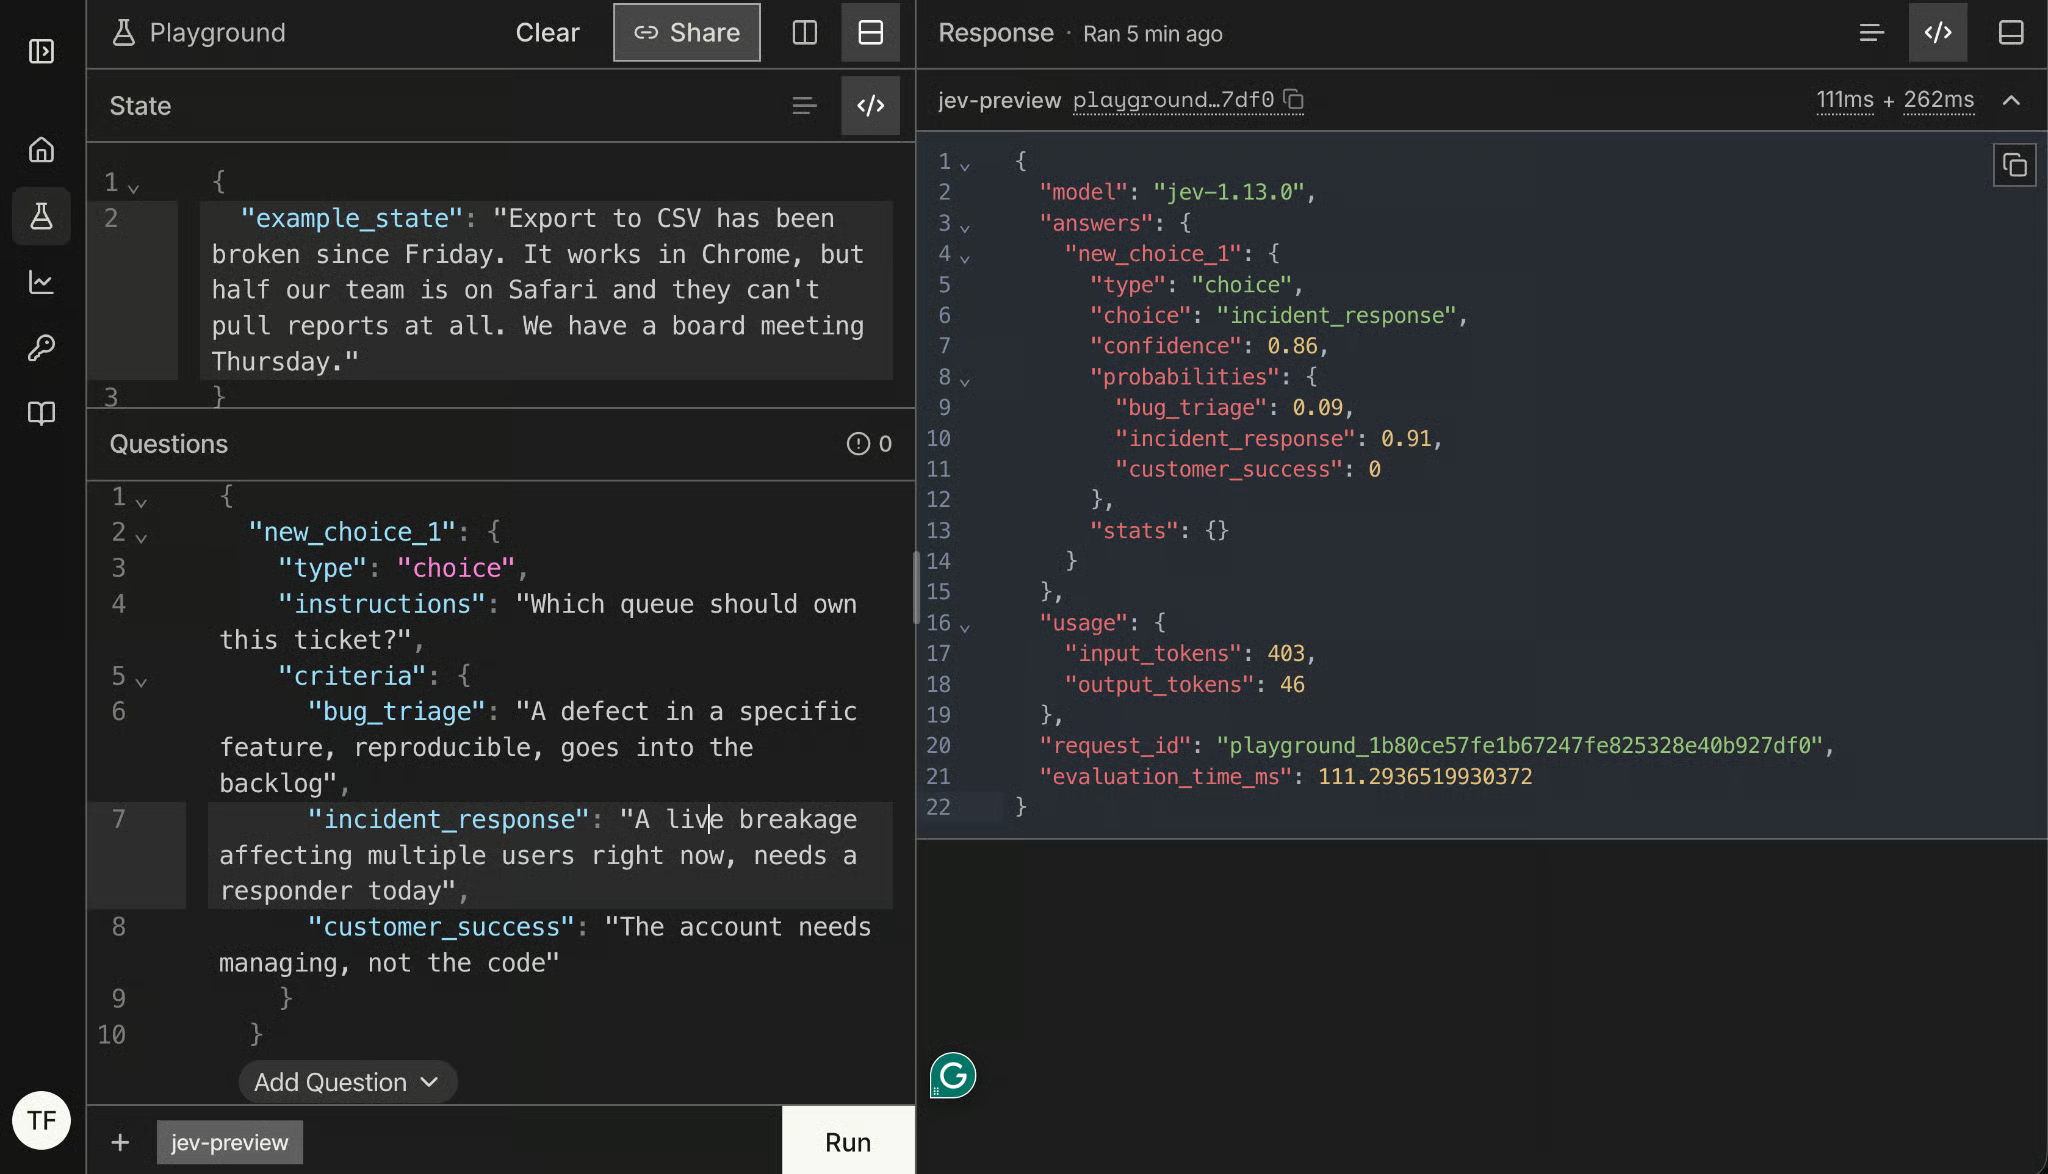
Ici, incident_response est la choice à 91 % de probabilité. La confidence de Jev pour ce choix est de 86 %.
La distribution complète est la partie à vraiment regarder.
choice vous dit seulement quelle option a gagné.
probabilities vous dit avec quelle marge.
Ce sont deux informations différentes quand vous allez router un ticket automatiquement. Un partage 0,41/0,38/0,21 et le 0,91/0,09/0 que nous avons reçu peuvent tous deux retourner la même choice.
Un Score évalue l’état selon des niveaux ordonnés. Vous passez criteria comme un tableau de 2 à 10 descriptions de niveaux, du plus faible au plus élevé, et la réponse inclut un score, une legend qui associe chaque position à votre description, une probabilité par niveau et la confiance.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}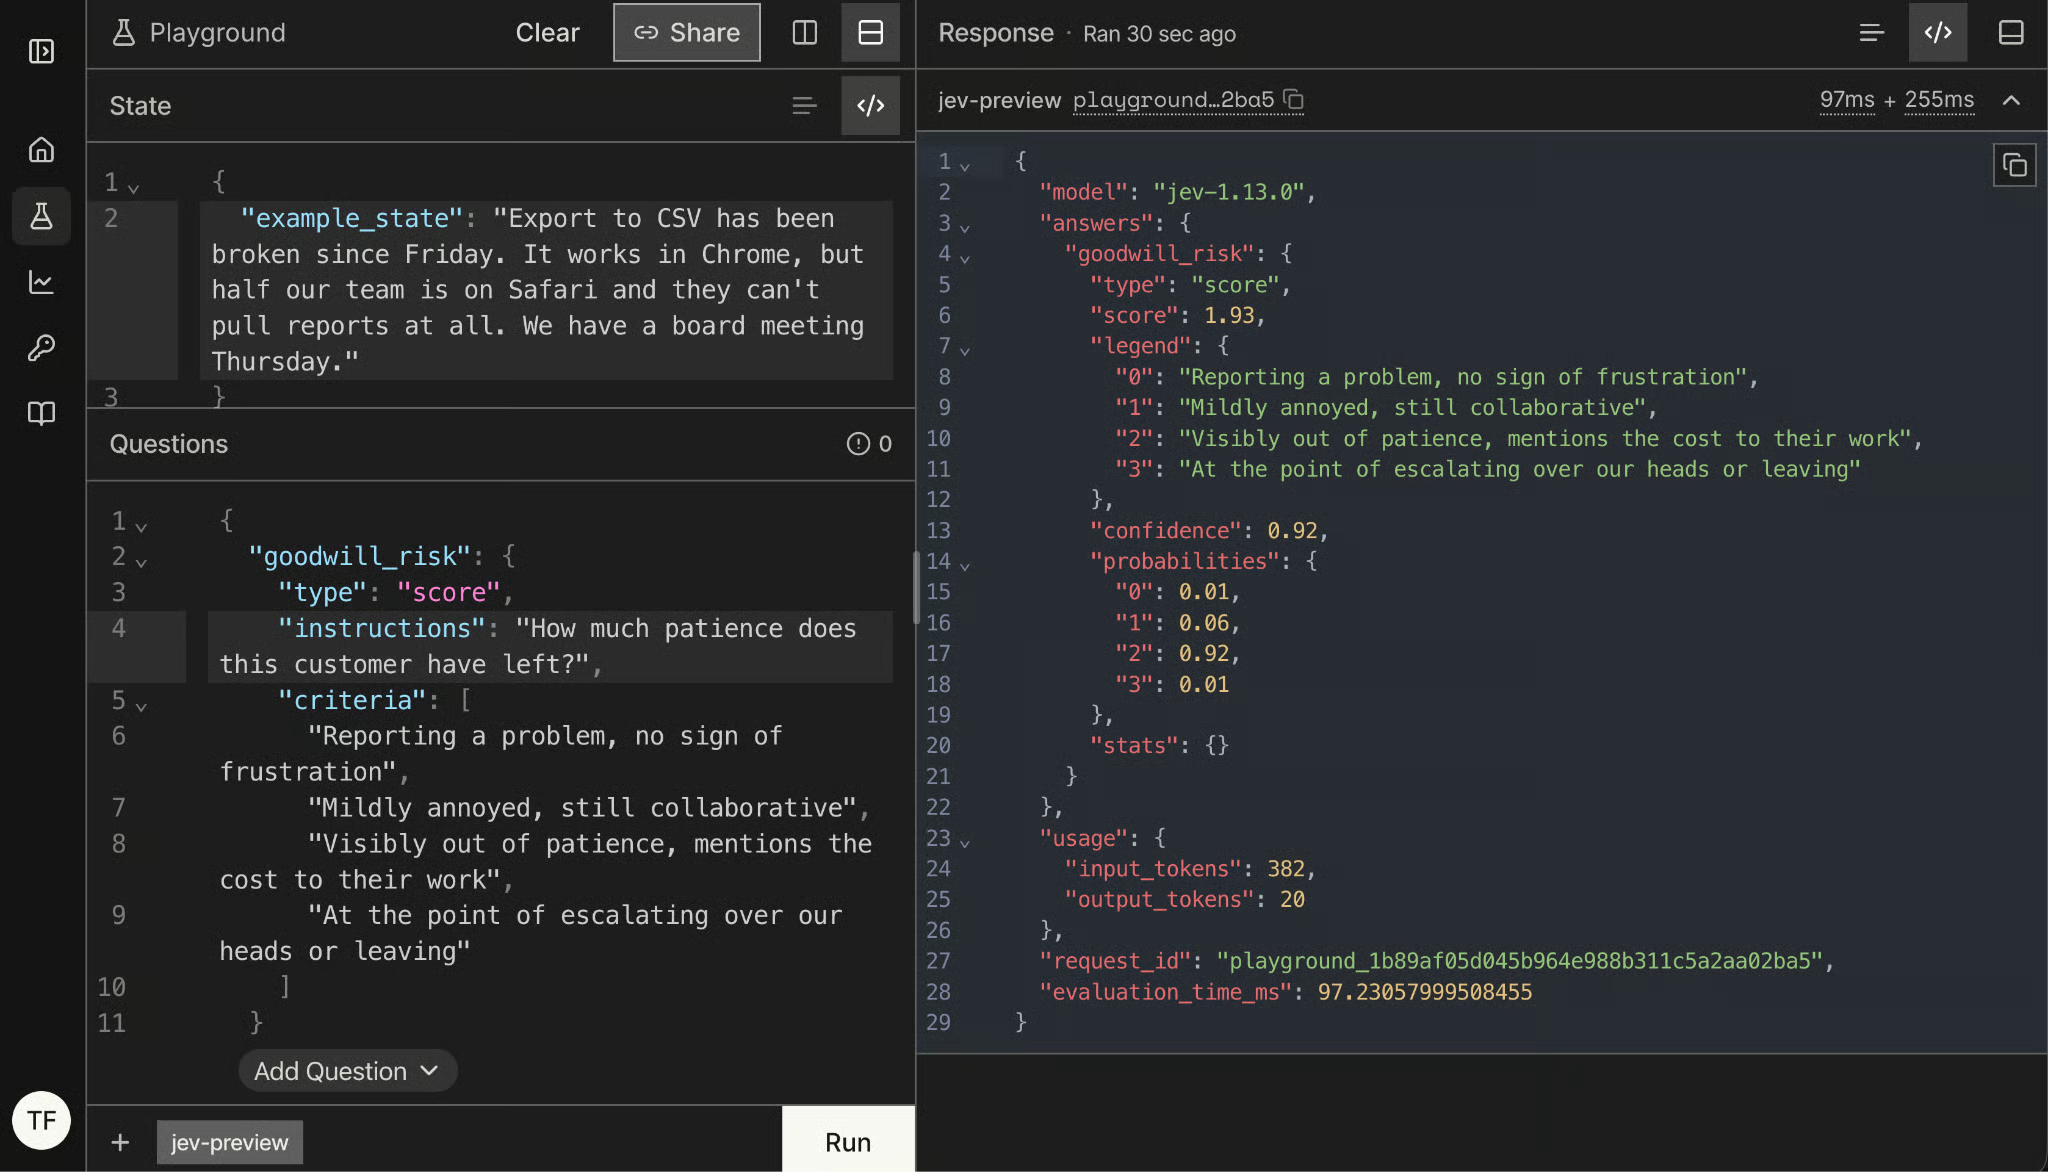
Le score peut tomber entre vos niveaux, et c’est tout l’intérêt de la legend. Un score de 1,93 ici signifie que le modèle hésite entre « un peu agacé » et « visiblement à bout de patience », avec une forte pente vers le second : une lecture cohérente d’un ticket poli qui cite une échéance imminente.
Là encore, lisez la dispersion des probabilities plutôt que le seul nombre : une probabilité concentrée sur un niveau indique une réponse tranchée, une probabilité étalée sur trois niveaux donne une moyenne, pas un jugement.
Un Noul est le type pour les questions binaires, nommé par TypeSafe. criteria est facultatif, mais vous pouvez décrire ce que signifient true et false, ce qui vaut la peine dès que « oui » peut se lire de deux manières.
Formulez la question pour qu’une valeur élevée signifie oui. La documentation de TypeSafe est explicite : un Noul dont true correspond à « non » obtient de moins bons résultats.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}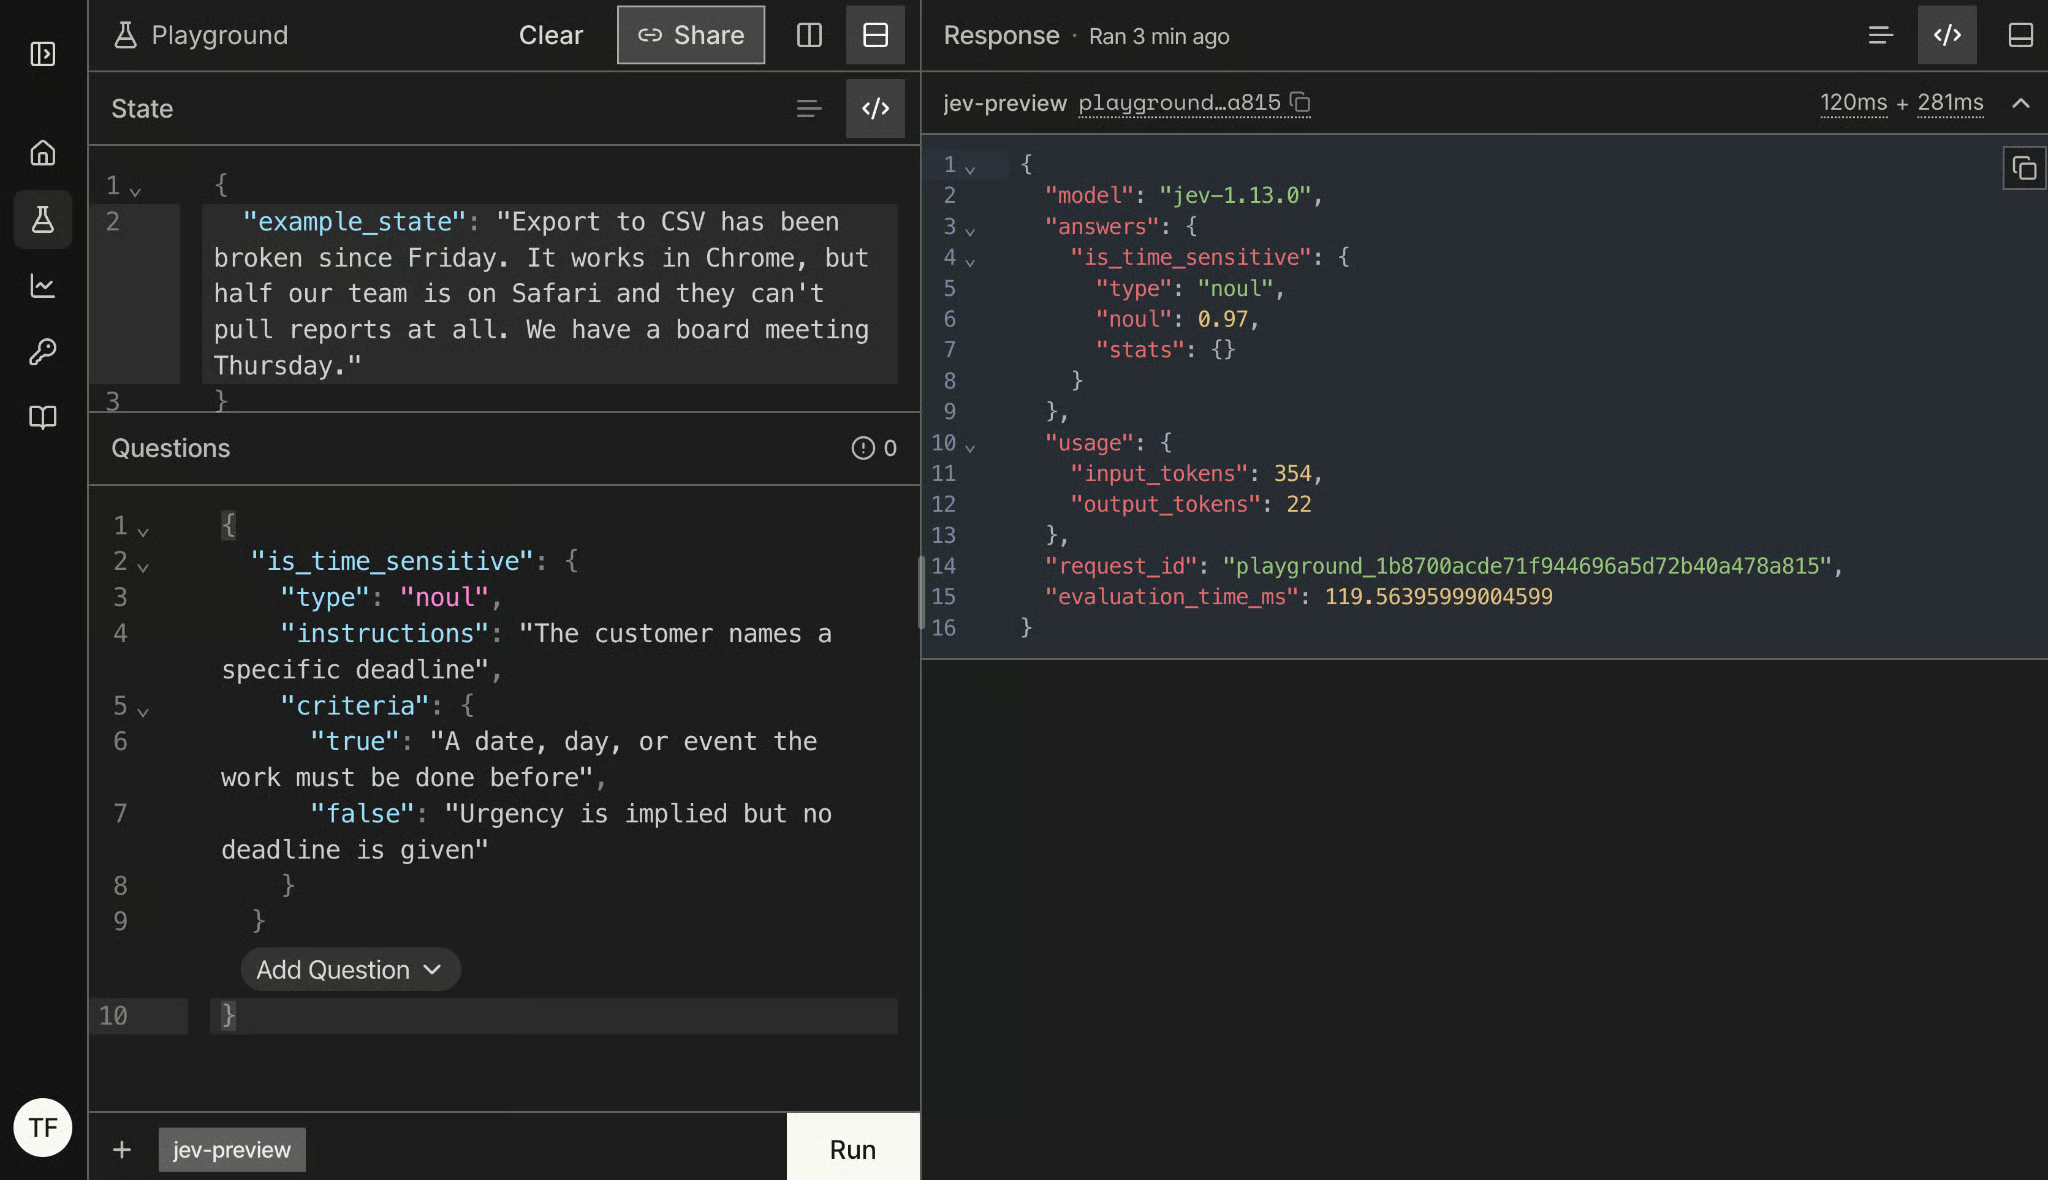
Comme l’état mentionne une réunion de conseil jeudi, la forte valeur de noul (0,97) est attendue.
Choice et Score renvoient une confiance en plus des probabilités. Noul non, et cela déroute ; voici pourquoi.
La confiance et la probabilité sont deux axes différents. Pour une Choice, les probabilités indiquent comment le modèle répartit sa croyance entre vos options, et la confiance indique à quel point il tient sa réponse, d’où une option en tête à 0,85 avec une confiance à 0,78. Un Noul n’a que deux issues ; la probabilité unique porte donc les deux : 0,97 est un oui très ferme, 0,03 un non très ferme, 0,52 signifie que le modèle n’en sait rien.
La distance à 0,5 est donc votre signal de décision, pas un champ séparé. Et vous ne pouvez pas reporter un seuil d’un Noul vers une Choice ; j’y reviens dans la section « rugosités », car c’est plus piégeux qu’il n’y paraît.
Pour suivre, vous n’avez besoin que de Python 3.10+ et d’une clé d’accès anticipé TypeSafe.
Installez le SDK :
pip install typesafe-sdkOu avec uv :
uv add typesafe-sdkCréez ensuite une clé dans la console TypeSafe et exportez-la. Le client lit TYPESAFE_API_KEY depuis l’environnement, vous ne la passez donc jamais en code :
export TYPESAFE_API_KEY="your-key"Les imports suivants vous donnent tout ce que vous avez dans le playground :
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul et Score sont les mêmes types de questions, sous forme d’objets Python.
TypeSafeClient est le client synchrone, et il existe un AsyncTypeSafeClient avec la même interface si vous appelez Jev depuis un service async. Les deux fonctionnent en context managers, ce que je recommande dès qu’on dépasse le simple script :
with TypeSafeClient() as client:
...Par défaut, le client appelle jev-latest, qui bouge à chaque nouvelle version ; c’est ce que nous utiliserons tout au long du tutoriel. Dès que vous avez réglé un seuil, figez la version :
client = TypeSafeClient(model="jev-1.13.0")La réponse vous dit de toute façon quel modèle a répondu, et nous verrons plus loin pourquoi vous devriez le journaliser.
Pour appeler l’API Jev, vous définissez un élément response avec TypeSafeClient et la fonction system_one(), qui prend votre contexte sous forme de state et les questions au même format que dans le playground.
Nous pouvons créer un appel qui répond à nos 3 questions du playground, puisqu’elles partagent le même state :
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Les réponses reviennent sous les mêmes noms que vous avez donnés aux questions, ce qui rend le tout très agréable à utiliser :
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Si votre premier appel échoue avec une TypeError à propos de output_buffer_limit : c’est un souci de version dans le backend de compression du SDK, pas dans votre code. Le SDK embarque son propre client HTTP, httpx2, qui décompresse via zstandard et brotli, et une ancienne copie de l’un des deux ne connaît pas l’argument passé. pip install -U typesafe-sdk httpx2 zstandard brotli a réglé le problème pour moi.
Deux points méritent un arrêt.
D’abord, response.model renvoie jev-1.13.0, pas jev-latest. Vous avez demandé l’alias mouvant et Jev vous dit quelle version a vraiment répondu, raison pour laquelle journaliser ce champ coûte peu et vaut la peine.
Ensuite, les objets réponses sont typés par type de question : .choice, .score et .noul sont de vrais attributs, connus de votre éditeur. Il n’y a aucun JSON brut ici, rien à parser, aucune branche pour une réponse mal formée. Si vous préférez regrouper, le SDK expose aussi response.choices, response.scores et response.nouls, avec les mêmes clés.
Vérifiez aussi response.usage :
print(response.usage.input_tokens, response.usage.output_tokens)524
78Les tokens de sortie sont à un chiffre et gratuits. Vous payez pour l’état et les questions, donc vous contrôlez pleinement le coût en choisissant combien de contexte envoyer. C’est plus important qu’il n’y paraît, et cela revient dans la section sur les rugosités : un état boursouflé vous coûte de l’argent et de la précision.
C’est un cas d’usage pour lequel Jev est conçu. Un ticket arrive, et il faut décider dans quelle file il va, si un humain doit le voir d’abord, et à quelle vitesse. Chacun de ces points est un jugement avec un espace de réponses que vous pouvez écrire avant même l’arrivée du ticket.
La règle de conception à énoncer clairement : Jev décide de ce qui est, votre code décide de ce qui se passe. Jev ne route jamais rien. Il renvoie des nombres, et le routage vit dans une fonction ordinaire que vous pouvez lire, tester et faire évoluer sans toucher au modèle.
Les questions d’une même requête sont évaluées en parallèle ; une sixième question ne coûte que ses tokens et presque pas de latence supplémentaire. Cela change votre façon de demander. Avec un LLM, vous regrouperiez pour économiser les allers-retours ; ici, vous posez tout ce qui pourrait vous servir sur un contexte donné, y compris des questions dont vous n’utiliserez sans doute pas la réponse.
Ajoutons trois Nouls qui nous donnent des signaux utiles sur le traitement du ticket :
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Six questions, une seule requête et une seule facture. is_automated est spéculative : c’est faux pour presque tous les vrais tickets, et cela vaut la peine de demander quand même car le jour où c’est vrai, vous épargnez à quelqu’un d’ouvrir un bounce de mailer-daemon.
Deux habitudes à prendre :
Gardez l’ensemble de questions en constante de module plutôt que de le construire inline : vous le versionnerez avec vos seuils.
Et nommez les questions selon ce qu’elles mesurent, pas selon l’action envisagée : is_time_sensitive survit à un changement de politique, pas route_to_incident.
Des formulations positives : on aurait pu appeler is_automated needs_no_reply, mais selon TypeSafe, les questions formulées positivement performent mieux.
Voici la partie que Jev ne fait pas. Chaque réponse arrive avec une confiance ou une probabilité, et ce deuxième nombre permet de bâtir trois voies au lieu de deux :
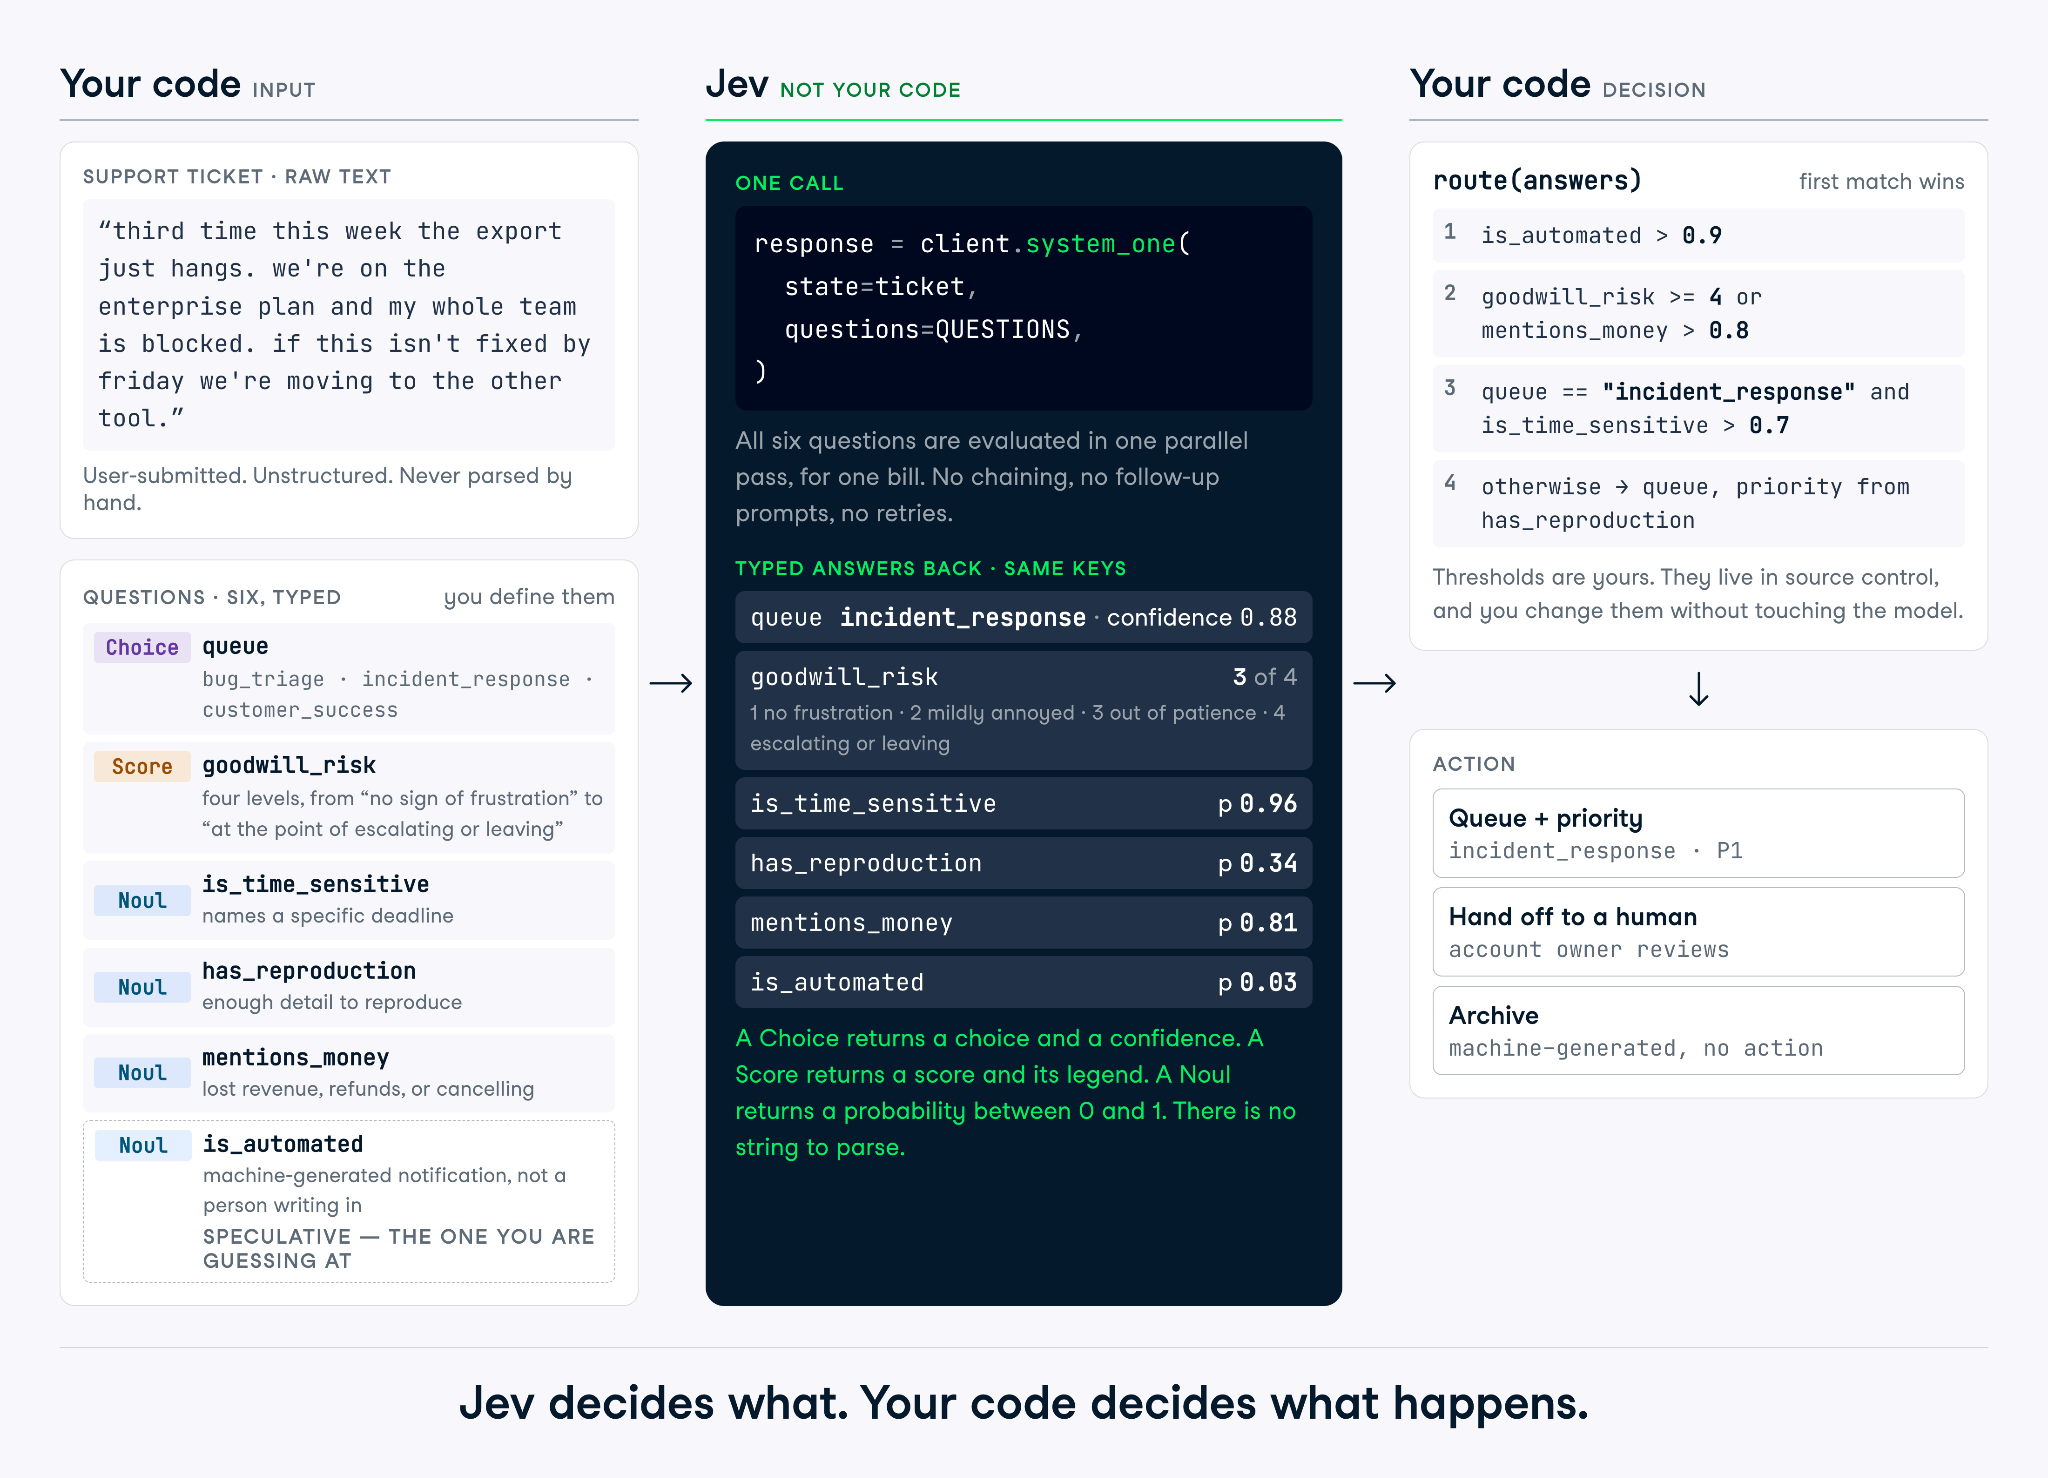
Traduisons cela en quelques règles de routage :
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Lisez bien ce que fait cette fonction. Le modèle a fourni six jugements, et la politique a décidé que l’un d’eux, mentions_money croisé avec un client frustré, prime sur la file choisie par Jev. Cet override est une décision métier, elle appartient au code, et vous pouvez la changer un vendredi après-midi sans retester un modèle.
has_reproduction n’est jamais utilisé. Je l’ai laissé volontairement, car c’est à cela que ressemble le fan-out en pratique : vous demandez plus que ce que consomme la politique actuelle, vous journalisez tout, et quand on vous demande si les tickets bug_triage sans étapes de repro sont plus longs à résoudre, vous avez déjà six semaines d’historique.
Les seuils ci-dessus sont illustratifs. Les bons réglages se trouvent par calibration, et une section en fin d’article explique comment les fixer avec des données, pas à l’intuition.
Vous pouvez accéder au script complet dans ce repo GitHub associé. En l’exécutant sur notre scénario, la décision a été de router le ticket vers l’équipe incident response aujourd’hui.
python routing.py('incident_response', 'today')TypeSafe publie une page de rugosité par version, listant les modes d’échec connus. J’aimerais que plus de labs fassent de même. Lisez-la avant de construire quoi que ce soit, et relisez-la au moment des montées de version : la liste est versionnée et les arêtes bougent.
Voici les cinq qui m’auraient fait perdre le plus de temps.
Vous ne pouvez pas porter un seuil d’un type de question à l’autre. L’exemple de TypeSafe demande « Le client demande-t-il un remboursement ? » des deux façons sur le même ticket : le Noul renvoie 0,22, la Choice oui/non renvoie 0,01 pour oui, avec 0,97 de confiance. Même question, deux nombres, deux ordres de grandeur.
Les négations ne coopèrent pas non plus. Un Noul et son opposé sont revenus à 0,72 et 0,47, ce qui fait 1,19.
La raison : les deux types demandent des choses différentes. Une Choice est relative et désigne un gagnant, tandis que chaque Noul est absolu et peut être bas pour toutes les options. Réglez vos seuils par question, dans la forme que vous livrerez, et n’assumez jamais que P(yes) et 1 - P(no) sont égaux.
Les niveaux d’un Score sont ordonnés, pas équidistants. Un 1,6 indique que le modèle se situe entre le deuxième et le troisième niveau, avec une pente vers le troisième, et c’est tout.
Ce que vous ne pouvez pas faire, c’est interpoler une grandeur réelle à partir de là. Si vos niveaux sont « moins d’une heure », « quelques heures », « une journée », un 1,5 ne vaut pas cinq heures. Servez-vous du score pour tester un seuil, puis gardez toutes les grandeurs réelles en code.
Jev traite l’état comme des données, mais il n’est pas blindé contre un état qui tente de le piloter. Une instruction injectée, un cadrage trompeur, ou un texte qui argumente pour sa propre classification peuvent infléchir la réponse, et TypeSafe dit vouloir améliorer cela. Si cette surface d’attaque est nouvelle pour vous, nous couvrons le cas général dans notre guide sur les prompt injections.
C’est crucial quand l’état est soumis par des utilisateurs, comme pour un routeur de tickets. Rédigez des critères assez précis pour que les affirmations du ticket sur lui-même ne décident pas de l’issue, et testez avec des entrées hostiles avant toute automatisation.
Le comptage est peu fiable et se dégrade avec la taille de l’ensemble, car le modèle reconnaît la forme de la réponse plus qu’il ne dénombre. Les dates sont lues comme du texte : tri, distances et fenêtres échouent. Les codages numériques sous-performent leurs équivalents sémantiques ; demandez « rouge » plutôt que #FF0000.
Le correctif est le même dans les trois cas : scindez le travail.
Si vous avez besoin d’un compte, itérez en code et posez un Noul par élément :
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Trois points liés. Jev répond à la question écrite, pas à l’intention. Les mots de cadrage et les négations sont pris au pied de la lettre. Les doubles négations et les questions sur la propriété d’une propriété coûtent de la précision. Un état volumineux, gonflé de détails hors sujet, coûte précision et argent, car le bruit distrait le modèle.
Le signe qui ne trompe pas : si, devant une mauvaise réponse, vous vous surprenez à expliquer ce que vous vouliez vraiment dire, cette explication manquait à vos instructions.
Sur la base de ce que nous avons vu, voici quelques bonnes pratiques pour tirer le meilleur de Jev.
Décrivez la condition, pas l’intention. Si vous expliquez ce que vous vouliez dire en révisant une mauvaise réponse, cette explication appartient aux instructions. Concrètement :
jev-latest bouge. Figez la version dès qu’un seuil dépend du comportement du modèle :
client = TypeSafeClient(model="jev-1.13.0")Journalisez response.model ainsi que les réponses complètes à chaque appel, pas seulement la valeur agissante. Quand un seuil se met à dévier, ce log est votre seul moyen de distinguer un changement de modèle d’une dérive de vos tickets.
Enfin, les seuils ne s’imposent pas : ils se testent.
Jev est un outil ciblé, et c’est justement son intérêt. Il répond à des questions dont vous pouvez énumérer les réponses, à un coût tel que vous cessez de les rationner, puis rend la décision à votre code.
Là où je nuancerais, c’est l’idée « ne peut pas halluciner ». Au sens strict, le modèle ne peut pas sortir du schéma ; mais cela ne garantit pas l’exactitude. Une Choice renvoie toujours une file valide ; elle peut tout de même être la mauvaise, avec 0,9 de confiance, et la sortie typée rend cet échec plus discret.
Pour tester sur votre contexte, trouvez une décision que votre code prend via une règle fragile ou un appel LLM lent, et essayez d’écrire les réponses valides. Si vous pouvez, c’est un cas « format Jev ». Sinon, aucune écriture de question n’y changera quoi que ce soit.
Pour démarrer avec la construction de systèmes qui utilisent l’IA, je vous recommande vivement de vous inscrire à notre Associate AI Engineer for Developers career track. Vous y apprendrez à travailler avec l’OpenAI API, MCP, LangChain, et bien plus.
Formez-vous à l'AI Engineering avec DataCamp !
Cursus
Cours
Cours