Tracks
開発者向けアソシエイトAIエンジニア
26時間
すでに述べたとおり、期待値はモデルに合わせる必要があります。特にJevではそれが当てはまり、主にそのモデルクラス(System Oneモデルと呼ばれる)に関係します。
System Oneモデルはテキストではなく、型付きの判断を返します。状態のブロックと、各自が定義した回答空間を持つ質問の集合を送ると、モデルは各質問に対して確率付きの1つの回答を返します。トークン逐次生成は行わないため、文字列をパースしたり、不正なJSONを修復する必要はありません。TypeSafeはこの用語をダニエル・カーネマンの有名な二分法に由来させています:
回答空間はコード側で宣言するスキーマなので、System Oneモデルは設計上、未定義のカテゴリを返すことがありません。つまりスキーマ外にはなりえません。ただし、間違うことはありえます。その厄介な事例はいくつか後で扱います。
TypeSafeは2026年9月15日にステルスを抜け、Jevの早期アクセスを開始。応答時間は70〜500ms、入力100万トークンあたり$0.042、出力は無料と公表しました。独自の4ワークフローベンチマークでは、Jevは約68%の精度で、中堅LLM並みの性能をごく一部のコストで達成しています。
機能やベンチマークの詳細は、当社のJevガイドをおすすめします。
呼び出す前に、有効な回答を書き出してください。列挙できるなら、それはJev向きの課題です:
LLMは、出力が文章やコードであるとき、回答空間がオープンなとき、あるいは複数段の推論を連鎖させる必要があるときに使ってください。Jevは数値関連にも不向きで、その理由は後ほど説明します。
コードを書く前に、TypeSafeアカウントを作成し、Playgroundを開いてください。ここでは、テキストを状態として貼り付け、質問を追加し、インストール不要で完全な回答オブジェクトを確認できます。各質問タイプが何を返すかを最速で理解でき(そして、質問の書き方が悪いかどうかも分かります)。
3つの例すべてで、同じサポートチケットを状態として使います:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.あらゆる質問タイプはinstructions(求める回答を自然言語で述べたもの)を受け取ります。タイプ間で変わるのはcriteriaと、返ってくる内容です。
Choice は、定義した集合から1つを選びます。
criteriaは 辞書オブジェクトとして渡し、各オプションを説明にマッピングします(1〜255まで)。回答には以下が含まれます:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}APIで受け取るコード出力を確認するには、右上の</>ボタンをクリックし、Runを押してJevに回答させてください。
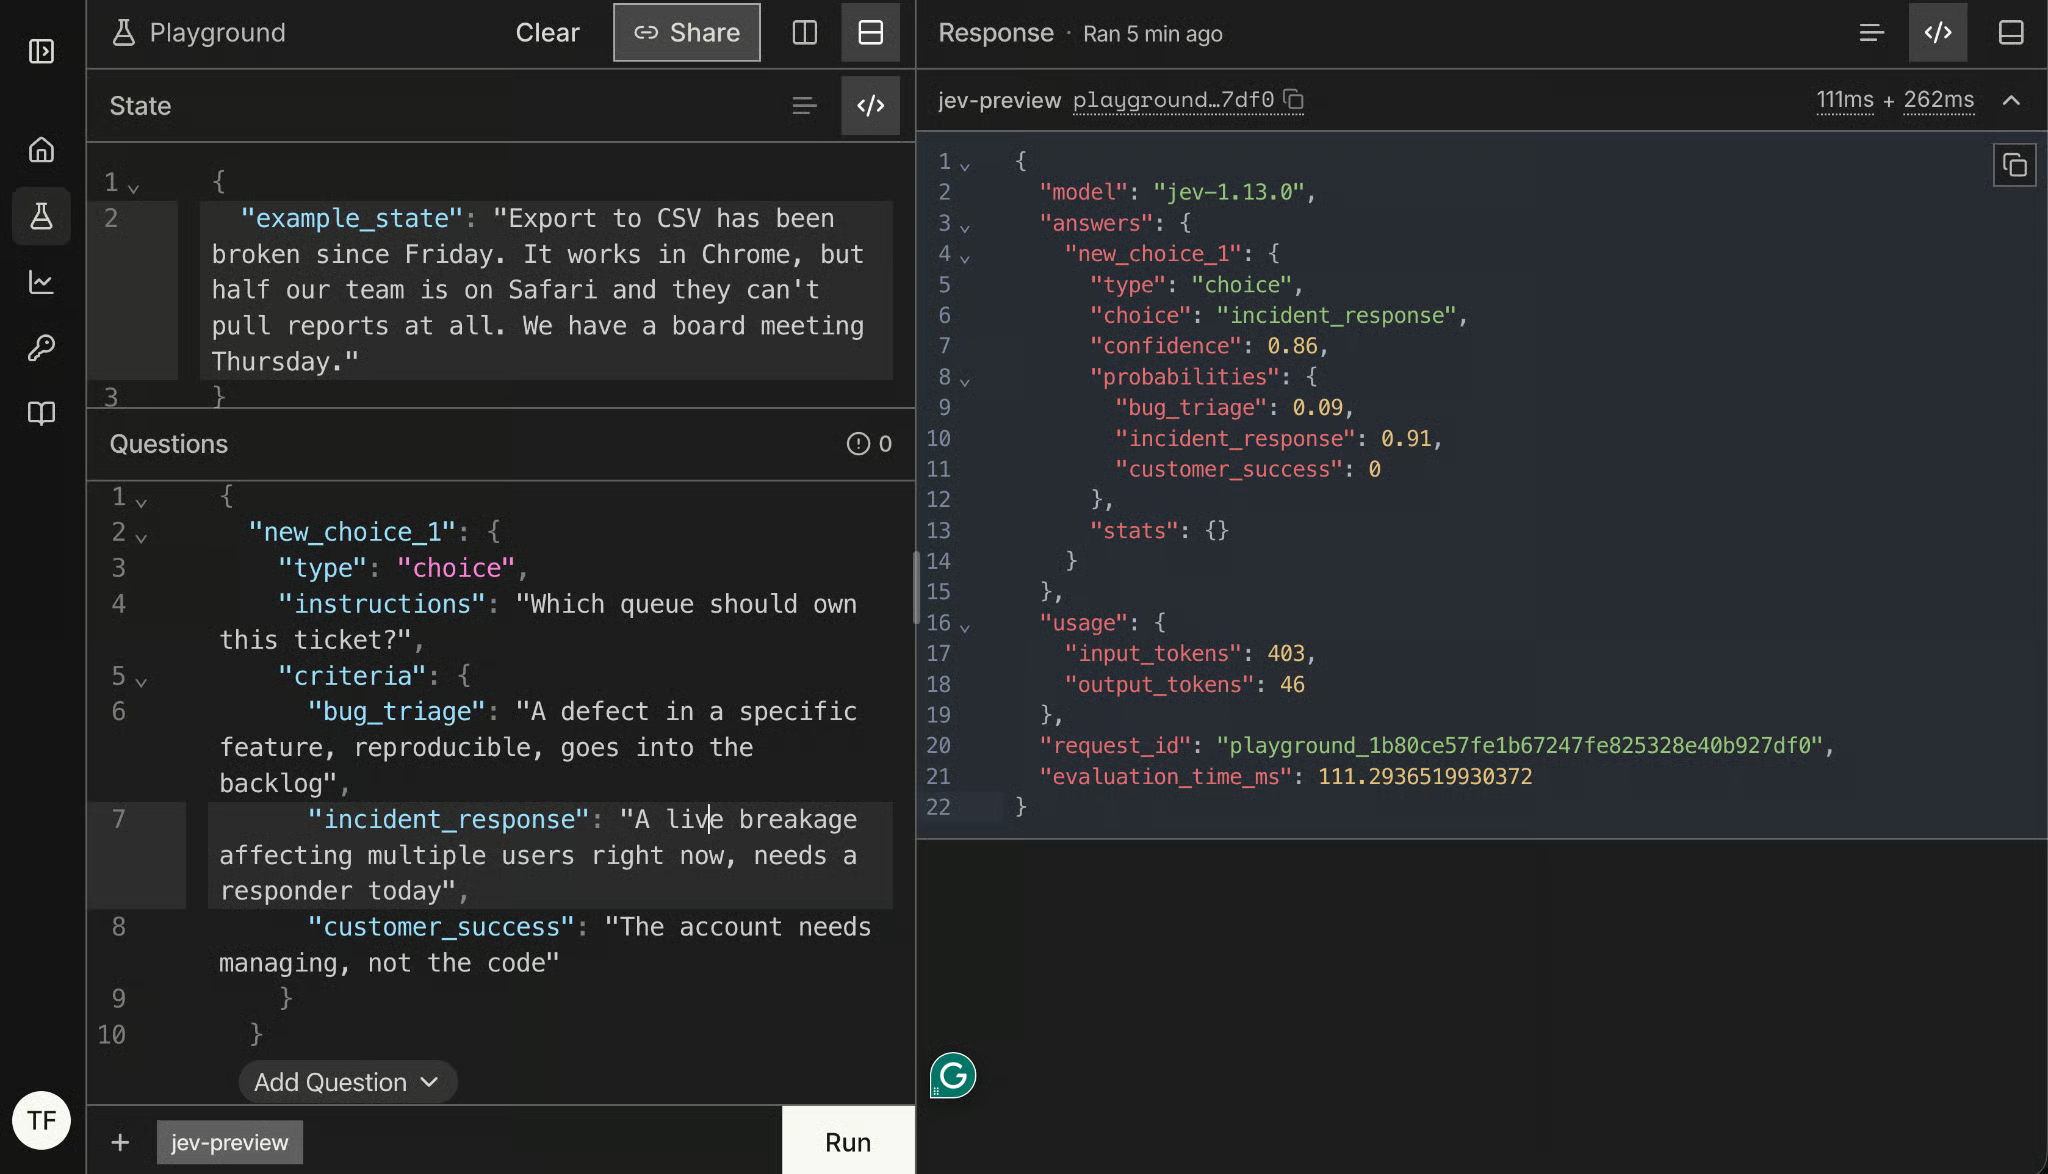
このケースでは、incident_responseがchoiceで91%の確率。選択に対するJevのconfidenceは86%です。
注目すべきは確率分布の全体です。
choiceは、どのオプションが勝ったかだけを示します。
probabilitiesは、その勝ち方の強さを示します。
自動でチケットをルーティングしようとする際、これは異なる情報です。0.41/0.38/0.21の分布と、今回の0.91/0.09/0の分布は、どちらも同じchoiceを返し得ます。
Scoreは、状態を順序づいたレベルで評価します。criteriaは配列として2〜10個のレベル説明を低い方から渡します。回答にはスコア、位置と説明を対応させるlegend、各レベルの確率、確信度が含まれます。
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}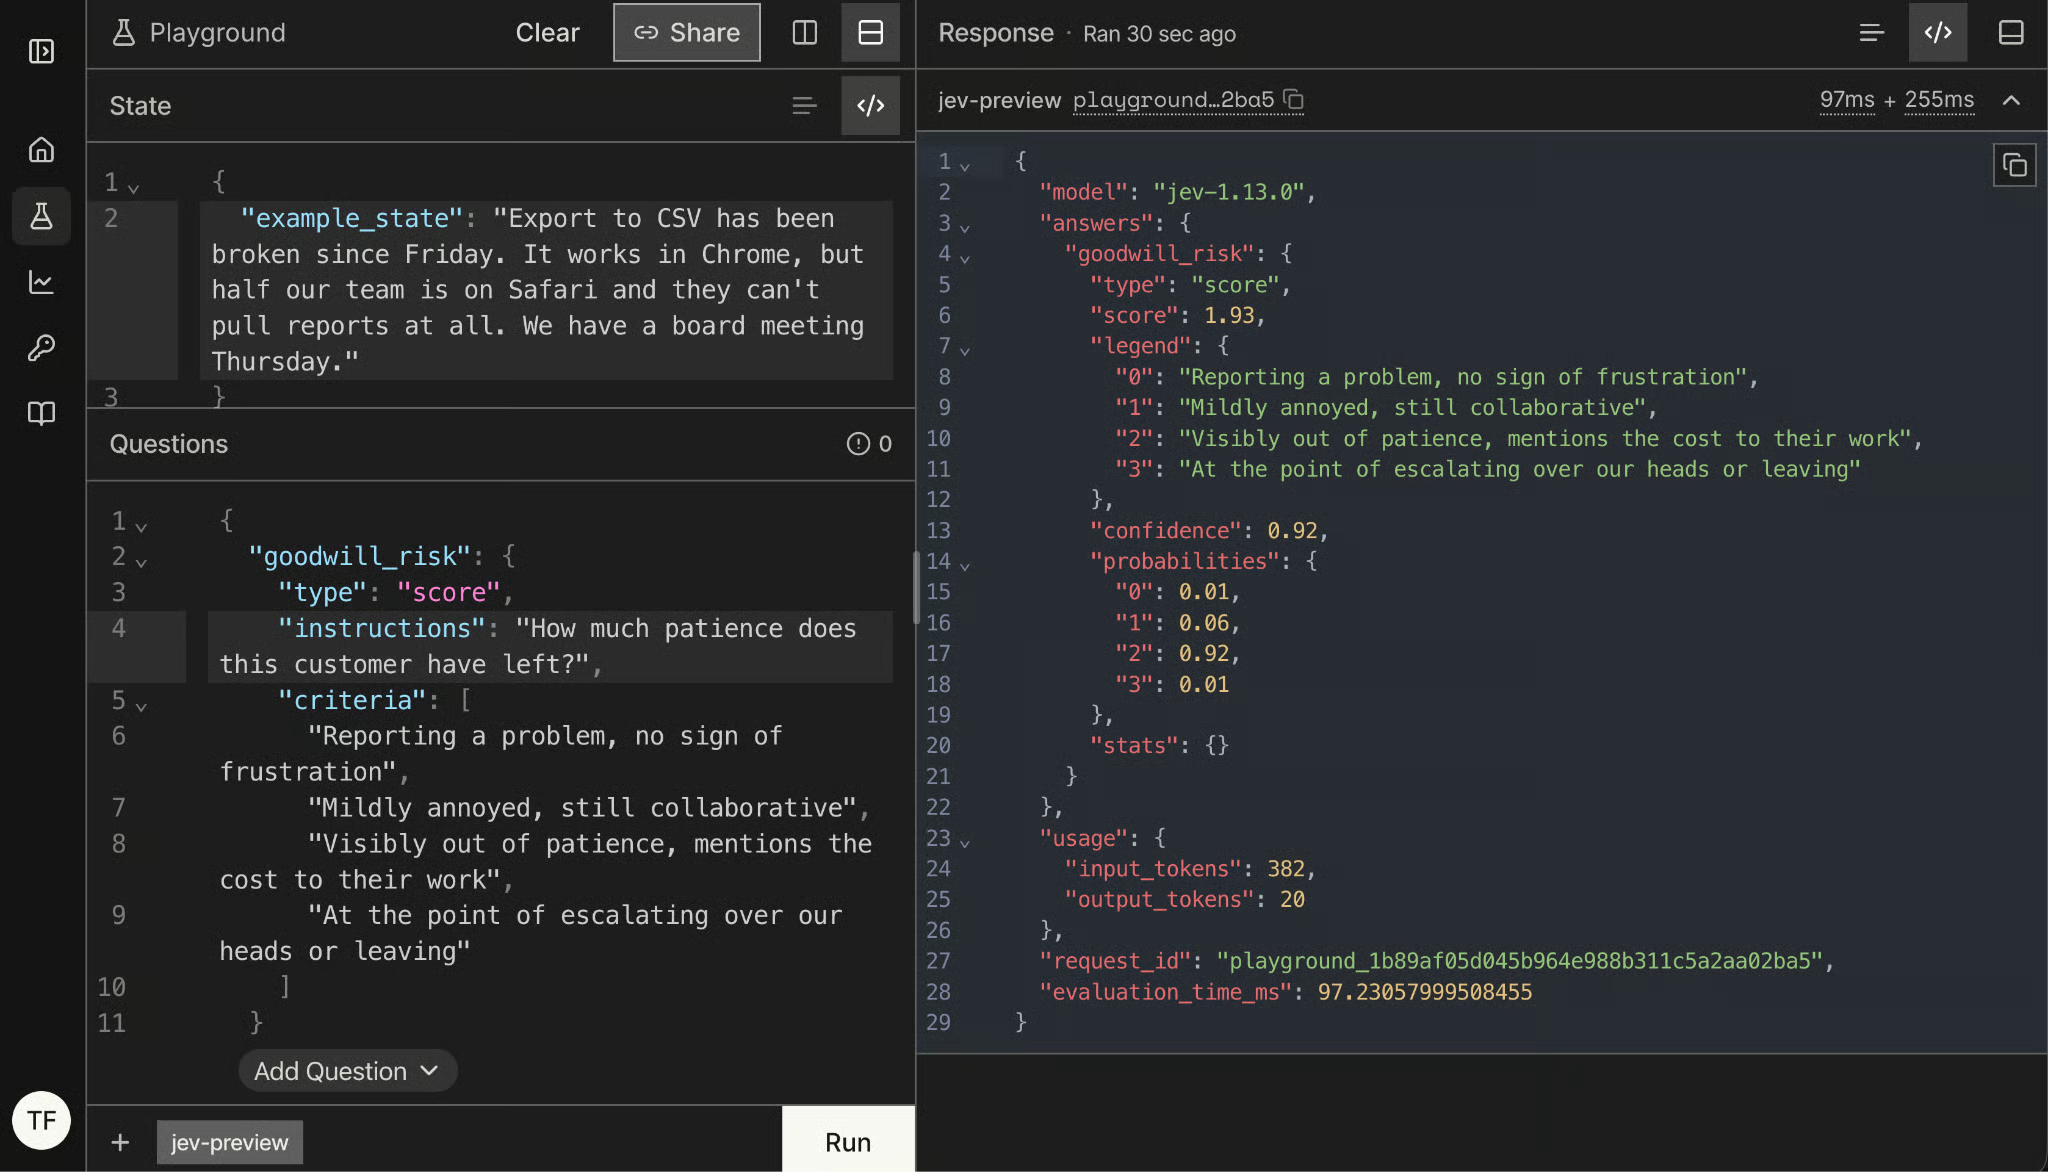
スコアはレベル間に着地することがあり、それがlegendの要点です。ここでのscoreが1.93というのは、モデルが「やや不満」と「明確に我慢の限界」の間にあり、後者寄りであることを意味します。締切に間に合わないことを述べつつ、丁寧さは保っているチケットの読みとして妥当です。
今回も数値だけでなくprobabilitiesの広がりを見てください。1つのレベルに確率が集中していれば決定的な回答、3つに広がっていれば判断ではなく平均を得ただけです。
Noulは二値質問のタイプで、名称はTypeSafeが作りました。ここではcriteriaは任意ですが、trueとfalseの意味を記述できます。「はい」が二通りに読める場合は特に有用です。
高い値が「はい」を意味するように質問を作ってください。TypeSafeのドキュメントでも明記されており、trueが「いいえ」に対応するNoulは性能が有意に悪化します。
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}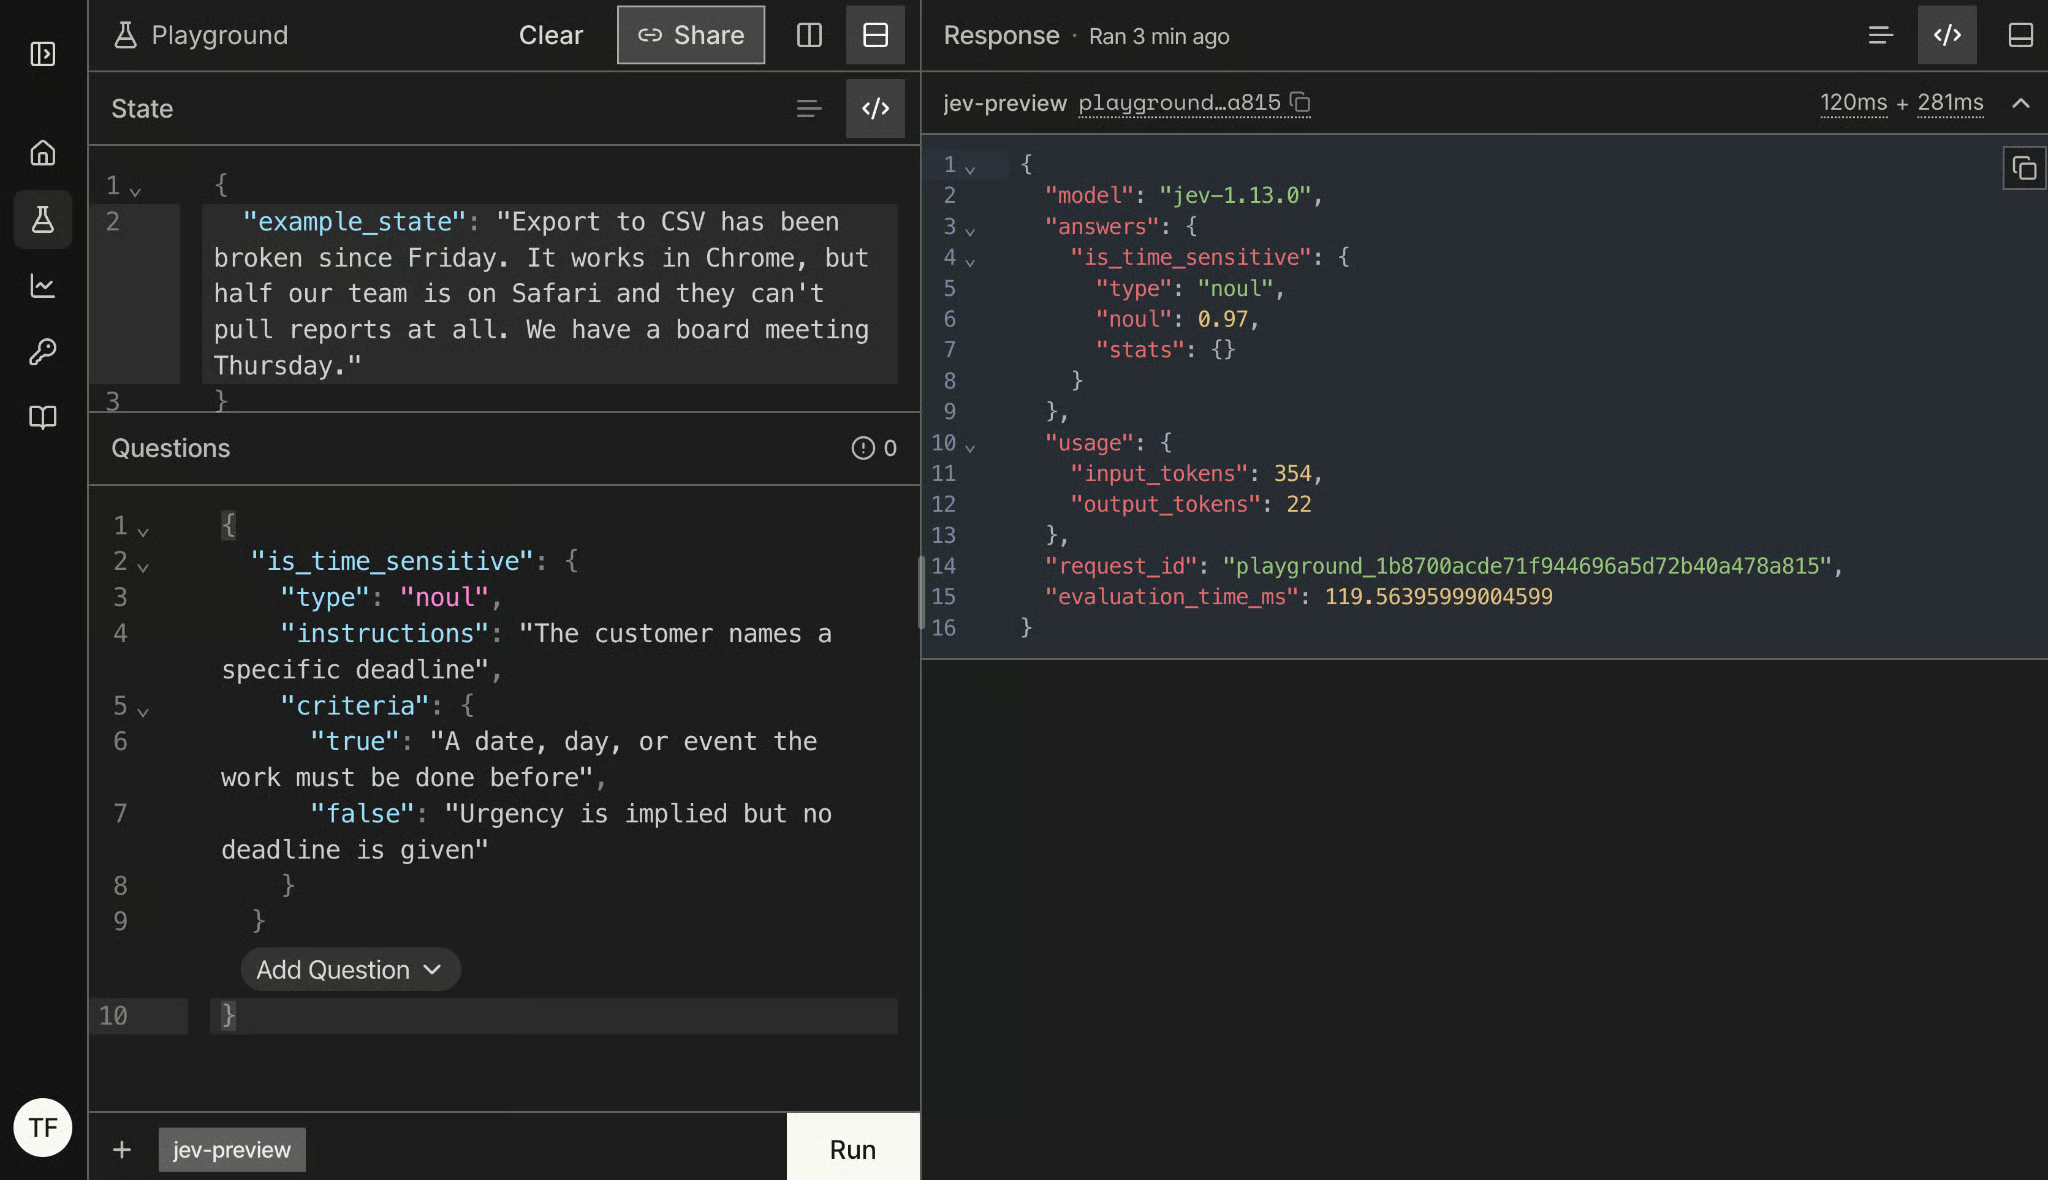
状態内に「木曜の取締役会」が記載されているため、高いnoul値0.97は想定どおりです。
ChoiceとScoreは確率と併せて確信度を返します。Noulは返しません。ここでつまずく人が多いので、その理由を正確に押さえておきましょう。
確信度と確率は別軸です。Choiceでは、確率がオプション間の信念の配分を示し、確信度がその答えの確からしさを示します。だからこそ、トップのオプションが0.85で確信度0.78のような結果がありえます。Noulは結果が2つしかないため、単一の確率がすでに両方を担います。0.97は強い「はい」、0.03は強い「いいえ」、0.52はモデルが「分からない」と伝えています。
つまり、0.5からの距離が決定性のシグナルであり、別個のフィールドを読む必要はありません。また、Noulのしきい値をChoiceに流用することはできません。これはギザギザの項で改めて触れますが、見た目以上に痛手になります。
ここまでを追うには、Python 3.10+とTypeSafeの早期アクセスキーだけで十分です。
SDKをインストールします:
pip install typesafe-sdkあるいはuvで:
uv add typesafe-sdk次にTypeSafeコンソールでキーを作成し、エクスポートします。クライアントは環境変数TYPESAFE_API_KEYを読み取るため、コードで直接渡すことはありません:
export TYPESAFE_API_KEY="your-key"以下のインポートでPlaygroundの機能をすべて利用できます:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice、Noul、Scoreは、いまクリックで確認したのと同じ質問タイプをPythonオブジェクトとして提供します。
TypeSafeClientは同期クライアントで、asyncサービスからJevを呼ぶ場合は同一インターフェースのAsyncTypeSafeClientがあります。どちらもコンテキストマネージャとして動作し、スクリプト以上の用途ならこれを使うのがおすすめです:
with TypeSafeClient() as client:
...デフォルトではクライアントはjev-latestを呼びます。これはTypeSafeが新バージョンを出すたびに動くエイリアスで、このチュートリアルではそのまま使います。すでにしきい値を調整済みの用途では、代わりにバージョンを固定してください:
client = TypeSafeClient(model="jev-1.13.0")レスポンスは、どのモデルが実際に回答したかをいずれにせよ教えてくれます。これをログに残すべき理由については、末尾近くで触れます。
JevへAPIコールするには、TypeSafeClientとsystem_one()関数を使ってresponse項目を定義します。関数は質問のコンテキストをstateとして、質問そのものをPlaygroundと同じ形式で受け取ります。
3つのPlayground質問は同じstateを共有しているので、1回の呼び出しでまとめて回答させられます:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
回答は、各質問に付けた同じ名前の下に返ってきます。これが、全体の扱いを快適にしているポイントです:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97最初の呼び出しがoutput_buffer_limitに関するTypeErrorで失敗した場合:それはSDKの圧縮バックエンドのバージョン不整合で、あなたのコードの問題ではありません。SDKは独自のHTTPクライアントhttpx2をバンドルし、レスポンスの解凍にzstandardとbrotliを使いますが、どちらかの古い版が、呼び出しに必要な引数を欠いています。pip install -U typesafe-sdk httpx2 zstandard brotliで私の環境では解決しました。
この出力で注目すべき点が2つあります。
まず、response.modelが返したのはjev-latestではなくjev-1.13.0でした。可動エイリアスを指定しても、実際に回答したバージョンをJevが教えてくれます。これが、そのフィールドをログに残すコストが十分低く、やる価値がある唯一の理由です。
次に、回答オブジェクトは質問タイプごとに型が付いており、.choice、.score、.noulは実在の属性で、エディタも認識します。このコード内にJSON文字列は一切なく、パースも不要、壊れたレスポンスの分岐も不要です。グルーピングが好みなら、SDKはresponse.choices、response.scores、response.noulsも同じキーで提供します。
response.usageも確認してください:
print(response.usage.input_tokens, response.usage.output_tokens)524
78出力トークンは一桁台で無料です。コストは状態と質問に対して発生するため、どれだけのコンテキストを送るかで完全に制御できます。これは見た目以上に重要で、ギザギザの項でも触れます。膨れた状態はコストと精度の両方を同時に悪化させます。
これはJevが設計上得意とするユースケースの1つです。サポートチケットが届いたら、どのキューへ送るか、まず人間が見るべきか、対応速度をどうするか、を決める必要があります。どれも、チケットが来る前に回答空間を書き出せる判断です。
最初に明言しておく設計ルール:Jevは「事実」を判断し、「何をするか」はコードが決めます。Jev自体は何もルーティングしません。数値を返し、ルーティングはモデルに触れずに読めてテストできて変更できる通常の関数に置きます。
1つのリクエスト内の質問は並列評価されるため、6問目のコストは質問文のトークン分と、ほとんど増えないレイテンシーだけです。これは質問の仕方を変えます。LLMでは往復時間を節約するために慎重にバッチ化しますが、ここでは、そのコンテキストについて欲しい可能性のあることはすべて聞き、たとえ後で無視するにしても問います。
先ほどの質問に、チケット対応のために重要な情報を与える3つのNoulを追加しましょう:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
response = client.system_one(state=ticket, questions=QUESTIONS)6つの質問が、1回の呼び出しと1回分の課金で済みます。is_automatedはやや博打的ですが、実チケットのほとんどでfalseでも、1回でもtrueならメールデーモンのバウンスを人が開かずに済みます。
ここで身につけたい習慣が2つあります。
質問セットはインラインで組み立てず、モジュールレベルの定数として持ちましょう。しきい値と並行してバージョン管理する対象だからです。
質問名は、回答後に行うアクションではなく、測っている対象にちなんで付けましょう。is_time_sensitiveはポリシー変更後も生きますが、route_to_incidentはそうではありません。
質問は肯定的に表現:例えばis_automatedをneeds_no_replyのようにも呼べますが、TypeSafeによると肯定形のほうが性能が良いとのことです。
ここからはJevがやらない部分です。各回答には確信度または確率が付いており、その2つ目の数値によって、2分岐ではなく3分岐を作れます:
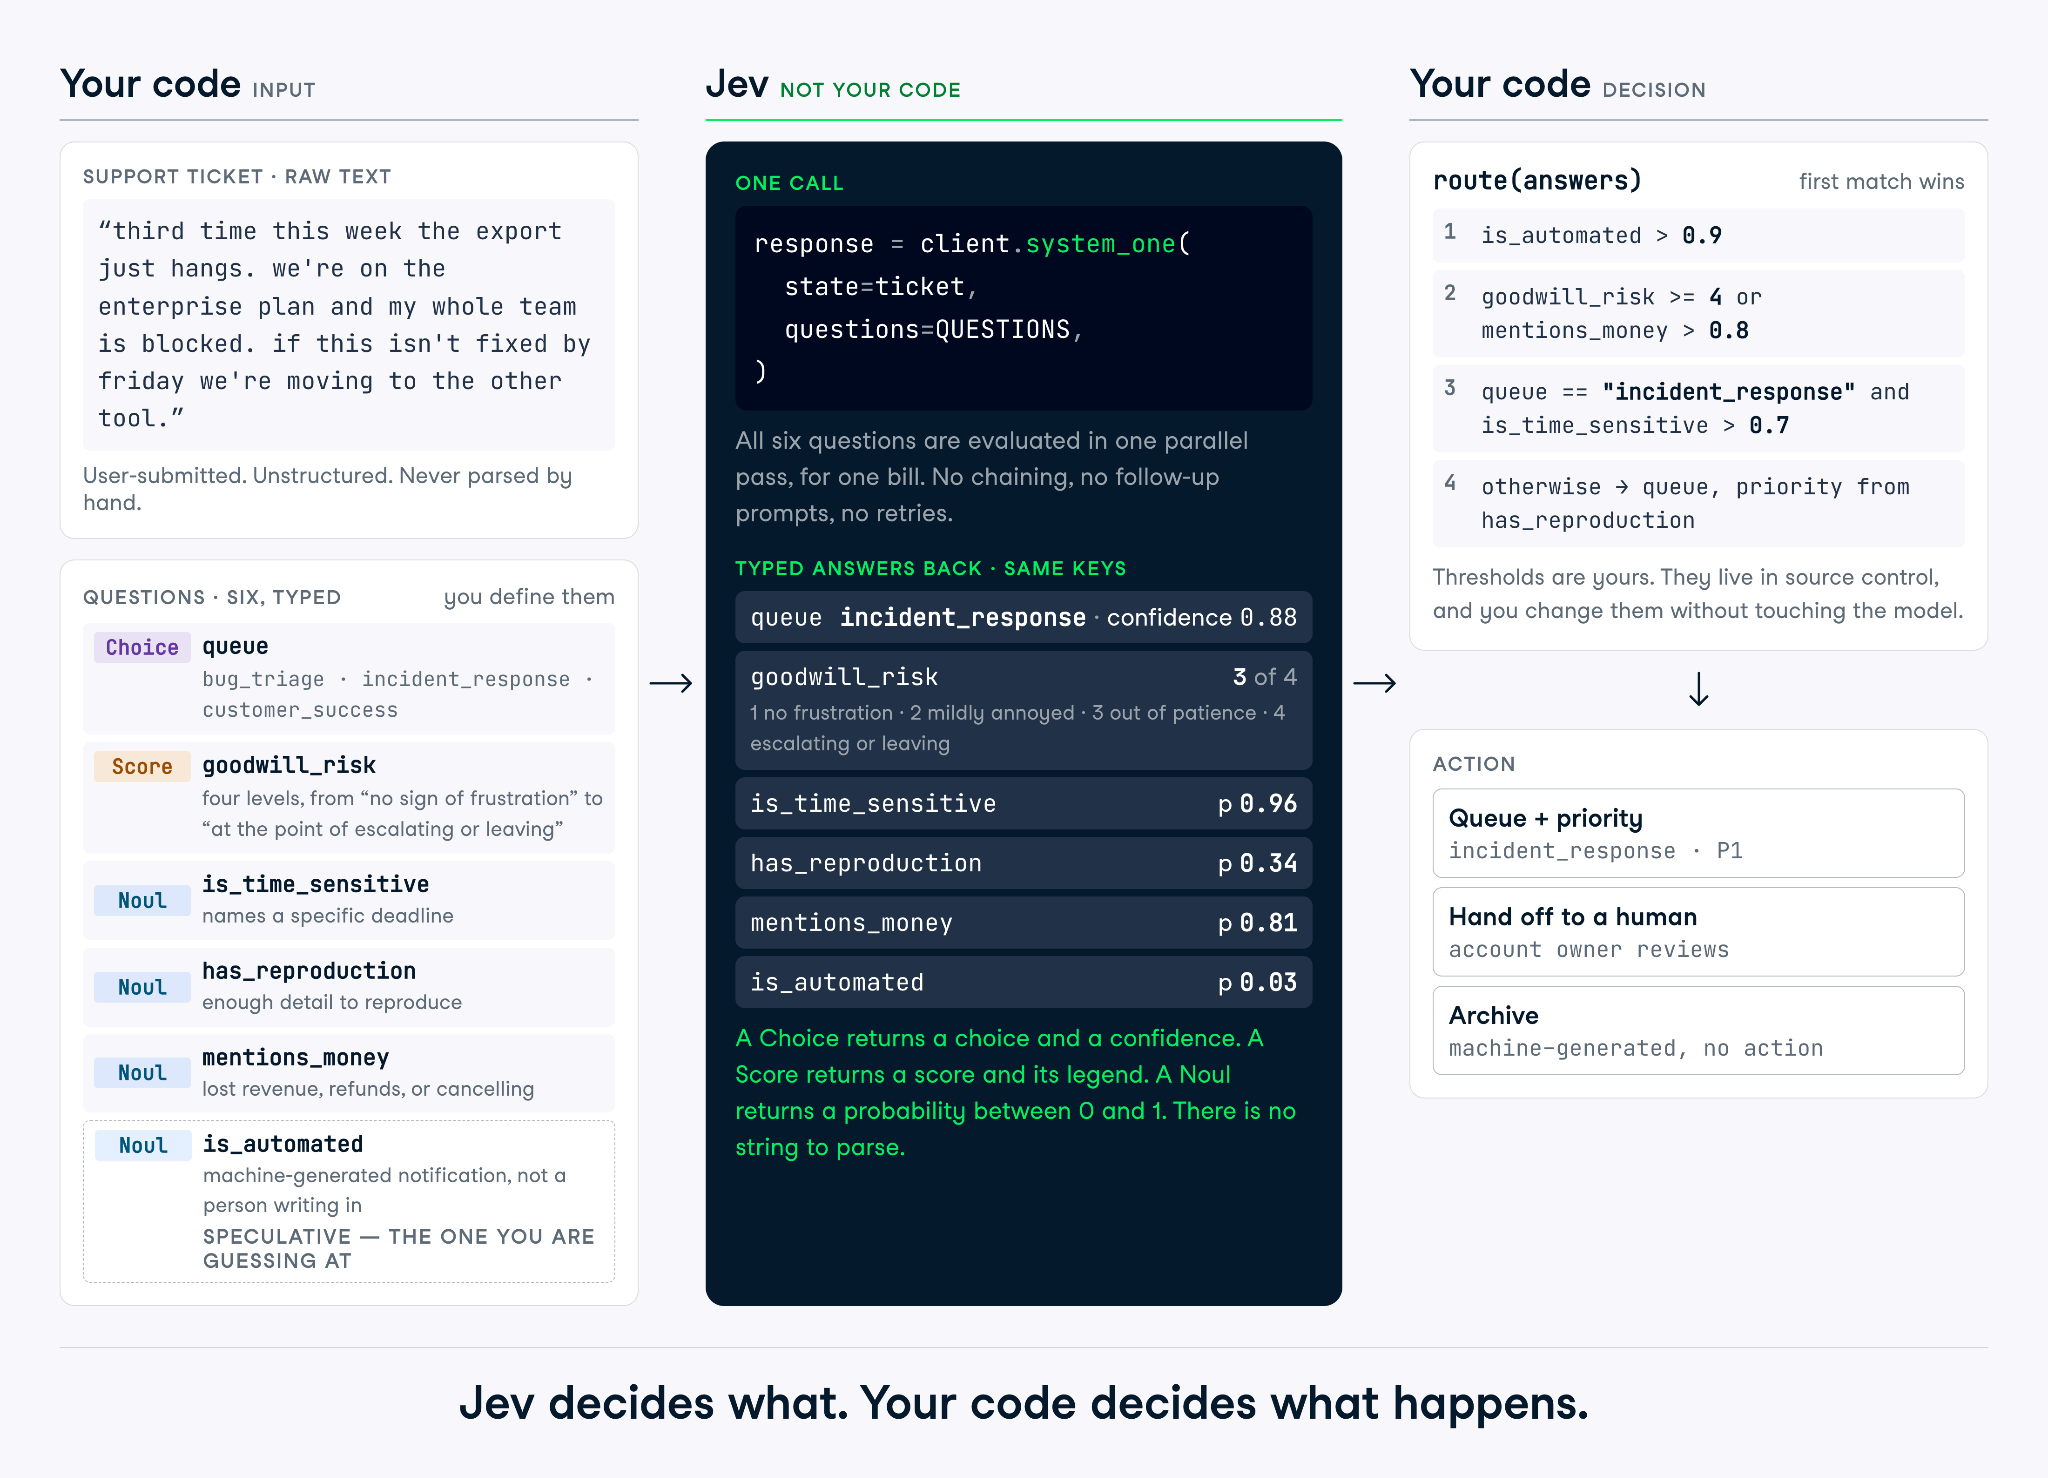
これをチケットのルーティング規則に落とし込みます:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
return queue.choice, priorityこの関数が何をしているかを読んでください。モデルは6つの判断を提供し、ポリシーはそのうちmentions_moneyと不満度の掛け合わせが、Jevの選んだキューよりも優先されると決めています。この上書きはビジネス判断であり、コードに置くのが筋です。そして金曜の午後にモデルを再テストせずとも変更できます。
has_reproductionは使っていません。意図的に残しました。実際のファンアウトではこうなるからです——現行ポリシーが使う以上の質問を投げ、すべてログに残し、後から「再現手順のないbug_triageチケットはクローズまで長引くか?」と問われたとき、すでに6週間分の答えがある、という具合です。
上のしきい値はあくまで例です。適切なしきい値の決定は較正の問題であり、最後にデータで設定する方法を説明します。
完全なスクリプトは付随のGitHubリポジトリで参照できます。今回のシナリオでPythonスクリプトを実行すると、判断は「本日、インシデント対応チームにルーティング」となりました。
python routing.py('incident_response', 'today')TypeSafeはモデルのバージョンごとにギザギザのページを公開し、既知の失敗モードを列挙しています。こうした取り組みは他の研究所にも広がってほしいものです。何かを作る前に読み、アップグレード時にも読み返してください。リストはバージョン管理され、縁(弱点)は動きます。
私が最も時間を浪費しかねないと感じたのは次の5つです。
質問タイプをまたいでしきい値を移植できません。TypeSafe自身の例では、同じチケットに対し「顧客は返金を求めているか?」を両形式で聞いたところ、Noulは0.22、はい/いいえのChoiceでは「はい」0.01、確信度0.97でした。同じ質問で、数値は2桁違います。
否定も協調しません。あるNoulとその反対は0.72と0.47で、合計は1.19になりました。
理由は、2つのタイプが聞いているものが違うからです。Choiceは相対的で、どのオプションが勝つかを決めます。一方で各Noulは絶対的で、すべてが低いこともありえます。しきい値は、出荷する形で、質問ごとに調整しましょう。P(yes)と1 - P(no)が同じ数だと決めつけないでください。
Scoreのレベルは順序づいていますが、等間隔ではありません。1.6は、2番目と3番目の間で3番目寄りだと教えるだけです。
できないのは、そこから実数値を補間すること。 レベルが「1時間未満」「数時間」「1日」だとしても、1.5は5時間を意味しません。Scoreはしきい値判定に使い、実数はすべてコード側で持ってください。
Jevは状態をデータとして扱いますが、誘導するように書かれた状態に対する耐性は十分ではありません。注入された指示、ミスリーディングな枠組み、自分の分類を主張するテキストは、回答を動かし得ます。TypeSafeはここを改善予定だと述べています。攻撃面が初めてという方は、一般論を当社のプロンプトインジェクションガイドで扱っています。
これは、状態がユーザー投稿である場合に最も重要です。チケットルーターでは常にそうです。チケット自身の自己申告が結果を決めないよう、criteriaを十分に精密に書き、自動ルーティング前に悪意ある入力でテストしてください。
カウントは信頼できず、対象が増えるほど悪化します。モデルは合計するのではなく答えの形を認識するからです。日付はテキストとして読まれるため、順序、距離、ウィンドウが破綻します。数値エンコーディングは意味的な同等物より劣るため、#FF0000より「赤」と尋ねてください。
対策は3つとも同じです:作業を分割する。
カウントが必要なら、コードで反復し、アイテムごとにNoulを1つずつ問います:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)原因を同じくする小さなものが3つ。Jevは書かれた質問に答え、「意図した質問」には答えません。範囲を定める語や否定は字義どおりに読み取られます。二重否定や「性質の性質」を問う質問は精度を落とします。不要な詳細でパディングされた大きな状態は、無関係な情報が気を散らすため、精度とコストの両方を悪化させます。
最初の見分け方:誤答を見て「本当に言いたかったのは…」と自分で説明しているなら、その説明がinstructionsに欠けている半分です。
ここまでの学びを踏まえ、Jevを最大限活用するためのベストプラクティスをいくつか。
意図ではなく条件を書く。誤答をレビューして「言いたかったのは…」と説明する羽目になったら、その説明はinstructionsに入れるべきです。つまり:
jev-latestは動きます。しきい値がモデルの挙動に依存する段階では、バージョンを固定してください:
client = TypeSafeClient(model="jev-1.13.0")毎回、response.modelと、実際に行動した値だけでなく完全な回答を併せてログに残しましょう。しきい値の挙動が変になったとき、そのログだけが、モデル変更なのかチケット側のドリフトなのかを区別する手がかりです。
最後に、しきい値は所与ではなく、実験の結果です。
Jevはスコープの狭いツールですが、まさにそれが狙いです。列挙可能な答えのある質問に安価に答え、遠慮なく質問を増やせるようにし、最終判断はコードへ返します。
「幻覚しない」という表現には異議があります。狭い意味では、モデルがスキーマ外の回答を出せないのは事実ですが、正しさを保証するものではありません。Choiceは常に有効なキューを返します。しかし0.9の確信度で誤ったキューを返すことはありえますし、型付き出力はその失敗を静かにします。
自分の仕事で試すには、コードが脆いルールや遅いLLM呼び出しで決めている判断を1つ見つけ、正当な回答を列挙できるかを書き出してみてください。できるなら、それはJev向き。できないなら、どれだけ質問を工夫しても変わりません。
AIを使うシステム作りを始めるなら、Associate AI Engineer for Developers キャリアトラックがおすすめです。OpenAI API、MCP、LangChainなど、幅広く学べます。
DataCampでAIエンジニアリングを学ぼう!
Tracks
Courses
Courses