
Tracks
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Tôi đã nói rằng kỳ vọng phải phù hợp với mô hình. Điều này đặc biệt đúng với Jev, và chủ yếu liên quan đến lớp mô hình của nó, được gọi là System One.
Một mô hình System One trả về các quyết định có kiểu thay vì văn bản. Bạn gửi một khối trạng thái cùng tập câu hỏi, mỗi câu có không gian đáp án do bạn định nghĩa, và mô hình trả về một câu trả lời cho mỗi câu hỏi với xác suất đi kèm. Không có việc tạo theo từng token, nên không có chuỗi để parse và cũng không có JSON lỗi định dạng để sửa. TypeSafe đặt thuật ngữ này dựa trên phân đôi nổi tiếng của Daniel Kahneman:
Vì không gian đáp án là một schema do mã của bạn khai báo, các mô hình System One theo thiết kế sẽ không bao giờ trả về một hạng mục bạn chưa định nghĩa. Điều này có nghĩa là nó không thể lệch schema. Dù vậy, nó vẫn có thể sai, và chúng ta sẽ bàn một vài ca khó ngay sau.
TypeSafe ra mắt khỏi chế độ stealth vào ngày 15 tháng 9, 2026, với Jev ở giai đoạn truy cập sớm, báo cáo thời gian phản hồi 70 đến 500 ms và $0,042 mỗi triệu token đầu vào, đầu ra miễn phí. Trên bộ benchmark bốn quy trình của chính họ, Jev đạt khoảng 68% độ chính xác, xấp xỉ tầm trung của LLM với chi phí chỉ bằng một phần nhỏ.
Để biết thêm về tính năng và hiệu năng benchmark, tôi khuyến nghị đọc hướng dẫn Jev của chúng tôi.
Hãy viết ra các đáp án hợp lệ trước khi bạn gọi. Nếu bạn có thể liệt kê chúng, bạn đang có một vấn đề hợp với Jev:
Hãy dùng một LLM khi đầu ra là văn bản hoặc mã, khi không gian đáp án là mở, hoặc khi nhiệm vụ cần vài bước lập luận xâu chuỗi. Jev cũng là công cụ sai cho mọi thứ liên quan đến số, và tôi sẽ quay lại lý do sau.
Trước khi viết bất kỳ mã nào, hãy tạo tài khoản TypeSafe và mở Playground. Tại đây, bạn có thể dán văn bản làm trạng thái, thêm câu hỏi, và xem đầy đủ đối tượng câu trả lời mà không cần cài đặt gì. Đây là cách nhanh nhất để hiểu mỗi loại câu hỏi trả về gì (và để biết câu hỏi của bạn có diễn đạt tệ không).
Tôi sẽ dùng một vé hỗ trợ làm trạng thái cho cả ba ví dụ:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Mỗi loại câu hỏi đều nhận instructions, tức câu hỏi ngôn ngữ tự nhiên bạn muốn được trả lời. Thứ thay đổi giữa chúng là criteria, và những gì được trả về.
Một Choice chọn một phương án từ tập bạn định nghĩa.
Bạn truyền criteria dưới dạng một từ điển ánh xạ mỗi phương án tới mô tả, từ 1 đến 255 lựa chọn, và câu trả lời trả về gồm:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Để xem đầu ra dạng mã mà bạn cũng sẽ nhận qua API, nhấp nút </> ở góc phải trên cùng, rồi nhấp Run để Jev trả lời câu hỏi.
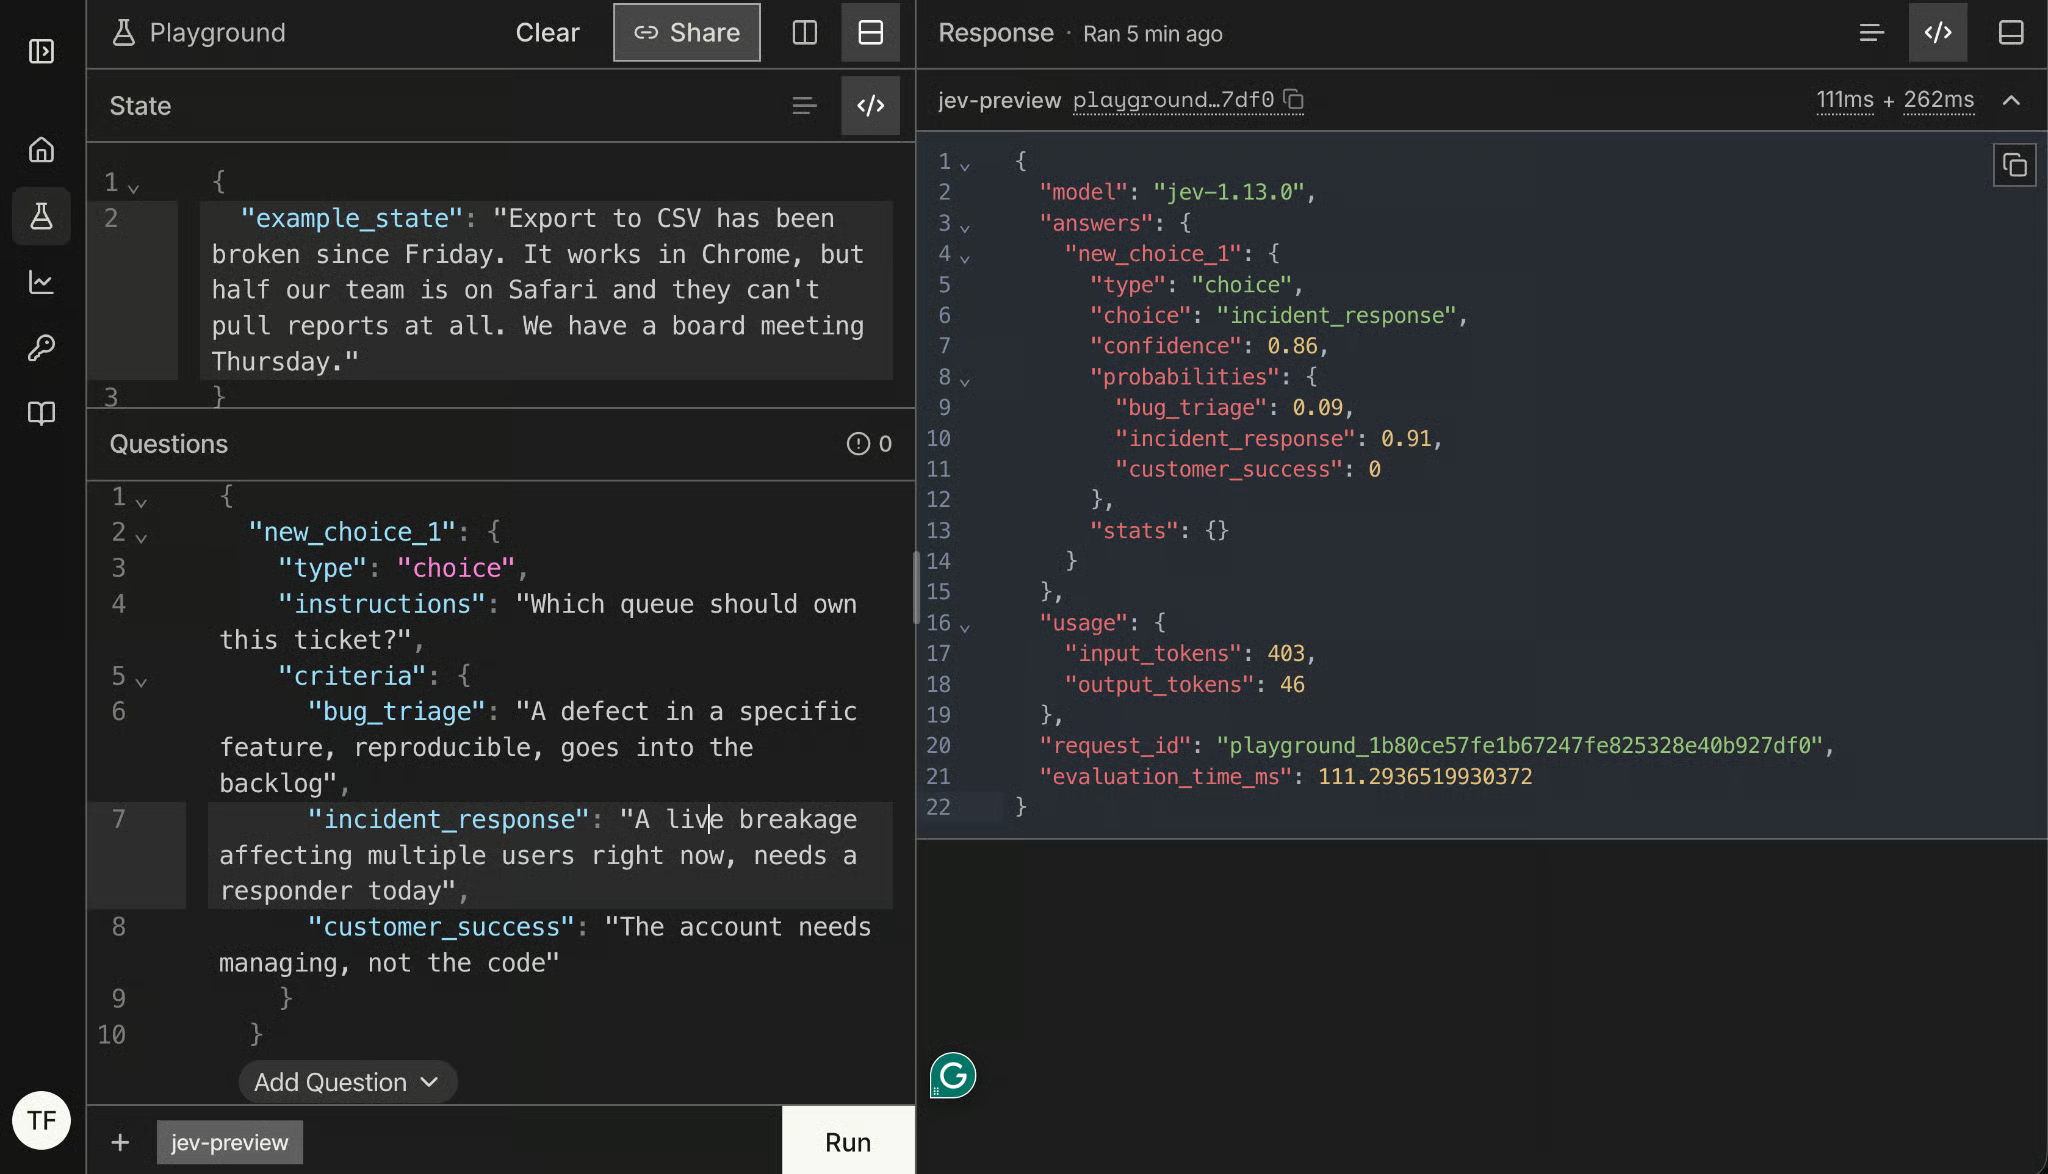
Trong trường hợp này, incident_response là choice với xác suất 91%. confidence của Jev cho lựa chọn này là 86%.
Phân phối đầy đủ mới là phần đáng chú ý.
choice chỉ cho bạn biết phương án nào thắng.
probabilities cho bạn biết thắng với cách biệt bao nhiêu.
Đó là hai mẩu thông tin khác nhau khi bạn sắp định tuyến vé tự động. Một tỉ lệ 0,41/0,38/0,21 và tỉ lệ 0,91/0,09/0 mà ta nhận được có thể đều trả về cùng một choice.
Score chấm trạng thái theo các mức có thứ tự. Bạn truyền criteria dưới dạng một mảng gồm 2 đến 10 mô tả mức, từ thấp đến cao, và câu trả lời bao gồm điểm số, một legend ánh xạ mỗi vị trí tới mô tả của bạn, một xác suất cho mỗi mức, và độ tin cậy.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}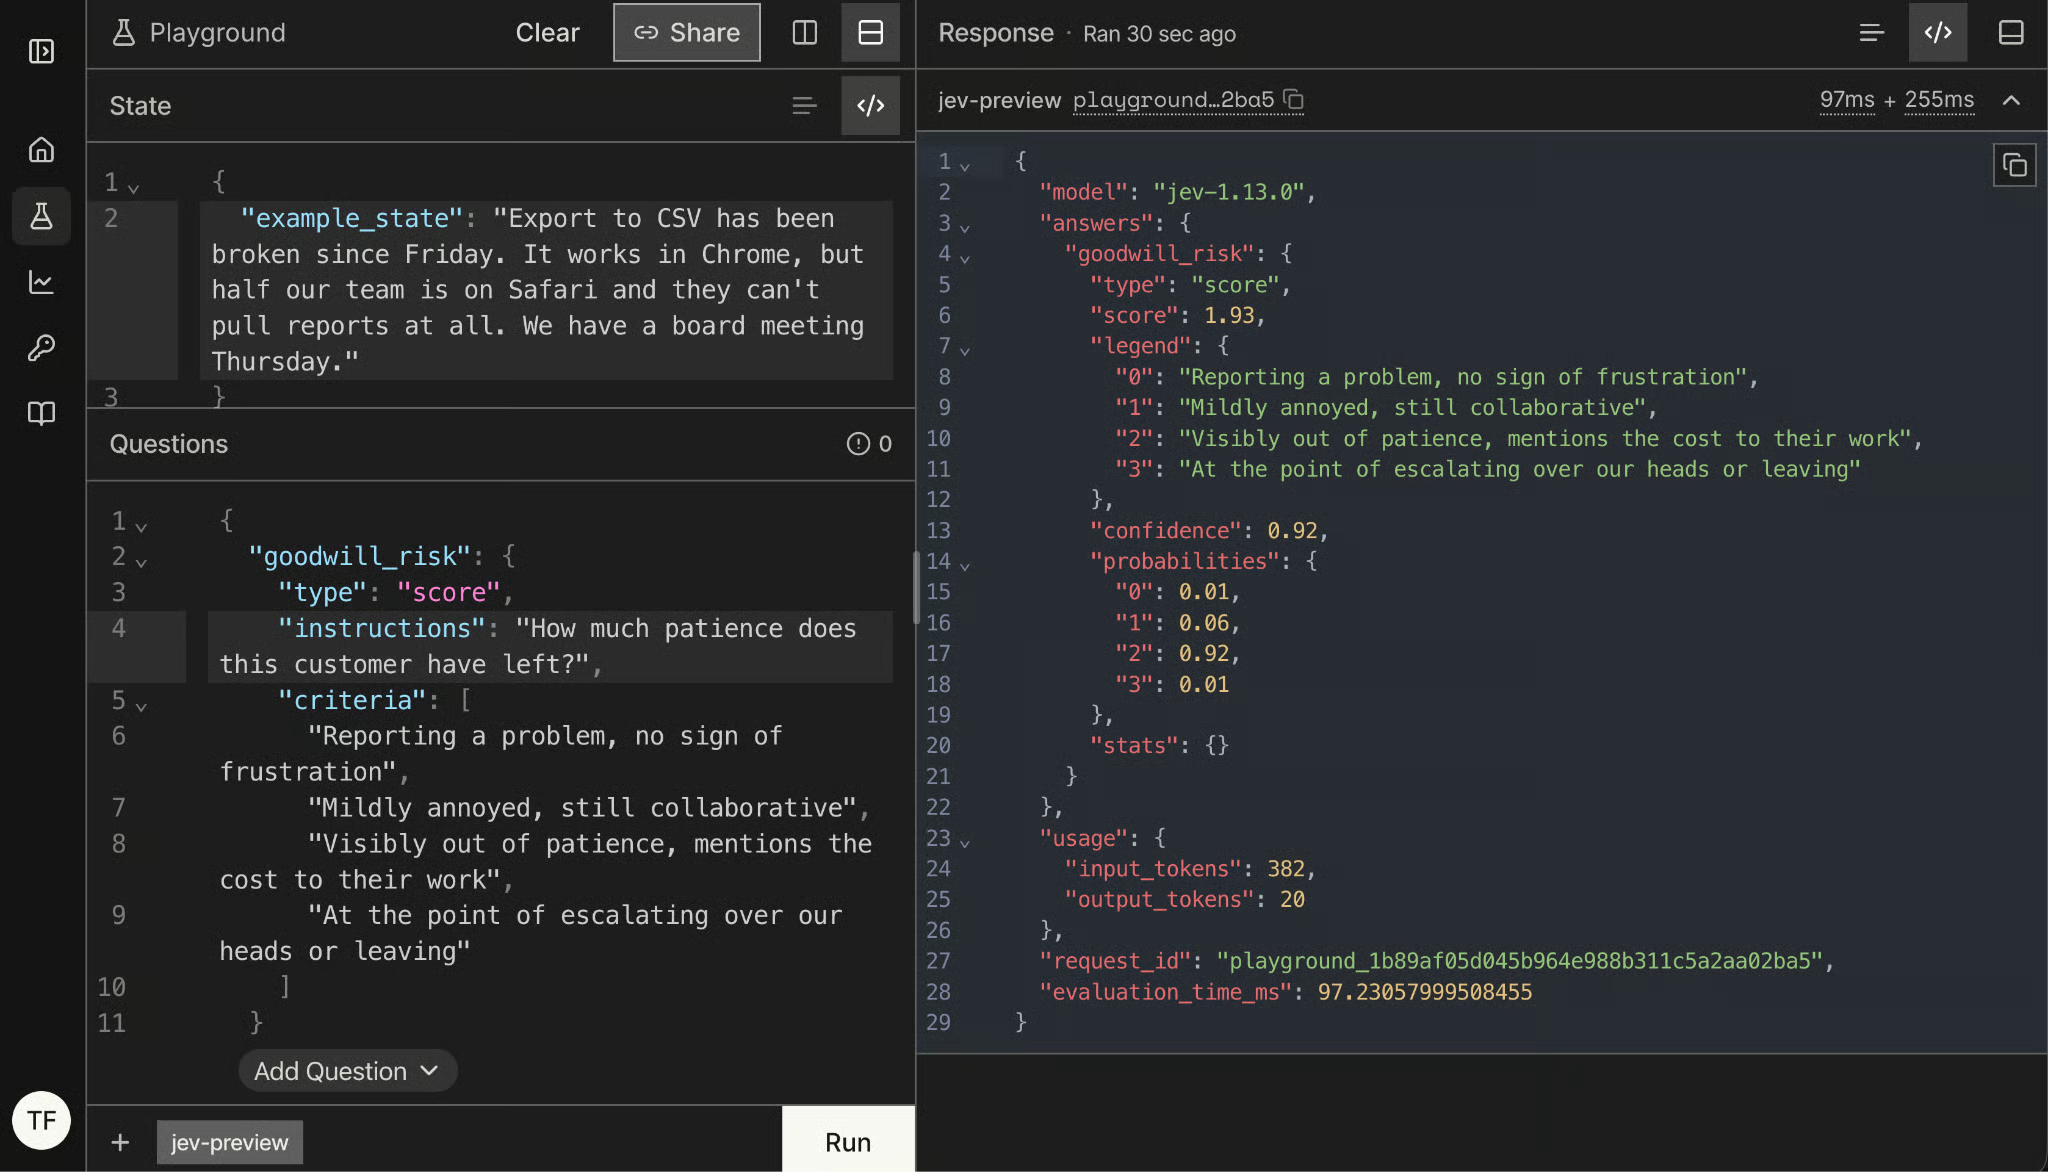
Điểm số có thể rơi giữa các mức của bạn, và đó chính là lý do tồn tại của legend. Một score 1,93 ở đây nghĩa là mô hình phân vân giữa "khó chịu nhẹ" và "rõ ràng hết kiên nhẫn", nghiêng mạnh về vế sau, là cách đọc hợp lý với một vé vẫn lịch sự nhưng nêu ra hạn chót có thể lỡ.
Một lần nữa, hãy đọc độ trải rộng của probabilities thay vì chỉ nhìn con số: xác suất tập trung ở một mức nghĩa là câu trả lời dứt khoát, còn xác suất dàn trải qua ba mức nghĩa là bạn nhận một giá trị trung bình chứ không phải một phán đoán.
Noul là loại dành cho các câu hỏi nhị phân, và tên do TypeSafe đặt. criteria là tùy chọn ở đây, dù bạn có thể mô tả true và false nghĩa là gì, điều này đáng làm mỗi khi "có" có thể hiểu theo hai cách.
Đặt câu sao cho giá trị cao nghĩa là có. Tài liệu của TypeSafe nói rõ điều này, và một Noul mà true ánh xạ sang "không" sẽ hoạt động kém đi trông thấy.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}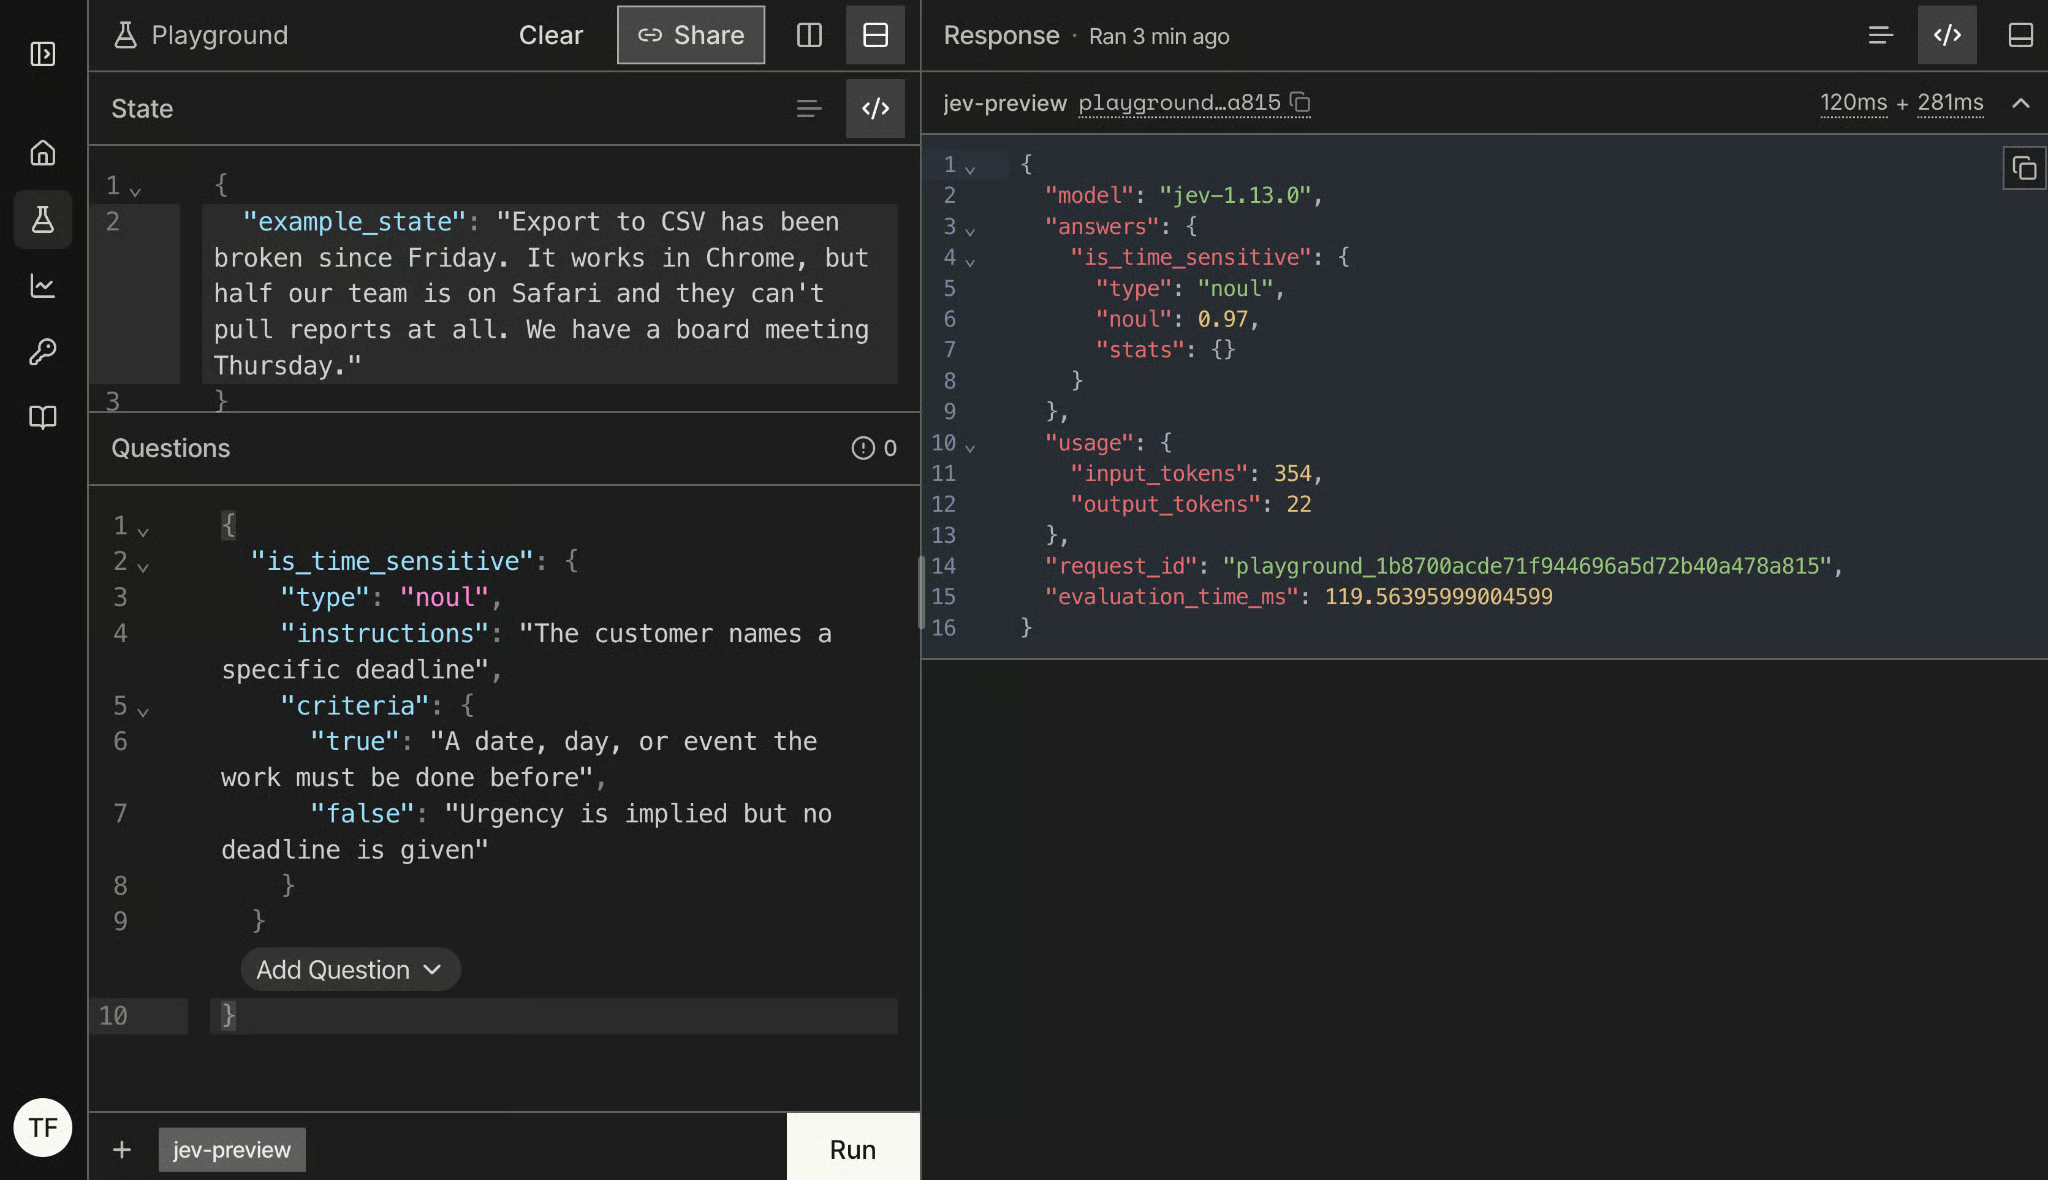
Vì trạng thái có nhắc đến một cuộc họp hội đồng vào thứ Năm, giá trị noul cao 0,97 là điều dễ đoán.
Choice và Score trả về confidence cùng với các xác suất. Noul thì không, và điều này dễ gây nhầm lẫn, nên đáng giải thích kỹ.
Độ tin cậy và xác suất là hai trục riêng. Với Choice, probabilities cho biết mô hình phân bổ niềm tin ra các phương án của bạn thế nào, và confidence cho biết nó giữ câu trả lời đó chắc đến đâu, vì vậy một Choice có thể trả về phương án top 0,85 với confidence 0,78. Noul chỉ có hai kết cục, nên một xác suất duy nhất đã mang cả hai: 0,97 là một "có" chắc chắn, 0,03 là một "không" chắc chắn, và 0,52 là mô hình báo nó không biết.
Điều đó có nghĩa là khoảng cách tới 0,5 chính là tín hiệu dứt khoát của bạn, không phải một trường riêng để đọc. Nó cũng có nghĩa là bạn không thể bê một ngưỡng từ Noul sang Choice, và tôi sẽ quay lại điều này ở phần sần sùi, vì nó gây đau đầu hơn bạn nghĩ.
Để làm theo, bạn chỉ cần Python 3.10+ và một khóa truy cập sớm của TypeSafe.
Cài SDK:
pip install typesafe-sdkHoặc với uv:
uv add typesafe-sdkSau đó tạo khóa trong bảng điều khiển TypeSafe và xuất nó. Client đọc TYPESAFE_API_KEY từ biến môi trường, nên bạn không bao giờ truyền trong mã:
export TYPESAFE_API_KEY="your-key"Các import sau cung cấp cho bạn mọi thứ như trong playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul, và Score là các loại câu hỏi bạn vừa click qua, dưới dạng đối tượng Python.
TypeSafeClient là client đồng bộ, và có AsyncTypeSafeClient với cùng giao diện nếu bạn gọi Jev từ một dịch vụ async. Cả hai hoạt động như context manager, đây là cách tôi sẽ dùng cho mọi thứ dài hơn một script:
with TypeSafeClient() as client:
...Nếu để mặc định, client sẽ gọi jev-latest, vốn thay đổi mỗi khi TypeSafe phát hành phiên bản mới, và đó là thứ chúng ta sẽ dùng trong suốt hướng dẫn. Với bất cứ thứ gì đã tinh chỉnh ngưỡng, hãy ghim phiên bản thay vào đó:
client = TypeSafeClient(model="jev-1.13.0")Dù thế nào, phản hồi sẽ cho bạn biết mô hình nào thực sự đã trả lời, và có một mục gần cuối nói về lý do bạn nên log trường đó.
Để gọi API tới Jev, bạn cần định nghĩa một mục response bằng TypeSafeClient và hàm system_one(), hàm này nhận ngữ cảnh câu hỏi của bạn qua tham số state, và các questions theo cùng định dạng như trong playground.
Ta có thể tạo một lần gọi trả lời cả 3 câu hỏi trong playground, vì chúng dùng chung state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Các câu trả lời trả về dưới cùng tên bạn đặt cho từng câu hỏi, đây là chi tiết khiến việc sử dụng trở nên dễ chịu:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Nếu cuộc gọi đầu tiên của bạn lỗi TypeError về output_buffer_limit: đó là do lệch phiên bản trong backend nén của SDK, không phải do mã của bạn. SDK đi kèm HTTP client riêng, httpx2, giải nén phản hồi qua zstandard và brotli, và một bản cũ của một trong hai thiếu tham số được truyền. pip install -U typesafe-sdk httpx2 zstandard brotli đã giải quyết cho tôi.
Có hai điều trong đầu ra đáng dừng lại.
Thứ nhất, response.model trả về jev-1.13.0, không phải jev-latest. Bạn yêu cầu bí danh di động và Jev cho bạn biết phiên bản nào thực sự trả lời, đó là lý do duy nhất khiến việc log trường này rẻ đến mức đáng làm.
Thứ hai, các đối tượng câu trả lời được gõ theo loại câu hỏi, nên .choice, .score, và .noul là thuộc tính thật và trình soạn thảo của bạn biết về chúng. Không có chuỗi JSON nào trong đoạn mã này, không cần parse, và không có nhánh cho trường hợp phản hồi lỗi định dạng. Nếu bạn thích nhóm, SDK cũng cung cấp response.choices, response.scores, và response.nouls, khóa giống nhau.
Hãy kiểm tra cả response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Token đầu ra là một chữ số và miễn phí. Bạn trả tiền cho trạng thái và câu hỏi, nên bạn có thể kiểm soát hoàn toàn cần gạt chi phí bằng cách quyết định gửi bao nhiêu ngữ cảnh. Điều này quan trọng hơn vẻ bề ngoài, và sẽ quay lại ở phần sần sùi: một trạng thái phình to vừa tốn tiền vừa giảm độ chính xác.
Đây là một trong các trường hợp sử dụng mà Jev được xây dựng để phục vụ. Một vé hỗ trợ đến, và cần có thứ gì đó quyết định nó vào hàng đợi nào, có cần con người xem trước không, và mức độ nhanh thế nào. Mỗi điều đó là một phán đoán với không gian đáp án bạn có thể viết ra trước khi vé tới.
Quy tắc thiết kế đáng nêu ngay từ đầu: Jev quyết định cái gì là gì, mã của bạn quyết định chuyện gì xảy ra. Jev không bao giờ định tuyến bất cứ thứ gì. Nó trả về các con số, và việc định tuyến nằm trong một hàm bình thường mà bạn có thể đọc, kiểm thử, và thay đổi mà không đụng đến mô hình.
Các câu hỏi trong một yêu cầu được đánh giá song song, nên câu thứ sáu chỉ tốn số token của chính nó và hầu như không thêm độ trễ. Điều đó thay đổi cách bạn hỏi. Với LLM, bạn sẽ gom mẻ cẩn thận để tiết kiệm thời gian khứ hồi, còn ở đây bạn hỏi mọi thứ bạn có thể muốn về một ngữ cảnh, kể cả những câu có lẽ bạn sẽ bỏ qua.
Hãy mở rộng các câu trước đó của chúng ta với thêm ba Noul cung cấp thông tin quan trọng về cách xử lý vé:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Sáu câu hỏi, tất cả được trả lời trong một lần gọi và một hóa đơn. is_automated là câu mang tính suy đoán: gần như luôn false với mọi vé thực, nhưng vẫn đáng hỏi vì lần hiếm hoi nó đúng sẽ giúp tránh để ai đó mở một thư trả lại của mailer daemon.
Có hai thói quen tôi khuyên áp dụng ở đây.
Giữ tập câu hỏi ở cấp module như một hằng số thay vì dựng inline, vì đó là thứ bạn sẽ version cùng các ngưỡng.
Và đặt tên câu hỏi theo điều chúng đo lường, không phải theo việc bạn sẽ làm với câu trả lời, vì is_time_sensitive sống sót qua một thay đổi chính sách còn route_to_incident thì không.
Đặt câu hỏi theo hướng khẳng định: Ta cũng có thể gọi is_automated kiểu như needs_no_reply, nhưng theo TypeSafe, câu hỏi được diễn đạt tích cực cho hiệu năng tốt hơn.
Giờ đến phần Jev không làm. Mỗi câu trả lời đi kèm hoặc một độ tin cậy hoặc một xác suất, và con số thứ hai là thứ cho phép bạn xây ba đường đi thay vì hai:
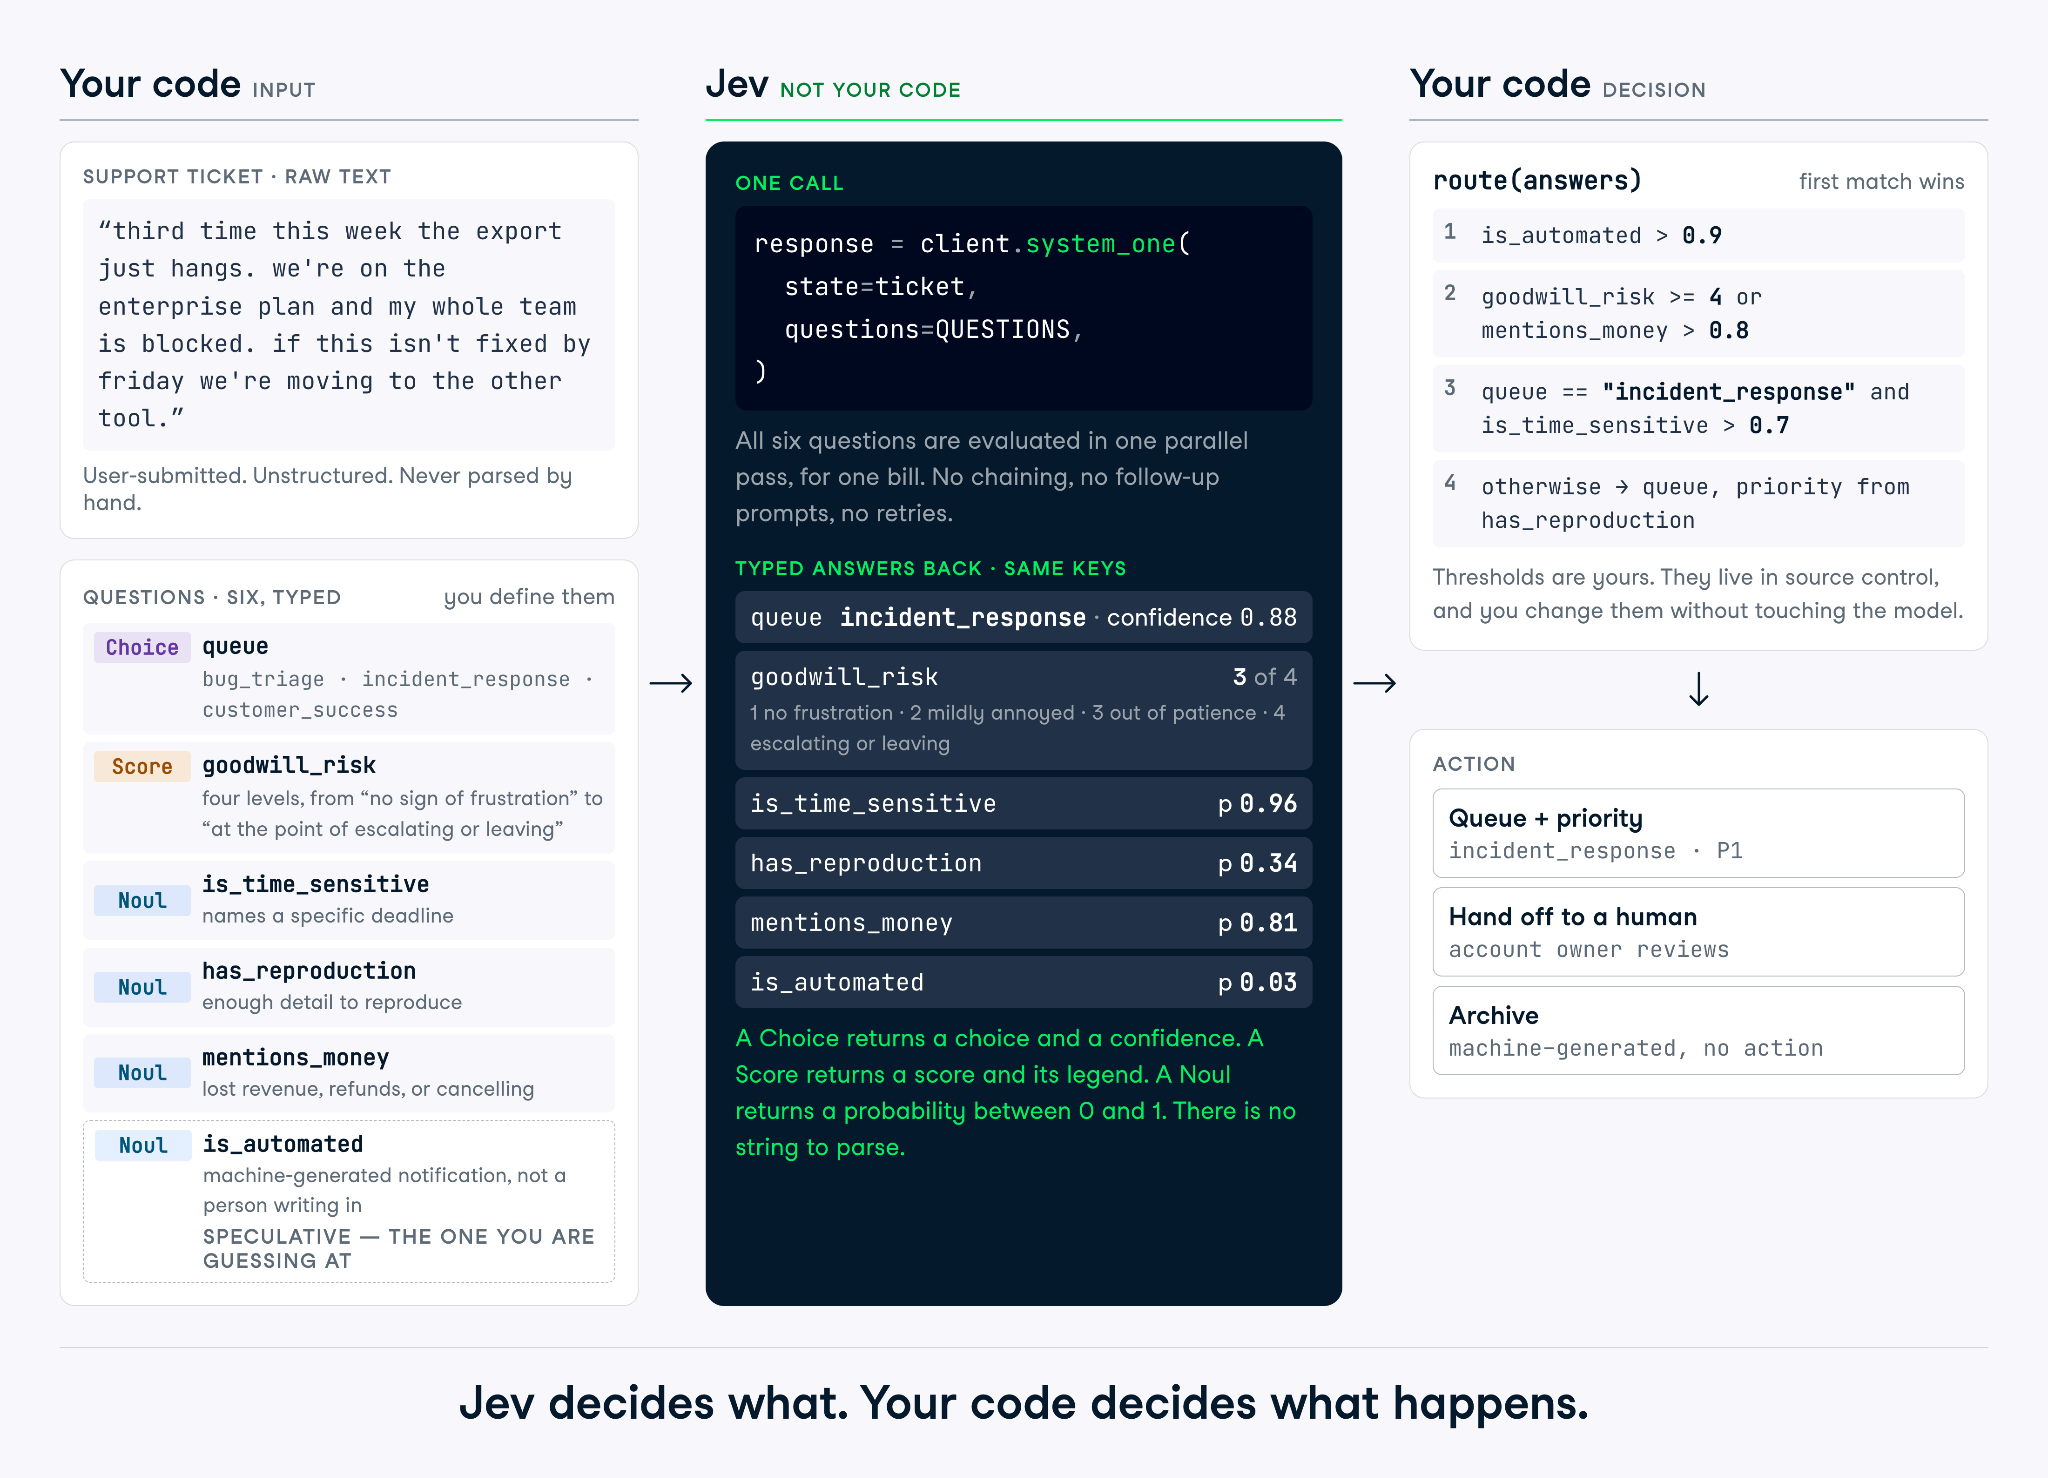
Hãy chuyển điều đó thành vài quy tắc định tuyến vé:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Hãy đọc kỹ hàm đó làm gì. Mô hình cung cấp sáu phán đoán, và chính sách quyết định rằng một trong số đó, mentions_money kết hợp một khách hàng bức xúc, có quyền ưu tiên cao hơn hàng đợi mà Jev chọn. Sự ghi đè đó là quyết định kinh doanh, thuộc về mã, và bạn có thể thay đổi nó vào chiều thứ Sáu mà không cần kiểm thử lại mô hình.
has_reproduction không bao giờ được dùng. Tôi cố ý để nó lại, vì đó là hình mẫu fan-out trên thực tế: bạn hỏi nhiều hơn những gì chính sách hiện tại tiêu thụ, log tất cả, và khi ai đó hỏi liệu các vé bug_triage không có bước tái hiện có mất nhiều thời gian hơn để đóng không, bạn đã có sáu tuần dữ liệu câu trả lời.
Các ngưỡng trên chỉ là ví dụ. Tìm ra ngưỡng đúng là chuyện hiệu chỉnh, và có một mục cuối hướng dẫn đặt ngưỡng bằng dữ liệu thay vì cảm tính.
Bạn có thể truy cập toàn bộ script trong repo GitHub đi kèm này. Khi tôi chạy script Python với kịch bản của chúng ta, phán đoán là định tuyến vé đến đội incident response hôm nay.
python routing.py('incident_response', 'today')TypeSafe công bố một trang sần sùi cho mỗi phiên bản mô hình, liệt kê các chế độ lỗi đã biết. Tôi ước nhiều phòng lab làm như vậy. Hãy đọc trước khi xây bất cứ thứ gì, và đọc lại khi nâng cấp, vì danh sách được quản lý theo phiên bản và các cạnh sẽ dịch chuyển.
Đây là năm điều sẽ khiến tôi tốn thời gian nhất.
Bạn không thể bê một ngưỡng giữa các loại câu hỏi. Ví dụ của chính TypeSafe hỏi "Khách hàng có đang yêu cầu hoàn tiền không?" theo cả hai cách trên cùng một vé: Noul trả về 0,22, Choice có/không trả về 0,01 cho "có", với confidence 0,97. Cùng câu hỏi, hai con số, chênh nhau hai bậc độ lớn.
Phủ định cũng không phối hợp. Một Noul và mệnh đề đối của nó trả về 0,72 và 0,47, cộng lại thành 1,19.
Lý do là hai loại này hỏi những điều khác nhau. Choice là tương đối và xác định phương án thắng, trong khi mỗi Noul là tuyệt đối và có thể đều thấp cho tất cả. Hãy tinh chỉnh ngưỡng theo từng câu hỏi, ở hình thức bạn sẽ triển khai, và đừng bao giờ giả định P(yes) và 1 - P(no) là cùng một con số.
Các mức Score có thứ tự, không có khoảng cách đều. Một 1,6 cho bạn biết mô hình ở giữa mức hai và ba, nghiêng về mức ba, và chỉ có thế.
Điều bạn không thể làm là nội suy ra một đại lượng thực. Nếu mức của bạn là "dưới một giờ", "vài giờ", và "một ngày", thì 1,5 không có nghĩa là năm giờ. Hãy dùng điểm để kiểm thử ngưỡng, rồi giữ mọi con số thực trong mã.
Jev coi trạng thái là dữ liệu, nhưng nó chưa được gia cố chống lại mã được viết trong trạng thái nhằm lèo lái nó. Một chỉ dẫn được chèn, một khung diễn giải sai, hoặc văn bản tự biện hộ cho phân loại của mình có thể làm lệch câu trả lời, và TypeSafe cho biết họ kỳ vọng sẽ cải thiện. Nếu bề mặt tấn công này mới với bạn, chúng tôi bàn tổng quan trong hướng dẫn prompt injection.
Điều này quan trọng nhất khi trạng thái do người dùng gửi lên, với bộ định tuyến vé thì luôn như vậy. Hãy viết tiêu chí đủ chính xác để các tuyên bố của chính vé về bản thân nó không quyết định kết quả, và kiểm thử với đầu vào thù địch trước khi tự động định tuyến bất cứ thứ gì.
Đếm là không đáng tin và càng tệ khi đối tượng cần đếm tăng, vì mô hình nhận ra hình dáng câu trả lời hơn là thực sự đếm. Ngày tháng được đọc như văn bản, nên sắp xếp, khoảng cách, và cửa sổ đều thất bại. Mã hóa số kém hơn tương đương ngữ nghĩa bằng ngôn ngữ thường, nên hãy hỏi về "đỏ" thay vì #FF0000.
Cách khắc phục giống nhau cho cả ba: tách việc ra.
Nếu bạn cần đếm, hãy lặp trong mã và hỏi một Noul cho mỗi mục:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Ba điều nhỏ hơn có chung nguyên nhân. Jev trả lời câu bạn viết, không phải điều bạn định nói, nên các từ phạm vi và phủ định được đọc đúng nghĩa đen. Phủ định kép và câu hỏi về thuộc tính của thuộc tính làm giảm độ chính xác. Và một trạng thái lớn bị độn bằng chi tiết không liên quan làm giảm cả độ chính xác lẫn tiền bạc, vì chất liệu không liên quan đóng vai trò gây nhiễu.
Dấu hiệu cho điều đầu tiên: khi bạn nhìn một câu trả lời sai và tự giải thích điều mình thực sự muốn nói, thì phần giải thích đó chính là nửa còn thiếu của chỉ dẫn.
Dựa trên những gì đã học, đây là một vài thực hành tốt để tận dụng tối đa Jev.
Viết điều kiện thay vì ý định. Nếu bạn phải giải thích mình muốn nói gì khi xem một câu trả lời sai, thì lời giải thích đó nên nằm trong instructions. Có nghĩa là:
jev-latest thay đổi. Hãy ghim phiên bản khi một ngưỡng phụ thuộc vào hành vi mô hình:
client = TypeSafeClient(model="jev-1.13.0")Log response.model cùng toàn bộ câu trả lời ở mọi lần gọi, không chỉ giá trị bạn đã hành động theo. Khi một ngưỡng bắt đầu cư xử lạ, log đó là cách duy nhất để phân biệt thay đổi mô hình với trôi dạt trong các vé của bạn.
Cuối cùng, ngưỡng không phải điều hiển nhiên mà là kết quả của thử nghiệm.
Jev là một công cụ hẹp, và đó thực sự là chủ đích. Nó trả lời các câu hỏi có thể liệt kê đáp án, rẻ đến mức bạn thôi phải dè sẻn, và trao quyết định lại cho mã của bạn.
Điều tôi muốn phản biện là cách đóng khung "không thể bịa". Đúng theo nghĩa hẹp là mô hình không thể trả lời ngoài schema, nhưng điều đó không nói gì về việc câu trả lời có đúng không. Một Choice luôn trả về một hàng đợi hợp lệ. Nó vẫn có thể là hàng đợi sai với độ tin cậy 0,9, và đầu ra có kiểu khiến lỗi đó im ắng hơn.
Để kiểm thử cho công việc của riêng bạn, tôi gợi ý tìm một quyết định mà mã của bạn hiện thực bằng một quy tắc mong manh hoặc một cuộc gọi LLM chậm, và thử viết ra các đáp án hợp lệ. Nếu bạn viết được, đó là vấn đề hợp với Jev. Nếu không, dù có kỹ nghệ câu hỏi thế nào cũng không thay đổi được.
Nếu bạn muốn bắt đầu xây dựng hệ thống sử dụng AI, tôi rất khuyến nghị đăng ký lộ trình Associate AI Engineer for Developers của chúng tôi. Bạn sẽ học cách làm việc với OpenAI API, MCP, LangChain, và nhiều hơn nữa.
Học AI Engineering với DataCamp!
Tracks
Courses
Courses