Track
Ассоциированный AI-инженер для разработчиков
26 ч
Я уже упоминал, что ожидания нужно соотносить с моделью. В случае с Jev это особенно верно и связано главным образом с классом модели — так называемыми System One.
Модель System One возвращает типизированные решения вместо текста. Вы отправляете блок состояния плюс набор вопросов, у каждого из которых задано пространство ответов, и модель возвращает по одному ответу на вопрос с прикреплёнными вероятностями. Ничего не производится по токену, так что не нужно парсить строки и чинить некорректный JSON. TypeSafe ввели этот термин, отсылая к знаменитому делению у Даниэля Канемана:
Поскольку пространство ответов — это схема, объявленная вашим кодом, модели System One по определению не могут вернуть категорию, которой вы не задали. То есть выйти за схему она не может. При этом ошибаться она всё же может, и мы разберём пару хитрых случаев позже.
TypeSafe вышли из тени 15 сентября 2026 года, открыв ранний доступ к Jev, заявив о времени ответа 70–500 мс и цене $0.042 за миллион входных токенов при бесплатных выходных. На собственном бенчмарке из четырёх рабочих процессов Jev показывает около 68% точности — уровень середнячка среди LLM при доле стоимости.
За подробностями о функциях и результатах бенчмарков рекомендуем почитать наш гид по Jev.
Сначала запишите валидные ответы. Если вы можете их перечислить, у вас задача под Jev:
Обращайтесь к LLM, когда на выходе нужна проза или код, когда пространство ответов открыто или когда задаче нужно несколько шагов рассуждений. Jev также не подходит для всего числового — ниже вернусь к причинам.
Прежде чем писать код, создайте аккаунт TypeSafe и откройте Playground. Здесь вы можете вставить текст как состояние, добавить вопросы и увидеть полные объекты ответов без установки чего-либо. Это самый быстрый способ понять, что возвращает каждый тип вопроса (и выяснить, плохо ли сформулирован ваш вопрос).
В качестве состояния для всех трёх примеров я возьму один тикет поддержки:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Каждый тип вопроса принимает instructions — формулировку вопроса на естественном языке. То, что между ними меняется, — это criteria и структура ответа.
Тип Choice выбирает один вариант из заданного вами набора.
Вы передаёте criteria как словарь, сопоставляющий каждому варианту описание, от 1 до 255 штук. Ответ включает:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Чтобы увидеть код вывода, который вы получите и через API, нажмите кнопку </> в правом верхнем углу и затем Run, чтобы Jev ответил на вопрос.
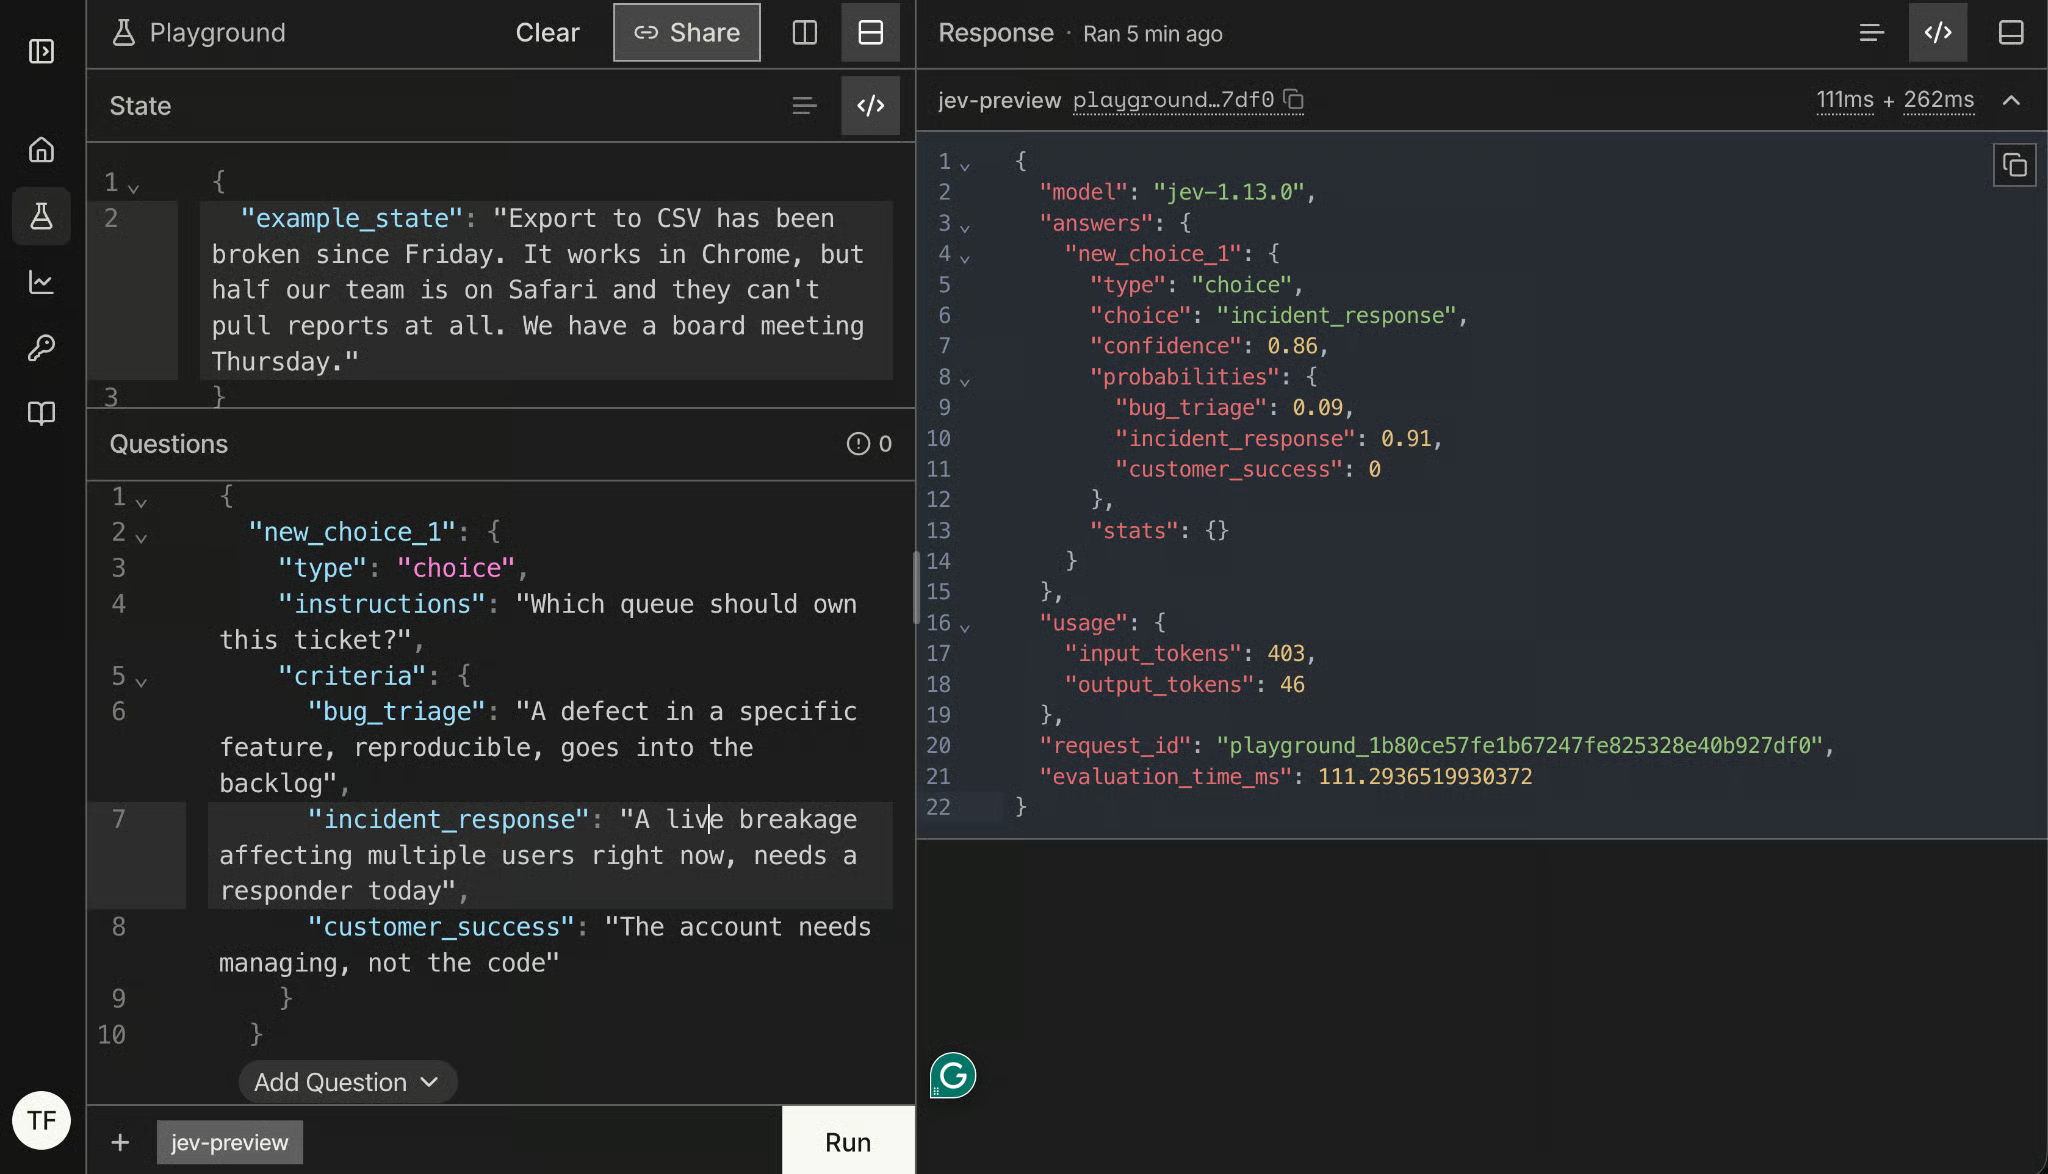
В этом случае incident_response — это choice с вероятностью 91%. Уверенность Jev в выборе — 86%.
Полное распределение — то, на что стоит смотреть в первую очередь.
choice говорит только, какой вариант победил.
probabilities показывает, с каким отрывом.
Это разные сведения, когда вы собираетесь маршрутизировать тикет автоматически. Разбиение 0.41/0.38/0.21 и полученное нами 0.91/0.09/0 могут дать один и тот же choice.
Score оценивает состояние по упорядоченным уровням. Вы передаёте criteria как массив из 2–10 описаний уровней (от меньшего к большему). Ответ включает оценку, legend с сопоставлением позиций вашим описаниям, вероятность по каждому уровню и уверенность.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}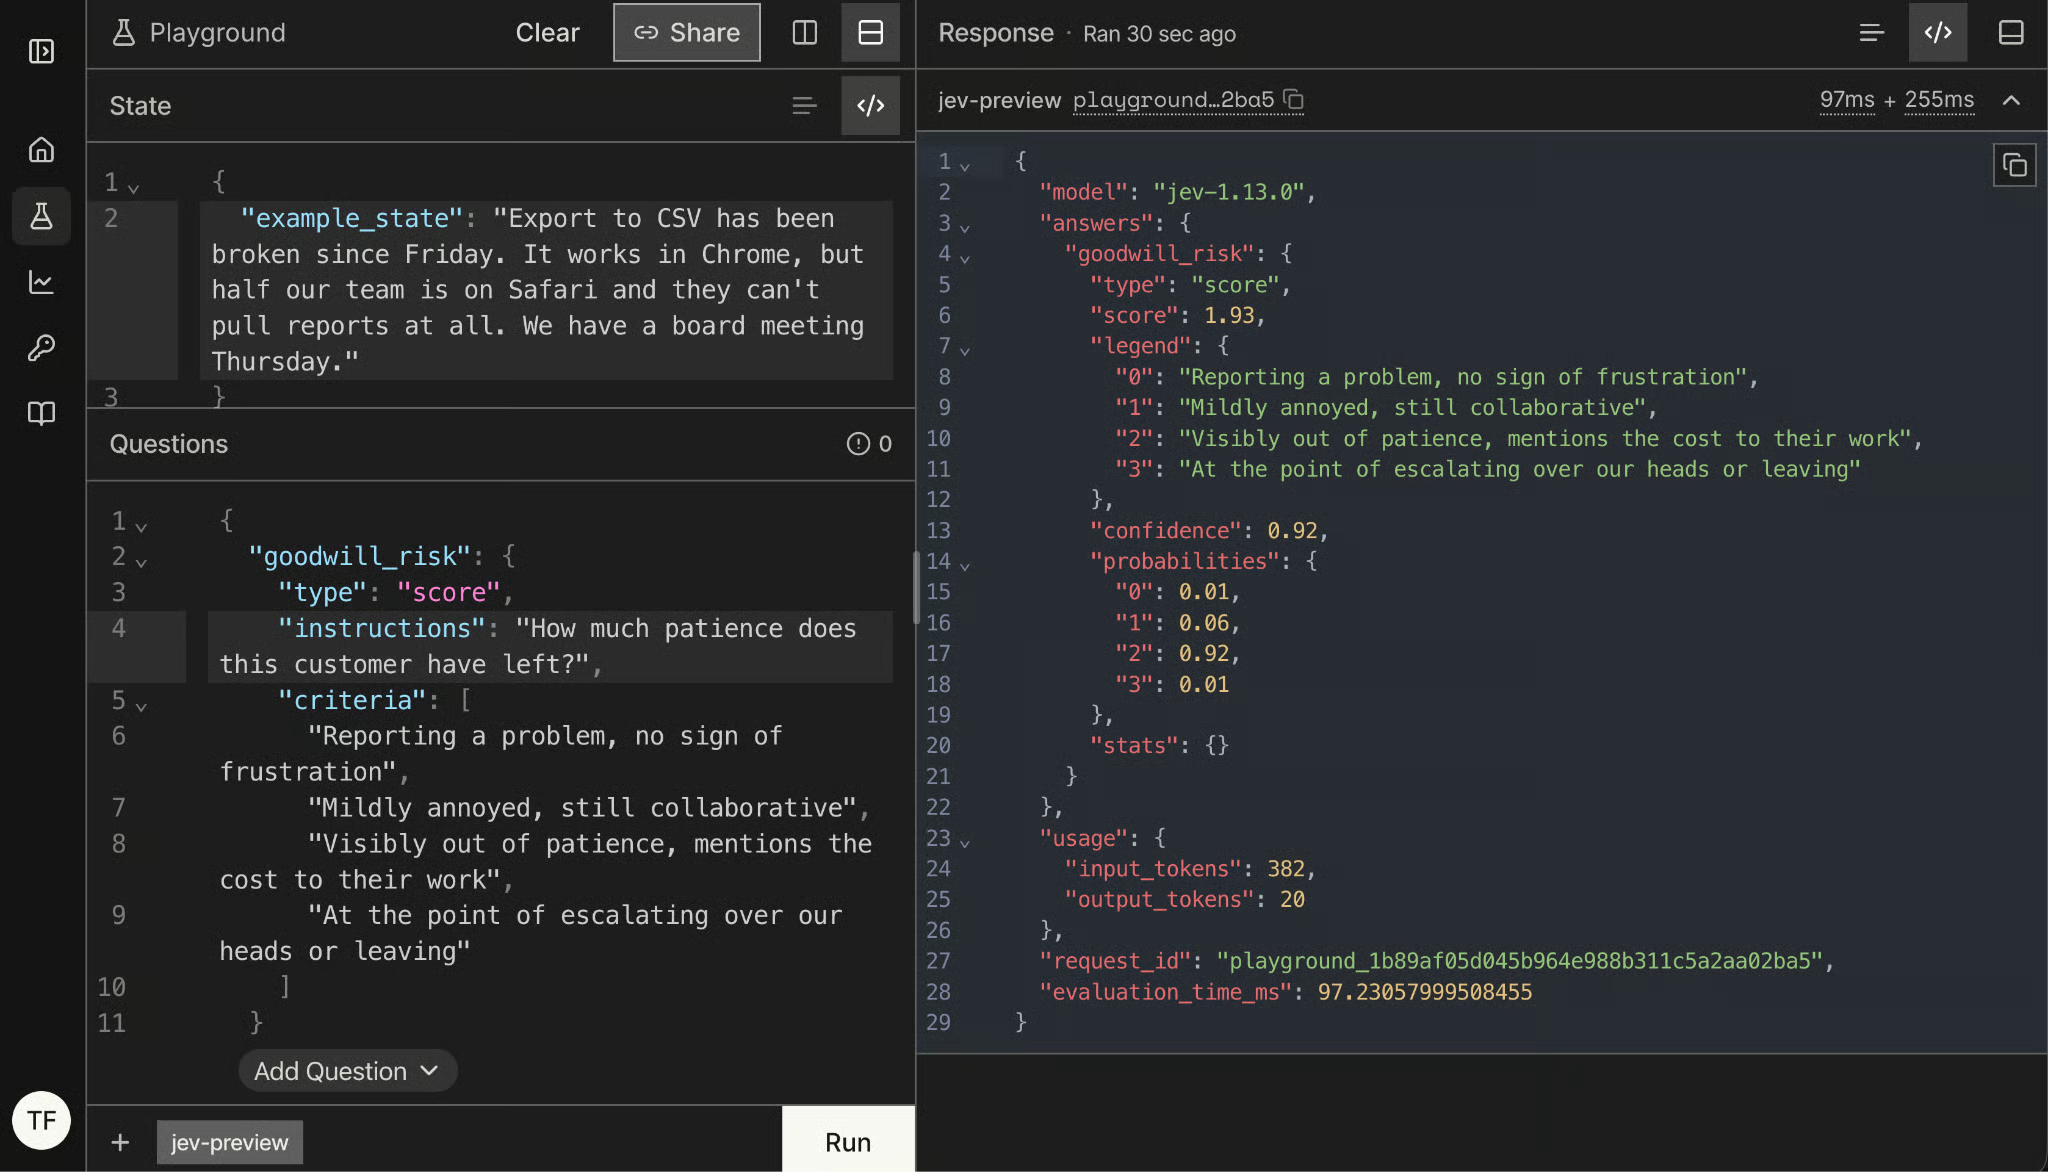
Оценка может оказаться между вашими уровнями — в этом вся суть legend. Здесь score 1.93 означает, что модель сомневается между «слегка раздражён» и «очевидно потерял терпение», заметно склоняясь ко второму, что честно отражает тикет, в котором вежливо упоминают дедлайн, который сорвётся.
Опять же, смотрите на распределение probabilities, а не только на число: сконцентрированная вероятность по одному уровню = решительный ответ, размазанная по трём = вы получили среднее вместо суждения.
Noul — тип для бинарных вопросов, термин ввёл TypeSafe. criteria здесь необязателен, но вы можете описать, что означают true и false — это полезно, когда «да» можно понять двояко.
Формулируйте вопрос так, чтобы высокая величина означала «да». Документация TypeSafe это явно рекомендует: Noul, у которого true соответствует «нет», работает заметно хуже.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}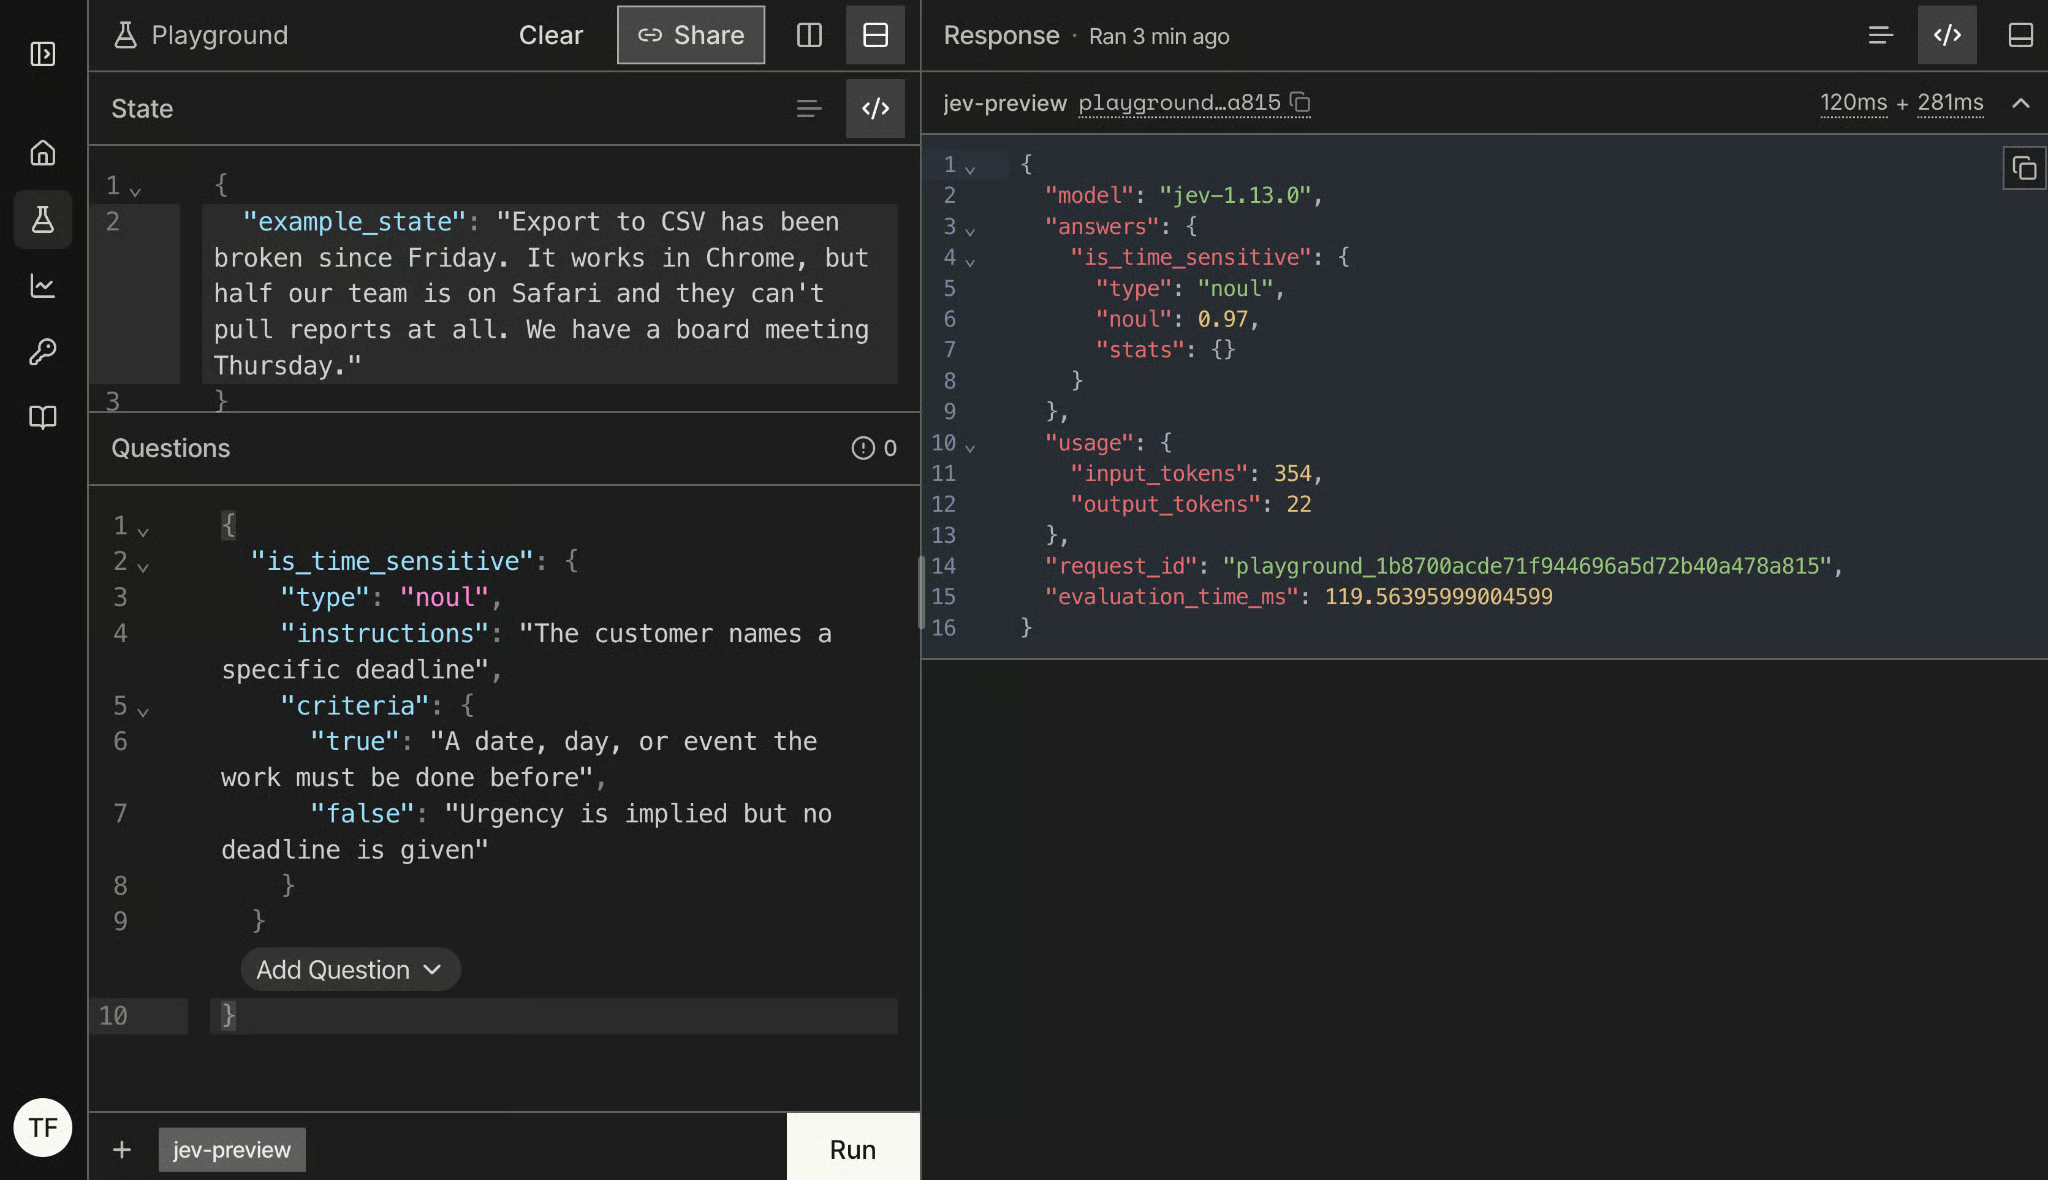
Поскольку в состоянии упомянуто заседание совета директоров в четверг, высокая величина noul 0.97 ожидаема.
Choice и Score возвращают уверенность вместе с вероятностями. Noul — нет, и это сбивает с толку, так что важно понять почему.
Уверенность и вероятность — разные оси. Для Choice вероятности показывают, как модель распределяет убеждённость между вариантами, а уверенность — насколько крепко она держится выбранного ответа. Поэтому Choice может вернуть топ-вариант с 0.85 при уверенности 0.78. У Noul всего два исхода, значит одиночная вероятность уже несёт оба сигнала: 0.97 — твёрдое «да», 0.03 — твёрдое «нет», 0.52 — модель говорит, что не знает.
Отсюда следует, что удалённость от 0.5 — ваш сигнал решительности, а не отдельное поле. Также нельзя переносить порог из Noul в Choice — к этому вернёмся в разделе про «зазубрины», там это больнее, чем звучит.
Чтобы повторить действия, вам понадобится только Python 3.10+ и ключ раннего доступа TypeSafe.
Установите SDK:
pip install typesafe-sdkИли через uv:
uv add typesafe-sdkЗатем создайте ключ в консоли TypeSafe и экспортируйте его. Клиент читает TYPESAFE_API_KEY из окружения, так что в коде его передавать не нужно:
export TYPESAFE_API_KEY="your-key"Следующие импорты дают вам всё то же, что в Playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul и Score — те же типы вопросов, по которым вы только что кликали, но как объекты Python.
TypeSafeClient — синхронный клиент; если вы вызываете Jev из асинхронного сервиса, есть AsyncTypeSafeClient с тем же интерфейсом. Оба работают как контекстные менеджеры — именно так стоит делать в чём-то длиннее скрипта:
with TypeSafeClient() as client:
...По умолчанию клиент вызывает jev-latest, который сдвигается при каждом релизе TypeSafe — мы так и будем делать в этом руководстве. Для всего, где вы уже настроили пороги, зафиксируйте версию:
client = TypeSafeClient(model="jev-1.13.0")В ответе в любом случае указано, какая модель реально отвечала — ниже будет раздел, почему это стоит логировать.
Чтобы обратиться к API Jev, задайте элемент response с помощью TypeSafeClient и функции system_one(), которая принимает контекст вопросов как параметр state, а сами questions — в том же формате, что и в Playground.
Мы можем создать один вызов, который ответит на все три наших вопроса из Playground, так как они используют одно и то же state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
Ответы приходят под теми же именами, которые вы выбрали для вопросов — деталь, из-за которой с этим приятно работать:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Если первый вызов упал с TypeError о output_buffer_limit: это несовместимость версий в бэкенде сжатия SDK, а не ошибка вашего кода. SDK ставит свой HTTP-клиент httpx2, который распаковывает ответы через zstandard и brotli, и в старой копии одного из них отсутствует аргумент, с которым его вызывают. Команда pip install -U typesafe-sdk httpx2 zstandard brotli у меня проблему сняла.
Здесь есть две вещи, на которых стоит остановиться.
Во-первых, response.model вернул jev-1.13.0, а не jev-latest. Вы просили движущийся алиас, а Jev сказал, какая версия реально ответила — именно поэтому логировать это поле достаточно дёшево, чтобы было оправдано.
Во-вторых, объекты ответов типизированы по типу вопроса, так что .choice, .score и .noul — настоящие атрибуты, и редактор о них знает. В этом коде нигде нет JSON-строки, нечего парсить и нет ветки на случай некорректного ответа. Если вам удобнее группировать, SDK также предоставляет response.choices, response.scores и response.nouls с теми же ключами.
Проверьте и response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Выходные токены — однозначное число и бесплатны. Вы платите за состояние и вопросы, значит, вы полностью контролируете стоимость, решая, сколько контекста отправлять. Это важнее, чем кажется, и снова всплывёт в разделе про «зазубрины»: раздутый state одновременно стоит денег и точности.
Это один из кейсов, под который Jev и делали. Приходит тикет в поддержку, и кто-то должен решить, в какую очередь он попадёт, нужно ли человеку посмотреть его сначала и насколько срочно. Всё это — суждения с пространством ответов, которое можно выписать до прихода тикета.
Правило проектирования, которое стоит проговорить заранее: Jev решает, что есть; ваш код решает, что делать. Jev ничего не маршрутизирует. Он возвращает числа, а маршрутизация живёт в обычной функции, которую можно читать, тестировать и менять без трогания модели.
Вопросы в рамках одного запроса оцениваются параллельно, так что шестой вопрос стоит лишь своих токенов и почти не добавляет задержки. Это меняет подход. С LLM вы бы аккуратно батчили для экономии RTT, а здесь — спрашиваете всё, что может пригодиться по данному контексту, включая вопросы, ответы на которые, скорее всего, проигнорируете.
Расширим прежние вопросы ещё тремя Noul, которые дадут важную информацию для обработки тикета:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Шесть вопросов — все отвечены одним вызовом и одной строкой в счёте. is_automated — спекулятивный: почти во всех реальных тикетах он «ложь», и всё равно его стоит задавать, потому что однажды он спасёт человека от открытия ответа почтового демона.
Две полезные привычки.
Держите набор вопросов константой модульного уровня, а не собирайте его на лету — вы будете версионировать его вместе с порогами.
Называйте вопросы по тому, что они измеряют, а не по тому, что вы сделаете с ответом: is_time_sensitive переживёт смену политики, а route_to_incident — нет.
Формулируйте вопросы позитивно: можно было назвать is_automated чем-то вроде needs_no_reply, но, по данным TypeSafe, положительные формулировки работают лучше.
Далее — часть, которую Jev не делает. Каждый ответ приходит с уверенностью или вероятностью, и именно это второе число позволяет строить три пути, а не два:
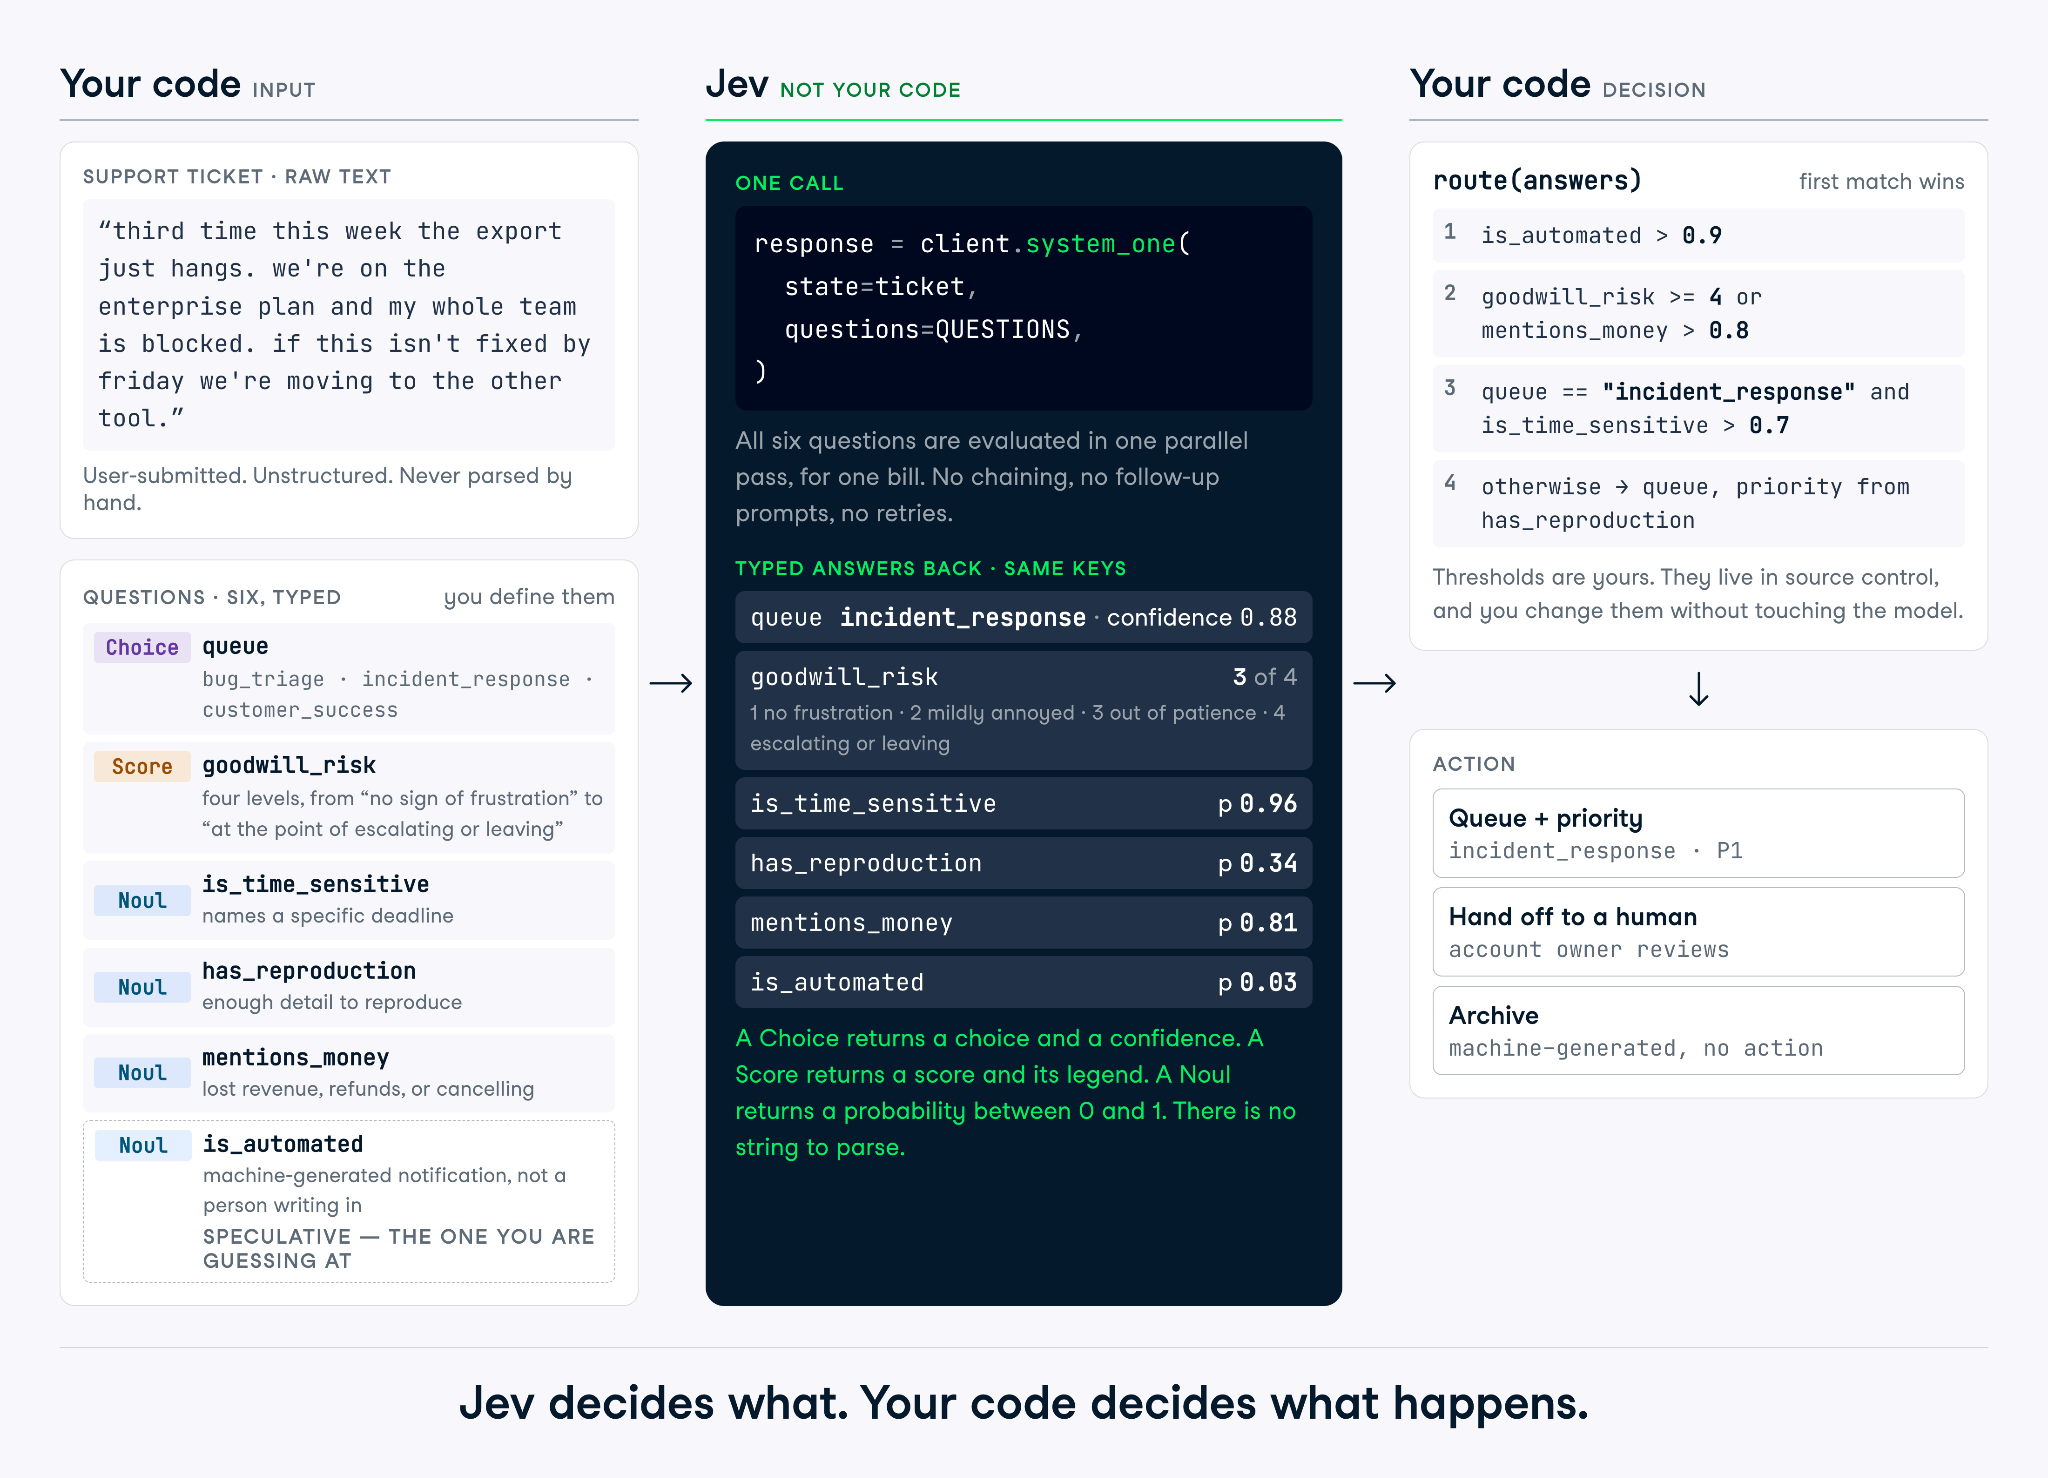
Переведём это в пару правил для маршрутизации тикетов:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Посмотрите, что делает эта функция. Модель дала шесть суждений, а политика решила, что одно из них — mentions_money в сочетании с раздражённым клиентом — важнее очереди, выбранной Jev. Это бизнес-решение, ему место в коде, и вы можете поменять его в пятницу днём без повторного тестирования модели.
has_reproduction нигде не используется. Я оставил его намеренно, потому что так на практике выглядит шаблон «fan-out»: вы спрашиваете больше, чем потребляет текущая политика, логируете всё, и когда кто-то спросит, дольше ли закрываются bug_triage-тикеты без шагов воспроизведения, у вас уже будет шесть недель ответа.
Пороги выше — лишь примеры. Правильные — вопрос калибровки; в конце есть раздел о том, как настраивать их данными, а не интуицией.
Полный скрипт доступен в сопровождающем репозитории на GitHub. В моём прогоне для нашего сценария решение — направить тикет в команду инцидент-реагирования сегодня.
python routing.py('incident_response', 'today')TypeSafe публикует страницу с «зазубринами» для каждой версии модели — перечень известных режимов отказа. Хотелось бы, чтобы так делали больше лабораторий. Прочитайте перед разработкой и перечитайте при апгрейде — список версионируется, и острые углы меняются.
Вот пять пунктов, которые стоили бы мне больше всего времени.
Нельзя переносить порог между типами вопросов. В собственном примере TypeSafe задаёт «Просит ли клиент возврат денег?» двумя способами по одному тикету: Noul даёт 0.22, а бинарный Choice — 0.01 для «да» при уверенности 0.97. Один вопрос — два числа, разница на два порядка.
Отрицания тоже не сходятся. Noul и его противоположность вернулись 0.72 и 0.47, что суммарно даёт 1.19.
Причина в том, что типы спрашивают разное. Choice — относительный и решает, какой вариант выигрывает; каждый Noul — абсолютный и может быть низким для всех. Настраивайте пороги под конкретный вопрос в той форме, в которой будете его использовать, и никогда не предполагайте, что P(yes) и 1 - P(no) — это одно и то же число.
Уровни Score упорядочены, но не равномерно распределены. Значение 1.6 говорит лишь, что модель между вторым и третьим уровнями и склоняется к третьему — и только.
Чего нельзя делать — это интерполировать из него реальную величину. Если ваши уровни — «менее часа», «несколько часов» и «день», 1.5 не значит «пять часов». Используйте оценку для проверки порога, а сами числа храните в коде.
Jev воспринимает состояние как данные, но не защищён от написанных в состоянии инструкций, смещающих ответ. Внедрённая инструкция, вводящее в заблуждение оформление или текст, аргументирующий за собственную классификацию, могут повлиять на ответ; TypeSafe обещает улучшения. Если для вас эта поверхность атаки нова, мы разбираем общий случай в руководстве по prompt-injection.
Это особенно важно там, где состояние присылают пользователи — для маршрутизатора тикетов так всегда. Пишите критерии достаточно точно, чтобы собственные утверждения тикета о себе не определяли исход, и тестируйте на враждебных вводах до любой автоматической маршрутизации.
Подсчёт ненадёжен и ухудшается с ростом количества — модель распознаёт форму ответа, а не суммирует. Даты читаются как текст, так что порядок, расстояния и окна ломаются. Числовые кодировки работают хуже их словесных эквивалентов, так что спрашивайте про «красный», а не про #FF0000.
Лекарство одно и то же во всех трёх случаях: разделяйте работу.
Если нужен счёт, итерируйтесь в коде и задавайте по одному Noul на элемент:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Три мелких, но с общей причиной. Jev отвечает на вопрос, который вы написали, а не подразумевали, поэтому слова-ограничители и отрицания читаются буквально. Двойные отрицания и вопросы о свойстве свойства снижают точность. А большой state, набитый нерелевантными деталями, снижает и точность, и стоит денег — лишнее работает как отвлекающий фактор.
Признак первого: если вы смотрите на неверный ответ и ловите себя на объяснении, что вы «на самом деле имели в виду», — это объяснение и есть недостающая половина инструкции.
С учётом всего сказанного — несколько практик, чтобы извлечь максимум из Jev.
Формулируйте условие, а не намерение. Если при разборе ошибки вы объясняете, что «имели в виду», это объяснение нужно перенести в инструкции. Что это значит:
jev-latest меняется. Фиксируйте версию, как только какой-то порог зависит от поведения модели:
client = TypeSafeClient(model="jev-1.13.0")Логируйте response.model вместе с полными ответами на каждом вызове, а не только значение, по которому вы действовали. Когда порог начнёт «плыть», это единственный способ отличить смену модели от дрейфа в тикетах.
Наконец, пороги — не данность, а результат экспериментов.
Jev — узкоспециализированный инструмент, и в этом его суть. Он отвечает на вопросы с перечислимыми ответами, достаточно дёшево, чтобы перестать их экономить, и возвращает решение обратно вашему коду.
К формуле «не может галлюцинировать» я бы отнёсся осторожно. В узком смысле верно, что модель не выйдет за схему, но это ничего не говорит о правильности ответа. Choice всегда вернёт валидную очередь. Это всё ещё может быть неверная очередь с уверенностью 0.9, и типизированный вывод делает эту ошибку тише.
Чтобы проверить модель под свои задачи, найдите одно решение в вашем коде, которое сейчас держится на хрупком правиле или медленном вызове LLM, и попытайтесь выписать валидные ответы. Если можете — задача под Jev. Если нет — никакая инженерия вопросов это не изменит.
Если хотите начать строить системы с ИИ, рекомендую записаться на наш карьерный трек Associate AI Engineer for Developers. Вы научитесь работать с OpenAI API, MCP, LangChain и многим другим.
Изучайте AI Engineering с DataCamp!
Track
Course
Course