
Programa
Associate AI Engineer para desenvolvedores
26 h
Já comentei que é preciso alinhar expectativas ao modelo. Isso é especialmente verdadeiro no caso do Jev e tem muito a ver com sua classe de modelo, chamada de System One.
Um modelo System One retorna decisões tipadas em vez de texto. Você envia um bloco de estado mais um conjunto de perguntas, cada uma com um espaço de resposta que você define, e o modelo retorna uma resposta por pergunta com probabilidades anexadas. Nada é produzido token a token, então não há string para fazer parse nem JSON malformado para consertar. A TypeSafe cunhou esse termo em referência à famosa divisão de Daniel Kahneman:
Como o espaço de respostas é um esquema declarado pelo seu código, modelos System One, por design, nunca retornam uma categoria que você não definiu. Isso significa que nunca saem do esquema. Dito isso, eles ainda podem errar — e vamos ver alguns casos difíceis mais adiante.
A TypeSafe saiu do stealth em 15 de setembro de 2026 com o Jev em early access, reportando respostas de 70 a 500 ms e US$ 0,042 por milhão de tokens de entrada, com saída gratuita. No próprio benchmark de quatro workflows, o Jev fica perto de 68% de acurácia — mais ou menos território de LLM intermediário — a uma fração do custo.
Para mais informações sobre recursos e desempenho em benchmarks, recomendo ler nosso guia do Jev.
Anote as respostas válidas antes de fazer a chamada. Se você consegue enumerá-las, você tem um problema com a cara do Jev:
Procure um LLM quando a saída for texto ou código, quando o espaço de resposta for aberto ou quando a tarefa exigir várias etapas de raciocínio encadeadas. O Jev também é a ferramenta errada para qualquer coisa numérica, e volto ao porquê mais tarde.
Antes de escrever qualquer código, crie uma conta na TypeSafe e abra o Playground. Aqui, você pode colar um texto como estado, adicionar perguntas e ver os objetos de resposta completos sem instalar nada. É a forma mais rápida de entender o que cada tipo de pergunta devolve (e descobrir se a sua pergunta está mal formulada).
Vou usar um ticket de suporte como estado para os três exemplos:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Todo tipo de pergunta recebe instructions, a pergunta em linguagem natural que você quer responder. O que muda entre elas é o criteria e o que volta.
Um Choice escolhe uma opção de um conjunto que você define.
Você passa criteria como um dicionário que mapeia cada opção para uma descrição, de 1 a 255 delas, e a resposta volta com:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
Para ver o output de código que você também receberia via API, clique no botão </> no canto superior direito e clique em Run para o Jev responder à pergunta.
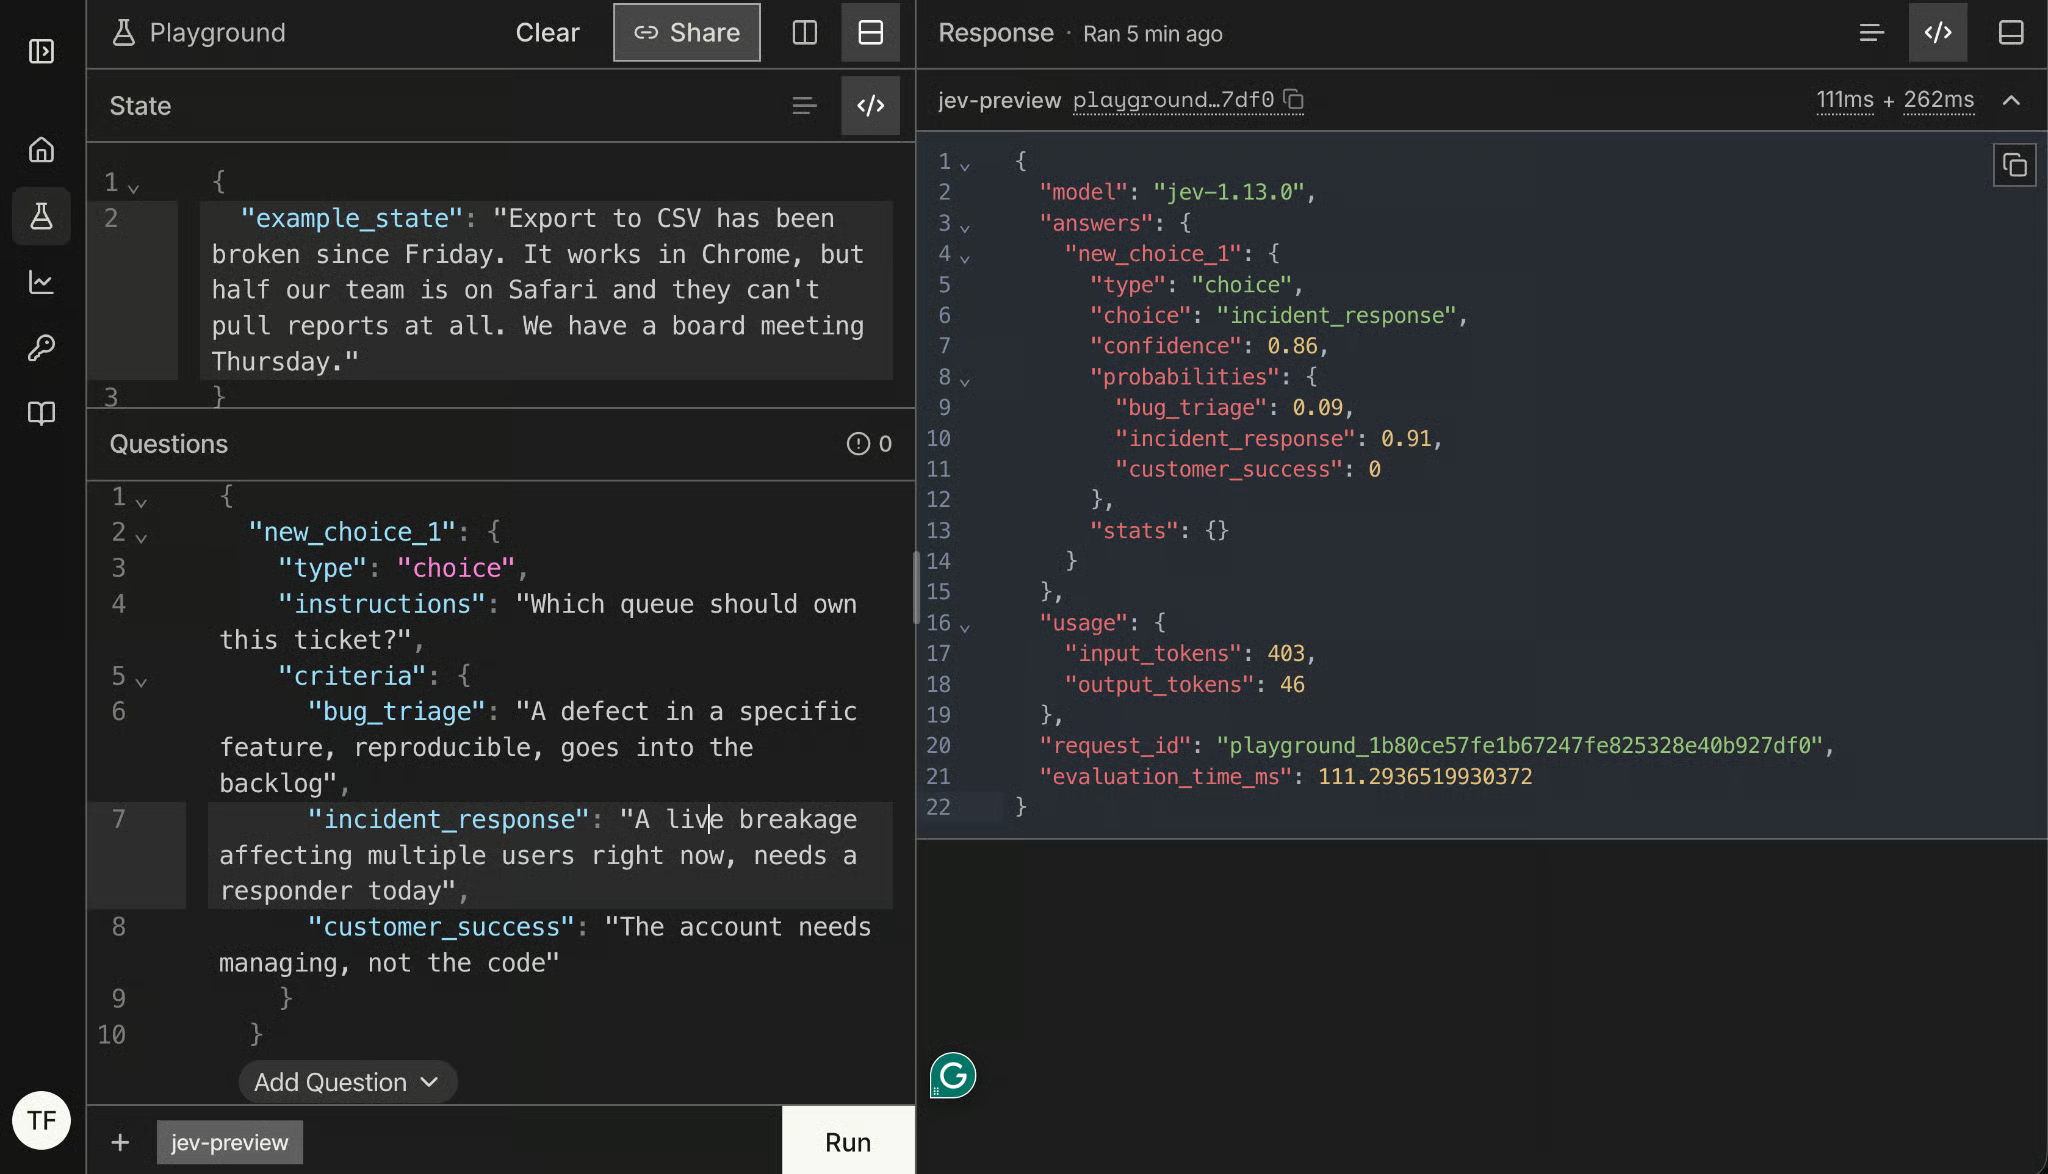
Neste caso, incident_response é o choice com probabilidade de 91%. A confidence do Jev para a escolha é 86%.
A distribuição completa é a parte que merece sua atenção.
choice só diz qual opção venceu.
probabilities diz por quanto.
Essas são informações diferentes quando você está prestes a rotear um ticket automaticamente. Uma divisão 0,41/0,38/0,21 e a 0,91/0,09/0 que recebemos podem ambas retornar o mesmo choice.
Um Score avalia o estado contra níveis ordenados. Você passa criteria como um array de 2 a 10 descrições de nível, do menor para o maior, e a resposta inclui um score, uma legend mapeando cada posição para sua descrição, uma probabilidade por nível e confiança.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}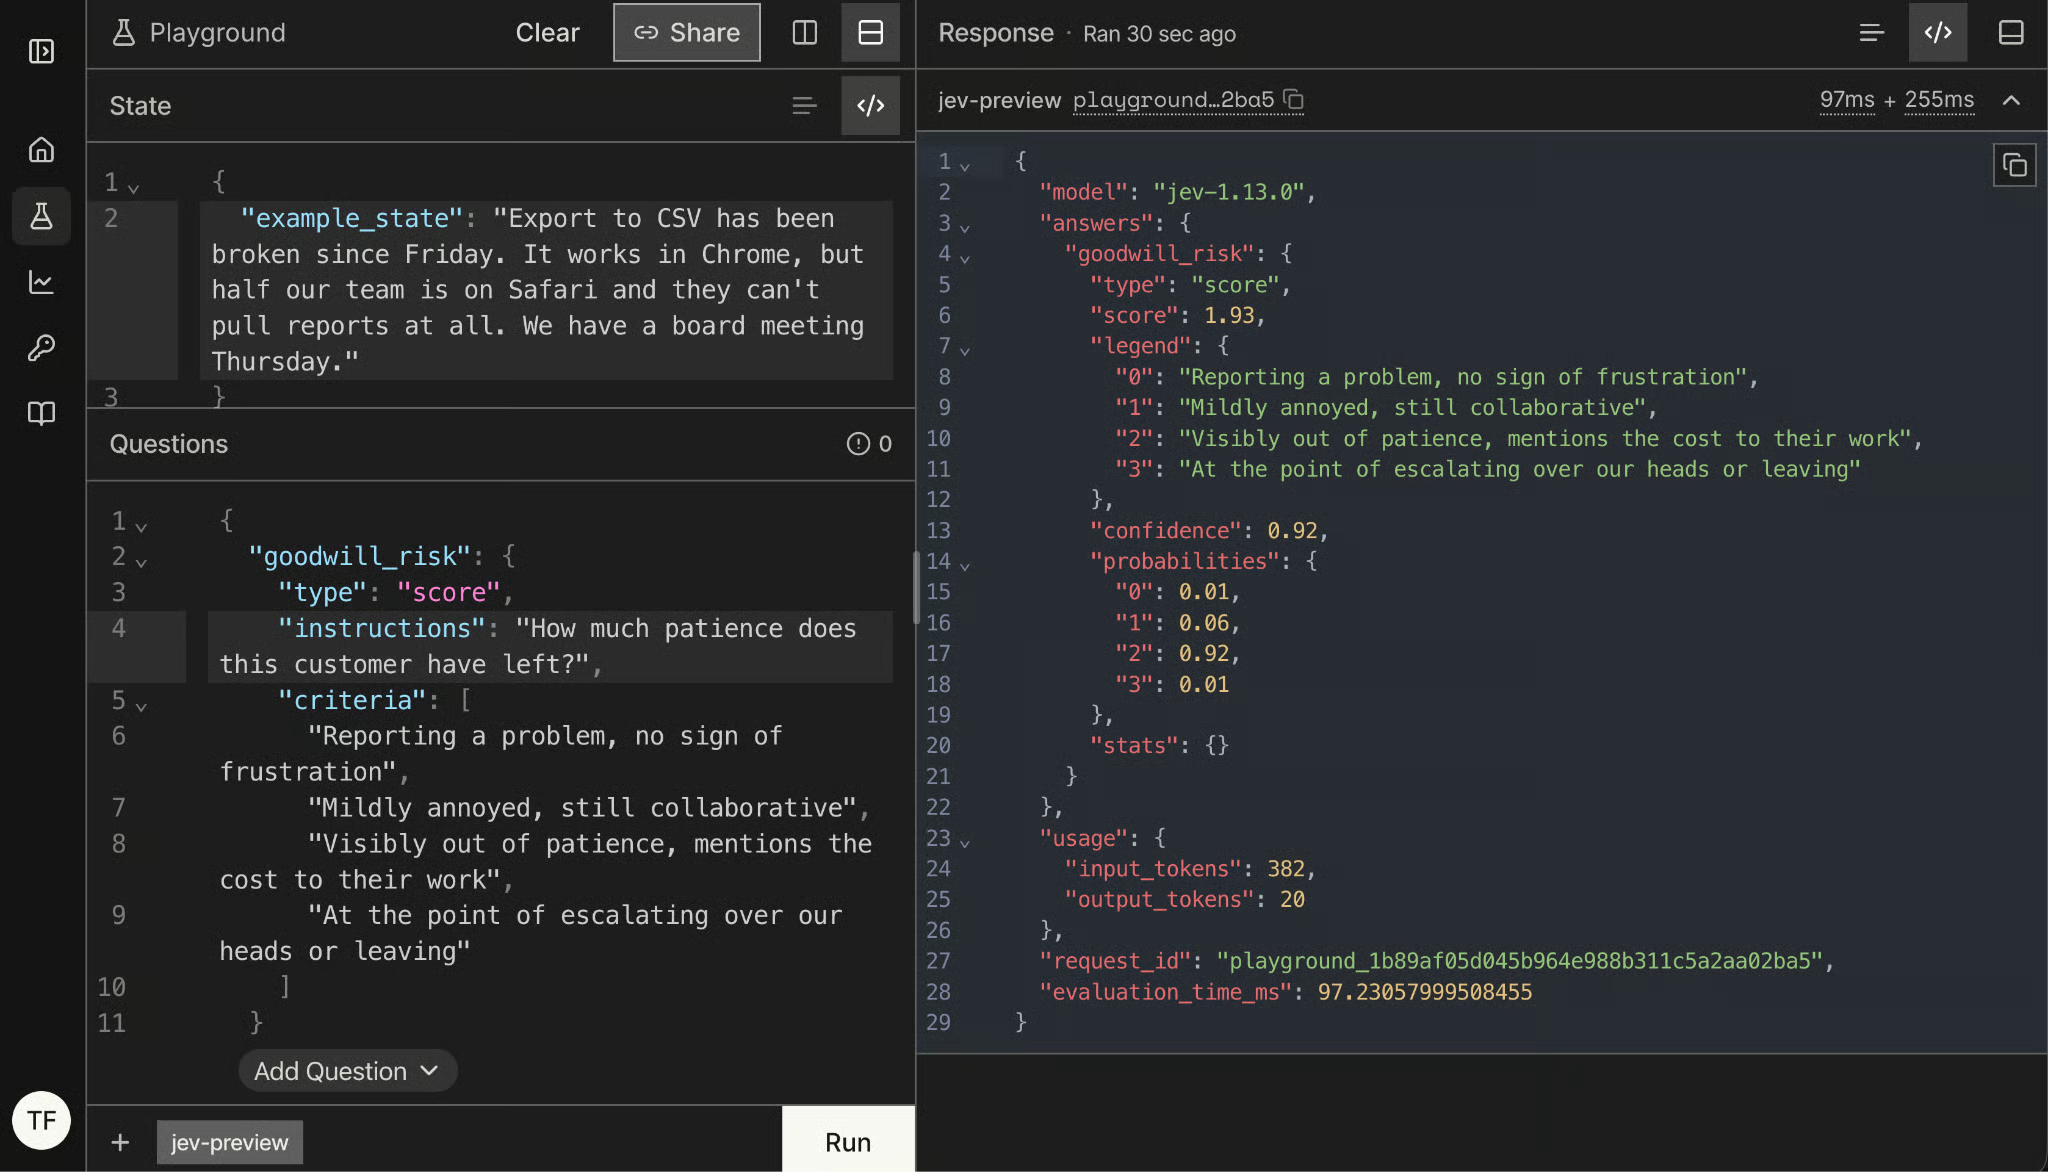
O score pode cair entre seus níveis — e é exatamente para isso que serve a legend. Um score de 1,93 aqui significa que o modelo está dividido entre "mildly annoyed" e "visibly out of patience", com forte inclinação para o segundo — o que faz sentido para um ticket que se mantém educado enquanto cita um prazo que vai perder.
De novo: leia a distribuição de probabilities em vez do número isolado. Probabilidade concentrada em um nível indica resposta decisiva; probabilidade espalhada por três indica que você ganhou uma média, não um julgamento.
Noul é o tipo para perguntas binárias, e o nome foi cunhado pela TypeSafe. criteria é opcional aqui, embora você possa descrever o que true e false significam — o que vale a pena quando "sim" pode ser lido de duas formas.
Formule a pergunta de modo que valor alto signifique sim. A documentação da TypeSafe é explícita sobre isso, e um Noul cujo true mapeia para "não" tem desempenho visivelmente pior.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}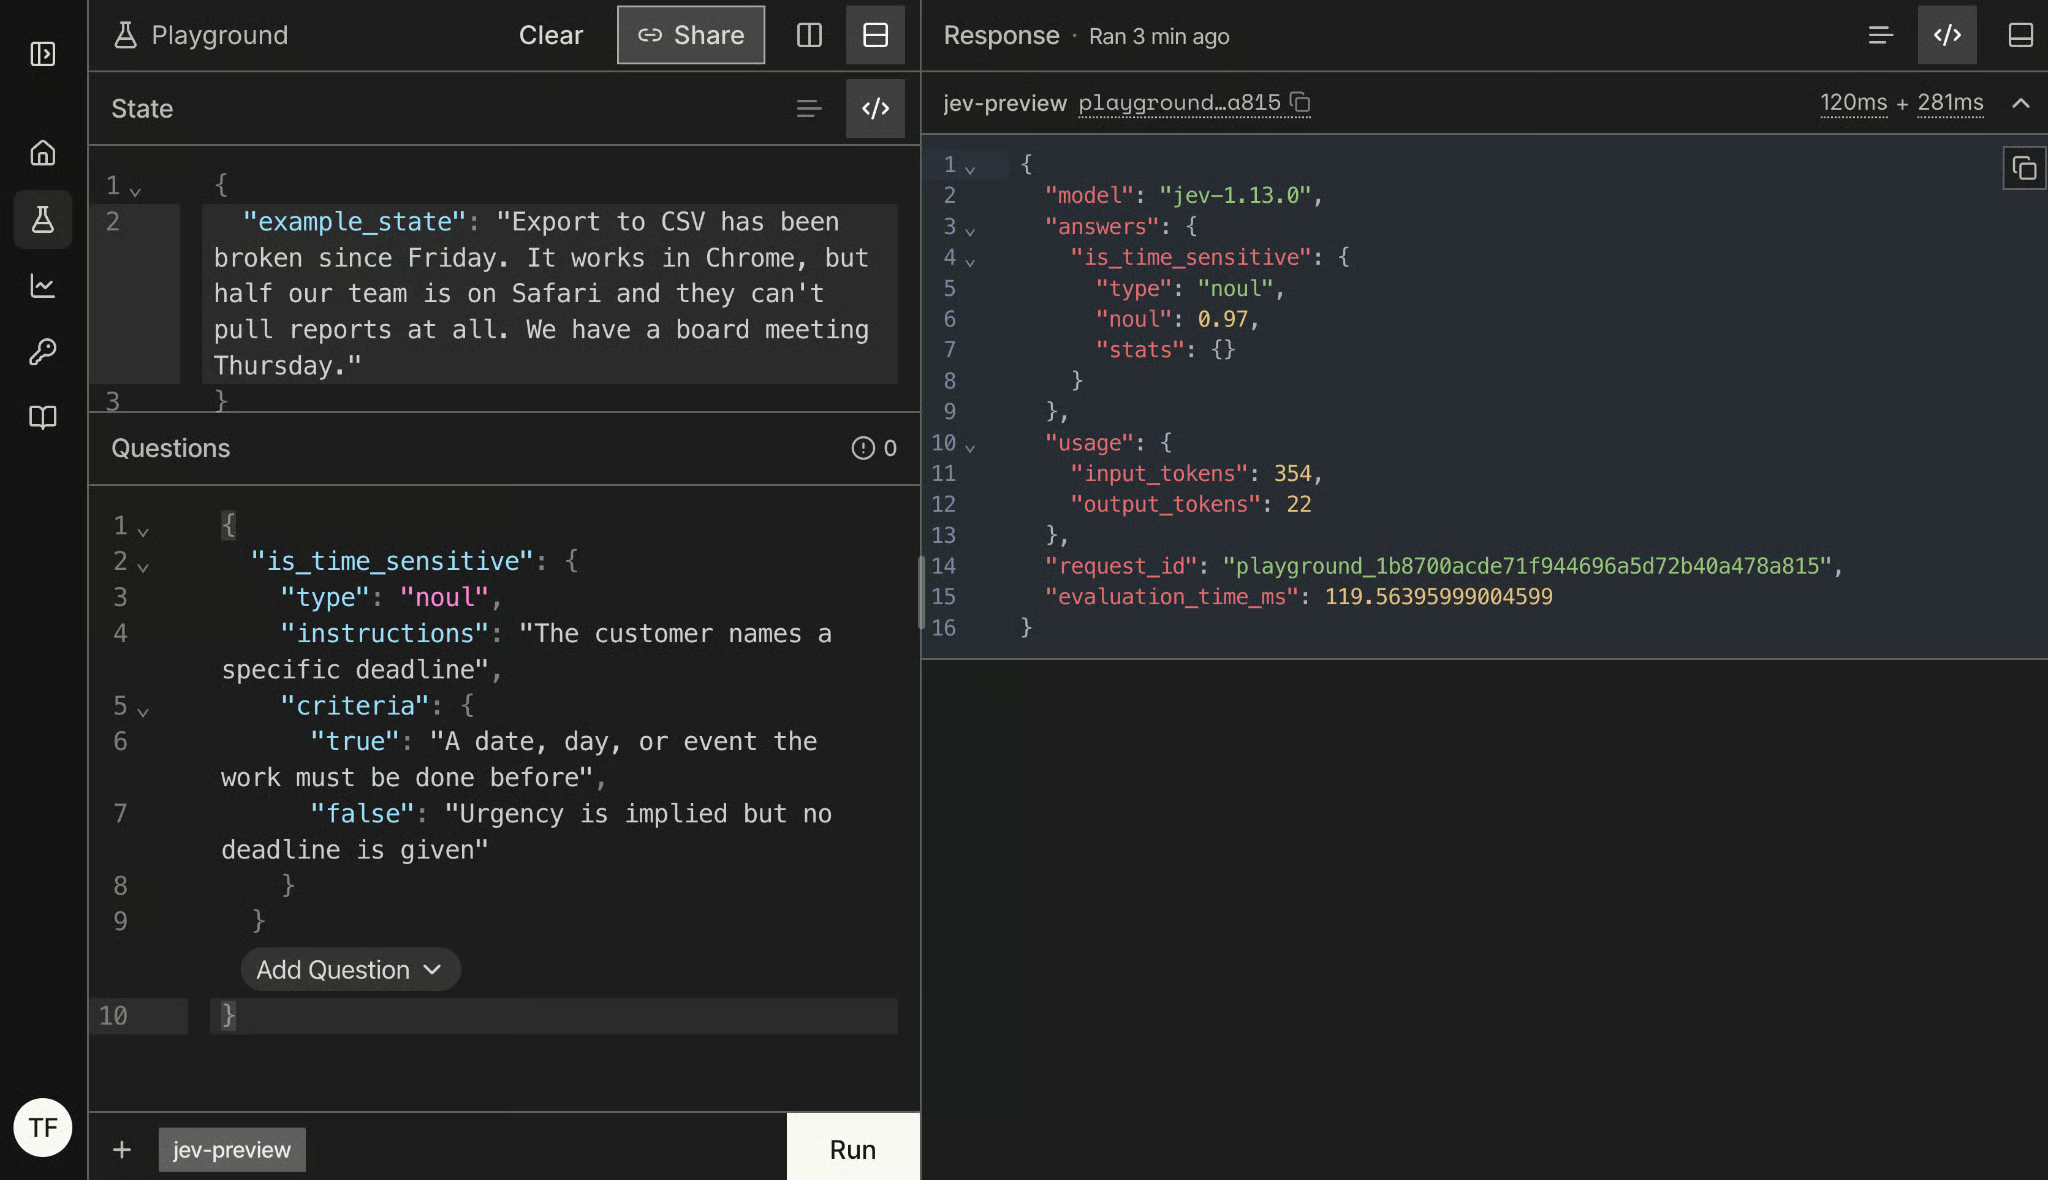
Como o estado menciona uma reunião do conselho na quinta-feira, o valor noul alto de 0,97 era esperado.
Choice e Score retornam confiança junto com as probabilidades. Um Noul não, e isso confunde muita gente — vale explicar o motivo com precisão.
Confiança e probabilidade são eixos diferentes. Em um Choice, probabilities diz como o modelo distribui crença entre suas opções, e confidence diz o quão firme ele está nessa resposta — por isso um Choice pode retornar uma opção top de 0,85 com confiança 0,78. Um Noul tem só dois desfechos, então a probabilidade única já carrega ambos: 0,97 é um sim firme, 0,03 é um não firme e 0,52 é o modelo dizendo que não faz ideia.
Isso significa que a distância de 0,5 é o seu sinal de decisão — não um campo separado. Também significa que você não pode portar um threshold de um Noul para um Choice, e volto a isso na seção de arestas, porque morde mais do que parece.
Para acompanhar, você só vai precisar de Python 3.10+ e uma chave de early access da TypeSafe.
Instale o SDK:
pip install typesafe-sdkOu com uv:
uv add typesafe-sdkDepois, crie uma chave no console da TypeSafe e exporte. O cliente lê TYPESAFE_API_KEY do ambiente, então você nunca passa isso no código:
export TYPESAFE_API_KEY="your-key"Os imports a seguir te dão tudo o que há no playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul e Score são os mesmos tipos de perguntas em que você acabou de clicar, agora como objetos Python.
TypeSafeClient é o cliente síncrono; existe um AsyncTypeSafeClient com a mesma interface se você for chamar o Jev de um serviço assíncrono. Ambos funcionam como context managers — o que eu usaria em qualquer coisa maior que um script:
with TypeSafeClient() as client:
...Sem configuração, o cliente chama jev-latest, que muda sempre que a TypeSafe lança uma nova versão — e é o que vamos usar ao longo do tutorial. Para qualquer coisa em que você já ajustou um threshold, fixe a versão:
client = TypeSafeClient(model="jev-1.13.0")A resposta te diz qual modelo realmente respondeu de qualquer forma, e há uma seção perto do fim sobre por que você deve registrar isso em log.
Para fazer uma chamada de API ao Jev, você precisa definir um item response usando TypeSafeClient e a função system_one(), que recebe o contexto da sua pergunta como parâmetro state e as questions no mesmo formato do playground.
Podemos criar uma chamada que responda às nossas 3 perguntas do playground, já que elas compartilham o mesmo state:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
As respostas voltam sob os mesmos nomes que você escolheu para cada pergunta — e é esse detalhe que deixa tudo agradável de trabalhar:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97Se sua primeira chamada falhar com um TypeError sobre output_buffer_limit: isso é um desencontro de versão no backend de compactação do SDK, não no seu código. O SDK traz seu próprio cliente HTTP, o httpx2, que descompacta respostas via zstandard e brotli, e uma cópia antiga de um deles não tem o argumento com que está sendo chamado. pip install -U typesafe-sdk httpx2 zstandard brotli resolveu aqui.
Duas coisas nessa saída valem a pausa.
Primeiro, response.model retornou jev-1.13.0, não jev-latest. Você pediu o alias móvel e o Jev disse qual versão realmente respondeu — e é por isso que registrar esse campo em log é barato o suficiente para valer a pena.
Segundo, os objetos de resposta são tipados por tipo de pergunta, então .choice, .score e .noul são atributos reais e o seu editor sabe disso. Não há string JSON em lugar nenhum deste código, nada a fazer parse, e nenhum branch para a chamada que voltou malformada. Se você preferir agrupar, o SDK também expõe response.choices, response.scores e response.nouls, com as mesmas chaves.
Confira também response.usage:
print(response.usage.input_tokens, response.usage.output_tokens)524
78Tokens de saída são de um dígito e gratuitos. Você paga pelo estado e pelas perguntas, então consegue controlar totalmente o custo decidindo quanta coisa de contexto envia. Isso importa mais do que parece e volta na seção das arestas: um estado inchado te custa dinheiro e acurácia ao mesmo tempo.
Esse é um dos casos de uso para os quais o Jev foi feito. Um ticket de suporte chega e algo precisa decidir para qual fila ele vai, se um humano deve olhar antes e com que rapidez. Cada uma dessas é um julgamento com um espaço de resposta que você consegue escrever antes do ticket chegar.
A regra de design que vale declarar logo de cara: o Jev decide o que é; seu código decide o que acontece. O Jev nunca roteia nada. Ele retorna números, e o roteamento vive em uma função comum que você pode ler, testar e mudar sem tocar no modelo.
Perguntas em uma única requisição são avaliadas em paralelo, então uma sexta pergunta te custa os tokens com que ela foi escrita e quase nenhuma latência extra. Isso muda como você pergunta. Com um LLM, você agruparia com cuidado para poupar idas e voltas; aqui você pergunta tudo o que pode querer sobre certo contexto, incluindo perguntas que provavelmente vai ignorar.
Vamos expandir nossas perguntas anteriores com mais três Nouls que nos dão informações importantes sobre como tratar o ticket:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Seis perguntas, todas respondidas em uma chamada e uma cobrança. is_automated é a especulativa: é falso em quase todo ticket real, e ainda assim vale perguntar porque, na única vez que for verdadeiro, poupa uma pessoa de abrir um bounce de mailer daemon.
Dois hábitos que eu adotaria aqui.
Mantenha o conjunto de perguntas como uma constante em nível de módulo em vez de construí-lo inline, porque é ele que você vai versionar junto com seus thresholds.
E nomeie perguntas pelo que elas medem, não pelo que você fará com a resposta, já que is_time_sensitive sobrevive a uma mudança de política e route_to_incident não.
Perguntas formuladas positivamente: poderíamos ter chamado is_automated de algo como needs_no_reply, mas, segundo a TypeSafe, o desempenho para perguntas formuladas positivamente é melhor.
Agora a parte que o Jev não faz. Toda resposta chega com um valor de confiança ou uma probabilidade, e esse segundo número permite construir três caminhos em vez de dois:
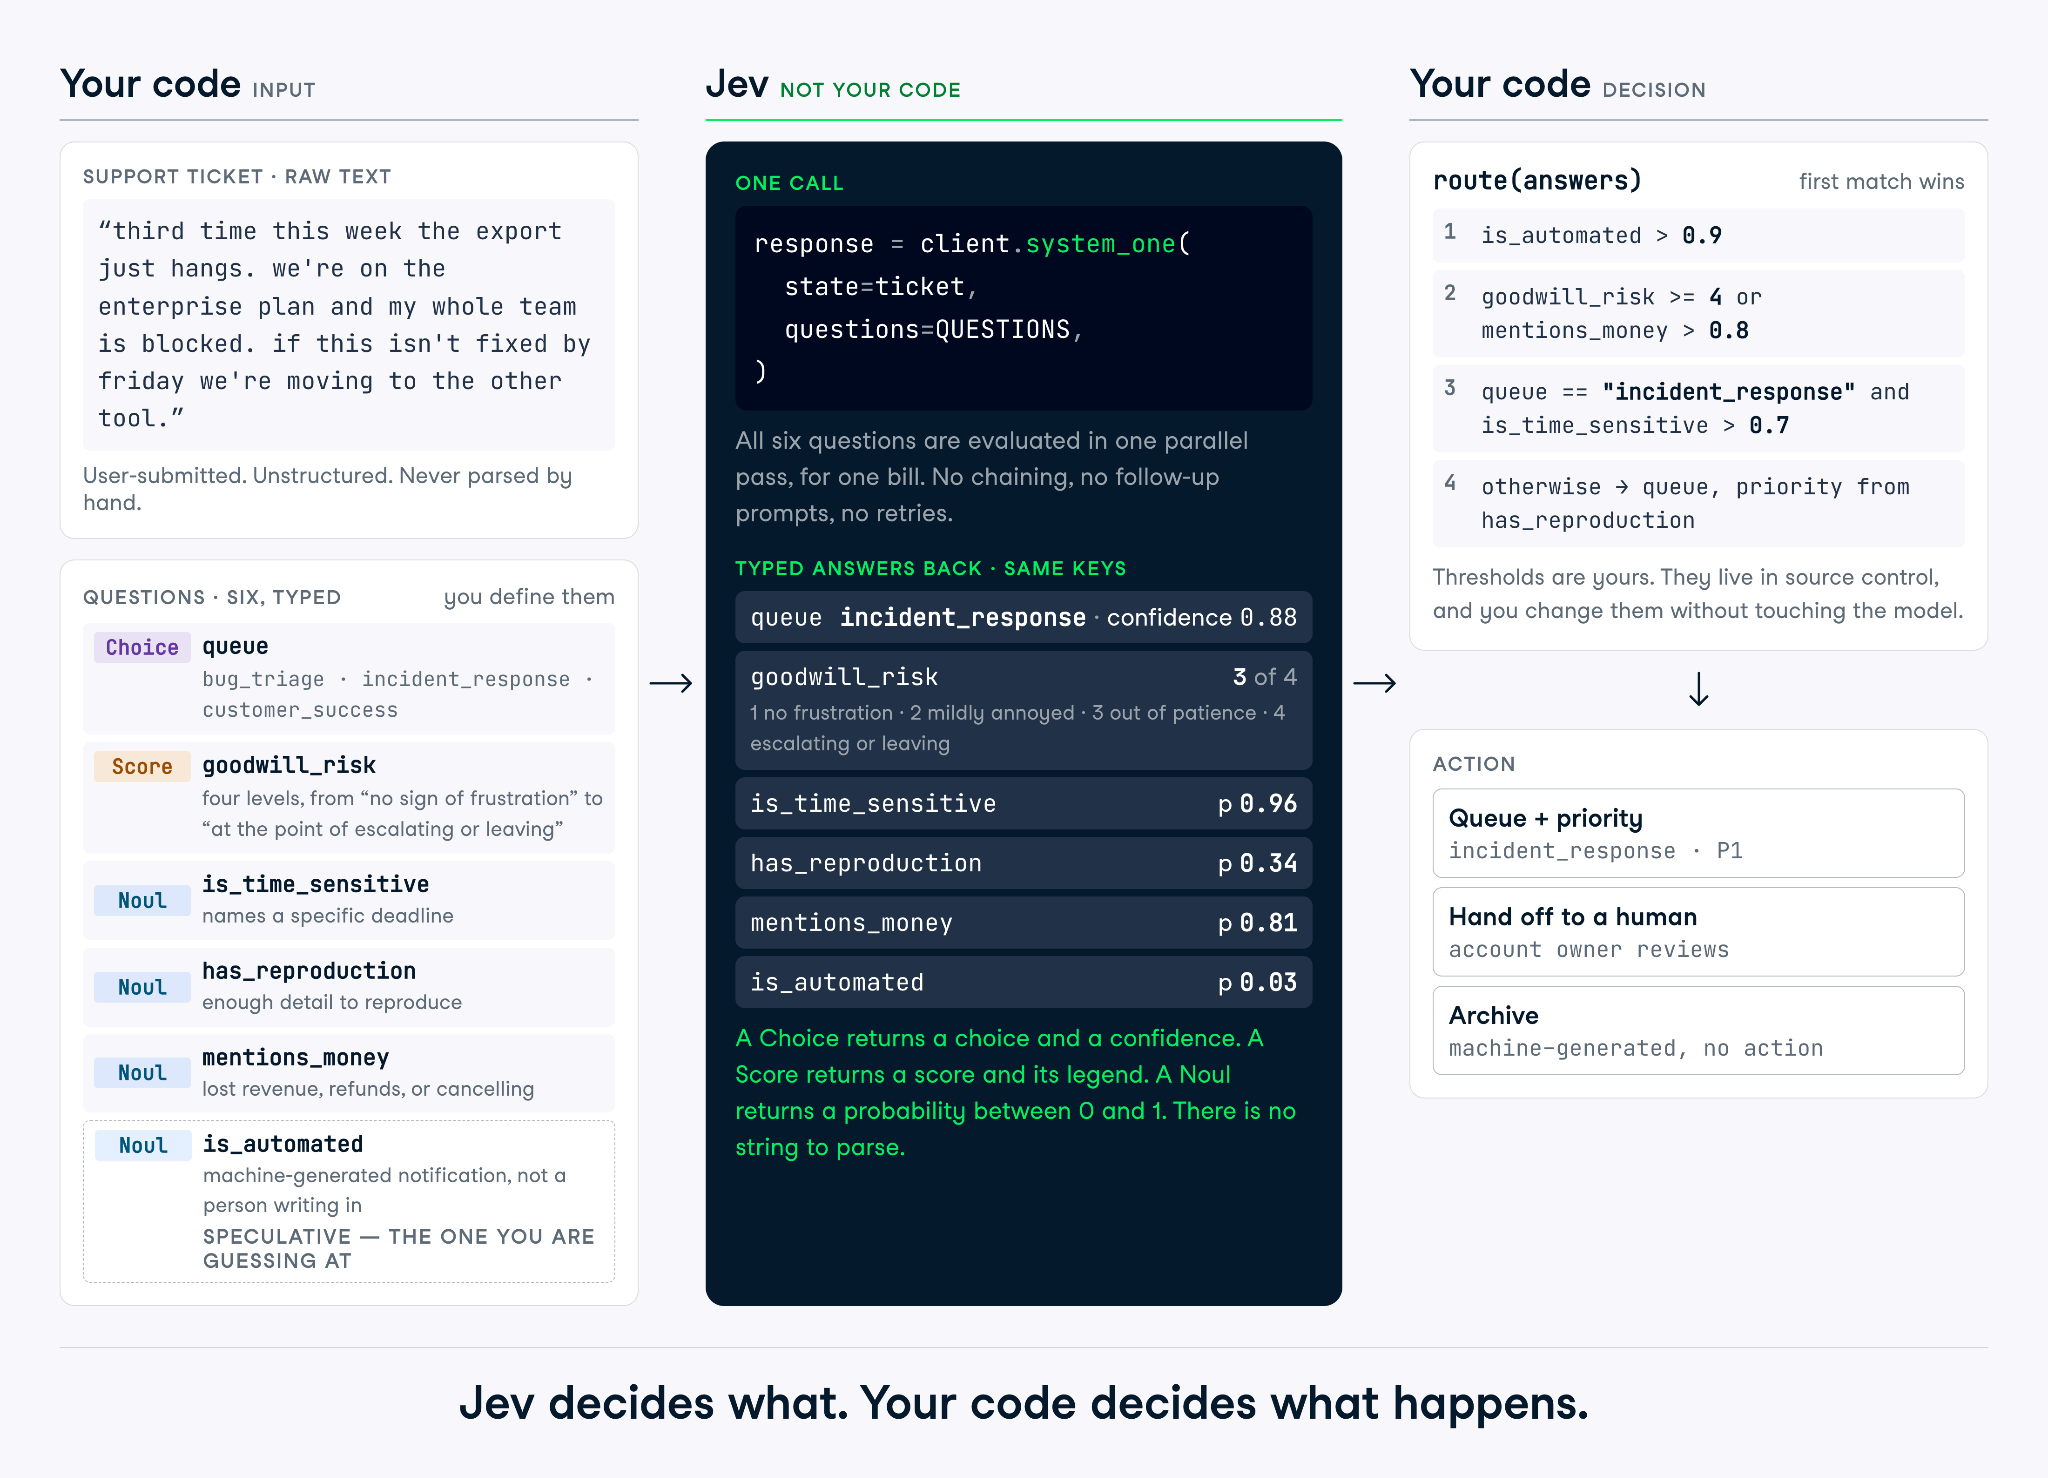
Vamos transformar isso em algumas regras para rotear tickets:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Leia o que essa função está fazendo. O modelo forneceu seis julgamentos, e a política decidiu que um deles — mentions_money cruzado com cliente frustrado — tem prioridade sobre a fila escolhida pelo Jev. Esse override é uma decisão de negócios, pertence ao código e você pode mudá-lo numa sexta-feira à tarde sem retestar o modelo.
has_reproduction nunca é usado. Eu deixei de propósito, porque é assim que o padrão de fan-out fica na prática: você pede mais do que a política atual consome, registra tudo e, quando alguém perguntar se tickets de bug_triage sem passos de repro demoram mais para fechar, você já tem seis semanas da resposta.
Os thresholds acima são só exemplos. Descobrir os certos é questão de calibração, e há uma seção no fim sobre como defini-los com dados em vez de intuição.
Você pode acessar o script completo neste repositório no GitHub. Quando executei o script Python com nosso cenário, o julgamento foi rotear o ticket para o time de incident response hoje.
python routing.py('incident_response', 'today')A TypeSafe publica uma página de arestas por versão do modelo, listando os modos de falha conhecidos. Queria que mais labs fizessem isso. Leia antes de construir qualquer coisa, e leia de novo quando atualizar, porque a lista é versionada e as arestas se movem.
Aqui vão cinco que mais me custariam tempo.
Você não consegue portar um threshold entre tipos de pergunta. O exemplo da própria TypeSafe pergunta "O cliente está pedindo reembolso?" das duas formas no mesmo ticket: o Noul retorna 0,22; o Choice de sim/não retorna 0,01 para sim, com 0,97 de confiança. Mesma pergunta, dois números, duas ordens de grandeza de diferença.
Negações também não cooperam. Um Noul e seu oposto voltaram 0,72 e 0,47, que somam 1,19.
A razão é que os dois tipos perguntam coisas diferentes. Choice é relativo e decide qual opção vence, enquanto cada Noul é absoluto e pode ser baixo para todas. Ajuste thresholds por pergunta, no formato em que você vai embarcar, e nunca assuma que P(yes) e 1 - P(no) são o mesmo número.
Níveis de Score são ordenados, não espaçados. Um 1,6 diz que o modelo está entre seu segundo e terceiro nível, inclinando ao terceiro — e é só isso que diz.
O que você não pode fazer é interpolar uma quantidade real a partir dele. Se seus níveis são "menos de uma hora", "algumas horas" e "um dia", 1,5 não significa cinco horas. Use o score para testar um threshold e mantenha todo número real no código.
O Jev trata o estado como dado, mas ele não é blindado contra código escrito no estado para direcioná-lo. Uma instrução injetada, um enquadramento enganoso ou um texto argumentando pela própria classificação podem mover a resposta — e a TypeSafe diz que espera melhorar aqui. Se a superfície de ataque é novidade para você, cobrimos o guia de prompt injection no caso geral.
Isso importa mais quando o estado é enviado por usuário — o que, para um roteador de tickets, é sempre. Escreva critérios precisos o suficiente para que as declarações do próprio ticket sobre si não decidam o resultado e teste com entradas hostis antes de rotear qualquer coisa automaticamente.
Contagem é pouco confiável e piora conforme a coisa a ser contada cresce, porque o modelo reconhece o formato de uma resposta em vez de somar. Datas são lidas como texto, então ordenação, distância e janelas dão errado. Codificações numéricas têm desempenho pior que equivalentes semânticos, então pergunte sobre "vermelho" em vez de #FF0000.
A correção é a mesma nos três casos: divida o trabalho.
Se você precisa de uma contagem, itere no código e pergunte um Noul por item:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Três pontos menores com a mesma causa. O Jev responde à pergunta que você escreveu, não à que você quis dizer — então palavras de escopo e negações são lidas ao pé da letra. Duplas negações e perguntas sobre a propriedade de uma propriedade custam acurácia. E um estado grande, acolchoado com detalhes irrelevantes, custa acurácia e dinheiro, já que material não relacionado atua como distrator.
O indício para o primeiro: quando você olha para uma resposta errada e se pega explicando o que realmente quis dizer, essa explicação é a metade que faltou nas suas instruções.
Com base no que já vimos, aqui vão algumas boas práticas para tirar mais proveito do Jev.
Escreva a condição, não a intenção. Se você está explicando o que quis dizer ao revisar uma resposta errada, essa explicação pertence às instruções. Em prática:
jev-latest se move. Fixe a versão assim que um threshold depender do comportamento do modelo:
client = TypeSafeClient(model="jev-1.13.0")Registre response.model junto com as respostas completas em toda chamada, não só o valor em que você agiu. Quando um threshold começar a se comportar de forma estranha, esse log é o único jeito de diferenciar mudança de modelo de drift nos seus tickets.
Por fim, thresholds não são dados: são resultado de experimentação.
Jev é uma ferramenta estreita — e isso é proposital. Ele responde perguntas cujas respostas você consegue enumerar, barato o bastante para você parar de racioná-las, e entrega a decisão de volta ao seu código.
O ponto em que eu colocaria um asterisco é a ideia de "não pode alucinar". É verdade num sentido estreito que o modelo não responde fora do esquema, mas isso não diz nada sobre a correção da resposta. Um Choice sempre retorna uma fila válida. Ela ainda pode ser a fila errada com 0,9 de confiança — e a saída tipada torna essa falha mais silenciosa.
Para testar no seu trabalho, sugiro encontrar uma decisão que seu código toma com uma regra frágil ou uma chamada lenta de LLM e tentar escrever as respostas válidas. Se você conseguir, é um problema com a cara do Jev. Se não der, nenhuma engenharia de perguntas vai mudar isso.
Se quiser começar a construir sistemas que usam IA, recomendo muito se inscrever na nossa Associate AI Engineer for Developers career track. Você vai aprender a trabalhar com a OpenAI API, MCP, LangChain e muito mais.
Aprenda engenharia de IA com a DataCamp!
Programa
Curso
Curso