track
Associate AI Engineer för utvecklare
26 timmar
Jag nämnde redan att förväntningarna måste matcha modellen. Det gäller särskilt för Jev, och det handlar mest om dess modellklass, som kallas System One-modeller.
En System One-modell returnerar typade beslut i stället för text. Du skickar ett block med tillstånd plus en uppsättning frågor, var och en med ett svarsutrymme du definierar, och modellen returnerar ett svar per fråga med sannolikheter. Inget produceras token för token, så det finns ingen sträng att parsa och inget felaktigt JSON att reparera. TypeSafe myntade termen med hänvisning till Daniel Kahnemans kända uppdelning:
Eftersom svarsutrymmet är ett schema din kod deklarerar kan System One-modeller per design aldrig returnera en kategori du inte har definierat. Det betyder att den aldrig kan vara utanför schemat. Däremot kan den fortfarande ha fel, och vi kommer till några knepiga fall senare.
TypeSafe kom ut ur stealth den 15 september 2026 med Jev i tidig åtkomst, med 70 till 500 ms svarstider och $0,042 per miljon inmatningstoken med gratis utdata. På sin egen fyrarbetsflödes-benchmark landar Jev kring 68% noggrannhet, ungefär i mellanskiktet för LLM:er till en bråkdel av kostnaden.
För mer information om funktioner och benchmarkresultat rekommenderar jag att du läser vår Jev-guide.
Skriv ner de giltiga svaren innan du gör anropet. Om du kan räkna upp dem har du ett Jev-format problem:
Välj en LLM när utdata är prosa eller kod, när svarsutrymmet är öppet eller när uppgiften kräver flera steg av kedjad slutledning. Jev är också fel verktyg för allt numeriskt, och jag återkommer till varför senare.
Innan du skriver någon kod, skapa ett TypeSafe-konto och öppna Playground. Här kan du klistra in text som tillstånd, lägga till frågor och se hela svarobjekten utan att installera något. Det är det snabbaste sättet att förstå vad varje frågetyp returnerar (och att ta reda på om din fråga är dåligt formulerad).
Jag använder en supportbiljett som tillstånd för alla tre exemplen:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
Varje frågetyp tar instructions, den vardagliga formuleringen av frågan du vill få besvarad. Det som skiljer dem åt är criteria och vad som kommer tillbaka.
En Choice väljer ett alternativ från en uppsättning du definierar.
Du skickar criteria som ett dictionary-objekt som mappar varje alternativ till en beskrivning, allt från 1 till 255 stycken, och svaret kommer tillbaka med:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
För att se kodutdata som du också skulle få via API, klicka på </>-knappen uppe till höger och klicka på Run för att låta Jev svara på frågan.
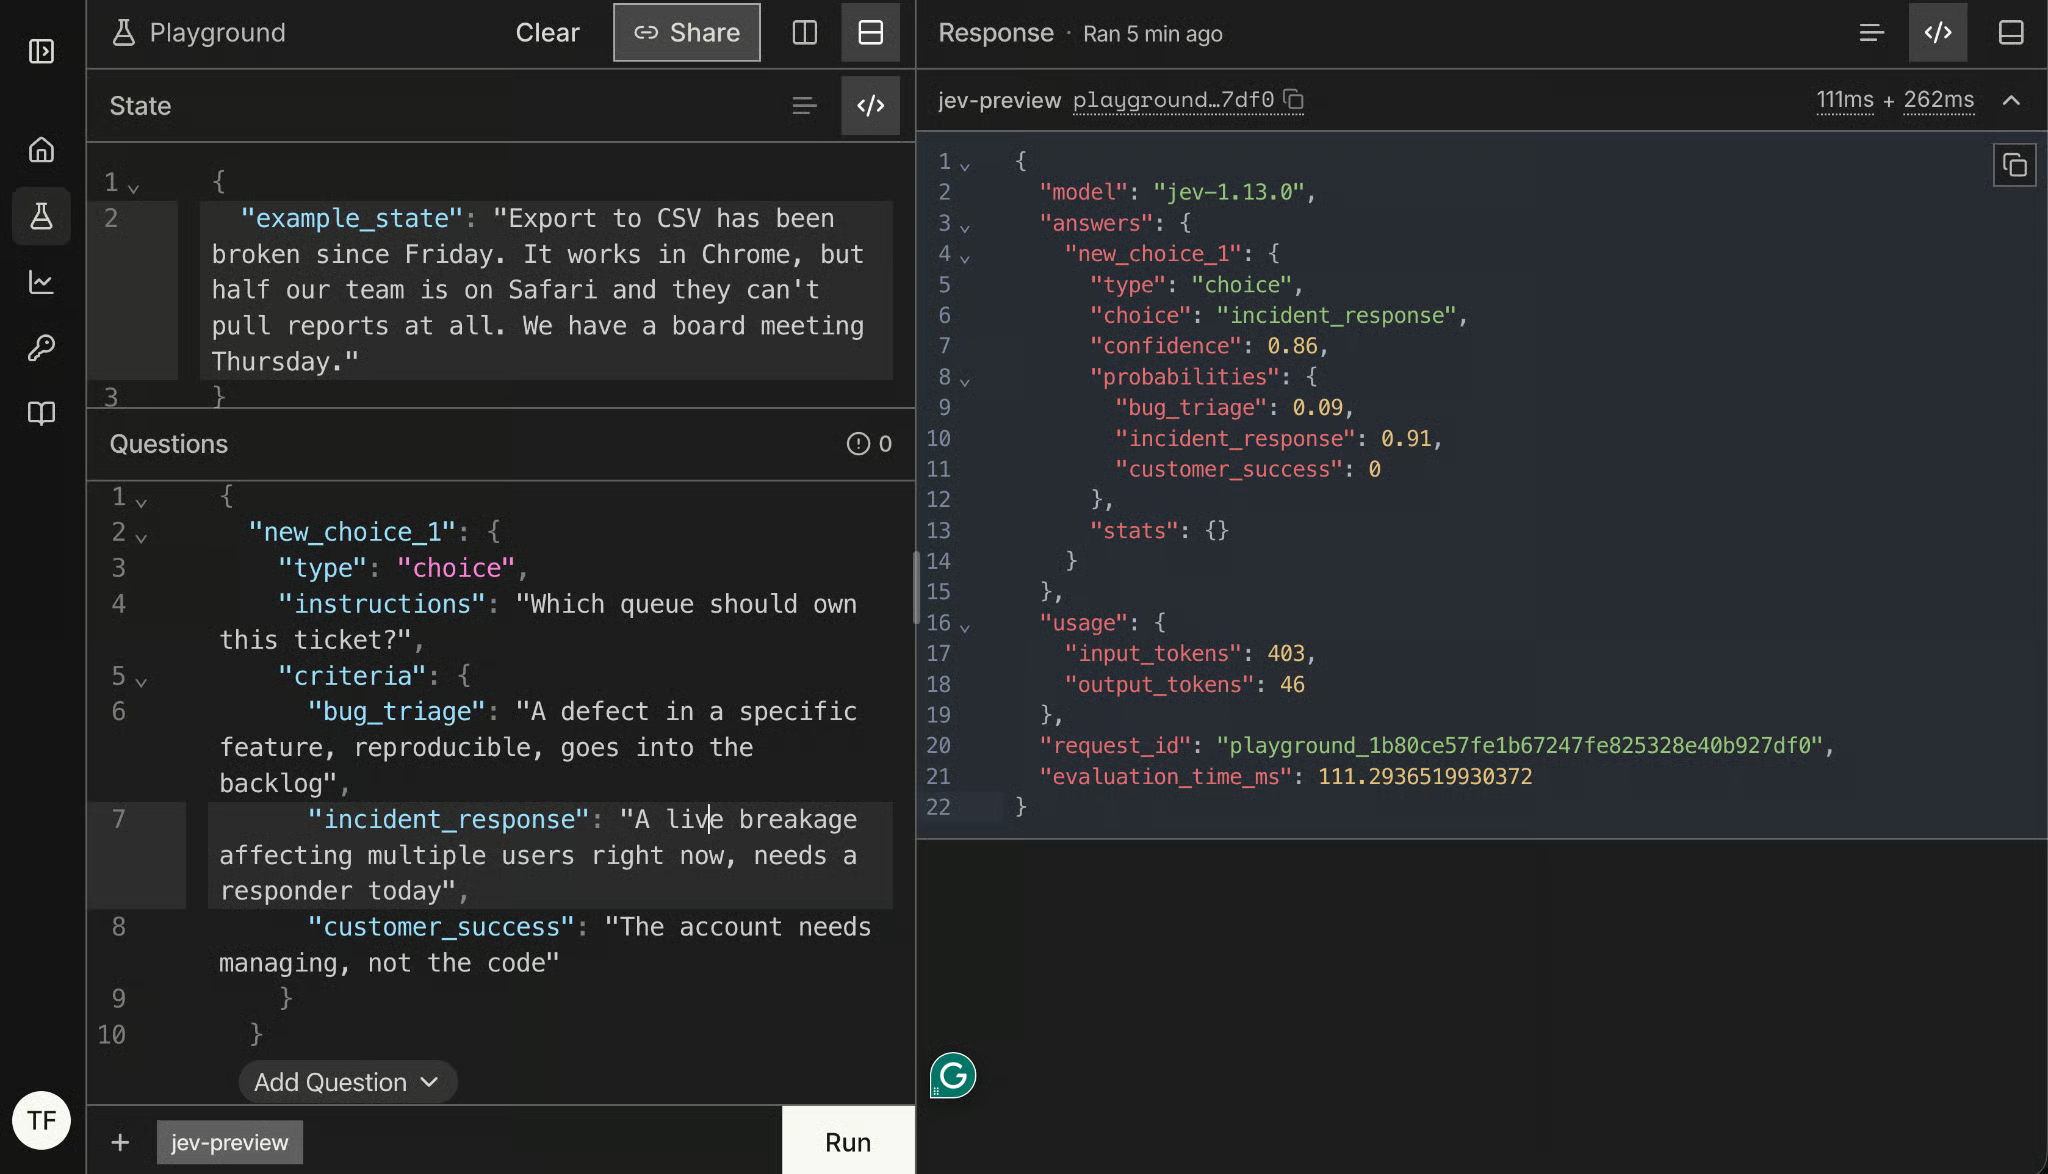
I det här fallet är incident_response choice med 91% sannolikhet. Jevs confidence för valet är 86%.
Den fulla fördelningen är delen som förtjänar din uppmärksamhet.
choice berättar bara vilket alternativ som vann.
probabilities berättar med hur mycket.
Det är olika informationsbitar när du ska dirigera en biljett automatiskt. En 0,41/0,38/0,21-fördelning och 0,91/0,09/0 vi fick kan båda returnera samma choice.
En Score betygsätter tillståndet mot ordnade nivåer. Du skickar criteria som en array med 2 till 10 nivåbeskrivningar, lägsta först, och svaret inkluderar en poäng, en legend som mappar varje position till din beskrivning, en sannolikhet per nivå och confidence.
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}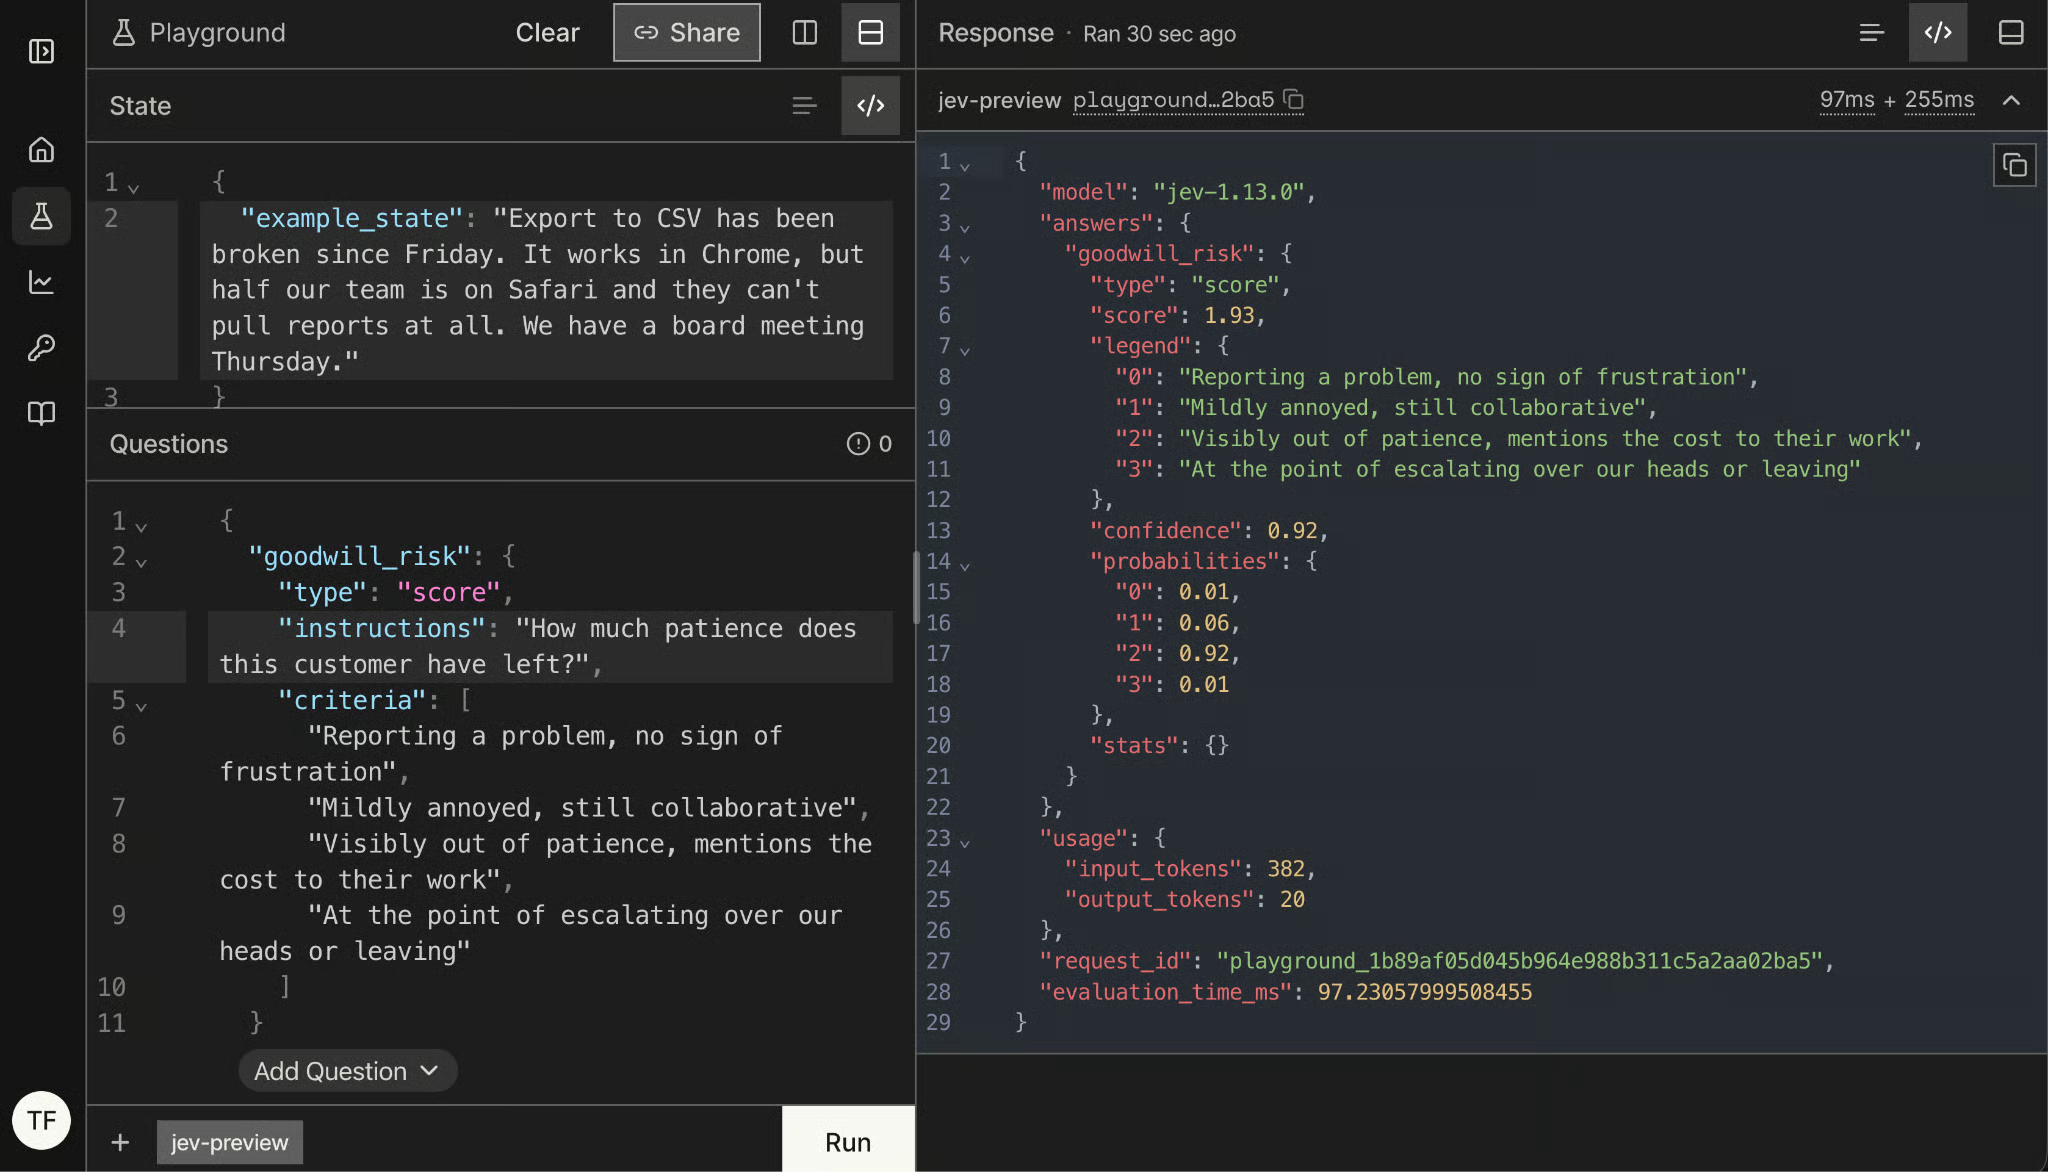
Poängen kan landa mellan dina nivåer, och det är hela poängen med legend. En score på 1,93 här betyder att modellen är delad mellan ”milt irriterad” och ”tydligt otålig”, med stark lutning mot det senare, vilket är en rimlig tolkning av en biljett som förblir artig men nämner en deadline den kommer att missa.
Läs återigen spridningen av probabilities i stället för bara siffran: koncentrerad sannolikhet på en nivå betyder ett avgörande svar, utsmetad över tre betyder att du fick ett medelvärde i stället för en bedömning.
En Noul är typen för binära frågor, och namnet myntades av TypeSafe. criteria är valfritt här, men du kan beskriva vad true och false betyder, vilket är värt att göra när ”ja” kan tolkas på två sätt.
Formulera frågan så att ett högt värde betyder ja. TypeSafes dokumentation är tydlig med detta, och en Noul vars true mappar till ”nej” presterar mätbart sämre.
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}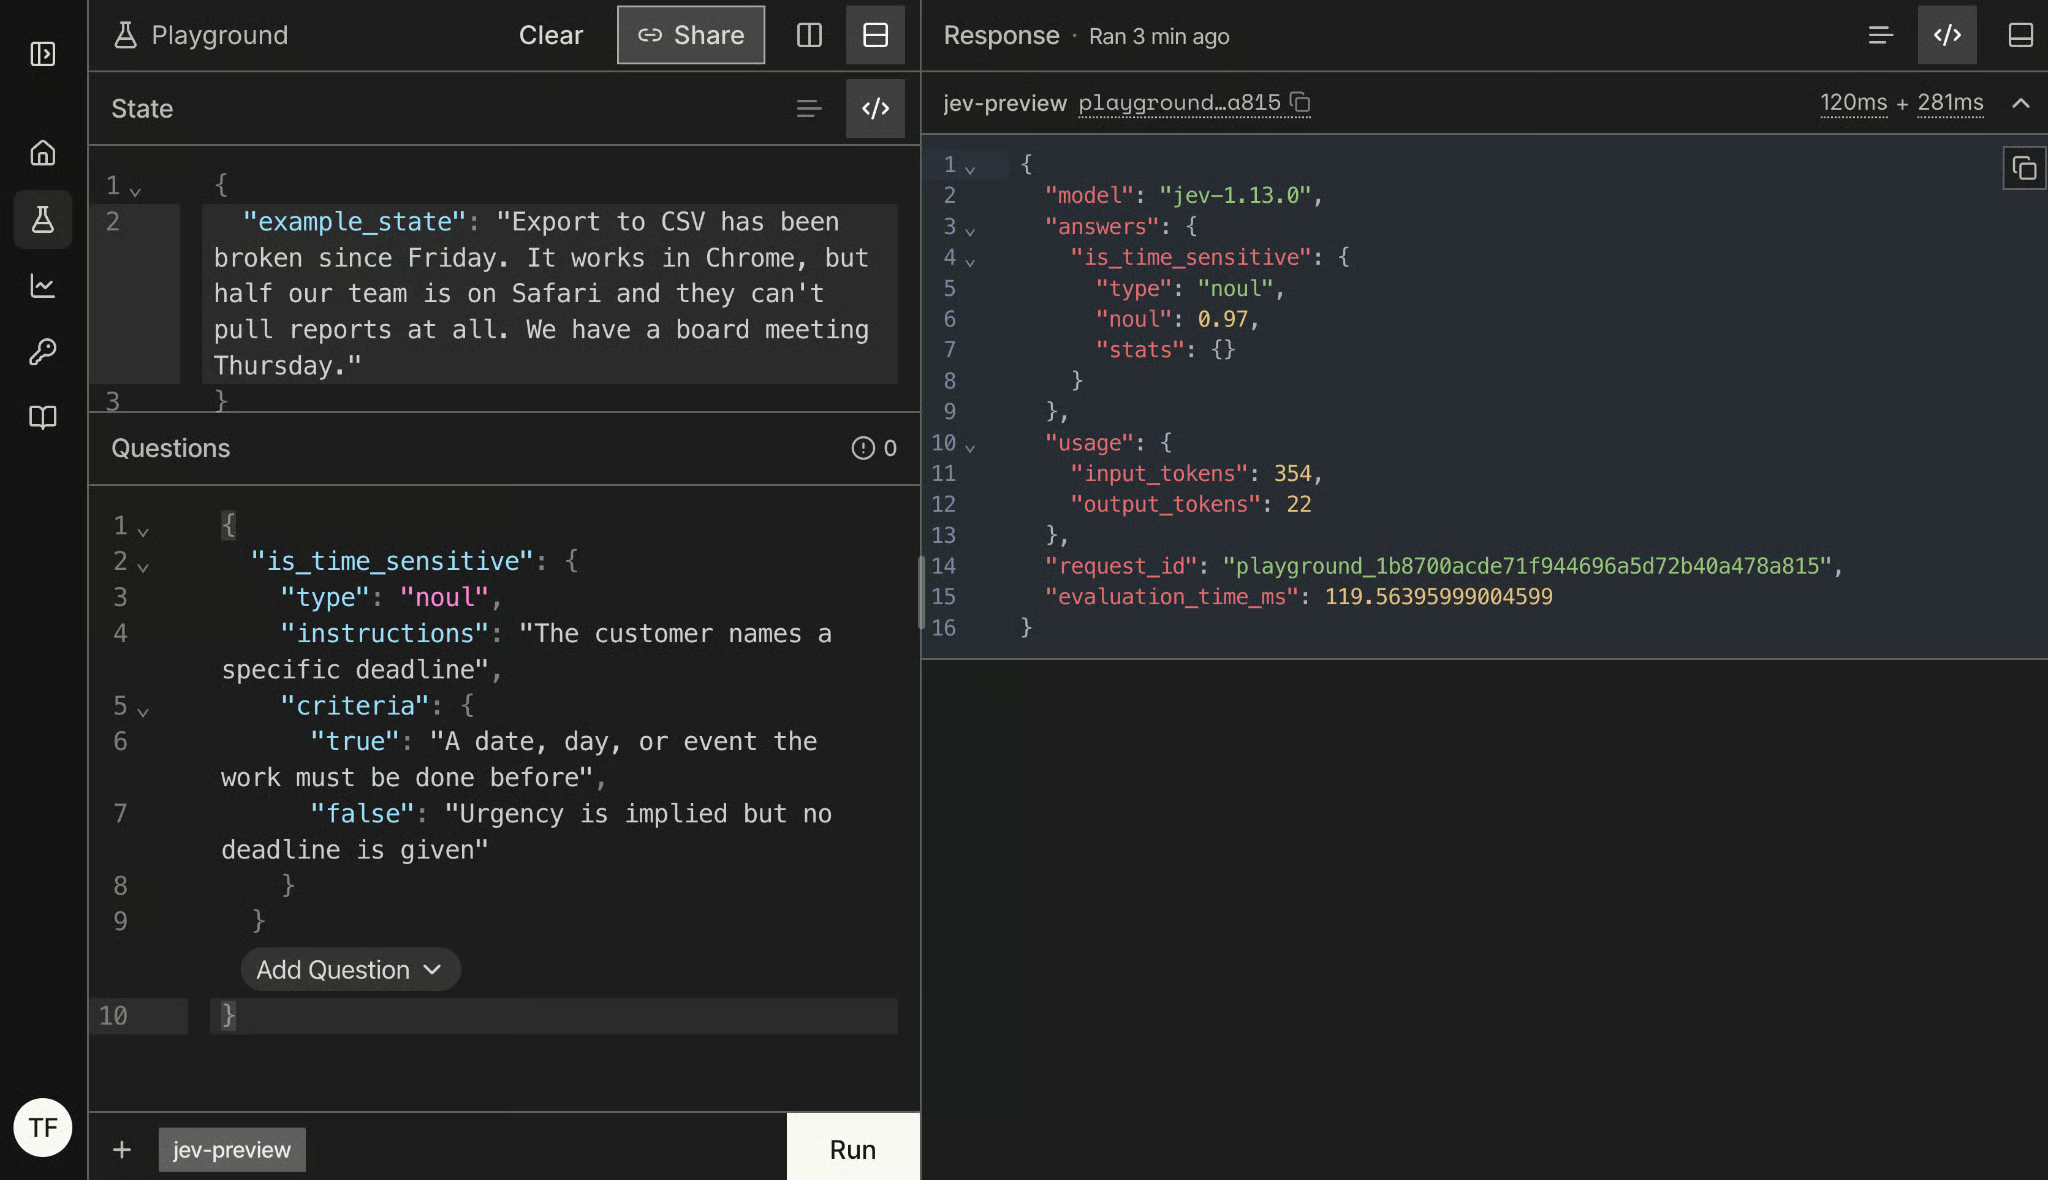
Eftersom ett styrelsemöte på torsdag nämns i tillståndet var det höga noul-värdet 0,97 väntat.
Choice och Score returnerar confidence tillsammans med sina sannolikheter. En Noul gör inte det, och det snubblar folk på, så det är värt att vara exakt med varför.
Confidence och sannolikhet är separata axlar. För en Choice säger sannolikheter hur modellen fördelar tro över dina alternativ, och confidence säger hur fast den håller vid svaret, vilket är varför en Choice kan returnera ett toppalternativ på 0,85 med confidence 0,78. En Noul har bara två utfall, så den enda sannolikheten bär redan båda: 0,97 är ett säkert ja, 0,03 är ett säkert nej och 0,52 är att modellen säger att den inte har någon aning.
Det betyder att avståndet från 0,5 är din beslutsamhetssignal, inte ett separat fält att läsa. Det betyder också att du inte kan porta en tröskel från en Noul till en Choice, och jag återkommer till det i avsnittet om taggighet, för det biter hårdare än det låter.
För att följa med behöver du bara Python 3.10+ och en TypeSafe-nyckel för tidig åtkomst.
Installera SDK:t:
pip install typesafe-sdkEller med uv:
uv add typesafe-sdkSkapa sedan en nyckel i TypeSafe-konsolen och exportera den. Klienten läser TYPESAFE_API_KEY från miljön, så du skickar den aldrig i kod:
export TYPESAFE_API_KEY="your-key"Följande importer ger dig allt från playgrounden:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul och Score är samma frågetyper du just klickade igenom, som Python-objekt.
TypeSafeClient är den synkrona klienten, och det finns en AsyncTypeSafeClient med samma gränssnitt om du anropar Jev från en asynkron tjänst. Båda fungerar som context managers, vilket är vad jag skulle använda i allt längre än ett skript:
with TypeSafeClient() as client:
...Lämnad ifred anropar klienten jev-latest, som flyttar när TypeSafe släpper en ny version, vilket är vad vi använder genom hela handledningen. För allt där du redan har trimmat en tröskel, pinna i stället versionen:
client = TypeSafeClient(model="jev-1.13.0")Svaret talar om vilken modell som faktiskt svarade oavsett, och det finns ett avsnitt mot slutet om varför du bör logga det.
Göra ditt första Jev API-anrop
För att göra ett API-anrop till Jev behöver du definiera ett
response-objekt medTypeSafeClientoch funktionensystem_one(), som tar din frågekontext som parameternstateoch självaquestionsi samma format som i playgrounden.Vi kan skapa ett enda anrop som besvarar alla våra tre playgroundfrågor, eftersom de delar samma
state:from typesafe_sdk import Choice, Noul, Score, TypeSafeClient ticket = ( "Export to CSV has been broken since Friday. It works in Chrome, " "but half our team is on Safari and they can't pull reports at all. " "We have a board meeting Thursday." ) with TypeSafeClient() as client: response = client.system_one( state=ticket, questions={ "queue": Choice( instructions="Which queue should own this ticket", criteria={ "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog", "incident_response": "A live breakage affecting multiple users right now, needs a responder today", "customer_success": "The account needs managing, not the code", }, ), "goodwill_risk": Score( instructions="How much patience does this customer have left", criteria=[ "Reporting a problem, no sign of frustration", "Mildly annoyed, still collaborative", "Visibly out of patience, mentions the cost to their work", "At the point of escalating over our heads or leaving", ], ), "is_time_sensitive": Noul( instructions="The customer names a specific deadline", criteria={ "true": "A date, day, or event the work must be done before", "false": "Urgency is implied but no deadline is given", }, ), }, )Svar kommer tillbaka under samma namn du valde för varje fråga, vilket är detaljen som gör hela grejen trevlig att jobba med:
print(response.model) print(response.answers["queue"].choice, response.answers["queue"].confidence) print(response.answers["goodwill_risk"].score) print(response.answers["is_time_sensitive"].noul)jev-1.13.0 Incidence_response 0.95 1.95 0.97Felsöka TypeErrors
Om ditt första anrop misslyckas med en
TypeErroromoutput_buffer_limit: det är en versionsmismatch i SDK:ns komprimeringsbackend, inte din kod. SDK:t skickar med sin egen HTTP-klient,httpx2, som dekomprimerar svar viazstandardochbrotli, och en äldre kopia av endera saknar argumentet den anropas med.pip install -U typesafe-sdk httpx2 zstandard brotlilöste det för mig.Vad utdata berättar
Två saker i den utdata är värda att stanna upp vid.
För det första returnerade
response.modeljev-1.13.0, intejev-latest. Du bad om den rörliga aliasen och Jev berättade vilken version som faktiskt svarade, vilket är den enda anledningen att logga det fältet är billigt nog för att vara värt det.För det andra är svarobjekten typade per frågetyp, så
.choice,.scoreoch.noulär riktiga attribut och din editor känner till dem. Det finns ingen JSON-sträng någonstans i den här koden, inget att parsa och ingen gren för anropet som kom tillbaka felaktigt. Om du föredrar gruppering exponerar SDK:t ocksåresponse.choices,response.scoresochresponse.nouls, nycklade på samma sätt.Kolla också
response.usage:print(response.usage.input_tokens, response.usage.output_tokens)524 78Utdata-token är ensiffriga och gratis. Du betalar för tillståndet och frågorna, så du kan helt styra kostnadsreglaget genom att avgöra hur mycket kontext du skickar. Det spelar större roll än det ser ut och kommer upp igen i taggighetsavsnittet: ett uppsvällt tillstånd kostar dig både pengar och noggrannhet samtidigt.
Bygga en biljett-router i ett Jev-anrop
Detta är ett av de användningsfall Jev är byggd för. En supportbiljett anländer, och något måste avgöra vilken kö den ska till, om en människa ska titta först och hur snabbt. Var och en av dessa är en bedömning med ett svarsutrymme du kan skriva ner innan biljetten anländer.
Designregeln som är värd att säga direkt: Jev avgör vad som är fallet, din kod avgör vad som händer. Jev dirigerar aldrig något. Den returnerar siffror, och dirigeringen lever i en vanlig funktion du kan läsa, testa och ändra utan att röra modellen.
Ställa alla frågor i ett anrop
Frågor i ett enda anrop utvärderas parallellt, så en sjätte fråga kostar dig tokenen den är skriven i och nästan ingen extra latens. Det ändrar hur du frågar. Med en LLM skulle du batcha noga för att spara tur-och-retur-tid, men här frågar du allt du kan tänkas vilja veta om en viss kontext, inklusive frågor du troligen ignorerar.
Låt oss utöka våra tidigare frågor med tre ytterligare Noul som ger oss viktig information om hur biljetten ska hanteras:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
Sex frågor, alla besvarade i ett anrop och en faktura. is_automated är den spekulativa: den är falsk på nästan alla riktiga biljetter, och den är värd att ställa ändå eftersom den enda gången den är sann sparar den en person från att öppna en mailer-daemon-bounce.
Två vanor jag skulle ta till mig här.
Behåll frågeuppsättningen som en modulkonstant i stället för att bygga den inline, eftersom det är den du versionshanterar tillsammans med dina trösklar.
Och namnge frågor efter vad de mäter, inte vad du gör med svaret, eftersom is_time_sensitive överlever en policyändring och route_to_incident gör det inte.
Formulera frågor positivt: Vi hade också kunnat kalla is_automated något i stil med needs_no_reply, men enligt TypeSafe är prestandan bättre för positivt formulerade frågor.
Nu kommer delen Jev inte gör. Varje svar kommer med antingen ett confidence-värde eller en sannolikhet, och det där andra talet är vad som låter dig bygga tre vägar i stället för två:
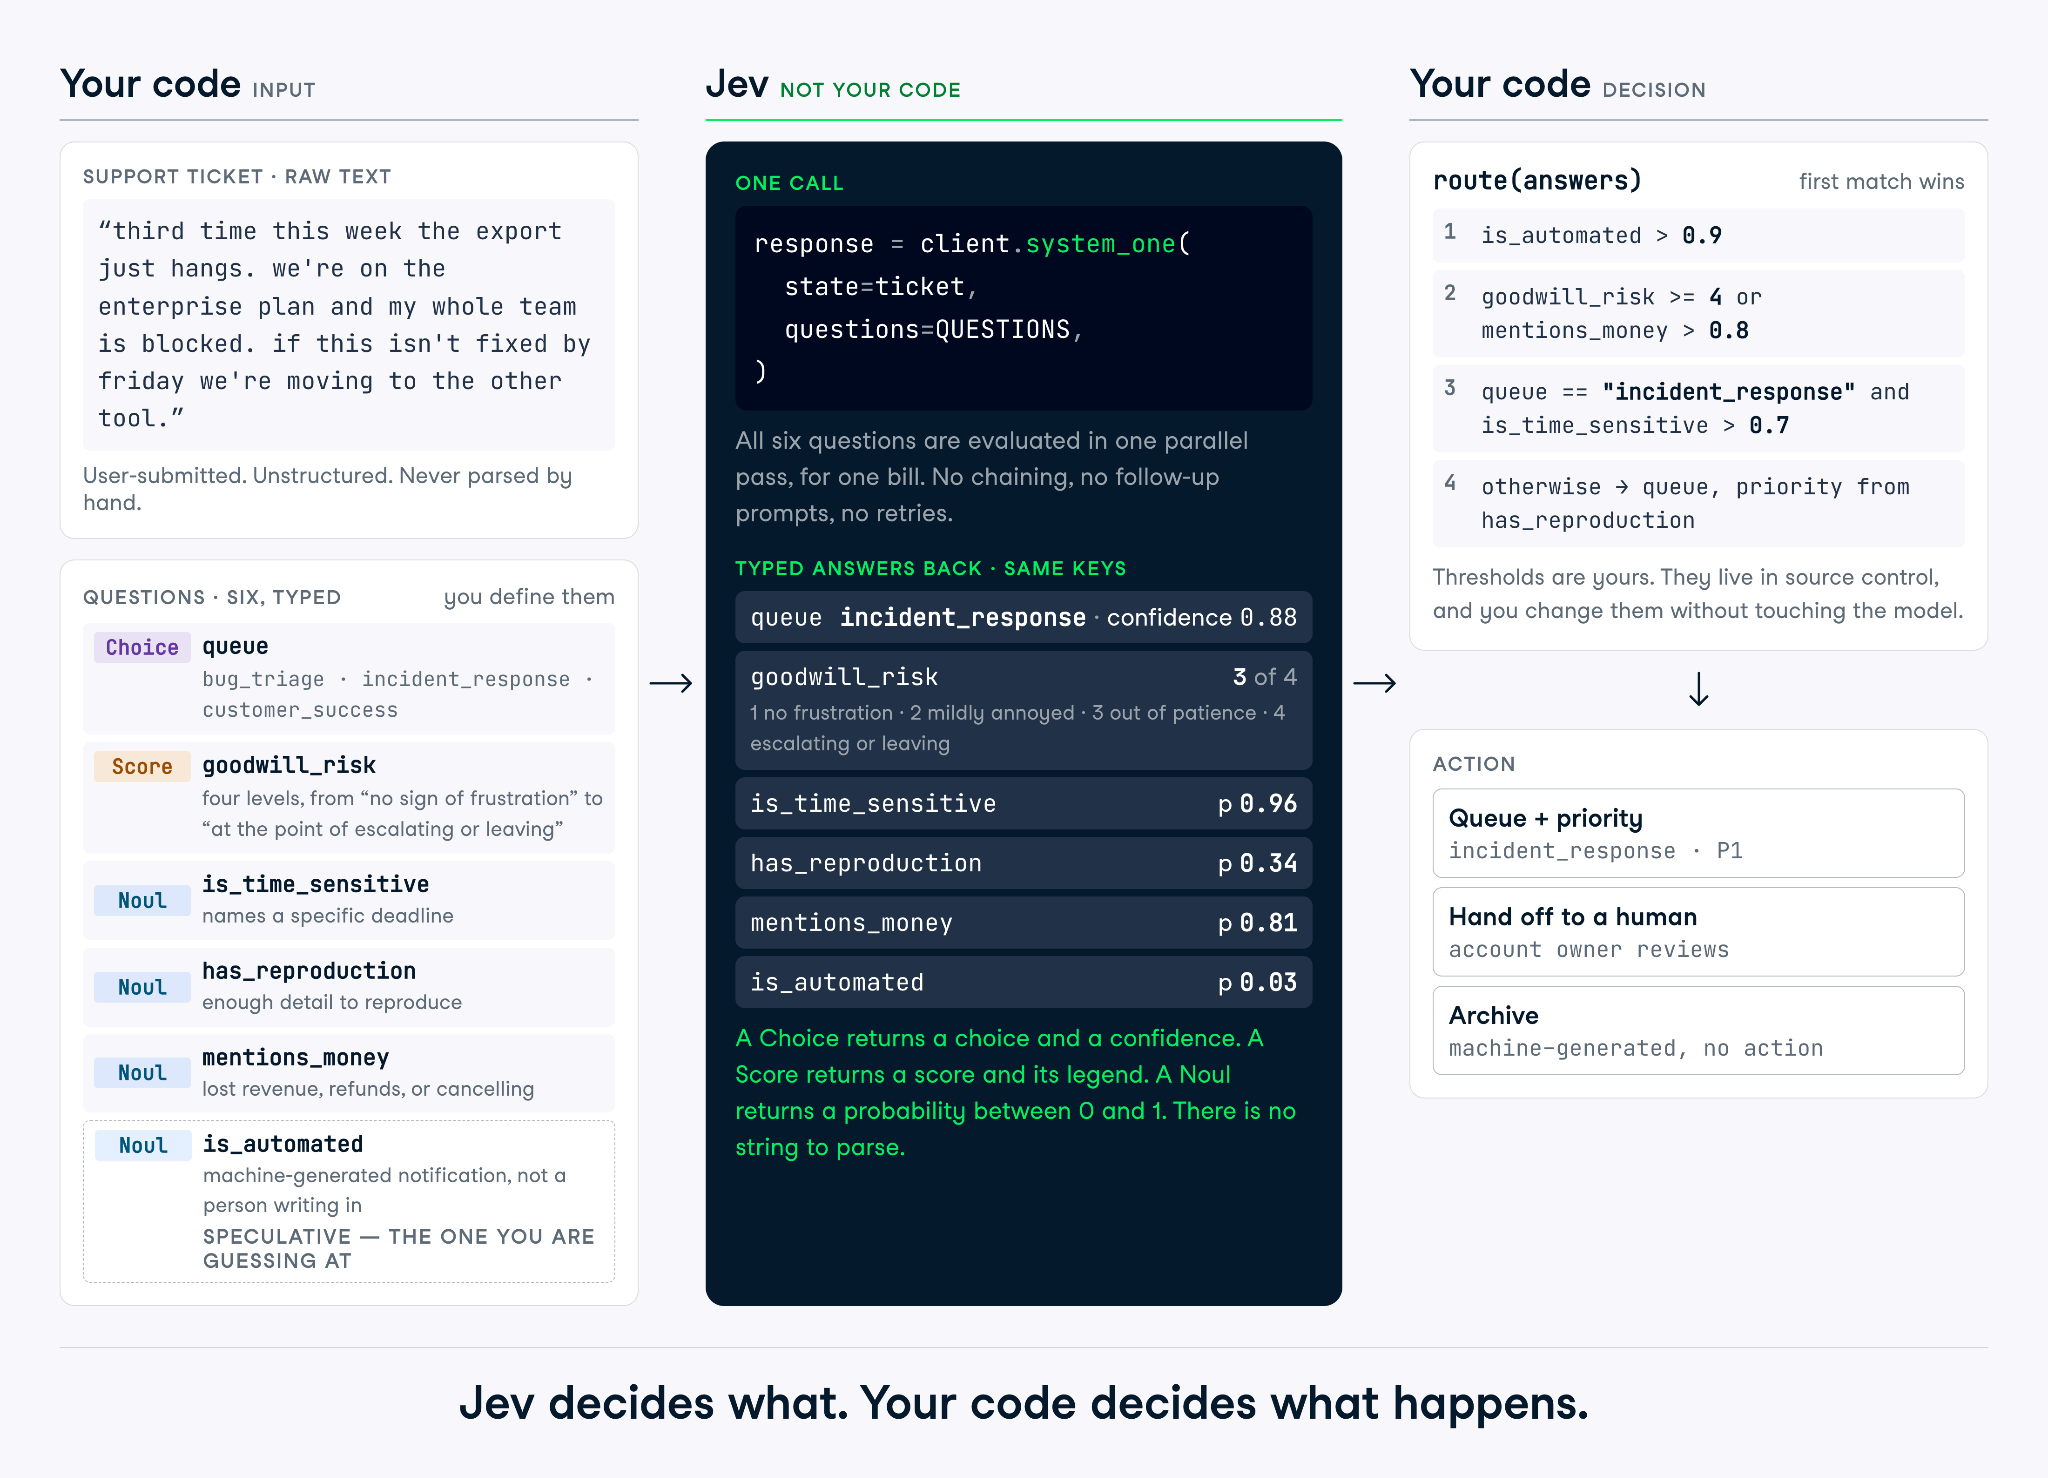
Låt oss översätta det till ett par regler för dirigering av biljetter:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
Läs vad den funktionen gör. Modellen gav sex bedömningar, och policyn bestämde att en av dem, mentions_money korsad med en frustrerad kund, väger tyngre än den kö Jev valde. Den override:n är ett affärsbeslut, den hör hemma i kod, och du kan ändra den en fredagseftermiddag utan att återtesta en modell.
has_reproduction används aldrig. Jag lämnade den kvar med flit, för det är så fan-out-mönstret ser ut i praktiken: du frågar efter mer än vad den aktuella policyn konsumerar, loggar allt och när någon frågar om bug_triage-biljetter utan reprosteg tar längre tid att stänga har du redan sex veckors svar.
Trösklarna ovan är bara exempel. Att hitta rätt är en fråga om kalibrering, och det finns ett avsnitt i slutet om hur du sätter dem med data i stället för känsla.
Du kan komma åt hela skriptet från det medföljande GitHub-repot. När jag körde Python-skriptet med vårt scenario blev bedömningen att skicka biljetten till incident response-teamet idag.
python routing.py('incident_response', 'today')TypeSafe publicerar en taggighetssida per modellversion som listar de felmoder man känner till. Jag önskar att fler labb gjorde detta. Läs den innan du bygger något, och läs den igen när du uppgraderar, eftersom listan är versionshanterad och kanterna flyttar sig.
Här är de fem som skulle ha kostat mig mest tid.
Du kan inte porta en tröskel mellan frågetyper. TypeSafes eget exempel frågar ”Ber kunden om återbetalning?” på båda sätten på samma biljett: Noul returnerar 0,22, Choice med ja/nej returnerar 0,01 för ja, med 0,97 i confidence. Samma fråga, två tal, två tiopotenser isär.
Negationer samarbetar inte heller. En Noul och dess motsats kom tillbaka på 0,72 och 0,47, vilket summerar till 1,19.
Anledningen är att de två typerna frågar efter olika saker. En Choice är relativ och avgör vilket alternativ som vinner, medan varje Noul är absolut och kan vara låg för dem alla. Trimma trösklar per fråga, i den form du skeppar, och anta aldrig att P(yes) och 1 - P(no) är samma tal.
Score-nivåer är ordnade, inte jämnt fördelade. En 1,6 berättar att modellen ligger mellan din andra och tredje nivå, med lutning mot den tredje, och det är allt den berättar.
Vad du inte kan göra är att interpolera en verklig kvantitet ur den. Om dina nivåer är ”under en timme”, ”några timmar” och ”en dag” betyder inte 1,5 fem timmar. Använd poängen för att testa en tröskel och behåll sedan varje faktisk siffra i kod.
Jev behandlar tillståndet som data, men är inte härdat mot kod i tillståndet som styr in det. En injicerad instruktion, en missvisande inramning eller text som argumenterar för sin egen klassificering kan flytta svaret, och TypeSafe säger att man förväntar sig förbättringar här. Om attackytan är ny för dig täcker vi the allmänna fallet i vår guide till prompt injection.
Det spelar störst roll där tillståndet är användarinlämnat, vilket för en biljett-router alltid är fallet. Skriv kriterier tillräckligt precisa så att biljettens egna påståenden om sig själv inte avgör utfallet, och testa med fientliga indata innan du dirigerar något automatiskt.
Räkning är opålitligt och blir sämre ju större det som räknas är, eftersom modellen känner igen formen på ett svar snarare än summerar. Datum läses som text, så ordning, avstånd och fönster fallerar. Numeriska kodningar underpresterar sina semantiska motsvarigheter, så fråga om ”röd” i stället för #FF0000.
Fixen är densamma i alla tre fallen: dela upp arbetet.
Om du behöver en räkning, iterera i kod och ställ en Noul per objekt:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)Tre mindre som delar orsak. Jev besvarar frågan du skrev, inte den du menade, så avgränsande ord och negationer läses bokstavligt. Dubbla negationer och frågor om en egenskap hos en egenskap kostar noggrannhet. Och ett stort tillstånd utfyllt med irrelevant detalj kostar både noggrannhet och pengar, eftersom orelaterat material fungerar som distraktor.
Tecknet på det första: när du tittar på ett fel svar och kommer på dig själv med att förklara vad du egentligen menade, då är den förklaringen den saknade halvan av din instruktion.
Baserat på det vi redan lärt oss kommer här några bästa praxis för att få ut det mesta av Jev.
Skriv villkoret i stället för avsikten. Om du förklarar vad du menade när du granskar ett fel svar, hör den förklaringen hemma i instruktionerna. Det innebär:
jev-latest rör på sig. Pinna versionen när en tröskel beror på modellbeteende:
client = TypeSafeClient(model="jev-1.13.0")Logga response.model tillsammans med fullständiga svar vid varje anrop, inte bara värdet du agerade på. När en tröskel börjar bete sig annorlunda är den loggen det enda sättet att skilja en modellförändring från drift i dina biljetter.
Slutligen är trösklar inte givna utan resultatet av experiment.
Jev är ett smalt verktyg, och det är faktiskt poängen. Det besvarar frågor vars svar du kan räkna upp, billigt nog att du slutar ransonera dem, och lämnar beslutet tillbaka till din kod.
Det jag vill invända mot är inramningen ”kan inte hallucinera”. Det är sant i snäv mening att modellen inte kan svara utanför schemat, men det säger ingenting om huruvida svaret är rätt. En Choice returnerar alltid en giltig kö. Det kan fortfarande vara fel kö vid 0,9 i confidence, och typade utdata gör det felet tystare.
För att testa den för ditt eget arbete föreslår jag att du hittar ett beslut din kod fattar med en spröd regel eller ett långsamt LLM-anrop och försöker skriva ner de giltiga svaren. Om du kan, är det Jev-format. Om du inte kan, kommer ingen mängd frågeingenjörskonst ändra det.
Om du vill komma igång med att bygga system som använder AI rekommenderar jag varmt att registrera dig på vår Associate AI Engineer for Developers-karriärspår. Det lär dig arbeta med OpenAI API, MCP, LangChain och mycket mer.
Lär dig AI Engineering med DataCamp!
track
course
course