Tracks
วิศวกร AI ระดับ Associate สำหรับนักพัฒนา
26 ชม.
บอกไปแล้วว่าความคาดหวังต้องสอดคล้องกับตัวโมเดล ประเด็นนี้ยิ่งจริงกับ Jev และเกี่ยวข้องกับชนิดของโมเดลที่เรียกว่า System One
โมเดล System One จะคืนการตัดสินใจแบบกำหนดชนิดแทนข้อความ คุณส่งบล็อกของ state พร้อมชุดคำถาม โดยกำหนดขอบเขตคำตอบเอง แล้วโมเดลคืนหนึ่งคำตอบต่อคำถามพร้อมความน่าจะเป็นประกอบ ไม่มีการสร้างทีละโทเค็น จึงไม่ต้องพาร์สสตริง หรือซ่อม JSON ที่เสีย คำนี้ TypeSafe ตั้งขึ้นโดยอิงจากการแบ่งชื่อดังของ Daniel Kahneman:
เพราะขอบเขตคำตอบคือสคีมาที่โค้ดของคุณประกาศไว้ ตามการออกแบบแล้ว System One จะไม่คืนหมวดหมู่ที่คุณไม่ได้กำหนดไว้ แปลว่ามันจะไม่หลุดสคีมา ถึงอย่างนั้นก็ยังตอบผิดได้ และจะยกกรณีล tricky ๆ ไว้ท้ายๆ
TypeSafe เปิดตัวออกจาก stealth เมื่อ 15 กันยายน 2026 พร้อม Jev แบบ early access รายงานเวลาโต้ตอบ 70 ถึง 500 มิลลิวินาที และค่าบริการ $0.042 ต่อหนึ่งล้านโทเค็นขาเข้า โดยขาออกฟรี บน benchmark สี่เวิร์กโฟลว์ของตน Jev อยู่ราวความแม่นยำ 68% ระดับกลางของ LLM แต่อยู่ที่ต้นทุนเสี้ยวเดียว
สำหรับข้อมูลฟีเจอร์และผลงาน benchmark แนะนำให้อ่าน คู่มือ Jev ของเรา
เขียนคำตอบที่เป็นไปได้ให้ครบก่อนเรียก ถ้าแจกแจงได้ แสดงว่าเป็นปัญหารูปทรงของ Jev:
เลือกใช้ LLM เมื่อผลลัพธ์เป็นร้อยแก้วหรือโค้ด ขอบเขตคำตอบเปิดกว้าง หรือเมื่องานต้องเชื่อมเหตุผลหลายทอด Jev ก็ไม่เหมาะกับงานเชิงตัวเลขด้วย จะอธิบายเหตุผลภายหลัง
ก่อนเขียนโค้ด ให้สร้างบัญชี TypeSafe แล้วเปิด Playground ที่นี่สามารถวางข้อความเป็น state เพิ่มคำถาม และดูอ็อบเจ็กต์คำตอบเต็ม ๆ ได้โดยไม่ต้องติดตั้งอะไรเลย วิธีนี้เร็วที่สุดในการเข้าใจว่าแต่ละชนิดคำถามคืนค่าอะไร (และดูว่าคำถามของคุณเขียนแย่หรือเปล่า)
จะใช้ทิกเก็ตสนับสนุนหนึ่งฉบับเป็น state สำหรับตัวอย่างทั้งสาม:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
ทุกชนิดคำถามรับ instructions คือคำถามภาษาธรรมดาที่อยากให้ตอบ สิ่งที่ต่างกันคือ criteria และสิ่งที่ได้กลับมา
คำถาม Choice เลือกตัวเลือกหนึ่งจากชุดที่คุณกำหนด
ส่ง criteria เป็นดิกชันนารีที่แมปแต่ละตัวเลือกกับคำอธิบาย จำนวน 1 ถึง 255 รายการ และคำตอบจะกลับมาพร้อม:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
เพื่อดูเอาต์พุตโค้ดแบบที่ได้รับผ่าน API ให้คลิกปุ่ม </> ที่มุมขวาบน แล้วคลิก Run เพื่อให้ Jev ตอบคำถาม
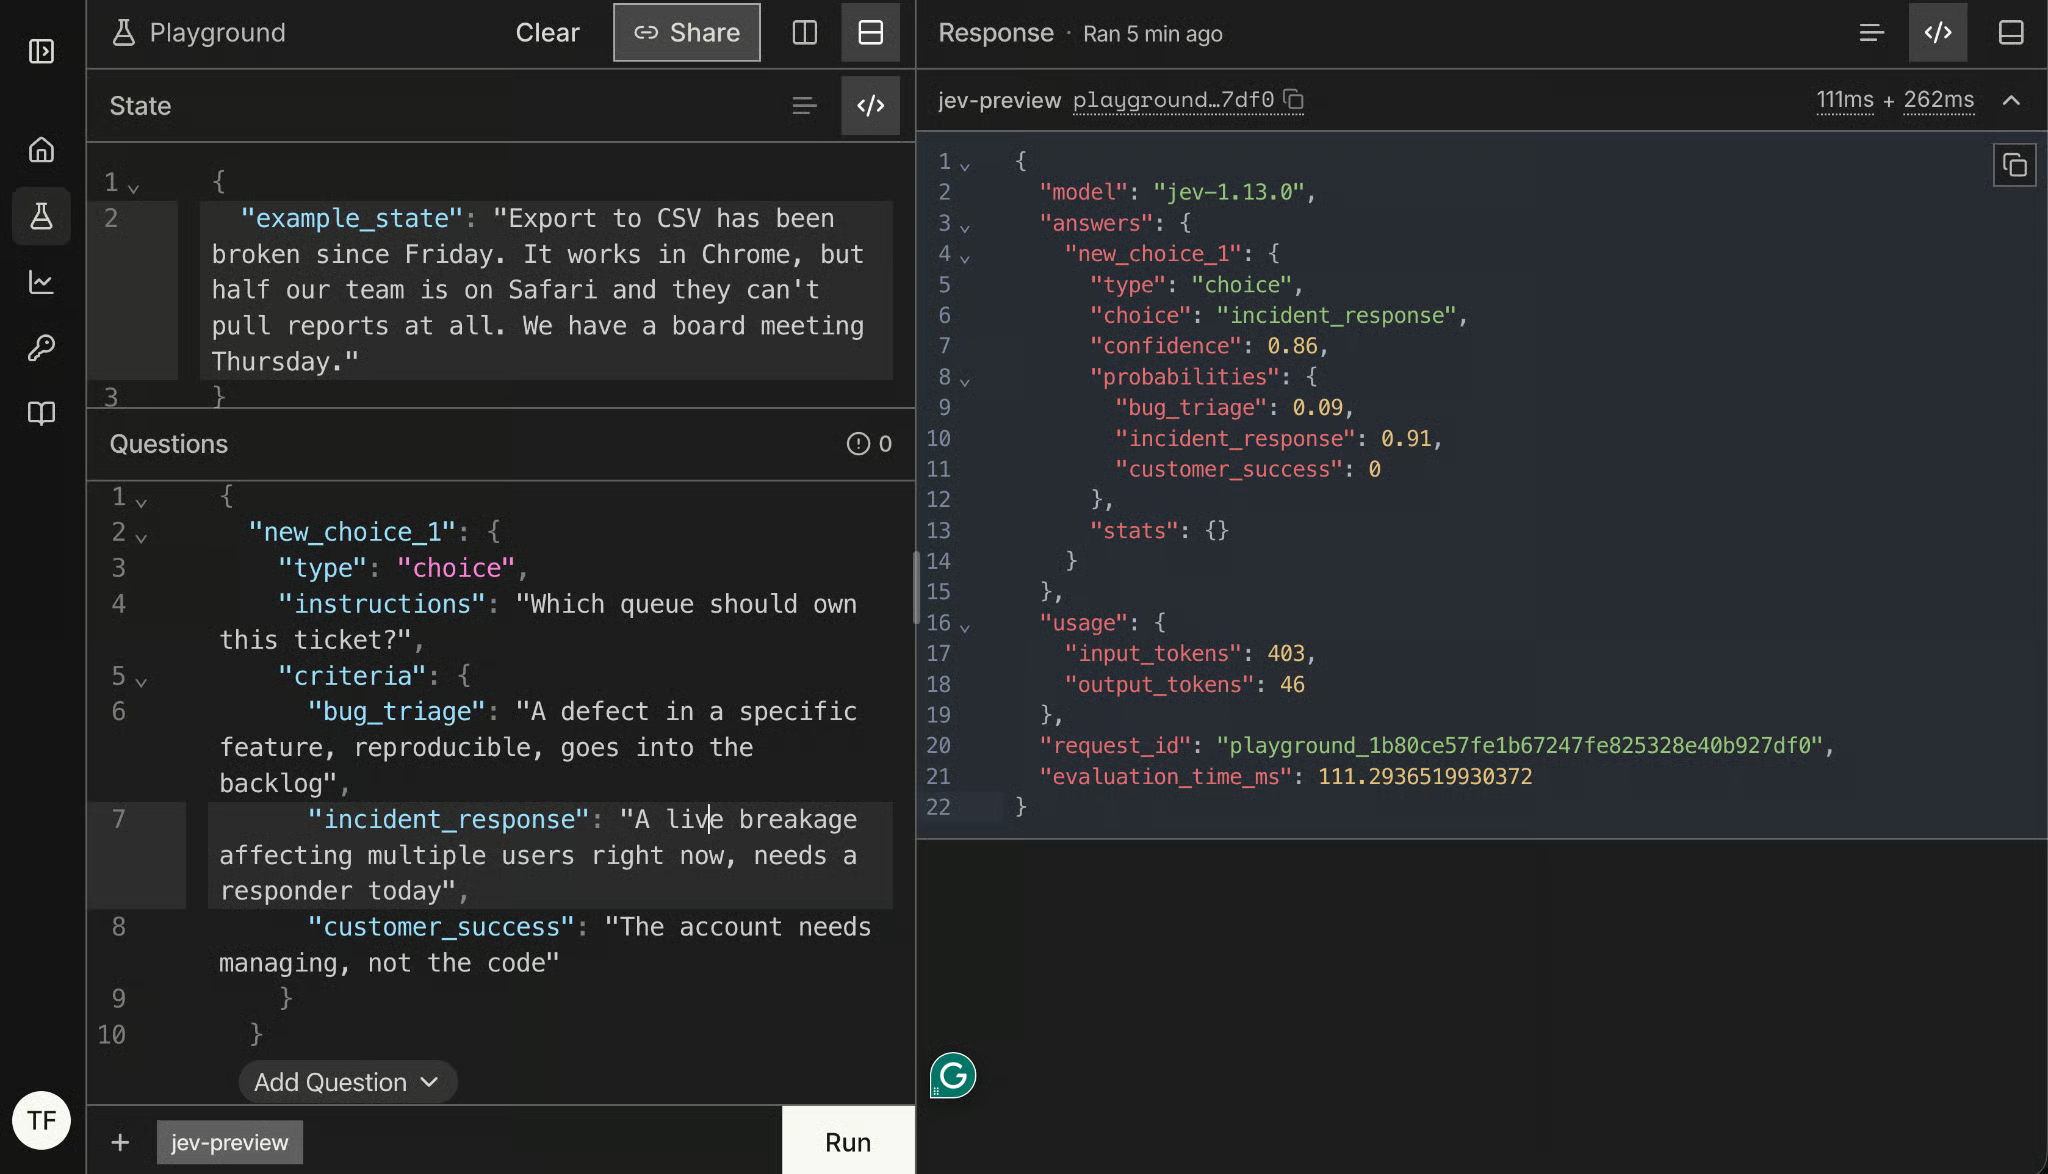
กรณีนี้ incident_response เป็น choice ด้วยความน่าจะเป็น 91% และ confidence ของ Jev สำหรับตัวเลือกนี้คือ 86%
การกระจายทั้งหมดคือส่วนที่ควรสนใจ
choice บอกแค่ว่าตัวเลือกไหนชนะ
probabilities บอกว่าชนะมากน้อยแค่ไหน
สองอย่างนี้ให้ข้อมูลคนละแบบเมื่อกำลังจะจัดเส้นทางทิกเก็ตอัตโนมัติ การแยก 0.41/0.38/0.21 กับ 0.91/0.09/0 อาจคืน choice เดียวกันได้
Score คือการให้คะแนน state เทียบกับระดับที่เรียงลำดับไว้ ส่ง criteria เป็นอาร์เรย์ ระบุคำอธิบายระดับ 2 ถึง 10 รายการ ไล่จากต่ำไปสูง และคำตอบจะมีคะแนน legendที่แมปตำแหน่งกับคำอธิบายของคุณ ความน่าจะเป็นต่อระดับ และค่า confidence
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}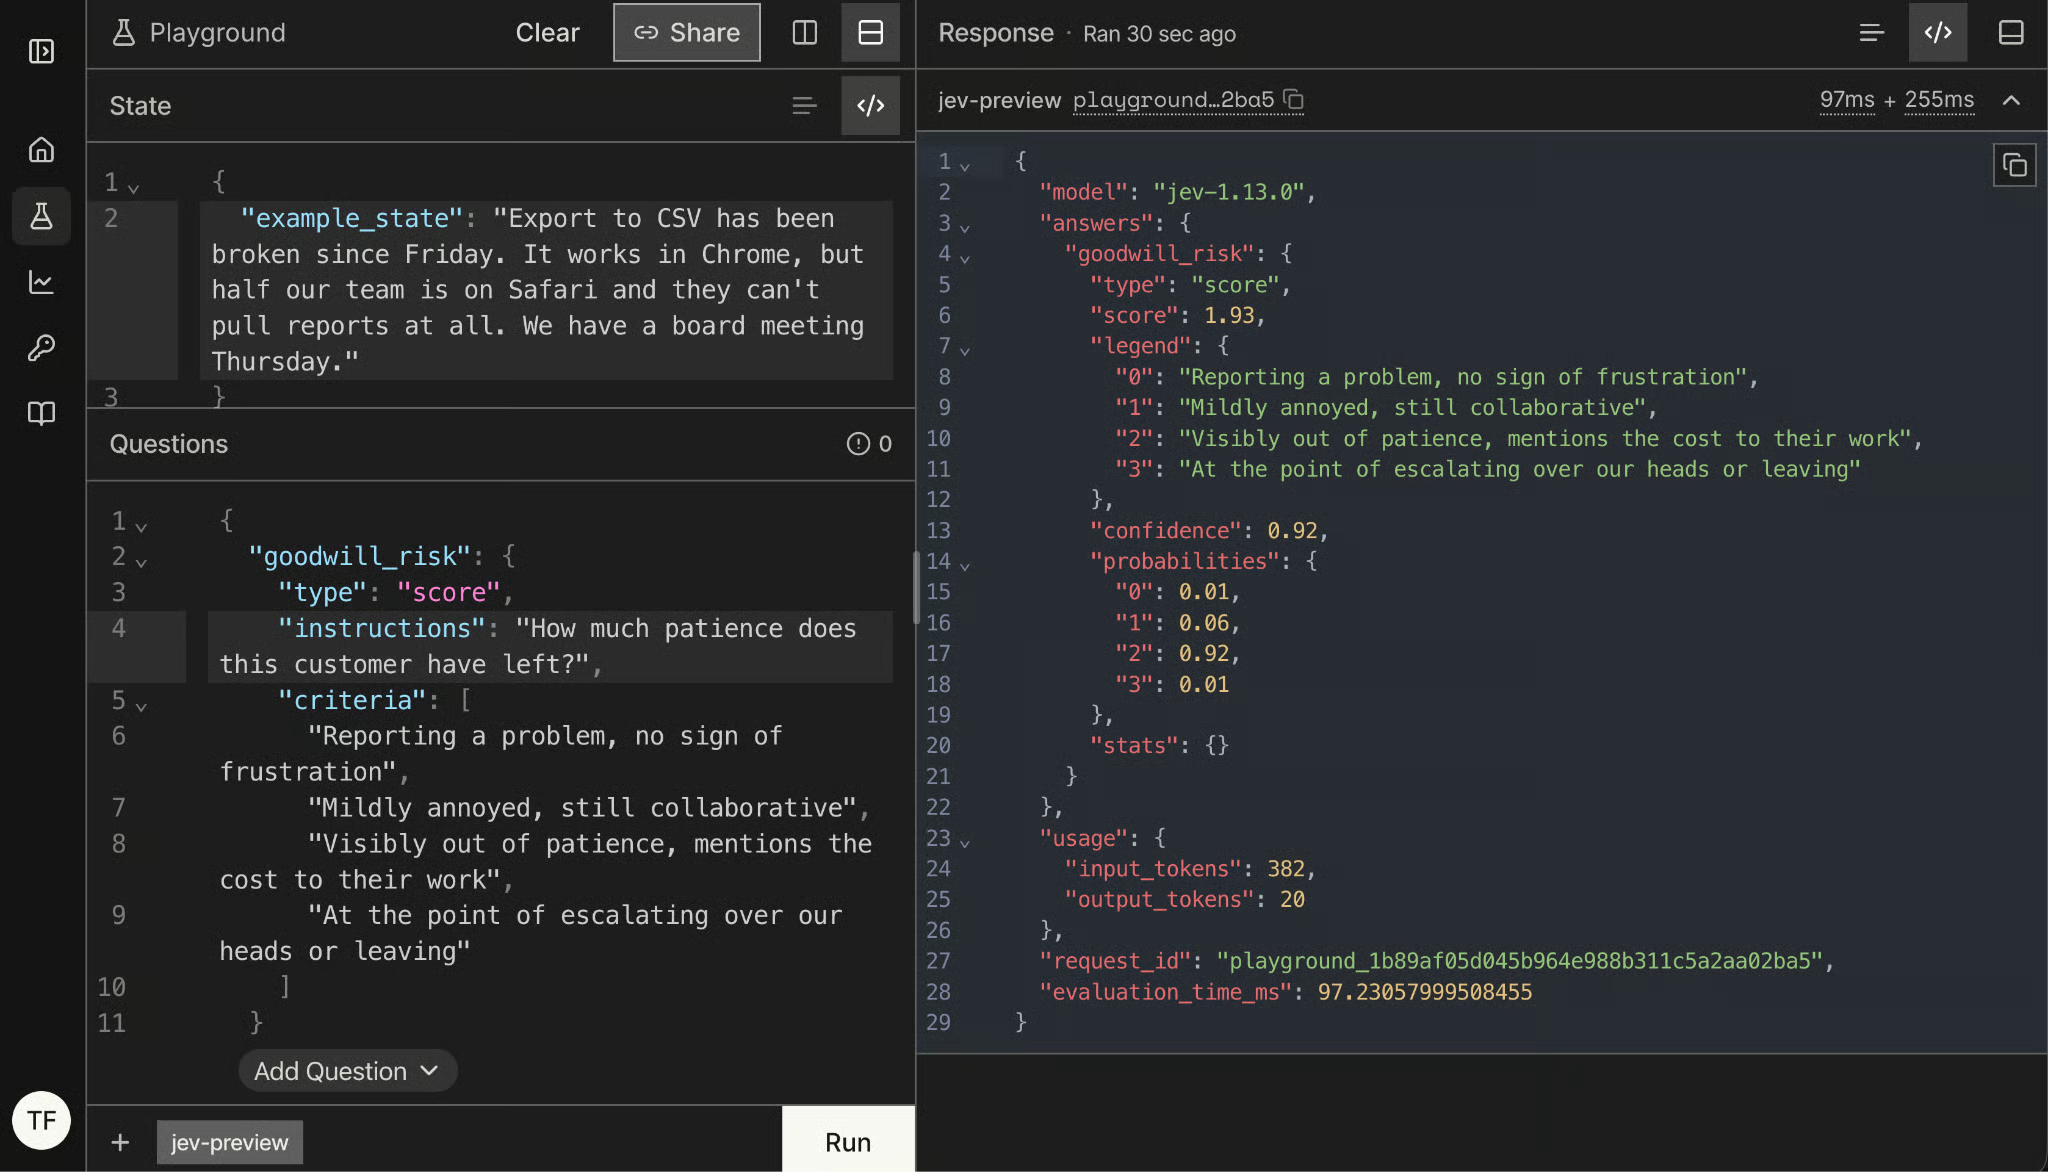
คะแนนอาจอยู่กึ่งกลางระหว่างระดับ และนั่นคือประเด็นของ legend ที่นี่ score 1.93 หมายถึงโมเดลลังเลระหว่าง "รำคาญเล็กน้อย" กับ "หมดความอดทนอย่างเห็นได้ชัด" โดยเอนเอียงไปอย่างหลัง ซึ่งสอดคล้องกับทิกเก็ตที่ยังสุภาพแต่ย้ำเส้นตายที่จะพลาด
อีกครั้ง ให้ดูการกระจาย probabilities แทนที่จะดูตัวเลขอย่างเดียว: ความน่าจะเป็นกระจุกที่ระดับเดียวแปลว่ามั่นใจ ส่วนที่กระจายสามระดับแปลว่าได้ค่าเฉลี่ยแทนการตัดสิน
Noul คือชนิดคำถามแบบไบนารี ชื่อนี้ TypeSafe ตั้งเอง criteria เป็นออปชัน แต่คุณสามารถอธิบายว่า true และ false หมายถึงอะไร ซึ่งควรทำเมื่อ "ใช่" อาจตีความได้สองทาง
ตั้งคำถามให้ค่ามากแปลว่าใช่ เอกสารของ TypeSafe ย้ำเรื่องนี้ และ Noul ที่แมป true เป็น "ไม่" จะมีประสิทธิภาพแย่ลงอย่างเห็นได้ชัด
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}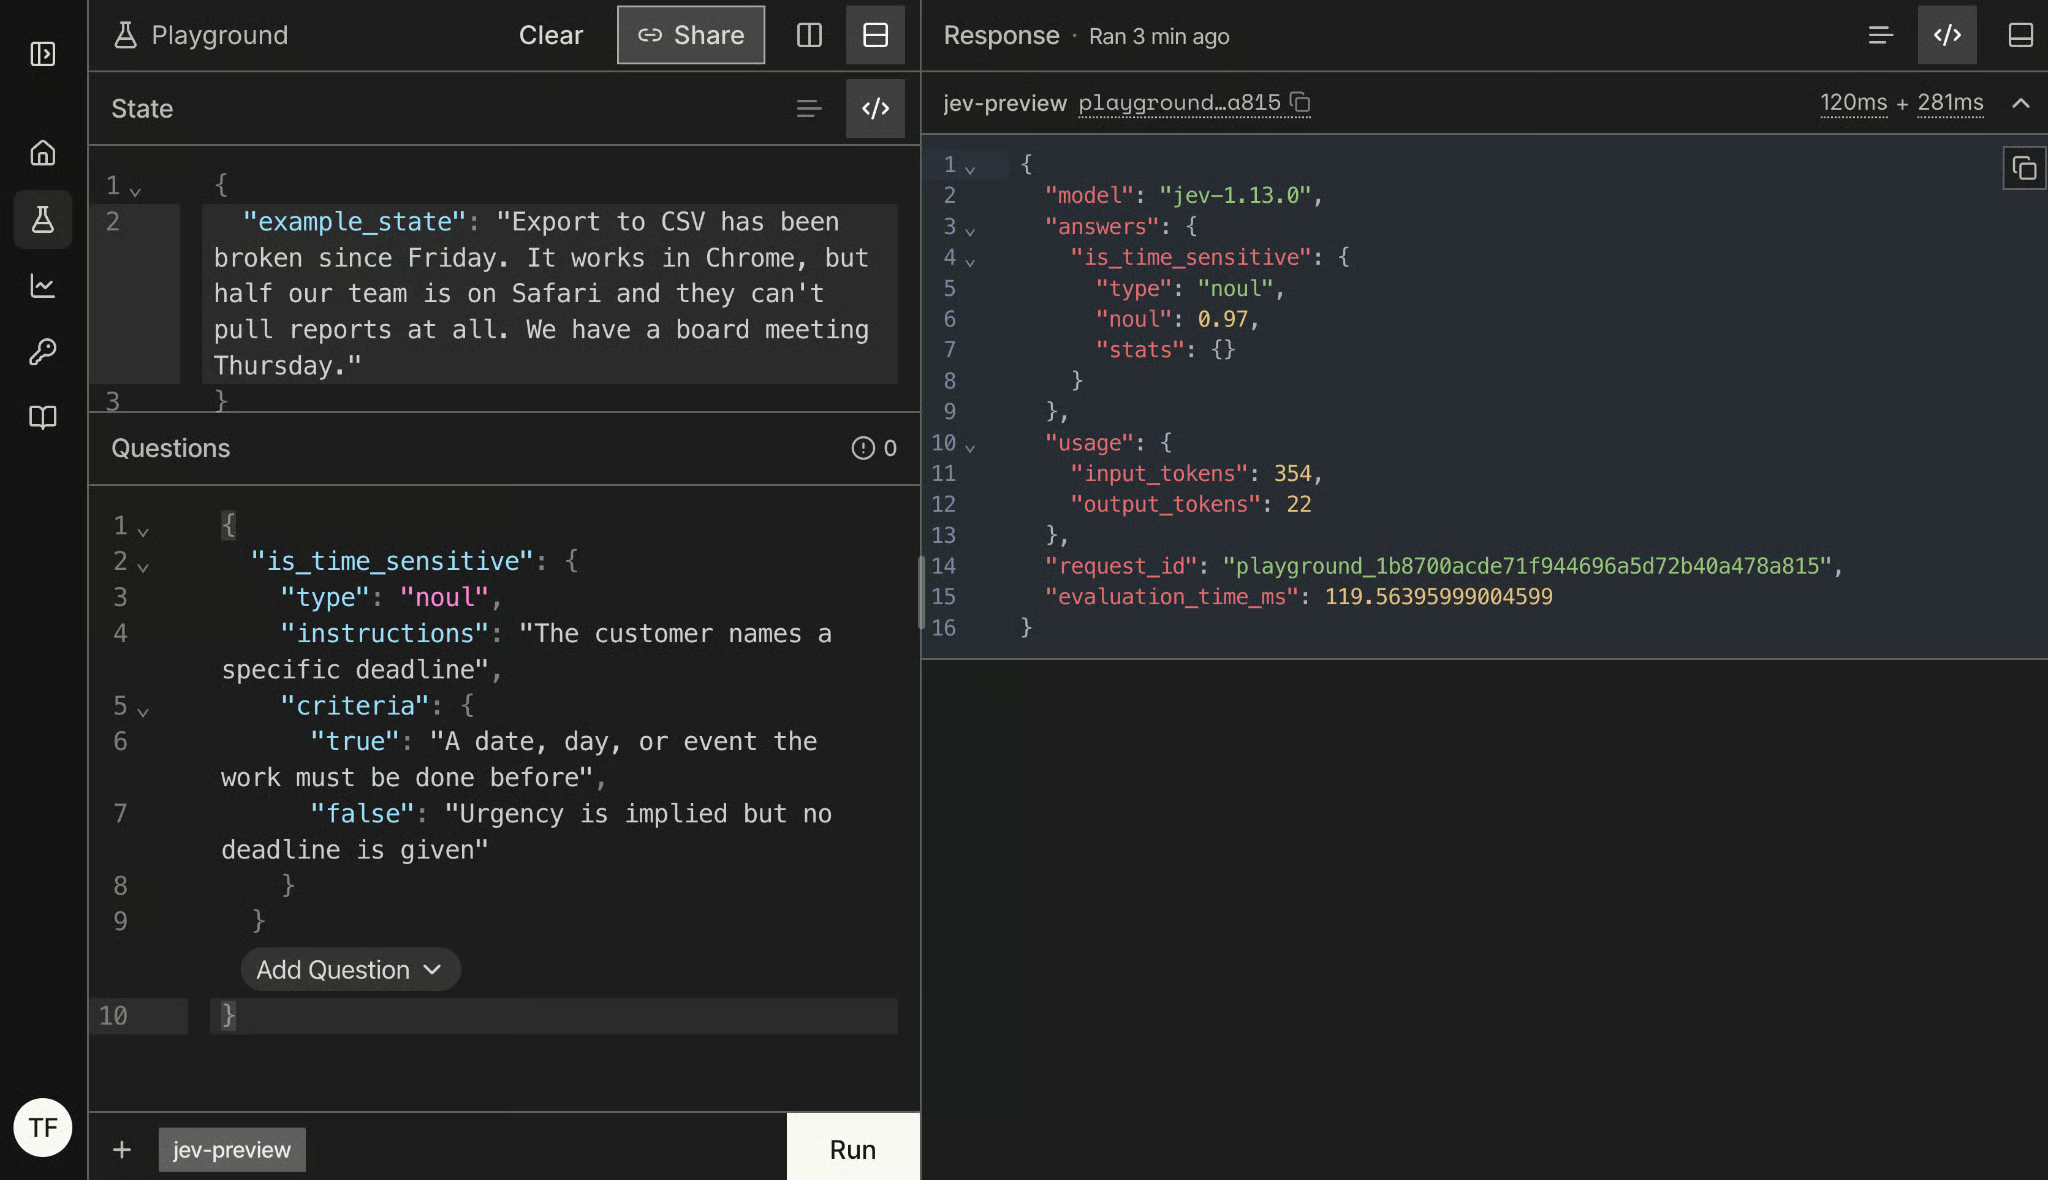
เนื่องจาก state กล่าวถึงการประชุมบอร์ดในวันพฤหัสฯ ค่า noul ที่สูง 0.97 จึงสอดคล้องความคาดหมาย
Choice และ Score คืนค่า confidence เคียงคู่กับ probabilities ส่วน Noul ไม่คืน ทำให้หลายคนสะดุด จึงควรอธิบายให้ชัด
confidence กับ probability เป็นแกนคนละอัน สำหรับ Choice probabilities บอกว่าความเชื่อของโมเดลกระจายระหว่างตัวเลือกอย่างไร และ confidence บอกว่ามันยึดมั่นกับคำตอบนั้นแค่ไหน จึงเห็นได้ว่า Choice อาจมีตัวเลือกบนสุด 0.85 แต่ confidence 0.78 ส่วน Noul มีผลลัพธ์แค่สองค่า ดังนั้นความน่าจะเป็นหนึ่งตัวเลขนั้นแบกรับทั้งสองอย่าง: 0.97 คือใช่แบบมั่นคง 0.03 คือไม่แบบมั่นคง และ 0.52 คือโมเดลบอกว่าไม่แน่ใจ
ดังนั้น ระยะห่างจาก 0.5 คือสัญญาณความเด็ดขาดของคุณ ไม่ใช่ฟิลด์แยกต่างหาก และแปลว่าไม่สามารถยก threshold จาก Noul ไปใช้กับ Choice ได้ จะกลับมาพูดอีกทีในส่วนความขรุขระ เพราะผลกระทบแรงกว่าที่คิด
ต้องมีแค่ Python 3.10+ และคีย์ early access ของ TypeSafe
ติดตั้ง SDK:
pip install typesafe-sdkหรือด้วย uv:
uv add typesafe-sdkจากนั้นสร้างคีย์ในคอนโซลของ TypeSafe และ export ออกมา ไคลเอนต์จะอ่าน TYPESAFE_API_KEY จาก environment จึงไม่ต้องส่งคีย์ในโค้ด:
export TYPESAFE_API_KEY="your-key"นำเข้าเหล่านี้เพื่อใช้งานแบบเดียวกับใน playground:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul, และ Score คือชนิดคำถามเดียวกับที่คลิกไปมาในรูปแบบอ็อบเจ็กต์ Python
TypeSafeClient เป็นไคลเอนต์ synchronous และมี AsyncTypeSafeClient ที่หน้าอินเทอร์เฟซเหมือนกันหากเรียก Jev จากบริการแบบ async ทั้งสองใช้เป็น context manager ได้ ซึ่งเหมาะกับงานยาวกว่า script สั้น ๆ:
with TypeSafeClient() as client:
...ถ้าปล่อยไว้ ไคลเอนต์จะเรียก jev-latest ซึ่งจะขยับตามที่ TypeSafe ปล่อยรุ่นใหม่ ซึ่งเราจะใช้แบบนี้ตลอดบทเรียน แต่สำหรับงานที่ตั้ง threshold ไว้แล้ว ควรปักเวอร์ชันแทน:
client = TypeSafeClient(model="jev-1.13.0")คำตอบจะบอกว่าจริง ๆ แล้วใช้โมเดลตัวไหนตอบ และมีส่วนท้ายอธิบายว่าทำไมควรล็อกค่าไว้
ในการเรียก API หา Jev ต้องนิยามรายการ response โดยใช้ TypeSafeClient และฟังก์ชัน system_one() ซึ่งรับบริบทคำถามเป็นพารามิเตอร์ state และรับ questions ในรูปแบบเดียวกับใน playground
สามารถสร้างการเรียกเดียวที่ตอบทั้ง 3 คำถามจาก playground ได้ เพราะใช้ state ร่วมกัน:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
คำตอบจะกลับมาภายใต้ชื่อเดียวกับที่คุณตั้งให้ในแต่ละคำถาม นี่แหละทำให้ใช้งานได้สบาย:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97ถ้าการเรียกครั้งแรกพังด้วย TypeError เกี่ยวกับ output_buffer_limit: นั่นคือปัญหาเวอร์ชันไม่ตรงกันในแบ็กเอนด์บีบอัดของ SDK ไม่ใช่โค้ดของคุณ SDK มี HTTP client ของตัวเองชื่อ httpx2 ซึ่งคลายการบีบอัดผ่าน zstandard และ brotli และสำเนาเก่าของอย่างใดอย่างหนึ่งไม่มีอาร์กิวเมนต์ที่ถูกเรียกใช้ pip install -U typesafe-sdk httpx2 zstandard brotli แก้ได้ในเคสของเรา
มีสองอย่างที่ควรหยุดดู
อย่างแรก response.model คืน jev-1.13.0 ไม่ใช่ jev-latest คุณขอ alias ที่ขยับได้ และ Jev บอกคุณว่าเวอร์ชันไหนเป็นคนตอบ ซึ่งนี่แหละเหตุผลว่าทำไมการล็อกฟิลด์นี้ถึงคุ้มค่า
อย่างที่สอง อ็อบเจ็กต์คำตอบถูกกำหนดชนิดตามชนิดคำถาม จึงมี .choice, .score, และ .noul เป็นแอททริบิวต์จริง ซึ่งเอดิเตอร์ของคุณรับรู้ได้ ไม่มีสตริง JSON ในโค้ดนี้เลย ไม่ต้องพาร์ส ไม่ต้องเผื่อกิ่งสำหรับเคสที่ตอบกลับมาพัง ถ้าชอบจัดกลุ่ม SDK ก็มี response.choices, response.scores, และ response.nouls ให้ด้วย โดยคีย์เหมือนเดิม
ตรวจ response.usage ด้วย:
print(response.usage.input_tokens, response.usage.output_tokens)524
78โทเค็นขาออกหลักหน่วยและฟรี ต้นทุนมาจาก state และคำถาม ดังนั้นคุณควบคุมคันบังคับต้นทุนได้เต็มที่ด้วยการตัดสินใจว่าจะส่งบริบทมากแค่ไหน ประเด็นนี้สำคัญกว่าที่คิด และจะพูดอีกทีในส่วนความขรุขระ: state ที่พองฟูทำให้เสียทั้งเงินและความแม่นยำพร้อมกัน
นี่คือหนึ่งในกรณีใช้งานที่ Jev ถูกสร้างมาเพื่อมัน ทิกเก็ตสนับสนุนเข้ามา และต้องมีบางอย่างตัดสินใจว่าควรไปคิวไหน ควรมีมนุษย์ดูก่อนหรือไม่ และเร็วแค่ไหน ทุกข้อนี้คือการตัดสินด้วยขอบเขตคำตอบที่คุณเขียนไว้ล่วงหน้าได้
กฎการออกแบบที่ควรระบุแต่แรก: Jev ตัดสินว่า "อะไร" โค้ดของคุณตัดสินว่า "แล้วทำอะไร" Jev ไม่เคยจัดเส้นทางเอง มันคืนตัวเลข และการจัดเส้นทางอยู่ในฟังก์ชันปกติที่คุณอ่าน ทดสอบ และเปลี่ยนได้โดยไม่ต้องแตะโมเดล
คำถามในคำขอเดียวกันจะประเมินแบบขนาน ดังนั้นคำถามที่หกมีต้นทุนแค่โทเค็นที่เขียน และหน่วงเวลาเพิ่มน้อยมาก นี่เปลี่ยนวิธีการถาม กับ LLM คุณจะรวมคำถามเพื่อลดรอบไป-กลับ แต่ที่นี่ให้ถามทุกอย่างที่อาจอยากรู้เกี่ยวกับบริบทนั้น ๆ รวมถึงคำถามที่อาจจะยังไม่ใช้
มาเพิ่มคำถามจากก่อนหน้าอีกสามข้อแบบ Noul เพื่อให้ได้ข้อมูลสำคัญในการจัดการทิกเก็ต:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
หกคำถาม ตอบในครั้งเรียกเดียว และบิลเดียว is_automated เป็นคำถามเผื่อไว้: โดยมากจะเป็นเท็จในทิกเก็ตจริง แต่ก็ควรถาม เพราะครั้งที่มันเป็นจริง จะช่วยไม่ให้คนหนึ่งต้องเปิดอีเมลเดมอนดีดกลับ
สองนิสัยที่อยากแนะนำ
เก็บชุดคำถามเป็นคอนสแตนต์ระดับโมดูลแทนการสร้าง inline เพราะจะเวอร์ชันร่วมกับ threshold ของคุณ
ตั้งชื่อตามสิ่งที่วัด มากกว่าสิ่งที่จะทำกับคำตอบ เพราะ is_time_sensitive อยู่รอดแม้เปลี่ยนนโยบาย แต่ route_to_incident ไม่
กรอบคำถามเชิงบวก: เราอาจตั้งชื่อ is_automated ว่า needs_no_reply ก็ได้ แต่ตามที่ TypeSafe ระบุ ประสิทธิภาพของคำถามเชิงบวกดีกว่า
ส่วนที่ Jev ไม่ทำคือส่วนนี้ ทุกคำตอบมาพร้อมค่า confidence หรือ probability และตัวเลขที่สองนี่แหละทำให้สร้างสามเส้นทางแทนที่จะมีแค่สอง:
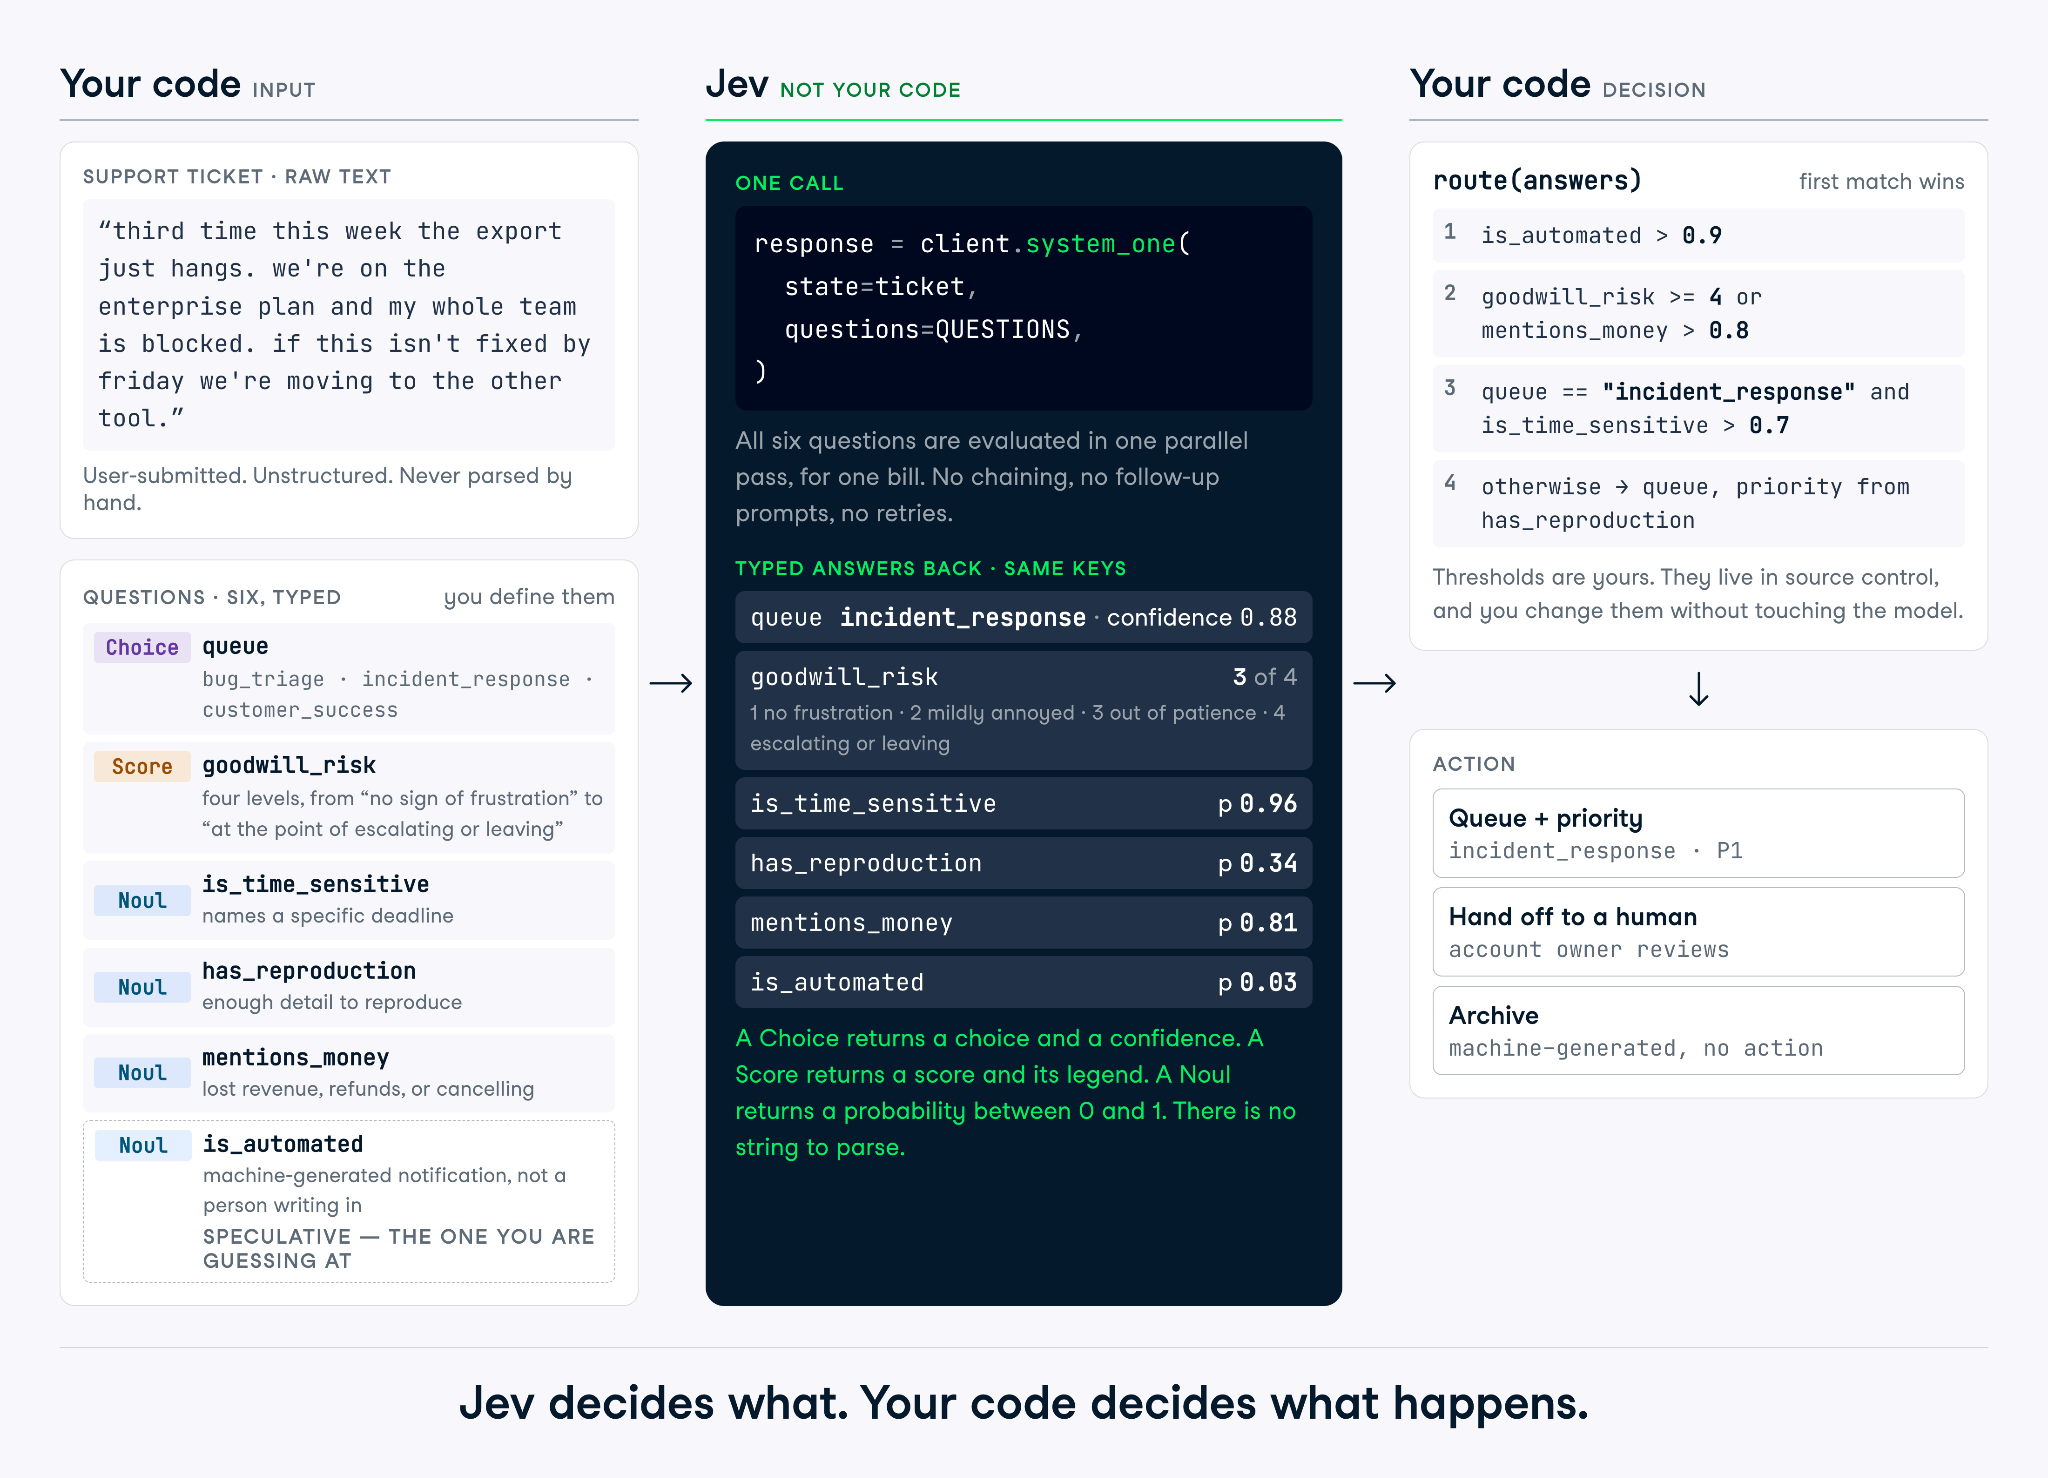
แปลงสิ่งนี้เป็นกฎสำหรับจัดเส้นทางทิกเก็ต:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
อ่านให้ชัดว่าฟังก์ชันนี้ทำอะไร โมเดลให้คำตัดสินหกข้อ และนโยบายก็ตัดสินว่าหนึ่งในนั้น คือ mentions_money ร่วมกับลูกค้าที่หงุดหงิด มีความสำคัญกว่าคิวที่ Jev เลือก การ override แบบนี้เป็นการตัดสินเชิงธุรกิจ ควรอยู่ในโค้ด และคุณเปลี่ยนได้เย็นวันศุกร์โดยไม่ต้องทดสอบโมเดลใหม่
has_reproduction ไม่เคยถูกใช้ ตั้งใจทิ้งไว้ เพราะลักษณะการ fan-out ในทางปฏิบัติคือแบบนี้: ขอมากกว่าสิ่งที่นโยบายปัจจุบันใช้ บันทึกทั้งหมดไว้ แล้วเมื่อมีคนถามว่าทิกเก็ต bug_triage ที่ไม่มีขั้นทำซ้ำปัญหาใช้เวลาปิดนานกว่าหรือไม่ คุณก็มีข้อมูลหกสัปดาห์พร้อม
threshold ข้างบนเป็นตัวอย่างเท่านั้น การหาค่าที่เหมาะคือการคาลิเบรต และมีส่วนท้ายอธิบายการตั้งด้วยข้อมูลแทนความรู้สึก
เข้าถึงสคริปต์เต็มได้จาก รีโป GitHub ที่แนบมา เมื่อรันสคริปต์ Python กับสถานการณ์ของเรา ผลการตัดสินคือส่งทิกเก็ตให้ทีม incident response ภายในวันนี้
python routing.py('incident_response', 'today')TypeSafe เผยแพร่หน้าความขรุขระรายเวอร์ชันของโมเดล ระบุโหมดความล้มเหลวที่ทราบ อยากให้แลบอื่นทำแบบนี้ด้วย อ่านก่อนเริ่มสร้างอะไร และอ่านอีกครั้งเมื่ออัปเกรด เพราะรายการมีเวอร์ชันและขอบเปลี่ยน
นี่คือห้าข้อที่น่าจะทำให้เสียเวลามากสุด
ไม่สามารถยก threshold ข้ามชนิดคำถามได้ ตัวอย่างของ TypeSafe เองถามว่า "ลูกค้าขอเงินคืนหรือไม่" ด้วยสองแบบในทิกเก็ตเดียวกัน: Noul คืน 0.22 ส่วน Choice แบบใช่/ไม่ใช่คืน 0.01 สำหรับใช่ พร้อม confidence 0.97 คำถามเดียว ตัวเลขสองตัว ต่างกันสองหลัก
การปฏิเสธก็ไม่ลงรอยกัน Noul กับคำถามตรงข้ามกันคืนค่า 0.72 และ 0.47 ซึ่งบวกกันได้ 1.19
เหตุผลคือสองชนิดถามคนละเรื่อง Choice เป็นเชิงสัมพัทธ์และชี้ว่าตัวเลือกไหนชนะ ขณะที่ Noul แต่ละข้อเป็นเชิงสัมบูรณ์ และอาจได้ค่าต่ำสำหรับทุกตัวเลือก ตั้ง threshold รายคำถามตามรูปแบบที่จะปล่อยใช้จริง และอย่าคิดว่า P(yes) กับ 1 - P(no) เป็นเลขเดียวกัน
ระดับของ Score เรียงลำดับ ไม่ได้มีระยะห่างเท่ากัน ค่า 1.6 บอกว่าโมเดลอยู่ระหว่างระดับสองกับสาม เอนเข้าหาสาม และบอกได้แค่นั้น
สิ่งที่ทำไม่ได้คือแทรกค่าจริงจากมัน ถ้าระดับคือ "ต่ำกว่าชั่วโมง", "ไม่กี่ชั่วโมง", และ "หนึ่งวัน" ค่า 1.5 ไม่ได้แปลว่า 5 ชั่วโมง ใช้คะแนนเพื่อตรวจ threshold แล้วเก็บตัวเลขจริงทั้งหมดไว้ในโค้ด
Jev มอง state เป็นข้อมูล แต่ยังไม่ได้แข็งแรงพอจะกันโค้ดที่เขียนใน state เพื่อชี้นำคำตอบได้ คำสั่งที่ฉีดเข้ามา กรอบคำอธิบายที่ทำให้เข้าใจผิด หรือข้อความที่โต้แย้งเพื่อจัดประเภทตัวเอง สามารถขยับคำตอบได้ และ TypeSafe ระบุว่าจะพัฒนาในจุดนี้ ถ้าเพิ่งรู้จักผิวโจมตีแบบนี้ เราครอบคลุมเคสทั่วไปไว้ใน คู่มือ prompt injection
สำคัญที่สุดเมื่อ state มาจากผู้ใช้ ซึ่งสำหรับตัวจัดเส้นทางทิกเก็ตคือเสมอ เขียน criteria ให้แม่นพอที่การกล่าวอ้างของทิกเก็ตเกี่ยวกับตัวเองจะไม่เป็นตัวตัดสินผล และทดสอบด้วยอินพุตมุ่งร้ายก่อนเปิดใช้อัตโนมัติ
การนับไม่น่าเชื่อถือและยิ่งแย่เมื่อจำนวนเพิ่ม เพราะโมเดลรู้จักรูปแบบคำตอบมากกว่าการนับจริง วันที่ถูกอ่านเป็นข้อความ จึงล้มเหลวทั้งการเรียง ระยะห่าง และช่วงเวลา การเข้ารหัสเชิงตัวเลขทำผลงานแย่กว่าความหมายเชิงภาษา ดังนั้นให้ถามหา "สีแดง" ดีกว่า #FF0000.
ทางแก้เหมือนกันทั้งสามกรณี: แยกงานออกจากกัน.
ถ้าต้องการนับ ให้วนในโค้ดและถาม Noul ต่อรายการ:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)อีกสามข้อเล็ก ๆ ที่มีสาเหตุร่วมกัน Jev ตอบคำถามที่คุณเขียน ไม่ใช่สิ่งที่คุณตั้งใจ ดังนั้นคำจำกัดขอบเขตและการปฏิเสธจะถูกอ่านตรงตัว ปฏิเสธซ้อนปฏิเสธ และคำถามเกี่ยวกับคุณสมบัติของคุณสมบัติ ทำให้ความแม่นยำลดลง และ state ขนาดใหญ่ที่ยัดรายละเอียดไม่เกี่ยวข้องทำให้ความแม่นยำลดลงและเสียเงินเพิ่ม เพราะสิ่งไม่เกี่ยวข้องทำหน้าที่เป็นตัวเบี่ยงเบน
สัญญาณของข้อแรก: เมื่อเห็นคำตอบผิดแล้วต้องอธิบายว่าจริง ๆ ตั้งใจถามอะไร คำอธิบายนั้นคือครึ่งที่หายไปของ instruction ของคุณ
จากสิ่งที่เรียนรู้มา ต่อไปนี้คือแนวทางปฏิบัติที่ดีที่สุดเพื่อใช้ Jev ให้คุ้มค่า
เขียนเงื่อนไข แทนที่จะเขียนเจตนา ถ้าเวลาตรวจคำตอบผิดแล้วต้องอธิบายว่าหมายถึงอะไร แปลว่าคำอธิบายนั้นควรอยู่ใน instructions สรุปว่า:
jev-latest ขยับเสมอ ปักเวอร์ชันเมื่อมี threshold ใด ๆ ขึ้นกับพฤติกรรมของโมเดล:
client = TypeSafeClient(model="jev-1.13.0")ล็อก response.model คู่กับคำตอบเต็มทุกครั้ง ไม่ใช่แค่ค่าที่คุณนำไปใช้ เมื่อ threshold เริ่มงอแง ล็อกนี้คือวิธีเดียวที่จะบอกได้ว่าเป็นการเปลี่ยนโมเดลหรือดริฟท์ในทิกเก็ตของคุณ
สุดท้าย threshold ไม่ใช่ของตาย แต่เป็นผลจากการทดลอง
Jev เป็นเครื่องมือเฉพาะทาง และนั่นแหละคือจุดประสงค์ มันตอบคำถามที่คุณแจกแจงคำตอบได้ ถูกพอที่จะเลิกต้องประหยัดจำนวนคำถาม และส่งการตัดสินใจกลับไปให้โค้ดของคุณ
สิ่งที่อยากแย้งคือกรอบว่า "ไม่เพ้อ" จริงในความหมายแคบ ๆ ว่าโมเดลจะไม่ตอบนอกสคีมา แต่มันไม่ได้บอกว่าคำตอบถูกหรือไม่ Choice จะคืนคิวที่ถูกต้องตามสคีมาเสมอ แต่อาจเป็นคิวที่ผิดด้วย confidence 0.9 ได้ และเอาต์พุตแบบกำหนดชนิดทำให้ความล้มเหลวนี้เงียบกว่า
เพื่อทดสอบกับงานของคุณ แนะนำให้หาการตัดสินใจหนึ่งข้อที่โค้ดทำด้วยกฎเปราะบางหรือเรียก LLM ช้า แล้วลองเขียนคำตอบที่เป็นไปได้ ถ้าเขียนได้ นั่นคือปัญหารูปทรงของ Jev ถ้าเขียนไม่ได้ ต่อให้แก้คำถามแค่ไหนก็ไม่ช่วย
ถ้าอยากเริ่มสร้างระบบที่ใช้ AI แนะนำหลักสูตรอาชีพ Associate AI Engineer for Developers ซึ่งสอนการทำงานกับ OpenAI API, MCP, LangChain และอีกมาก
เรียนวิศวกรรม AI กับ DataCamp!
Tracks
Courses
Courses