
Cursus
Introductie tot Python
4 uur
7.1M
Met de Exploratory Data Analysis (EDA) en het basismodel bij de hand, kun je aan de slag met je eerste echte machinelearningmodel.
Let op dat deze tutorial is gebaseerd op een Facebook Live code along-sessie; je kunt hem hier terugkijken:
Voordat je begint, importeer je alle benodigde libraries:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data die bestaat uit de gecombineerde train- en testsets. Je doet dit omdat je de data eerst wat wilt preprocessen en zeker wilt weten dat alle bewerkingen die je op de trainingset uitvoert, ook op de testset gebeuren.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data met de methode info().data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Er zijn 2 numerieke variabelen met missende waarden.
Welke zijn dat?
Precies, je mist waarden voor de kolommen 'Age' en 'Fare'! In de output van de methode .info() hierboven zie je dat je 263 waarden mist voor de eerste kolom, omdat je slechts 1046 non-null waarden hebt op een totaal van 1309 rijen in je DataFrame. Idealiter wil je natuurlijk dat al die 1309 rijen non-null waarden hebben, maar dat is hier niet zo!
Gelukkig mis je er voor de kolom Fare maar één. Merk ook op dat 'Cabin' en 'Embarked' ook missende waarden hebben en dat je daar op een gegeven moment ook iets mee moet doen.
Nu focus je je echter op het oplossen van de numerieke variabelen: je gaat de missende waarden voor de kolommen 'Age' en 'Fare' imputeren of invullen met de mediaan van deze variabelen, waar je die kent.
Let op dat je in dit geval de mediaan gebruikt omdat die perfect is om met uitschieters om te gaan. Met andere woorden, de mediaan is nuttig wanneer de verdeling van de data scheef is. Andere manieren om de missende waarden te imputeren zijn het gemiddelde (mean), dat je vindt door alle datapunten op te tellen en te delen door het aantal punten, of de modus (mode), het getal dat het vaakst voorkomt.
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Dat ziet er al een stuk beter uit, toch!
Merk ook op dat je in de vorige tutorial en de notebook een aantal features had die je wilde gebruiken om te voorspellen, omdat je uit je EDA had gezien dat ze belangrijk zullen zijn voor 'Survived' of niet. Eén van die features was 'Fare', maar ook 'Age' en 'Sex' hoorden daarbij!
Maar je wilt je data numeriek encoden, dus wil je 'male' en 'female' naar getallen omzetten. Je doet dit omdat de meeste machinelearningmodellen werken met numerieke inputfeatures. Je kunt hiervoor de pandas-functie .get_dummies() gebruiken:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() laat je voor elke optie in 'Sex' een nieuwe kolom maken. Dus het maakt een nieuwe kolom voor female, genaamd 'Sex_female', en een nieuwe kolom voor 'Sex_male', die encodet of die rij mannelijk of vrouwelijk was.
Omdat je het argument drop_first in de code hierboven hebt toegevoegd, heb je 'Sex_female' laten vallen, omdat deze nieuwe kolommen, 'Sex_female' en 'Sex_male', in essentie dezelfde informatie bevatten.
Dus alles wat je hebt gedaan, is een nieuwe kolom 'Sex_male' maken, met een 1 als die rij mannelijk is – en een 0 als die rij vrouwelijk is.
.get_dummies() wordt een van je beste vrienden bij datamanipulatie voor machine learning!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] uit je DataFrame om je eerste machinelearningmodel te bouwen:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() om data te bekijken:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Alle rijen zijn nu non-null. Goed bezig!
Tot nu toe heb je je data in een vorm gebracht om je eerste machinelearningmodel te bouwen. Dat betekent dat je eindelijk je eerste machinelearningmodel kunt bouwen!
Voor meer over pandas, bekijk onze Data Manipulation with Python-track.
Wat is een decision tree-classifier? Het is een boomstructuur waarmee je datapunten, ook wel doelvariabelen, kunt classificeren op basis van featurevariabelen.
Bijvoorbeeld, de onderstaande boom heeft een wortelknoop die je dwingt eerst een beslissing te nemen, op basis van de vraag: "Was 'Sex_male'" minder dan 0,5? Met andere woorden, was het datapunt vrouwelijk. Als het antwoord op deze vraag True is, ga je links naar beneden en krijg je 'Survived'. Als het False is, ga je rechts naar beneden en krijg je 'Dead'.
Voor nu hoef je je geen zorgen te maken over alle extra informatie die je in de knopen ziet, zoals gini, samples of value. Dat kun je later nog bekijken!
'Male' resulteert in een voorspelling 'Dead'.Let op dat het eigenlijk de gini-coëfficiënt is die voor deze beslissingen wordt gebruikt. Op dit punt ga je daar niet verder op in.
data fit, splits je het terug in train- en testsets:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn, dat je data als arrays vereist, niet als DataFrames, dus transformeer ze:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 en fit het dan op je data. Let op dat je je model clf noemt, kort voor "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
De featurevariabelen X zijn het eerste argument dat je doorgeeft aan de methode .fit(), terwijl de doelvariabele, y, het tweede argument is.
De output vertelt je alles wat je moet weten over de Decision Tree Classifier die je zojuist hebt gebouwd: zo zie je bijvoorbeeld dat de maximale diepte is ingesteld op 3.
'Survived' en sla je je voorspellingen daarin op. Sla de kolommen 'PassengerId' en 'Survived' van df_test op naar een .csv en dien in bij Kaggle.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
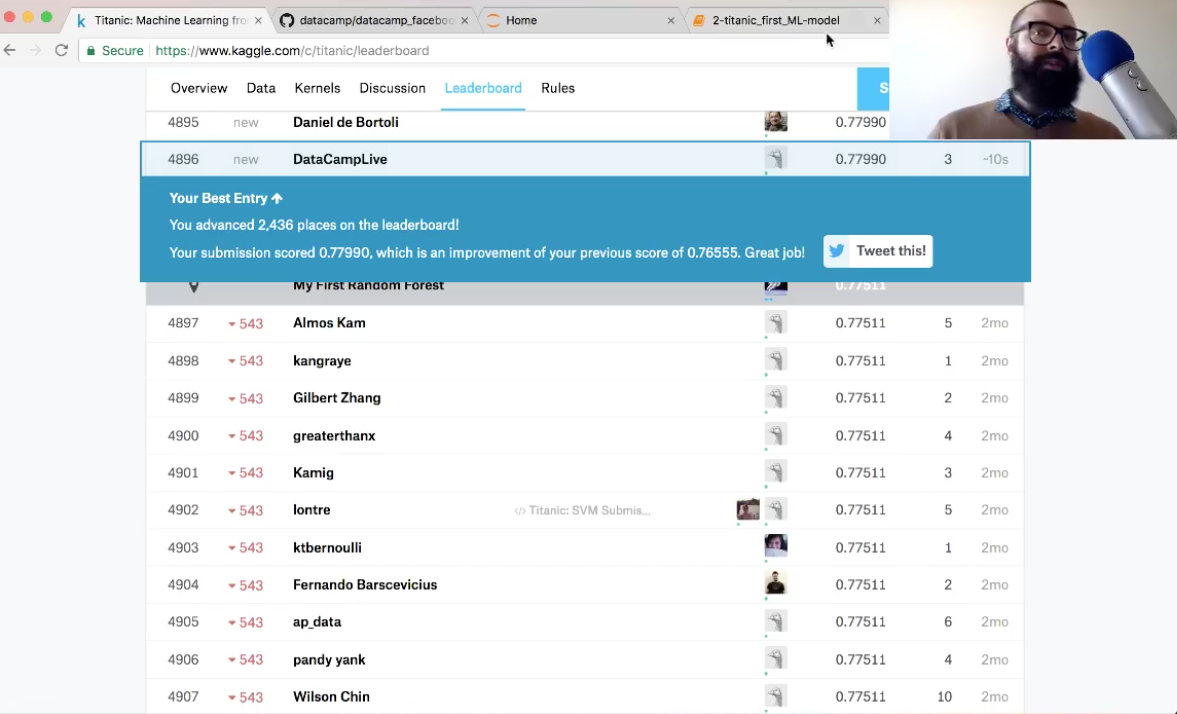
De nauwkeurigheid is 78%. Je bent meer dan 2.000 plaatsen gestegen!
Gefeliciteerd, je hebt je data in een vorm gebracht om je eerste machinelearningmodel te bouwen. Bovendien heb je ook meteen je eerste model gebouwd: een decision tree-classifier.
Nu ga je uitzoeken wat dit max_depth-argument precies is, waarom je het gekozen hebt en train_test_split verkennen.
Voor meer over scikit-learn, bekijk onze Supervised Learning with scikit-learn-cursus.
De Decision Tree Classifier die je zojuist hebt gebouwd had een max_depth=3 en ziet er zo uit:
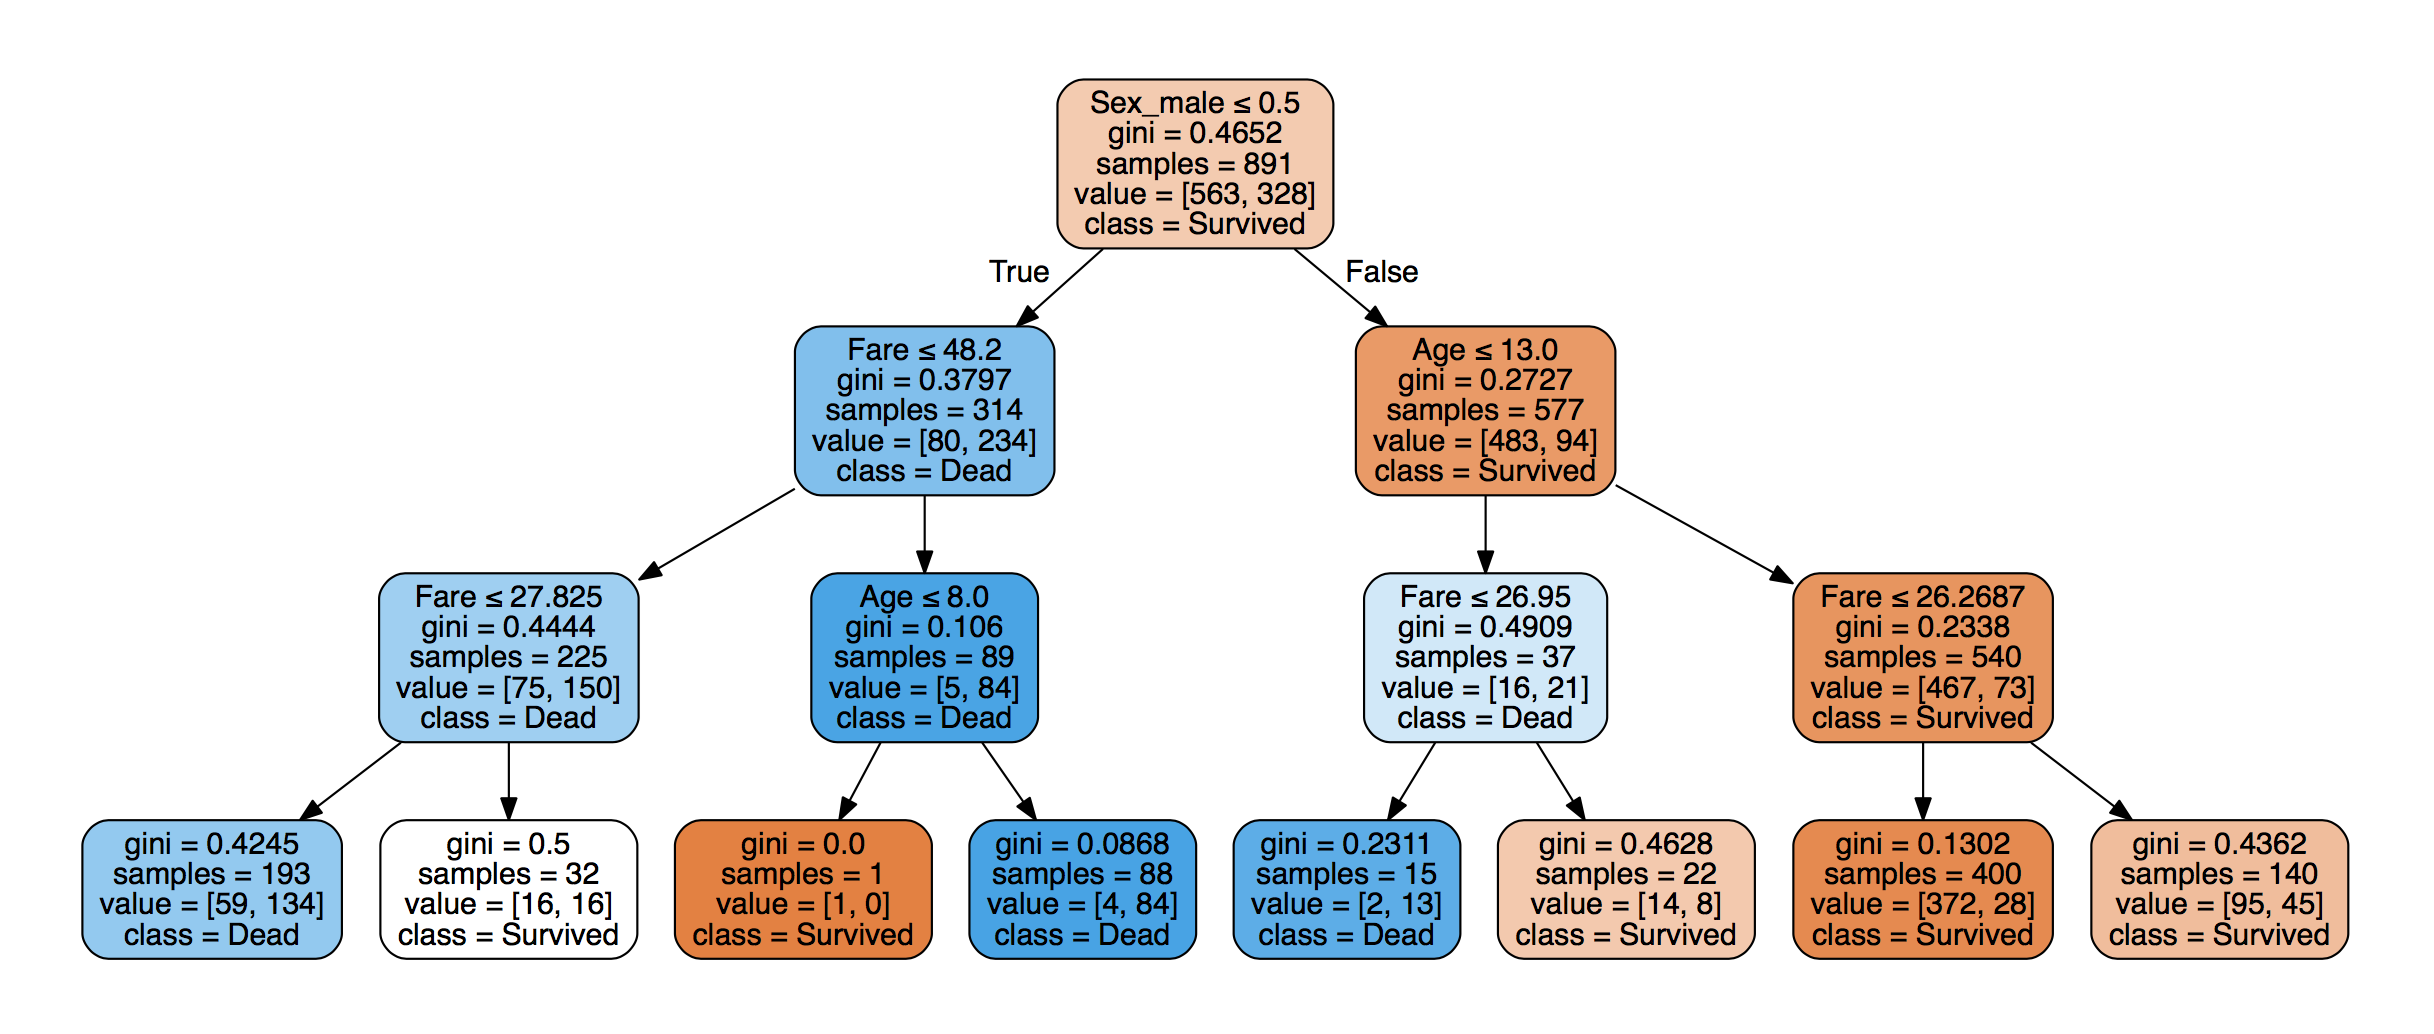
De maximale afstand tussen de eerste beslissing en de laatste is 3, dus dat is max_depth=3.
Let op: je kunt graphviz gebruiken om dit soort figuren te genereren. Zie de scikit-learn-documentatie hier voor meer details.
Bij het bouwen van dit model creëer je in essentie een beslissingsgrens in de ruimte van featurevariabelen, bijvoorbeeld (afbeelding van hier):
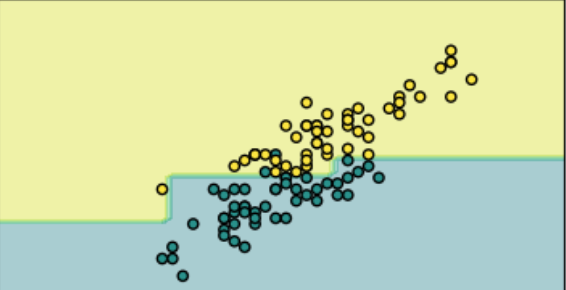
max_depth=3?De diepte van de boom is een hyperparameter, wat betekent een parameter die je moet kiezen vóórdat je het model op de data fit. Als je een grotere max_depth kiest, krijg je een complexere beslissingsgrens.
Als je beslissingsgrens te complex is, kun je overfitten op de data, wat betekent dat je model ruis én signaal beschrijft.
Als je max_depth te klein is, kun je underfitten, wat betekent dat je model niet genoeg van het signaal bevat.
Maar hoe zie je of je aan het overfitten of underfitten bent?
Let op: dit wordt ook wel de bias-variance trade-off genoemd; we gaan daar hier niet op in, maar noemen het voor de volledigheid!
Eén manier is om een testset apart te houden van je trainingsdata. Je kunt dan het model op je trainingsdata fitten, voorspellingen doen op je testset en zien hoe goed je voorspellingen het op de testset doen.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth van 1 tot 9 en de nauwkeurigheid van de modellen op de train- en testsets plotten:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
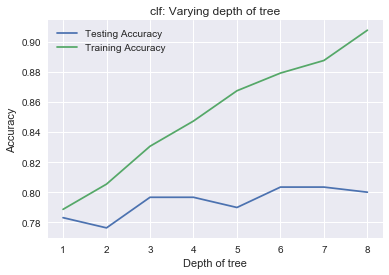
Naarmate je de max_depth verhoogt, ga je steeds beter op de trainingsdata passen, omdat je beslissingen maakt die de trainingsdata beschrijven. De nauwkeurigheid voor de trainingsdata zal blijven stijgen, maar je ziet dat dit niet gebeurt voor de testdata: je overfit.
Daarom koos je voor max_depth=3.
In deze tutorial heb je je data in een vorm gebracht om je eerste machinelearning-model te bouwen. Daarna heb je ook je eerste machinelearningmodel gebouwd: een decision tree-classifier. Tot slot leerde je over train_test_split en hoe dat helpt bij het kiezen van hyperparameters voor ML-modellen.
In de volgende tutorial, die op 10 januari 2018 op de DataCamp Community verschijnt, leer je hoe je nieuwe features kunt engineeren en nieuwe modellen kunt bouwen!
Wil je intussen meer ontdekken over scikit-learn, bekijk dan DataCamps Supervised Learning with scikit-learn-cursus.
Machine learning-cursussen
Cursus
Cursus
blog
Adel Nehme
15 min

