
Last chance! 50% off DataCamp Premium
Sale ends in
Con l'Exploratory Data Analysis (EDA) e il modello di base già pronti, puoi iniziare a lavorare sul tuo primo, vero modello di Machine Learning.
Nota che questo tutorial si basa su una sessione di code along trasmessa in diretta su Facebook; puoi rivederla qui:
Prima di iniziare, importa tutte le librerie necessarie:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data che consiste nella combinazione di train e test set. Lo fai perché vuoi pre-processare un po' i dati e assicurarti che qualsiasi operazione eseguita sul training set venga applicata anche al test set.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data usando il metodo info().data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Ci sono 2 variabili numeriche che hanno valori mancanti.
Quali sono?
Esatto, mancano valori nelle colonne 'Age' e 'Fare'! Dal risultato del metodo .info() qui sopra vedi che mancano 263 valori per la prima colonna, dato che ci sono solo 1046 valori non null su un totale di 1309 righe del DataFrame. Idealmente, vorresti che tutte le 1309 avessero valori non null, ma non è così!
Per fortuna, nella colonna Fare ne manca solo uno. Nota anche che 'Cabin' ed 'Embarked' hanno valori mancanti e dovrai occupartene più avanti.
Per ora, ti concentrerai sulla sistemazione delle variabili numeriche: imputerai, cioè riempirai, i valori mancanti delle colonne 'Age' e 'Fare' usando la mediana di queste variabili dove è disponibile.
Nota che in questo caso usi la mediana perché è perfetta per gestire gli outlier. In altre parole, la mediana è utile quando la distribuzione dei dati è asimmetrica. Altri modi per imputare i valori mancanti sono usare la media, che si ottiene sommando tutti i punti dati e dividendo per il loro numero, o la moda, cioè il valore che ricorre più spesso.
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Già molto meglio, vero?
Nota anche che, nel tutorial precedente e nel notebook, avevi individuato un gruppo di feature da usare per la predizione perché dall'analisi esplorativa dei dati era emerso che sarebbero state importanti per 'Survived' o meno. Una di queste feature era 'Fare', ma anche 'Age' e 'Sex'!
Dato che vuoi codificare i dati in numeri, trasformerai 'male' e 'female' in numeri. Lo fai perché la maggior parte dei modelli di machine learning lavora con feature di input numeriche. Puoi usare la funzione di pandas .get_dummies() per farlo:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() ti permette di creare una nuova colonna per ognuna delle opzioni in 'Sex'. Quindi crea una nuova colonna per female, chiamata 'Sex_female', e poi una nuova colonna per 'Sex_male', che codifica se la riga corrisponde a un uomo o a una donna.
Ora, poiché hai aggiunto l'argomento drop_first nella riga di codice qui sopra, hai eliminato 'Sex_female' perché, in sostanza, queste nuove colonne, 'Sex_female' e 'Sex_male', codificano la stessa informazione.
Quindi tutto ciò che hai fatto è creare una nuova colonna 'Sex_male', che ha 1 se la riga è un uomo e 0 se è una donna.
.get_dummies() sarà uno dei tuoi migliori alleati nella manipolazione dei dati per il machine learning!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] dal tuo DataFrame per costruire il tuo primo modello di machine learning:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() per controllare data:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Tutte le righe ora sono non null. Ottimo lavoro!
Finora hai messo i dati nella forma giusta per costruire il primo modello di machine learning. Questo significa che finalmente puoi costruire il tuo primo modello di machine learning!
Per saperne di più su pandas, dai un'occhiata al nostro percorso Data Manipulation with Python.
Cos'è un classificatore ad albero decisionale? È un albero che ti consente di classificare i punti dati, noti anche come variabili target, in base alle variabili caratteristica.
Per esempio, l'albero qui sotto ha un nodo radice che ti costringe a prendere una prima decisione, basata sulla domanda: "'Sex_male' era minore di 0,5?" In altre parole, il punto dati era una donna. Se la risposta è True, vai a sinistra e ottieni 'Survived'. Se è False, vai a destra e ottieni 'Dead'.
Per ora, non preoccuparti di tutte le informazioni aggiuntive che vedi nei nodi, come gini, samples o value. Potrai approfondire più avanti!
'Male' porti a una previsione di 'Dead'.Nota che in realtà è il coefficiente di gini a essere usato per prendere queste decisioni. A questo punto non entrerai nei dettagli.
data, suddividili di nuovo in training e test set:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn, che richiede i dati come array, non come DataFrame, quindi trasformali:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 e poi adattalo ai tuoi dati. Nota che chiami il tuo modello clf, abbreviazione di "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
Le variabili caratteristica X sono il primo argomento che passi al metodo .fit(), mentre la variabile target, y, è il secondo argomento.
L'output ti dice tutto ciò che devi sapere sul classificatore ad albero decisionale che hai appena costruito: ad esempio, vedi che la profondità massima è impostata a 3.
'Survived' e ci salverai le tue previsioni. Salva le colonne 'PassengerId' e 'Survived' di df_test in un file .csv e inviale a Kaggle.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
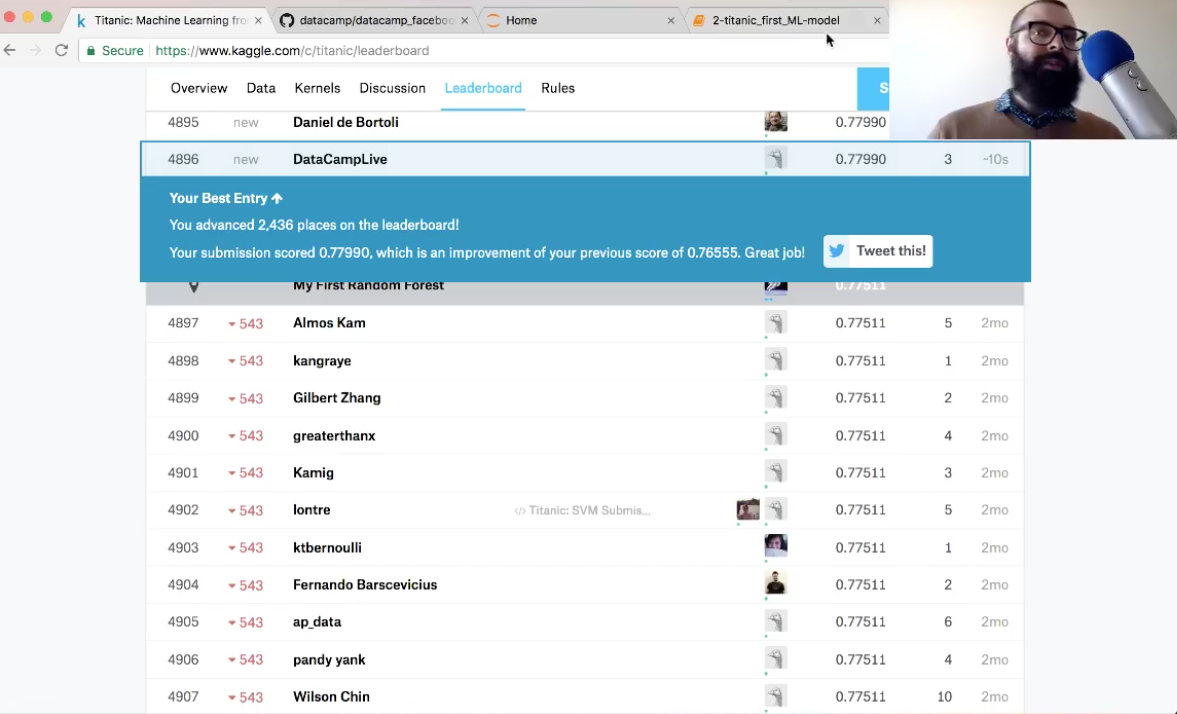
L'accuratezza è del 78%. Sei salito di oltre 2.000 posizioni!
Complimenti, hai messo i dati nella forma giusta per costruire il primo modello di machine learning. Inoltre hai anche costruito il tuo primo modello di machine learning: un classificatore ad albero decisionale.
Ora capirai cos'era questo argomento max_depth, perché lo hai scelto ed esplorerai train_test_split.
Per approfondire scikit-learn, dai un'occhiata al nostro corso Supervised Learning with scikit-learn.
Il classificatore ad albero decisionale che hai appena costruito aveva max_depth=3 e appare così:
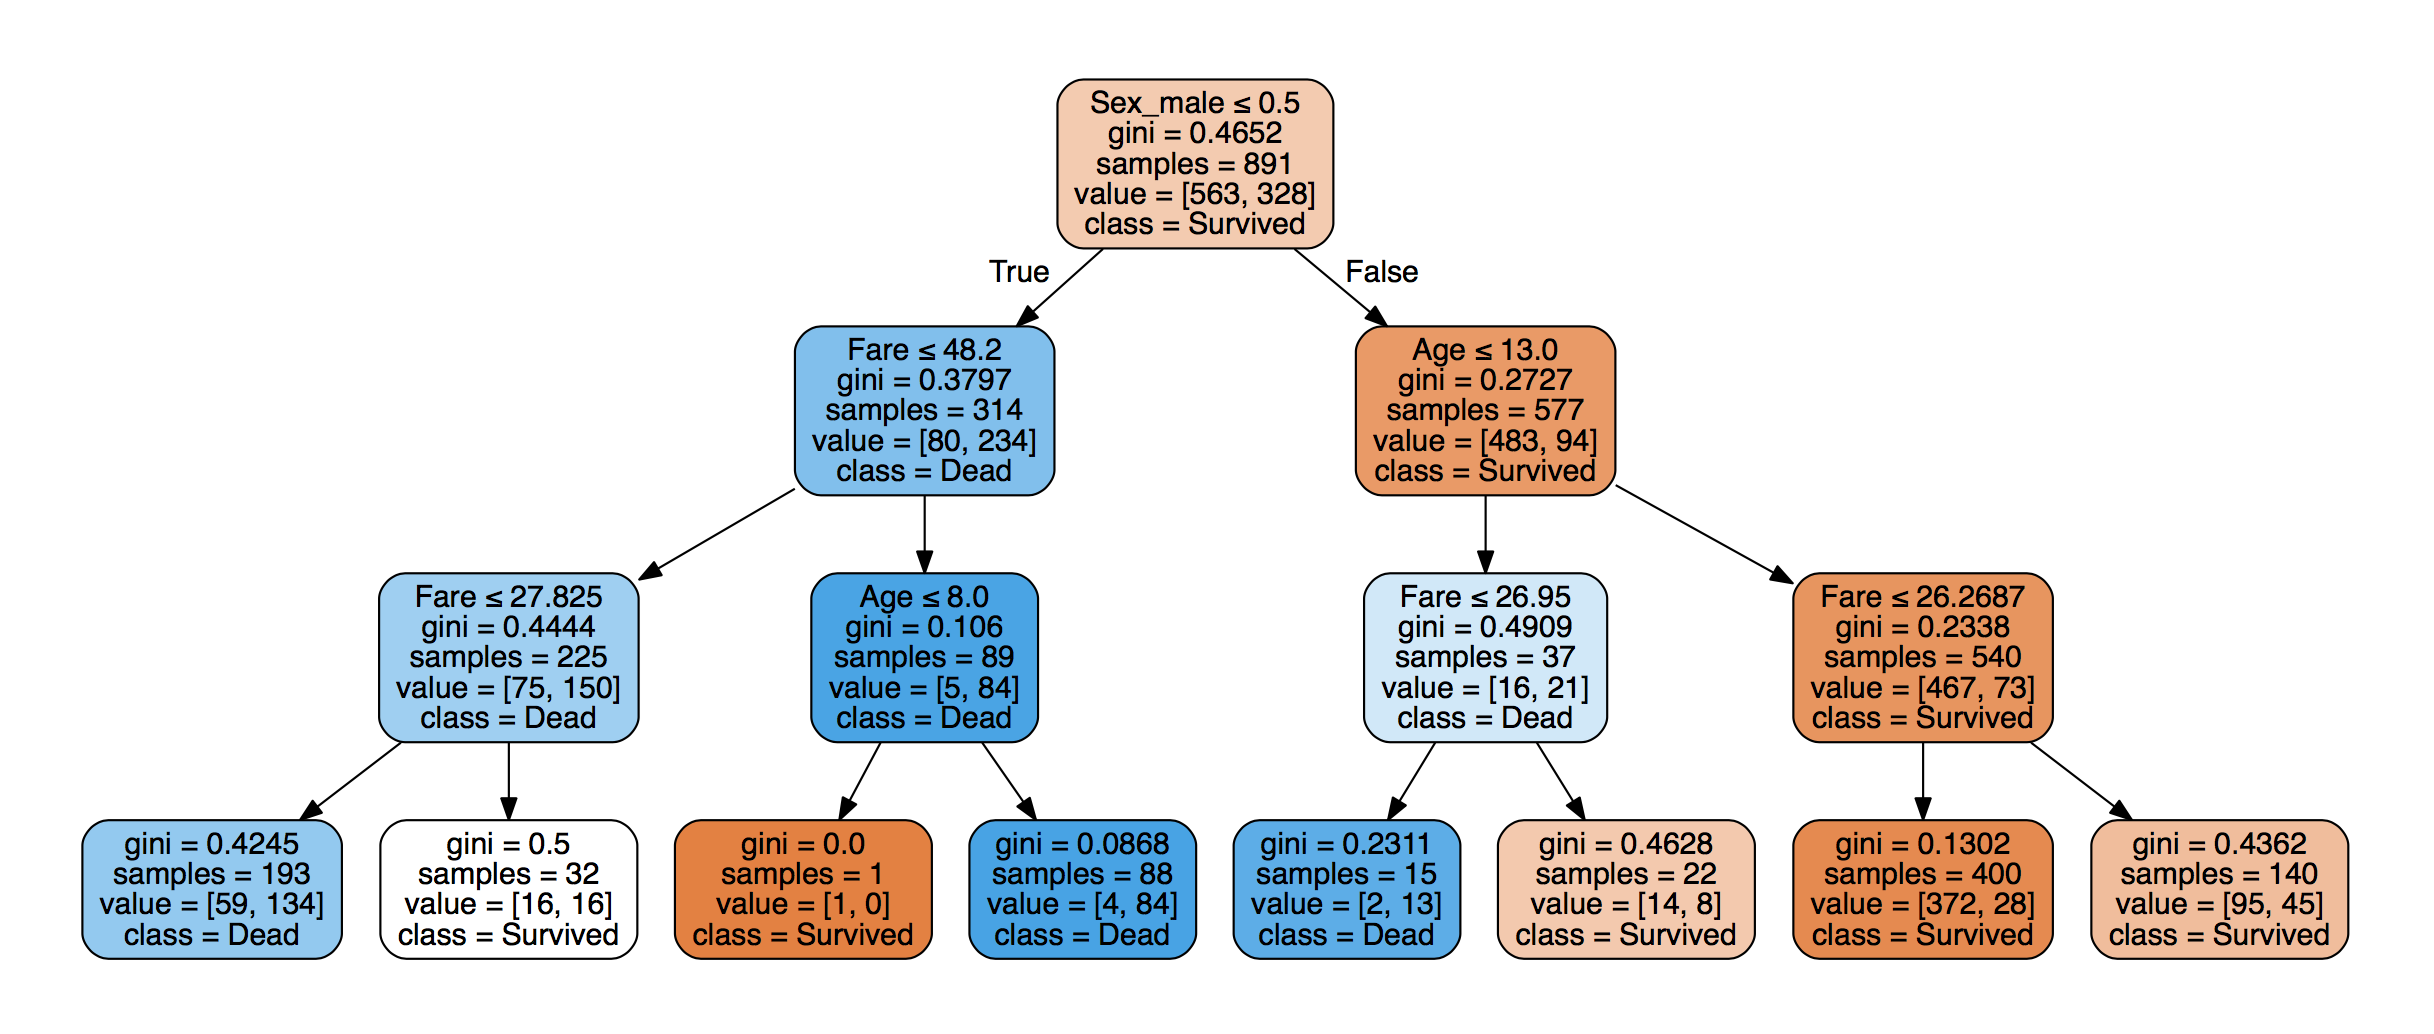
La distanza massima tra la prima decisione e l'ultima è 3, quindi ecco perché max_depth=3.
Nota: puoi usare graphviz per generare figure come questa. Consulta la documentazione di scikit-learn qui per maggiori dettagli.
Nel costruire questo modello, in sostanza stai creando un confine decisionale nello spazio delle variabili caratteristica, per esempio (immagine da qui):
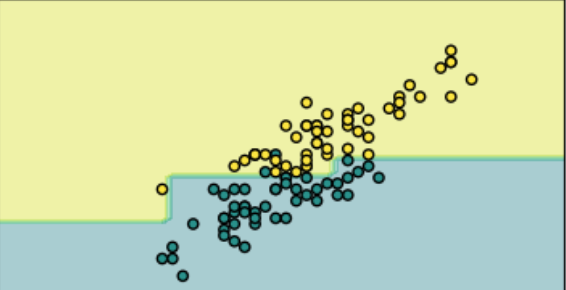
max_depth=3?La profondità dell'albero è un iperparametro, cioè un parametro che devi decidere prima di adattare il modello ai dati. Se scegli un max_depth più grande, otterrai un confine decisionale più complesso.
Se il tuo confine decisionale è troppo complesso, puoi andare in overfitting sui dati, cioè il tuo modello descriverà anche il rumore oltre al segnale.
Se il tuo max_depth è troppo piccolo, potresti andare in underfitting, cioè il tuo modello non cattura abbastanza segnale.
Ma come si fa a capire se stai facendo overfitting o underfitting?
Nota: questo è anche noto come compromesso bias-varianza; non entreremo nei dettagli qui, ma lo citiamo per completezza!
Un modo è tenere da parte un test set dai tuoi dati di training. Puoi poi adattare il modello ai dati di training, fare previsioni sul test set e vedere quanto bene il modello si comporta sul test set.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth che vanno da 1 a 9 e traccerai l'accuratezza dei modelli su training e test set:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
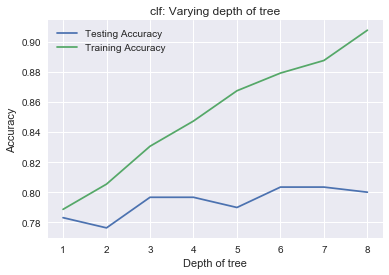
Aumentando il max_depth, ti adatterai sempre meglio ai dati di training perché prenderai decisioni che descrivono quei dati. L'accuratezza sul training salirà sempre di più, ma vedi che questo non succede per i dati di test: stai andando in overfitting.
Ecco perché hai scelto max_depth=3.
In questo tutorial, hai messo i dati nella forma giusta per costruire il primo modello di machine learning. Poi hai anche costruito il tuo primo modello di machine learning: un classificatore ad albero decisionale. Infine, hai imparato train_test_split e come ci aiuta a scegliere gli iperparametri dei modelli di ML.
Nel prossimo tutorial, che uscirà sulla Community di DataCamp il 10 gennaio 2018, imparerai a creare nuove feature e a costruire nuovi modelli!
Nel frattempo, se vuoi scoprire di più su scikit-learn, dai un'occhiata al corso Supervised Learning with scikit-learn di DataCamp.
Corsi di Machine Learning
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min




