
Khóa học
Nhập môn Python
4 giờ
7.1M
Với Phân tích Thăm dò Dữ liệu (EDA) và mô hình cơ sở trong tay, bạn có thể bắt đầu làm việc trên mô hình Học máy thực sự đầu tiên của mình.
Lưu ý hướng dẫn này dựa trên một buổi code along Facebook Live; Bạn có thể xem lại tại đây:
Trước khi bắt đầu, hãy import tất cả thư viện cần thiết:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data bao gồm cả tập huấn luyện và tập kiểm tra gộp lại. Bạn làm vậy vì muốn tiền xử lý dữ liệu một chút và đảm bảo mọi thao tác trên tập huấn luyện cũng được áp dụng cho tập kiểm tra.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data mới của bạn bằng phương thức info().data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Có 2 biến số học đang bị thiếu giá trị.
Chúng là gì?
Đúng vậy, bạn đang thiếu giá trị cho các cột 'Age' và 'Fare'! Bạn thấy trong kết quả của phương thức .info() ở trên rằng bạn thiếu 263 giá trị cho cột đầu tiên, vì chỉ có 1046 giá trị khác null trên tổng 1309 hàng của DataFrame. Lý tưởng nhất, bạn muốn cả 1309 đều có giá trị khác null, nhưng không phải vậy ở đây!
May mắn là bạn chỉ thiếu một giá trị cho cột Fare. Cũng lưu ý rằng 'Cabin' và 'Embarked' cũng thiếu giá trị và bạn sẽ cần xử lý chúng ở một thời điểm nào đó.
Tuy nhiên, bây giờ bạn sẽ tập trung sửa các biến số học: bạn sẽ nội suy hoặc điền giá trị thiếu cho các cột 'Age' và 'Fare' bằng trung vị của các biến này ở những nơi bạn biết.
Lưu ý trong trường hợp này, bạn dùng trung vị vì nó xử lý ngoại lệ rất tốt. Nói cách khác, trung vị hữu ích khi phân phối dữ liệu bị lệch. Cách khác để điền giá trị thiếu là dùng trung bình, được tính bằng cách cộng tất cả điểm dữ liệu và chia cho số lượng điểm, hoặc mode, là giá trị xuất hiện nhiều nhất.
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Nhìn đã ổn hơn nhiều rồi, đúng không!
Cũng lưu ý rằng, trong hướng dẫn trước và notebook, bạn có một loạt đặc trưng muốn dùng để dự đoán vì bạn nhận thấy qua phân tích thăm dò rằng chúng sẽ quan trọng cho việc 'Survived' hay không. Một trong những đặc trưng đó là 'Fare', nhưng 'Age' và 'Sex' cũng vậy!
Nhưng bạn muốn mã hóa dữ liệu thành số, nên bạn sẽ muốn chuyển 'male' và 'female' thành số. Bạn làm vậy vì hầu hết mô hình học máy hoạt động với đặc trưng đầu vào dạng số. Bạn có thể dùng hàm pandas .get_dummies() để làm điều này:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() cho phép bạn tạo một cột mới cho mỗi lựa chọn trong 'Sex'. Vì vậy nó tạo cột mới cho female, gọi là 'Sex_female', và một cột mới cho 'Sex_male', mã hóa việc hàng đó là nam hay nữ.
Bây giờ, vì bạn thêm đối số drop_first trong dòng lệnh trên, bạn đã bỏ 'Sex_female' vì về bản chất, các cột mới 'Sex_female' và 'Sex_male' mã hóa cùng một thông tin.
Vậy là bạn chỉ tạo một cột mới 'Sex_male', có giá trị 1 nếu hàng đó là nam - và 0 nếu là nữ.
.get_dummies() sẽ là một trong những người bạn tốt nhất của bạn khi thao tác dữ liệu cho học máy!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] từ DataFrame để xây dựng mô hình học máy đầu tiên:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() để kiểm tra data:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Tất cả các hàng giờ đã khác null. Làm tốt lắm!
Đến đây, bạn đã có dữ liệu ở dạng sẵn sàng để xây dựng mô hình học máy đầu tiên. Nghĩa là cuối cùng bạn có thể xây dựng mô hình đầu tiên rồi!
Để tìm hiểu thêm về pandas, xem lộ trình Data Manipulation with Python của chúng tôi.
Bộ phân loại cây quyết định là gì? Đó là một cây cho phép bạn phân loại các điểm dữ liệu, còn gọi là biến mục tiêu, dựa trên các biến đặc trưng.
Ví dụ, cây bên dưới có một nút gốc buộc bạn đưa ra quyết định đầu tiên, dựa trên câu hỏi: "'Sex_male' có nhỏ hơn 0,5 không?" Nói cách khác, điểm dữ liệu đó có phải là nữ không. Nếu câu trả lời là True, bạn đi sang trái và nhận được 'Survived'. Nếu False, bạn đi sang phải và nhận 'Dead'.
Hiện tại, bạn chưa cần lo về tất cả thông tin bổ sung trong các nút, như gini, samples hoặc value. Bạn có thể tìm hiểu sau!
'Male' dẫn đến dự đoán 'Dead'.Lưu ý thực ra hệ số gini được dùng để đưa ra các quyết định này. Tại thời điểm này, bạn chưa đi sâu vào phần đó.
data, hãy tách lại thành tập huấn luyện và tập kiểm tra:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn, vốn yêu cầu dữ liệu ở dạng mảng, không phải DataFrame nên hãy chuyển đổi chúng:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 rồi fit vào dữ liệu. Lưu ý bạn đặt tên mô hình là clf, viết tắt của "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
Các biến đặc trưng X là đối số đầu tiên bạn truyền vào phương thức .fit(), trong khi biến mục tiêu, y, là đối số thứ hai.
Đầu ra cho bạn biết tất cả những gì cần về Bộ phân loại Cây quyết định vừa xây dựng: ví dụ, bạn thấy độ sâu tối đa được đặt là 3.
'Survived' và lưu dự đoán vào đó. Lưu hai cột 'PassengerId' và 'Survived' của df_test ra .csv và gửi lên Kaggle.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
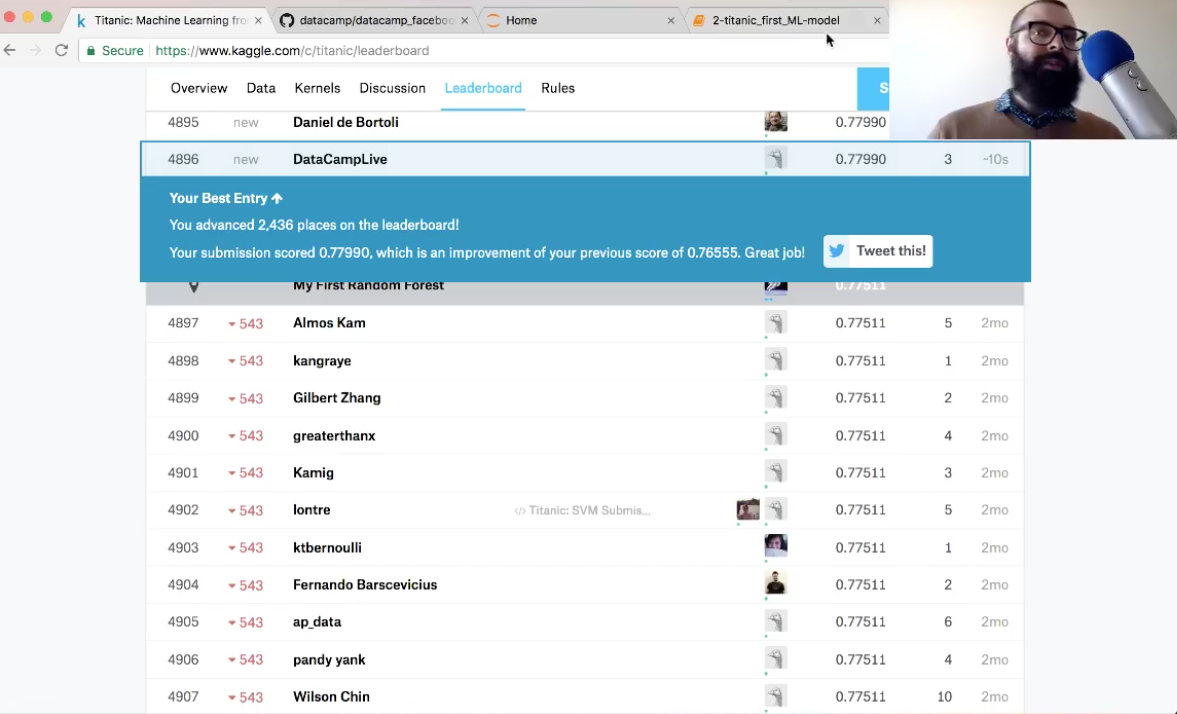
Độ chính xác là 78%. Bạn đã tiến hơn 2.000 hạng!
Chúc mừng, bạn đã đưa dữ liệu về dạng sẵn sàng để xây dựng mô hình học máy đầu tiên. Không chỉ vậy, bạn còn đã xây dựng mô hình đầu tiên: một bộ phân loại cây quyết định.
Giờ đây, bạn sẽ tìm hiểu đối số max_depth là gì, vì sao bạn chọn nó và khám phá train_test_split.
Để biết thêm về scikit-learn, hãy xem khóa học Supervised Learning with scikit-learn của chúng tôi.
Bộ phân loại Cây quyết định bạn vừa xây dựng có max_depth=3 và trông như sau:
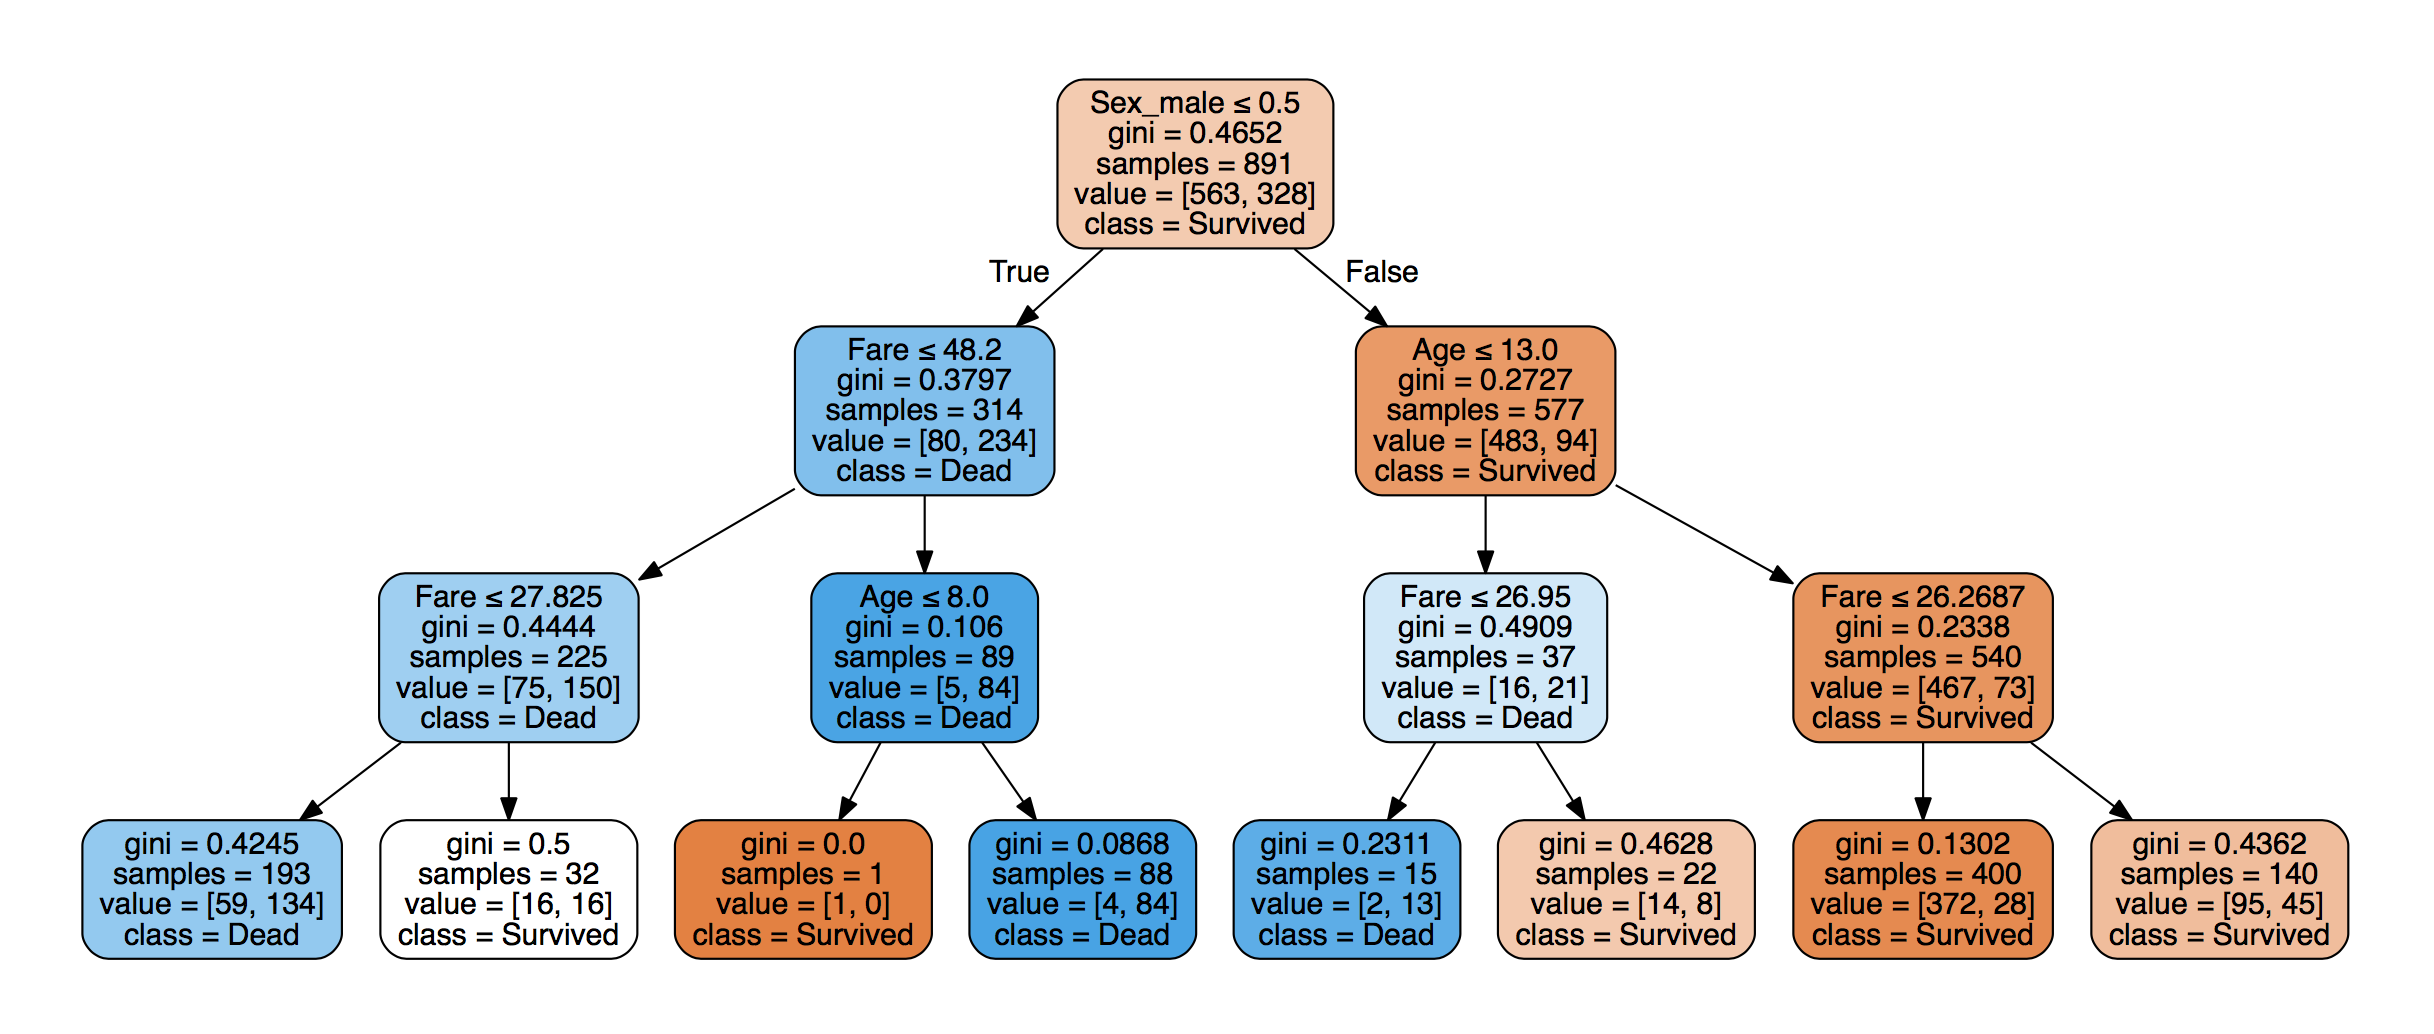
Khoảng cách tối đa giữa quyết định đầu tiên và cuối cùng là 3, nên đó là max_depth=3.
Lưu ý: bạn có thể dùng graphviz để tạo các hình như thế này. Xem tài liệu scikit-learn tại đây để biết chi tiết.
Khi xây dựng mô hình này, về bản chất bạn đang tạo một ranh giới quyết định trong không gian các biến đặc trưng, ví dụ (hình từ đây):
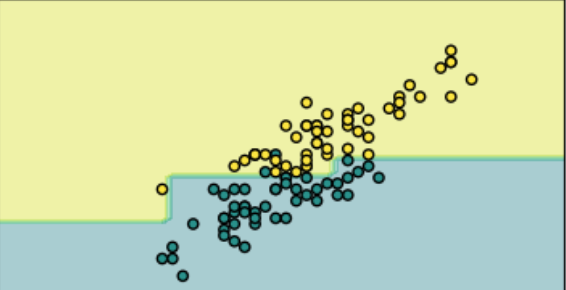
max_depth=3 ?Độ sâu của cây được gọi là siêu tham số (hyperparameter), nghĩa là tham số bạn cần quyết định trước khi fit mô hình vào dữ liệu. Nếu bạn chọn max_depth lớn hơn, bạn sẽ có ranh giới quyết định phức tạp hơn.
Nếu ranh giới quyết định quá phức tạp, bạn có thể overfit dữ liệu, nghĩa là mô hình sẽ mô tả cả nhiễu lẫn tín hiệu.
Nếu max_depth quá nhỏ, bạn có thể underfit dữ liệu, tức mô hình không nắm bắt đủ tín hiệu.
Nhưng làm sao biết bạn đang overfit hay underfit?
Lưu ý: điều này còn được gọi là đánh đổi bias-variance; chúng tôi sẽ không đi sâu vào đây, chỉ nhắc để đầy đủ!
Một cách là giữ lại một tập kiểm tra từ dữ liệu huấn luyện. Sau đó bạn fit mô hình vào dữ liệu huấn luyện, tạo dự đoán trên tập kiểm tra và xem dự đoán hoạt động thế nào trên tập kiểm tra.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth từ 1 đến 9 và vẽ độ chính xác của mô hình trên tập huấn luyện và kiểm tra:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
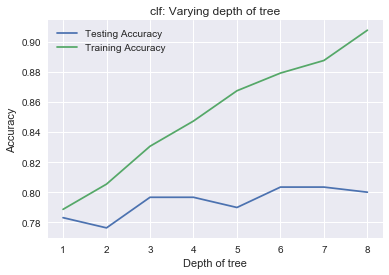
Khi bạn tăng max_depth, bạn sẽ fit ngày càng tốt hơn với dữ liệu huấn luyện vì bạn đưa ra các quyết định mô tả dữ liệu huấn luyện. Độ chính xác trên dữ liệu huấn luyện sẽ tăng dần, nhưng bạn thấy điều này không xảy ra với dữ liệu kiểm tra: bạn đang overfit.
Đó là lý do bạn đã chọn max_depth=3.
Trong hướng dẫn này, bạn đã đưa dữ liệu về dạng sẵn sàng để xây dựng mô hình học máy đầu tiên. Tiếp theo, bạn cũng đã xây dựng mô hình học máy đầu tiên của mình: một bộ phân loại cây quyết định. Cuối cùng, bạn đã tìm hiểu về train_test_split và cách nó giúp chúng ta chọn siêu tham số cho mô hình ML.
Trong hướng dẫn tiếp theo, sẽ xuất hiện trên DataCamp Community vào ngày 10 tháng 1 năm 2018, bạn sẽ học cách xây dựng một số đặc trưng mới và tạo thêm một số mô hình mới!
Trong lúc chờ đợi, nếu bạn muốn khám phá thêm về scikit-learn, hãy xem khóa học Supervised Learning with scikit-learn của DataCamp.
Các khóa học Machine Learning
Khóa học
Khóa học